
在 GitHub 上搜尋「amazon scraper」,大約會出現 3,515 個儲存庫。如果再縮小到最近六個月有更新的專案,數量就只剩約 727 個——不到 20%。那其餘的呢?多半是早已停更的教學、過時的封裝,以及 Amazon 一加強防禦就立刻失效的腳本。
我花了很多時間翻查 Amazon scraper 儲存庫、閱讀 GitHub issues,並追蹤 Reddit 和 Stack Overflow 上的社群討論。模式非常一致:有人找到一個熱門 repo,花一小時把它架起來,跑一次之後就被一整片 CAPTCHA 或 503 錯誤擋住。Amazon 在 2026 年的反機器人策略,和兩年前已經完全不同——TLS 指紋辨識、行為分析、以及更激進的 CAPTCHA 部署,讓過去那套「輪換 user agent,然後祈禱順利」的做法幾乎失效。這篇指南會整理真正重要的最佳做法:如果你想從 GitHub repo 穩定取得 Amazon 資料,該怎麼做;以及當你的 scraper 壞掉時,甚至不是「如果」,而是「何時」壞掉時,該怎麼應對。
GitHub 上的 Amazon Scraper 到底是什麼?為什麼這麼多都失敗?
GitHub 上的 Amazon scraper repo 通常是一個開源腳本——多半是 Python、Node.js 或基於 Scrapy——用來從 Amazon 頁面擷取結構化資料。常見的資料目標都很熟悉:商品標題、價格、ASIN、評分、評論數、庫存狀態、賣家資訊、搜尋結果卡片,以及評論文字。
整體架構通常很直觀:
- HTTP client 或無頭瀏覽器抓取頁面。
- HTML 或 JSON parser 擷取欄位。
- 資料存成 CSV、JSON 或資料庫。
這些 repo 大致可分成四類:
- 輕量級 Python 函式庫(例如 amzpy)
- Scrapy spiders(例如 amazon-python-scrapy-scraper)
- Selenium 或 Playwright 瀏覽器自動化工具
- API wrapper 專案,其實只是商業爬取服務的前端(例如 oxylabs/amazon-scraper)
失敗模式其實可以預期。大多數 repo 失效的原因包括:
- Amazon 改了頁面版型或 HTML 片段
- Amazon 直接回傳 503 或 CAPTCHA,而不是正常內容
- scraper 的 TLS 與 HTTP 指紋不再像瀏覽器
- 地區、語言或標頭不一致,觸發了可疑行為判定
- 原作者完成最初的窄範圍需求後就不再維護
高星數和「目前可用」是兩回事。根據我為這篇文章做的檢視,在八個廣為出現的 repo 裡,只有大約三個在 2026 年看起來明顯還有持續維護。
在複製任何 Amazon Scraper GitHub Repo 之前,先做 2026 新鮮度檢查
這一步對 Amazon 來說,比大多數其他目標都更重要。Amazon 的防禦策略變動速度,比一般電商網站快得多,所以一個在展示型網站上運作正常的 repo,可能幾週內就在 Amazon 上失去價值。然而大多數「best amazon scraper github」清單在推薦 repo 時,根本沒有確認它們是否還真的能跑。使用者常常白白花幾小時設定一個壞掉的工具。
如何判斷 GitHub Repo 是否還活著
在 git clone 之前,先做以下檢查:
- 最後一次 commit 日期: 在 Amazon 這種目標上,超過 6 個月沒更新就是明顯警訊。
- 未解決 issues 與回應率: 到 Issues 分頁搜尋「captcha」、「503」、「blocked」與「not working」。如果這些問題一直堆積,卻看不到維護者回覆,就別碰了。
- 依賴健康度: 打開
requirements.txt或package.json。過時的函式庫(例如不支援現代 TLS 處理的舊requests)是紅旗。 - Amazon 頁面類型涵蓋範圍: 這個 repo 是否同時支援商品頁、搜尋結果和評論頁?還是只支援其中一種?
- 反機器人策略: 只有硬編碼 headers、沒有 proxy 支援的做法,還停留在 2023 年,撐不到 2026。
Amazon Scraper GitHub 新鮮度檢查清單
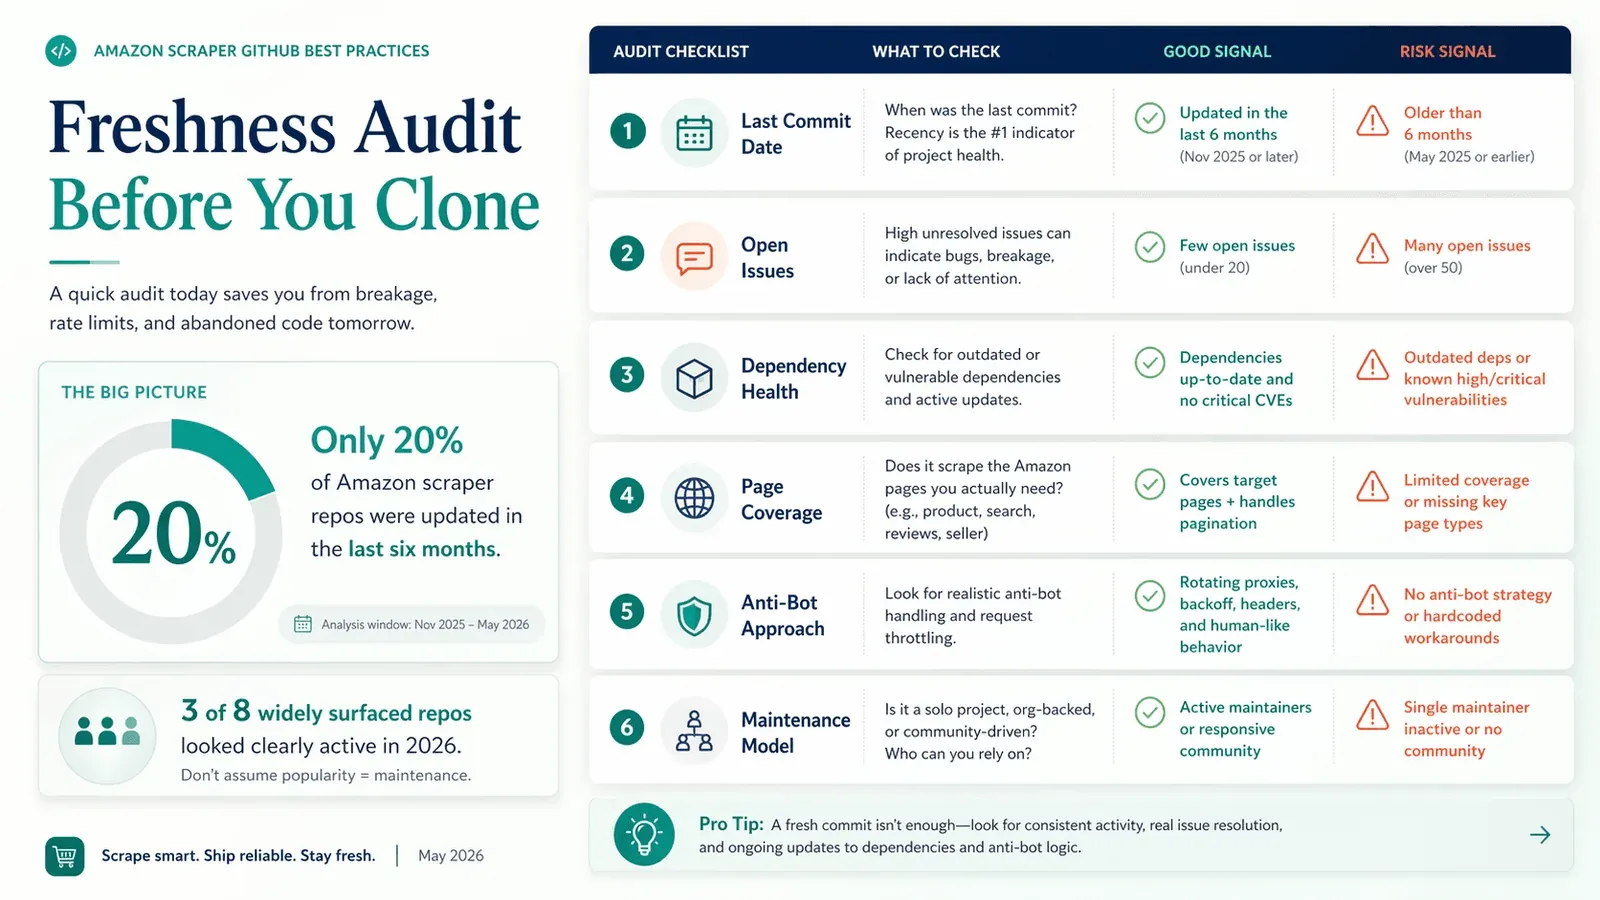
| 新鮮度訊號 | 檢查重點 | 紅旗 🚩 |
|---|---|---|
| 最後 commit 日期 | Commit feed 或 repo 推送日期 | 超過 6 個月 |
| 未解決 issues | Issues 分頁——篩選「captcha」、「503」、「blocked」 | 一再壞掉,卻沒有維護者回覆 |
| 依賴健康度 | requirements.txt / package.json | 過時函式庫,沒有現代 TLS 策略 |
| Amazon 頁面涵蓋範圍 | README + 程式範例 | 只處理一種頁面(例如商品頁,不支援搜尋或評論) |
| 反機器人策略 | 原始碼、proxy 設定 | 只有硬編碼 headers 和 UA 字串 |
| 維護模式 | 真的是 scraper、教學,還是商業 API wrapper? | 其實只是付費服務的前端 |
這次檢查真正發現了什麼
我根據上述標準檢查了八個廣為出現的 Amazon scraper repo。結果很令人警醒:
| Repo / 工具 | 星數 | 最後 commit 訊號 | 範圍 | 2026 狀態 | 備註 |
|---|---|---|---|---|---|
| oxylabs/amazon-scraper | 約 2,872 | 2026-04-02 | 代管 scraper API wrapper | 存活中,但不適合 DIY | 更新很新,但本質上是代管服務的前端 |
| omkarcloud/amazon-scraper | 約 214 | 2026-02-25 | 搜尋、詳情、評論的代管 API | 存活中,但不適合 DIY | 涵蓋範圍不錯,但它是 API 產品,不是原生 scraper |
| theonlyanil/amzpy | 約 110 | 2026-02-26 | 輕量級 Python 函式庫 | 存活中 | 目前最清楚的直接 GitHub scraper,使用 curl_cffi |
| philipperemy/amazon-reviews-scraper | 約 134 | 2024-11-21 | 只抓評論 | 範圍狹窄,但仍可用 | 很老,而且高度聚焦評論頁 |
| python-scrapy-playbook/amazon-python-scrapy-scraper | 約 74 | 最後 commit 2023;repo 推送 2024-08-20 | Scrapy spiders + proxy middleware | 教學等級,已老化 | 適合學習,不是 2026 的即戰型堆疊 |
| drawrowfly/amazon-product-api | 約 744 | 2022-11-13 | Node CLI,支援搜尋、詳情、評論 | 高風險 | 涵蓋範圍廣,但維護太久沒更新 |
| tducret/amazon-scraper-python | 約 881 | 2020-10-13 | 從搜尋到 CSV | 2026 已失效 | 歷史上很受歡迎,但明顯停更 |
| scrapehero-code/amazon-scraper | 約 432 | 2020-06-21 | 搜尋/商品教學 | 2026 已失效 | 幾乎可視為歸檔內容 |
公開 issues 也說明了同樣的情況。 drawrowfly/amazon-product-api 有一則 issue 標題叫「All requests receive captcha response.」。theonlyanil/amzpy 有「Doesn't seem to be working.」。python-scrapy-playbook 的 scraper 則是「Bypass Amazon protection.」。這些都不是冷門邊角案例——而是使用者最先會碰到的問題。
反封鎖實戰:如何避免用 GitHub 的 Amazon Scraper 被擋
被封鎖,是任何使用 amazon scraper github 專案的人最頭痛的問題。像「使用 proxies 和輪換 user agents」這種泛泛之談,現在已經不夠用了。Amazon 在 2025–2026 的反機器人堆疊,包含 TLS 指紋辨識、行為分析,以及更積極的 CAPTCHA 部署。你需要的是分層策略。
TLS 指紋匹配:為什麼原生 requests 會害你被封
這是最常被忽略的反封鎖技巧之一。TLS 指紋辨識的運作方式是:當你的腳本對 Amazon 建立安全連線時,伺服器可以透過「握手」方式看出很多客戶端特徵——例如支援的 cipher suites、extensions 的順序、HTTP/2 設定。瀏覽器會使用相對固定的 TLS 與 HTTP/2 設定,而這些組合可以透過 JA3 和 Akamai HTTP/2 fingerprints 之類的技術被識別。
單純的 requests 與一般 httpx 設定可以複製 headers,卻無法複製像 Chrome 那樣的 TLS 和 HTTP/2 行為。Amazon 分得出差異。
curl_cffi 就是直接針對這件事而生。它提供瀏覽器擬態——支援的目標包括 chrome136、safari184 和 firefox133——讓你的 HTTP client TLS 指紋更接近真實瀏覽器。文件也明確提醒不要隨機生成 JA3 字串:瀏覽器指紋在同一版本下大多是固定的,亂造一個反而比複製真實指紋更容易被偵測。
社群資料也印證了這點。Reddit 上一個關於 curl_cffi + Amazon 的討論串 確認 impersonate 參數很有用,因為它可以輪換瀏覽器 profile,並讓 headers 保持一致。另一則 Reddit 討論串 指出,Amazon 大約在「一到兩個月後」就會根據 TLS 指紋封鎖 client。還有一個 Stack Overflow 討論 直接問 Amazon 是否在 fingerprint python-requests(答案:是)。
如果你現在還把原生 requests 當作抓 Amazon 的第一線 client,那你應該先升級這個假設,再升級其他任何東西。
正確的 Proxy 輪換方式(不只是「用 proxies」)
Proxy 的目的不是盡可能頻繁輪換,而是讓 session 看起來可信。
住宅 proxy vs. 資料中心 proxy: 資料中心 proxy 比較便宜,但也更容易被偵測。住宅 proxy 成本較高,但 Amazon 更難標記。 Bright Data 的住宅 proxy 定價 起價是每 GB 4.00 美元,較大的方案可降到每 GB 3.50 美元。Oxylabs 住宅 proxy 起價則是每 GB 6 美元。Amazon 屬於那種「目標很成熟」的類型,住宅 proxy 的溢價通常是值得的。
每次請求輪換 vs. 每個 session 輪換: 這是很多教學最容易做錯的地方。每次 request 都換 proxy,卻維持固定 cookies 和 headers,反而可能看起來 更不像 真人,而不是更像。比較安全的模式是:
- 盡可能讓搜尋 → 商品 → 評論的流程走在同一個 sticky session
- 開始新的搜尋旅程時再切換 session,而不是每個 request 都切
- 在session 之間輪換,不要在單一瀏覽 session 裡亂跳
一位 Reddit 留言者 提到,在熱門電商網站上,標準 ISP IP 的表現遠不如行動 IP。另一個 討論串 也回報,即使輪換 user agent 並使用住宅 proxy,仍然會被封——這提醒我們:只靠 proxies 並不夠。
請求節奏、退避與速率限制
Amazon 的 503 頁面不是偶然的壞運氣,而是在回饋你。
一篇關於抓取超過 500 個 ASIN 的 Stack Overflow 貼文 提到,即使有 sleep,每次都會在相同位置、約第 101 個 ASIN 左右出現 503。這種模式並不新,但教訓很明確:單一 IP 或單一指紋的原始流量量級,終究會觸發防禦機制。
DIY GitHub scraper 的最佳節奏做法:
- 請求之間加入隨機延遲(不要固定間隔,因為那很容易被偵測)
- 對簡單 HTTP client,公開商品請求之間留 2 到 5 秒
- 遇到 503 或 CAPTCHA 後做 指數退避——逐步拉長等待,而不是立刻重試
- 降低 concurrency,比你直覺想要的還要低
- 使用 fail-open 記錄,不要寫成死循環重試
大多數 amazon scraper github repo 都沒有內建速率限制。這部分通常得自己加。
Header 編排:不只是 User-Agent 字串
Amazon 檢查的是整組 headers,不只是 User-Agent。
一組像真的瀏覽器的 headers 應該包含:
User-AgentAcceptAccept-LanguageAccept-Encoding- 適當時使用
Sec-CH-*提示 - 與所選瀏覽器 profile 一致的連線行為
Headers 也應該與 marketplace 的地區一致。有一位 Reddit 使用者在抓 10 個 Amazon 地區站時 發現,同一套 bot 設定只在某些地區被偵測到,另一位留言者則指向像 Accept-Language 這類和區域相關的 headers。
原則是:headers、TLS/瀏覽器 profile、以及 proxy 地理位置彼此不能矛盾。不要拿 Chrome 的 headers 配 Firefox UA。也不要用美國 proxy,卻送出 Accept-Language: de-DE。
CAPTCHA 處理:什麼時候該解,什麼時候該退
碰到 CAPTCHA 代表 Amazon 已經對你起疑心了。把它解開,並不會重置你的信任分數。
對於偶發、低頻率的 CAPTCHA 事件:
amazoncaptcha這個 PyPI 套件是純 Python 的 Amazon 文字 CAPTCHA 解題工具,但最新版本是 2023 年 5 月發布——請把它當成戰術工具,而不是長期策略- 2Captcha 對 Amazon Captcha 的定價是每 1,000 次 0.45 美元
對於反覆出現的 CAPTCHA 迴圈:
- 停止解題,開始退避
- 反覆 CAPTCHA 代表這個 session 已經燒掉了——解掉它們,並不能重建對 fingerprint、session 歷史或 IP 信譽的信任
- 如果 CAPTCHA 集中出現在某個 proxy 子網,問題在網路層,而不是 parser
什麼時候真的需要無頭瀏覽器,什麼時候只是過度設計
常見的錯誤直覺是:什麼都先跑 Playwright。
適合用瀏覽器的情境:
- 需要 JavaScript render 或與地區狀態相關的搜尋結果頁
- 會導向登入頁或 sign-in 頁面的評論流程
- cookies 和瀏覽器 context 比速度更重要的流程
不適合用瀏覽器的情境:
- 一般公開商品頁
- 只要像瀏覽器的 HTTP client 就足夠的靜態商品詳情擷取
- 重視運算效率的大規模批次抓取
先從能用的最輕量 client 開始。一則關於大規模抓取的 Reddit 討論串 也描述了這種遞進方式:先從 requests 開始,再用 curl_cffi,只有在輕量方案失敗時才升級成完整瀏覽器。對 Amazon 商品頁抓取來說,無頭瀏覽器在速度上和資源消耗上都明顯更重。
Amazon Scraper GitHub 專案的反封鎖決策矩陣
| 情境 | 建議做法 | 原因 |
|---|---|---|
| 公開商品頁(小規模) | curl_cffi + sticky 住宅 session | 成本最低,且仍像瀏覽器 |
| 搜尋結果頁 | 先用 curl_cffi,只有在 render 或 state 讓 HTTP 失效時才用 Playwright | 搜尋更有狀態,也更依賴地區設定 |
| 評論頁(需要登入) | 使用真實 cookies/session 的瀏覽器模式 | 登入與動態評論流程,比純 HTTP 更難模擬 |
| 大規模(每天 5k+) | 代管 scraper API、unlocker,或無程式碼平台 | 只靠 DIY GitHub 程式碼,最後會變成基礎設施問題 |
當你的 Amazon Scraper GitHub 專案壞掉時:要有無程式碼備援方案
有經驗的人都會準備 Plan B。
Amazon 的更新終究會在最糟的時候,把任何 GitHub repo 弄壞。對電商團隊來說,scraper 壞掉意味著錯過價格變動、競品資料過時,以及儀表板出現缺口。
很多搜尋「amazon scraper github」的人,其實是商業使用者——電商營運、行銷人員、FBA 研究者——他們嘗試寫程式解法,只因為找不到更好的選項。論壇資料也顯示,大家對 Amazon 官方 Product Advertising API 的不滿很真實:存取限制嚴格、資料有限,而且 註冊要求 讓很多賣家根本無法符合。
為什麼 GitHub 的 Amazon Scraper 需要持續維護
上面的檢查結果把這件事說得很清楚:
- 停更 repo 的 bug 報告只會越積越多,卻沒人修
- 現在「還能用」的 repo,README 也開始直接談反機器人措施
- 社群討論越來越集中在 TLS 指紋、CAPTCHA 迴圈和 proxy 品質,而不是 CSS selector
對商業使用者來說,這份維護成本才是真正隱藏的成本。repo 本身可能免費,但你在凌晨兩點 debug 它所花的時間,可不是免費的。
Thunderbit:一個實用的 Amazon Scraper 替代方案
Thunderbit 提供一個 Amazon Products Scraper 範本,可以擷取標題、價格、ASIN、評分、品牌、庫存、出貨地,以及原始 URL——完全不需要寫程式。
實際用起來大概是這樣:
- 2 次點擊即可抓取,不用先架 Python 環境、裝依賴、設 proxy
- 即時 Amazon 範本——不需要 AI 額外處理,只要 1 次點擊就能擷取
- 瀏覽器抓取模式,適用需要登入的頁面(像讓 GitHub scraper 使用者很頭痛的評論頁)
- 雲端抓取,可高速處理公開商品頁(一次 50 頁)
- 免費匯出到 Google Sheets、Airtable、Notion、Excel,不只是 CSV/JSON
- 排程爬蟲,適合持續監控價格
- AI 會自動適應版面變化——你不用自己維護
GitHub Amazon Scraper vs. Thunderbit:誠實比較
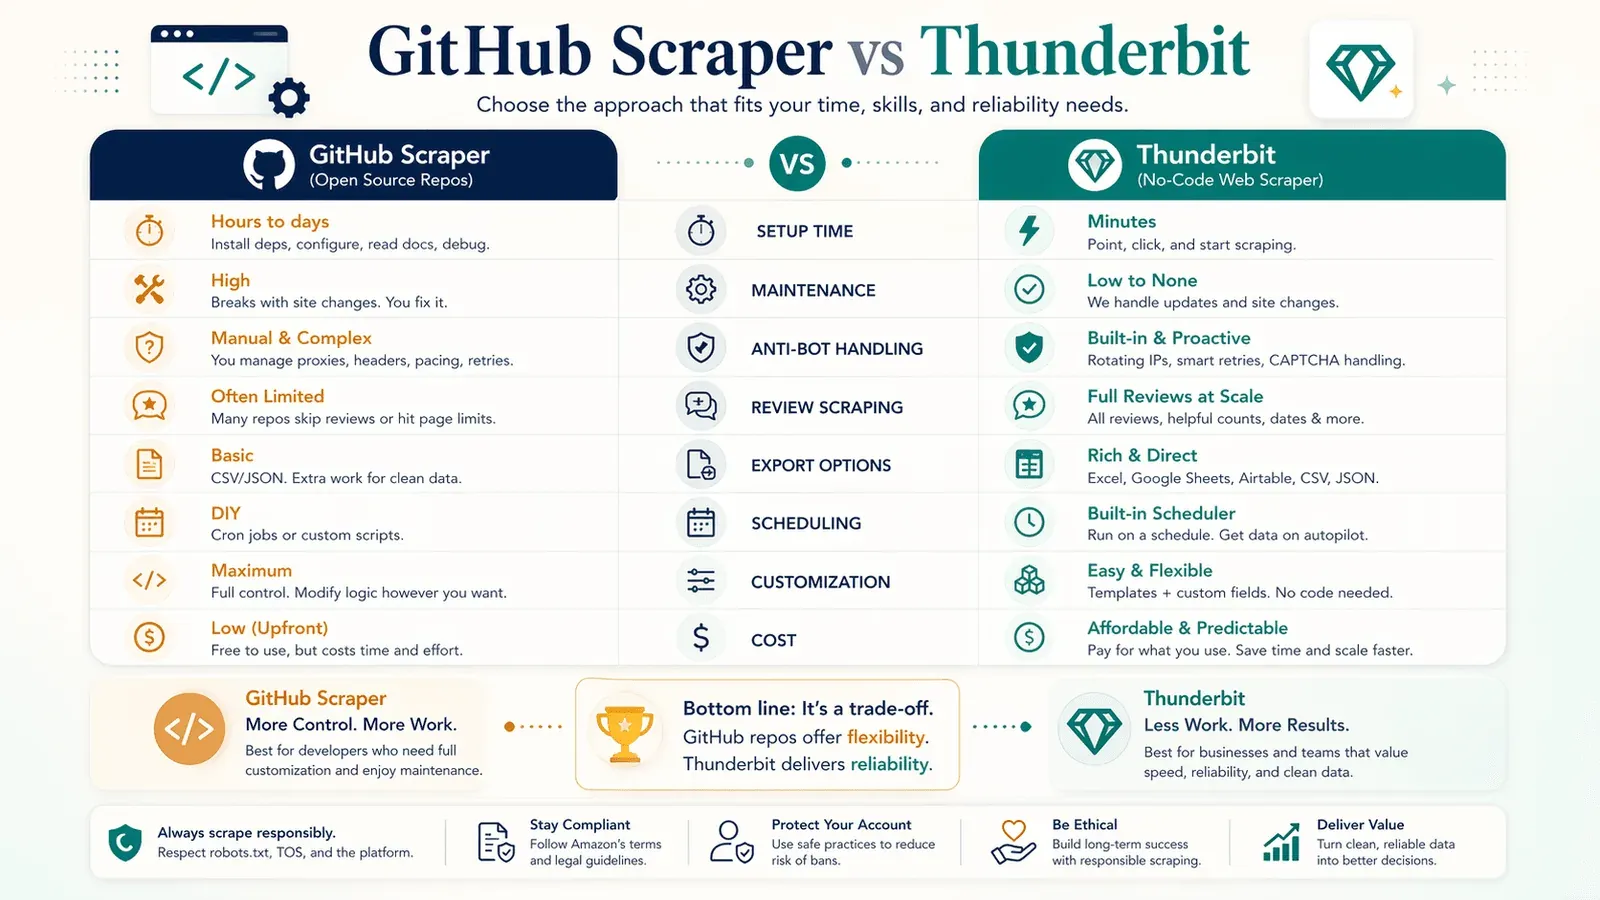
| 因素 | GitHub Scraper(例如 AmzPy) | Thunderbit |
|---|---|---|
| 設定時間 | 15–60 分鐘(Python、依賴、proxies) | 約 2 分鐘(安裝 Chrome 擴充功能) |
| 維護 | 你自己修壞掉的部分 | AI 會適應版面變化 |
| 反機器人處理 | 自己處理(proxies、headers、TLS) | 內建(雲端 + 瀏覽器模式) |
| 評論抓取(需登入) | session 管理複雜 | 瀏覽器抓取模式 |
| 資料匯出 | 只有 CSV/JSON | Sheets、Airtable、Notion、Excel、CSV、JSON |
| 排程 | 自己做(cron、Airflow 等) | 內建排程爬蟲 |
| 客製化 | 較高 | 較低 |
| 成本 | 免費(另加 proxy 成本) | 有免費方案;採點數制 |
誠實地說,取捨就在這裡:GitHub repo 提供更多客製化;Thunderbit 提供更高可靠性。如果你的團隊更在意可用性,而不是彈性,那麼無程式碼方案通常是更理性的選擇。
Amazon 排程與週期性抓取的最佳做法
大多數 amazon scraper github 專案都是為一次性執行而設計,但真實商業場景——價格監控、庫存追蹤、競品分析——都需要定期抓取。GitHub repo 幾乎不會原生附帶排程功能,使用者只能自己拼 cron job、Airflow 或 n8n workflows。
GitHub Amazon Scraper 的 DIY 排程
最低可行的週期性設定:
- 在 Linux 或 macOS 上用 cron job 按排程執行腳本
- 使用 只追加日誌,方便之後回頭 debug 失敗原因
- 依 ASIN + 時間戳 去重,避免重複儲存資料
- 設定 失敗警示(即使只是非零 exit 時寄封 email),讓你知道任務在凌晨 3 點壞掉了
對更複雜的團隊來說:
- n8n 適合輕量 workflow 自動化(社群討論中經常被提到)
- Airflow 適合較重的排程資料管線
- 如果你需要 diff 與歷史紀錄,就要用 資料庫保存狀態
關鍵最佳做法不是排程器本身,而是 狀態管理。要追蹤上一次成功執行、最後一批 ASIN、已變動價格,以及失敗 URL。
用 Thunderbit 讓排程更簡單
Thunderbit 的 scheduled scraper 可以讓你用自然語言描述間隔、輸入 URL,然後按一下「Schedule」。AI 會把自然語言轉成 cron 排程,完全不需要技術設定。對那些要監控價格或競品新品發布、但不是工程背景的電商團隊來說,這能大幅減少營運摩擦。
週期性 Amazon 抓取的最佳做法
不管你用什麼工具,這些都適用:
- 依 ASIN + 時間窗去重——每次執行不要存同一個商品兩次
- 把價格存成數字,不要存原始字串——後續清理更省事
- 每一列都加上抓取時間戳——做趨勢分析時會用到
- 追蹤變化量,而不只是當前狀態——「價格比上週降了 12%」比「價格是 24.99 美元」更有用
- 針對有意義的變化發警示——競品降價 15% 值得通知;0.5% 波動只是雜訊
- 思考資料儲存方式——小規模可用平面檔;若每天 5k+ ASIN,建議用資料庫或雲端試算表
輸出品質逐項比較:不同 Amazon Scraper GitHub 做法實際回傳什麼
沒有人真的會把各個 amazon scraper github repo 的輸出品質拿來並排比較。使用者非常在意資料品質——「哪個工具給的資料最乾淨、最完整」——但卻只能自己 clone 每個 repo 測試。這一節就是要補上這個缺口。
熱門 GitHub Repo 實際擷取了什麼、又漏掉了什麼
根據 README 範例、公開示例與已文件化的輸出格式:
| 做法 | 明確擷取的內容 | 常見缺口/取捨 |
|---|---|---|
| amzpy | 標題、價格、幣別、圖片 URL、評分、評論、變體、ASIN | 偏向商品頁;對完整評論/規格段落較不豐富 |
| tducret/amazon-scraper-python | 含標題、評分、評論數、商品 URL、圖片 URL、ASIN 的 CSV | 停更、以列表為主、反機器人策略偏弱 |
| python-scrapy-playbook scraper | 搜尋結果、商品頁、評論、CSV/JSON pipeline | 教學等級;依賴外部 proxy middleware;通常需要更多清理 |
| omkarcloud/amazon-scraper | 搜尋、分類、詳情、熱門評論、許多圖片/影片/規格 | 不是原生 scraper,而是代管 API 服務 |
| Thunderbit Amazon template | 標題、價格、ASIN、品牌、評分、評論、庫存、出貨地、子頁面補強 | 比起自訂腳本,程式層級控制較少 |
輸出品質比較表
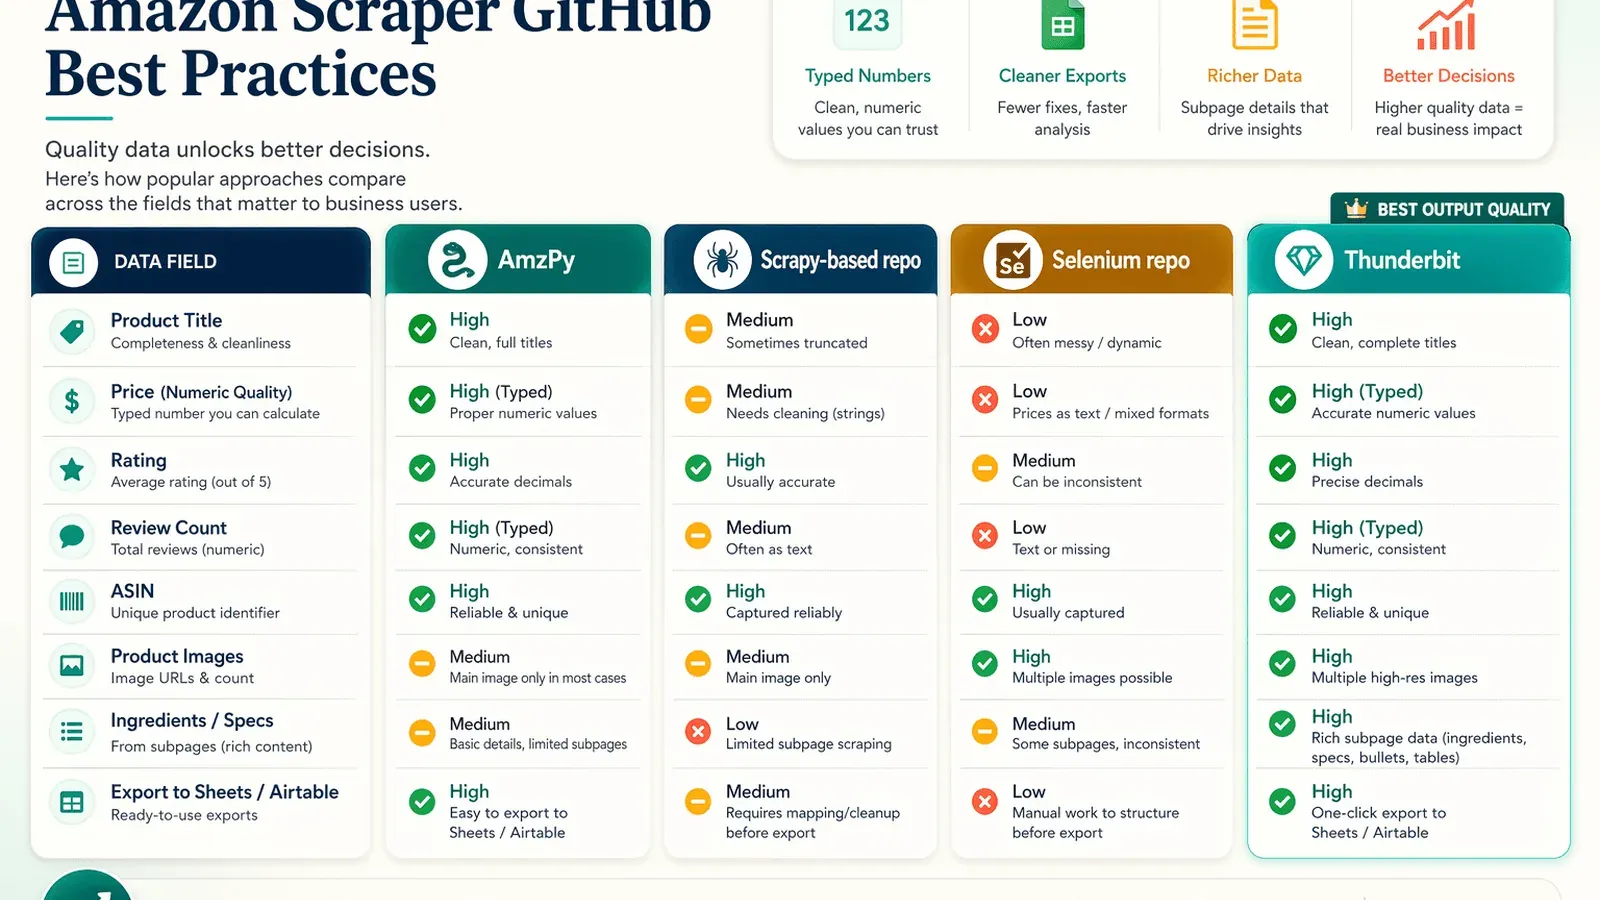
| 資料欄位 | AmzPy | 基於 Scrapy 的 repo | Selenium repo | Thunderbit |
|---|---|---|---|---|
| 商品標題 | ✅ | ✅ | ✅ | ✅ |
| 價格(數值) | ⚠️ 字串 | ✅ | ⚠️ 字串 | ✅(數字型別) |
| 評分 | ✅ | ✅ | ✅ | ✅ |
| 評論數 | ❌ | ✅ | ✅ | ✅ |
| ASIN | ✅ | ✅ | ✅ | ✅ |
| 商品圖片 | ❌ | ⚠️ 只有縮圖 | ✅ | ✅(高解析度,可匯出) |
| 成分/規格 | ❌ | ❌ | ❌ | ✅(透過子頁抓取 + AI) |
| 匯出到 Sheets/Airtable | ❌ | ❌ | ❌ | ✅ 免費 |
為什麼資料格式對商業使用者很重要
雜亂資料會製造隱形勞動。即使 scraper 成功了,如果出現以下情況,營運上還是可能失敗:
- 價格是帶貨幣符號的字串,而不是乾淨的數字
- 缺失值不一致(空字串、null、
"N/A"混用) - 圖片只有低解析度縮圖
- 評論欄位或規格要先後處理才能分析
對電商營運團隊來說,乾淨資料會直接影響分析速度與決策效率。Thunderbit 的 AI 會依資料型別格式化——數字就是數字、日期就是日期、URL 就是 URL——所以拿到手就能直接使用。GitHub repo 在這方面差異很大,而清理時間很快就會累積起來。
快速參考:Amazon Scraper GitHub 最佳做法清單
- 複製前先看最後 commit 日期。 在 Amazon 上,超過六個月沒更新就是強烈警訊。
- 安裝前先搜尋 issues,看看有沒有「captcha」、「503」、「blocked」和「not working」。
- 優先使用
curl_cffi或其他能模擬瀏覽器的 HTTP client,而不是原生requests。 - 保持 headers、TLS profile、語言和 proxy 地理位置一致——不要彼此矛盾。
- 瀏覽流程使用 sticky sessions;不要每個 request 都盲目輪換。
- 加入隨機節奏 與指數退避。
- 把重複 CAPTCHA 視為 session 已燒掉,而不是可以硬解的謎題。
- 只有在 HTTP client 無法可靠還原頁面時,才使用無頭瀏覽器。
- 儲存檢查點與狀態,讓失敗任務可以安全續跑。
- 準備備援方案——不管是代管 API,還是像 Thunderbit 這種無程式碼工具。
2026 年 Amazon 抓取的法律與倫理考量
有幾件事值得簡短了解。
Amazon 的立場偏嚴格,而且愈來愈嚴格。最明顯的訊號包括:
- Amazon 自己的說明頁現在會回傳一個 403 頁面,內容寫著:「若要討論對 Amazon 資料的自動化存取,請聯絡 api-services-support@amazon.com。」
- Amazon 的 robots.txt 禁止了大量動態頁面、評論、個人檔案、願望清單與商品列表相關路徑。
- Amazon 在 2025 年 10 月 31 日寄給 Perplexity 的 cease-and-desist 信 中,明確反對隱蔽或偽裝的代理人存取、繞過安全措施,以及將代理人偽裝成 Google Chrome。Amazon 也針對此事件 發表了公開聲明。
- Amazon 在 2025 年底還 擴大了 bot 排除規則,針對 OpenAI crawlers 加強限制。
當你從公開商品頁轉向需驗證登入的流程、偽裝自動化,或大規模商業擷取時,實際風險會明顯升高。這不是法律建議——請就你的具體情況諮詢自己的法務團隊。
重點結論:在不被封鎖的前提下取得可靠的 Amazon 資料
依重要性排序:
- 先檢查,再複製。 假設大多數 GitHub 結果都已停更、只是教學,或只是商業 API 的封裝。
- 先升級網路層。 TLS 指紋辨識和 session 一致性,比 HTML selector 更重要。
- 使用 sticky 住宅 session,不要隨機亂跳的 proxy。 在 session 之間輪換,不要在 session 內亂輪換。
- 把請求節奏做得像真人,而不是壓力測試。 隨機延遲和指數退避不可妥協。
- 單發 CAPTCHA 就解;反覆受挑戰的 session 就退休。 不要硬解一個已經燒掉的 fingerprint。
- 要有備援。 Amazon 可能在週中改個東西,你的 GitHub scraper 就會壞。像 Thunderbit 這種持續維護的無程式碼工具,或代管 API,都能在你除錯時維持資料管線運作。
- 優先重視輸出品質。 乾淨、型別正確的資料,比速度快但很髒的 scraper 更能省下後續時間。
如果你要的是可靠性,而不是客製化,Thunderbit 提供了一個有持續維護的替代方案——可以看看 Amazon Products Scraper 範本,或到 Thunderbit YouTube 頻道 看教學。想要完全控制權的開發者,當然也可以用 GitHub repo——但前提是要搭配本指南提到的反封鎖與維護做法。
常見問題
用 GitHub scraper 抓 Amazon 商品資料是否合法?
Amazon 的服務條款限制自動化資料蒐集,而且 Amazon 也積極透過 cease-and-desist 信與技術反制措施來執行這項限制(尤其是在 2025–2026 年)。抓取公開可見的商品資料屬於灰色地帶;若是在登入後抓取,或把你的 bot 偽裝成真實瀏覽器,風險會更高。這不是法律建議——請針對你的具體使用情境諮詢法務團隊。
Amazon scraper GitHub repo 多久會壞一次?
很頻繁。Amazon 會定期更改頁面版型、加入新的反機器人層,並讓某些端點失效。根據本文檢視,在八個廣為出現的 repo 中,只有大約 3 個在 2026 年明顯可正常運作。即使是「可用」的 repo,也常常有關於 CAPTCHA 和 503 錯誤的未解 issues。你應該預期每隔幾週到幾個月,就需要除錯或更新設定。
2026 年 GitHub 上最好的 Amazon scraper 是哪個?
沒有單一答案——要看你的使用情境與技術熟悉度。若你要的是輕量、直接的 Python scraper, amzpy 算是較新的選項之一。若你要透過代管 API 獲得更廣泛涵蓋範圍,omkarcloud/amazon-scraper 可以用,但它不是真正的 DIY。請先套用本文的新鮮度檢查清單,再決定是否投入任何 repo。
Thunderbit 可以不用寫程式就抓 Amazon 嗎?
可以。Thunderbit 的 Amazon Products Scraper 範本 只要一鍵,就能擷取商品標題、價格、ASIN、評分、品牌、庫存等資訊。它支援需要登入頁面的瀏覽器抓取模式、公開頁面的高速雲端抓取、週期性任務的排程抓取,以及免費匯出到 Google Sheets、Airtable、Notion 和 Excel。你可以先安裝 Thunderbit Chrome 擴充功能 開始使用。
抓 Amazon 時,怎麼避免我的 IP 被封?
請採用分層策略:(1) 從原生 requests 改用像 curl_cffi 這種能模擬 TLS 的 client,(2) 使用帶 sticky session 的住宅 proxy,而不是隨機輪換資料中心 proxy,(3) 加入隨機節奏與指數退避,(4) 讓完整 header 組合與你的瀏覽器 profile 和 marketplace 地區一致,(5) 將反覆 CAPTCHA 視為 session 該退役的訊號,而不是無限解題的謎題。更多細節可參考本文前面的反封鎖決策矩陣。




