
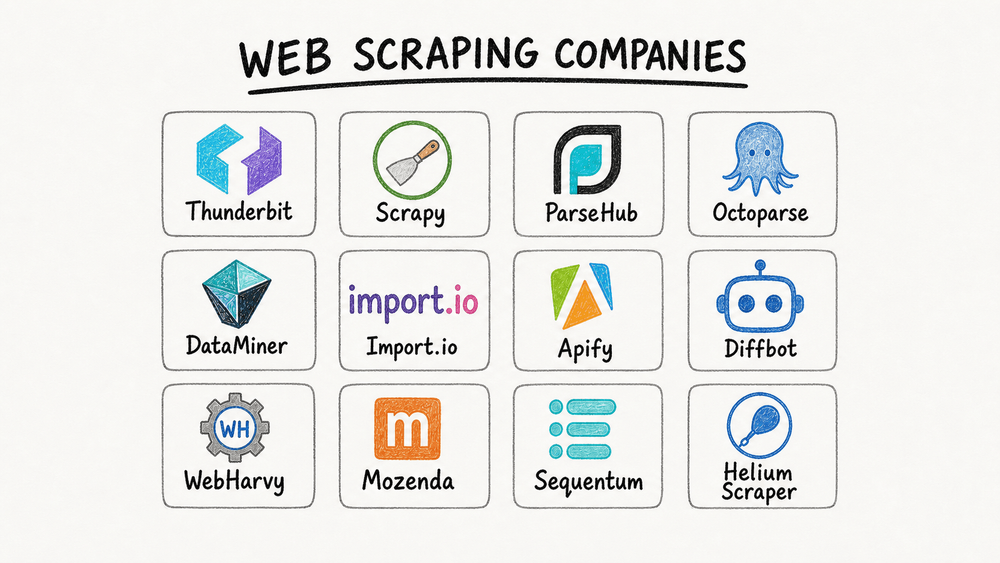
互联网的发展速度说实话已经快到有点让人跟不上了——到 2026 年,接近一半的互联网流量都来自机器人,而其中很大一部分正是企业在抓取数据,用来支持销售、运营和竞品研究。我亲眼看到网页爬虫是怎么从“可有可无的技术工具”,一步步变成销售团队、房产经纪人等各种业务人群的刚需。但问题在于:并不是所有网页爬虫公司都一样,选对了,流程会顺到飞起;选错了,可能就得面对整整一周的复制粘贴噩梦。
所以,我花了不少时间认真梳理 2026 年最值得关注的网页爬虫公司。无论你是只想两步拿到数据的非技术用户,还是想把流程完全掌控在手里的开发者,这份名单都能帮你找到最合适的选择——我也会直说,告诉你每一家到底强在哪儿、又有哪些短板。我们开始吧。
为什么企业需要头部网页爬虫公司
使用 AI 从任何网站抓取数据 Get Started Free
如果你曾经自己整理过潜在客户名单、盯过竞品价格,或者想从几十页、几百页甚至几千页里提取产品数据,你一定知道人工收集数据有多折腾。它慢、容易出错,而且说实话,没人会觉得这是件轻松愉快的事。也正因为这样,网页爬虫已经慢慢长成了一个真正的行业,企业把它用在线索获取、价格监控、市场研究和情绪分析等各种场景里。
真正的价值就在自动化。现代网页爬虫公司可以帮你:
- 自动处理重复性调研(再也不用疯狂复制粘贴)
- 轻松扩展到数千个页面,几乎不增加额外工作量
- 把数据直接接入你常用的工具(Excel、Google Sheets、Notion、CRM 等)
- 比竞争对手更快拿到更新、更丰富的数据,抢占先机
不过选择这么多,到底该怎么挑?这就是这篇指南存在的意义。
我们如何评估这些头部网页爬虫公司
并不是每个爬虫工具都适合所有人,也不一定适合所有任务。以下是我评估这些产品时主要看的维度:
- 易用性: 非技术人员能不能很快上手?界面是否直观?
- 自动化与功能: 能不能处理分页、子页面、定时任务和动态内容?
- 可扩展性: 能不能支撑大项目,还是更适合小任务?
- 集成能力: 数据导出或对接其他工具是否方便?
- 价格: 有没有免费方案?对于中小企业是否友好?能不能随着企业规模增长而扩展?
- 支持与社区: 需要时有没有教程、模板和真实可用的帮助?
我也会关注每家公司独有的亮点——因为有时候,“最好”的工具不一定是功能最多的,而是最贴合你工作流的那一个。
好了,下面进入名单。
1. Thunderbit
 Thunderbit 是我对 2026 年最期待的 AI 网页爬虫——当然不只是因为我参与了它的开发!Thunderbit 专为需要数据、而不是麻烦的商业用户打造。它的 Chrome 扩展支持用自然语言提示词和 AI 字段建议来抓取任意网站。无需代码、无需模板、没有压力。
Thunderbit 的亮点:
- 一键抓取: 只要点击“单击提取”,剩下的交给 Thunderbit 的 AI。
- 支持子页面和分页: 先抓取列表页,再让 AI 自动访问每个子页面获取更多细节。
- 即时模板: 针对 Amazon、Zillow、Shopify 等热门网站,直接使用预设模板实现一键抓取。
- 免费导出数据: 可导出到 Excel、Google Sheets、Notion 或 Airtable,自己的数据无需付费解锁。
- AI 数据增强: 在抓取过程中即可完成标签、分类和翻译。
- 定时与云端抓取: 支持设置循环任务,或直接在云端执行以提升速度。
- 完全免费额度: 可免费抓取 6 个页面,试用加成后可达 10 个;付费计划从每月 $15 起。
Thunderbit 受到全球超过20 万用户的信赖,覆盖销售团队到电商运营等多个行业。如果你想在 2026 年体验最简单、最顺手的网页爬虫,Thunderbit 几乎很难被超越。
想看看它怎么工作?下载 Chrome 扩展亲自试试吧。
2. Scrapy
 Scrapy 是开发者最常用的开源 Python 框架,适合需要完全掌控爬虫逻辑的人。它功能强大、灵活,经过大量实战验证,从小型网站到数百万页面抓取都能胜任。
适合人群: 技术团队、数据工程师,以及任何熟悉 Python 的人。
核心功能:
- 自定义规则: 可构建 spider 处理任何网站结构。
- 高扩展、高性能: 支持大规模抓取,并具备强大的错误处理能力。
- 融入 Python 生态: 可与 Pandas、Jupyter 等工具无缝衔接。
- 免费且开源: 无许可费用,社区支持也很强。
提醒: Scrapy 有一定学习门槛。如果你不会写代码,可能更适合看看别的工具。但对开发者来说,它就是强力选手(ScraperAPI)。
3. ParseHub
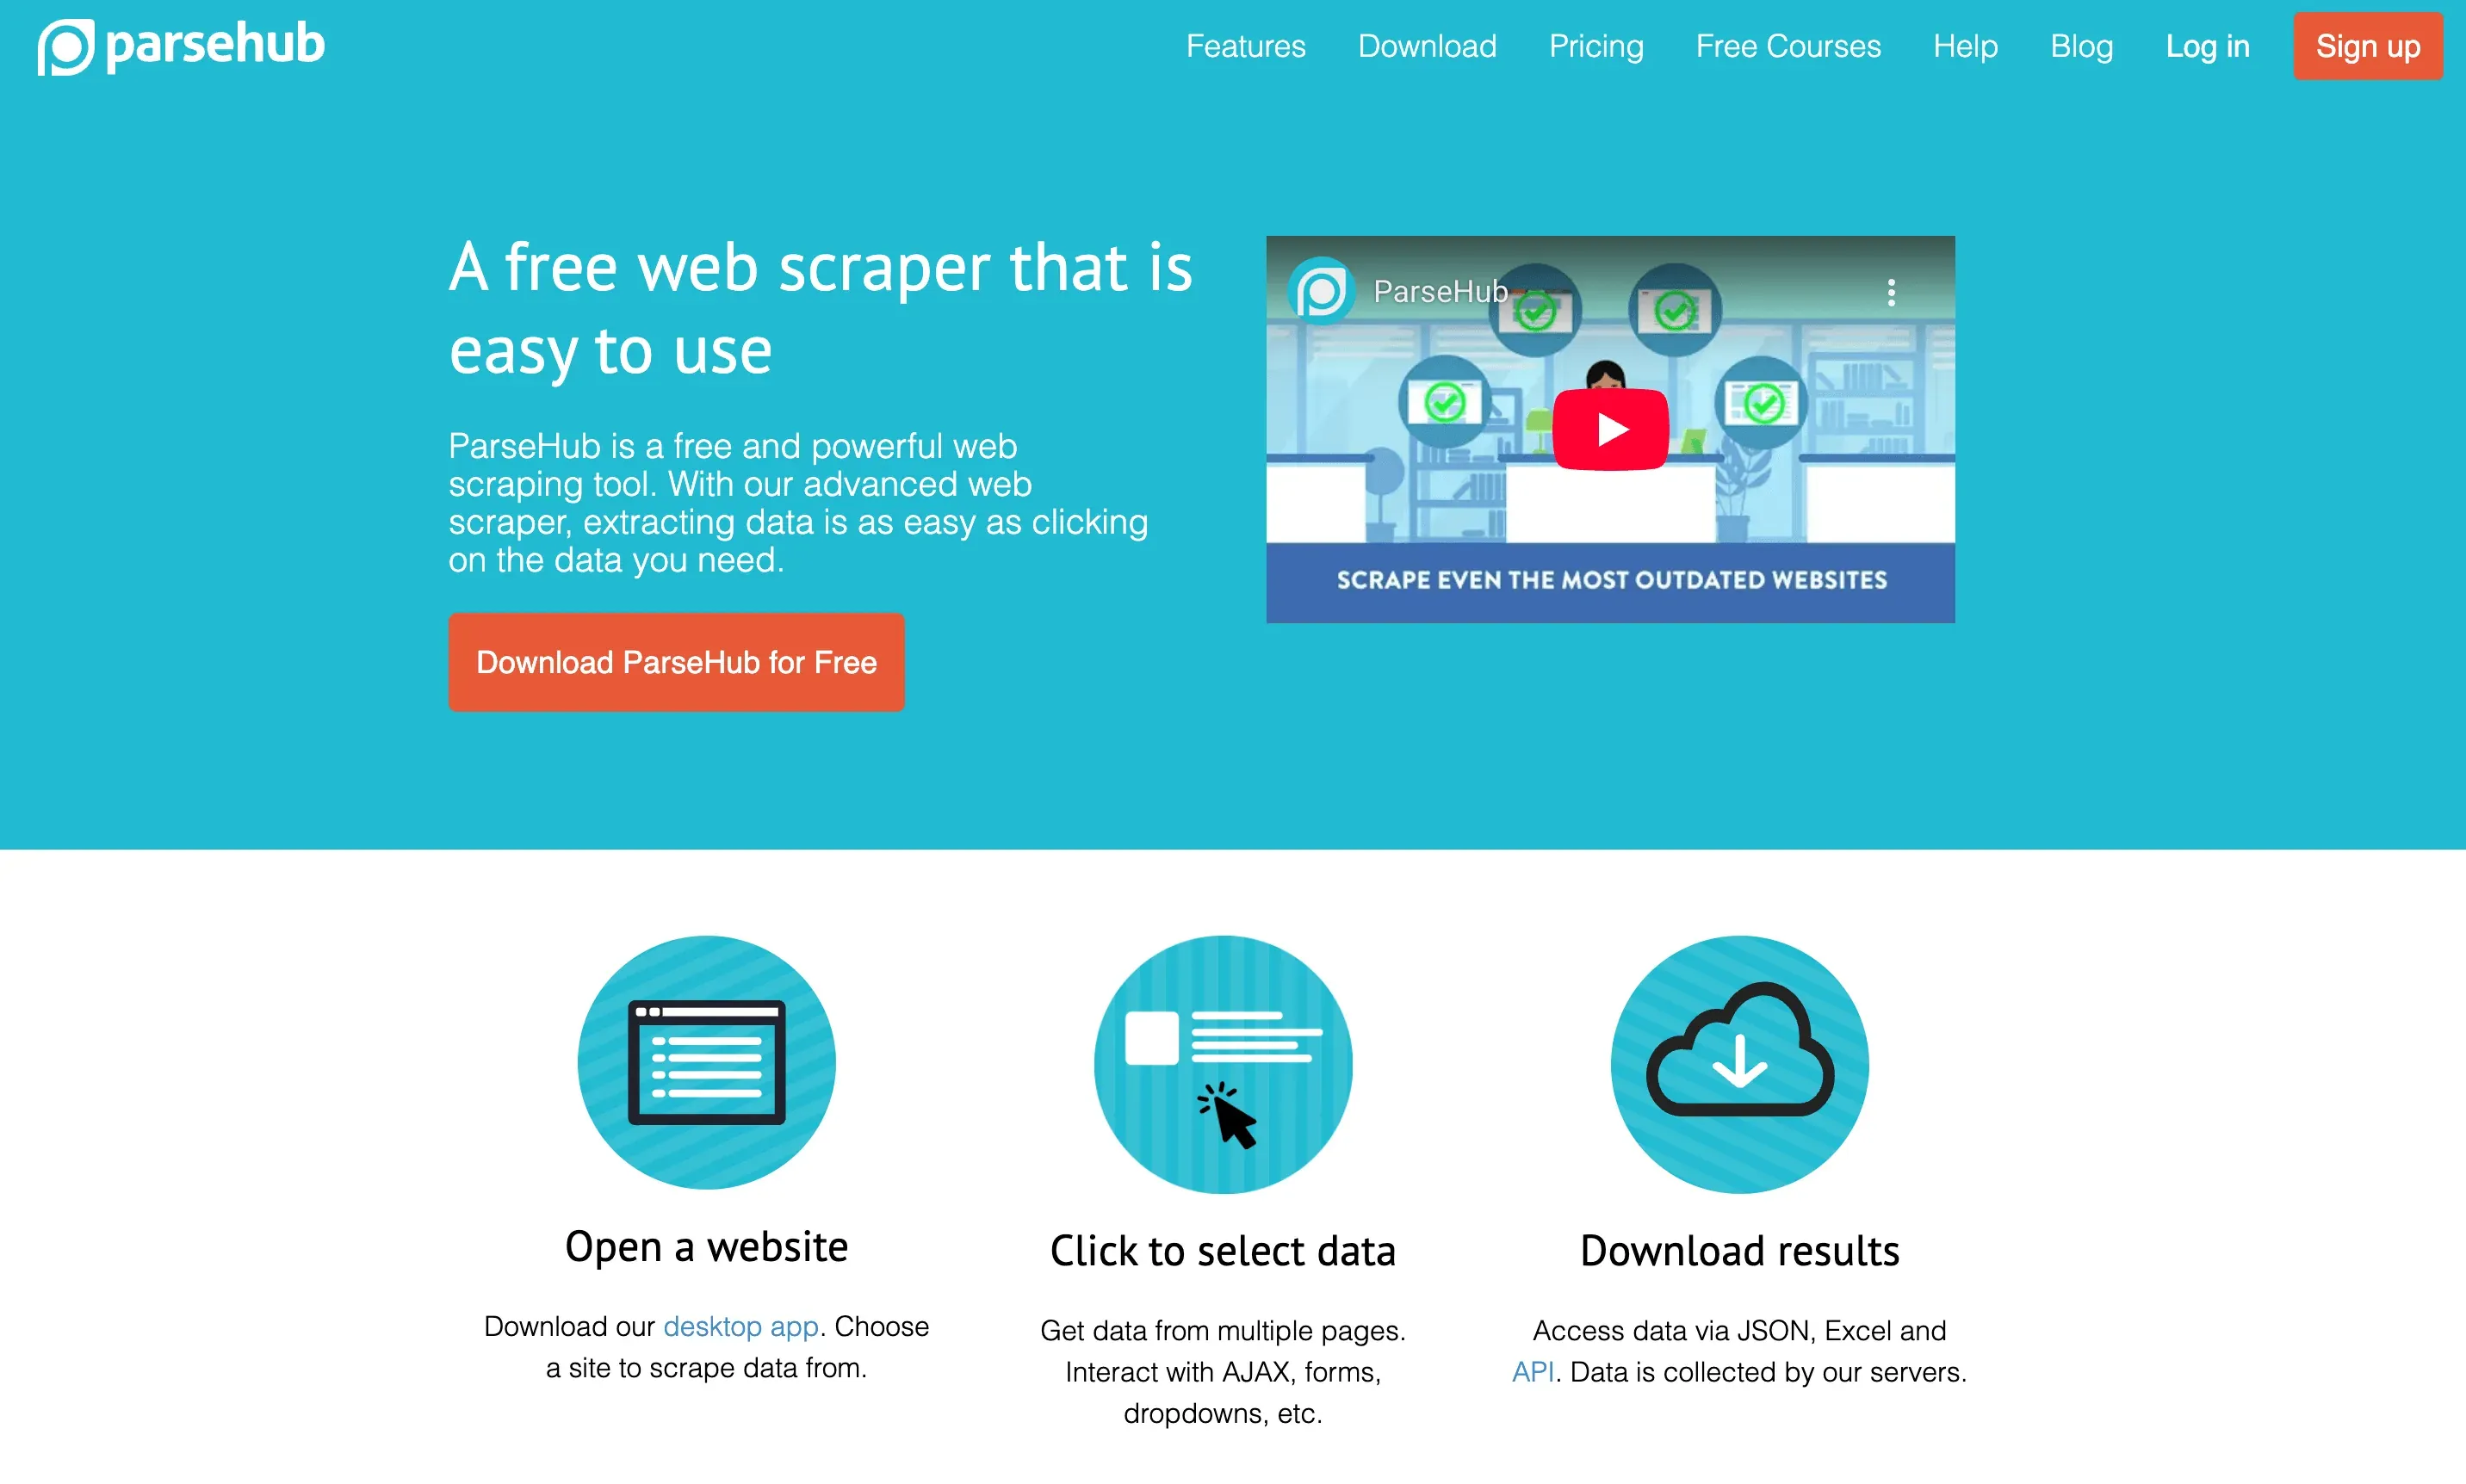 ParseHub 是一款桌面应用,把网页爬虫做得更直观、更容易上手。它的点选式界面让你无需写代码就能搭建爬虫。
适合人群: 中小企业、研究人员,以及希望保留一定灵活度的非技术用户。
核心功能:
- 可视化流程: 通过点击选择数据,并构建分页和子页面逻辑。
- 云端定时: 即使电脑关机,也能按计划自动运行。
- 导出选项: 可下载为 CSV、Excel 或 JSON。
- 免费方案: 5 个项目、每次最多 200 页;付费计划从每月 $189 起。
ParseHub 尤其适合抓取列表页、评论和电商数据(ScraperAPI)。
4. Octoparse
 Octoparse 是一款无需代码、支持拖拽操作的网页爬虫平台,重点强调大规模自动化。对于想搭建复杂任务、但又不想写脚本的团队来说,它非常合适。
适合人群: 市场、研究和运营团队。
核心功能:
- 拖拽式流程: 可视化构建爬虫,支持动态内容和无限滚动。
- 云端抓取与定时: 云端执行任务,支持周期性调度。
- IP 轮换与反封锁: 内置应对高难度网站的能力。
- 导出到 Excel、Sheets、数据库: 便于接入现有工作流。
- 免费额度: 每月最多 10,000 条记录;付费计划从每月 $83 起,按年付费为每月 $69。
Octoparse 尤其因速度快、能处理大型项目而受到重视(ScraperAPI)。
5. DataMiner
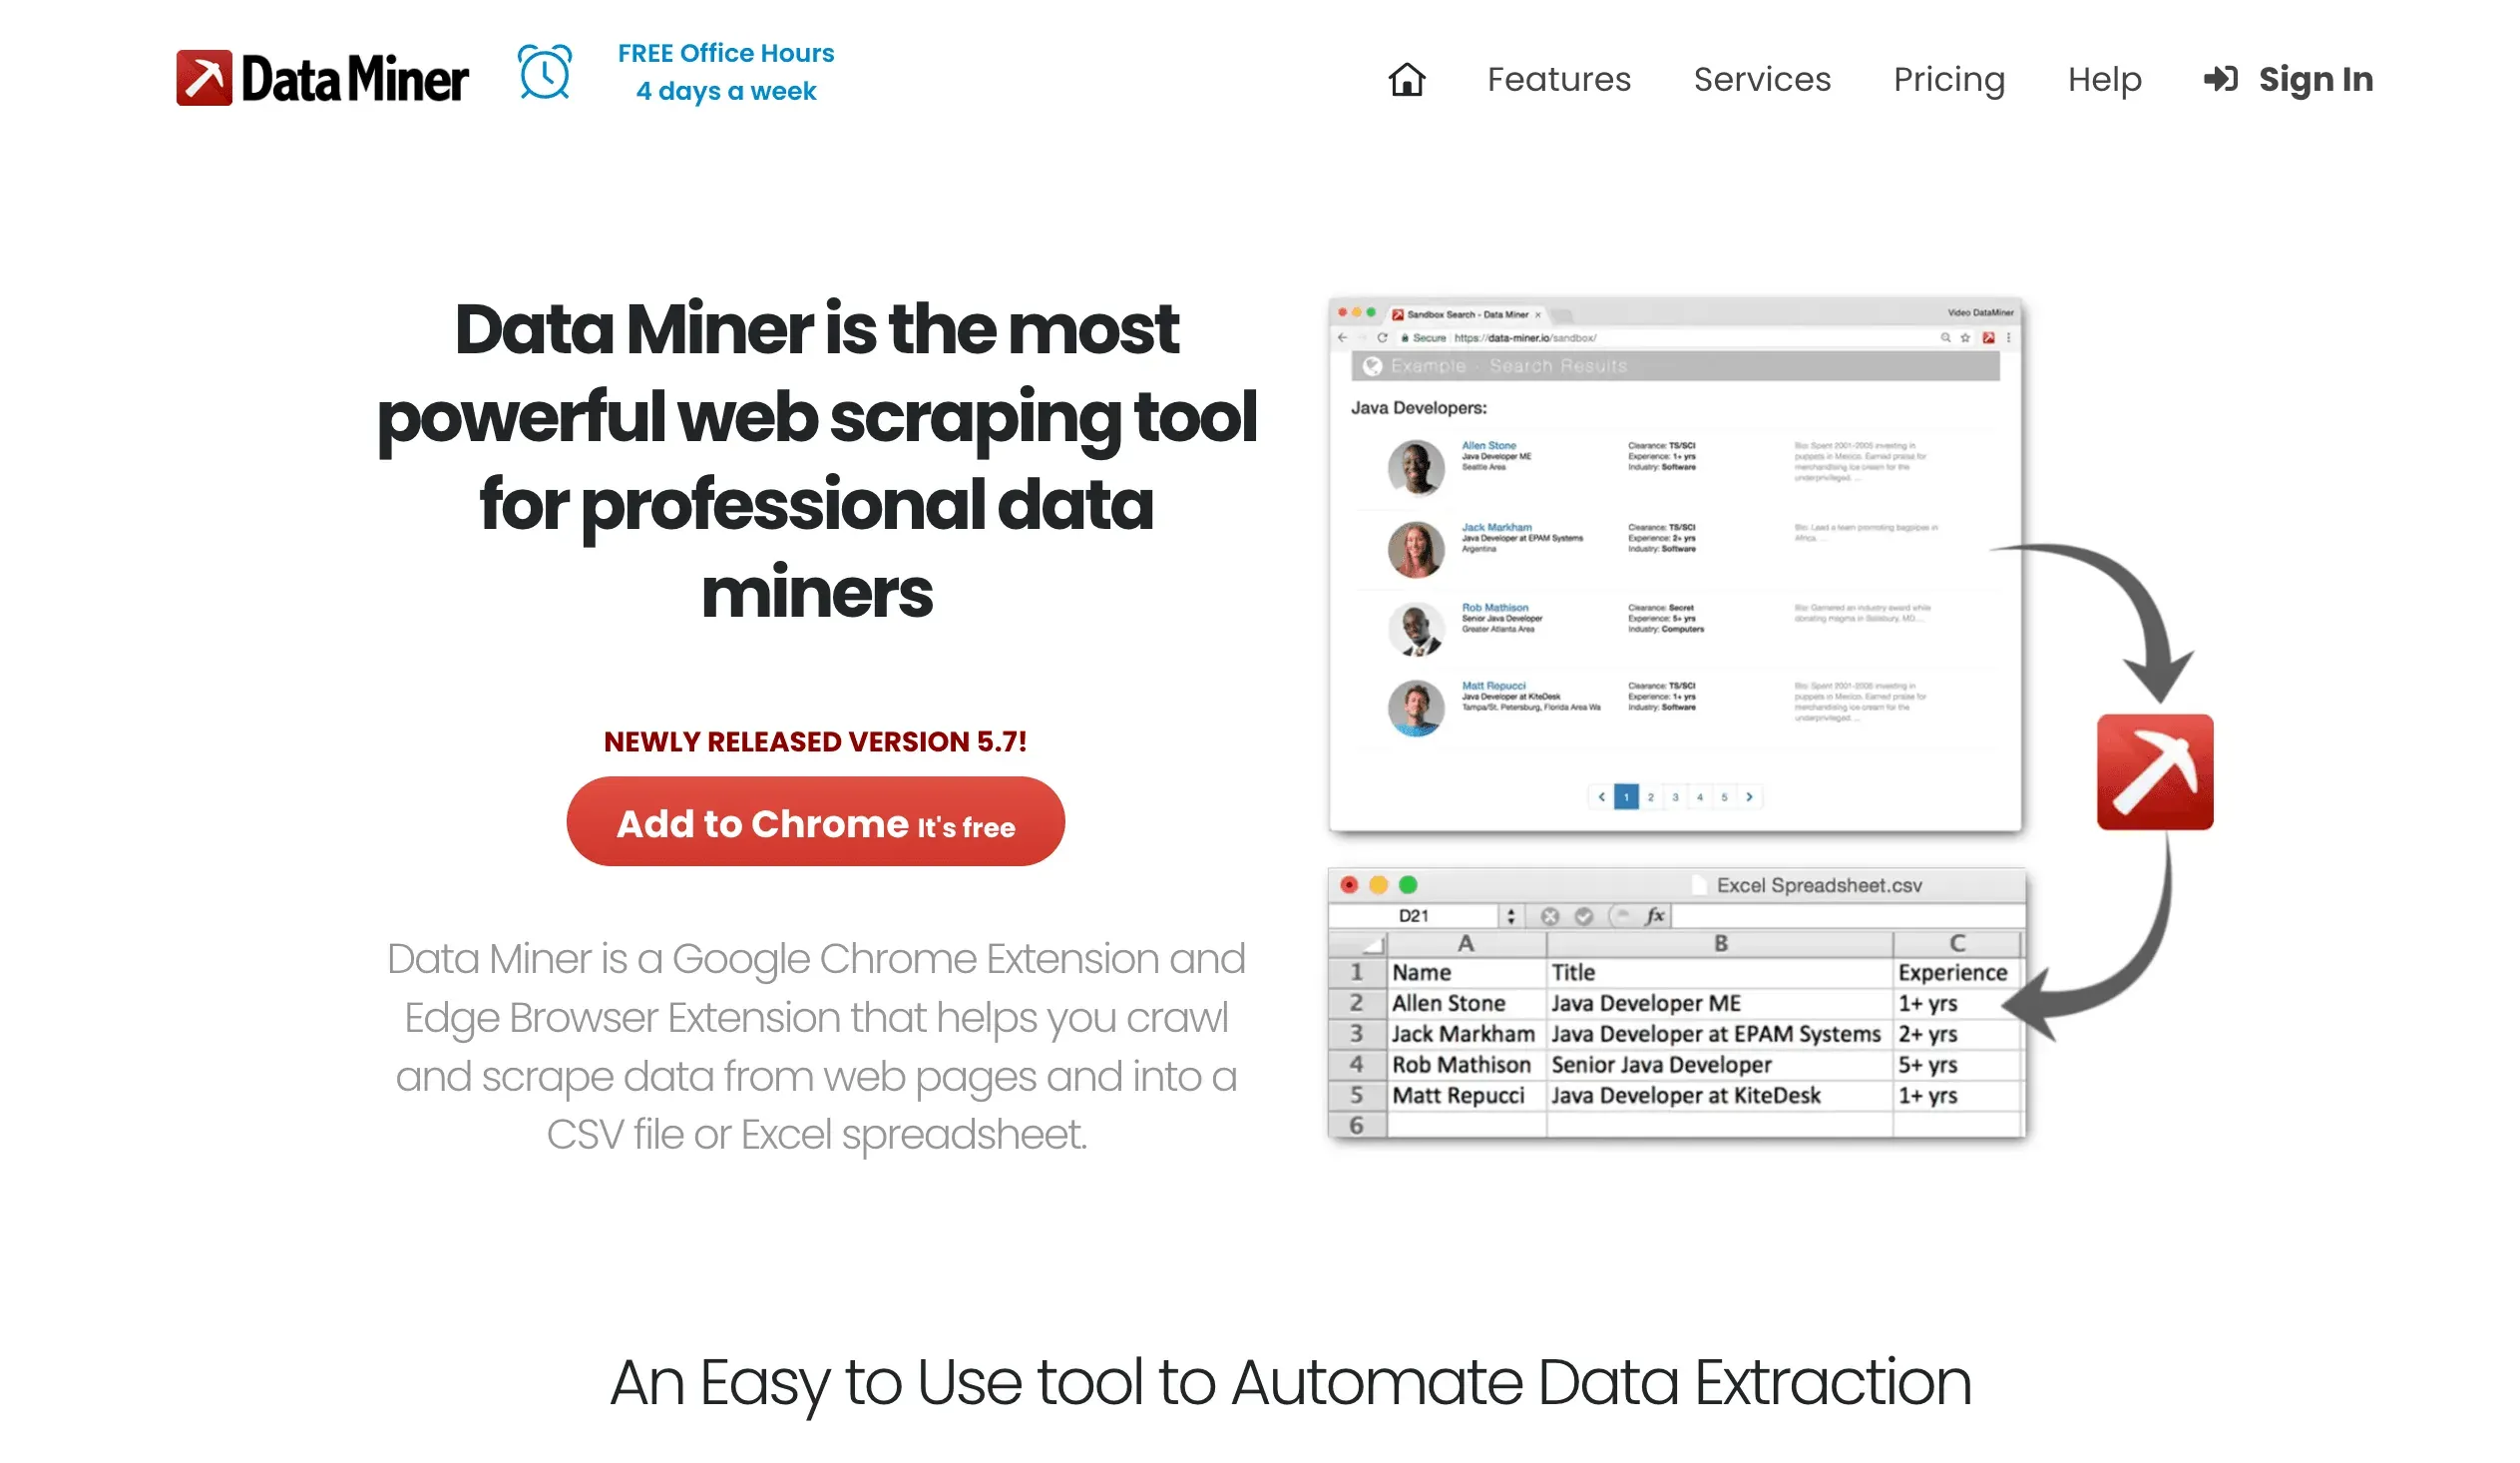 DataMiner 是一款 Chrome 扩展,把网页爬虫直接带进浏览器。它特别适合快速、基于模板的表格、列表和简单网站抓取。
适合人群: 日常用户、销售运营,以及所有长期使用 Chrome 的人。
核心功能:
- 模板市场: 提供 60,000+ 个热门网站的预设方案。
- 点选式提取: 通过可视化方式选择数据,无需代码。
- 导出到 Excel/Google Sheets: 一键导出。
- 免费方案: 每月 500 页;付费计划从每月 $19 起。
DataMiner 很适合快速任务,也很受非技术用户欢迎(DataMiner)。
6. Import.io
 Import.io 是一个企业级平台,专注于把网页内容转化为结构化数据,用于分析和商业智能。
适合人群: 数据需求大、集成要求高的大型企业。
核心功能:
- 托管服务模式: 由 Import.io 团队代为构建和维护爬虫。
- 可视化界面: 无需代码即可搭建提取流程。
- API 访问: 抓取数据可直接接入应用和仪表盘。
- 合规与安全: 企业级控制、PII 脱敏等能力。
价格: 定制报价,通常从每月约 $199 起(PromptCloud)。
7. Apify
 Apify 是一款对开发者很友好的自动化平台,拥有庞大的预构建 “Actors”(爬虫机器人)市场,同时也支持自定义工作流。
适合人群: 开发者、代理商,以及需要灵活性的团队。
核心功能:
- Actor 市场: 可直接使用热门网站的现成爬虫,也能自己构建。
- 云端基础设施: 支持大规模运行、任务调度和 API 集成。
- GitHub 集成: 便于自动化工作流和 CI/CD。
- 按量付费: 提供免费额度,之后按使用量计费;付费计划从每月 $29 起。
Apify 既适合简单项目,也适合复杂项目(Black Bear Media)。
8. Diffbot
 Diffbot 使用 AI 和知识图谱,将非结构化网页内容转换成结构化、机器可读的数据。你可以把它理解为网页爬虫领域的“智能大脑”。
适合人群: 企业、研究人员,以及需要大规模自动化提取的人。
核心功能:
- AI 驱动提取: 自动识别文章、产品、组织等内容类型。
- 知识图谱: 可通过 API 访问全球最大的网页数据图谱。
- 数据增强: 拉取相关实体、新闻和上下文信息。
- API 优先: 便于接入 BI 工具和数据管道。
价格: 从每月 $299 起(Diffbot Pricing)。
9. WebHarvy
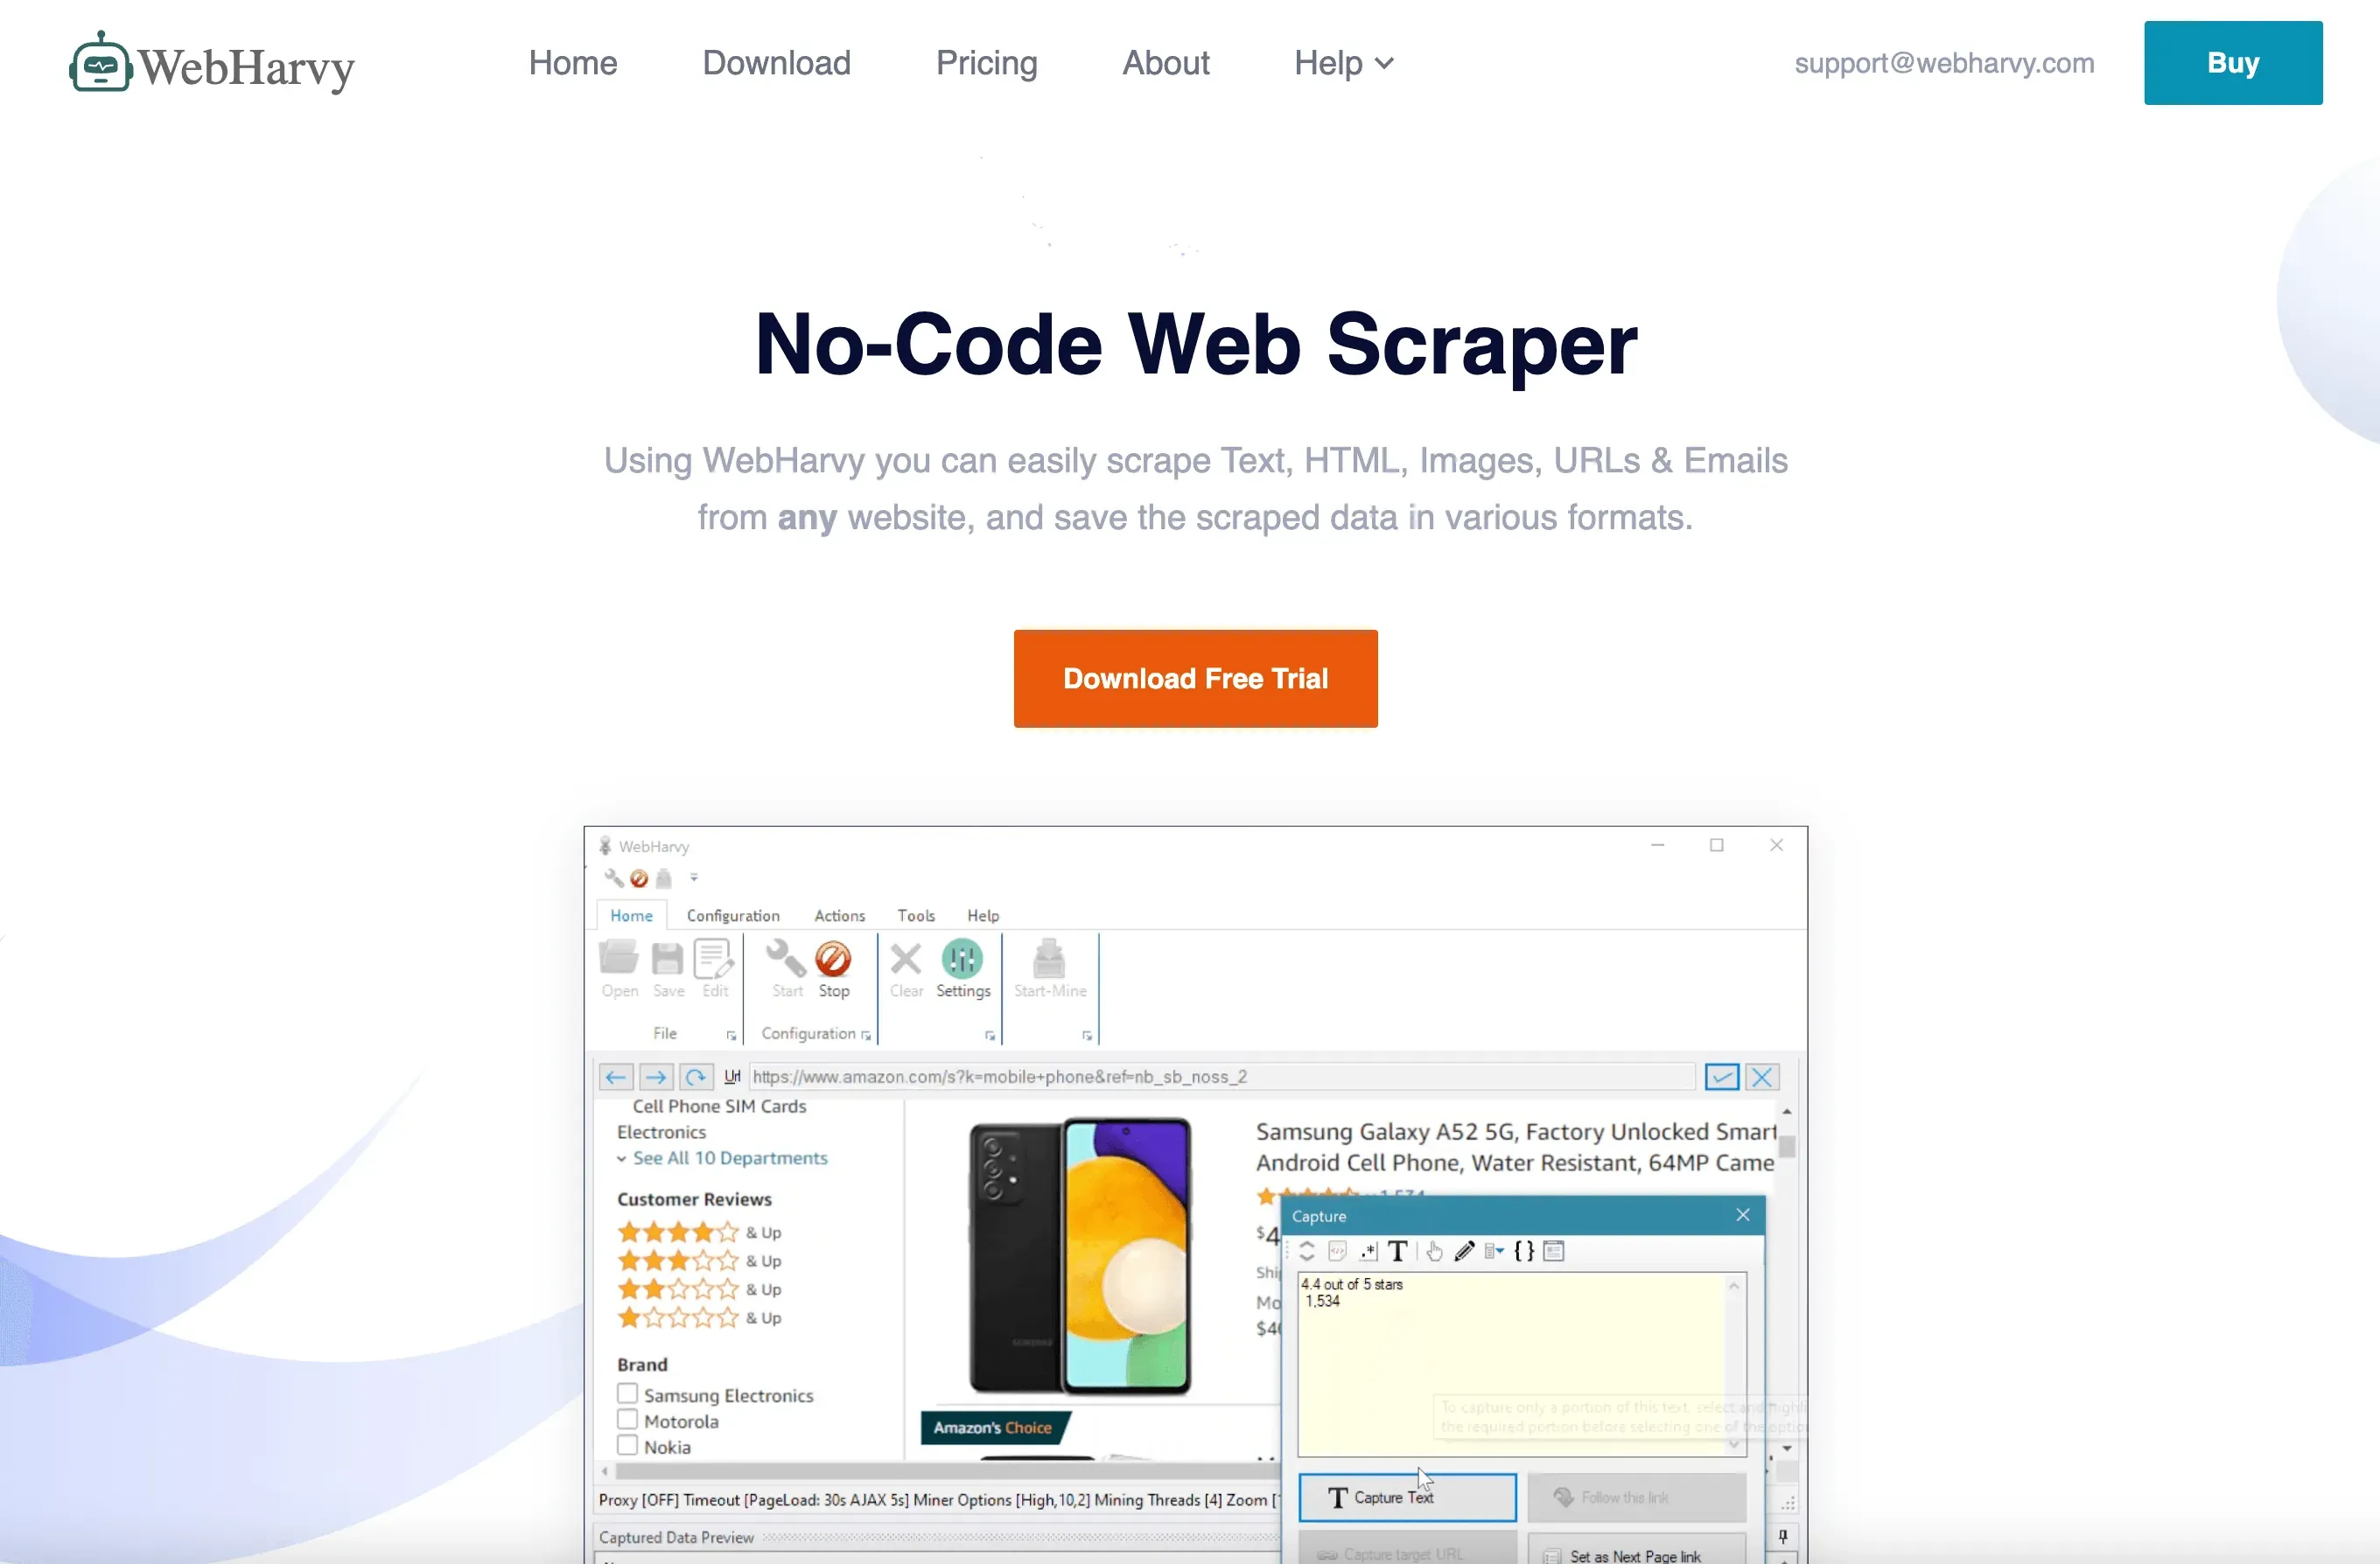 WebHarvy 是一款基于 Windows 的桌面爬虫,提供可视化点选界面。对不想写代码、又更喜欢桌面应用的用户来说,它非常合适。
适合人群: Windows 用户、研究人员和中小企业。
核心功能:
- 可视化选择: 直接点击数据定义字段,无需代码。
- 支持图片和多页跳转: 可抓取文本、图片,并自动翻页。
- 导出到 Excel、XML、数据库: 输出格式灵活。
- 一次性授权: 一次付费,永久使用(WebHarvy)。
WebHarvy 在电商和分类信息网站抓取场景中特别受欢迎(Thunderbit Blog)。
10. Mozenda
 Mozenda 是一款基于云的企业级数据提取与自动化平台。
适合人群: 大型组织、合规要求高的行业。
核心功能:
- 云端自动化: 统一调度、监控和管理抓取任务。
- 数据转换: 清洗、增强并导出多种格式的数据。
- 团队协作: 支持多人协同与工作流管理。
- 企业支持: 提供合规性、稳定性和专属支持(Appvizer)。
价格: 大约每月 $99 起;也提供企业定价。
11. Sequentum(原 Content Grabber)
 Sequentum 是面向数据专业人士和代理商的高级桌面/网页爬虫。如果你以前知道它叫 Content Grabber,那现在这个名字已经没有了——Sequentum 已经重命名该产品,而且 contentgrabber.com 目前也无法访问(Sequentum FAQ)。
适合人群: 数据专家、代理商,以及需要深度自动化的人。
核心功能:
- 高级脚本: 可自动处理复杂提取逻辑。
- 报告与监控: 跟踪任务、设置提醒、管理大型项目。
- 集成能力: 可导出到数据库、API 或云存储。
- 无免费方案: 仅提供付费许可(DataOX)。
Sequentum 专为高容量、可定制的提取任务而设计。
12. Helium Scraper
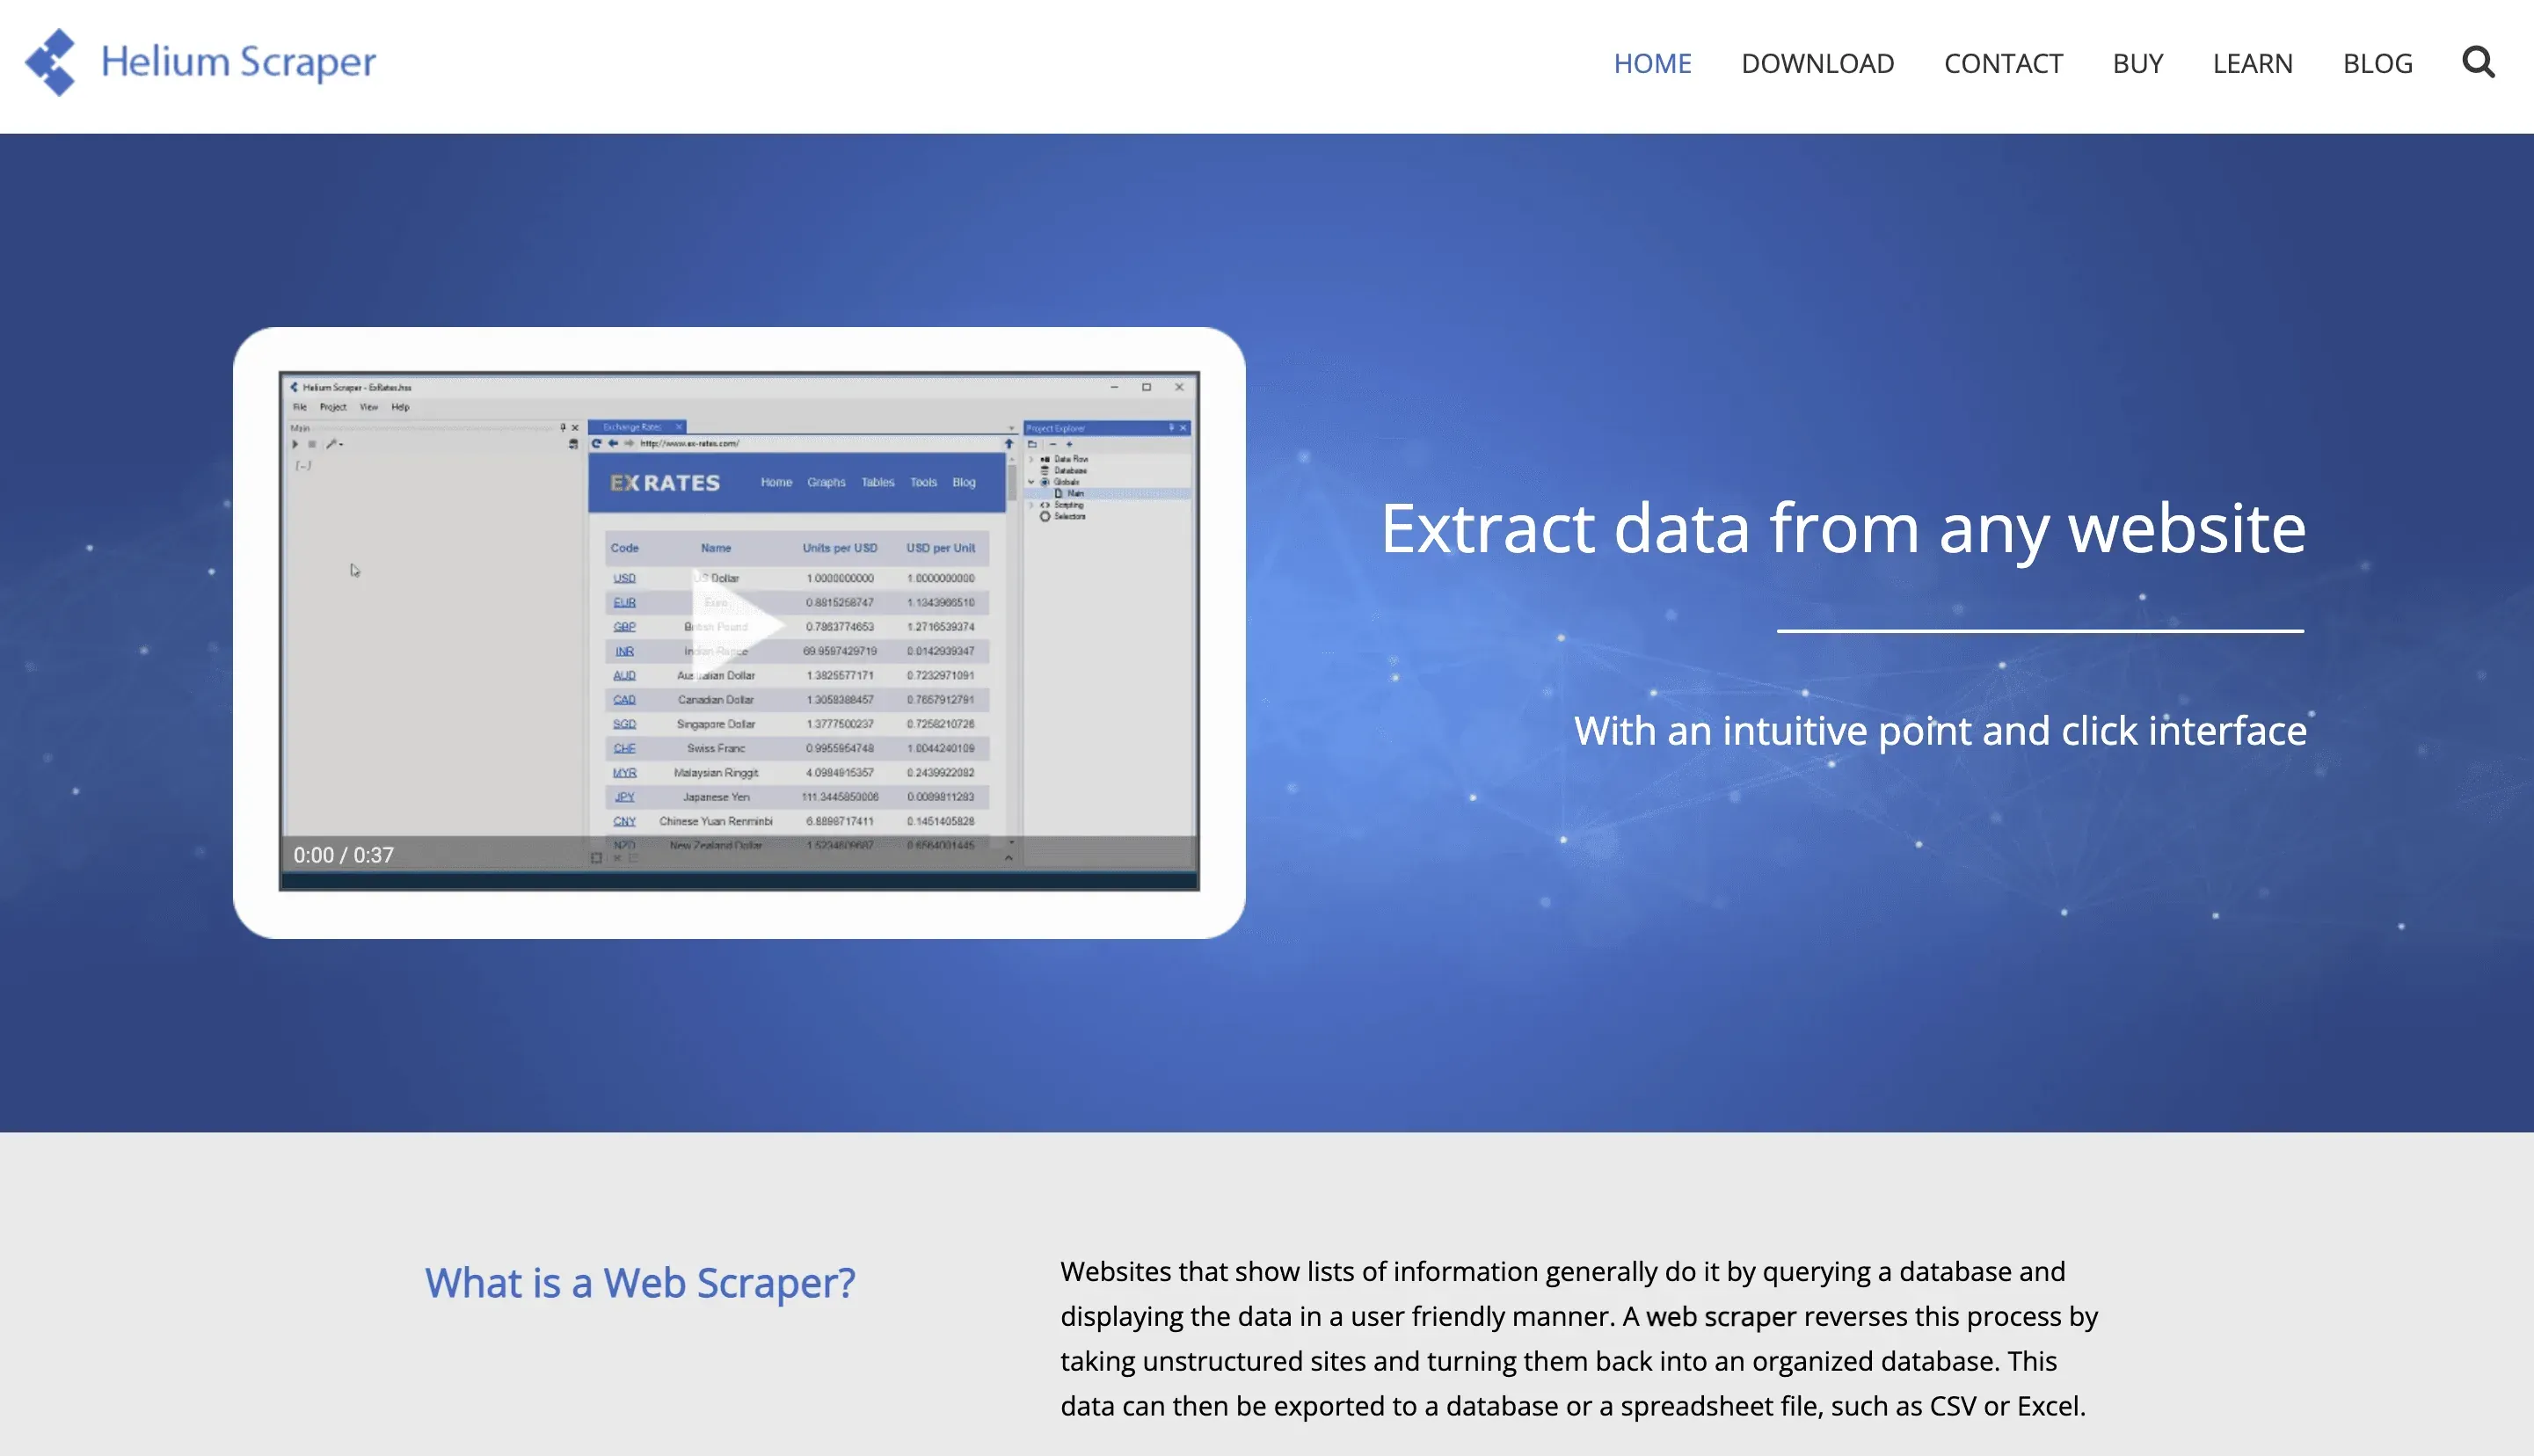 Helium Scraper 是一款桌面工具,配有可视化工作流构建器,非常适合从复杂、动态网站中提取数据。
适合人群: 重度用户、分析师,以及希望灵活但不想写代码的人。
核心功能:
- 可视化工作流: 用拖拽方式搭建提取逻辑。
- 支持动态内容: 可处理大量 JavaScript 渲染的网站。
- 数据转换: 导出前可先清洗和整理数据。
- 导出选项: 支持 Excel、CSV、数据库等多种格式。
- 一次性付费: 永久授权从 $99(基础版,1 用户)到 $699(企业版,10 用户)不等,无订阅制(Helium Scraper)。
Helium Scraper 尤其适合非标准网站和自定义工作流。
对比头部网页爬虫公司:功能一览
下面这张快速对比表可以帮你更容易选出适合自己的工具:
| 公司 | 适合人群 | 易用性 | 自动化与 AI | 可扩展性 | 导出选项 | 免费方案 / 价格 |
|---|---|---|---|---|---|---|
| Thunderbit | 非技术用户、中小企业 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | Excel、Sheets、Notion | 免费(6 页),$15/月起 |
| Scrapy | 开发者 | ⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | Python、CSV、DB | 免费,开源 |
| ParseHub | 中小企业、研究人员 | ⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐ | CSV、Excel、JSON | 免费(5 个项目),$189 起 |
| Octoparse | 运营、市场团队 | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | Excel、DB、API | 免费(1 万行),$69 起 |
| DataMiner | Chrome 用户 | ⭐⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐ | Excel、Sheets | 免费(500 页),$19 起 |
| Import.io | 企业 | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | API、DB、Cloud | 定制报价,$199+/月 |
| Apify | 开发者、代理商 | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | API、DB、Sheets | 免费额度,$29+/月 |
| Diffbot | 研究、分析 | ⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | API、知识图谱 | $299+/月 |
| WebHarvy | Windows 用户 | ⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐ | Excel、XML、DB | 一次性付费,$129 起 |
| Mozenda | 企业 | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | Excel、API、Cloud | $99+/月,企业版另计 |
| Sequentum | 数据专家、代理商 | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | DB、API、Cloud | 仅付费许可 |
| Helium Scraper | 重度用户、分析师 | ⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐ | Excel、CSV、DB | 一次性付费,$99 起 |
快速推荐:
- 非技术用户: Thunderbit、DataMiner、ParseHub、WebHarvy
- 开发者: Scrapy、Apify、Sequentum
- 企业: Import.io、Diffbot、Mozenda
- 需要灵活可视化流程: Thunderbit、Octoparse、Helium Scraper
结论:如何为你的业务选择合适的网页爬虫合作伙伴
探索更多网页爬虫指南 Get Started Free
到了 2026 年,网页爬虫早就不只是技术人员的工具了——它已经变成任何需要数据来更快、更聪明做决策的企业核心能力。选对网页爬虫公司,能帮你省下大量时间,提高投资回报率,还能挖出竞争对手可能忽略的洞察。
我的建议是:
- 工具要匹配团队: 非技术用户会喜欢 Thunderbit 或 DataMiner。开发者可以看看 Scrapy 或 Apify。企业用户则建议关注 Import.io 或 Diffbot。
- 考虑规模和集成: 你是否需要抓取数千个页面?是否希望数据直接进入 Sheets、Notion 或 CRM?
- 先试免费版: 大多数工具都有免费额度,先用真实项目测试,再决定是否投入。
- 别怕组合使用: 有时候,最好的工作流本来就需要两三款工具配合。
如果你已经准备好体验网页爬虫到底能有多简单,不妨试试 Thunderbit。你的表格和你的心态都会感谢你。
想看更多深度内容、技巧和教程,请访问 Thunderbit Blog。
常见问题
1. 什么是网页爬虫,为什么它在 2026 年对企业很重要?
网页爬虫是自动从网站中提取数据的过程。它之所以重要,是因为它能帮助企业快速、大规模地收集数据,用于线索获取、价格监控、市场研究等场景,从而节省时间并提升决策质量。
2. 哪家网页爬虫公司最适合非技术用户?
Thunderbit 和 DataMiner 是非程序员的热门选择,因为它们分别提供 AI 驱动和可视化界面。两者都能让你只用几次点击就完成数据提取,无需编写代码。
3. 选择网页爬虫公司时应该关注哪些功能?
重点看易用性、自动化能力(分页、子页面、定时)、可扩展性、导出选项(Excel、Sheets、API)以及客户支持。最好选择与自身技术能力和业务需求匹配的工具。
4. 有免费的网页爬虫方案吗?
有!Thunderbit、DataMiner、ParseHub 和 Octoparse 都提供免费额度。Scrapy 作为开源工具,对开发者来说也是免费的。免费方案很适合小项目,或者在扩展前先测试。
5. 抓取数据时如何保持合规和合乎伦理?
务必遵守网站服务条款和隐私政策,只抓取公开可访问的数据,避免对网站造成过大压力,并注意 GDPR 等数据隐私法规。许多头部网页爬虫公司也会提供合规功能和最佳实践指南。
准备好更聪明地开始抓取了吗?免费试用 Thunderbit 或前往 Thunderbit Blog 浏览更多指南。
试用 AI 网页爬虫 Get Started Free
了解更多



