Trình Scraper Wikipedia cho Hộp Thông Tin, Trích Dẫn và Mục Nội Dung













Sắp xếp Bài Viết Wikipedia cho Mục Đích Nghiên Cứu
Giữ riêng thông tin bài viết, giá trị hộp thông tin, trích dẫn và ngữ cảnh của từng mục trong các trường riêng biệt.
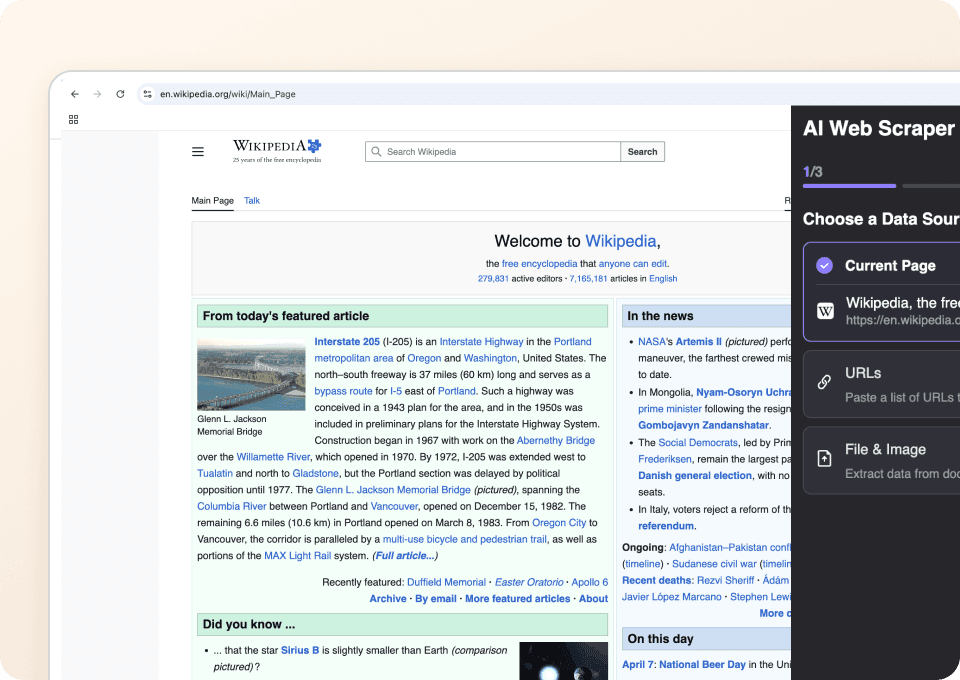
Trích Xuất Dữ Liệu Wikipedia Chỉ Với Một Cú Nhấp
Nó sẽ đề xuất các cột cho trang bạn đang mở và hoàn tất việc thu thập chỉ trong một lần chạy. Bạn có thể chỉnh sửa hoặc đổi tên trường bằng ngôn ngữ tự nhiên, rồi chạy lại nếu muốn.
Hoạt Động Trên Nhiều Loại Trang Wikipedia Khác Nhau
Tác nhân đọc các nhãn, tiêu đề và tên mục đang hiển thị để ánh xạ các giá trị trên trang bạn có thể truy cập. Nếu một trường không tồn tại, cột đó sẽ để trống.
Xuất Dữ Liệu Wikipedia Trực Tiếp
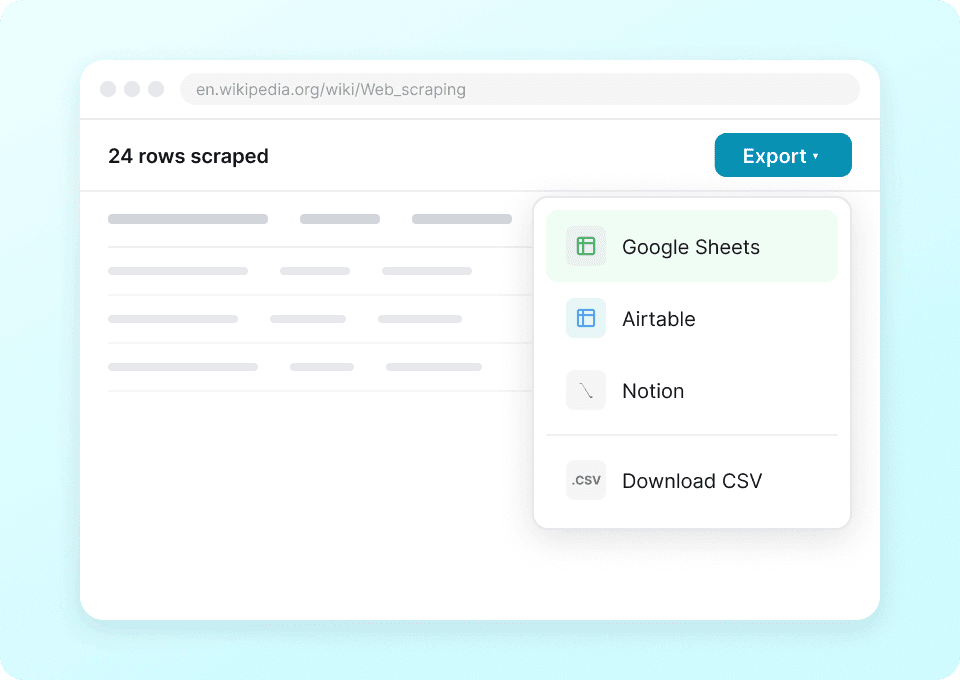
Tiếp tục nghiên cứu trong Google Sheets, Excel, Airtable, Notion hoặc tải xuống dưới dạng CSV.
Thu Thập Dữ Liệu Nghiên Cứu Wikipedia Mà Không Cần Tự Xây Scraper
Giảm công sức duy trì bộ chọn cho nghiên cứu Wikipedia.
Thiết lập thủ công hoặc dựa trên bộ chọn
Tốn thời gian để duy trì quy tắcTác nhân AI của Thunderbit
Gợi ý trường và chỉ cần chạy một lầnCác cột cho thông tin bài viết, hộp thông tin, trích dẫn và các mục nội dung
Các cột chỉ xuất hiện khi chúng được hiển thị trên trang mà bạn có thể truy cập.
- page_title
- page_url
- lead_paragraph
- first_sentence
- infobox_image_url
- infobox_image_caption
- birth_name
- birth_date
- death_date
- birth_place
- death_place
- nationality
- occupation
- years_active
- employer
- alma_mater
- spouse
- children
- website
- notable_works
- latitude
- longitude
- categories
- reference_titles
- reference_links
- external_links
- article_sections
- table_of_contents
- hatnotes
- page_last_edited_date
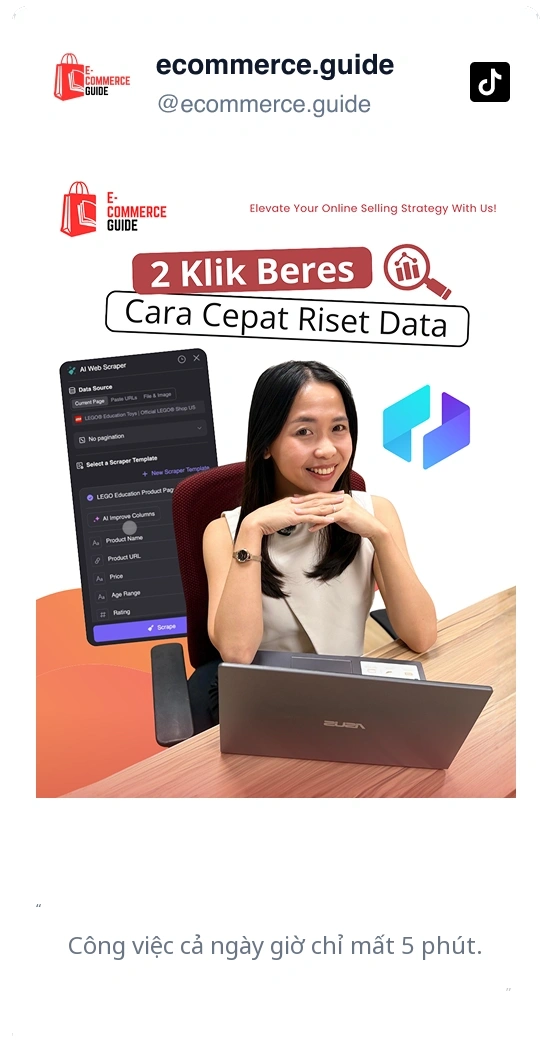
See researchers capture structured facts from open pages
In user-recorded videos, researchers pick page facts, check the rows, and move the result into their own tools.


Câu hỏi về các lần thu thập nghiên cứu Wikipedia
Trả lời ngắn gọn cho Agent Mode trên Wikipedia.
When your research spans Wikimedia projects
Pair Wikipedia articles with Wikidata items, Commons groups, or media pages.
Framer Scraper
Framer Scraper của Thunderbit giúp bạn trích xuất danh sách template và các ví dụ trong Framer Showcase bằng AI. Bạn có thể thu thập dữ liệu theo từng danh mục như template Portfolio, sau đó truy cập từng trang template hoặc trang con của Showcase để lấy thêm chi tiết như tiêu đề, thẻ (tags), liên kết xem trước và metadata. Kết quả có thể xuất sang Excel, Google Sheets, Airtable hoặc Notion chỉ với vài cú nhấp.
Tìm hiểu thêm ->
Trình thu thập dữ liệu WordPress.org
Trình thu thập dữ liệu WordPress.org của Thunderbit giúp bạn trích xuất dữ liệu có cấu trúc từ thư mục plugin WordPress và thư viện block pattern bằng AI. Bạn có thể thu thập từ các trang danh sách và làm giàu kết quả bằng thông tin ở trang chi tiết như thống kê plugin, phiên bản, đánh giá và metadata của pattern, sau đó xuất sang Excel, Google Sheets, Airtable hoặc Notion.
Tìm hiểu thêm ->
Capterra 爬虫
Chỉ với 2 cú nhấp chuột, trích xuất tên phần mềm, đánh giá và mô hình giá từ Capterra — rồi xuất thẳng sang Excel, Google Sheets hoặc Notion. Không cần biết lập trình.
Tìm hiểu thêm ->
CoinMarketCap scraper
Trích xuất dữ liệu crypto — giá, vốn hóa thị trường và khối lượng giao dịch 24 giờ — từ CoinMarketCap chỉ với 2 cú nhấp. Mở bất kỳ trang nào, để AI tự nhận diện các trường dữ liệu, rồi xuất thẳng sang Excel, Google Sheets hoặc Notion.
Tìm hiểu thêm ->
GoDaddy Scraper
Chỉ cần trỏ vào bất kỳ tên miền, trạng thái còn trống hay mức giá nào trên GoDaddy — AI của Thunderbit sẽ lấy dữ liệu chỉ trong 2 cú nhấp và xuất ngay sang Excel, Google Sheets hoặc Notion.
Tìm hiểu thêm ->
Goodreads scraper
Chỉ với 2 cú nhấp chuột, trích xuất tiêu đề sách, tên tác giả, điểm đánh giá và số lượng review từ Goodreads — rồi xuất dữ liệu sang Excel, Google Sheets hoặc Notion, sẵn sàng để phân tích.
Tìm hiểu thêm ->Sẵn sàng tăng tốc trích xuất dữ liệu của bạn chưa?
Gia nhập hơn 200.000+ chuyên gia đã dùng Thunderbit để tự động hóa quy trình web scraping.
Dùng thử miễn phí cung cấp credit không giới hạn cho 8 trang web.


