TechCrunch scraper













Mở khóa dữ liệu TechCrunch chỉ với hai cú nhấp
Scrape TechCrunch đơn giản trong hai cú nhấp
Việc sao chép thủ công tiêu đề bài viết, tác giả, ngày đăng hoặc toàn bộ nội dung từ TechCrunch rất mất thời gian. Thunderbit giúp bạn bỏ qua hoàn toàn công việc thủ công. Chỉ cần chọn vào dữ liệu bạn cần, AI sẽ tự xử lý phần còn lại. Hai cú nhấp là bạn đã có thể trích xuất dữ liệu có cấu trúc mà không cần viết dù chỉ một dòng code hay lo lắng về cấu hình phức tạp.
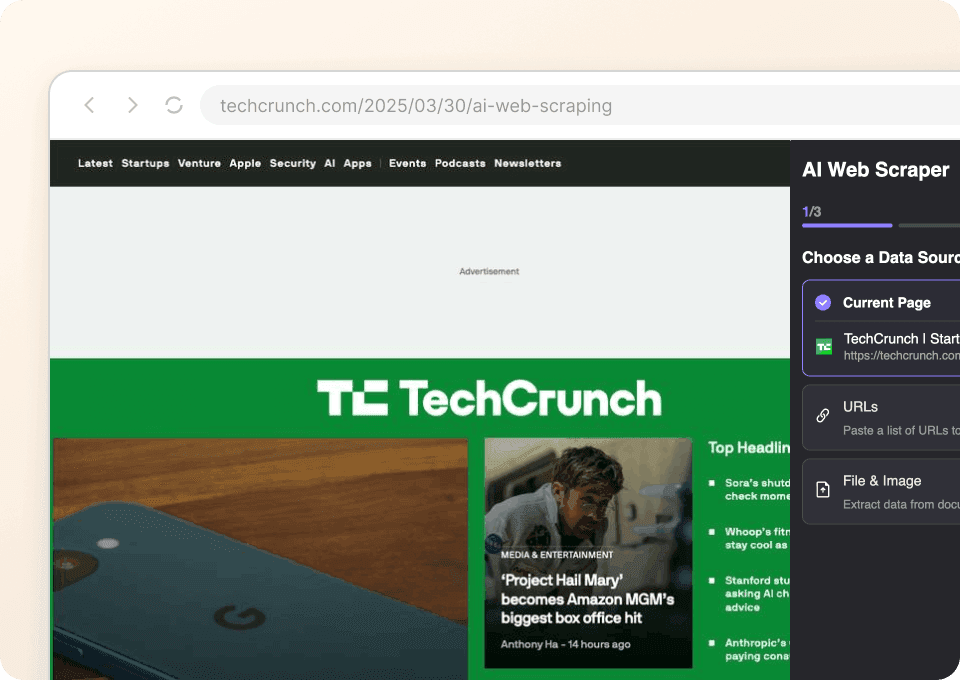
Nhận dữ liệu TechCrunch sạch ngay lập tức
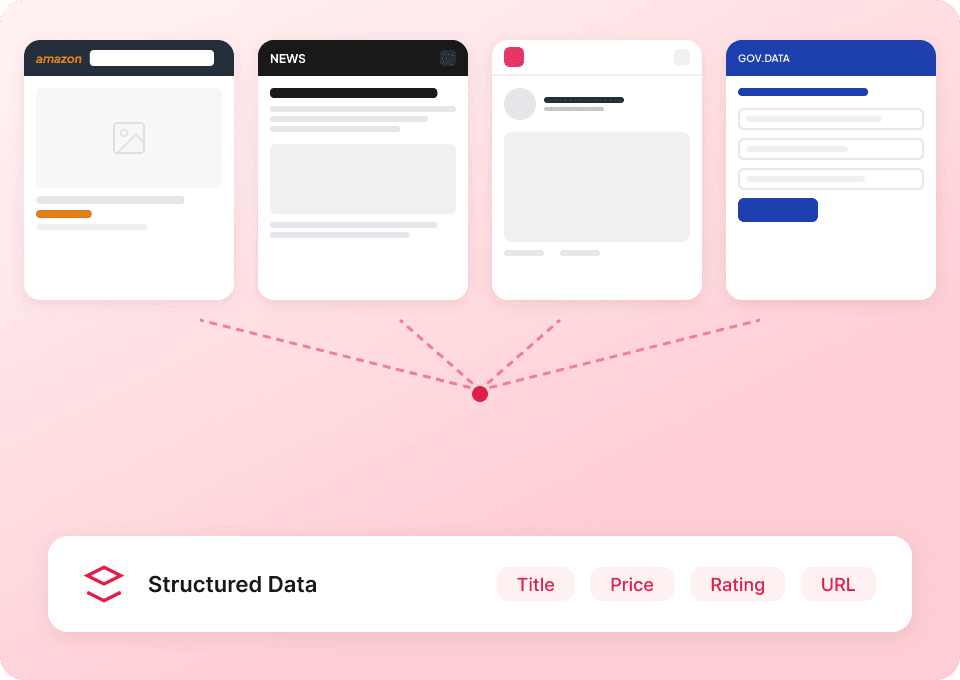
Scrape HTML thô từ TechCrunch sẽ không giúp ích nhiều — điều bạn cần là dữ liệu sạch và có cấu trúc. Thunderbit tự động làm sạch và định dạng dữ liệu ngay trong quá trình trích xuất, để bạn có thể phân tích danh mục bài viết, theo dõi tác giả hoặc so sánh ngày đăng ngay lập tức. Xuất trực tiếp sang Google Sheets, Notion hoặc Airtable và bắt đầu làm việc với dữ liệu đã được tổ chức sẵn — không cần dọn dẹp thủ công.

Scrape mọi website, không chỉ TechCrunch
Tại sao phải học một công cụ mới cho từng website khác nhau? Thunderbit hoạt động trên hầu như mọi trang web, bao gồm cả TechCrunch. Với hơn 50 mẫu dựng sẵn, bạn có thể bắt đầu nhanh hơn nữa. Dù bạn đang thu thập nội dung bài viết, hồ sơ tác giả hay thẻ phân loại bài đăng, Thunderbit vẫn là giải pháp duy nhất cho việc trích xuất dữ liệu web trên toàn bộ Internet.
Đang gặp khó khi scrape TechCrunch hiệu quả?
Xem cách Thunderbit đơn giản hóa việc trích xuất dữ liệu TechCrunch so với phương pháp truyền thống.
Các scraper truyền thống
Cách làm cũThunderbit
Cách làm thông minh hơn
Câu hỏi thường gặp
Liên quan trường hợp sử dụng
Khám phá thêm các trường hợp sử dụng của web scraper Thunderbit.

Investing.com scraper
Chỉ với 2 cú click, bạn có thể trích xuất dữ liệu chứng khoán từ Investing.com — gồm mã cổ phiếu, giá, khối lượng giao dịch và vốn hóa thị trường — rồi xuất thẳng sang Google Sheets, Notion hoặc Excel. Chỉ cần mở bất kỳ trang nào trên Investing.com và để AI tự nhận diện các trường dữ liệu giúp bạn.
Tìm hiểu thêm ->
Trình trích xuất Substack
Trích xuất số lượng người đăng ký Substack, tiêu đề bài viết và mô tả ấn phẩm chỉ với 2 cú nhấp chuột — rồi xuất sang Excel, Google Sheets hoặc Notion. Không cần viết code; AI của Thunderbit sẽ tự lo phần cấu trúc dữ liệu cho bạn.
Tìm hiểu thêm ->
ESPN scraper dễ dùng
Theo dõi tên vận động viên, ngày thi đấu và tỷ số từ ESPN chỉ trong 2 lần nhấp với AI của Thunderbit — không cần code, không cần cài đặt. Xuất thẳng sang Excel, Google Sheets hoặc Notion để biến dữ liệu thể thao của bạn thành giá trị ngay lập tức.
Tìm hiểu thêm ->
Trình thu thập PubMed
Trình thu thập PubMed của Thunderbit giúp bạn dùng AI để trích xuất dữ liệu có cấu trúc từ trang kết quả tìm kiếm và trang bài viết PubMed. Bạn có thể thu thập nghiên cứu y khoa đang nổi bật, bằng chứng thử nghiệm lâm sàng, tóm tắt, tác giả, đơn vị công tác, ngày xuất bản và liên kết, sau đó xuất sang Excel, Google Sheets, Airtable hoặc Notion.
Tìm hiểu thêm ->
Trình Scraper bài viết cho tiêu đề, tác giả và ngày đăng
Thu thập tiêu đề, tên tác giả, ngày tháng, tóm tắt, nội dung bài viết, liên kết và media từ các trang bài viết công khai. Giữ đầy đủ thông tin của từng bài trong một hàng rõ ràng, ngay cả khi các trang tin có bố cục khác nhau.
Tìm hiểu thêm ->
News Scraper: Kết nối tiêu đề với chi tiết bài viết đầy đủ
Thu thập tiêu đề từ trang chủ đề, chuyên mục hoặc kết quả tìm kiếm, sau đó mở từng liên kết bài viết để lấy các thông tin hiển thị như tên tác giả, ngày đăng, tóm tắt, chuyên mục và URL nguồn. Chỉ cần mô tả bằng tiếng Anh đơn giản những chi tiết bài viết bạn cần trước khi chạy, Thunderbit sẽ lo phần còn lại.
Tìm hiểu thêm ->Sẵn sàng tăng tốc trích xuất dữ liệu của bạn chưa?
Gia nhập hơn 200.000+ chuyên gia đã dùng Thunderbit để tự động hóa quy trình web scraping.
Dùng thử miễn phí cung cấp credit không giới hạn cho 8 trang web.



