Baidu Scraper cho Kết Quả Tìm Kiếm và Bài Viết













Biến kết quả Baidu thành dữ liệu gọn gàng, hữu ích
Giữ kết quả tìm kiếm và thông tin bài viết có sẵn trong một bảng duy nhất, rõ ràng.
Làm sạch dữ liệu Baidu ngay khi thu thập
Thunderbit sắp xếp các tiêu đề, URL, đoạn trích, ngày tháng và nguồn hiển thị vào các cột rõ ràng. Nếu kết quả không có một trường nào đó, ô tương ứng sẽ để trống.

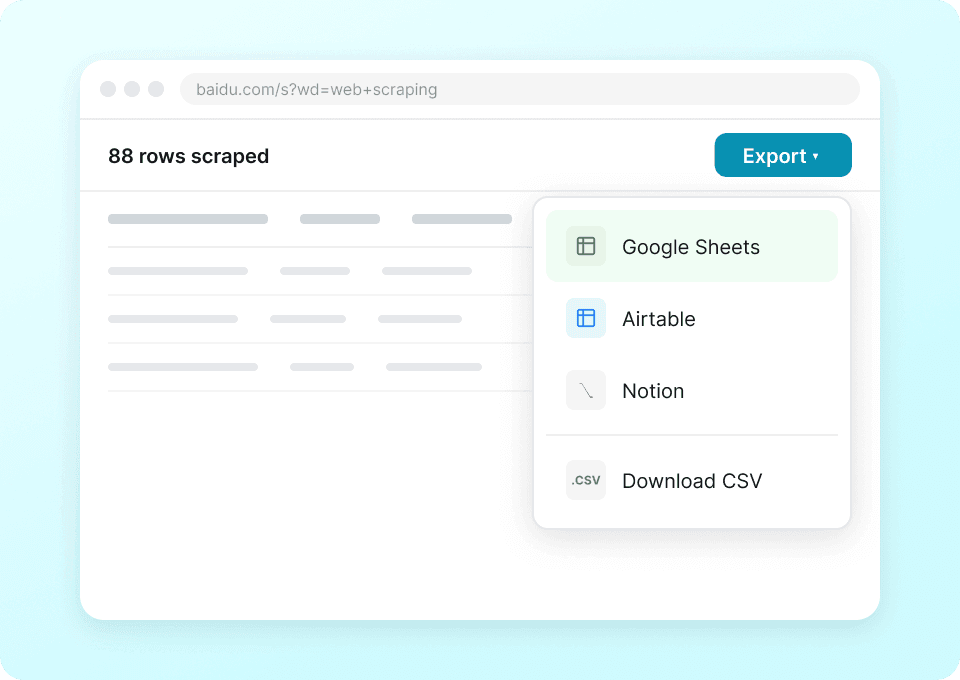
Xuất nghiên cứu Baidu chỉ với một cú nhấp
Gửi mỗi lần chạy vào một bảng kiểm tra kết quả tìm kiếm. Thứ hạng, nguồn, ngày tháng và chi tiết từ trang liên kết sẽ nằm cạnh đúng kết quả Baidu tương ứng.
Dùng cùng một quy trình trên bất kỳ trang web nào
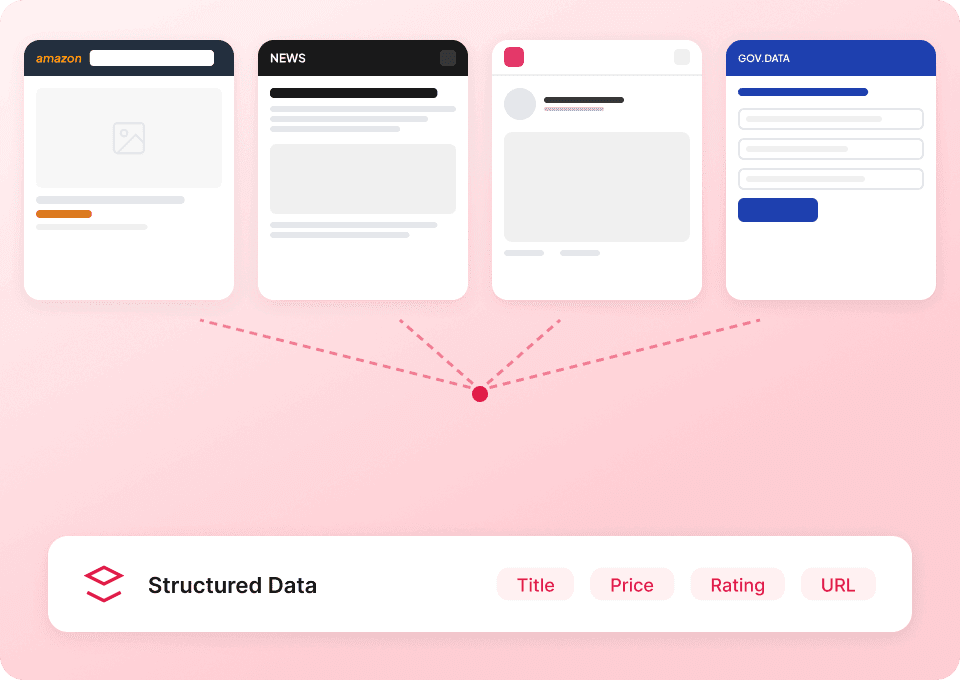
Thunderbit đọc trường dữ liệu theo ý nghĩa, không phụ thuộc vào riêng một bố cục của Baidu. Bạn có thể áp dụng cùng cách làm này cho bất kỳ trang công khai nào có thể truy cập khi nghiên cứu chuyển sang một nguồn mới.
Giữ nguyên ngữ cảnh cho từng kết quả Baidu
Một danh sách liên kết sẽ làm mất ngữ cảnh. Thunderbit giữ các chi tiết hiển thị ngay bên cạnh từng kết quả.
Danh sách link và ghi chú rời rạc
Thông tin kết quả bị tách raNghiên cứu Baidu có cấu trúc
Ngữ cảnh hiển thị luôn đi cùng từng kết quảBạn có thể trích xuất những dữ liệu nào từ Baidu?
Hãy chọn từ các trường công khai, hiển thị này. Các mô-đun kết quả và trang liên kết không phải lúc nào cũng hiển thị đầy đủ mọi trường cho mọi truy vấn.
- Truy vấn tìm kiếm
- Thứ hạng kết quả
- Tiêu đề kết quả
- URL kết quả
- URL hiển thị
- Đoạn trích kết quả
- Ngày kết quả
- Biểu tượng trang của kết quả
- Cụm từ tìm kiếm liên quan
- Gợi ý sửa chính tả
- Gợi ý Pinyin
- Số trang kết quả tìm kiếm
- Trang nguồn
- Tên miền nguồn
- Tác giả bài viết
- Ngày xuất bản bài viết
- Tóm tắt bài viết
- Tên tài liệu
- Mô tả tài liệu
- Breadcrumb tài liệu
- Thể loại tài liệu
- Định dạng tệp tài liệu
- Số trang tài liệu
- Thời gian tải lên tài liệu
- URL tài liệu
- Loại nội dung kết quả
- Ảnh thu nhỏ
- Thumbnail video
- Địa chỉ vị trí
- Mô-đun tính năng của Baidu
See how researchers track Chinese search results
These user feedback videos show how people review Chinese search results, track sources, and check linked articles.
Câu hỏi về việc thu thập dữ liệu tìm kiếm Baidu
Các trường khả dụng sẽ thay đổi tùy theo truy vấn, loại kết quả và thông tin được hiển thị trên trang liên kết.
Continue from Baidu results to source-page research
Explore article and website scrapers when you need full page text or other details beyond the fields shown in Baidu results.
Framer Scraper
Framer Scraper của Thunderbit giúp bạn trích xuất danh sách template và các ví dụ trong Framer Showcase bằng AI. Bạn có thể thu thập dữ liệu theo từng danh mục như template Portfolio, sau đó truy cập từng trang template hoặc trang con của Showcase để lấy thêm chi tiết như tiêu đề, thẻ (tags), liên kết xem trước và metadata. Kết quả có thể xuất sang Excel, Google Sheets, Airtable hoặc Notion chỉ với vài cú nhấp.
Tìm hiểu thêm ->
Trình thu thập dữ liệu WordPress.org
Trình thu thập dữ liệu WordPress.org của Thunderbit giúp bạn trích xuất dữ liệu có cấu trúc từ thư mục plugin WordPress và thư viện block pattern bằng AI. Bạn có thể thu thập từ các trang danh sách và làm giàu kết quả bằng thông tin ở trang chi tiết như thống kê plugin, phiên bản, đánh giá và metadata của pattern, sau đó xuất sang Excel, Google Sheets, Airtable hoặc Notion.
Tìm hiểu thêm ->
Capterra 爬虫
Chỉ với 2 cú nhấp chuột, trích xuất tên phần mềm, đánh giá và mô hình giá từ Capterra — rồi xuất thẳng sang Excel, Google Sheets hoặc Notion. Không cần biết lập trình.
Tìm hiểu thêm ->
CoinMarketCap scraper
Trích xuất dữ liệu crypto — giá, vốn hóa thị trường và khối lượng giao dịch 24 giờ — từ CoinMarketCap chỉ với 2 cú nhấp. Mở bất kỳ trang nào, để AI tự nhận diện các trường dữ liệu, rồi xuất thẳng sang Excel, Google Sheets hoặc Notion.
Tìm hiểu thêm ->
GoDaddy Scraper
Chỉ cần trỏ vào bất kỳ tên miền, trạng thái còn trống hay mức giá nào trên GoDaddy — AI của Thunderbit sẽ lấy dữ liệu chỉ trong 2 cú nhấp và xuất ngay sang Excel, Google Sheets hoặc Notion.
Tìm hiểu thêm ->
Goodreads scraper
Chỉ với 2 cú nhấp chuột, trích xuất tiêu đề sách, tên tác giả, điểm đánh giá và số lượng review từ Goodreads — rồi xuất dữ liệu sang Excel, Google Sheets hoặc Notion, sẵn sàng để phân tích.
Tìm hiểu thêm ->Sẵn sàng tăng tốc trích xuất dữ liệu của bạn chưa?
Gia nhập hơn 200.000+ chuyên gia đã dùng Thunderbit để tự động hóa quy trình web scraping.
Dùng thử miễn phí cung cấp credit không giới hạn cho 8 trang web.



