
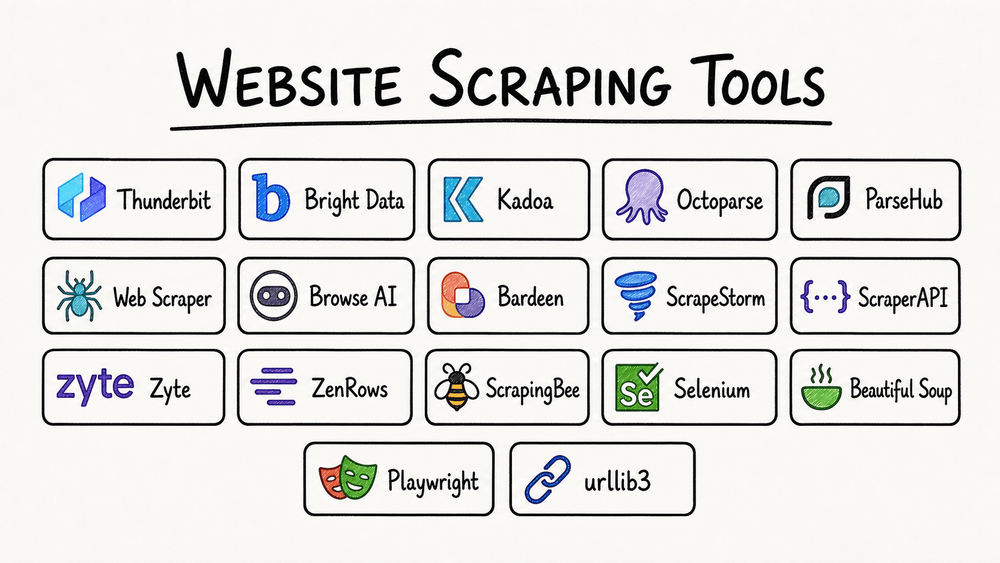
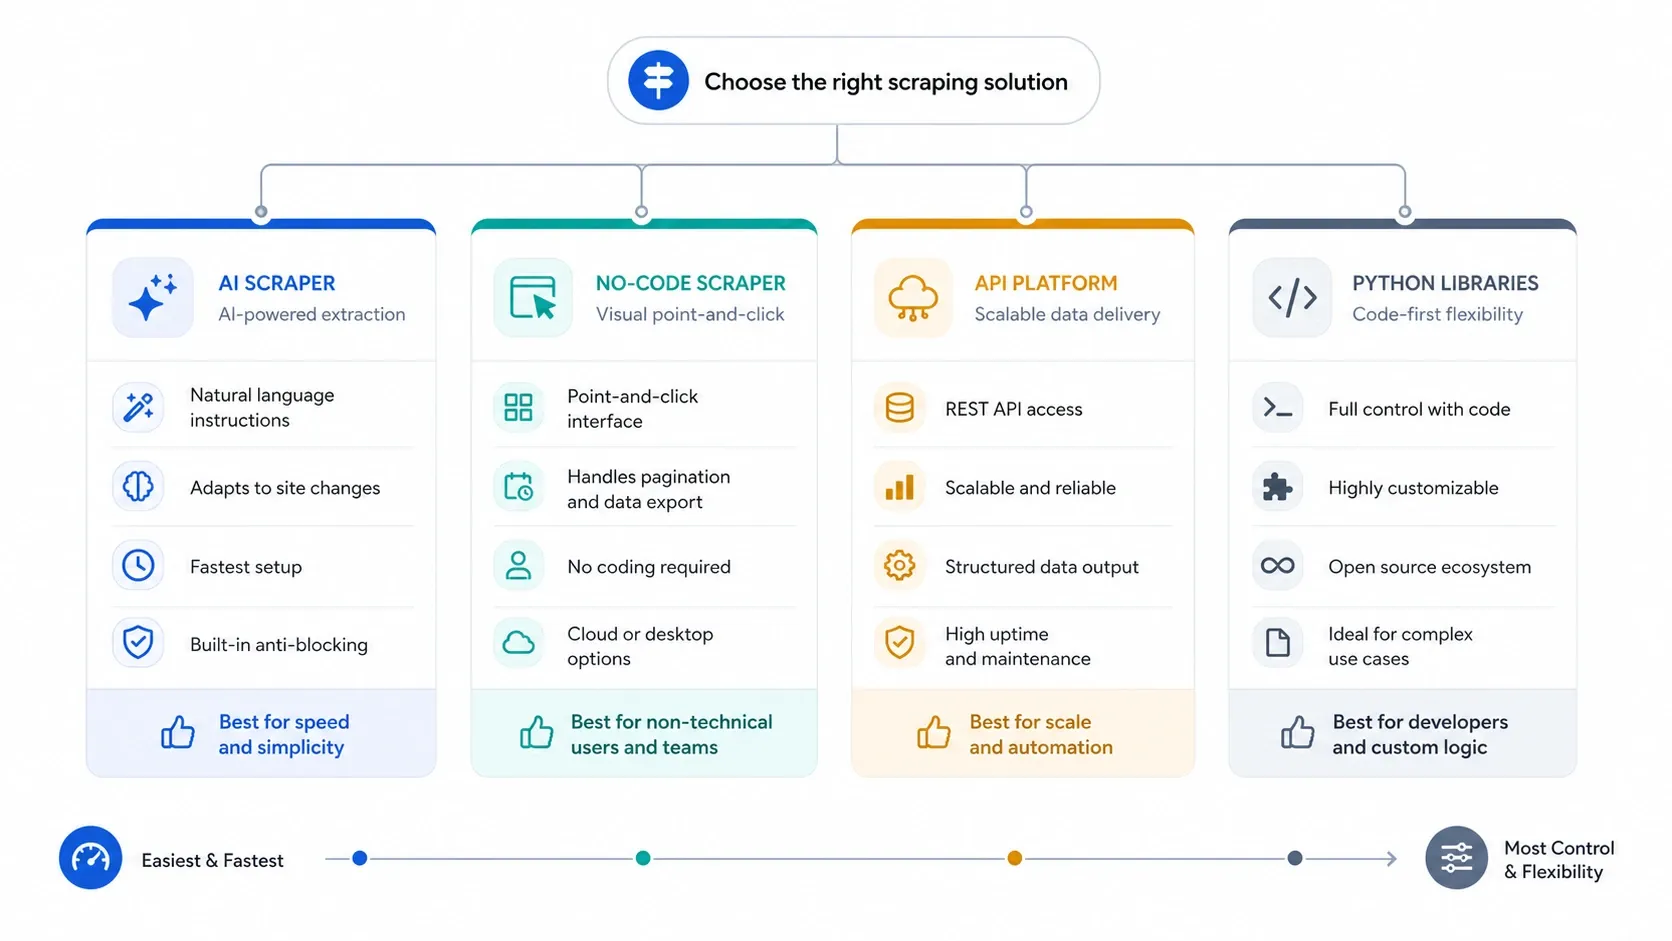
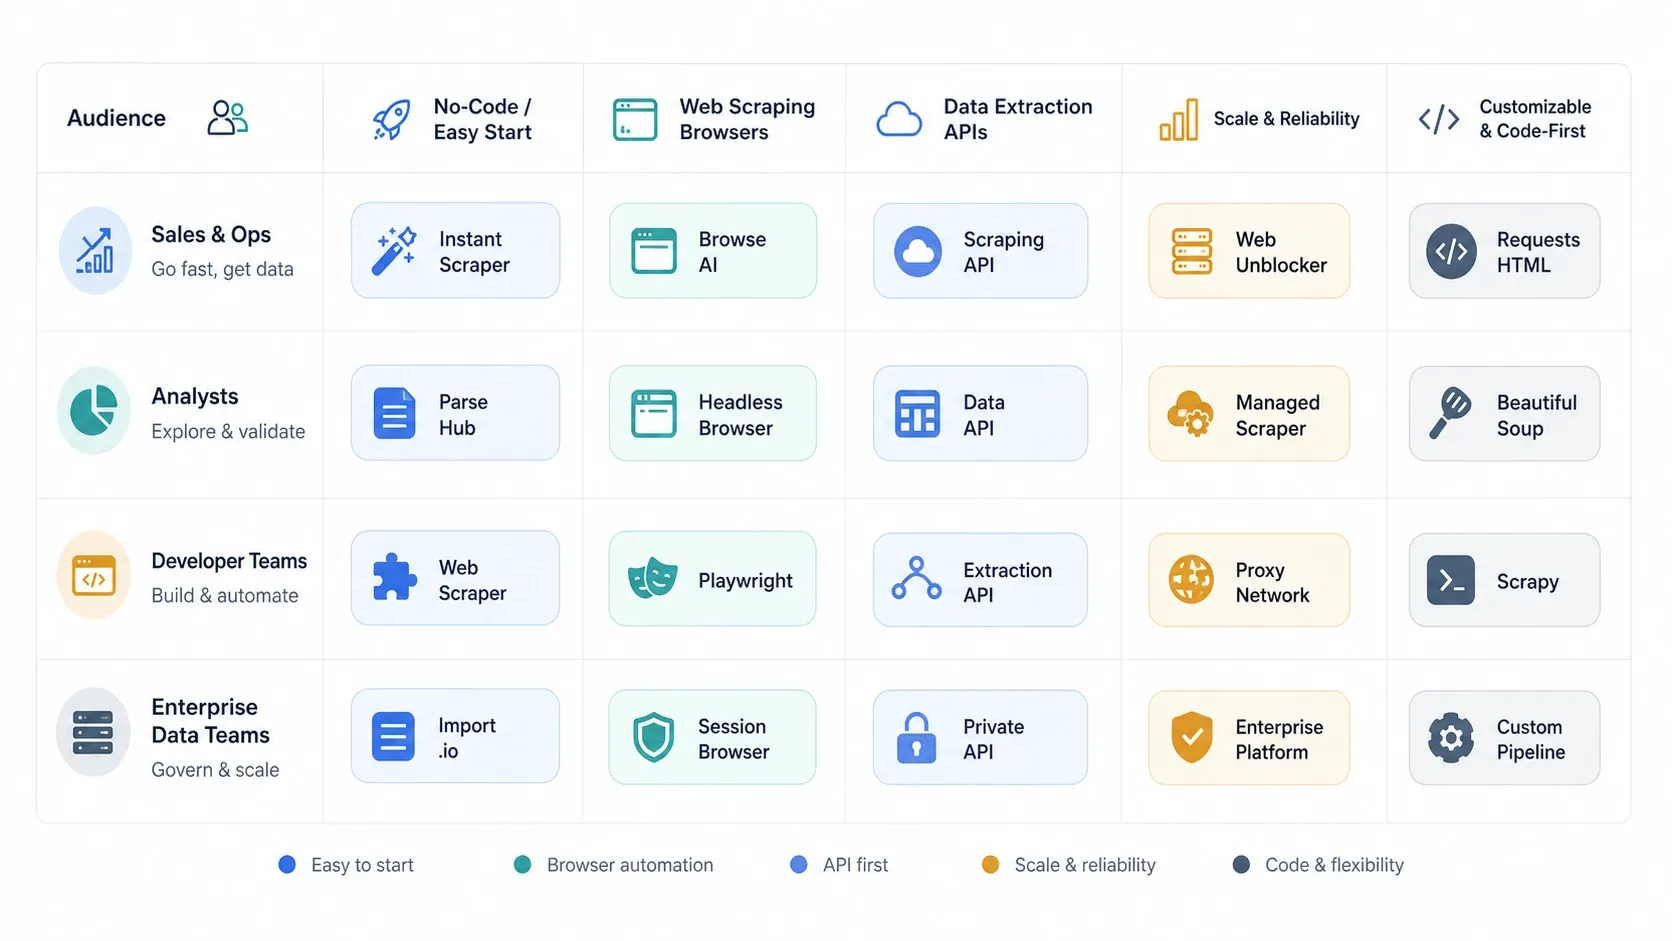
Nếu bạn cần dữ liệu web trong năm 2026, câu hỏi khó không còn là "có cào được hay không?" nữa. Mà là: "nên dùng lớp công cụ nào để lấy được dữ liệu dùng được với ít công sức thiết lập, bảo trì và chi phí hạ tầng nhất?" Vì vậy, bài viết này được sắp xếp theo mức độ phù hợp trước tiên: AI web scraper cho tốc độ, công cụ no-code cho các tác vụ trình duyệt lặp lại, API cho quy mô lớn và xử lý chống bot, còn thư viện Python dành cho đội ngũ muốn toàn quyền kiểm soát.
Câu Trả Lời Nhanh
- Chọn AI web scraper nếu bạn muốn đi từ trang web đến bảng tính nhanh nhất với cấu hình tối thiểu.
- Chọn scraper no-code nếu bạn cần phân trang rõ ràng hơn, chạy theo lịch, xử lý đăng nhập hoặc kiểm soát tác vụ lặp lại.
- Chọn scraping API nếu khả năng render, chống bot, xử lý đồng thời và tỷ lệ vượt chặn quan trọng hơn sự đơn giản của giao diện.
- Chọn thư viện Python nếu đội ngũ của bạn muốn toàn quyền với request, phân tích dữ liệu, tự động hóa trình duyệt, retry và triển khai.
Với phần lớn đội ngũ kinh doanh, sai lầm thường là đi xuống tầng công nghệ quá sớm. Hãy bắt đầu bằng công cụ nhẹ nhất có thể làm việc ổn định, rồi chỉ chuyển từ AI sang no-code, sang API, rồi sang code khi quy trình thực sự bắt buộc.
Bảng So Sánh Nhanh: Các Công Cụ Scraping Website
Các tín hiệu về giá bên dưới được kiểm tra lại từ trang sản phẩm, trang giá hoặc tài liệu chính thức vào tháng 8 năm 2026. Với những nhà cung cấp dùng giá tùy chỉnh hoặc tính theo mức sử dụng, tôi mô tả mô hình giá thay vì ép họ vào một con số hàng tháng giả tạo để so sánh cho “công bằng”.
| Công cụ | Nhóm | Phù hợp nhất cho | Vì sao có mặt trong danh sách 2026 này | Tín hiệu giá (kiểm tra tháng 5/2026) |
|---|---|---|---|---|
| Thunderbit | AI web scraper | Sales, vận hành, ecommerce, bất động sản | Cách nhanh nhất cho người không kỹ thuật từ trang web đến bảng có cấu trúc | Gói miễn phí, gói trả phí, giá doanh nghiệp |
| Bright Data Web Scraper | Nền tảng scraping doanh nghiệp | Các chương trình nặng về mua sắm, tuân thủ | Bộ công cụ thu thập dữ liệu toàn diện nhất trong nhóm | Giá theo sản phẩm và theo mức sử dụng |
| Kadoa | Nền tảng trích xuất AI | Đội ngũ dữ liệu và các chương trình định kỳ quy mô lớn | Phù hợp cho quy trình trích xuất tự phục hồi, kiểu agent | Đánh giá miễn phí, gói theo mức sử dụng và doanh nghiệp |
| Octoparse | Scraper no-code | Chuyên viên phân tích và tác vụ vận hành lặp lại | Cloud scraping lâu đời và trình dựng tác vụ trực quan | Gói miễn phí, Standard từ $69/tháng, các gói cao hơn |
| ParseHub | Scraper low-code | Người không code có tư duy kỹ thuật và nhà nghiên cứu | Logic điều hướng linh hoạt cho các website khó | Gói miễn phí, gói trả phí từ $189/tháng |
| Web Scraper | Scraper no-code trên trình duyệt | Người mới và các tác vụ lặp lại nhẹ | Mô hình sitemap đơn giản, có thể mở rộng sang cloud | Extension miễn phí, Cloud từ $50/tháng |
| Browse AI | Scraper robot no-code | Giám sát và đội ngũ ưu tiên spreadsheet | Rất mạnh cho theo dõi lặp lại và cảnh báo thay đổi | Gói miễn phí, gói trả phí, gói quản lý |
| Bardeen | Tự động hóa trình duyệt bằng AI | GTM và tự động hóa revops | Tốt nhất khi scraping chỉ là một bước trong quy trình lớn hơn | Gói miễn phí, Basic từ $10/tháng, Premium và Enterprise |
| ScrapeStorm | Scraper trực quan có hỗ trợ AI | Người muốn thiết lập nhanh bằng giao diện trực quan | Cầu nối hữu ích giữa selector thủ công và hỗ trợ AI | Dùng thử miễn phí, gói trả phí, giá doanh nghiệp |
| ScraperAPI | Scraping API | Developer cần mở rộng số lượng request | API đơn giản kèm proxy, CAPTCHA và render offload | Dùng thử 7 ngày, gói từ $49/tháng |
| Zyte | API + bộ chống bot | Developer và đội ngũ dữ liệu | Hỗ trợ tốt browser action, render JS và xoay IP | Tín dụng dùng thử $5, gói theo mức sử dụng |
| ZenRows | Scraping API | Startup và đội ngũ developer | API chống bot gọn gàng, dễ tiếp cận hơn | Dùng thử miễn phí, Developer từ $69/tháng |
| ScrapingBee | Scraping API | Đội ngũ cào các site nặng JavaScript | Hữu ích khi render là điểm đau lớn nhất | Dùng thử miễn phí, gói từ $49/tháng |
| Selenium | Tự động hóa trình duyệt mã nguồn mở | Luồng kiểu QA và scraping cần tương tác nhiều | Vẫn rất hữu ích khi cần mô phỏng hành vi người dùng chính xác | Miễn phí, mã nguồn mở |
| Beautiful Soup | Thư viện phân tích Python | Scraping Python nhẹ | Parser dễ dùng nhất để xử lý HTML lộn xộn | Miễn phí, mã nguồn mở |
| Playwright | Tự động hóa trình duyệt hiện đại | Web app hiện đại và đội ngũ developer | Lựa chọn hiện đại tốt nhất cho scraping trình duyệt theo script | Miễn phí, mã nguồn mở |
| urllib3 | Thư viện HTTP Python | Developer muốn kiểm soát request ở mức thấp | Nền tảng hữu ích khi bạn muốn tự nắm toàn bộ hành vi truyền tải | Miễn phí, mã nguồn mở |
Cách Chọn Công Cụ Scraping Website Phù Hợp
Hãy dùng 4 tiêu chí sau trước khi so sánh các thương hiệu:
- Thời gian để có đầu ra hữu ích đầu tiên
Nếu công cụ không thể nhanh chóng xuất ra một bảng dữ liệu thật sự, thì nó đã thua trong phần lớn trường hợp kinh doanh. - Gánh nặng bảo trì
Một scraper rẻ nhưng cứ hỏng mỗi khi giao diện thay đổi thì thực ra không hề rẻ. - Giới hạn về quy mô
Một extension trên trình duyệt có thể hoàn hảo cho 50 trang mỗi tuần, nhưng lại rất tệ nếu bạn cần 5 triệu request mỗi tháng. - Độ phù hợp với quy trình làm việc
Scraper tốt nhất cho revops hiếm khi là lựa chọn tốt nhất cho kỹ sư nền tảng.
Khung ra quyết định thường đơn giản hơn các đội ngũ vẫn tưởng:
- Nếu bạn muốn cào lead, danh sách sản phẩm hoặc trang sản phẩm mà không đụng vào selector, hãy bắt đầu với AI.
- Nếu bạn cần tác vụ lặp lại, chạy trên cloud và kiểm soát rõ hơn, hãy chuyển sang trình dựng no-code dạng trực quan.
- Nếu vấn đề thực sự là chống bot, render JavaScript và xử lý đồng thời, hãy nhảy sang API.
- Nếu bạn muốn tự nắm mọi lớp, hãy dùng thư viện Python và chấp nhận gánh nặng bảo trì.
Best AI Web Scrapers for Fast Business Workflows
Đây là nhóm đầu tiên tôi sẽ thử nếu đầu ra bạn cần là dữ liệu sẵn sàng đưa vào bảng tính với mức cấu hình thấp nhất có thể.
1. Thunderbit
Thunderbit vẫn là điểm khởi đầu dễ nhất cho người không biết code. Lợi thế cốt lõi không chỉ là “AI” theo nghĩa chung chung; mà là sản phẩm rút ngắn mạnh vòng lặp thiết lập. Bạn mở trang web, để AI gợi ý trường dữ liệu, mở rộng sang các trang con khi cần, rồi gửi kết quả thẳng vào những công cụ mà đội ngũ của bạn đang dùng.
- Phù hợp nhất cho: tìm kiếm khách hàng tiềm năng, theo dõi ecommerce, thu thập dữ liệu bất động sản và các đội ngũ vận hành làm việc ngay trong trình duyệt.
- Điểm nổi bật: đường đi nhanh nhất từ trang web lộn xộn đến bảng dữ liệu có cấu trúc.
- Lưu ý: nếu bạn cần logic kiểu crawler hoặc quy trình kỹ thuật tùy biến cao, cuối cùng bạn sẽ chuyển sang API hoặc code.
- Tín hiệu giá: gói miễn phí, các gói tự phục vụ trả phí và giá cho doanh nghiệp.
Video hướng dẫn này vẫn là cách nhanh nhất để đánh giá xem scraping theo hướng AI có đủ cho quy trình của bạn hay không:
Thử Thunderbit AI Web Scraper miễn phí Cào dữ liệu từ bất kỳ website nào chỉ với 1 cú nhấp — không cần selector, không cần thiết lập, xuất thẳng sang Sheets hoặc Excel. Get Started Free
2. Bright Data Web Scraper
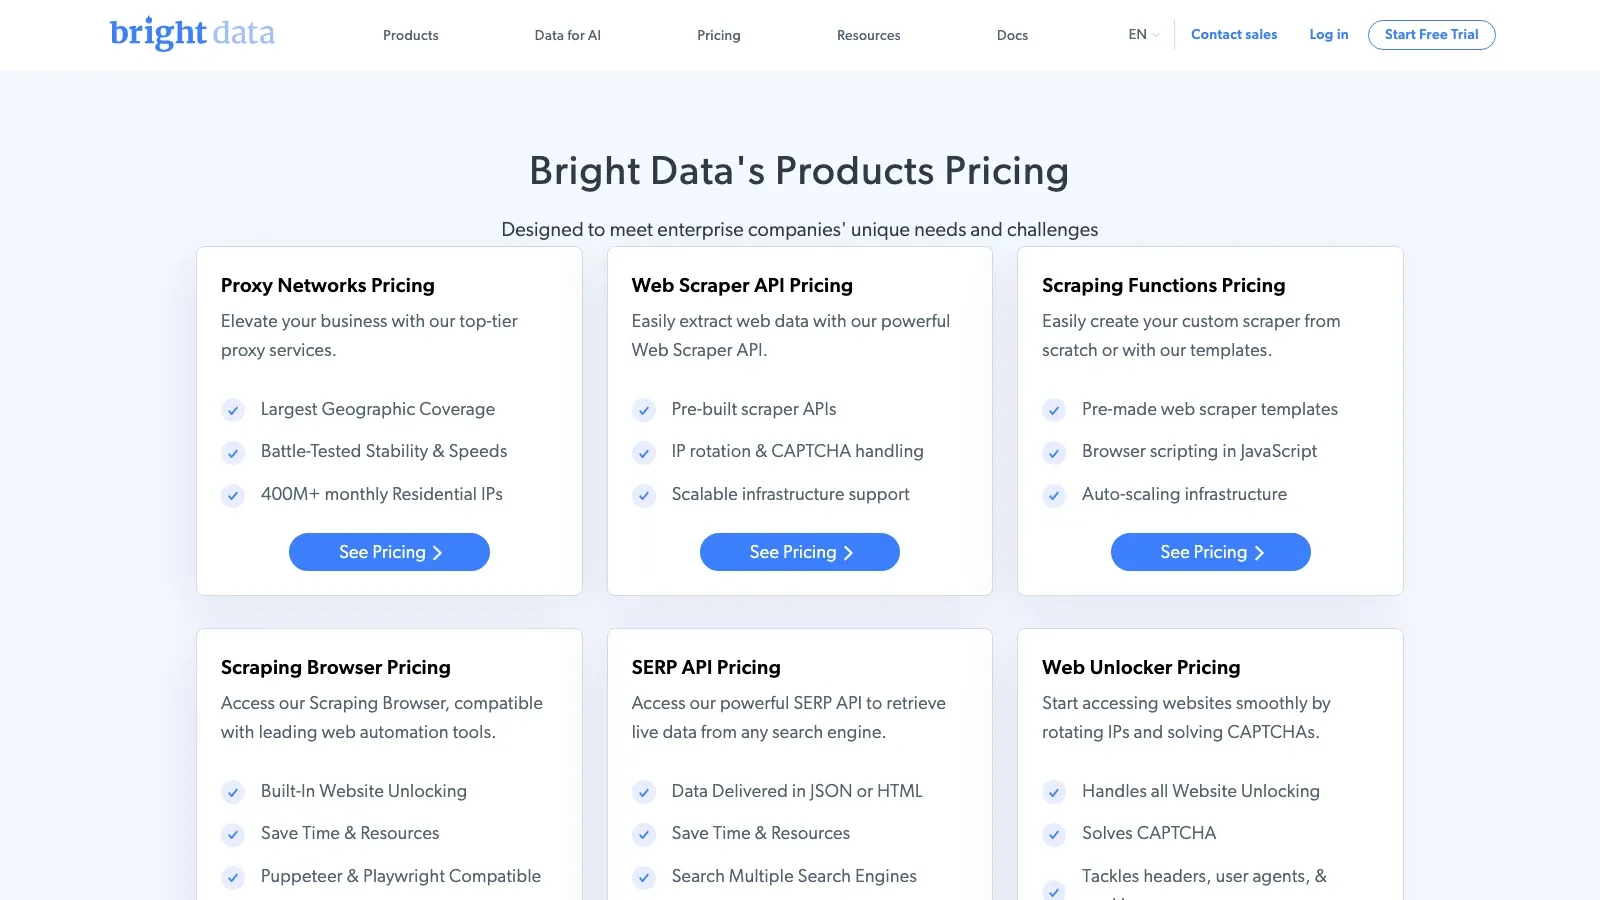
Bright Data là lựa chọn “nặng đô” khi khả năng vượt chặn, kho proxy, mức độ tuân thủ và các tùy chọn được quản lý quan trọng hơn sự đơn giản.
- Phù hợp nhất cho: thu thập dữ liệu ở quy mô doanh nghiệp và các chương trình nhạy cảm về tuân thủ.
- Điểm nổi bật: bộ công cụ rộng nhất trong so sánh này, từ proxy đến sản phẩm thu thập được quản lý.
- Lưu ý: rất dễ mua quá tay nếu quy trình của đội bạn vẫn còn khá đơn giản.
- Tín hiệu giá: giá theo sản phẩm và theo mức sử dụng.
3. Kadoa
Kadoa là lựa chọn AI thiên về hạ tầng hơn trong nhóm này. Nó phù hợp khi bạn muốn trích xuất có khả năng tự phục hồi và các job định kỳ ở quy mô vận hành lớn hơn mức mà hầu hết extension trình duyệt có thể xử lý.
- Phù hợp nhất cho: đội ngũ dữ liệu, chương trình intelligence nội bộ và các khối lượng trích xuất lặp lại lớn.
- Điểm nổi bật: điều phối theo kiểu agent và câu chuyện giảm bảo trì rất mạnh.
- Lưu ý: nặng hơn mức mà đa số người dùng kinh doanh cần cho những lần scraping nhanh, một lần.
- Tín hiệu giá: đánh giá miễn phí, gói theo mức sử dụng và gói doanh nghiệp.
Best No-Code Website Scraping Tools for Repeatable Jobs
Khi công việc scraping trở thành thứ phải lặp lại, trình dựng workflow trực quan và khả năng chạy trên cloud sẽ quan trọng hơn tốc độ một cú nhấp.
4. Octoparse
Octoparse vẫn là một trong những công cụ no-code đáng tin cậy nhất khi công việc lớn hơn một browser extension nhưng chưa đến mức thành dự án kỹ thuật tùy chỉnh. Giá trị của nó nằm ở sự kết hợp giữa chạy trên cloud, template và trình dựng tác vụ trực quan đã trưởng thành.
- Phù hợp nhất cho: chuyên viên phân tích, đội định giá và các job thu thập lặp lại có ý nghĩa vận hành thực sự.
- Điểm nổi bật: sâu hơn plugin trình duyệt mà không buộc bạn phải viết code.
- Lưu ý: bạn phải trả giá bằng đường học tập dốc hơn so với các công cụ AI-first.
- Tín hiệu giá: gói miễn phí, Standard từ $69/tháng, các gói trả phí cao hơn.
Nếu bạn muốn đánh giá một không gian no-code truyền thống trước khi đầu tư vào công cụ AI-first, bài giới thiệu chính thức của Octoparse vẫn rất hữu ích:
5. ParseHub
ParseHub vẫn còn giá trị vì rất nhiều đội ngũ muốn logic tác vụ theo từng bước rõ ràng hơn so với những gì một AI scraper nhẹ có thể mang lại. Sản phẩm này không phải đẹp nhất trong nhóm, nhưng vẫn rất linh hoạt.
- Phù hợp nhất cho: nhà nghiên cứu, nhà báo và người không code nhưng có tư duy kỹ thuật, chấp nhận thiết lập nhiều hơn.
- Điểm nổi bật: logic điều kiện và khả năng điều hướng mạnh hơn nhiều công cụ dành cho người mới.
- Lưu ý: học chậm hơn và cảm giác “ít hiện đại” hơn các sản phẩm mới.
- Tín hiệu giá: gói miễn phí, gói trả phí từ $189/tháng.
6. Web Scraper
Web Scraper là một trong những lựa chọn “học cơ bản mà chưa cần mua nền tảng” rõ ràng nhất. Nếu bạn thích mô hình sitemap, đây vẫn là điểm khởi đầu hợp lý.
- Phù hợp nhất cho: người mới, dự án cá nhân và các job nhỏ chạy từ trình duyệt.
- Điểm nổi bật: thiết lập đơn giản và dễ đi từ extension cục bộ lên gói cloud.
- Lưu ý: trở nên hạn chế khi bạn cần logic thích ứng hơn hoặc khả năng vượt chặn mạnh hơn.
- Tín hiệu giá: extension miễn phí, Cloud từ $50/tháng.
7. Browse AI
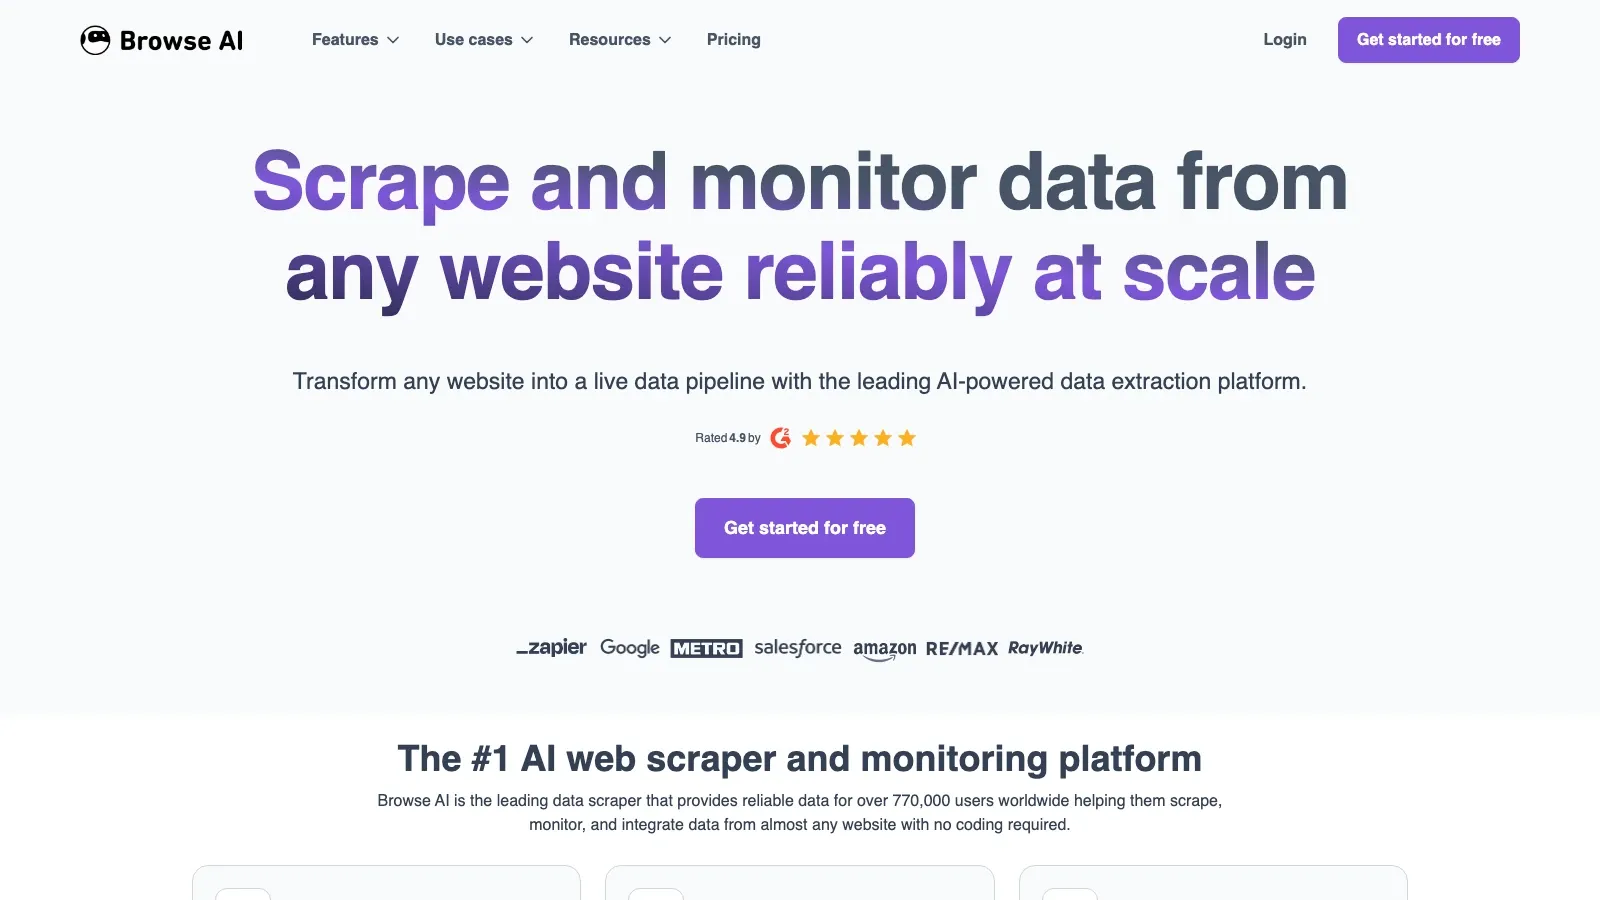
Browse AI vẫn là lựa chọn mạnh khi scraping và monitoring có mức độ quan trọng ngang nhau. Mô hình robot của nó rất trực quan với người dùng kinh doanh, những người nghĩ theo kiểu: “hãy theo dõi trang này và báo cho tôi khi có thay đổi.”
- Phù hợp nhất cho: giám sát đối thủ, theo dõi giá và đội ngũ ưu tiên spreadsheet.
- Điểm nổi bật: onboarding mượt, giám sát định kỳ và đầu ra thân thiện với tự động hóa.
- Lưu ý: các job phức tạp, khối lượng lớn có thể tăng chi phí nhanh hơn so với stack ưu tiên API.
- Tín hiệu giá: gói miễn phí, gói trả phí, gói quản lý.
Với các đội đang đánh giá giám sát trang thay vì chỉ trích xuất một lần, video giới thiệu ngắn chính thức này vẫn là một phép kiểm tra khá tốt:
8. Bardeen
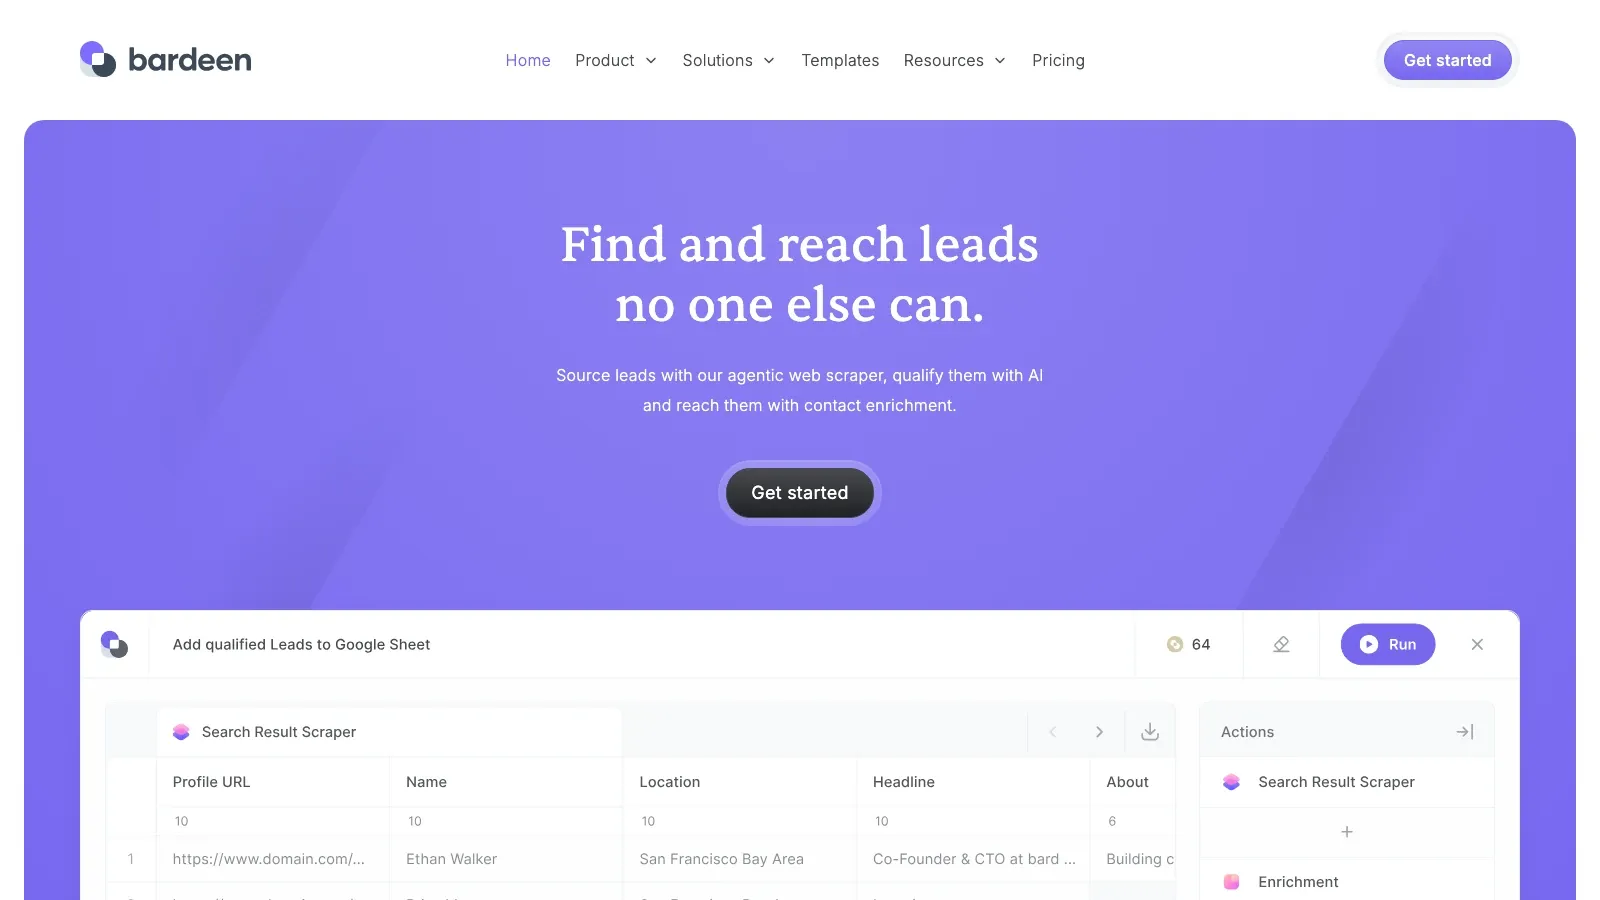
Bardeen không thiên về độ sâu scraping thuần túy mà thiên về những gì xảy ra sau khi scraping xong. Nó mạnh nhất khi việc trích xuất web chỉ là một bước trong quy trình tự động hóa trình duyệt lớn hơn.
- Phù hợp nhất cho: GTM ops, định tuyến lead, chuyển giao vào CRM và tự động hóa ngay trong trình duyệt.
- Điểm nổi bật: câu chuyện tự động hóa workflow xoay quanh chính tác vụ scrape.
- Lưu ý: không phải lựa chọn sạch nhất khi độ chính xác trích xuất là điều duy nhất quan trọng.
- Tín hiệu giá: gói miễn phí, Basic từ $10/tháng, cùng các gói Premium và Enterprise.
9. ScrapeStorm
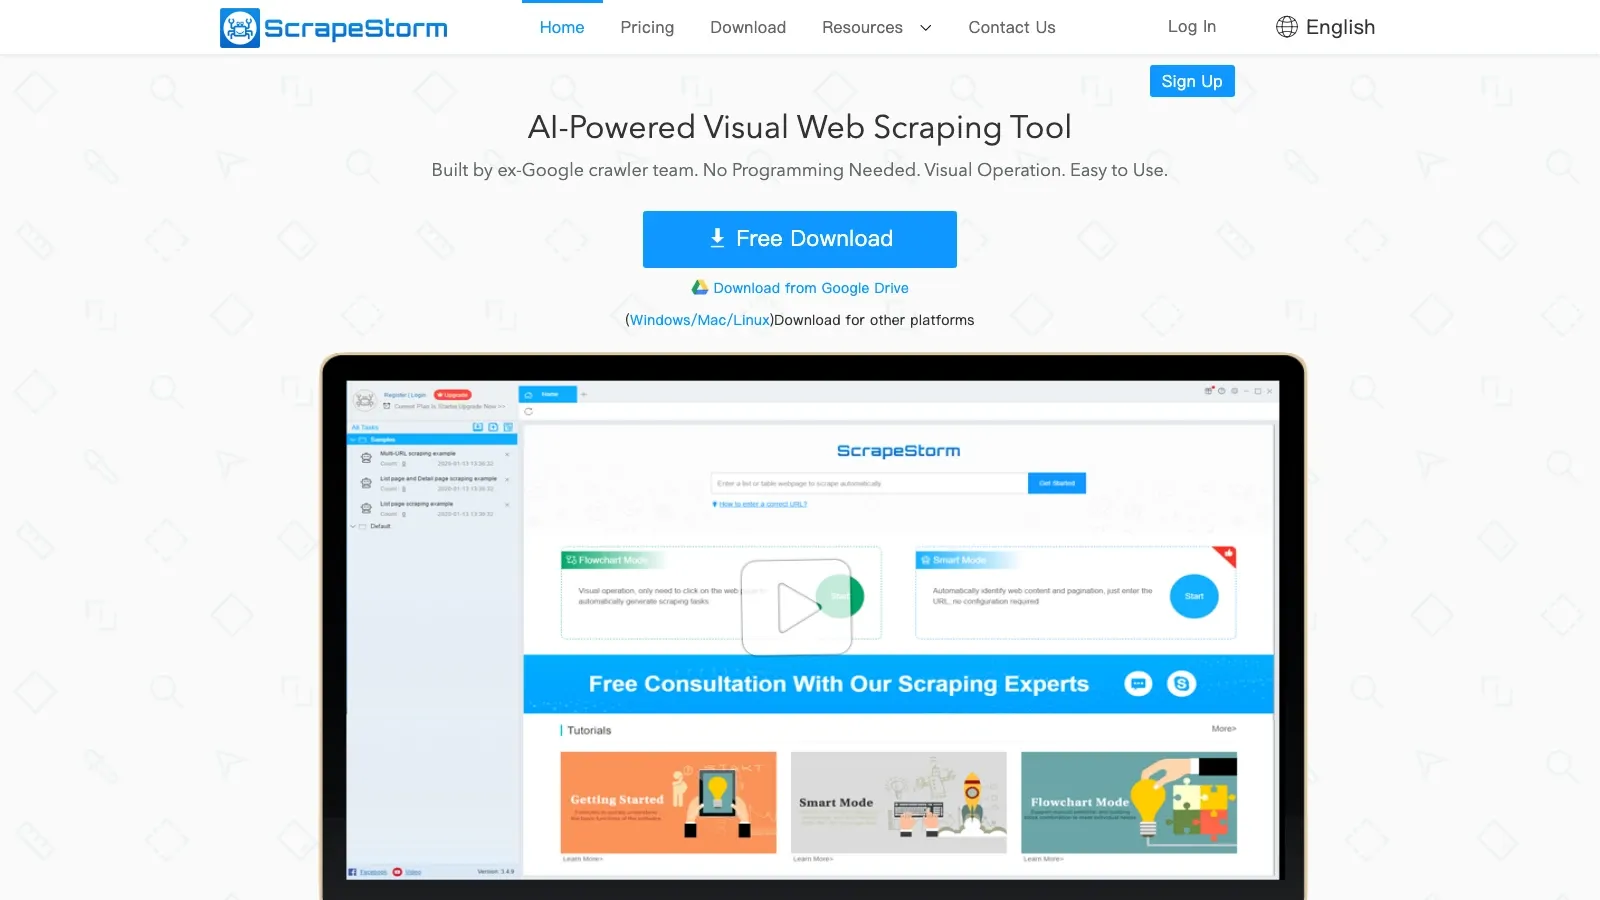
ScrapeStorm vẫn lấp một khoảng giữa rất hữu ích cho người dùng muốn có hỗ trợ AI nhưng vẫn kỳ vọng một môi trường scraping trực quan kiểu truyền thống.
- Phù hợp nhất cho: scraping danh bạ, thu thập trang ecommerce và các job định kỳ cấu hình bằng giao diện.
- Điểm nổi bật: dễ bắt đầu hơn nhiều công cụ trực quan đời cũ.
- Lưu ý: chưa bóng bẩy bằng các sản phẩm dẫn đầu và có thể thấy hạn chế hơn trên các website khó.
- Tín hiệu giá: dùng thử miễn phí, gói trả phí, giá doanh nghiệp.
Best Scraping APIs When Scale and Anti-Bot Handling Matter
Đây là nhóm bạn nên chuyển sang khi rào cản thực sự không còn là “làm sao để chọn đúng dữ liệu?” mà là “làm sao để hệ thống vẫn ổn định khi chạy tải lớn?”
10. ScraperAPI
ScraperAPI vẫn là một trong những sản phẩm API-first dễ tiếp cận nhất cho developer muốn khỏi phải nghĩ về proxy và tỷ lệ request thành công.
- Phù hợp nhất cho: developer cần mở rộng từ prototype sang production nhanh.
- Điểm nổi bật: API đơn giản kèm hỗ trợ proxy, CAPTCHA và render.
- Lưu ý: bạn vẫn phải tự lo parsing, retry và chất lượng dữ liệu đầu ra.
- Tín hiệu giá: dùng thử 7 ngày, gói từ $49/tháng.
11. Zyte
Zyte vẫn là lựa chọn nghiêm túc cho các đội developer muốn browser actions, render JS, xoay IP và năng lực chống bot trong cùng một câu chuyện nền tảng.
- Phù hợp nhất cho: các chương trình scraping do kỹ sư dẫn dắt và hệ thống trích xuất lặp lại.
- Điểm nổi bật: bộ chống phát hiện mạnh và quy trình ưu tiên API.
- Lưu ý: hợp với đội có ownership kỹ thuật hơn là người dùng kinh doanh.
- Tín hiệu giá: tín dụng dùng thử $5, gói theo mức sử dụng.
12. ZenRows
ZenRows là một trong những trải nghiệm developer gọn gàng hơn trong nhóm API nếu bạn muốn xử lý chống bot mà không cần quy trình mua sắm kiểu doanh nghiệp.
- Phù hợp nhất cho: startup, developer và đội công cụ nội bộ gọn nhẹ.
- Điểm nổi bật: dễ tiếp cận hơn và định vị chống bot rất rõ ràng.
- Lưu ý: vẫn là một sản phẩm API, nên bạn phải tự giữ logic ứng dụng và gánh nặng QA.
- Tín hiệu giá: dùng thử miễn phí, Developer từ $69/tháng.
13. ScrapingBee
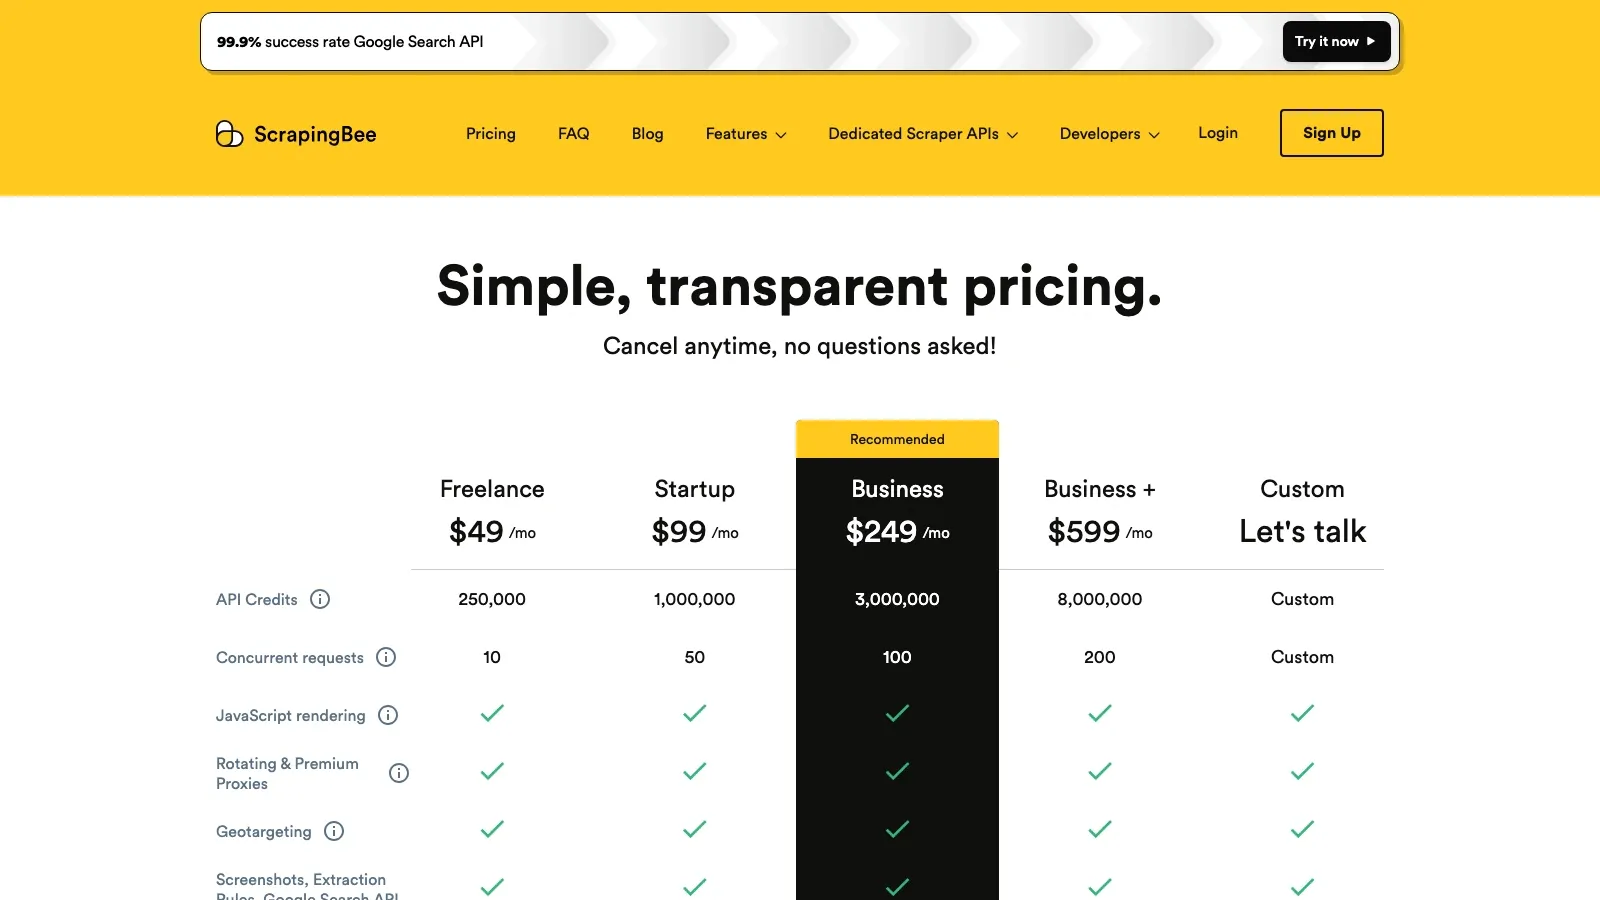
ScrapingBee phù hợp khi nhu cầu thực sự của bạn là một trang đã render và ít phải lo hạ tầng hơn, đặc biệt với các website nặng JavaScript.
- Phù hợp nhất cho: developer scraping site động và muốn giảm tải phần render.
- Điểm nổi bật: API đơn giản xoay quanh headless browsing và proxy.
- Lưu ý: nó giảm gánh nặng hạ tầng, nhưng không thay bạn nghĩ ra logic scraping tốt.
- Tín hiệu giá: dùng thử miễn phí, gói từ $49/tháng.
Best Python Web Scraping Libraries for Custom Stacks
Nhóm này vẫn là câu trả lời đúng khi khả năng kiểm soát quan trọng hơn sự tiện lợi và đội ngũ của bạn sẵn sàng tự gánh bảo trì.
14. Selenium
Selenium không phải là công cụ trình duyệt mới nhất, nhưng nó vẫn rất liên quan ở những nơi mà độ sát với hành vi người dùng quan trọng hơn thông lượng scraping thuần túy.
- Phù hợp nhất cho: các luồng cần tương tác nhiều, trùng với QA, và website mà hành vi trình duyệt là thách thức chính.
- Điểm nổi bật: hệ sinh thái trưởng thành và hỗ trợ nhiều trình duyệt.
- Lưu ý: nặng và chậm hơn các stack tự động hóa mới trong nhiều khối lượng scraping.
- Tín hiệu giá: miễn phí, mã nguồn mở.
15. Beautiful Soup
Beautiful Soup vẫn là parser dễ dùng nhất trong stack scraping Python. Nó không phải một nền tảng scraping hoàn chỉnh, nhưng vẫn là cách đơn giản nhất để biến HTML lộn xộn thành cấu trúc dùng được.
- Phù hợp nhất cho: job Python nhẹ, trang HTML tĩnh và prototype nhanh.
- Điểm nổi bật: ít tốn sức nghĩ và parsing khá “dễ chịu”.
- Lưu ý: hãy ghép nó với
requests, một lớp trình duyệt hoặc crawler; tự nó chỉ làm nhiệm vụ phân tích. - Tín hiệu giá: miễn phí, mã nguồn mở.
16. Playwright
Playwright là lựa chọn hiện đại mặc định của tôi cho các đội developer cần tự động hóa trình duyệt mạnh mẽ trên web hiện nay.
- Phù hợp nhất cho: website nặng JavaScript, tự động hóa trình duyệt hiện đại và đội đã quen viết code.
- Điểm nổi bật: cơ chế chờ tốt, hỗ trợ đa trình duyệt và API sạch.
- Lưu ý: bạn vẫn phải tự lo xử lý đồng thời, selector, hạ tầng trình duyệt và kiểm tra dữ liệu.
- Tín hiệu giá: miễn phí, mã nguồn mở.
17. urllib3
urllib3 có mặt trong danh sách vì một số đội muốn kiểm soát trực tiếp hành vi truyền tải thay vì dùng lớp trừu tượng cao hơn. Nó không phải scraper thân thiện cho người mới, nhưng là thư viện nền tảng rất hữu ích khi bạn tự xây stack của mình.
- Phù hợp nhất cho: developer muốn kiểm soát chặt retry, proxy, session và hành vi HTTP.
- Điểm nổi bật: nhẹ, ổn định và được dùng rộng rãi như một lớp hạ tầng.
- Lưu ý: bạn đang tự xây phần lớn stack.
- Tín hiệu giá: miễn phí, mã nguồn mở.
Các Công Cụ Scraping Website Miễn Phí Đáng Thử Trước
Nếu bạn muốn thử trước khi mua, những điểm bắt đầu miễn phí tốt nhất trong danh sách này là Thunderbit, Octoparse, ParseHub, Web Scraper, Browse AI, Bardeen, Selenium, Beautiful Soup, Playwright và urllib3. Trải nghiệm miễn phí đủ tốt để bạn hiểu mình thực sự cần loại scraper nào, và điều đó thường quan trọng hơn việc ám ảnh với một checklist tính năng hoàn hảo ngay từ ngày đầu.
Danh Sách Rút Gọn Theo Loại Đội Ngũ
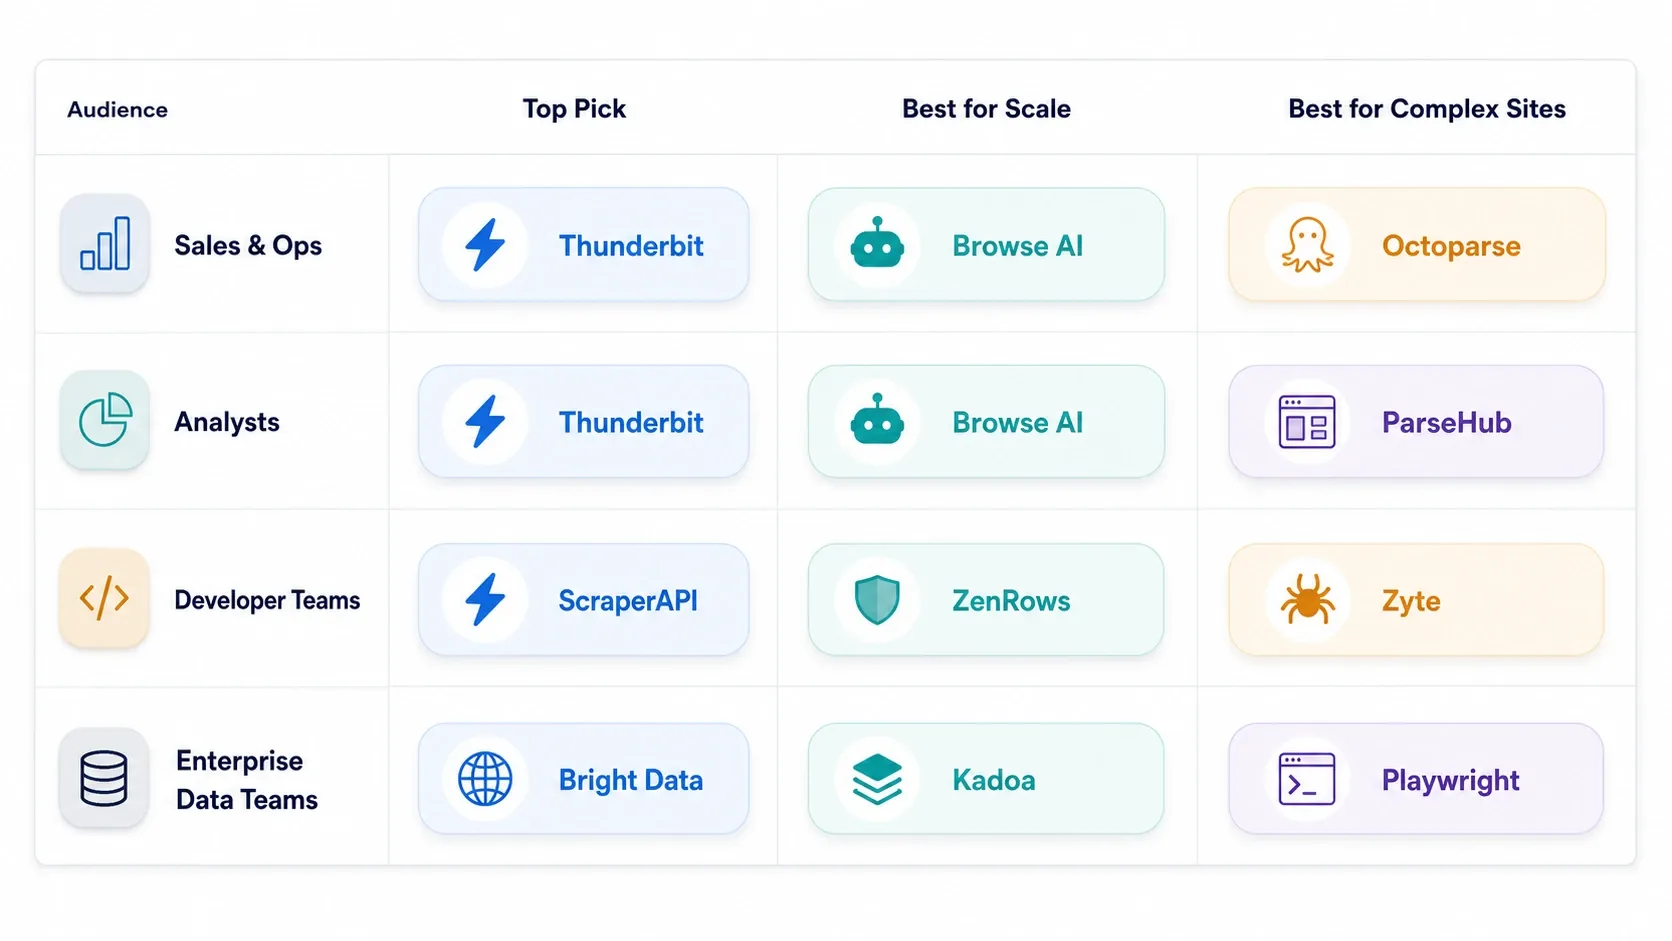
- Đội sales, vận hành và ecommerce: bắt đầu với Thunderbit, rồi so sánh Browse AI nếu giám sát quan trọng hơn việc mở rộng sang trang con.
- Chuyên viên phân tích và người vận hành tác vụ lặp lại: ưu tiên Octoparse, rồi đến ParseHub nếu bạn cần logic tác vụ tùy biến hơn.
- Đội tự động hóa GTM: chọn Bardeen nếu luồng scrape cần đi thẳng vào CRM, Sheets hoặc workflow trình duyệt.
- Đội developer xây công cụ nội bộ: chọn ScraperAPI, ZenRows, Zyte hoặc Playwright tùy mức độ bạn muốn tự sở hữu stack.
- Chương trình dữ liệu doanh nghiệp: Bright Data và Zyte là hai cuộc trò chuyện nghiêm túc hơn về hạ tầng, trong khi Kadoa là lựa chọn thiên về AI nếu mục tiêu chính là giảm bảo trì.
Khi Nào Nên Xuống Tầng Công Nghệ
Hãy dùng lộ trình nâng cấp này:
- Giữ nguyên AI web scraper cho đến khi bạn chạm giới hạn về tính lặp lại hoặc các trường hợp biên.
- Chuyển sang trình dựng no-code khi lập lịch, phân trang và chạy trên cloud quan trọng hơn sự đơn giản một cú nhấp.
- Chuyển sang API khi tỷ lệ vượt chặn, render và xử lý đồng thời trở thành nút thắt.
- Chuyển sang thư viện Python khi chi phí trừu tượng hóa của nhà cung cấp cao hơn việc tự sở hữu toàn bộ hệ thống.
Phần lớn đội ngũ làm điều này theo thứ tự sai. Họ xây quá mức ngay từ đầu rồi sau đó mới nhận ra một công cụ nhẹ hơn đã có thể giải quyết đúng quy trình.
Kết Luận
Công cụ scraping website tốt nhất năm 2026 không phải là công cụ có danh sách tính năng dài nhất. Đó là công cụ đưa dữ liệu chính xác vào bước workflow tiếp theo với chi phí bảo trì thấp nhất cho đội của bạn. Vì vậy, các công cụ AI-first vẫn thắng ở nhóm người vận hành, công cụ no-code vẫn rất giá trị cho các job trình duyệt lặp lại, API thống trị khi scale và chặn bot là vấn đề, còn thư viện Python vẫn giữ phần đòi hỏi kiểm soát cao nhất của stack.
Nếu mục tiêu của bạn là có được dữ liệu hữu ích ngay trong tuần này, hãy bắt đầu thật đơn giản. Nếu khối lượng công việc của bạn đã cho thấy tỷ lệ vượt chặn, render trình duyệt và khả năng kiểm soát của kỹ sư mới là vấn đề thật sự, hãy chuyển xuống tầng công nghệ một cách có chủ đích thay vì theo thói quen.
Bắt đầu với scraper nhẹ nhất nhưng vẫn làm được việc Get Started Free
Câu Hỏi Thường Gặp
1. Công cụ scraping website nào tốt nhất cho người không rành kỹ thuật trong năm 2026?
Với phần lớn đội ngũ không kỹ thuật, các công cụ AI-first như Thunderbit và Browse AI vẫn là con đường nhanh nhất vì chúng giảm thời gian thiết lập, công việc xử lý selector và gánh nặng bảo trì.
2. Tôi nên chọn gì cho website nhiều JavaScript hoặc được bảo vệ chống bot?
Đó thường là lúc ScraperAPI, Bright Data, Zyte, ZenRows, ScrapingBee, Playwright hoặc Selenium phù hợp hơn các browser extension.
3. Công cụ scraping no-code còn đáng dùng khi AI scraper đã tốt hơn không?
Có. Octoparse, ParseHub, Web Scraper và Browse AI vẫn rất hữu ích khi bạn cần kiểm soát tác vụ rõ hơn, chạy định kỳ hoặc debug trực quan ngay trên trình duyệt.
4. Công cụ nào phù hợp nhất cho đội ngũ developer?
ScraperAPI, Zyte, ZenRows, ScrapingBee, Playwright, Selenium, Beautiful Soup và urllib3 là những lựa chọn tự nhiên nhất khi kỹ sư sở hữu toàn bộ workflow.
Đọc thêm




