
Gõ "Thunderbit vs Oxylabs" lên Google, có lẽ bạn sẽ mong thấy ngay một bảng so sánh gọn gàng kiểu Coke vs Pepsi. Nhưng thực tế không đơn giản như vậy. Một bên là công cụ chạy ngay trong trình duyệt, có thể tự thao tác trên trang web chỉ trong vài giây. Bên còn lại là một mạng proxy với dấu chân IP mà hầu hết các nhà mạng cũng phải nể. Dù vậy, người ta vẫn thường đặt hai cái tên này cạnh nhau, vì cả hai đều trả lời cùng một câu hỏi cốt lõi: làm sao lấy dữ liệu từ web mà không phải tốn cả tuần cuộc đời cho việc đó?
Tôi đã dành khá nhiều năm đi qua cả hai thế giới: một bên là “xây hạ tầng”, một bên là “cứ đưa tôi dữ liệu là được” — trước ở Automation Anywhere, sau ở Jet.com, và giờ là khi vận hành Thunderbit. Vì vậy tôi hiểu vì sao nhiều người thấy khó chọn. Nó hơi giống so sánh một công ty chuyển nhà với một bộ thùng carton chuyển nhà — cả hai đều giúp đồ đạc đi từ điểm A đến điểm B, nhưng một bên là dịch vụ, còn bên kia là công cụ để bạn tự xây quy trình của mình. Hãy cùng làm rõ bạn thực sự cần gì, vì tôi đảm bảo nó không mù mờ như những gì các trang marketing thể hiện.
Câu trả lời nhanh
Nếu muốn tóm tắt ngắn gọn trước khi đi sâu: Thunderbit là một web scraper theo kiểu agentic, không cần code — bạn mở một trang, nhấn One Click Extract, và công cụ sẽ tự nhận diện trường dữ liệu, rồi xuất ra dữ liệu có cấu trúc; bên cạnh đó còn có Web App, Open API, MCP Server và CLI cho ai muốn đi sâu hơn. Oxylabs là hạ tầng scraping cho doanh nghiệp — gồm mạng proxy, Web Scraper API và Web Unblocker, được thiết kế cho các đội kỹ thuật đang tự xây pipeline dữ liệu của riêng họ ở quy mô lớn.
Không bên nào “tốt hơn” một cách tuyệt đối. Tất cả phụ thuộc vào việc bạn đang làm việc gì — một nhân sự kinh doanh cần bảng tính trước thứ Sáu, hay một data engineer chịu trách nhiệm giữ pipeline scraping chạy ổn định qua hàng triệu request mỗi tháng.
Nhìn nhanh
Trước khi đi vào từng tính năng, đây là cách tôi sẽ đặt hai sản phẩm này cạnh nhau:
| Hạng mục | Thunderbit | Oxylabs |
|---|---|---|
| Người dùng chính | Sales, vận hành, nghiên cứu, đội không kỹ thuật, và developer qua API/MCP | Data engineer, backend team, doanh nghiệp |
| Thiết lập | Cài tiện ích mở rộng trình duyệt, mở trang | Đăng ký, tạo API credential, viết logic request |
| Lớp trích xuất | Agentic — AI đọc trang và suy ra trường dữ liệu | Do developer định nghĩa — bạn tự parse và cấu trúc phản hồi |
| Chống bot/rendering | Tự động xử lý trên các trang được hỗ trợ và được phép truy cập | Xử lý qua Web Unblocker hoặc cấu hình ở lớp proxy |
| Đầu ra | Bảng/dòng dữ liệu, xuất sang Sheets, Airtable, Notion | HTML thô hoặc JSON có cấu trúc cho các target được hỗ trợ |
| Mô hình mở rộng | Dựa trên credit, theo tác vụ | Dựa trên băng thông (GB) và số lượng request |
| Bảo trì | Thấp — logic trích xuất tự thích ứng với trang | Liên tục — bạn phải tự lo retry, xoay proxy, bảo trì parser |
| Quản trị | Chỉ với các trang được phép và tương thích; tuân thủ do người dùng chủ động | Tương tự — việc sử dụng hợp pháp, được phép là trách nhiệm của khách hàng |
Thunderbit là gì?
Thunderbit là thứ tôi gọi là một agentic web scraper — nhấn mạnh vào “agentic”, vì điểm mấu chốt là bạn không phải tự viết selector hay dựng schema bằng tay. Bạn mở một trang mà mình có quyền truy cập, nhấn One Click Extract, và agent sẽ tự phát hiện, đọc và phân tích trang. Nó sẽ đề xuất các trường dữ liệu phù hợp với đúng trang đó, rồi nút Run Now xuất hiện — nhưng đây là chỗ nhiều người bỏ lỡ: bạn thậm chí không cần bấm. Nếu không làm gì cả, quá trình trích xuất vẫn tự bắt đầu.
Đó là một quy trình hoàn toàn khác so với kiểu thiết lập nhiều bước mà một số công cụ scraping đời đầu từng dùng, và nhiều bài đánh giá cũ có thể vẫn đang mô tả như vậy. Chúng tôi đã xây lại theo một hành động duy nhất, có chủ đích, vì thật lòng mà nói, chẳng ai muốn làm cả một nghi thức 5 bước chỉ để lấy một bảng giá từ một trang web.

Ngoài trích xuất một chạm, bạn còn có thể tinh chỉnh kết quả bằng ngôn ngữ tự nhiên (ví dụ: "chỉ hiển thị các tin đăng trong 30 ngày gần đây"), làm giàu dữ liệu từ các trang con khi cấu trúc website cho phép, và xuất thẳng sang Google Sheets, Airtable hoặc Notion. Nếu bạn là developer và muốn bỏ qua hoàn toàn trình duyệt, Thunderbit còn có Open API để truy cập bằng chương trình, Thunderbit MCP Server để kết nối trích xuất với Claude, Cursor hoặc các host AI khác, và bộ Thunderbit CLI và Skills cho workflow chạy trên terminal hoặc tác tử lập trình. Vẫn là cùng một “trí thông minh” trích xuất phía sau, chỉ khác là được mở ra qua con đường phù hợp với công việc của bạn.
Nếu muốn hiểu rõ hơn cách cả nhóm sản phẩm này hoạt động, bạn có thể xem thêm bài phân tích của chúng tôi về AI web scraping và web scraping không cần code — cả hai đều đi sâu hơn vào cơ chế vận hành mà tôi không có đủ chỗ để trình bày hết ở đây.
Oxylabs là gì?
Oxylabs là một câu chuyện hoàn toàn khác, và công bằng mà nói, họ cũng không thật sự định cạnh tranh với Thunderbit theo kiểu “nhấn là lấy”. Trang bảng giá hiện tại của họ liệt kê nhiều sản phẩm riêng biệt: Web Scraper API, Web Unblocker và một nhóm proxy network (residential, mobile, datacenter, ISP).
Web Scraper API là thứ gần nhất với một “sản phẩm scraping” — giá khởi điểm từ $49/tháng, xử lý render JavaScript và trả về JSON đã phân tích hoặc có cấu trúc cho những target được hỗ trợ như công cụ tìm kiếm, website thương mại điện tử và nền tảng du lịch. Web Unblocker giống một lớp truy cập hơn: nó tự quản lý fingerprint trình duyệt, cookie, lựa chọn proxy và cơ chế retry, được thiết kế để vượt qua các lớp chống bot khó nhằn trên những target được bảo vệ — nhưng nó chỉ trả lại phản hồi trang, chứ không phải một bảng sạch sẽ. Phần parse vẫn do bạn tự làm.
Rồi còn các sản phẩm proxy thuần túy, đúng như tên gọi: các pool IP residential, mobile hoặc datacenter mà bạn thuê theo gigabyte, và giả định rằng bạn đã có sẵn browser automation, parsing và pipeline lưu trữ của riêng mình. Đây là hạ tầng đúng nghĩa — bạn không mua kết quả hoàn chỉnh, bạn đang mua hệ thống ống dẫn.
Khác biệt cốt lõi: Dữ liệu kinh doanh đã trích xuất vs hạ tầng truy xuất
Ai là người định nghĩa schema và trường dữ liệu?
Với Thunderbit, agent nhìn vào trang và đề xuất các trường — tên sản phẩm, giá, đánh giá, hay bất cứ thứ gì thực sự xuất hiện trên trang — rồi bạn chỉnh lại bằng ngôn ngữ tự nhiên. Với Oxylabs, trừ khi bạn dùng parser riêng cho từng target trong Web Scraper API, bạn sẽ phải tự định nghĩa schema. Điều đó không có nghĩa là Oxylabs kém hơn; chỉ là cách phân chia công việc hoàn toàn khác. Một công cụ giả định rằng bạn không muốn bận tâm đến schema. Công cụ còn lại giả định rằng bạn có quan điểm rõ ràng về schema và có thời gian kỹ thuật để triển khai nó.
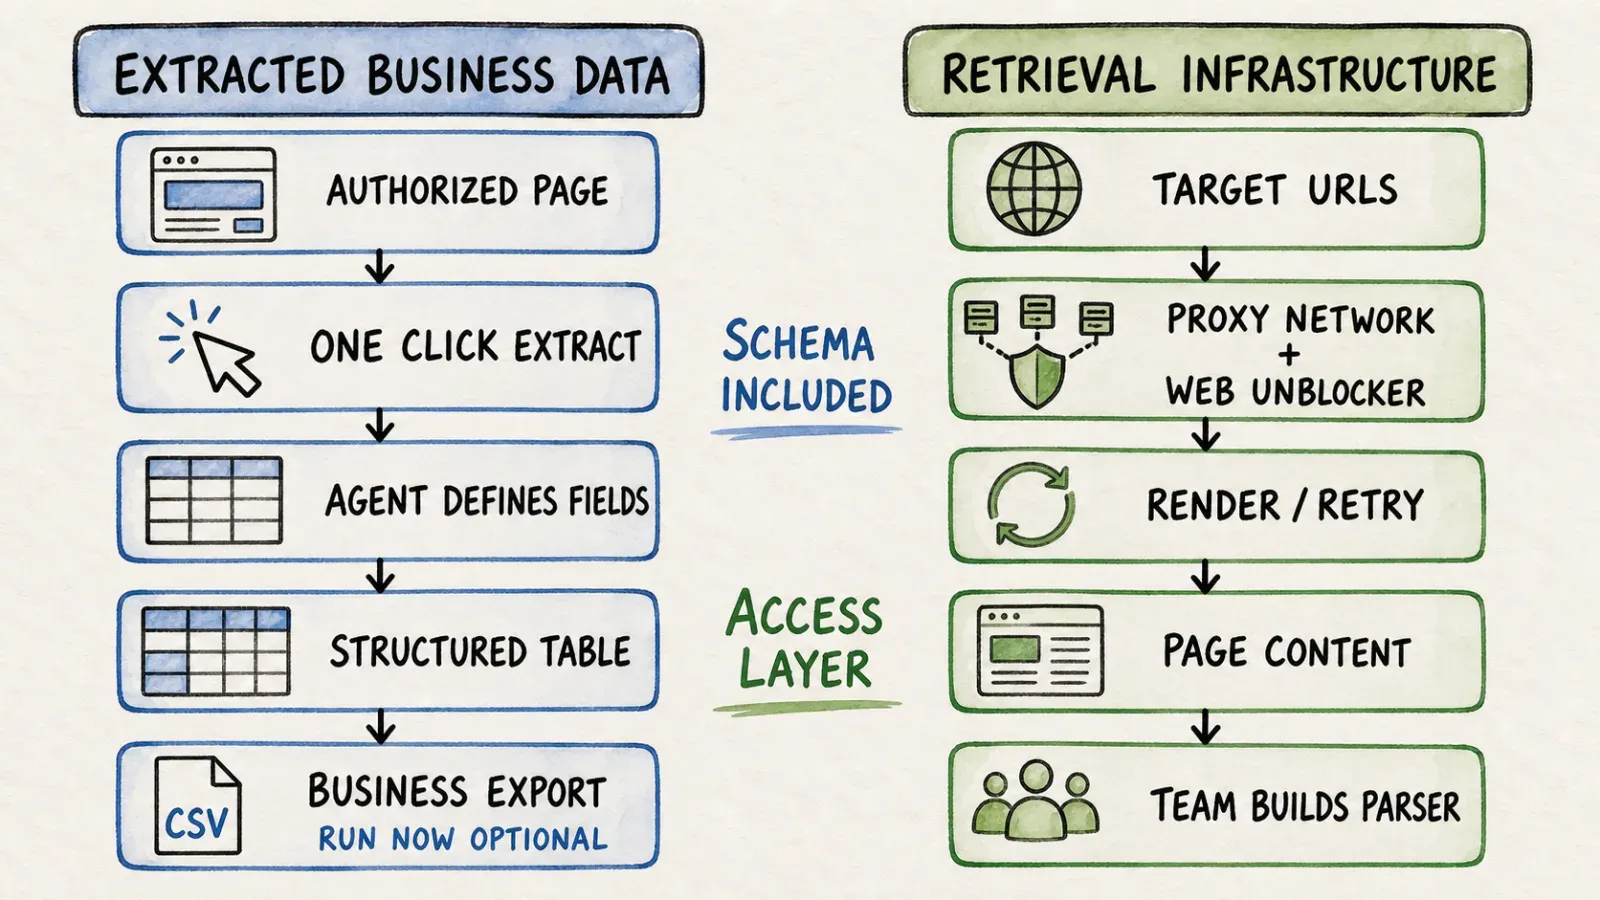
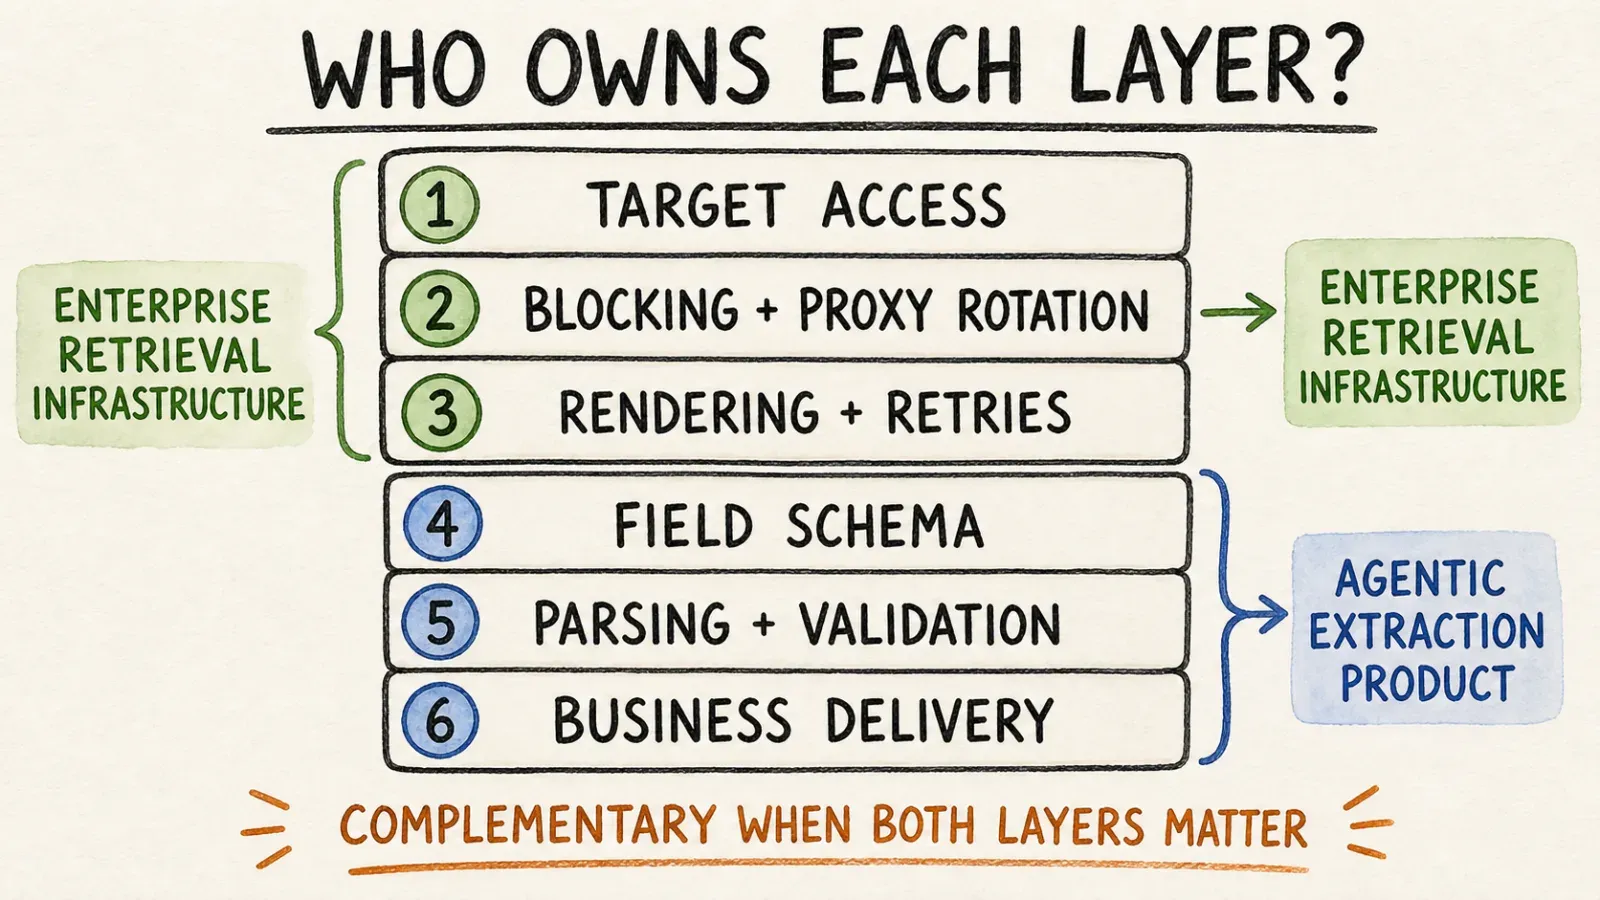
Ai xử lý chặn, render và xoay proxy?
Thunderbit tự xử lý rendering và truy cập trên các trang được hỗ trợ, được phép như một phần của luồng trích xuất — bạn không cần cấu hình riêng một sản phẩm proxy nào cả. Oxylabs tách hẳn điều đó thành một lớp riêng: Web Unblocker tồn tại chính vì việc vượt qua các hệ thống chống bot tinh vi đủ khó để trở thành một sản phẩm độc lập, với bảng giá và tài liệu riêng. Nếu các website mục tiêu của bạn chặn rất gắt, lớp unblocking chuyên dụng đó thực sự là một điểm mạnh của Oxylabs — vì nó được tạo ra bởi những người nghĩ về fingerprint và quản lý session cả ngày.
Ai chịu trách nhiệm monitoring và parse dữ liệu đầu ra?
Đây là chỗ khác biệt giữa “hạ tầng” và “kết quả hoàn chỉnh” lộ rõ nhất. Với Oxylabs, khi bạn nhận được phản hồi — dù là HTML thô từ Web Unblocker hay JSON có cấu trúc từ target được Web Scraper API hỗ trợ — bạn hoặc đội của bạn phải lo mọi thứ phía sau: kiểm tra dữ liệu, lưu trữ, lập lịch, xử lý lỗi, và cảnh báo khi có sự cố lúc 2 giờ sáng. Với Thunderbit, gánh nặng này nhẹ hơn nhiều vì bước trích xuất và bước cấu trúc dữ liệu diễn ra cùng lúc, và dữ liệu có thể xuất thẳng vào các công cụ mà đội bạn đã quen dùng.
Quy trình so sánh trực tiếp
Số bước không biết nói dối, nên hãy cùng đếm thật sự thay vì chỉ nói bên nào “dễ hơn”.
Tác vụ một lần: từ trang web sang bảng dữ liệu:
| Bước | Thunderbit | Oxylabs |
|---|---|---|
| 1 | Cài Thunderbit Chrome Extension, mở trang mục tiêu | Đăng ký, tạo API credentials |
| 2 | Nhấn One Click Extract | Cấu hình request payload (target, render, tham số geolocation) |
| 3 | Agent phân tích trang và đề xuất trường dữ liệu | Gửi request, xử lý tham số proxy/rendering |
| 4 | Run Now xuất hiện — nhưng là tùy chọn, vì việc trích xuất đã tự chạy | Parse phản hồi, tự xây logic retry và xoay proxy |
| 5 | Xuất sang Sheets/Airtable/Notion | Tự lưu, kiểm tra và cấu trúc đầu ra |
Với một người dùng kinh doanh chỉ cần bảng giá đối thủ hoặc danh sách khách hàng tiềm năng, Thunderbit gần như là một công việc một chạm, trong khi Oxylabs là một tác vụ phát triển nhỏ. Điều đó không phải là chê Oxylabs — vì ngay từ đầu họ vốn không được xây để bỏ qua bước kỹ thuật. Họ được xây để cung cấp cho kỹ sư một nền tảng đáng tin cậy để xây tiếp lên trên.
Hệ thống crawl/thu thập dữ liệu quy mô lớn, lặp đi lặp lại: ở đây cán cân đảo chiều. Nếu bạn đang kéo hàng triệu trang mỗi tháng, qua hàng chục khu vực địa lý, với yêu cầu SLA chặt chẽ, thì độ sâu proxy và cấu trúc hỗ trợ doanh nghiệp của Oxylabs bắt đầu trở nên quan trọng hơn sự tiện lợi của một cú nhấp chuột. Đây là sân nhà thực sự của họ.
Tích hợp AI agent qua API hoặc MCP: nếu bạn đang nối việc trích xuất vào workflow Claude hoặc Cursor, bạn có thể dùng Thunderbit MCP Server cho trích xuất có cấu trúc do agent kích hoạt, hoặc dùng Scraper API của Oxylabs nếu thứ agent thực sự cần là truy cập thô và unblocking, chứ không phải kết quả có cấu trúc hoàn chỉnh. Cả hai đều hợp lý, tùy mục đích của agent sau khi có dữ liệu.
Ai thực sự phù hợp với ai
Tôi thích mô tả theo persona hơn là những đoạn văn mơ hồ kiểu “sản phẩm này dành cho ai”, vì kiểu viết mơ hồ chính là nơi các trang marketing thích ẩn mình.
| Persona | Phù hợp hơn | Vì sao |
|---|---|---|
| Sales/marketing ops, người dùng kinh doanh không code | Thunderbit | Trích xuất bằng nhấp chuột, xuất thẳng sang Sheets/Airtable/Notion, không phải bảo trì gì |
| Data engineer xây pipeline scraping ở quy mô lớn | Oxylabs | Proxy pool sâu, hạ tầng chuyên dụng, mở rộng theo băng thông |
| Developer xây workflow AI-agent | Cả hai, tùy bài toán | Thunderbit có Open API/MCP cho trích xuất có cấu trúc; Oxylabs có Scraper API cho truy cập thô/unblocking |
| Doanh nghiệp cần độ đa dạng IP cực lớn | Oxylabs | Dấu chân proxy residential là thế mạnh cốt lõi |
Nếu phải gói gọn trong một câu: Thunderbit trả lời câu hỏi “làm sao tôi lấy được dữ liệu dùng ngay bây giờ,” còn Oxylabs trả lời câu hỏi “làm sao tôi xây một hệ thống cứ tiếp tục lấy dữ liệu mãi.”
Độ chính xác, chống bot và bảo trì
Không công cụ nào là phép màu, và tôi sẽ không nói khác đi. Trích xuất theo kiểu agentic của Thunderbit hoạt động rất tốt trên các trang tương thích và được phép mà nó được thiết kế cho — nhưng đây là một điều kiện quan trọng, không phải chi tiết marketing nhỏ lẻ. Nó không phải là lời hứa vượt qua mọi CAPTCHA, mọi tường đăng nhập hay mọi lớp chống tự động hóa trên internet. Web Unblocker của Oxylabs được thiết kế chuyên biệt để xử lý những target khó hơn như vậy, với quản lý fingerprint và session tự động, và đó là một chuyên môn rất đáng trân trọng.
Tuy vậy, câu chuyện bảo trì mới là chỗ khoảng cách bắt đầu nới rộng. Cách Thunderbit diễn giải trường dữ liệu tự thích nghi khi trang thay đổi, nên giảm đáng kể công chăm sóc mà scraper truyền thống thường cần. Oxylabs thì chuyển trách nhiệm đó sang bạn — retry, logic xoay proxy, cập nhật parser khi website đổi cấu trúc HTML. Đó chính là đánh đổi khi bạn tự sở hữu hạ tầng: kiểm soát nhiều hơn, trách nhiệm cũng nhiều hơn.
Một điều mà cả hai công ty đều sẽ — và nên — đồng ý: chỉ thu thập những gì bạn được phép truy cập, và tôn trọng điều khoản của website mục tiêu cũng như luật áp dụng. Không một AI agent hay mạng proxy nào biến scraping trái phép thành hợp pháp.
Chi phí và tổng chi phí sở hữu
Đây là chỗ mà tôi nghĩ nhiều bài so sánh làm quá hời hợt — họ chỉ copy vài con số trên trang giá rồi coi như xong. Hãy thử đặt một kịch bản cụ thể lên bàn.
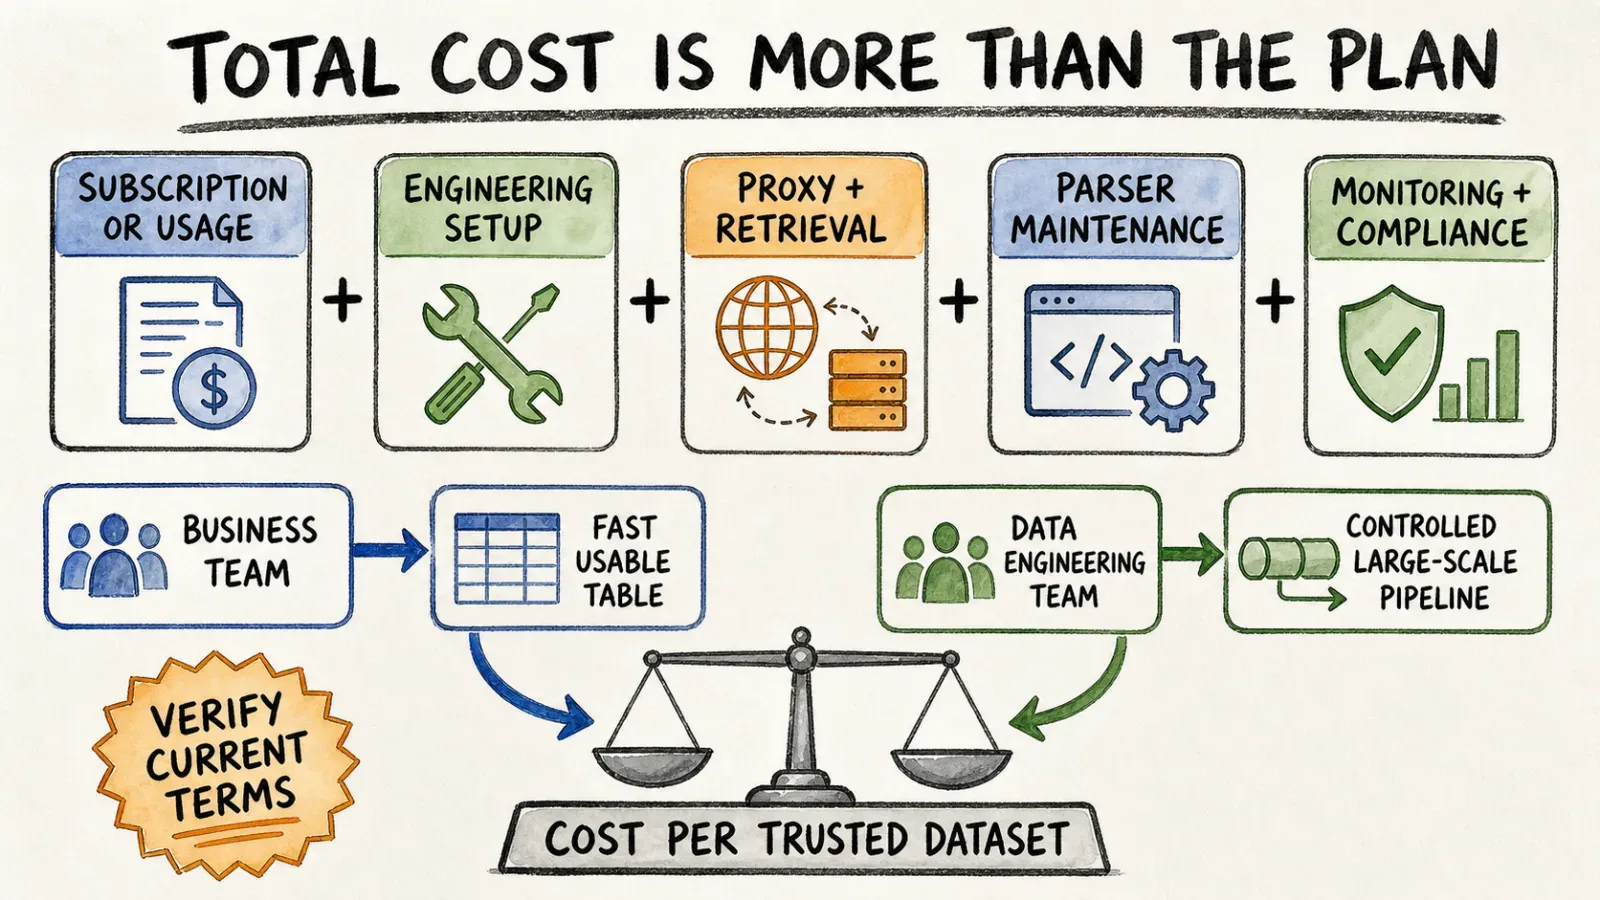
Giả sử bạn cần thu thập 5.000 danh sách sản phẩm mỗi tháng từ một trang danh mục thương mại điện tử, và cập nhật hàng tuần. Với Web Scraper API của Oxylabs, giá khởi điểm khoảng $49/tháng, bạn trả theo kết quả và request; nếu cần lớp truy cập khó hơn, các gói Web Unblocker dao động từ gói Micro $75/tháng cho 8GB đến gói Advanced $660/tháng cho 88GB (giá niêm yết thông thường, chưa tính coupon tạm thời). Vấn đề là mức dùng GB không tăng đều và dễ đoán — một trang có render JavaScript nặng có thể “đốt” băng thông nhanh hơn nhiều so với trang tĩnh nhẹ, và tài liệu billing của Oxylabs còn nêu rõ rằng cả traffic request lẫn response đều được tính vào hóa đơn, thậm chí một số phản hồi 4xx cũng vẫn bị tính phí.
Trong khi đó, Thunderbit dùng mô hình credit gắn với tác vụ trích xuất, thay vì băng thông thô — vì thế một job trích xuất 5.000 dòng về cơ bản sẽ có chi phí tương đương một job 5.000 dòng, bất kể trang gốc nặng JavaScript đến mức nào. Đây là một tư duy hoàn toàn khác: một bên tính như hóa đơn tiện ích, bên kia tính như thuê bao dịch vụ.
Tôi sẽ nói điều hiển nhiên mà mọi bài so sánh tử tế nên nói: bảng giá thay đổi liên tục, coupon đến rồi đi, và tên gói cũng bị sắp xếp lại. Hãy kiểm tra trực tiếp giá hiện tại của Thunderbit và trang giá của Oxylabs trước khi lập ngân sách, đồng thời tính cả thời gian kỹ thuật của chính bạn — một mức giá GB “rẻ” không hề rẻ nếu mỗi tháng phải mất hai ngày dev để giữ pipeline sống sót.
Người dùng thực tế nói gì
Tôi không muốn chỉ vẫy cờ cho đội của mình ở đây, vì điều đó chẳng giúp ích gì cho người đang nghiên cứu nghiêm túc. Các trang đánh giá như G2 thường cho thấy Oxylabs được chấm cao về hỗ trợ tài khoản chuyên biệt và độ tin cậy cấp doanh nghiệp — điều này rất khớp, vì đó chính xác là kiểu quan hệ khách hàng bạn sẽ kỳ vọng ở một công ty bán hạ tầng cho các đội kỹ thuật có SLA phải đảm bảo. Nếu doanh nghiệp của bạn phụ thuộc vào việc pipeline scraping không bao giờ ngừng, thì một đội hỗ trợ phản hồi nhanh thực sự đáng tiền.
Ngược lại, tín hiệu về mức độ dễ dùng và tốc độ đạt giá trị thường nghiêng về các công cụ được xây quanh template và trích xuất theo tác vụ hơn là cấu hình API thuần túy — và đó là “làn đường” của Thunderbit. Sản phẩm khác nhau, tiêu chí đánh giá khác nhau, và thật ra cả hai điều đó đều đúng cùng lúc mà không hề mâu thuẫn.
Ai nên chọn Thunderbit?
Hãy chọn Thunderbit nếu bạn làm trong sales, ops, research hoặc marketing, và cần dữ liệu có cấu trúc từ một trang web mà không phải chờ sprint từ đội kỹ thuật. Đây cũng là lựa chọn tốt cho developer muốn trích xuất thông qua AI-agent mà không phải tự xây từ đầu toàn bộ stack proxy và parser — bạn có sẵn Open API, MCP Server và CLI khi cần, mà vẫn giữ được tuỳ chọn nhấp một lần trong trình duyệt cho các tác vụ thủ công nhanh. Nếu bạn muốn xem nó đứng ở đâu so với các công cụ khác trong cùng phân khúc, bài tổng hợp best AI web scrapers của chúng tôi là một điểm bắt đầu khá ổn.
Ai nên chọn Oxylabs?
Hãy chọn Oxylabs nếu bạn là đội kỹ thuật hoặc đội dữ liệu đang vận hành khối lượng thu thập dữ liệu lớn, bị bảo vệ, và có tính production — kiểu công việc cần geotargeting, kiểm soát session, và một proxy pool đủ sâu để chịu được rate limit gắt. Nếu tổ chức của bạn đã tự sở hữu lớp orchestration, parsing và lưu trữ, và chỉ cần truy cập ổn định ở quy mô lớn, thì hạ tầng của Oxylabs sinh ra chính xác cho bài toán đó.
Hai bên có thể dùng cùng nhau không?
Về lý thuyết là có — một doanh nghiệp có thể dùng Oxylabs cho lớp truy cập thô và unblocking ở tầng hạ tầng, trong khi các đội cá nhân dùng một công cụ như Thunderbit để trích xuất nhanh, có cấu trúc trên các nguồn dữ liệu được phép. Tuy nhiên, tôi muốn nói rõ ở đây: tôi không biết có tích hợp chính thức nào giữa hai sản phẩm này, và tôi không muốn thổi phồng một mối quan hệ đối tác không tồn tại. Hãy nghĩ về nó không phải là “hai sản phẩm này gắn vào nhau”, mà là “hai sản phẩm này có thể cùng tồn tại ở các lớp khác nhau trong stack dữ liệu của một công ty” — đó là cách nói trung thực hơn nhiều.
Kết luận
Nếu mục tiêu của bạn là đi từ “trang web” đến “bảng tính dùng được” nhanh nhất có thể, Thunderbit được thiết kế quanh một cú nhấp có chủ đích trên One Click Extract; agent phân tích trang và công việc tự chạy, còn Run Now chỉ là tùy chọn. Cách tiếp cận Web Scraping Without Coding này giúp các đội không kỹ thuật cũng có thể sử dụng. Nếu mục tiêu của bạn là vận hành một hệ thống scraping bền vững, khối lượng lớn, do đội kỹ thuật của bạn hoàn toàn sở hữu và kiểm soát, Oxylabs cung cấp nguyên liệu thô để bạn xây dựng điều đó — độ sâu proxy, khả năng unblocking, và hệ thống hỗ trợ doanh nghiệp để đứng sau.
Tôi không nghĩ có người thắng tuyệt đối trong câu chuyện này, và bất kỳ bài viết nào nói chắc chắn như vậy thì có lẽ đang cố bán cho bạn một thứ gì đó. Hãy chọn dựa trên người sẽ vận hành công cụ hằng ngày — một người dùng kinh doanh muốn có kết quả, hay một kỹ sư muốn có hạ tầng.
Câu hỏi thường gặp
Oxylabs có no-code như Thunderbit không? Không hẳn. Web Scraper API và Web Unblocker của Oxylabs là các sản phẩm dành cho developer — bạn gửi API request và tự xử lý phản hồi. Không có trải nghiệm dùng trình duyệt kiểu nhấp là lấy tương tự như workflow một chạm của Thunderbit.
Thunderbit có API và MCP cho developer không? Có. Bên cạnh tiện ích mở rộng trình duyệt, Thunderbit cung cấp Open API để truy cập bằng chương trình, MCP Server cho các host AI như Claude và Cursor, và CLI cho workflow trên terminal.
Bên nào xử lý target có chống bot mạnh tốt hơn? Web Unblocker của Oxylabs được xây riêng cho các target khó và được bảo vệ, với quản lý fingerprint và session tự động. Thunderbit xử lý rendering và truy cập trên các trang tương thích, được phép như một phần của luồng trích xuất, nhưng không được quảng bá như một sản phẩm chuyên vượt chống bot.
Công cụ nào dễ dùng hơn cho người dùng kinh doanh không kỹ thuật? Thunderbit, vượt trội hơn hẳn. Không cần cấu hình API, không cần thiết kế schema, không cần viết parser — bạn chỉ cần nhấn, agent đề xuất trường dữ liệu, và kết quả xuất sang Sheets, Airtable hoặc Notion.
Nên so sánh giá của Thunderbit với Oxylabs như thế nào? Đừng so sánh các con số tuyệt đối — mô hình khác nhau. Oxylabs chủ yếu tính theo băng thông (GB) và số lượng request, thay đổi theo độ phức tạp của trang và việc render JavaScript. Thunderbit dùng credit gắn với tác vụ trích xuất, nên chi phí ổn định hơn theo từng job. Luôn kiểm tra trang giá của Thunderbit và trang giá của Oxylabs trước khi lập ngân sách.




