
Tóm tắt điều hành
Báo cáo trước đã đặt ra một câu hỏi về chính sách: trong số những website được truy cập nhiều nhất thế giới, có bao nhiêu site đang nói rõ cho các AI crawler biết chúng được phép làm gì và không được làm gì?
Báo cáo tiếp theo này đặt ra câu hỏi vận hành phía sau nó: robots.txt đáng tin cậy đến đâu khi được giao vai trò hạ tầng để gánh chính sách đó?
Câu trả lời khá khó nghe. robots.txt vẫn chạy được vì nó công khai, rẻ, máy đọc được, và các crawler đã quen xử lý nó. Nhưng nó cũng đang bị yêu cầu làm nhiều hơn rất nhiều so với thiết kế ban đầu. Đến năm 2026, cùng một tệp văn bản thuần này có thể chứa quy tắc crawl cho SEO, sitemap index, các phần mở rộng cũ của công cụ tìm kiếm, tùy chọn từ chối huấn luyện AI, từ vựng chính sách do Cloudflare chèn vào, tuyên bố bảo lưu bản quyền, và cả ngôn ngữ pháp lý hướng tới những tranh chấp trong tương lai.
Đó là nợ cấu hình.
Bộ dữ liệu phía sau báo cáo này vẫn là cùng Tranco Top 10,000 crawl đã dùng trong nghiên cứu AI crawler ban đầu. Trong 10.000 domain, 6.638 domain trả về một robots.txt có thể đọc được; thêm 610 domain trả về 404, và theo giao thức thì điều đó được xem là cho phép ngầm định. Như vậy có 7.248 website có thể phân tích để xem quyết định truy cập bot, và 6.638 tệp cụ thể để phân tích độ phức tạp cấu hình.
Sáu phát hiện nổi bật:
-
Phần lớn tệp
robots.txtvẫn nhỏ, nhưng phần đuôi bên phải thì rất phức tạp. Trung vị của tệp chỉ là 834 byte và 31 dòng. Nhưng có 1.005 tệp ít nhất 5 KB, 273 tệp ít nhất 20 KB, và 28 tệp ít nhất 100 KB. Tệp lớn nhất trong mẫu là 248 KB. -
Hàng trăm website lớn đang vận hành những tệp gần giống cấu hình sản xuất hơn là ghi chú chính sách. Trung vị của tệp có 9 chỉ thị
Disallow. Nhưng có 707 site có ít nhất 100 quy tắcDisallow, 13 site có ít nhất 1.000, 240 site nêu ít nhất 50 user agent, và 110 site nêu ít nhất 100 user agent. -
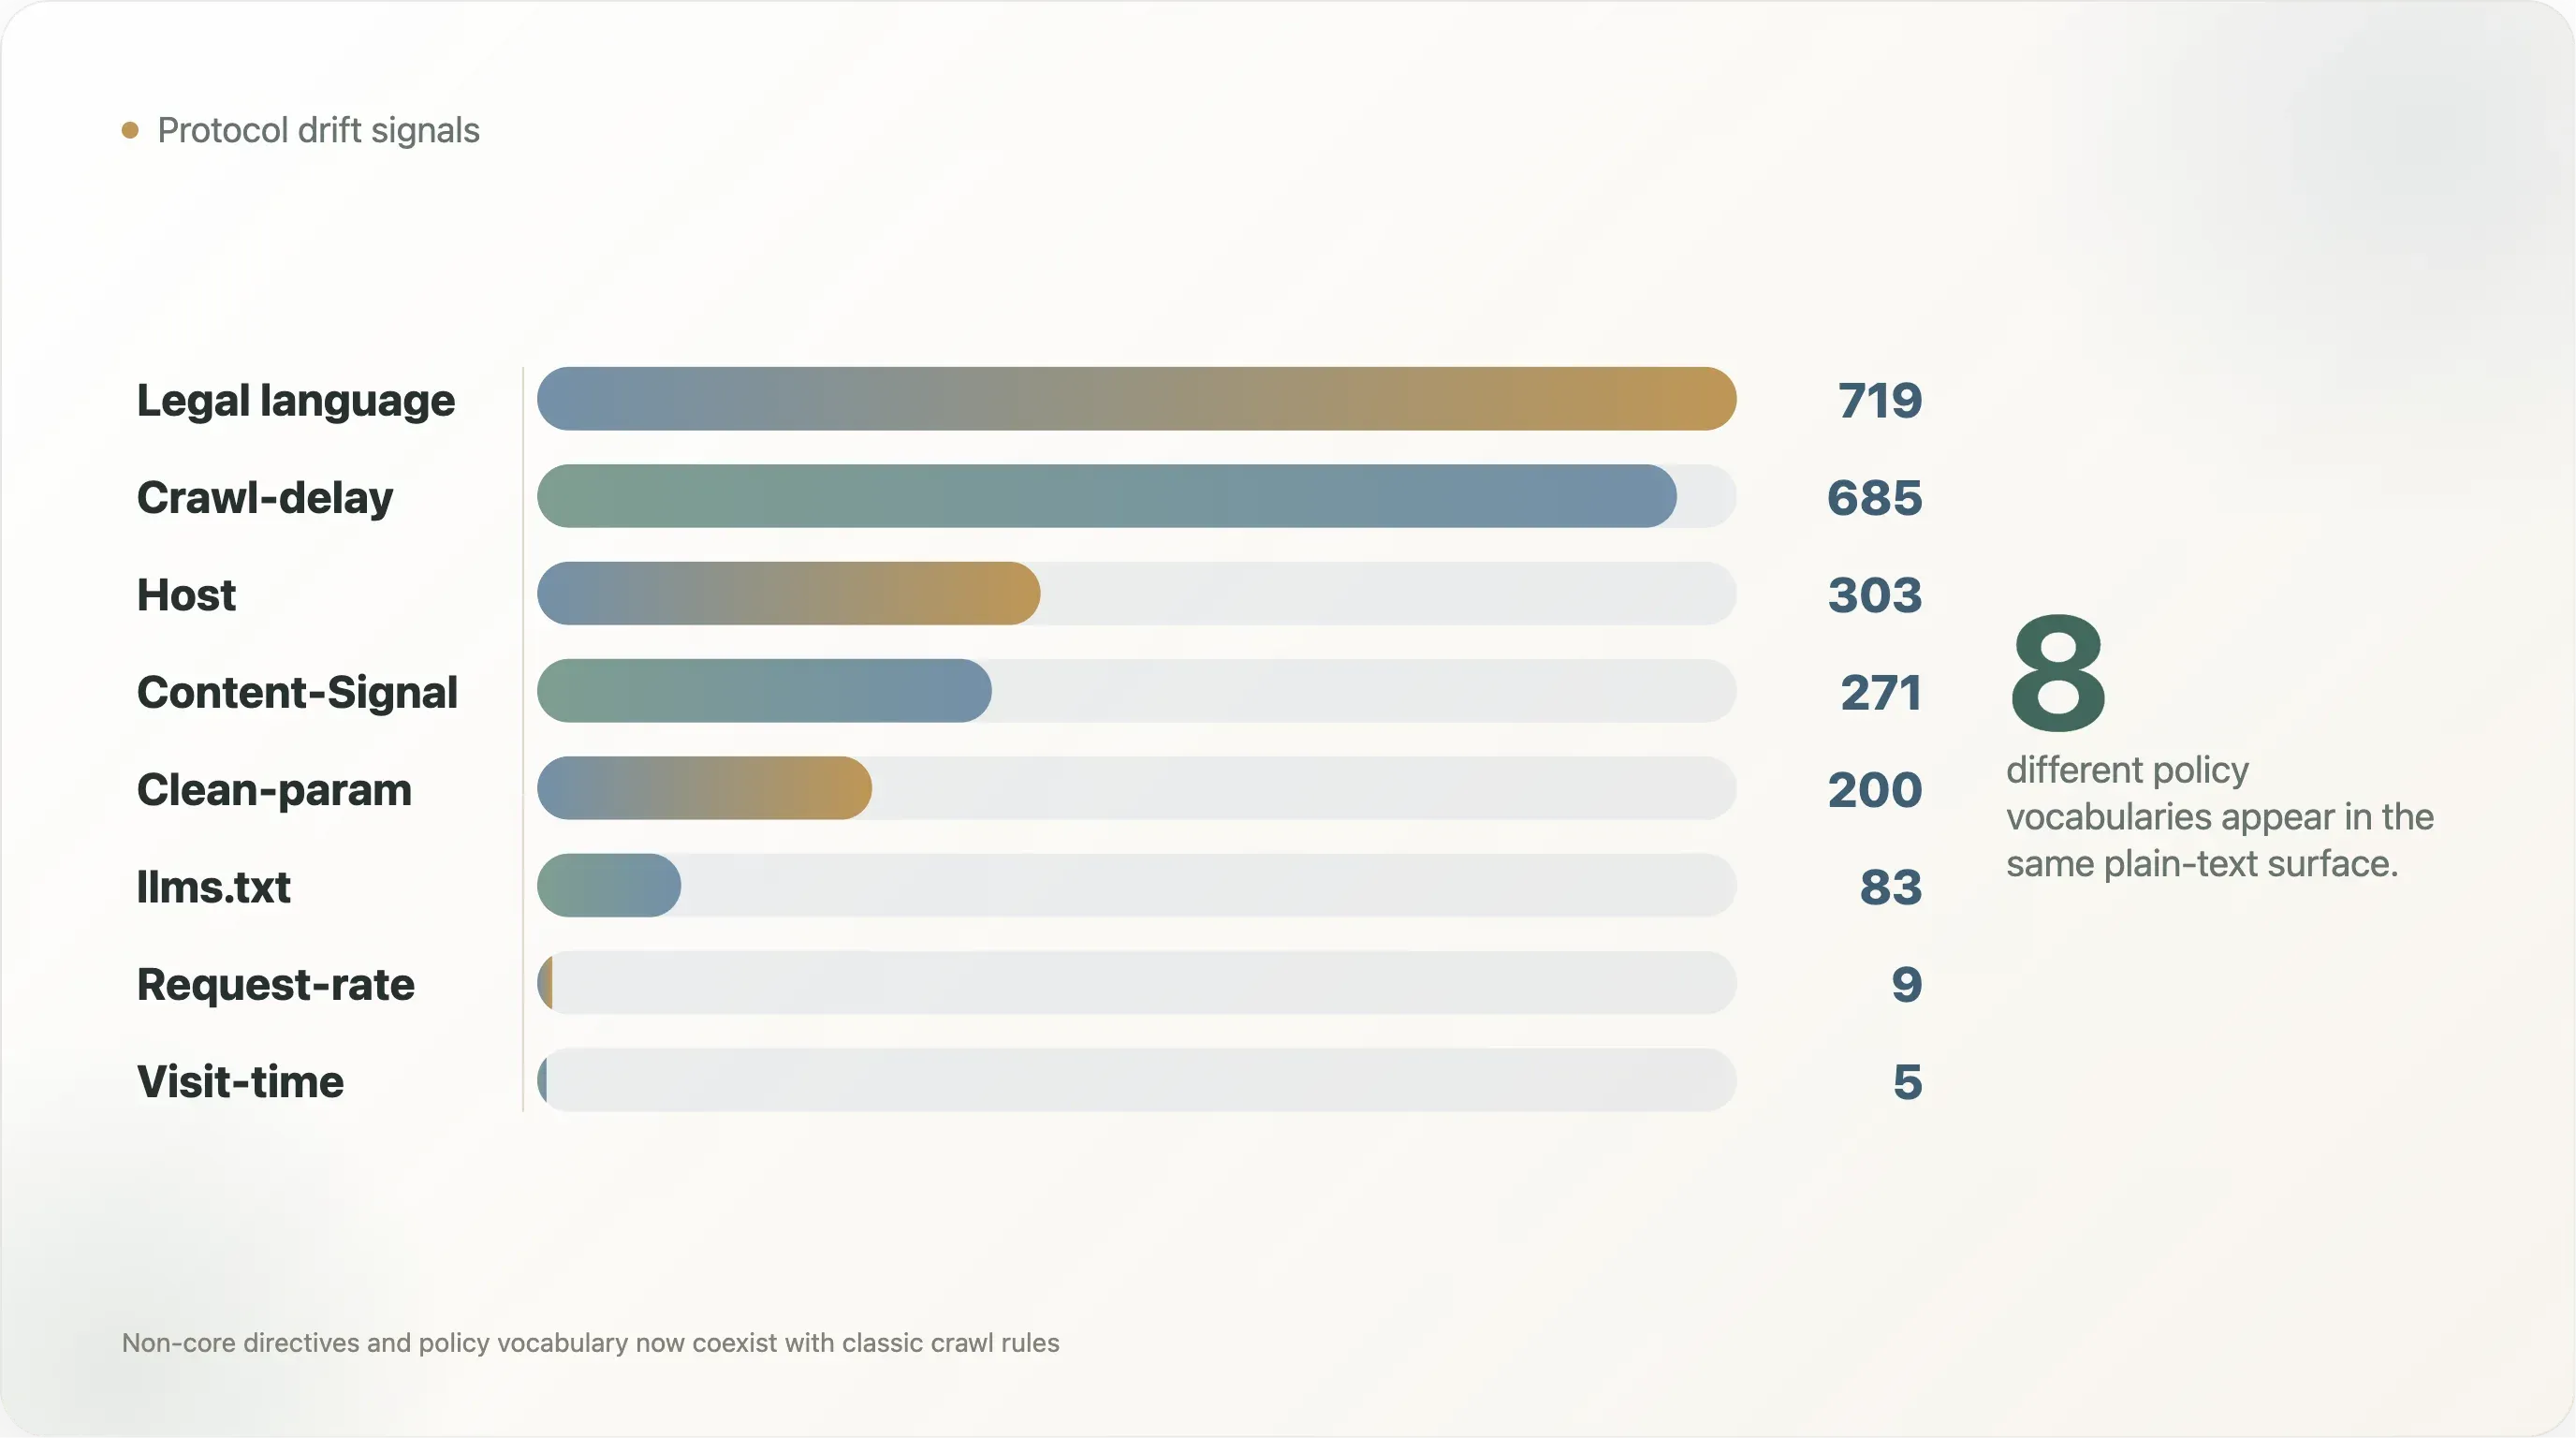
Sự trôi dạt của giao thức không phải chuyện lý thuyết. Trong 6.638 tệp đọc được, 685 tệp có
Crawl-delay, 303 tệp cóHost, 200 tệp cóClean-param, 9 tệp cóRequest-rate, 5 tệp cóVisit-time, và 271 tệp có ngôn ngữContent-Signalkiểu Cloudflare. Đây không phải tất cả đều thuộc cùng một chuẩn sạch sẽ. Chúng là folklore tích lũy của crawler. -
Googlebot được đối xử như một công dân đặc biệt. Có 562 domain phân tích được và chặn ít nhất một crawler tìm kiếm truyền thống. Trong 404 trường hợp đó, Googlebot được cho phép trong khi ít nhất một crawler tìm kiếm khác bị chặn. Phân biệt đối xử với AI crawler không xuất hiện trong một hệ sinh thái trung tính;
robots.txtvốn đã mã hóa thứ bậc giữa các công cụ tìm kiếm. -
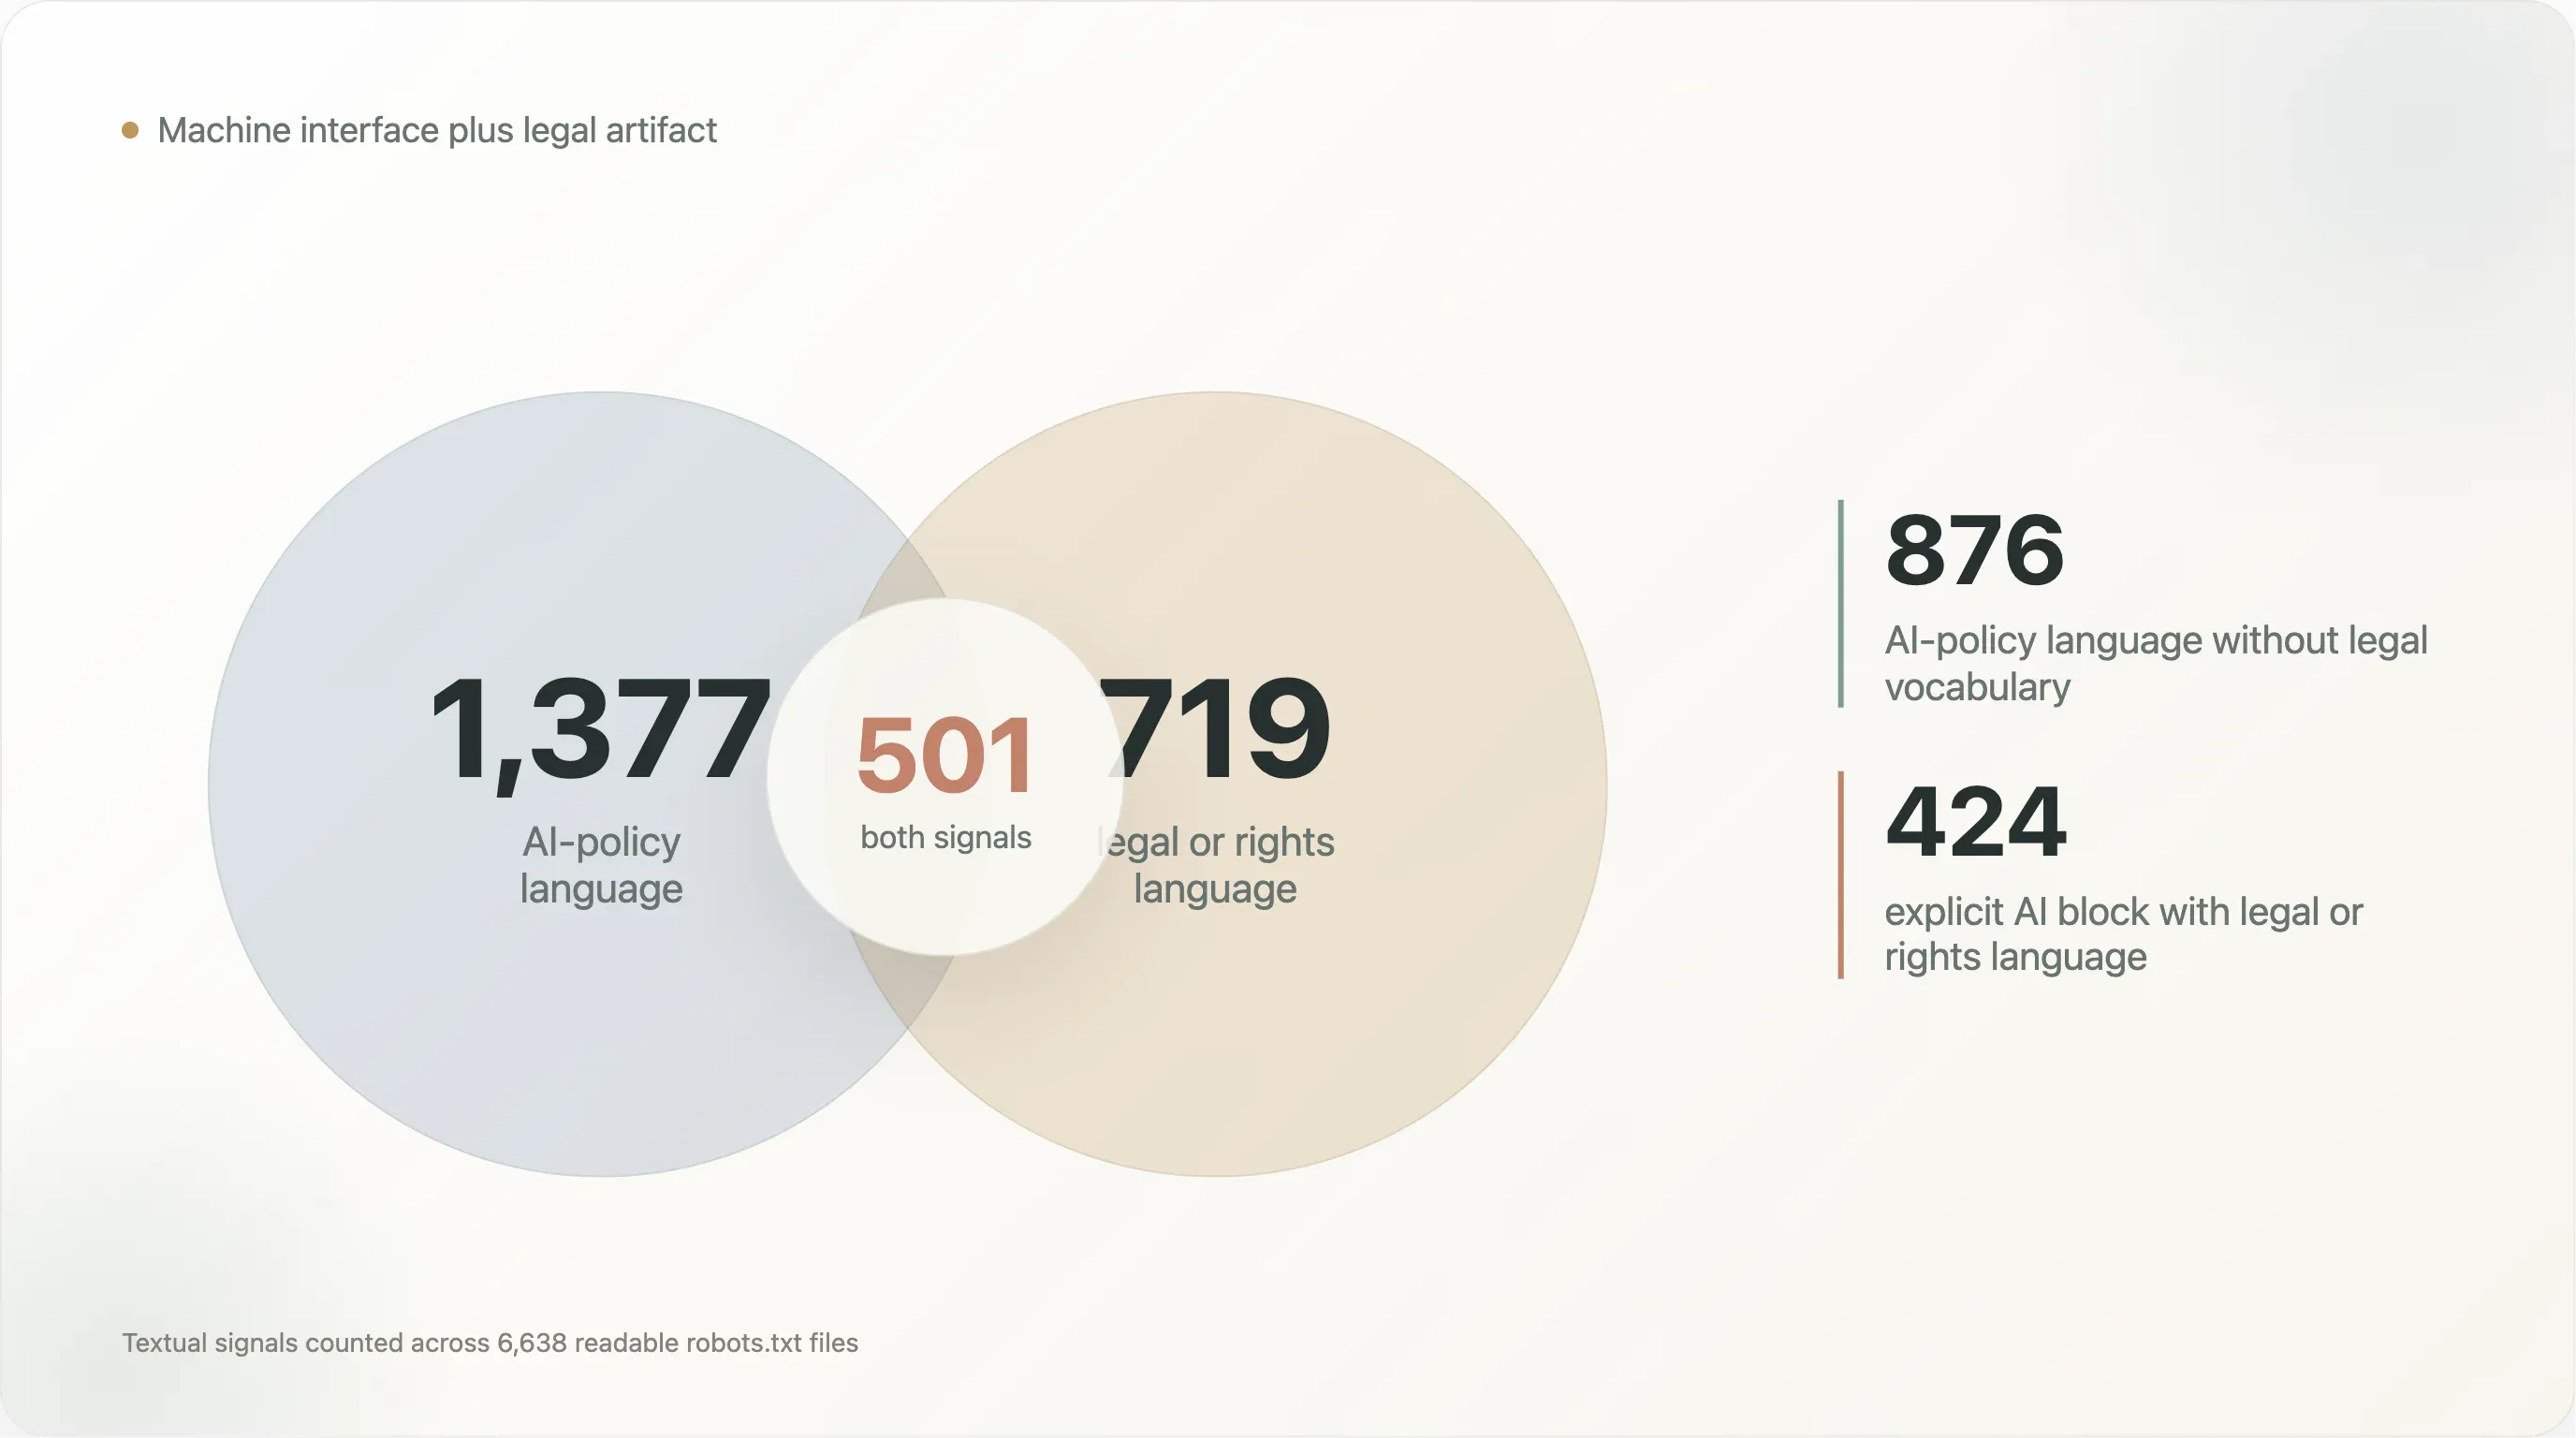
Chính sách AI làm cho khoản nợ này lộ rõ hơn. 1.377 tệp đọc được có ngôn ngữ chính sách AI; 719 tệp có ngôn ngữ về bản quyền, điều khoản, cấp phép hoặc quyền hạn; và 501 tệp có cả hai. Tệp này giờ vừa là giao diện cho máy, vừa là hiện vật pháp lý. Hữu ích, nhưng mong manh.
-
Những tệp rủi ro nhất không phải lúc nào cũng là những tệp chống AI mạnh nhất. Thương mại điện tử, du lịch, mạng xã hội, tài chính, học thuật và tin tức đều tạo ra các tệp phức tạp vì những lý do khác nhau: kiểm soát ngân sách crawl, đường dẫn cũ, nội dung do người dùng tạo, bảo lưu quyền, và ngoại lệ theo bot. Các quy tắc AI đang được xếp chồng lên một nền vốn đã lộn xộn.
Kết luận chính: robots.txt vẫn là bề mặt chính sách crawler quan trọng nhất của web công khai, nhưng nó là nền tảng yếu cho quản trị AI ở mức rủi ro cao nếu hệ sinh thái không chuẩn hóa danh tính crawler, từ vựng về cách dùng AI, và khả năng kiểm toán chính sách.
Phương pháp
Báo cáo này tái sử dụng bộ dữ liệu từ phân tích AI crawler policy ban đầu của Thunderbit trên 10.000 domain Tranco hàng đầu.
Nguồn đầu vào gồm:
tranco_top10k.csv— danh sách domain Tranco Top 10K gốc.out/fetch_meta.csv— trạng thái fetch, số byte, scheme, kết quả chuyển hướng và siêu dữ liệu lỗi.out/sites.csv— domain, thứ hạng, danh mục, ngôn ngữ và trạng tháirobots.txt.out/site_meta.csv— một dòng phân tích cho mỗi site, bao gồm lớp mẫu, cờ chặn AI, kích thước tệp và các trường tóm tắt policy bot.out/bot_status.csv— một dòng cho mỗi domain và crawler, bao gồm bot đó có bị chặn hay không và có quy tắc cụ thể hay không.raw_robots/— nội dungrobots.txtđược lưu đệm cho 6.638 site trả về trạng thái200.
Cho phần theo dõi này, mỗi tệp robots.txt đọc được đã được quét để tìm:
- kích thước tệp và số dòng;
- các dòng hoạt động không phải chú thích;
- số lượng chỉ thị
User-agent,Disallow,AllowvàSitemap; - các chỉ thị cũ hoặc ngoài lõi như
Crawl-delay,Host,Clean-param,Request-ratevàVisit-time; - từ vựng thời AI bao gồm
Content-Signal,llms.txt, AI, LLM, machine learning, TDM, và2019/790; - từ vựng pháp lý như bản quyền, điều khoản dịch vụ, cấp phép, quyền cho phép và ngôn ngữ bảo lưu quyền;
- cách đối xử với các crawler tìm kiếm Googlebot, Bingbot, DuckDuckBot, Slurp, Baiduspider và YandexBot.
Báo cáo cũng định nghĩa một điểm nợ cấu hình đơn giản để phân loại. Điểm này kết hợp kích thước tệp, số lượng user agent, số lượng Disallow, số lượng Allow, số lượng chỉ thị không chuẩn, và sự pha trộn giữa ngôn ngữ chính sách AI và ngôn ngữ pháp lý. Điểm này không nhằm là thước đo tính đúng đắn phổ quát. Nó là cách để nhận diện những tệp có khả năng khó bảo trì, khó xem xét hoặc khó suy luận.
Tất cả bảng và biểu đồ dẫn xuất đều được bao gồm trong thư mục bàn giao.
Phát hiện 1: Tệp trung vị thì đơn giản; phần đuôi thì không
Tệp robots.txt điển hình trên web hàng đầu vẫn còn nhỏ.
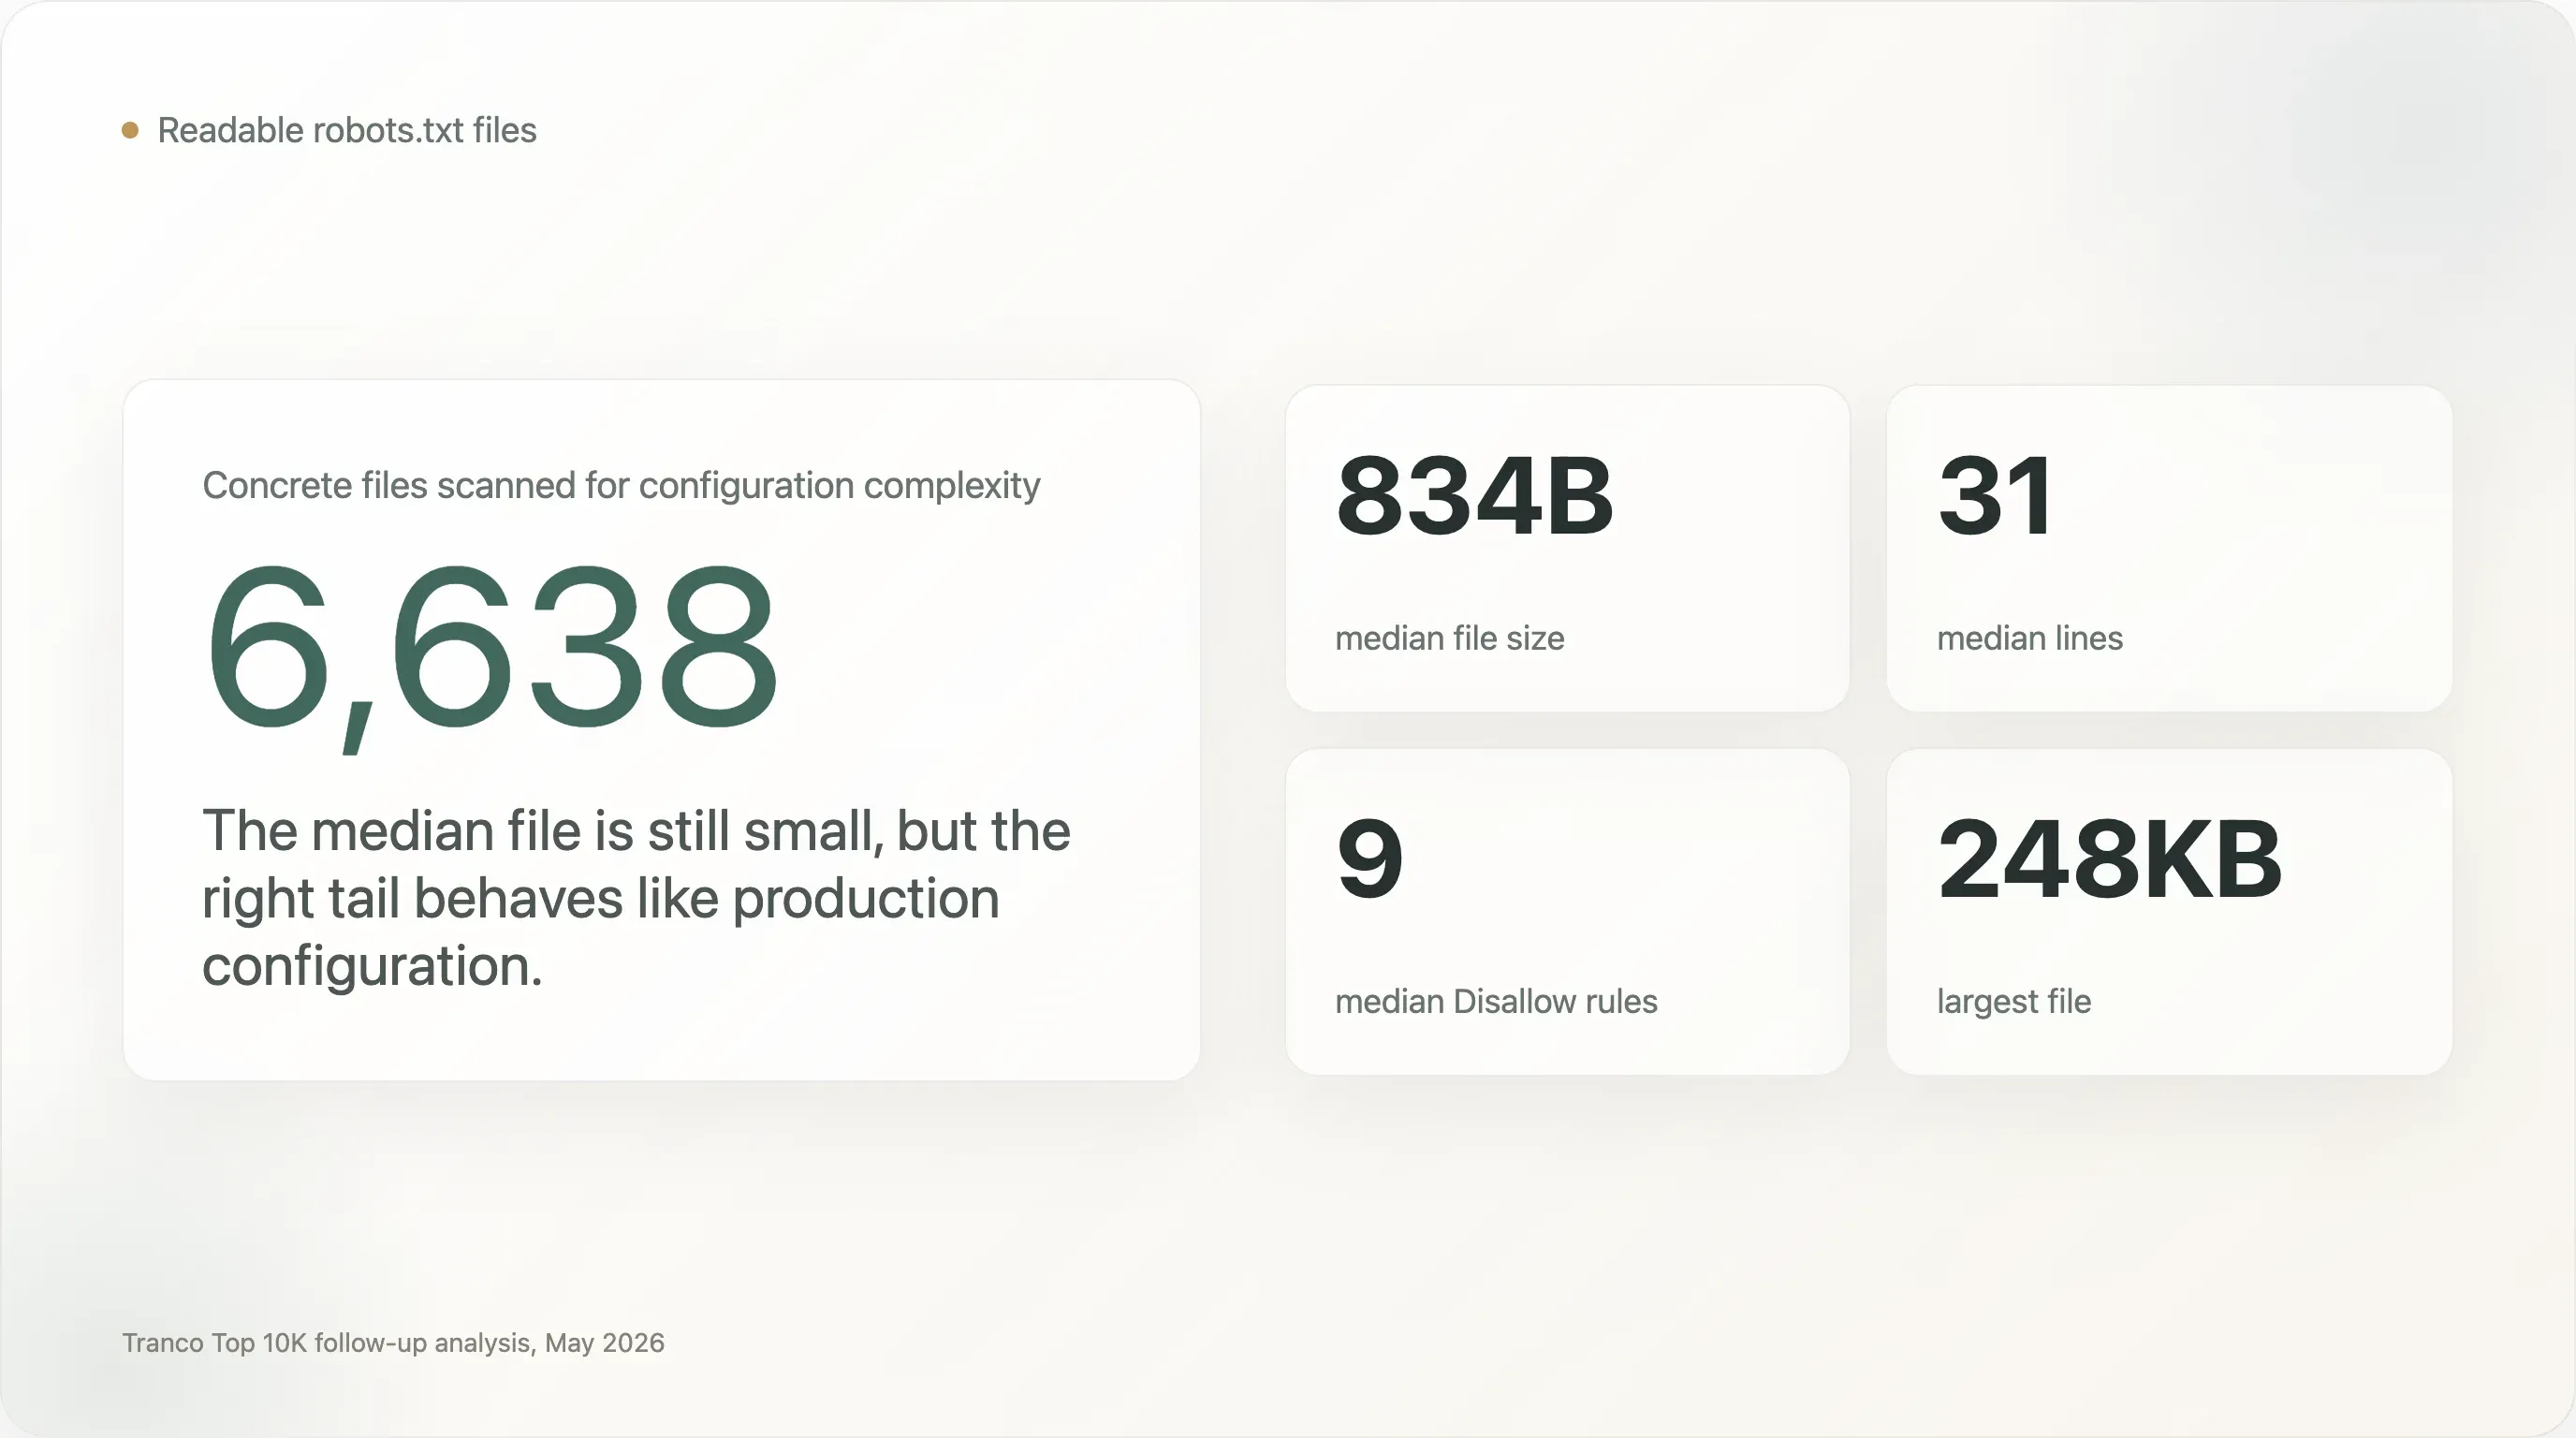
Trong 6.638 tệp đọc được:
| Chỉ số | Trung vị | P90 | P95 | P99 | Lớn nhất |
|---|---|---|---|---|---|
| Kích thước tệp | 834 byte | 6,7 KB | 15,8 KB | 76,0 KB | 248,3 KB |
| Số dòng | 31 | 238 | 332 | 1.008 | 4.998 |
| Số dòng hoạt động | 23 | 198 | 282 | 837 | 4.998 |
Chỉ thị User-agent | 1 | 21 | 39 | 137 | 823 |
Chỉ thị Disallow | 9 | 103 | 176 | 422 | 4.997 |
Chỉ thị Allow | 1 | 17 | 33 | 69 | 890 |
Phân phối này quan trọng vì robots.txt thường được nhắc đến như thể nó chỉ là một tuyên bố nhỏ:
User-agent: *
Disallow: /private/
Mô hình tinh thần đó là sai với một phần đáng kể của web có lưu lượng cao.
Trong bộ dữ liệu này:
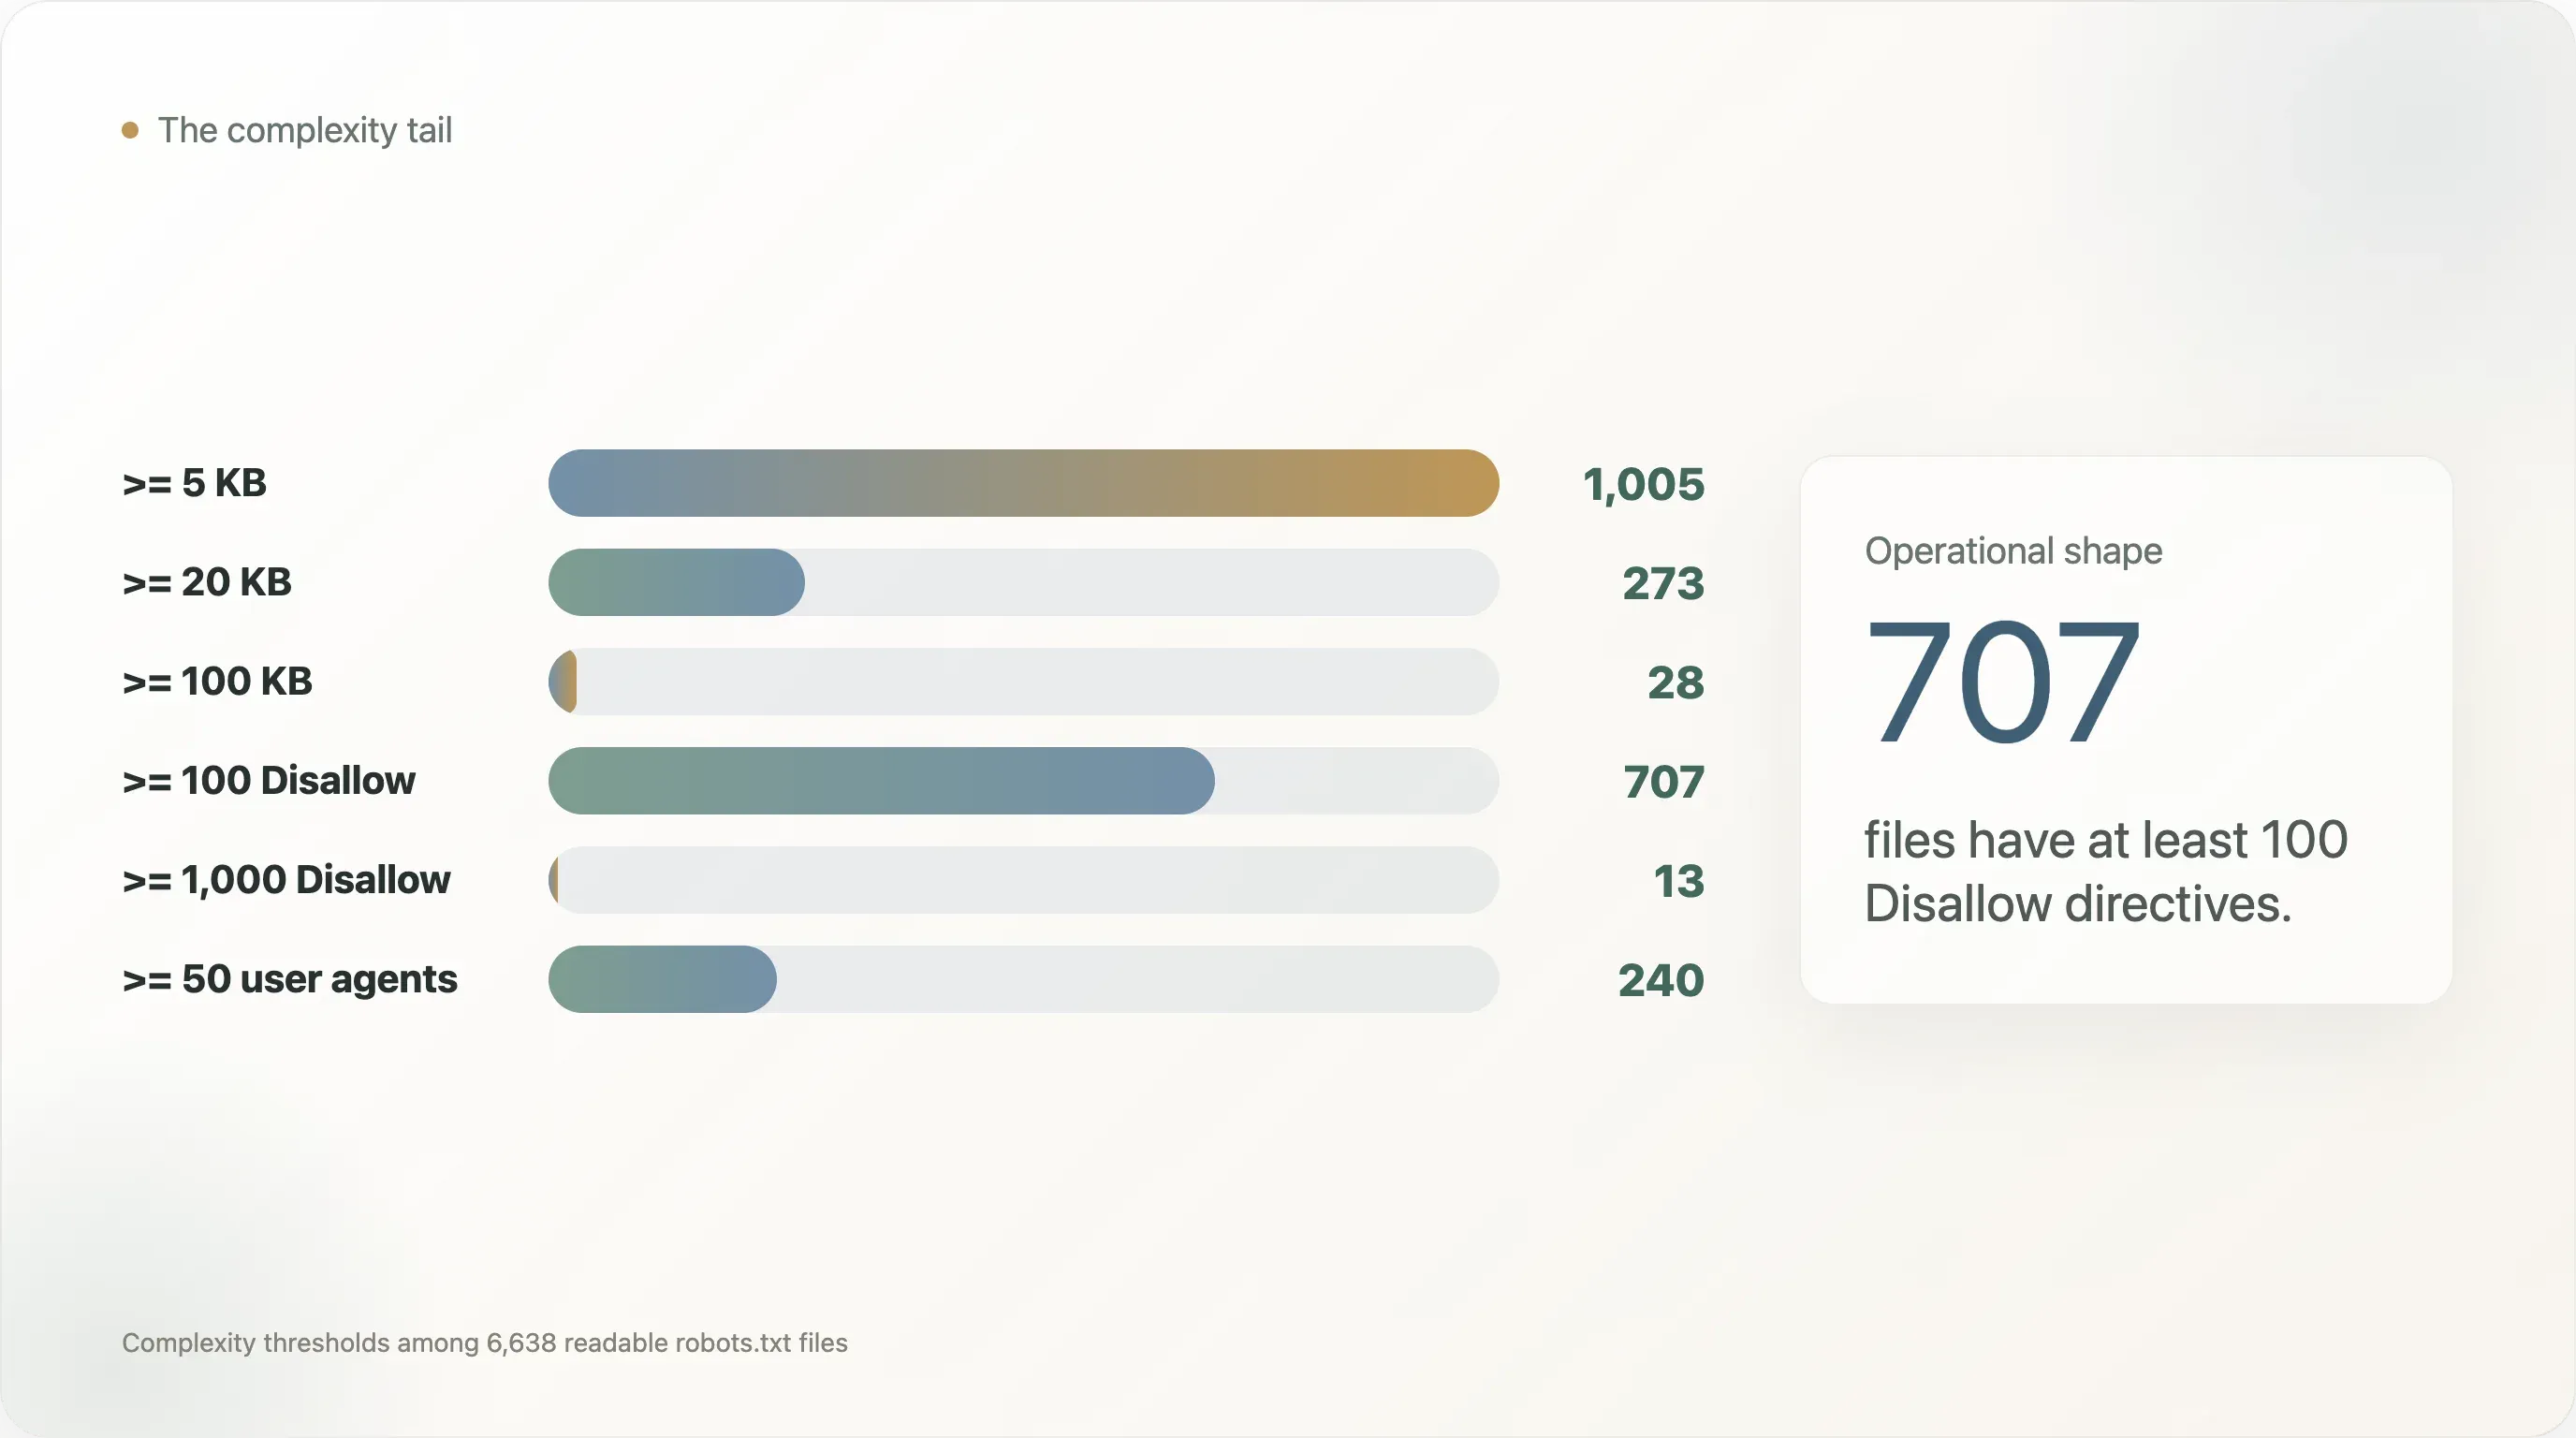
| Ngưỡng độ phức tạp | Site |
|---|---|
robots.txt lớn hơn hoặc bằng 5 KB | 1.005 |
| Lớn hơn hoặc bằng 20 KB | 273 |
| Lớn hơn hoặc bằng 100 KB | 28 |
Ít nhất 50 chỉ thị User-agent | 240 |
Ít nhất 100 chỉ thị User-agent | 110 |
Ít nhất 100 chỉ thị Disallow | 707 |
Ít nhất 1.000 chỉ thị Disallow | 13 |
Ít nhất 100 chỉ thị Allow | 40 |
Những tệp lớn và phức tạp nhất không phải là chuyện hiếm ở học thuật. Chúng thuộc về những thuộc tính có lưu lượng thực sự lớn:
| Domain | Xếp hạng | Danh mục | Byte | User-agent | Disallow | Allow |
|---|---|---|---|---|---|---|
linkedin.com | 17 | mạng xã hội | 114.341 | 76 | 4.184 | 281 |
runescape.com | 5.226 | không rõ | 113.393 | 1 | 4.997 | 0 |
academia.edu | 832 | học thuật | 57.384 | 63 | 2.044 | 227 |
etsy.com | 286 | thương mại điện tử | 51.320 | 3 | 1.621 | 120 |
thepaper.cn | 9.395 | tin tức | 56.867 | 1 | 1.496 | 0 |
opentable.com | 4.137 | không rõ | 70.494 | 32 | 1.683 | 176 |
alfabank.ru | 2.625 | tài chính | 73.158 | 2 | 1.566 | 133 |
Những tệp này gần với bảng định tuyến sản xuất hơn là khẩu hiệu chính sách. Chúng mã hóa nhiều năm ra mắt sản phẩm, đường dẫn cũ, mẫu tham số bị chặn, ngoại lệ cho crawler, thử nghiệm SEO, quyết định CDN, và giờ là cả quy tắc cho AI crawler.
Phần đuôi không chỉ là câu chuyện về AI. Trong 273 tệp có kích thước từ 20 KB trở lên, 131 tệp có ngôn ngữ chính sách AI và 142 tệp thì không. Trong 707 tệp có ít nhất 100 chỉ thị Disallow, chỉ 207 tệp có ngôn ngữ chính sách AI. Nói cách khác, AI không tạo ra vấn đề tệp lớn. Nó xuất hiện sau nhiều năm vận hành web thông thường đã lấp đầy tệp bằng quy tắc đường dẫn, tham chiếu sitemap và ngoại lệ crawler.
Điều đó quan trọng vì khả năng bảo trì phụ thuộc vào hình dạng, không chỉ ý định. Một tệp nhỏ với khối chặn AI trực tiếp có thể dễ kiểm toán. Một tệp ecommerce hoặc du lịch 70 KB có thể rất khó kiểm toán ngay cả khi nó không nói gì về AI. Rủi ro không phải là mọi tệp lớn đều sai. Rủi ro là chính sách thực thi trở nên quá khó để những người chịu trách nhiệm có thể xác minh.
Rủi ro vận hành là rất trực tiếp: khi robots.txt phình to, sẽ khó hơn cho nhà xuất bản, kỹ sư nền tảng, luật sư hoặc trưởng nhóm SEO trả lời câu hỏi cơ bản: tệp này thực sự cho phép điều gì?
Câu hỏi đó không còn đơn giản nữa. Theo kiểu phân tích RFC, crawler có thể khớp nhóm user-agent cụ thể hơn thay vì User-agent: *; đường dẫn khớp dài hơn có thể ghi đè đường dẫn ngắn hơn; các chỉ thị Allow và Disallow tương tác theo thứ tự ưu tiên; và các quy tắc chặn chung có thể vô tình bắt cả những crawler mới chưa tồn tại khi tệp được viết.
Với một tệp 30 dòng, con người có thể tự suy luận. Với một tệp 4.000 dòng có hàng chục bot được đặt tên, thì không ai nên làm vậy.
Phát hiện 2: robots.txt đang gánh nhiều hơn quy tắc crawl
Cuộc tranh luận về AI crawler đã làm robots.txt trở nên hữu hình hơn về mặt chính sách, nhưng bản thân tệp này đã tích lũy những trách nhiệm không liên quan từ trước.
Một tệp robots.txt hiện đại của một site lớn có thể bao gồm:
- kiểm soát đường dẫn cho crawler;
- khám phá sitemap;
- phần mở rộng riêng cho công cụ tìm kiếm;
- gợi ý về tốc độ crawl;
- gợi ý chuẩn hóa host;
- gợi ý dọn dẹp tham số URL;
- từ vựng chính sách do CDN chèn vào;
- văn bản bảo lưu bản quyền;
- tùy chọn từ chối huấn luyện AI;
- bình luận pháp lý dễ đọc cho con người.
Bộ dữ liệu cho thấy rõ lớp chồng này.
| Tín hiệu | Tệp | Tỷ lệ trên tệp đọc được |
|---|---|---|
Crawl-delay | 685 | 10,3% |
Host | 303 | 4,6% |
Clean-param | 200 | 3,0% |
Content-Signal | 271 | 4,1% |
Request-rate | 9 | 0,1% |
Visit-time | 5 | 0,1% |
Nhắc đến llms.txt | 83 | 1,3% |
| Ngôn ngữ về bản quyền, điều khoản, cấp phép hoặc quyền cho phép | 719 | 10,8% |
| Ngôn ngữ chính sách AI | 1.377 | 20,7% |
Một số chỉ thị này được các crawler cụ thể công nhận rộng rãi. Một số là quy ước cũ. Một số là của từng nhà cung cấp. Một số thậm chí không hẳn là chỉ thị crawler, mà là ngôn ngữ pháp lý hoặc sản phẩm được nhúng trong chú thích.
Đó chính là hình hài của sự trôi dạt giao thức.
Crawl-delay là một ví dụ điển hình. Nhiều quản trị viên site quen với nó, nhưng mức hỗ trợ giữa các crawler lớn không đồng đều. Host và Clean-param về mặt lịch sử gắn với hành vi của Yandex. Content-Signal là một phần của từ vựng chính sách thời AI của Cloudflare. llms.txt là một định dạng khám phá lân cận được đề xuất, không phải một chuẩn được mọi bên tôn trọng. Thế nhưng tất cả chúng đều xuất hiện trong cùng một loại tệp, thường đứng cạnh các quy tắc cổ điển User-agent và Disallow.
Các con số cũng cho thấy quy ước cũ và mới giờ cùng tồn tại. Crawl-delay xuất hiện trong 685 tệp, nhiều hơn gấp đôi so với 271 tệp có Content-Signal. Host xuất hiện trong 303 tệp và Clean-param trong 200 tệp, chủ yếu phản ánh các quy ước thời công cụ tìm kiếm. llms.txt, dù được bàn luận nhiều trong giới tìm kiếm AI, chỉ được nhắc trong 83 tệp đọc được. Web sống không hội tụ vào một từ vựng. Nó đang chồng nhiều từ vựng lên nhau.
Vấn đề không phải là bất kỳ phần mở rộng đơn lẻ nào sai. Vấn đề là tệp này đã trở thành một vùng chứa không có phiên bản cho nhiều hệ thống quản trị chồng lấn.
Điều đó tạo ra ba loại nợ:
- Nợ ngữ nghĩa. Các crawler khác nhau có thể diễn giải cùng một tệp theo cách khác nhau.
- Nợ sở hữu. Các nhóm SEO, pháp lý, hạ tầng, bảo mật và sản phẩm đều có lý do để chỉnh sửa tệp, nhưng có thể không có một nhóm nào sở hữu toàn bộ chính sách.
- Nợ kiểm toán. Một site có thể công bố một chính sách trông có vẻ có chủ ý trong khi chỉ có parser mới xác định được hành vi thực tế.
AI làm điều này quan trọng hơn vì mức độ rủi ro đã thay đổi. Khi một gợi ý tốc độ crawl cũ bị bỏ qua, kết quả có thể chỉ là thêm lưu lượng. Khi một tùy chọn từ chối huấn luyện AI mơ hồ, kết quả có thể trở thành bằng chứng trong tranh chấp bản quyền hoặc cấp phép.
Phát hiện 3: Tệp này đã trở thành vừa là giao diện máy, vừa là hiện vật pháp lý
Báo cáo AI crawler ban đầu cho thấy 17,0% site có thể phân tích đã viết quy tắc riêng cho AI một cách rõ ràng. Phần tiếp theo này xem xét gánh nặng văn bản mà các chính sách đó tạo ra.
Trong 6.638 tệp robots.txt đọc được:
- 1.377 tệp chứa ngôn ngữ chính sách AI;
- 719 tệp chứa ngôn ngữ về bản quyền, điều khoản, cấp phép, quyền hoặc cho phép;
- 271 tệp chứa
Content-Signal; - 83 tệp nhắc đến
llms.txt.
Điểm giao nhau mới là nơi câu chuyện trở nên thú vị hơn:
| Mẫu văn bản | Tệp |
|---|---|
| Ngôn ngữ chính sách AI và ngôn ngữ pháp lý/quyền hạn | 501 |
| Ngôn ngữ chính sách AI nhưng không có ngôn ngữ pháp lý/quyền hạn | 876 |
| Ngôn ngữ pháp lý/quyền hạn nhưng không có ngôn ngữ AI | 218 |
Content-Signal kèm ngôn ngữ pháp lý/quyền hạn | 242 |
| Chặn AI rõ ràng kèm ngôn ngữ pháp lý/quyền hạn | 424 |
Đây là một loại tệp mới.
Một tệp robots.txt truyền thống được viết cho crawler. Một tệp robots.txt có tiền đề pháp lý được viết cho ít nhất bốn đối tượng cùng lúc:
- người vận hành crawler, cần chỉ thị máy đọc được;
- nhà cung cấp tìm kiếm và AI, cần tín hiệu chính sách;
- luật sư, muốn tuyên bố bảo lưu quyền rõ ràng;
- các kiểm toán viên, tòa án hoặc nhà báo trong tương lai, có thể đọc phần chú thích như bằng chứng về ý định.
Thiết kế nhiều đối tượng như vậy giải thích vì sao một số tệp giờ đọc như tài liệu chính sách. Nhưng nó cũng làm suy yếu sự tách bạch gọn gàng giữa thứ mà crawler có thể phân tích và thứ mà một luật sư muốn tuyên bố.
876 tệp có ngôn ngữ chính sách AI nhưng không có từ vựng pháp lý chủ yếu là tệp chính sách máy: tên bot, khối Disallow, và ngôn ngữ mẫu. 501 tệp có cả AI và ngôn ngữ pháp lý thì khác. Chúng đang cố vừa là hướng dẫn crawler, vừa là tuyên bố bảo lưu quyền. 218 tệp có ngôn ngữ pháp lý nhưng không có từ vựng AI cho thấy mô hình này không bắt đầu từ LLM; robots.txt vốn đã được dùng để nêu điều khoản, ranh giới cho phép, và các tuyên bố quyền hạn.
Ví dụ, một chú thích có thể nói rằng machine learning bị cấm, trong khi khối chỉ thị thực tế chỉ chặn một phần các user agent đã biết. Một site có thể tuyên bố bảo lưu quyền trên phạm vi toàn cục nhưng chỉ nêu tên vài crawler. Một template của CDN có thể chèn từ vựng liên quan đến AI vào một tệp mà người vận hành chưa từng tự tay viết ngôn ngữ pháp lý. Một site có thể viết quy tắc rộng User-agent: * và vô tình chặn cả những crawler tương lai.
Từ góc độ quản trị, robots.txt trở nên hấp dẫn chính vì nó công khai và máy đọc được. Nhưng càng chứa nhiều chính sách, các giới hạn của nó càng quan trọng:
- Không có lớp xác thực nào chứng minh một chính sách cụ thể đã được chủ sở hữu quyền xem xét thay vì kế thừa từ hạ tầng.
- Không có lịch sử phiên bản gốc.
- Không có trường có cấu trúc cho mục đích dự kiến, như huấn luyện, truy xuất, lập chỉ mục tìm kiếm, tóm tắt, lưu cache, hoặc đánh giá mô hình.
- Không có sổ đăng ký phổ quát cho danh tính AI crawler.
- Không có cơ chế thực thi.
Điều đó không làm tệp này vô dụng. Nó làm nó mong manh.
Cách hiểu tốt hơn là robots.txt đang trở thành một lớp thông báo: một tuyên bố công khai, có thể kiểm tra về sở thích và ý định. Nó không phải, tự thân nó, là một hệ thống quản lý quyền đầy đủ.
Phát hiện 4: Search đã bất bình đẳng từ trước khi AI xuất hiện
Một trong những phát hiện mạnh nhất của báo cáo ban đầu là nhiều nhà xuất bản phân biệt giữa crawler huấn luyện AI và crawler tìm kiếm. Họ chặn CCBot, GPTBot hoặc Google-Extended trong khi vẫn giữ hiển thị tìm kiếm trên Google.
Phần tiếp theo này bổ sung một điểm khác: các crawler tìm kiếm truyền thống cũng không được đối xử bình đẳng.
Chúng tôi kiểm tra sáu crawler tìm kiếm:
- Googlebot;
- Bingbot;
- DuckDuckBot;
- Slurp;
- Baiduspider;
- YandexBot.
Trong 7.248 site có thể phân tích:
| Cách đối xử với search crawler | Site |
|---|---|
| Chặn ít nhất một search crawler | 562 |
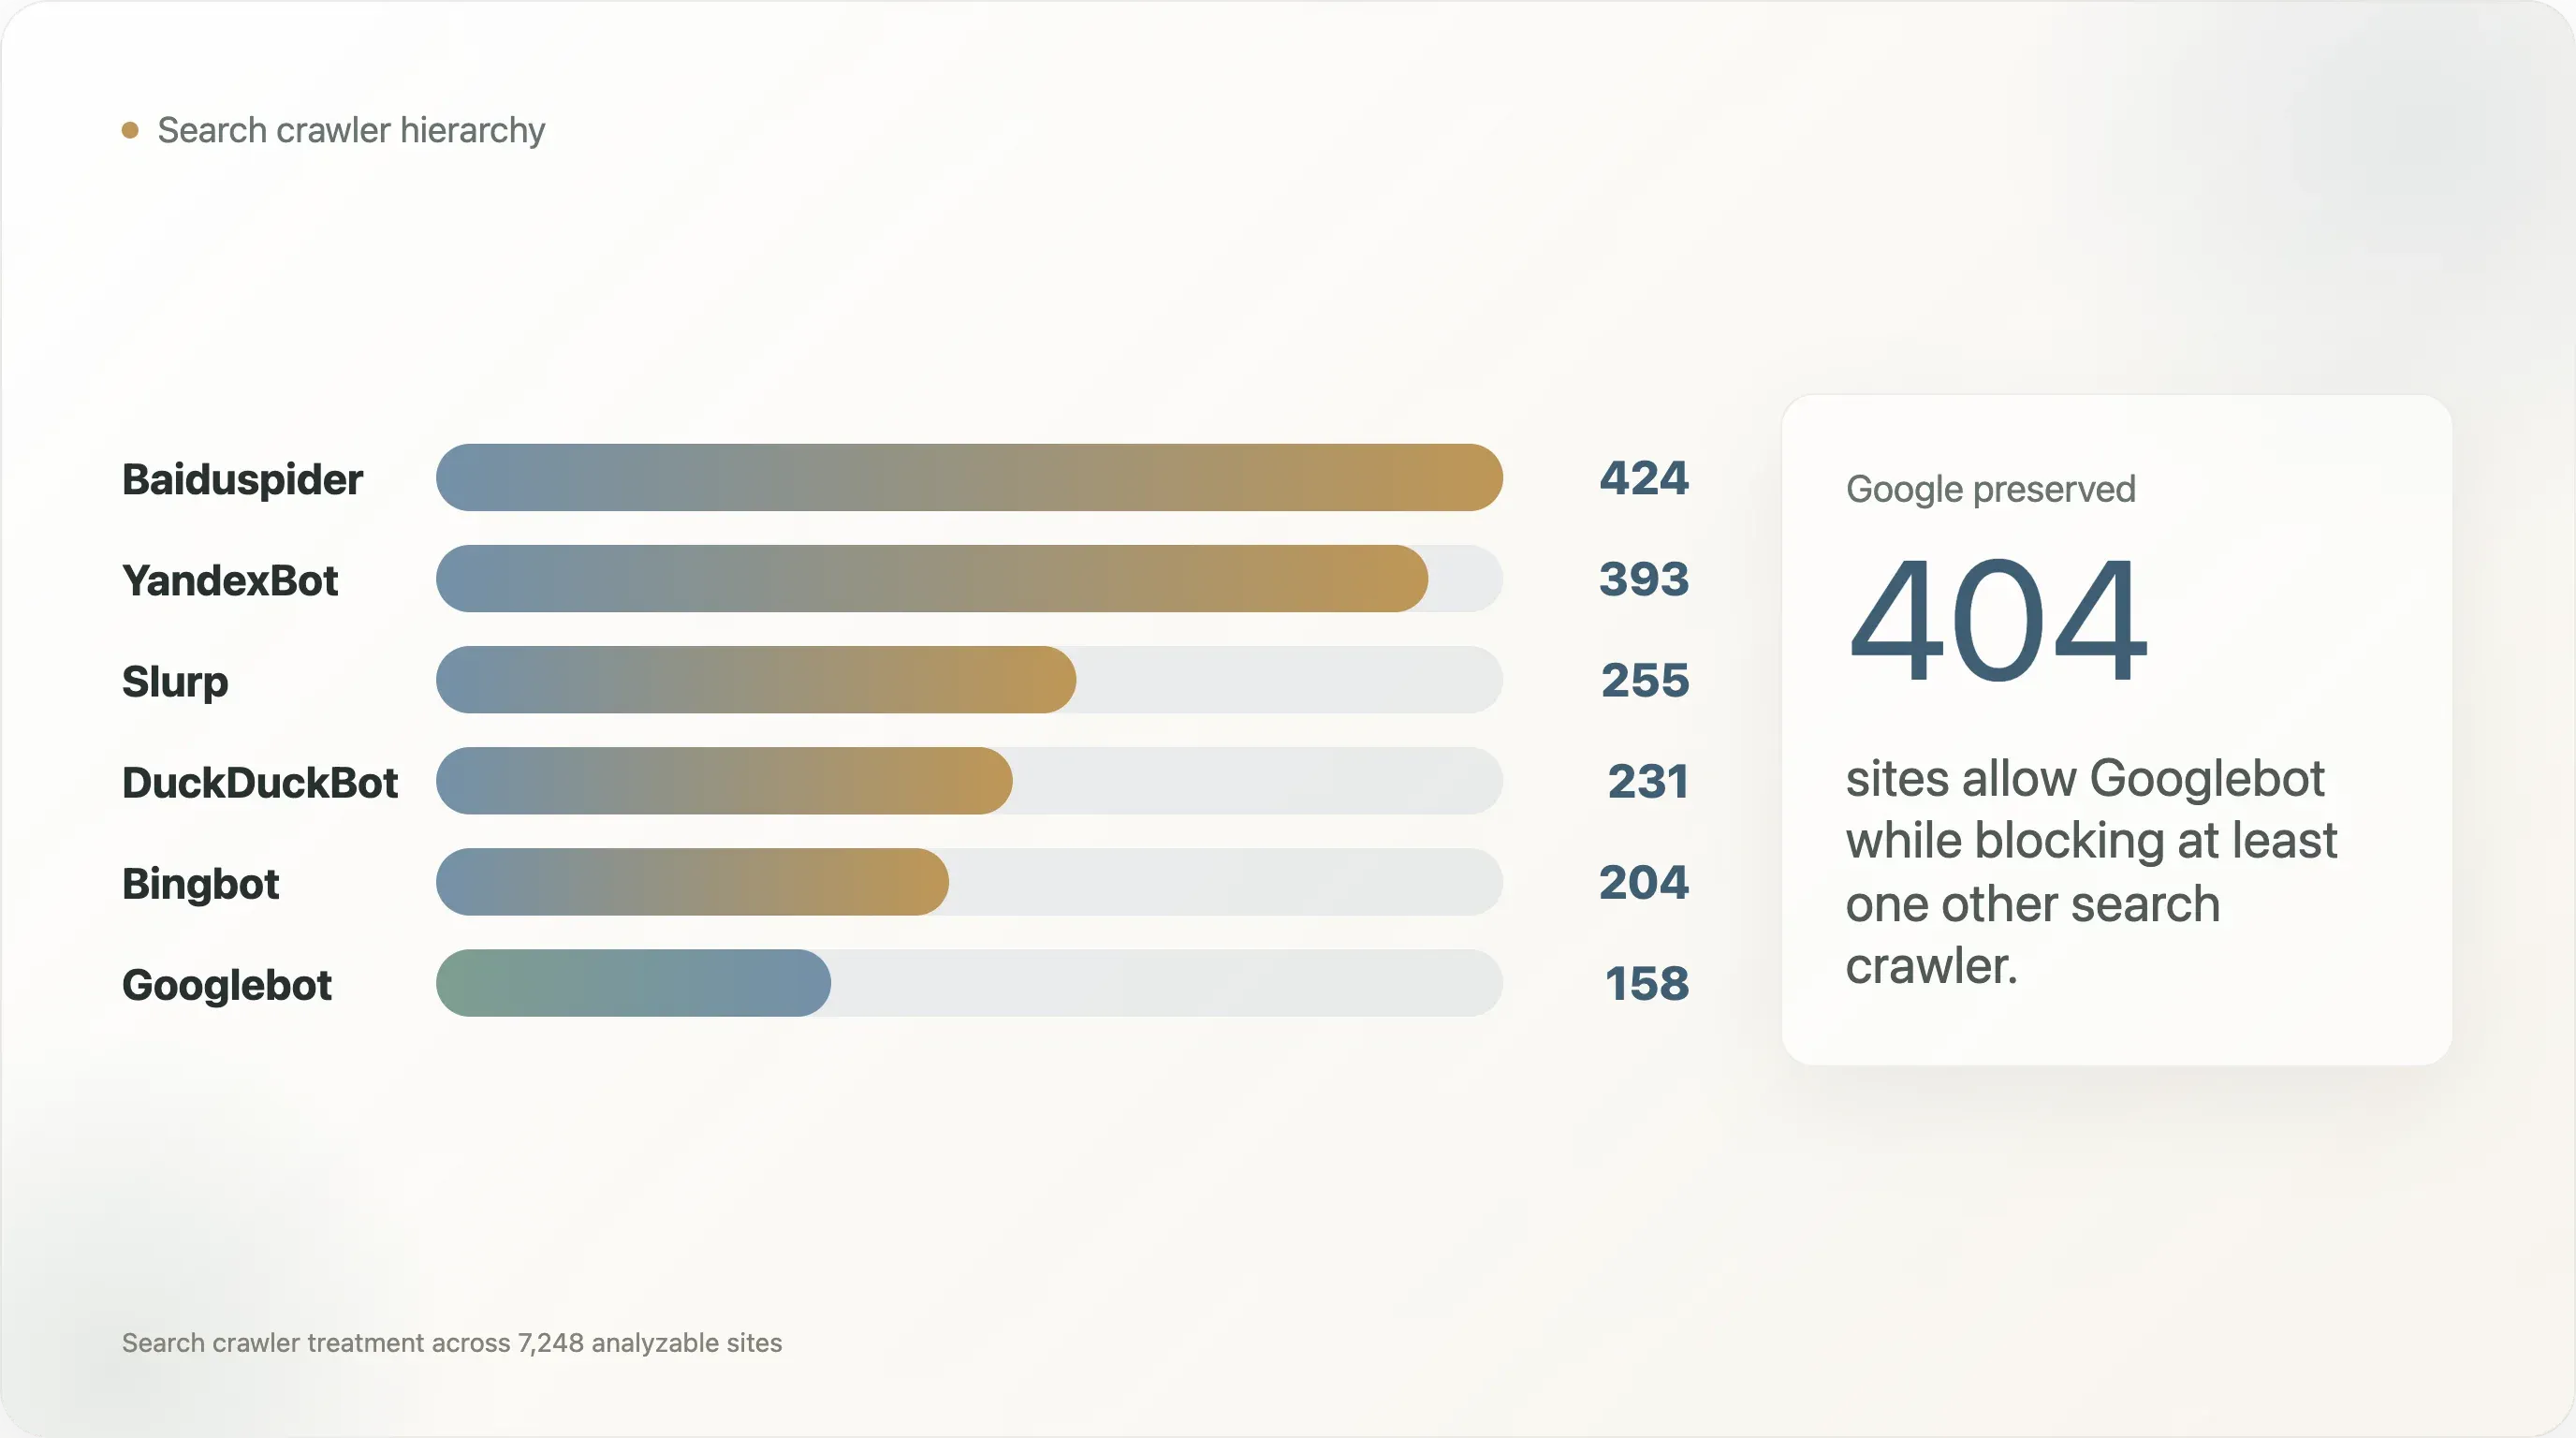
| Cho phép Googlebot nhưng chặn ít nhất một search crawler khác | 404 |
| Chặn cả sáu search crawler đã kiểm tra | 152 |
Số lượng bot bị chặn không phân bố đều:
| Search crawler | Site chặn nó |
|---|---|
| Baiduspider | 424 |
| YandexBot | 393 |
| Slurp | 255 |
| DuckDuckBot | 231 |
| Bingbot | 204 |
| Googlebot | 158 |
Googlebot là crawler ít bị chặn nhất trong bộ này. Baiduspider và YandexBot bị chặn thường xuyên hơn nhiều, và trong phần lớn các trường hợp đó Googlebot vẫn được phép. Trong số 404 site cho phép Googlebot nhưng chặn một search crawler khác, 269 site chặn Baiduspider và 240 site chặn YandexBot.
Các ví dụ đều là những tên tuổi lớn:
| Domain | Search crawler bị chặn trong khi Googlebot được phép |
|---|---|
facebook.com | Baiduspider, YandexBot |
apple.com | Baiduspider |
twitter.com | DuckDuckBot, Slurp, Baiduspider, YandexBot |
netflix.com | DuckDuckBot, Slurp |
x.com | DuckDuckBot, Slurp, Baiduspider, YandexBot |
tiktok.com | Baiduspider |
baidu.com | Bingbot, DuckDuckBot, Slurp, YandexBot |
washingtonpost.com | YandexBot |
wsj.com | YandexBot |
bilibili.com | DuckDuckBot, Slurp, YandexBot |
temu.com | Slurp |
t-mobile.com | Baiduspider, YandexBot |
Điều này quan trọng với cuộc tranh luận về AI vì nó cho thấy robots.txt vốn không phải là giao thức truy cập phổ quát trung tính ngay cả trước khi các crawler LLM xuất hiện. Web công khai đã có thứ bậc từ trước:
- Googlebot thường được giữ lại vì lưu lượng từ Google quá giá trị để mạo hiểm.
- Các crawler theo khu vực hoặc của đối thủ thì dễ bị chặn hơn.
- Một số site xem truy cập của crawler tìm kiếm như một quyết định theo từng thị trường hoặc từng nhà cung cấp.
Các crawler AI bước vào một hệ sinh thái mà truy cập phân biệt vốn đã là chuyện bình thường.
Điều đó giúp chuyển đổi chính sách dễ hiểu hơn. Một nhà xuất bản viết “chặn Google-Extended, cho phép Googlebot” không hề phát minh ra một hình thức phân biệt đối xử mới. Họ đang áp dụng một mẫu cũ cho một lớp crawler mới: giữ phân phối, hạn chế trích xuất.
Câu hỏi còn bỏ ngỏ là mẫu cũ này có mở rộng được không. Với search, chỉ có một nhóm nhỏ crawler quan trọng về mặt kinh tế. Với AI, danh tính crawler bị phân mảnh giữa nhà cung cấp mô hình, bot truy xuất, nhà môi giới dữ liệu, crawler học thuật, tác tử trình duyệt tổng hợp và các bộ lấy dữ liệu ở tầng hạ tầng. Số lượng user agent được đặt tên sẽ còn tăng trừ khi hệ sinh thái hội tụ quanh một tập tín hiệu nhỏ hơn dựa trên mục đích.
Đó là cách nợ cấu hình tích tụ.
Phát hiện 5: Độ phức tạp khác nhau theo ngành, nhưng không theo cách tỷ lệ chặn AI khác nhau
Báo cáo ban đầu cho thấy mức độ chặn AI phân hóa mạnh theo ngành: tin tức chặn cao; viễn thông, chính phủ và SaaS chặn thấp.
Độ phức tạp cấu hình cắt web theo một lát khác.
Trong các danh mục được chọn có đủ robots.txt đọc được để so sánh có ý nghĩa:
| Danh mục | n | Byte trung vị | Byte P90 | Disallow trung vị | Disallow P90 | User-agent trung vị | User-agent P90 |
|---|---|---|---|---|---|---|---|
| thương mại điện tử | 215 | 1.738 | 10.388 | 37 | 164 | 3 | 49 |
| du lịch | 63 | 2.074 | 27.368 | 41 | 779 | 5 | 34 |
| tin tức | 647 | 1.534 | 7.039 | 19 | 114 | 6 | 68 |
| tài chính | 121 | 1.002 | 8.337 | 17 | 132 | 2 | 23 |
| học thuật | 253 | 839 | 3.959 | 14 | 75 | 1 | 11 |
| chính phủ | 151 | 1.227 | 3.263 | 13 | 46 | 1 | 4 |
| SaaS | 368 | 485 | 12.606 | 4 | 56 | 1 | 10 |
| công cụ dev | 119 | 273 | 9.255 | 3 | 58 | 1 | 10 |
Biểu đồ P90 Disallow theo danh mục ở đây<<<<<<<<<<<<<<<<<<<<<<<<<
Tin tức phức tạp về mặt chính sách vì nó viết các quy tắc AI rõ ràng và ngôn ngữ pháp lý. Nhưng thương mại điện tử và du lịch phức tạp về mặt vận hành vì chúng có danh mục lớn, điều hướng theo bộ lọc, trang kết quả tìm kiếm, bộ lọc, đường dẫn tài khoản người dùng và URL có tham số.
Phân biệt đó rất quan trọng.
Du lịch là ví dụ rõ nhất. Chỉ có 63 tệp đọc được trong lát danh mục này, nhưng P90 robots.txt của nó là 27,4 KB và P90 số lượng Disallow là 779, cao hơn rất nhiều so với tin tức. Điều đó không có nghĩa là site du lịch có chính sách AI phát triển hơn. Nó có nghĩa là site du lịch có nhiều bề mặt mà người vận hành crawler có thể vô tình làm lãng phí ngân sách crawl: tìm kiếm theo ngày, trang còn phòng, phân trang đánh giá, luồng đặt chỗ, tổ hợp bộ lọc, và đường dẫn tồn kho bản địa hóa.
SaaS là kiểu bất ngờ ngược lại. Tệp trung vị của nó chỉ 485 byte, nhưng P90 của tệp nhảy lên 12,6 KB. Phần lớn site SaaS mở và nhẹ; một nhóm nhỏ mang các tệp kiểm soát đường dẫn rất dài, thường vì tài liệu, màn hình đăng nhập, đường dẫn ứng dụng và trang marketing cùng nằm dưới một domain.
Tin tức nằm ở giữa về vận hành nhưng gần đầu bảng về chính sách. Số lượng User-agent P90 của nó là 68, cao hơn thương mại điện tử, du lịch, tài chính, học thuật, chính phủ, SaaS và công cụ dev trong bảng này. Đó là tín hiệu của chính sách theo từng bot, không chỉ là vệ sinh đường dẫn.
Một tệp robots.txt của nhà xuất bản có thể phức tạp vì chính sách quyền. Một tệp của marketplace có thể phức tạp vì quản lý ngân sách crawl. Một tệp của trường đại học có thể phức tạp vì hàng nghìn đường dẫn cũ tích tụ dưới một domain. Một tệp của nền tảng xã hội có thể phức tạp vì nó phải mở một số bề mặt và khóa bớt những bề mặt khác ở quy mô cực lớn.
Chính sách AI được đặt lên trên tất cả những điều đó. Nó không thay thế các lý do hiện có khiến một tệp trở nên phức tạp.
Điều này giúp giải thích vì sao quản trị robots.txt trong thời AI không thể giải bằng một danh sách chặn chung cho tất cả. Những tệp nền có nhiệm vụ khác nhau:
- site thương mại điện tử quản lý các đường dẫn trùng lặp và bề mặt hàng tồn;
- site du lịch quản lý danh sách, lịch, đánh giá và trang tìm kiếm động;
- site tin tức quản lý bản quyền, lưu trữ và lập trường cấp phép;
- site SaaS và công cụ dev thường muốn được AI nhìn thấy;
- chính phủ thường cần truy cập công khai nhưng vẫn có thể có hệ thống nhạy cảm cần loại trừ;
- nền tảng xã hội quản lý nội dung do người dùng tạo, hồ sơ và lo ngại chống lạm dụng.
Cùng một quy tắc AI crawler sẽ có ý nghĩa khác nhau trong mỗi môi trường.
Phát hiện 6: Chỉ số nợ cấu hình nhận diện rủi ro kiểm tra, không phải thất bại đạo đức
Phân tích này đã tạo ra một điểm nợ cấu hình đơn giản để nhận diện những tệp robots.txt có khả năng khó xem xét.
Điểm này gán trọng số cho:
- kích thước tệp;
- số lượng chỉ thị
User-agent; - số lượng chỉ thị
Disallow; - số lượng chỉ thị
Allow; - số lượng chỉ thị ngoài lõi;
- sự hiện diện của ngôn ngữ chính sách AI;
- sự pha trộn giữa chặn AI rõ ràng và ngôn ngữ pháp lý hoặc bản quyền.
Đây không phải là điểm đúng sai. Một tệp phức tạp hoàn toàn có thể là có chủ đích. Một tệp đơn giản vẫn có thể sai. Mục tiêu là phân loại ưu tiên: nếu một tệp lớn, nặng về chính sách, theo từng bot, và đầy ngoại lệ, nó xứng đáng được review kỹ hơn.
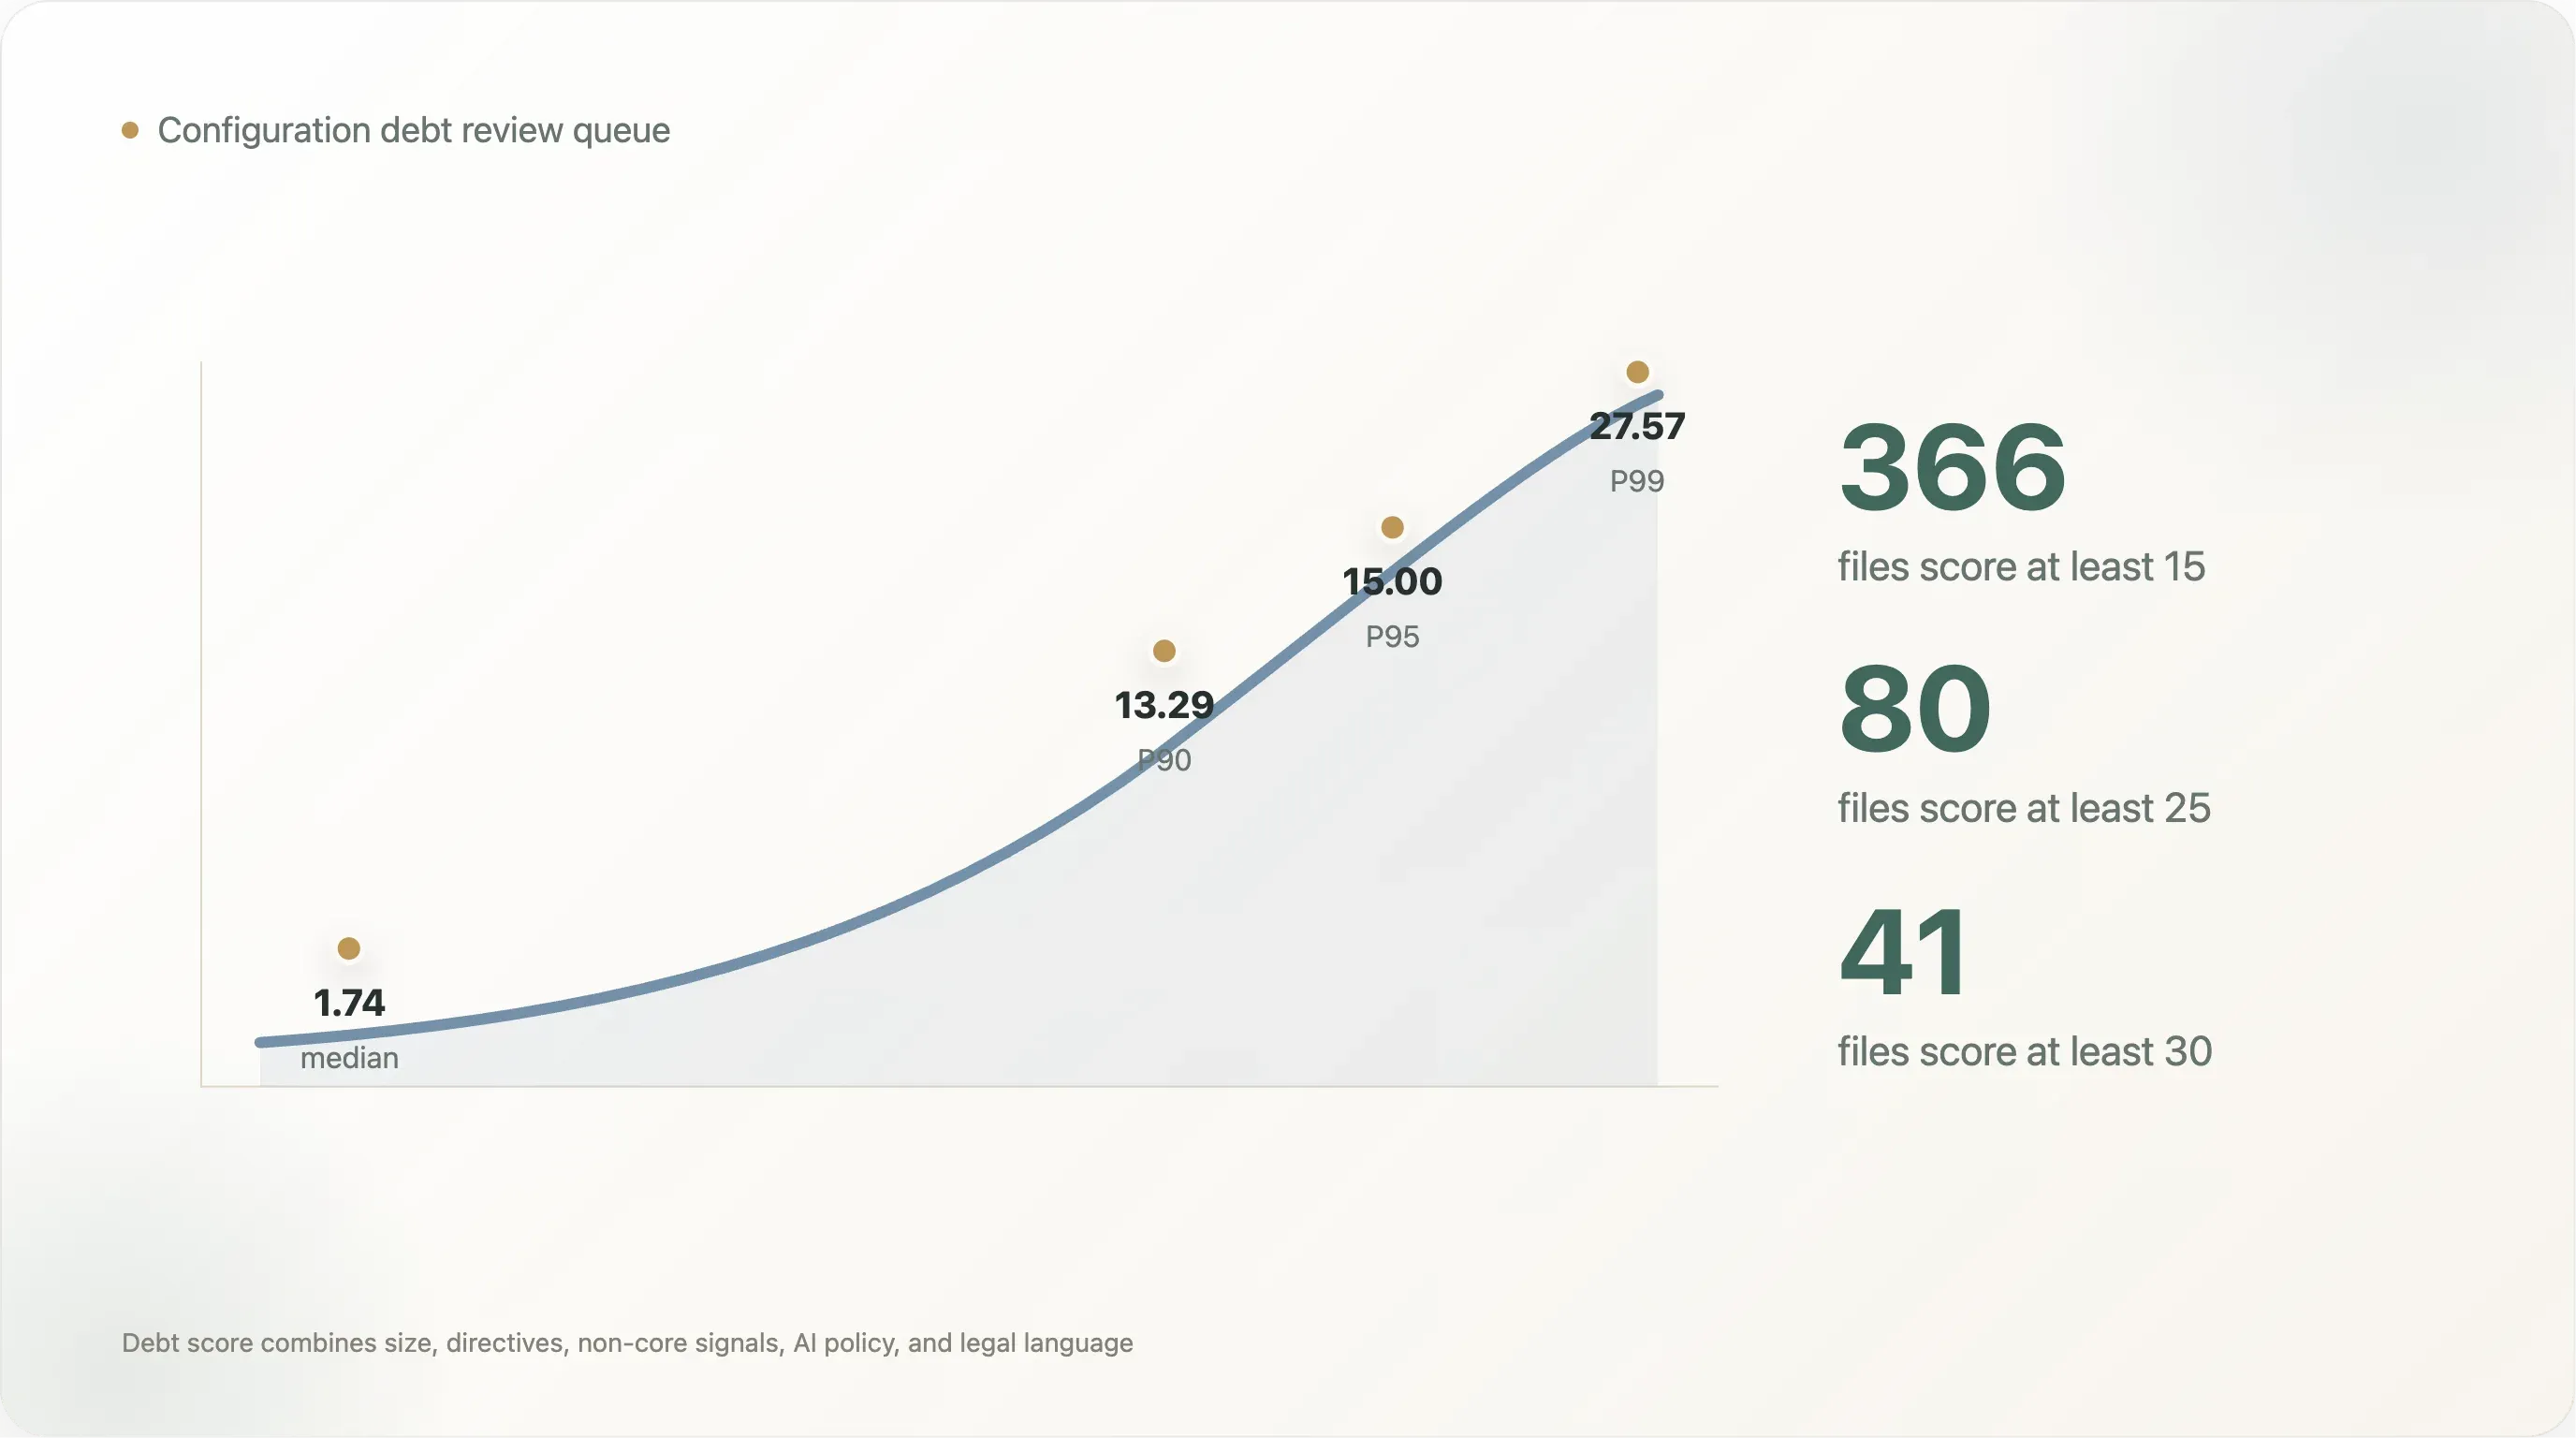
Phân phối điểm khá dốc. Tệp đọc được trung vị có điểm 1,74. P90 là 13,29, P95 là 15,00, và P99 là 27,57. Chỉ có 366 tệp đạt ít nhất 15 điểm, 80 tệp đạt ít nhất 25 điểm, và 41 tệp đạt ít nhất 30 điểm. Đó là hàng đợi review thực tế: không phải site nào cũng cần một dự án quản trị, nhưng phần đuôi trên thì có.
Góc nhìn theo danh mục cũng cho thấy vì sao nhãn “chặn AI” là quá phẳng:
| Danh mục | Điểm trung vị | Điểm P90 |
|---|---|---|
| du lịch | 4,92 | 28,94 |
| tìm kiếm | 2,97 | 24,23 |
| mạng xã hội | 2,25 | 15,00 |
| tin tức | 4,91 | 14,92 |
| tài chính | 1,67 | 12,61 |
| SaaS | 0,98 | 11,85 |
| thương mại điện tử | 3,88 | 10,87 |
| chính phủ | 1,57 | 6,38 |
Du lịch và tìm kiếm có P90 cao nhất vì một thiểu số tệp trở nên rất lớn và rất nhiều quy tắc. Tin tức có một trong những điểm trung vị cao nhất vì ngôn ngữ chính sách và xử lý theo từng bot phổ biến hơn trên toàn danh mục. Thương mại điện tử có số Disallow trung vị cao, nhưng điểm nợ P90 thấp hơn du lịch vì độ phức tạp tập trung nhiều ở quy tắc đường dẫn hơn là ở các tín hiệu chính sách/pháp lý pha trộn.
Các tệp có điểm cao nhất trong bộ dữ liệu này gồm:
| Domain | Vì sao nó có điểm cao |
|---|---|
linkedin.com | Tệp rất lớn, hàng nghìn quy tắc đường dẫn, nhiều user agent được đặt tên, ngôn ngữ chính sách AI rõ ràng |
lnkd.in | Cùng bề mặt chính sách với hạ tầng shortlink của LinkedIn |
fragrantica.com | Hàng trăm khối user agent được đặt tên cộng với ngôn ngữ chính sách AI |
sovcombank.ru | Hàng trăm khối user-agent và ngôn ngữ pháp lý/chính sách |
academia.edu | Ma trận allow/disallow lớn và chính sách chặn AI rõ ràng |
opentable.com | Bộ quy tắc đường dẫn lớn, nhiều chỉ thị sitemap, bề mặt chính sách liên quan AI |
etsy.com | Tệp kiểm soát đường dẫn ecommerce lớn với hơn 1.600 quy tắc Disallow |
runescape.com | Gần 5.000 chỉ thị Disallow dưới một nhóm user-agent |
Không nên chế giễu những tệp này vì chúng phức tạp. Sự phức tạp thường phản ánh nhu cầu kinh doanh thực tế. Nhưng chúng cho thấy vì sao chính sách robots.txt xứng đáng có cùng kỷ luật kỹ thuật như các cấu hình sản xuất khác:
- quyền sở hữu nên rõ ràng;
- thay đổi nên được review;
- các phần được tạo tự động nên được gắn nhãn;
- chú thích pháp lý nên được tách khỏi chỉ thị máy nếu có thể;
- test case nên xác nhận quyền truy cập bot dự kiến đối với các crawler quan trọng;
- lịch sử phiên bản nên được lưu;
- tên bot cũ nên được loại bỏ hoặc tài liệu hóa;
- huấn luyện AI, truy xuất AI, lập chỉ mục tìm kiếm và lưu trữ nên được xem là các mục đích riêng biệt.
Điểm cuối là quan trọng nhất. Ngữ pháp hiện tại đặt user-agent lên trước: nó yêu cầu người vận hành site nêu tên bot. Nhu cầu của thời AI là đặt mục đích lên trước: nó yêu cầu người vận hành site nói rõ cách dùng nào được phép.
Hai thứ đó không giống nhau.
Sự lệch đó là lý do danh sách chặn dài hơn sẽ không bền. Một nhà xuất bản hôm nay có thể thêm GPTBot, ClaudeBot, CCBot, Google-Extended, Bytespider, Applebot-Extended và PerplexityBot, nhưng tên crawler, tác tử truy xuất, hoặc nhà môi giới bộ dữ liệu tiếp theo có thể xuất hiện vào ngày mai. Một chính sách theo mục đích sẽ cho site nói “được lập chỉ mục tìm kiếm, không được huấn luyện AI, truy xuất do người dùng kích hoạt thì có thể” mà không biến robots.txt thành một danh bạ bot.
Điều này có ý nghĩa gì cho quản trị AI
Cuộc tranh luận công khai thường xem robots.txt hoặc là có ý nghĩa, hoặc là lỗi thời. Dữ liệu cho thấy một câu trả lời thực tế hơn:
robots.txt có ý nghĩa, nhưng đang bị quá tải.
Nó có ý nghĩa vì các site lớn sử dụng nó, crawler có thể phân tích nó, và các lựa chọn chính sách trở nên hữu hình với nhà nghiên cứu, nhà báo, nhà cung cấp và tòa án. Báo cáo gốc phát hiện 17,0% các site hàng đầu có thể phân tích đã viết quy tắc AI cụ thể một cách có chủ đích. Đó không phải là tiếng ồn mang tính biểu tượng.
Nó bị quá tải vì hiện giờ tệp này phải diễn đạt nhiều hơn truy cập bot:
- “Không được huấn luyện trên nội dung này.”
- “Bạn có thể dùng nội dung này để lập chỉ mục tìm kiếm.”
- “Bạn có thể dùng nội dung này cho truy xuất trực tiếp.”
- “Bạn không được tạo các bộ dữ liệu được lưu cache.”
- “Tuyên bố bảo lưu quyền này áp dụng theo luật TDM của EU.”
- “Site do CDN quản lý này gửi
Content-Signal: ai-train=no.” - “Site này muốn Googlebot nhưng không muốn YandexBot.”
- “Site này có 1.000 đường dẫn URL cũ không nên bị crawl.”
Ngữ pháp ban đầu không được thiết kế cho nhiều nhiệm vụ như vậy.
Ba thay đổi sẽ giảm nợ này:
-
Danh tính crawler cần một sổ đăng ký. Người vận hành site không nên phải duy trì một danh sách ngày càng dài của
GPTBot,ClaudeBot,anthropic-ai,CCBot,Google-Extended,Applebot-Extended,Bytespider,OAI-SearchBot,ChatGPT-Uservà hàng chục cái nữa. Không có sổ đăng ký, chính sách luôn chạy sau hành vi crawler. -
Cách dùng AI cần từ vựng có cấu trúc. Huấn luyện, truy xuất, lập chỉ mục, tóm tắt, bán lại bộ dữ liệu, đánh giá mô hình và duyệt web do người dùng kích hoạt là những cách dùng khác nhau. Diễn đạt chúng qua tên user-agent riêng của nhà cung cấp là rất dễ vỡ.
-
Chính sách cần khả năng kiểm toán. Web cần một cách để phân biệt tuyên bố bảo lưu quyền do con người soạn với mặc định CDN kế thừa, template CMS được tạo ra, các quy tắc cũ còn sót lại, và các khối chặn rộng vô tình. Sự phân biệt đó quan trọng với niềm tin và với tranh tụng.
Không gì trong số này có nghĩa là thay thế robots.txt ngay trong một đêm. Cách tốt hơn là xếp lớp: giữ robots.txt như bề mặt khám phá và tương thích, nhưng chuẩn hóa chính sách có thể đọc bằng máy ở lớp kế bên cho các cách dùng AI cụ thể.
llms.txt là một nỗ lực như vậy, nhưng mức độ áp dụng trong bộ dữ liệu này vẫn rất nhỏ: chỉ 83 tệp đọc được nhắc đến nó. Content-Signal nhìn thấy rõ hơn vì Cloudflare có thể phân phối nó qua hạ tầng, và cả 271 tệp Content-Signal trong lần quét này đều trùng với ngôn ngữ chính sách AI. Tuy nhiên, phân phối không đồng nghĩa với đồng thuận. Một giải pháp bền vững có lẽ cần bộ máy chuẩn hóa khô khan: trường rõ ràng, ngữ nghĩa rõ ràng, cam kết của crawler, và bộ test công khai.
Kết luận
Cuộc chiến về AI crawler đã biến robots.txt thành một hiện vật quản trị. Điều đó vừa hữu ích vừa rủi ro.
Hữu ích, vì tệp này công khai. Nhà nghiên cứu có thể kiểm tra. Nhà xuất bản có thể thay đổi. Crawler có thể tuân theo. Tòa án có thể đọc. Nhà cung cấp hạ tầng có thể triển khai ở quy mô lớn.
Rủi ro, vì nó đang gánh quá nhiều.
Tệp robots.txt trung vị trong Tranco Top 10K vẫn nhỏ đến mức có thể hiểu được. Nhưng phần đuôi dài của web có lưu lượng cao đầy những tệp lớn, cũ, nhiều lớp, phụ thuộc nhà cung cấp và mang tính pháp lý cao. Hàng trăm site hiện giờ duy trì các cấu hình robots.txt mà nên được hiểu là hệ thống chính sách sản xuất, chứ không chỉ là gợi ý đơn giản cho crawler.
Bài học trung tâm không phải là robots.txt đã thất bại. Mà là web đã giao cho nó nhiệm vụ lớn hơn mà không tái cấu trúc nó.
Nếu chính sách truy cập AI sẽ phụ thuộc vào các tuyên bố công khai, có thể đọc bằng máy, thì bước tiếp theo không phải là một danh sách chặn dài hơn nữa. Mà là hạ tầng chính sách tốt hơn: quyền dựa trên mục đích, danh tính crawler ổn định, template có thể review, và nhật ký kiểm toán.
Cho đến lúc đó, lớp quản trị AI của web công khai vẫn sẽ tiếp tục đặt lên một tệp văn bản vốn chưa bao giờ được thiết kế để gánh nhiều đến thế.
Ghi chú về khả năng tái lập
Thư mục bàn giao bao gồm:
source_data/analysis.json— các chỉ số tổng hợp gốc.source_data/site_meta.csv— bảng phân tích theo từng site gốc.source_data/bot_status.csv— bảng chính sách domain-theo-bot gốc.source_data/fetch_meta.csv— siêu dữ liệu fetch gốc.source_data/sites.csv— bảng domain/danh mục/trạng thái gốc.derived_data/robots_complexity_by_site.csv— các chỉ số độ phức tạp theo site được tạo cho báo cáo này.derived_data/search_bot_treatment.csv— ma trận cách đối xử với search crawler.derived_data/category_complexity_summary.csv— tóm tắt độ phức tạp theo danh mục.derived_data/top_config_debt_sites.csv— các site đứng đầu theo điểm phân loại được mô tả ở trên.derived_data/summary_metrics.json— toàn bộ chỉ số nổi bật được trích dẫn trong báo cáo này.
Tải xuống toàn bộ mã nguồn và bộ dữ liệu
Hoan nghênh các góp ý về phương pháp, vấn đề dữ liệu và phân tích tiếp theo tại support@thunderbit.com. Báo cáo này được xuất bản độc lập với bất kỳ vị thế thương mại nào Thunderbit đang có; chúng tôi xây dựng một web scraper dùng AI, và chúng tôi có lợi ích cấu trúc trong việc robots.txt tiếp tục là một hợp đồng có ý nghĩa, máy đọc được trên web công khai. Dữ liệu trong báo cáo này tự đứng vững. — Nhóm nghiên cứu Thunderbit, tháng 5 năm 2026.
Thử Thunderbit để thu thập dữ liệu web bằng AI Get Started Free



