
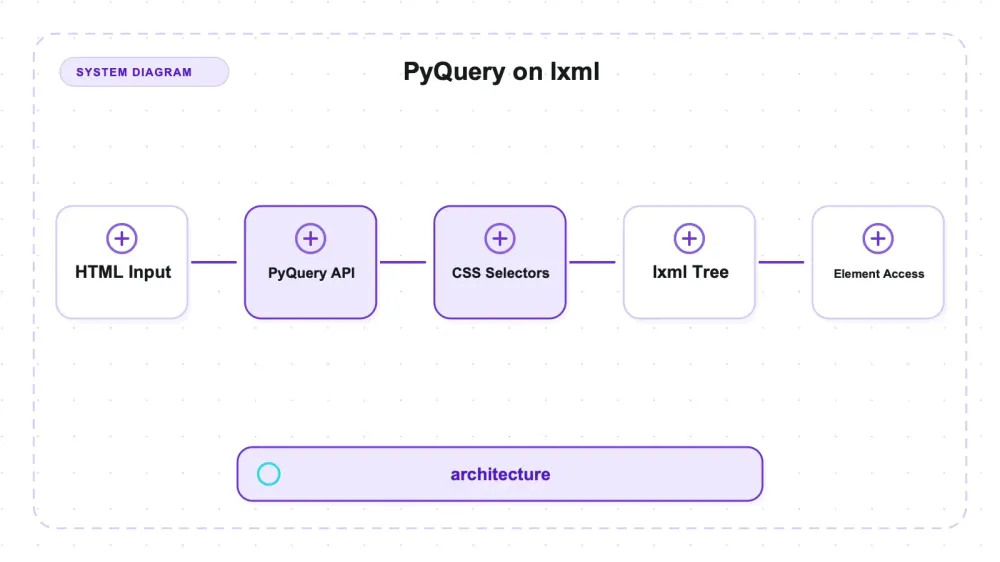
PyQuery đặt một API kiểu jQuery lên trên lxml. Trên năm kích thước trang từ 1 KB đến 10 MB, cả năm median hiển thị đều thấp hơn lxml thuần, trong đó mức chênh ở kích thước lớn nhất là 1,5%. Tuy vậy, benchmark này không chứng minh wrapper nhanh hơn; nó chỉ cho thấy không có khác biệt đủ lớn để thay đổi quyết định khi chỉ cần chọn selector và đọc dữ liệu.
Từ mức 10 KB trở lên, các median hiển thị của PyQuery cũng chỉ lệch vài phần trăm so với selectolax. Nhưng nếu không có ngưỡng tương đương được định sẵn, đây chỉ là một kết quả sát nút, chưa thể gọi là hòa về mặt thống kê.
PyQuery là gì
PyQuery là một thư viện Python mang đến cho bạn cú pháp chọn phần tử và nối chuỗi thao tác kiểu jQuery trên cây tài liệu lxml. Phiên bản được thử nghiệm: 2.1.0, giấy phép BSD, 2.380 sao GitHub, 59 issue đang mở, lần đẩy mã gần nhất vào 2026-07-27.
Tài liệu chính thức: PyQuery documentation.
from pyquery import PyQuery as pq
d = pq(html)
titles = [e.text_content() for e in d("h3.title")]
hrefs = [e.get("href") for e in d("a")]
Các phần tử mà nó trả về vẫn là phần tử lxml, nên mọi thao tác bạn đã biết với lxml vẫn dùng được. Đó chính là cách PyQuery được thiết kế: đây là một lớp tăng trải nghiệm sử dụng, không phải bộ phân tích cú pháp. pip install pyquery sẽ kéo về 3 gói — lxml, cssselect và chính PyQuery — với dung lượng 20,1 MiB, gần như toàn bộ là các extension biên dịch của lxml.
Nếu bạn từng dùng cheerio trong Node, thì đây là cùng một ý tưởng API trong Python. Hai selector được kiểm thử ở đây hoạt động giống nhau trên cả hai; nhưng thử nghiệm này không chứng minh được sự tương đương hoàn toàn của ngôn ngữ selector giữa cssselect và cheerio.
Phép đo
Bộ cơ sở nghiên cứu này đã có sẵn một benchmark parser với một đặc tính mà phần lớn benchmark khác thiếu: cổng đối chiếu parity bằng hash nội dung trích xuất — titles đã sắp xếp cùng hrefs đã sắp xếp — so với parser tham chiếu, để một thư viện có bỏ qua bước xử lý cũng không thể “ăn gian” thời gian nhanh. Năm kích thước trang, 50 vòng lặp, ba lần chạy độc lập.
Việc thêm PyQuery vào bài kiểm tra cần hai bước.
Chạy lại parser tham chiếu. selectolax được chạy lại trong cùng tiến trình. Hash nội dung của nó khớp trên 5/5 kích thước và p50 của nó nằm trong khoảng 0,989× đến 1,079× so với con số đã công bố — nghĩa là đây vẫn là cùng máy và cùng môi trường kiểm thử.
Chạy lxml trong cùng tiến trình. Benchmark đã công bố có ghi máy và phiên bản Python nhưng không ghi phiên bản thư viện, nên hàng lxml của nó có thể đến từ một bản lxml khác với bản mà PyQuery đang bọc ở đây. So sánh qua khoảng trống đó sẽ vô tình biến thành so sánh giữa hai phiên bản lxml và gọi đó là “chi phí wrapper”. Chạy lxml song song sẽ loại bỏ câu hỏi này — trong venv hiện tại, cả hai đều là lxml 6.1.1.
| Kích thước trang | selectolax | PyQuery | lxml | PyQuery so với lxml |
|---|---|---|---|---|
| 1 KB | 0,0286 ms | 0,0456 ms | 0,0508 ms | 0,90× |
| 10 KB | 0,1725 ms | 0,1728 ms | 0,1802 ms | 0,96× |
| 100 KB | 1,4855 ms | 1,4093 ms | 1,4145 ms | 1,00× |
| 1 MB | 14,97 ms | 14,96 ms | 15,03 ms | 1,00× |
| 10 MB | 158,10 ms | 162,86 ms | 165,25 ms | 0,99× |
p50 tính bằng mili giây, median của ba lần chạy, tất cả đều trong cùng một tiến trình. parser-bench.json. Cả ba hash nội dung đều khớp với bản tham chiếu ở mọi kích thước.
Chi phí wrapper gần như không tồn tại
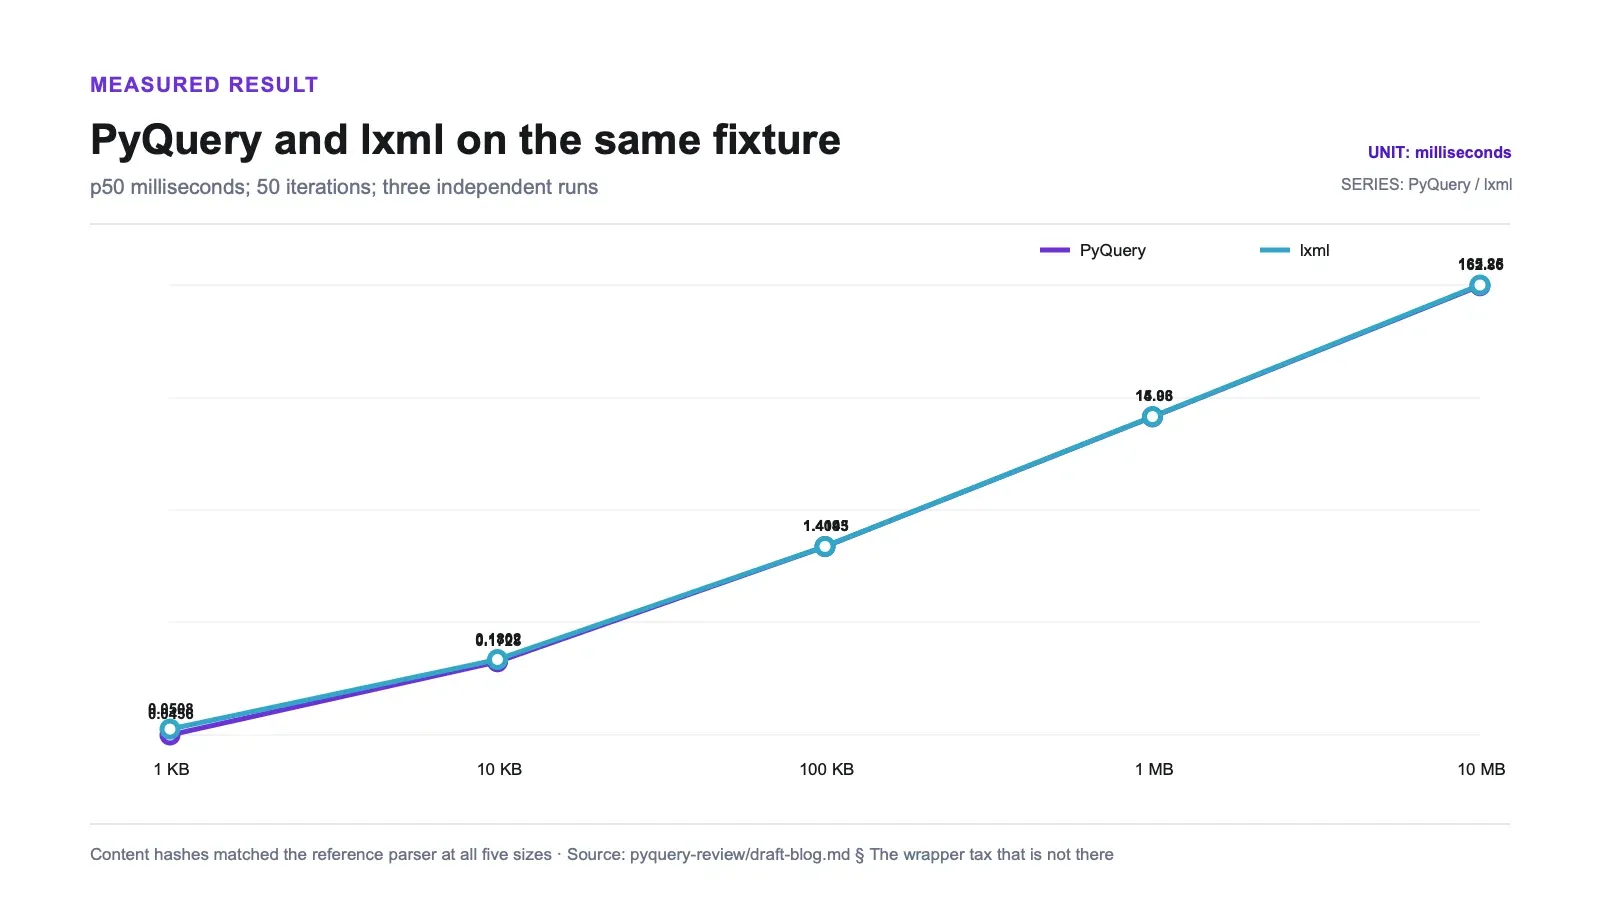
PyQuery luôn nằm bằng hoặc thấp hơn lxml thuần ở mọi median hiển thị. Điều đó không có nghĩa wrapper làm parsing nhanh hơn. Với chỉ ba lần chạy median và không có ngưỡng tương đương được xác định trước, kết luận hợp lý hơn là fixture này không cho thấy chi phí selector đáng kể đủ để ảnh hưởng quyết định.
Ở mức 10 MB, ba lần chạy của PyQuery là 162,86, 163,17 và 161,13 ms; của lxml là 169,46, 165,25 và 164,18 ms. Dải giá trị khá gần nhưng không chồng lấn. Ở mức 1 MB, median của hai bên chỉ chênh 0,5%. Những lần chạy nhỏ này đủ cho một nhận định thực dụng, nhưng chưa đủ để tuyên bố tương đương thống kê.
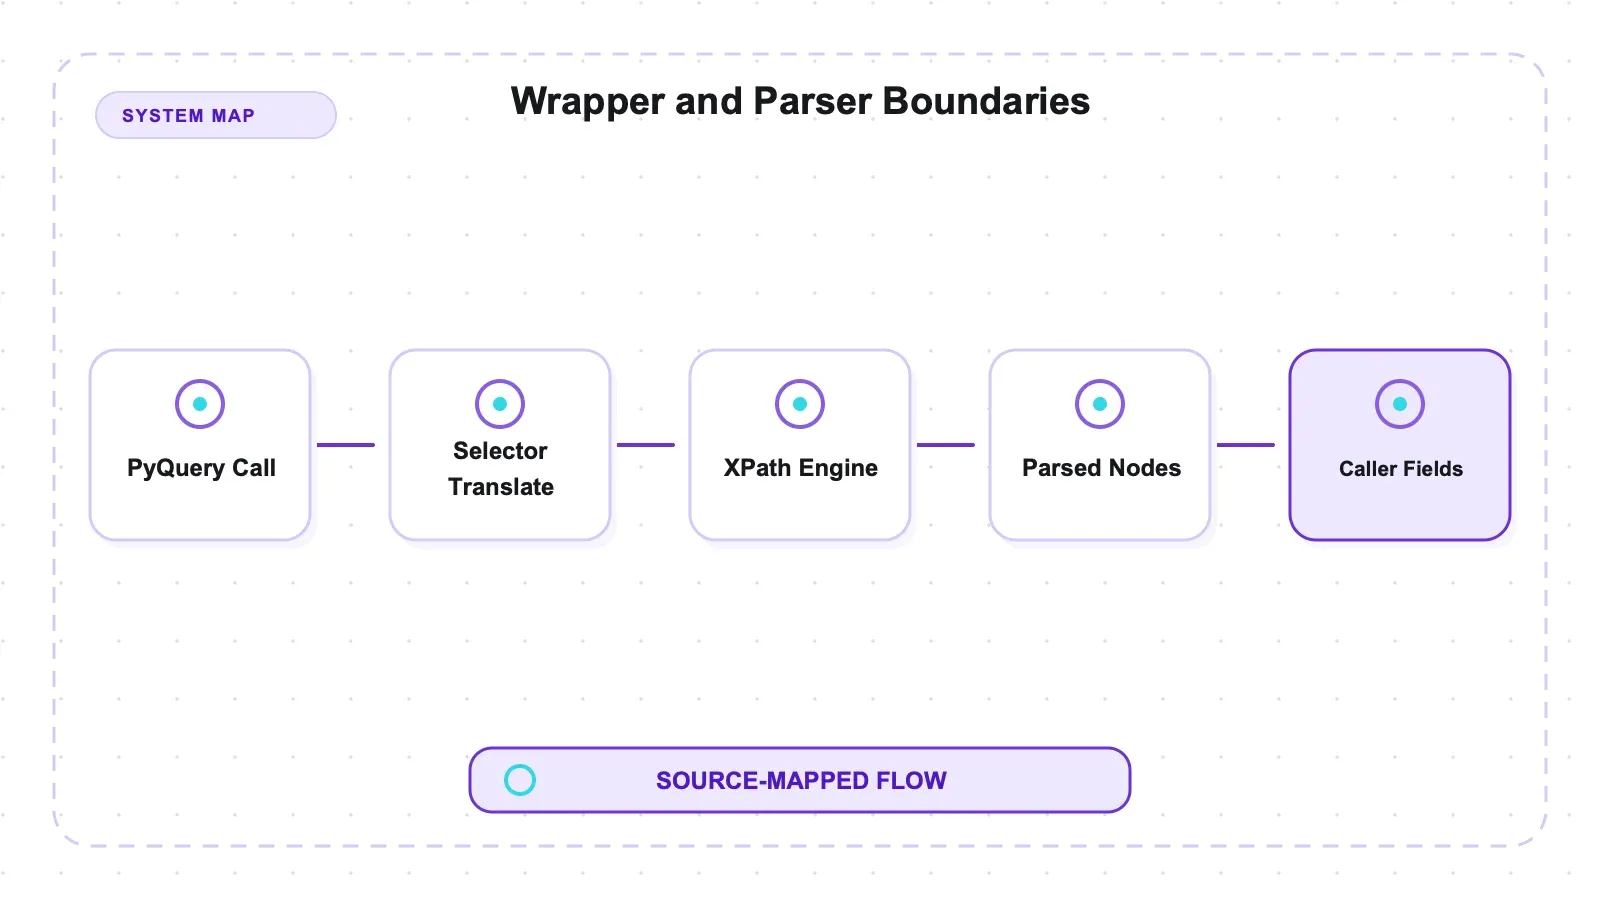
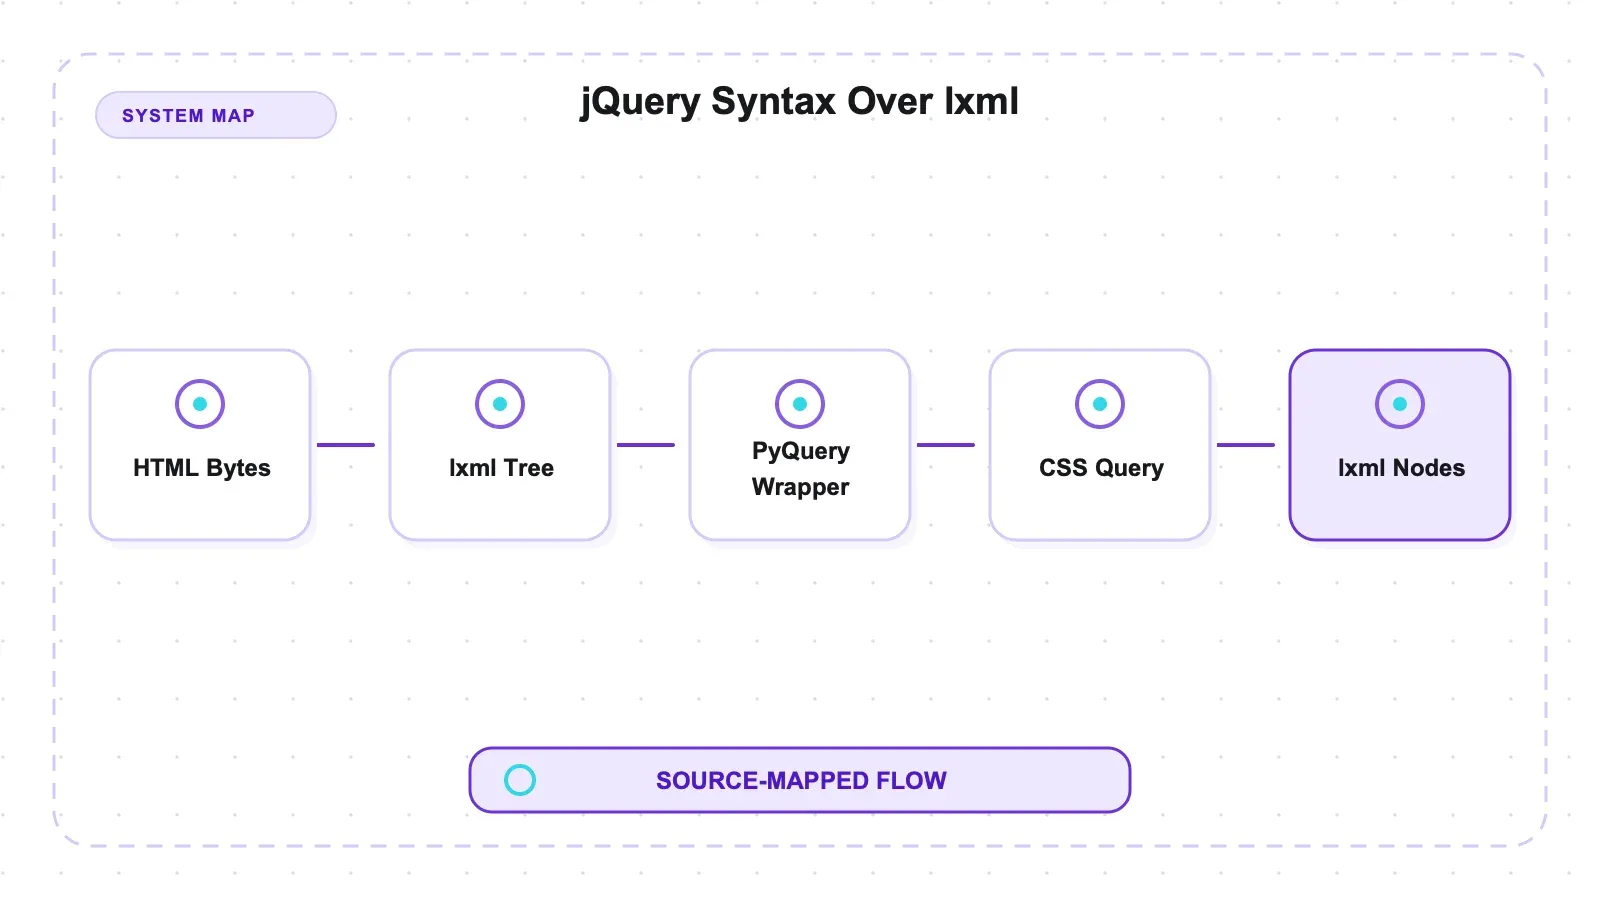
Cơ chế khá đơn giản: pq(html) tạo cây lxml một lần, d("h3.title") biên dịch CSS selector qua cssselect giống như tree.cssselect(), và các phần tử trả về vẫn là phần tử lxml. Nói cách khác, PyQuery gần như không làm gì nhiều trong đường nóng được đo ở đây. Các phần như traversal, thao tác DOM, truy vấn lặp lại, thời gian import và bộ nhớ vẫn nằm ngoài khẳng định về thời gian selector.
Kết quả sát nút từ 10 KB trở lên
Phát hiện hữu ích hơn nằm ở cột đầu tiên.
Từ 10 KB trở lên, độ chênh giữa parser nhanh nhất và chậm nhất trong selectolax, lxml và PyQuery là 4,5% ở 10 KB, 5,4% ở 100 KB, 0,5% ở 1 MB, và 4,5% ở 10 MB. Đây không phải một bài kiểm tra tương đương; kết luận thực tế là những khoảng chênh này sẽ không làm thay đổi lựa chọn parser trong phần lớn trường hợp của workload này.
selectolax thật sự nhanh hơn ở 1 KB — 0,0286 ms so với 0,0456 và 0,0508 — nhưng dòng này không dùng được. Trong ba parser, độ chênh ở kích thước đó là 77,6%, và chính ba lần chạy của selectolax cũng dao động từ 0,0267 đến 0,0404 ms. Ở mức 28 micro giây, timer và scheduler đã chi phối kết quả. Tôi sẽ không xếp hạng gì ở đó.
Với workload chỉ cần selector và đọc dữ liệu này, hãy chọn giữa ba lựa chọn dựa trên API và các факt phụ thuộc đã đo được, thay vì giả định một thứ bậc tốc độ sẵn có. PyQuery không cho thấy bất kỳ chi phí nào đủ đáng kể so với lxml. selectolax dùng một stack parser khác, nhưng bài viết này không đo footprint cài đặt, độ phủ wheel hay yêu cầu build của nó trên cùng một cơ sở.
Để so sánh, benchmark đã công bố đặt thêm hai lựa chọn Python khác lên cùng fixture 10 MB, và đó mới là những cái thực sự khác biệt:
| Parser (10 MB) | p50 |
|---|---|
| selectolax (lexbor) | 159,93 ms |
| lxml | 172,93 ms |
| parsel | 231,85 ms |
| selectolax (modest) | 247,95 ms |
| BeautifulSoup + lxml | 2.261,56 ms |
| BeautifulSoup + html.parser | 2.788,75 ms |
Các số liệu đã công bố từ bench_parse.json.
Các hàng benchmark lịch sử cho thấy BeautifulSoup chậm hơn hơn một bậc độ lớn so với các median parser nhanh hơn trên fixture này. Những hàng đó không được chạy lại với cặp PyQuery/lxml trong tiến trình hiện tại, nên chúng chỉ có giá trị làm bối cảnh chứ không phải một hệ số so sánh kiểm soát cho kết luận chính.
Hàng lưu trữ của cheerio là 2.927,89 ms (2927.8857 trong parser-bench.json) và các hash nội dung trích xuất khớp nhau. Kết quả khác runtime này cũng phụ thuộc vào Node, phiên bản package và các điều kiện chạy lịch sử; vì thế không nên đọc nó như một hệ số tốc độ chỉ của riêng thư viện.
Thực tế về thiết lập
| Thư viện | Gói | Dung lượng | Giấy phép | Sao | Lần đẩy cuối |
|---|---|---|---|---|---|
| PyQuery | 3 | 20,1 MiB | BSD | 2.380 | 2026-07-27 |
| cheerio (Node) | 22 (npm) | 9,0 MiB | MIT | 30.449 | 2026-08-11 |
Tài liệu chính thức: PyQuery trên PyPI.
Ba gói là một footprint phụ thuộc khá gọn, và hai trong số đó — lxml và cssselect — vốn đã xuất hiện trong rất nhiều dự án scraping Python. Trong trường hợp đó, chi phí tăng thêm của PyQuery chỉ là vài chục kilobyte.
Con số 20,1 MiB là phần extension biên dịch của lxml, không phải của PyQuery. Đó chính là khoảng dung lượng bạn vẫn phải trả nếu dùng lxml trực tiếp.
Thư viện có giấy phép BSD. Ở snapshot thời điểm đó, nó có 59 issue đang mở và có một lần đẩy mã cách thời điểm kiểm thử ba tuần; chỉ riêng những quan sát này không đủ để kết luận chất lượng bảo trì hay khả năng tương thích trong tương lai.
Bộ nhớ, và HTML hỏng làm gì với nó
Hai điều mà mọi bài review trong loạt này từng ghi là chưa kiểm thử, nay đã được đo.
Bối cảnh stress-test rộng hơn nằm trong so sánh bộ nhớ và HTML lỗi của mười thư viện.
Bộ nhớ resident đỉnh, đo qua /usr/bin/time -l, mỗi ô là một tiến trình mới — import floor là chi phí khi thư viện được nạp nhưng đang idle, còn peak bao gồm cả tài liệu.
| Thư viện | Runtime | Import floor | Peak 226 KB | Peak 10 MB |
|---|---|---|---|---|
| html2text | python3.14 | 18,7 | 19,9 | 71,2 |
| pyquery | python3.14 | 30,3 | 33,9 | 172,5 |
| resiliparse | python3.14 | 20,5 | 25,1 | 225,1 |
| markdownify | python3.14 | 23,9 | 28,9 | 278,5 |
| goose3 | python3.14 | 44,1 | 52,4 | 398,5 |
| cheerio | node22 | 66,8 | 76,5 | 398,5 |
| justext | python3.14 | 30,3 | 36,6 | 431,2 |
| newspaper4k | python3.14 | 52,6 | 61,8 | 668,5 |
| trafilatura | python3.14 | 52,5 | 64,8 | 927,1 |
| turndown | node22 | 47,8 | 68,4 | 2947,1 |
memory-results.json. Baseline của Python và Node không thể so sánh trực tiếp với nhau; bộ chạy (interpreter) nằm trong cả hai.
PyQuery nhẹ hơn resiliparse trên tài liệu lớn — 172,5 MiB so với 225,1 — dù import floor cao hơn. Cây lxml khá gọn, và phần lớn mức floor 30,3 MiB của PyQuery là do lxml được nạp, chứ không phải do bản thân PyQuery tiêu tốn.
HTML lỗi. Mười hai tài liệu, mỗi tài liệu cố tình hỏng đúng một kiểu — thẻ không đóng, inline lồng sai, thuộc tính có khoảng trắng nhưng không đặt trong ngoặc kép, thẻ đóng lạc chỗ, không có <html> nào cả, thuộc tính trùng lặp, tài liệu bị cắt ngang giữa thẻ, entity lỗi, một <script> không đóng, khai báo charset sai sự thật, một comment chứa markup, và 600 tầng lồng nhau — cộng thêm hai tài liệu chuẩn làm đối chứng ở kích thước tương ứng, vì câu “nó trả về rỗng” chỉ có ý nghĩa về độ lỗi nếu thư viện cũng im lặng trên một tài liệu sạch có cùng kích thước.
pyquery ném lỗi trên 0/14 và trả về rỗng trên 1, khôi phục được 10/22 sentinel qua các fixture lỗi (malformed-results.json). Một fixture bị loại khỏi phép đếm này: theo chuẩn HTML5, mọi thứ sau một <script> không đóng đều là nội dung script, nên mất dữ liệu ở đó là đúng, còn việc khôi phục nó mới là lệch chuẩn. Nếu không đặt cạnh các kết quả sentinel của lựa chọn thay thế trực tiếp, con số 10/22 chỉ là một quan sát về độ chịu lỗi, chứ chưa phải bảng xếp hạng parser.
Ưu và nhược điểm
Điểm mạnh. Cú pháp jQuery, quen thuộc với bất kỳ ai từng viết JavaScript front-end hoặc dùng cheerio. Trong fixture này không thấy chi phí selector đáng kể so với lxml thuần. Chỉ có 3 gói phụ thuộc, và 2 gói trong số đó rất có thể bạn đã có sẵn. Nó trả về phần tử lxml nên vẫn dùng được các kỹ thuật của lxml. BSD. Hash nội dung khớp với bản tham chiếu ở cả năm kích thước.
Điểm yếu. 20,1 MiB, vì lxml. 2.380 sao là một cộng đồng nhỏ hơn nhiều so với 30.449 của cheerio — nghĩa là khi gặp tình huống lạ sẽ có ít ví dụ thực chiến hơn. Đây là một lớp tiện ích, nên lxml không làm được gì thì nó cũng không làm được. Và nếu bạn hy vọng API kiểu jQuery mang lại hiệu năng, thì không: nó mang lại sự tiện tay, còn phần việc thật sự vẫn do parser bên dưới đảm nhiệm.
Ai nên dùng và ai không nên dùng
Nên dùng PyQuery khi bạn hoặc đội ngũ thích cú pháp selector kiểu jQuery trong Python. Phần tạo cây, hai truy vấn và đọc dữ liệu được đo cho thấy không có chi phí đáng kể so với lxml; các thao tác PyQuery khác chưa được tính thời gian.
Nên dùng lxml trực tiếp nếu bạn thích XPath hoặc muốn bớt đi một package. Lần chạy này không cho thấy lý do về tốc độ selector để chọn bên nào hơn bên nào.
Nên cân nhắc selectolax nếu API parser và stack phụ thuộc của nó phù hợp với dự án của bạn. Dòng 1 KB đã được cố ý không xếp hạng, và bài viết này cũng không đủ để kết luận về “ít phụ thuộc nhất”.
Trong Node, cheerio là hình thức API tương tự. Các hàng cross-runtime được lưu trữ ở đây chậm hơn, nhưng khác biệt giữa runtime và điều kiện chạy lịch sử khiến không thể rút ra một kết luận chỉ về thư viện.
Khi nào API được quản lý phù hợp
PyQuery chỉ phân tích HTML mà bạn đã có sẵn. Nó không tự tải trang, không render JavaScript, cũng không xử lý lớp chống bot — và trên nhiều đích thực tế, phần khó hơn chính là nửa đó.
Ghi chú của tác giả: Thunderbit là lựa chọn được quản lý của chúng tôi cho việc lấy URL, render và trích xuất dữ liệu. Nó không được benchmark đối chiếu với PyQuery trong bài này. Ranh giới cần quan tâm là: bạn đã có HTML và muốn dùng selector cục bộ, hay bạn muốn việc lấy trang và trích xuất được vận hành như một dịch vụ.
Nói thật ngắn gọn: nếu bạn đã có HTML và biết rõ selector của mình, PyQuery là lựa chọn miễn phí và dễ chịu. Nếu selector cứ hỏng liên tục, hoặc bạn đang fetch ở quy mô lớn, đó là một bài toán khác.
Đối với bức tranh rộng hơn, bài tổng hợp web scraping API của chúng tôi bao gồm các giải pháp hosted, còn bài trụ cột scraper mã nguồn mở nói về các lựa chọn self-hosted. Nếu đầu ra đã parse sẽ đưa vào mô hình, chuyển HTML sang Markdown trong Python là nơi độ trung thực dữ liệu bắt đầu thất thoát.
Dùng thử Thunderbit để trích xuất dữ liệu web
Có nên dùng PyQuery không?
Có, nếu bạn muốn cú pháp kiểu jQuery trong Python và đường dẫn selector/đọc dữ liệu được đo ở đây phản ánh đúng workload của bạn.
Benchmark không phát hiện chi phí selector đáng kể so với lxml, trong khi vẫn giữ parity của hash nội dung. Tuy nhiên, nó cũng không chứng minh rằng toàn bộ thư viện là “không tốn gì”.
Trên năm kích thước khác nhau, median của ba parser Python đều đủ sát nhau để độ phù hợp API nhiều khả năng quan trọng hơn. Hãy tự định nghĩa một ngưỡng tương đương rồi chạy lại đúng các lựa chọn thay thế đó trước khi biến nhận định này thành xếp hạng parser rộng hơn.
Dùng thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
PyQuery có làm chậm lxml không?
Trong lần chạy này không thấy chi phí selector đáng kể. Trên năm kích thước trang, các median đều nằm bằng hoặc dưới lxml thuần, và cả hai đều dùng lxml 6.1.1 trong cùng một tiến trình. Ở mức 10 MB, các dải giá trị khá sát nhưng không chồng lấn: PyQuery 161,13–163,17 ms và lxml 164,18–169,46 ms. pq(html) tạo cây lxml, và các selector được kiểm thử đều biên dịch qua cssselect.
selectolax có nhanh hơn PyQuery không? Median ở 1 KB của nó thấp hơn, nhưng dòng đó không được xếp hạng vì độ dao động ở thang micro giây lấn át mọi thứ. Từ 10 KB trở lên, độ chênh median là 0,5%–5,4%. Với workload này, đó là khá gần nhau, chưa đủ để chứng minh tương đương hay chồng lấn hoàn toàn trong mọi trường hợp.
Vì sao phải chạy lại lxml thay vì chỉ trích dẫn con số đã công bố? Vì benchmark đã công bố có ghi máy và phiên bản Python nhưng không ghi phiên bản thư viện. Hàng lxml của nó có thể đến từ một bản lxml khác với bản mà PyQuery đang bọc hiện nay, và một khác biệt phiên bản sẽ bị hiểu nhầm thành “chi phí wrapper” trong khi thực tế không có. Chạy cả hai trong cùng tiến trình với lxml 6.1.1 sẽ loại bỏ sự mơ hồ đó.
So với cheerio thì sao? Cùng ý tưởng API, nhưng hệ sinh thái khác nhau. Hai selector được kiểm thử ở đây hoạt động trên cả hai và hash nội dung khớp ở cả năm kích thước; điều đó không đồng nghĩa với tương thích selector đầy đủ. Các số đo lưu trữ của cheerio chậm hơn, nhưng khác biệt runtime và điều kiện chạy lịch sử khiến không thể quy kết thành hệ số chỉ của riêng thư viện.
Những gì chưa được kiểm thử ở đây là gì? Bộ nhớ được đo theo peak RSS cho ba trường hợp: chỉ import, tài liệu 226 KB và tài liệu 10 MB. HTML lỗi được kiểm tra bằng 12 tài liệu hỏng cộng hai đối chứng chuẩn. Những phần vẫn chưa kiểm thử gồm hiệu năng thao tác và traversal của PyQuery, cache cho truy vấn lặp lại, việc lấy URL, concurrency, và workload thực tế đại diện cho website thật. Mốc 1 KB vẫn chưa được xếp hạng.




