
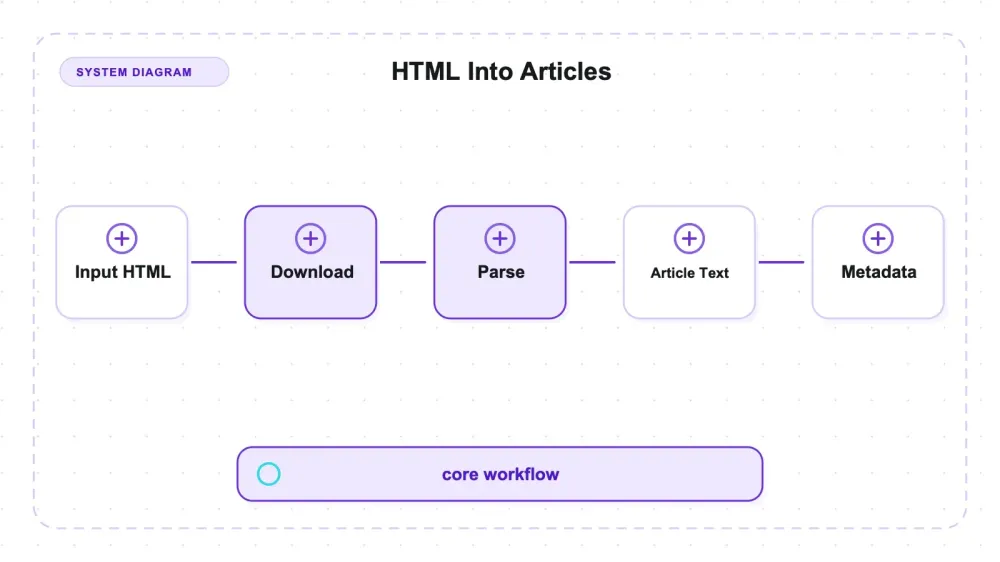
Trong một bộ fixture có chú thích, tập trung vào bài viết, newspaper4k tạo đầu ra trên toàn bộ 22 fixture, khôi phục được 98,65% các đơn vị nội dung bài viết được chấm điểm, và không chứa bất kỳ token boilerplate nào đã gắn nhãn. Ba yếu tố này khiến nó trở thành một lựa chọn rất mạnh theo ưu tiên của bài kiểm tra này; nhưng chúng không đủ để khẳng định nó là lựa chọn tốt nhất tuyệt đối.
Không có công cụ nào khác trong bộ này đạt cùng lúc cả ba kết quả quan sát được đó. Mozilla Readability khôi phục được mọi đơn vị nội dung được chấm điểm nhưng lại lẫn nhiều boilerplate hơn; goose3 không lẫn boilerplate nhưng lại trả về chuỗi rỗng hai lần. Các tiêu chí đánh giá khác có thể dẫn tới việc chọn thư viện khác.
Có một mặc định về cách lấy dữ liệu cần được chú ý rõ ràng trước khi triển khai.
newspaper4k là gì
newspaper4k là một nhánh được duy trì từ newspaper3k, vốn là phiên bản tiếp nối cho Python 3 của newspaper gốc. Dòng lịch sử này rất quan trọng khi bạn tìm kiếm tài liệu hỗ trợ, vì phần lớn kết quả bạn thấy trên mạng sẽ nói về thư viện tiền thân, và một số API của nó đã thay đổi vị trí.
Tài liệu chính thức: repo chính thức của newspaper4k.
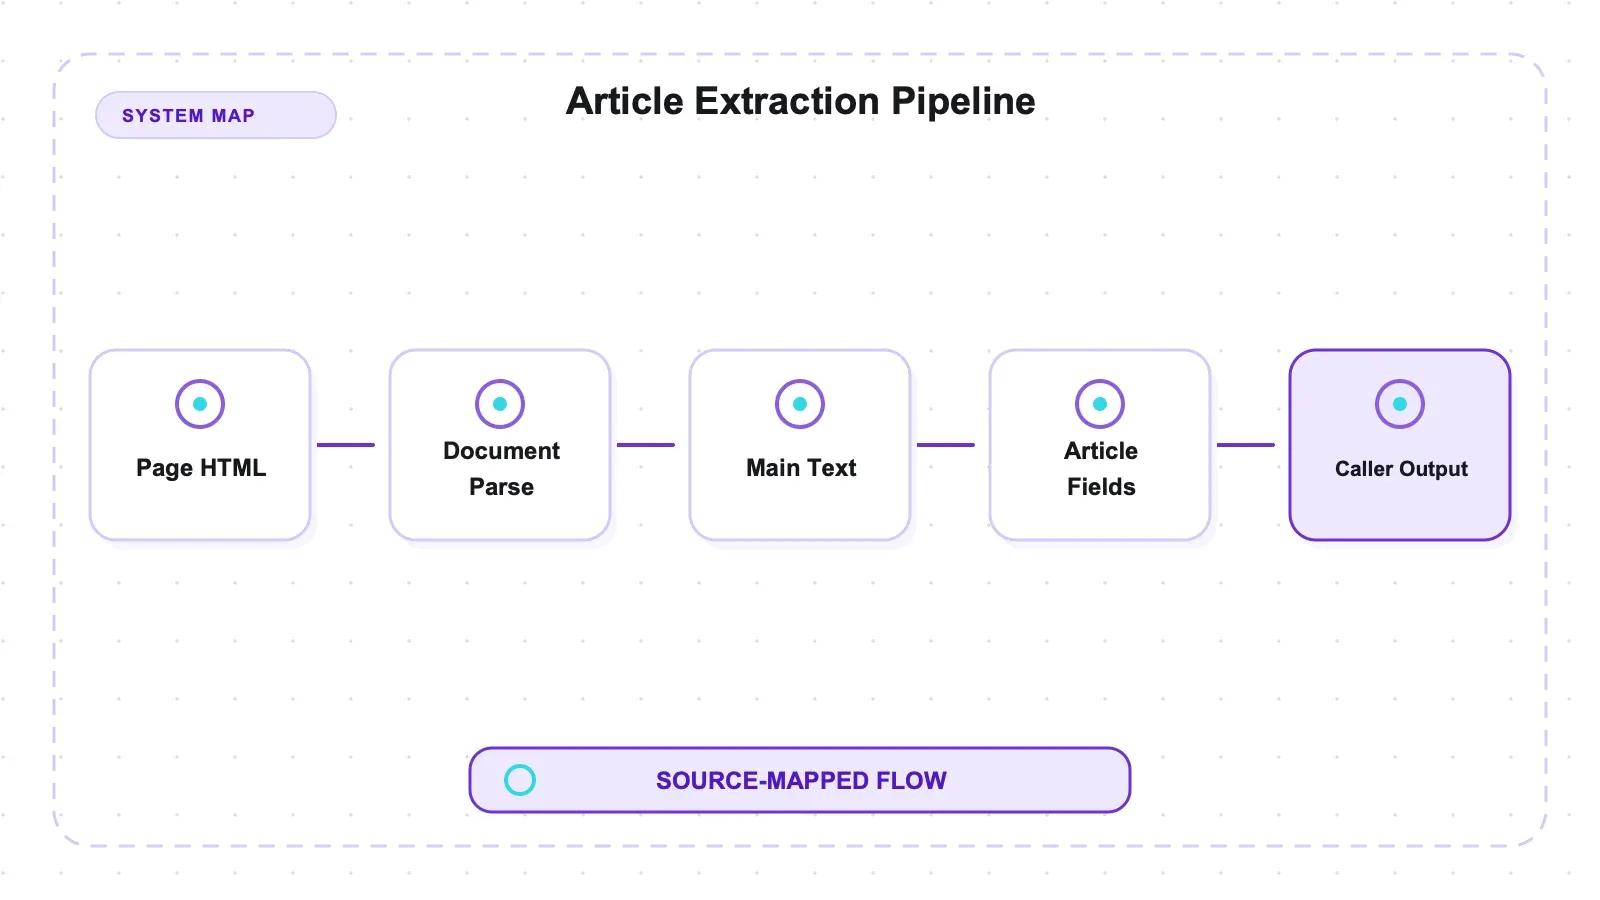
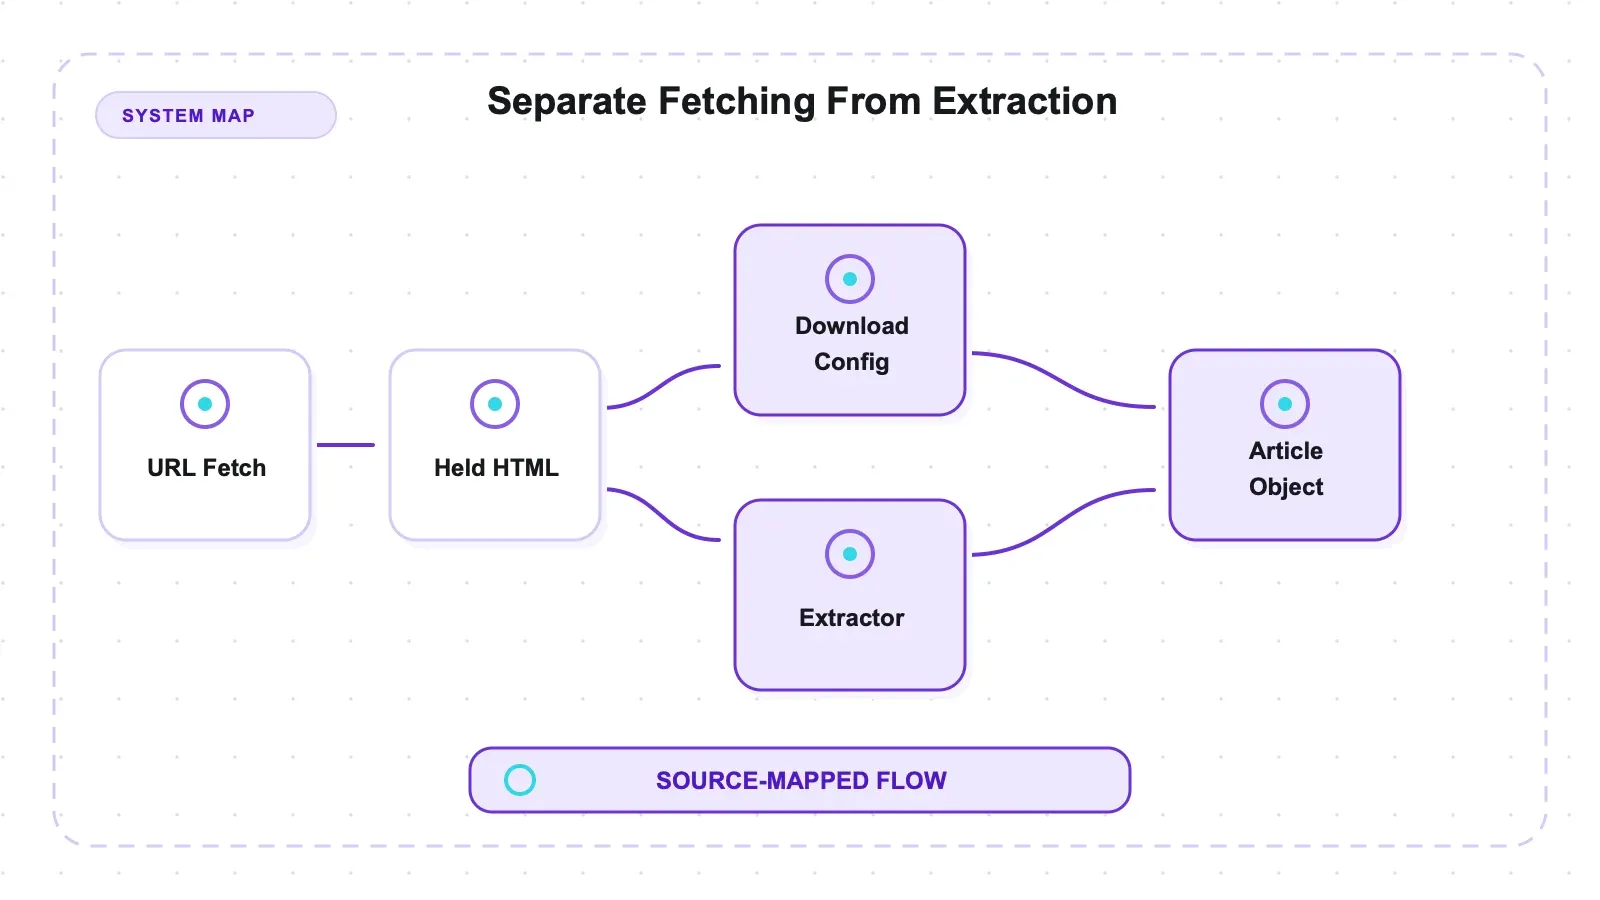
Một lỗi rất phổ biến khi dùng thư viện này, chẳng hạn, là tìm đến set_html(). Phương thức đó không tồn tại. HTML được đưa vào qua download():
from newspaper import Article
a = Article(url="https://example.com/story")
a.download(input_html=html)     # not set_html()
a.parse()
text = a.text
Lần chạy đầu tiên tôi cũng làm sai ở chỗ này và chấm thư viện 0/22 fixture trước khi kiểm tra xem lỗi có nằm ở mình không. Và đúng là lỗi của tôi.
Kết quả trả về không chỉ là văn bản. Đối tượng Article còn có các trường như text, title, authors, publish_date, top_image, images, movies, meta_description, meta_lang, tags và article_html. keywords và summary cần cài thêm NLP tùy chọn cùng bộ dữ liệu corpus như mô tả bên dưới. Phạm vi trường dữ liệu đã được kiểm kê, nhưng độ chính xác metadata không được chấm điểm.
Phiên bản đã thử: 0.9.6, MIT, 1.135 sao GitHub, với lần đẩy repo được ghi nhận ngày 2026-07-31. Mốc hoạt động này chỉ là ảnh chụp thời điểm, không phải đánh giá đầy đủ về sức khỏe bảo trì. Python 3.14.2.
Kết quả
| Thư viện | Độ bao phủ bài viết (22/22) | Rò rỉ boilerplate | Độ chính xác token nội dung | Token gây nhiễu | Có đầu ra |
|---|---|---|---|---|---|
| Readability | 1.0000 | 0.2353 | 0.9109 | 35 | 22/22 |
| trafilatura | 0.9865 | 0.0588 | 0.9411 | 4 | 22/22 |
| newspaper4k | 0.9865 | 0.0000 | 0.9452 | 0 | 22/22 |
| resiliparse | 0.9054 | 0.0588 | 0.9381 | 7 | 22/22 |
| jusText | 0.8378 | 0.4706 | 0.8760 | 74 | 19/22 |
| goose3 | 0.8243 | 0.0000 | 1.0000 | 0 | 20/22 |
sixway-scores.json. Mỗi đơn vị trong từng fixture đều có một sentinel token riêng, nên “khôi phục” và “rò rỉ” được xác định bằng việc có chứa chính xác chuỗi con đó, chứ không phải bằng điểm tương đồng. Độ bao phủ được tính trên toàn bộ 22 fixture; còn độ rò rỉ và độ chính xác được tính trên 11 fixture có cả bài viết lẫn boilerplate.
Có ba cột cần tách riêng để hiểu đúng.
Nó trả lời được trên mọi trang. goose3 và jusText thì không — lần lượt chỉ 20 và 19 trên 22. Điều này quan trọng hơn vẻ ngoài của nó, vì precision và F1 trong bảng như thế này phụ thuộc vào việc có xuất ra kết quả hay không: một thư viện trả về chuỗi rỗng sẽ không đóng góp gì vào hai vế của tỷ lệ, nên việc “không trả gì” gần như là miễn phí. Precision 1.0000 của goose3 chỉ được chấm trên 10/11 fixture; còn 0.9452 của newspaper4k là trên 11/11. Hai con số này không hoàn toàn đo cùng một thứ.
Nó không rò rỉ gì cả. Bộ fixture có các đoạn boilerplate mang tính đối kháng được đặt chủ ý — các khối quảng bá mang lớp trung tính nằm cạnh bài viết, các luồng bình luận dùng class tên vô hại, các khối quảng cáo không hề ghi “ad”. Readability với heuristics ghép anh em (sibling-append) đã nuốt mất vài đoạn; newspaper4k không dính đoạn nào trong số đó.
Nó chỉ bỏ sót một đơn vị trong 74, và đơn vị bị bỏ sót lại trùng với một trường hợp khác.
Phần bỏ sót nằm ở fixture phi văn xuôi — một trang được tạo từ bảng, khối mã, các mục ngắn và chú thích ảnh thay vì các đoạn văn — và đơn vị bị bỏ là caption. Nó không phải là thư viện duy nhất gặp điều này:
| Thư viện | Độ bao phủ trên trang phi văn xuôi | Đơn vị bị bỏ |
|---|---|---|
| Readability | 1.000 | — |
| jusText | 1.000 | — |
| trafilatura | 0.875 | caption |
| resiliparse | 0.875 | caption |
| newspaper4k | 0.875 | caption |
| goose3 | 0.250 | cả hai bảng, khối mã, cả hai mục ngắn, caption |
Ba thư viện bỏ cùng một caption và không bỏ đơn vị nào khác, điều này giống một giả định di truyền dùng chung về việc caption “đáng giá” đến đâu hơn là ba lỗi riêng lẻ. Nếu nội dung của bạn là tài liệu hướng dẫn, công thức nấu ăn hoặc bất cứ thứ gì mà caption mang thông tin mà đoạn văn không có, đây là điểm rất đáng kiểm tra trước khi chốt — và cả Readability lẫn jusText đều giữ lại phần này.
Chính fixture này cũng là nơi goose3 sụp hẳn, mất ba phần tư trang, nên “nội dung phi văn xuôi” là một trục mà sáu thư viện này khác nhau nhiều hơn bảng tổng quan gợi ý.
Về tốc độ, thời gian trích xuất trung vị của newspaper4k trên 22 fixture là 2,69 ms, chậm nhất trong sáu thư viện, với trường hợp xấu nhất là 199,81 ms. So với mức trung vị 0,06 ms của resiliparse, đây là khoảng cách 45 lần trong lần chạy kiểm soát này. Trung vị có thể nhỏ trong một workflow xử lý một trang đơn lẻ, nhưng thông lượng và độ trễ đuôi dưới tải thì chưa được kiểm tra. Tác động khi import lạnh được đo riêng ở phần dưới.
Mặc định tôi sẽ đổi ngay từ dòng đầu tiên
Tài liệu chính thức: tài liệu newspaper4k.
Xem đối tượng Configuration đi kèm sẽ thấy có 22 thiết lập. Một trong số đó là:
_honor_robotstxt = False
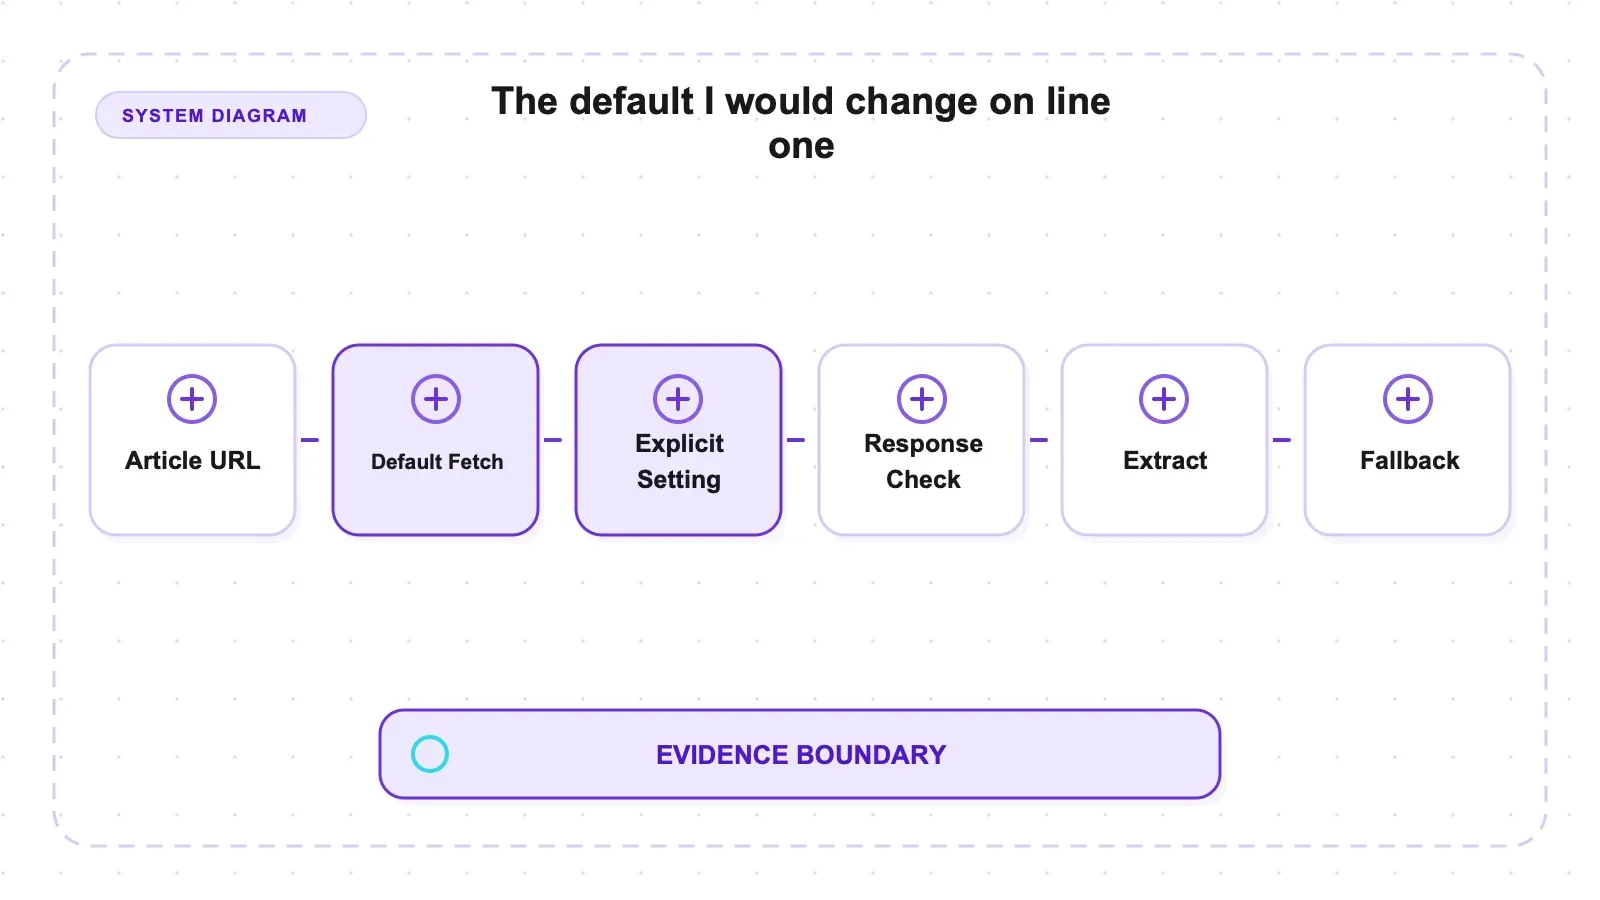
newspaper4k không tuân thủ robots.txt trừ khi bạn chủ động yêu cầu. Nếu bạn để nó tự fetch — Article(url).download() mà không truyền input_html — nó sẽ lấy bất cứ URL nào bạn đưa vào, bất kể file robots của site nói gì.
Đó là một mặc định kỹ thuật có thể chấp nhận được với một thư viện mà mục đích chính là phân tích HTML đã có sẵn trong tay bạn; nhưng sẽ là một mặc định rất tệ nếu bạn phát hiện ra nó trong môi trường production sau khi đã trỏ vào cả nghìn URL. Hãy đặt honor_robotstxt=True trong Configuration, hoặc truyền input_html và tự lo phần fetch, như tôi đã làm trong toàn bộ bài kiểm tra này.
Hai thiết lập khác cũng đáng biết:
number_threads = 10. Mức song song mặc định cho các helper đa bài viết là mười. Song song không đồng nghĩa với số request mỗi giây, nhưng nó vẫn có thể tạo ra một đợt request đồng thời nếu bạn không đặt giới hạn theo host và lịch chạy rõ ràng.
fetch_images = True. Việc tải ảnh được bật sẵn, nên nảy sinh câu hỏi về khả năng dùng ngoại tuyến. Với socket.connect bị chặn, luồng newspaper4k 0.9.6 đã được kiểm tra — download(input_html=…) rồi parse() trên một input HTML đã giữ sẵn — vẫn chạy xong, trả về 1.292 ký tự, và không hề thử kết nối mạng. Điều này chỉ xác nhận đúng đường đi đó, chứ không khẳng định cho mọi cấu hình, plugin, kiểu nội dung hay bản phát hành tương lai.
Các thiết lập còn lại khá hợp lý: min_word_count 300, min_sent_count 7, max_text 100.000, http_success_only True, memorize_articles True, follow_meta_refresh False, allow_binary_content False.
Thực tế cài đặt
pip install newspaper4k kéo về 22 gói và 47,5 MiB trong khoảng sáu giây. Import lạnh trong một subprocess mới: 2,812 s — chậm nhất trong so sánh.
| Thư viện | Số gói | site-packages | Import lạnh | Extraction p50 |
|---|---|---|---|---|
| resiliparse | 5 | 21.0 MiB | 0.015 s | 0.06 ms |
| jusText | 3 | 22.4 MiB | 0.777 s | 0.56 ms |
| goose3 | 16 | 44.3 MiB | 2.181 s | 1.85 ms |
| newspaper4k | 22 | 47.5 MiB | 2.812 s | 2.69 ms |
| trafilatura | 17 | 69.9 MiB | 1.584 s | 0.51 ms |
install-and-import.json. Mỗi thư viện nằm trong một virtualenv trống riêng, nên không có chuyện phụ thuộc được thừa kế từ thư viện khác.
2,812 giây để import là gấp 187 lần so với 15 mili-giây của resiliparse. Trong một worker chạy lâu dài, bạn chỉ trả cái giá này một lần nên nó gần như không đáng kể. Nhưng trong một hàm serverless, bạn phải trả nó ở mỗi lần cold start, và đó là tình huống newspaper4k không phải lựa chọn đúng, bất kể khả năng trích xuất của nó tốt đến đâu.
Có một điểm gồ ghề khi cài đặt. Khi import, thư viện in ra cảnh báo:
UserWarning: nltk is not installed. Some NLP features will be unavailable. Install it with: pip install 'newspaper4k[nlp]'
Bài kiểm tra này không cần các tính năng đó và việc trích xuất vẫn chạy tốt dù không có chúng, nhưng bản cài cơ bản không phải là bản cài đầy đủ, và newspaper4k[nlp] sẽ kéo theo một cây phụ thuộc nặng hơn nhiều cùng các lần tải corpus. Chỉ nên tính thêm phần này nếu bạn thật sự cần keywords và summaries.
Bộ nhớ, và HTML hỏng ảnh hưởng đến nó như thế nào
Hai điểm mà mọi bài review trong nhóm này từng ghi là chưa kiểm thử, nay đã được đo.
Bối cảnh stress-test rộng hơn nằm trong bài so sánh bộ nhớ và HTML lỗi của mười thư viện.
Bộ nhớ resident cực đại, đo bằng /usr/bin/time -l, mỗi ô là một tiến trình mới — mức nền import là chi phí của thư viện khi đã nạp và đang nhàn rỗi, còn mức đỉnh bao gồm cả tài liệu.
| Thư viện | Runtime | Mức nền import (MiB) | Đỉnh với HTML 226 KB (MiB) | Đỉnh với HTML 10 MB (MiB) |
|---|---|---|---|---|
| html2text | python3.14 | 18.7 | 19.9 | 71.2 |
| pyquery | python3.14 | 30.3 | 33.9 | 172.5 |
| resiliparse | python3.14 | 20.5 | 25.1 | 225.1 |
| markdownify | python3.14 | 23.9 | 28.9 | 278.5 |
| goose3 | python3.14 | 44.1 | 52.4 | 398.5 |
| cheerio | node22 | 66.8 | 76.5 | 398.5 |
| justext | python3.14 | 30.3 | 36.6 | 431.2 |
| newspaper4k | python3.14 | 52.6 | 61.8 | 668.5 |
| trafilatura | python3.14 | 52.5 | 64.8 | 927.1 |
| turndown | node22 | 47.8 | 68.4 | 2947.1 |
memory-results.json. Mức nền Python và Node không thể so sánh trực tiếp với nhau; trình thông dịch đã nằm bên trong cả hai.
Mức nền của newspaper4k là 52,6 MiB và đỉnh với HTML 10 MB là 668,5 MiB — đứng thứ hai nặng nhất trong nhóm Python. Cả hai con số đều không thành vấn đề với trang thông thường; nhưng chúng trở nên quan trọng nếu bạn batch tài liệu lớn trong một worker có giới hạn bộ nhớ.
HTML lỗi. Mười hai tài liệu, mỗi tài liệu chỉ hỏng đúng một thứ — thẻ chưa đóng, phần tử inline lồng sai, thuộc tính không có dấu ngoặc kép nhưng chứa khoảng trắng, thẻ đóng lạc chỗ, không có <html> nào cả, thuộc tính trùng lặp, tài liệu bị cắt giữa thẻ, entity sai, một <script> chưa đóng, khai báo charset nói dối, một comment chứa markup, và độ lồng 600 tầng — cộng thêm hai control hợp lệ với kích thước tương ứng, vì việc “nó không trả gì” chỉ nói lên điều gì đó về mức độ lỗi nếu thư viện đó cũng im lặng với một tài liệu sạch cùng kích thước.
Control và các trường hợp lỗi tách bạch rõ trong kết quả thô:
| Nhóm | Số tài liệu | Có lỗi ngoại lệ | Đầu ra rỗng | Khôi phục sentinel được chấm |
|---|---|---|---|---|
| Control hợp lệ, kích thước tương ứng | 2 | 0 | 0 | không dùng trong điểm lỗi malformed |
| Fixture lỗi | 12 | 0 | 10 | 5/33, không tính trường hợp <script> chưa đóng |
Hai control tạo ra lần lượt 70 và 1.351 ký tự, trong khi 10/12 đầu vào lỗi cho ra chuỗi rỗng. Điều đó khiến sự im lặng có thể quy cho lỗi malformed trong thiết kế fixture này, chứ không chỉ đơn thuần là do đầu vào ngắn. Bộ chấm điểm kiểm tra sentinel ở heading, paragraph và link trên 11 tài liệu malformed đủ điều kiện. Fixture <script> chưa đóng bị loại trừ vì theo cách phân tích HTML5, markup theo sau vẫn được xem là nội dung script. Xem malformed-results.json. Đây là một giới hạn lớn về khả năng khôi phục cần tính vào lựa chọn, chứ không chỉ là một thành công kiểu “không ném lỗi”.
Ưu và nhược điểm
Điểm mạnh. Không có token boilerplate nào bị gắn nhãn trong so sánh này, có đầu ra trên cả 22 fixture bài viết được kiểm soát, và độ bao phủ bài viết được chấm đạt 0,9865. Nó cung cấp text bài viết cùng các trường metadata, dù độ chính xác metadata không được kiểm tra. Đường đi giữ HTML trong tay được thử nghiệm và không hề phát sinh kết nối mạng khi socket.connect bị chặn. Repo có lần đẩy mới được gắn ngày lúc kiểm tra; còn sức khỏe bảo trì tổng thể thì chưa được đánh giá.
Điểm yếu. Import lạnh nặng nhất trong toàn bộ nhóm, 2,812 s và 22 gói / 47,5 MiB site-packages đo được. honor_robotstxt mặc định là False, và các helper đa bài viết mặc định dùng mười luồng. Bản cài cơ bản còn cảnh báo thiếu NLTK, nên keywords và summaries cần bản cài tùy chọn nặng hơn. Quan trọng nhất: 10/12 fixture malformed trả về đầu ra rỗng, dù cả hai control hợp lệ đều cho ra văn bản.
Ai nên dùng, ai không nên dùng
Nên cân nhắc newspaper4k khi ưu tiên của bạn là: tạo được văn bản không rỗng trên corpus bài viết được kiểm soát, hạn chế tối đa boilerplate đã gắn nhãn trong corpus đó, và chấp nhận việc import lạnh chậm hơn. Theo quy tắc rõ ràng này, nó dẫn đầu trong so sánh fixture này. Nếu bạn đặt tiêu chí khác, Readability có thể phù hợp hơn nếu muốn giữ lại nội dung tối đa theo điểm chấm, còn resiliparse lại thắng về tốc độ khởi động và tốc độ trích xuất trung vị.
Nên bỏ qua hoặc kiểm tra rất kỹ trước khi dùng nếu cold start là yếu tố quyết định, nếu 47,5 MiB site-packages là quá lớn với bạn, hoặc nếu khả năng phục hồi từ HTML lỗi là quan trọng. Ở đây resiliparse import nhanh hơn 187 lần, nhưng nó cũng không ngang trafilatura trên mọi cột chất lượng: trafilatura có độ bao phủ bài viết cao hơn, còn hồ sơ rò rỉ và precision của hai bên cũng khác nhau. newspaper4k thiên về bài viết; các trang listing sản phẩm và dashboard chưa được thử, nên không có kết luận nào được đưa ra cho các loại đó.
Dù thế nào, hãy đặt honor_robotstxt nếu bạn để nó tự fetch. Đây không phải là một ghi chú về hiệu năng.
Khi nào dùng API được quản lý
newspaper4k có thể phân tích HTML do người gọi cung cấp và cũng có các luồng tự fetch. Một dịch vụ trích xuất được quản lý sẽ đặt phần thu thập, render và xử lý schema phía sau ranh giới nhà cung cấp. Chúng tôi xây dựng Thunderbit, nhưng nó không được chạy trên bộ fixture này, nên bài viết này không đưa ra so sánh nào về chất lượng, rendering, chống bot, độ trễ hay chi phí. Với HTML bài viết đã có sẵn trong tay, bằng chứng ở đây chỉ nói về newspaper4k; các mục tiêu không phải bài viết cần được đánh giá riêng.
Để xem cùng bộ fixture đó trên cả sáu extractor, hãy xem so sánh sáu thư viện trích xuất.
Với mảng dịch vụ hosted, bài tổng hợp API web scraping tốt nhất cho góc nhìn rộng hơn; với các lựa chọn tự host, xem bài trụ cột về scraper mã nguồn mở. Nếu văn bản sẽ được đưa vào mô hình, bài chuyển HTML sang Markdown trong Python sẽ nói rõ chỗ nào fidelity bị mất.
Dùng thử Thunderbit để trích xuất dữ liệu web
Có nên dùng newspaper4k không?
Hãy xem newspaper4k như một ứng viên mạnh cho việc trích xuất text bài viết khi HTML đã có sẵn, rồi thử nó trên corpus thực tế của bạn trước khi quyết định dùng chính thức. Bộ kiểm tra có kiểm soát này cho thấy độ bao phủ bài viết cao, không có boilerplate được gắn nhãn, và đầu ra không rỗng trên cả 22 fixture hướng bài viết. Tuy nhiên nó không phản ánh các trang thực tế hay độ chính xác metadata, và 10/12 fixture malformed vẫn trả về đầu ra rỗng.
Nếu bạn dùng đường đi fetch của nó, hãy xem kỹ honor_robotstxt=False, mô hình song song mười luồng, và giới hạn tốc độ theo từng host. Nếu cold start hoặc footprint phụ thuộc là vấn đề, hãy đo con số import cục bộ 2,812 giây và site-packages 47,5 MiB trong môi trường triển khai của bạn thay vì coi chúng như chi phí container phổ quát.
Dùng thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
Vì sao set_html() không hoạt động?
Vì trong newspaper4k, phương thức này không tồn tại. HTML phải được đưa vào qua download(input_html=html), sau đó gọi parse(). Kết quả tìm kiếm có thể hiển thị ví dụ của newspaper3k, nên rất dễ nhầm; tôi đã nhầm ngay ở lần chạy đầu và sửa lại harness trước khi chấm điểm.
newspaper4k có tôn trọng robots.txt không?
Không theo mặc định. honor_robotstxt được ship với giá trị False. Hãy đặt nó thành True trong Configuration nếu bạn để thư viện tự fetch, hoặc truyền input_html và tự fetch bên ngoài. Công việc nhiều bài viết cũng mặc định dùng mười luồng. Đó là mức song song được chọn sẵn, không phải tốc độ request cố định; hãy đặt giới hạn riêng cho từng host khi fetch.
parse() có tạo request mạng không?
Trên newspaper4k 0.9.6, đường đi download(input_html=…) rồi parse() được thử nghiệm không tạo bất kỳ lần kết nối nào cho một input HTML đã giữ sẵn trong khi socket.connect bị chặn. Điều đó không chứng minh mọi cấu hình parser, plugin, kiểu nội dung hay bản phát hành tương lai đều không dùng mạng.
Cảnh báo NLTK khi import là gì?
Bản cài cơ bản không có NLTK, nên trích xuất keyword và tóm tắt sẽ không dùng được, và thư viện báo điều đó ngay lúc import. Bản thân việc trích xuất thì không bị ảnh hưởng — tất cả phép đo ở đây đều chạy trên bản cài cơ bản. pip install 'newspaper4k[nlp]' sẽ thêm chúng cùng với cây phụ thuộc nặng hơn và các lần tải corpus.
Bài review này không kiểm tra gì? Các trang thực tế — đây là những fixture được kiểm soát với đơn vị đã gắn nhãn. Các trường metadata đã được kiểm kê nhưng không chấm điểm về độ chính xác tiêu đề, tác giả, ngày hay ảnh. Cũng chưa kiểm tra trích xuất đa ngôn ngữ, phần NLP bổ sung, crawl nguồn đa luồng, hay thông lượng dưới tải. Bộ nhớ đỉnh của tiến trình chỉ được đo trên một đầu vào HTML 226 KB và một đầu vào 10 MB, chứ không phải dưới tải đồng thời hay tải kéo dài.




