
Trên bốn bộ HTML mẫu được chia sẻ với markitdown, markdownify tạo ra cùng số dòng bảng Markdown đầu ra theo bộ đếm của chúng tôi — 36 so với 36 — và khôi phục đầy đủ 16 chuỗi nội dung đã kiểm tra. Kết quả 21.062 token của nó về mặt số liệu là thấp nhất, dù ba trình chuyển đổi đầu tiên chỉ lệch nhau trong phạm vi 1,3%. Công cụ này chỉ chiếm 1,8 MiB khi cài đặt, dùng giấy phép MIT, và tại thời điểm chụp dữ liệu có 2.235 sao trên GitHub.
Đây là thư viện ít được nhắc tới nhất trong nhóm này và, xét theo những con số trên, cũng là lựa chọn tôi sẽ ưu tiên.
markdownify là gì
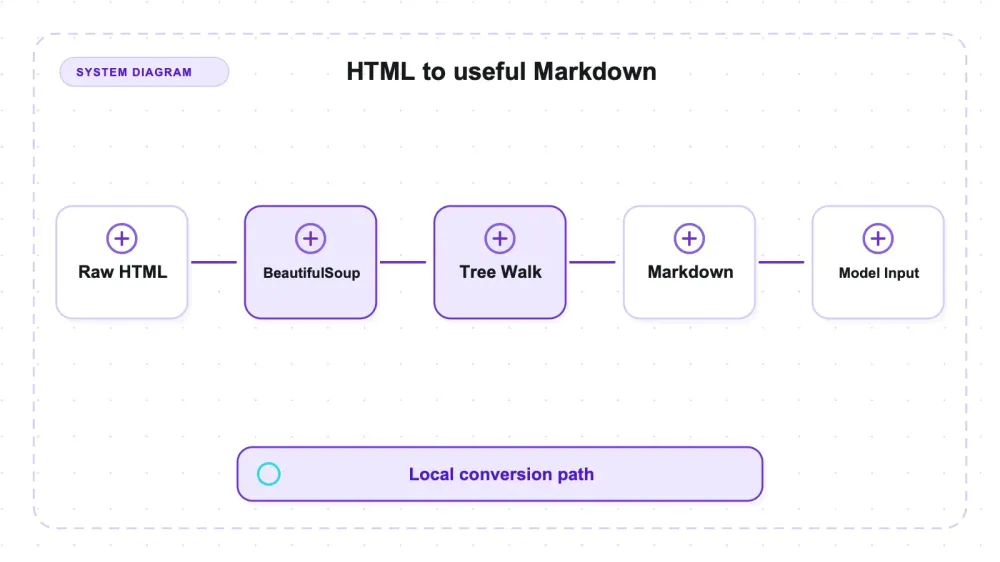
markdownify là một trình chuyển đổi HTML sang Markdown bằng Python, xây dựng trên BeautifulSoup. Kiến trúc của nó rất gọn: phân tích bằng BeautifulSoup, duyệt cây DOM, rồi xuất Markdown. Phiên bản đã kiểm tra: 1.2.3, giấy phép MIT, 2.235 sao, 42 vấn đề đang mở, phát hành gần nhất vào 2026-06-30 — vẫn đang được duy trì tích cực, với 44 lần phát hành.
Tài liệu chính thức: kho lưu trữ chính thức của python-markdownify.
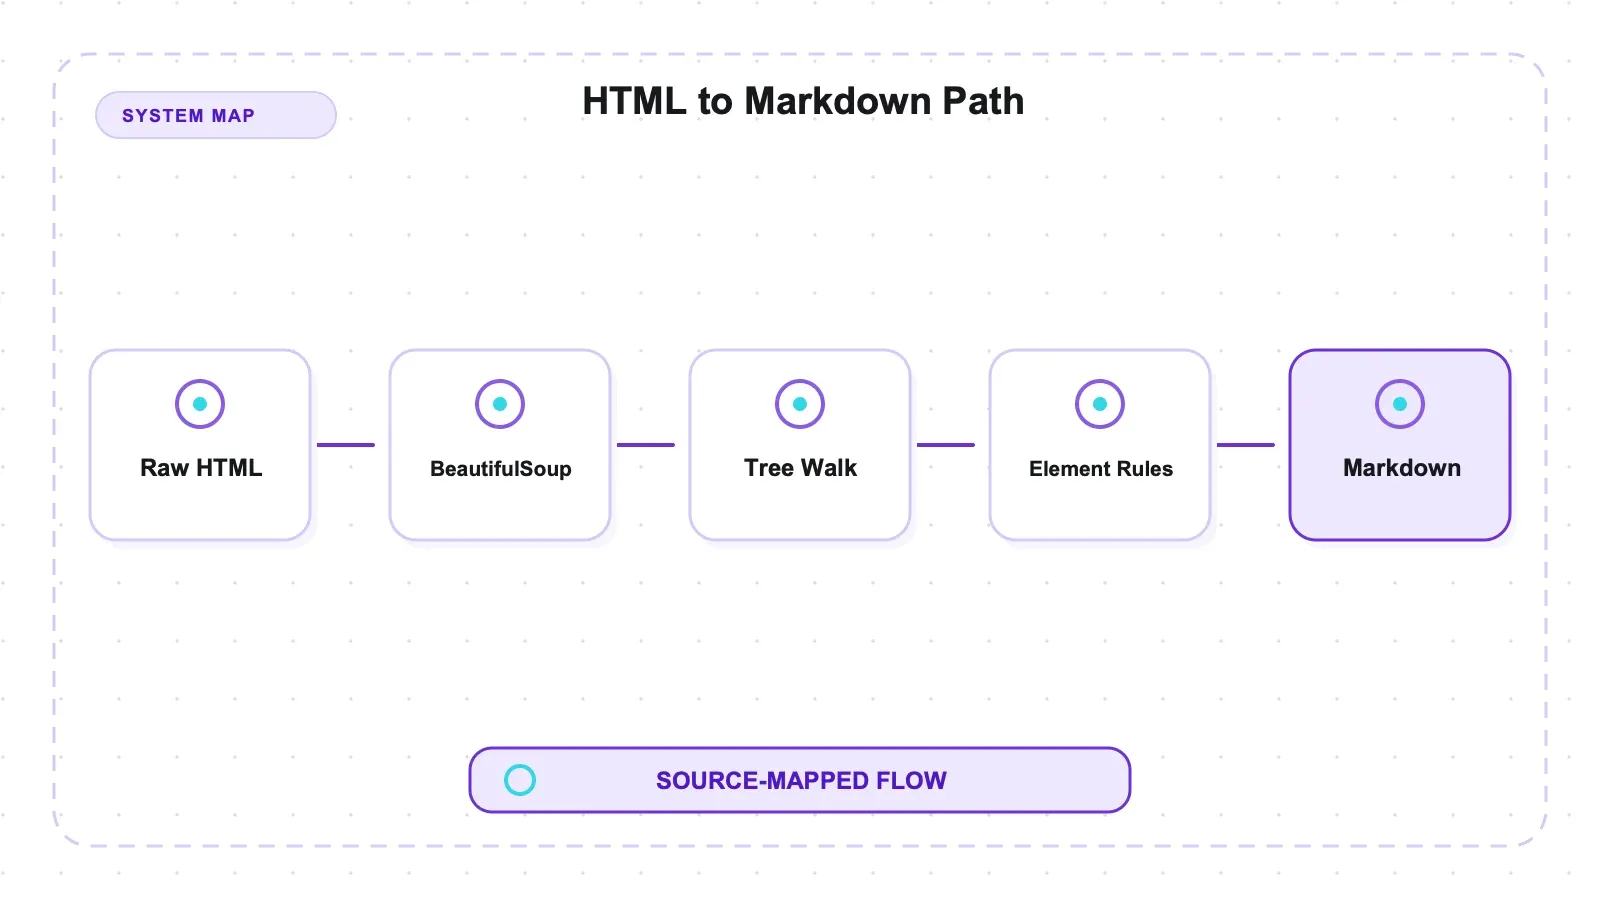
API chỉ cần một hàm:
from markdownify import markdownify
md = markdownify(html)
Ngoài ra còn có dạng lớp (MarkdownConverter) nếu bạn muốn ghi đè cách xử lý từng phần tử, cùng một bộ tùy chọn khá đầy đủ — kiểu tiêu đề, ký tự gạch đầu dòng, phát hiện ngôn ngữ trong khối code, loại bỏ phần tử. Nhưng trong thực tế, cách gọi một dòng vẫn là tình huống phổ biến nhất, và nó hoạt động ổn.
pip install markdownify kéo về 5 gói và 1,8 MiB, đồng thời cold-import trong 0,046 s — nhanh nhất trong ba trình chuyển đổi mà tôi thử. Cây phụ thuộc chủ yếu là BeautifulSoup và các thư viện đi kèm quen thuộc, vốn đã có sẵn trong nhiều dự án Python, nên chi phí tăng thêm thường gần như bằng không.
Cách đo
Tôi chạy nó trên bốn bộ HTML mẫu mà một gói khác trong cùng cơ sở này đã dùng cho markitdown, cùng với các chuỗi probe đã đăng ký trước của gói đó — 16 chuỗi nội dung chính xác được kiểm tra xem có còn giữ lại không, cộng thêm các kiểm tra phần khung giao diện trang. Một bộ mẫu thứ năm, Nothing but tables, là bộ chẩn đoán riêng thiên về bảng và không tính vào phép gộp bốn mẫu bên dưới.
| Trình chuyển đổi | Probe nội dung | Ký tự đầu ra | Token (o200k) | Số dòng bảng Markdown | Liên kết |
|---|---|---|---|---|---|
| markdownify | 16/16 | 76,868 | 21,062 | 36 | 599 |
| html2text | 16/16 | 76,452 | 21,176 | 32 | 545 |
| markitdown | 16/16 | 76,995 | 21,336 | 36 | 598 |
| turndown | 16/16 | 95,188 | 26,236 | 0 | 611 |
fourway-scores.json. Bốn bộ mẫu, token được đếm bằng o200k_base, số dòng bảng được tính bằng cùng một quy tắc trên cả bốn bộ — bao gồm cả việc đếm lại output đã lưu của markitdown, và con số này khớp chính xác với số liệu đã công bố.
Có ba điểm nổi bật.
Nó ngang bằng markitdown về số dòng bảng đầu ra. Mỗi bên 36 dòng trên bốn bộ mẫu chung, được đếm bằng cùng một heuristic. Điều đó không chứng minh hai output giống nhau từng ô; nó chỉ cho thấy cả hai đều hiển thị cùng số dòng bảng Markdown có thể nhận diện theo bộ đếm này.
Nó có số token thấp nhất. 21.062, thấp hơn nhẹ so với 21.176 của html2text và 21.336 của markitdown, và thấp hơn 19,7% so với 26.236 của turndown. Ba công cụ đầu tiên chỉ lệch nhau trong vòng 1,3%, vì vậy tôi xem đây là một thế cân bằng hơn là chiến thắng rõ rệt; chênh lệch đáng kể nằm ở turndown.
Mọi probe nội dung đều được giữ lại. Cả 16/16. Ba công cụ còn lại cũng vậy — khả năng giữ nội dung không phải là điểm khác biệt chính giữa chúng.
Bảng mà nó xử lý đúng
Bộ dữ liệu thống kê khúc côn cầu là nơi các trình chuyển đổi bắt đầu tách nhau ra. markdownify:
| Team Name | Year | Wins | Losses | OT Losses | Win % | ... |
| --- | --- | --- | --- | --- | --- | --- |
| Boston Bruins | 1990 | 44 | 24 |  | 0.55 | ... |
Đây là bảng GFM tiêu chuẩn, có dấu | ở đầu và cuối, có hàng phân cách, và — chú ý ô trống giữa 24 và 0.55 — nó giữ ô trống thay vì bỏ qua. Nghe thì có vẻ nhỏ nhặt, nhưng không hề nhỏ: một trình chuyển đổi làm mất ô trống sẽ đẩy mọi giá trị phía sau lệch sang cột sai, trong khi output nhìn qua vẫn giống một bảng hợp lệ.
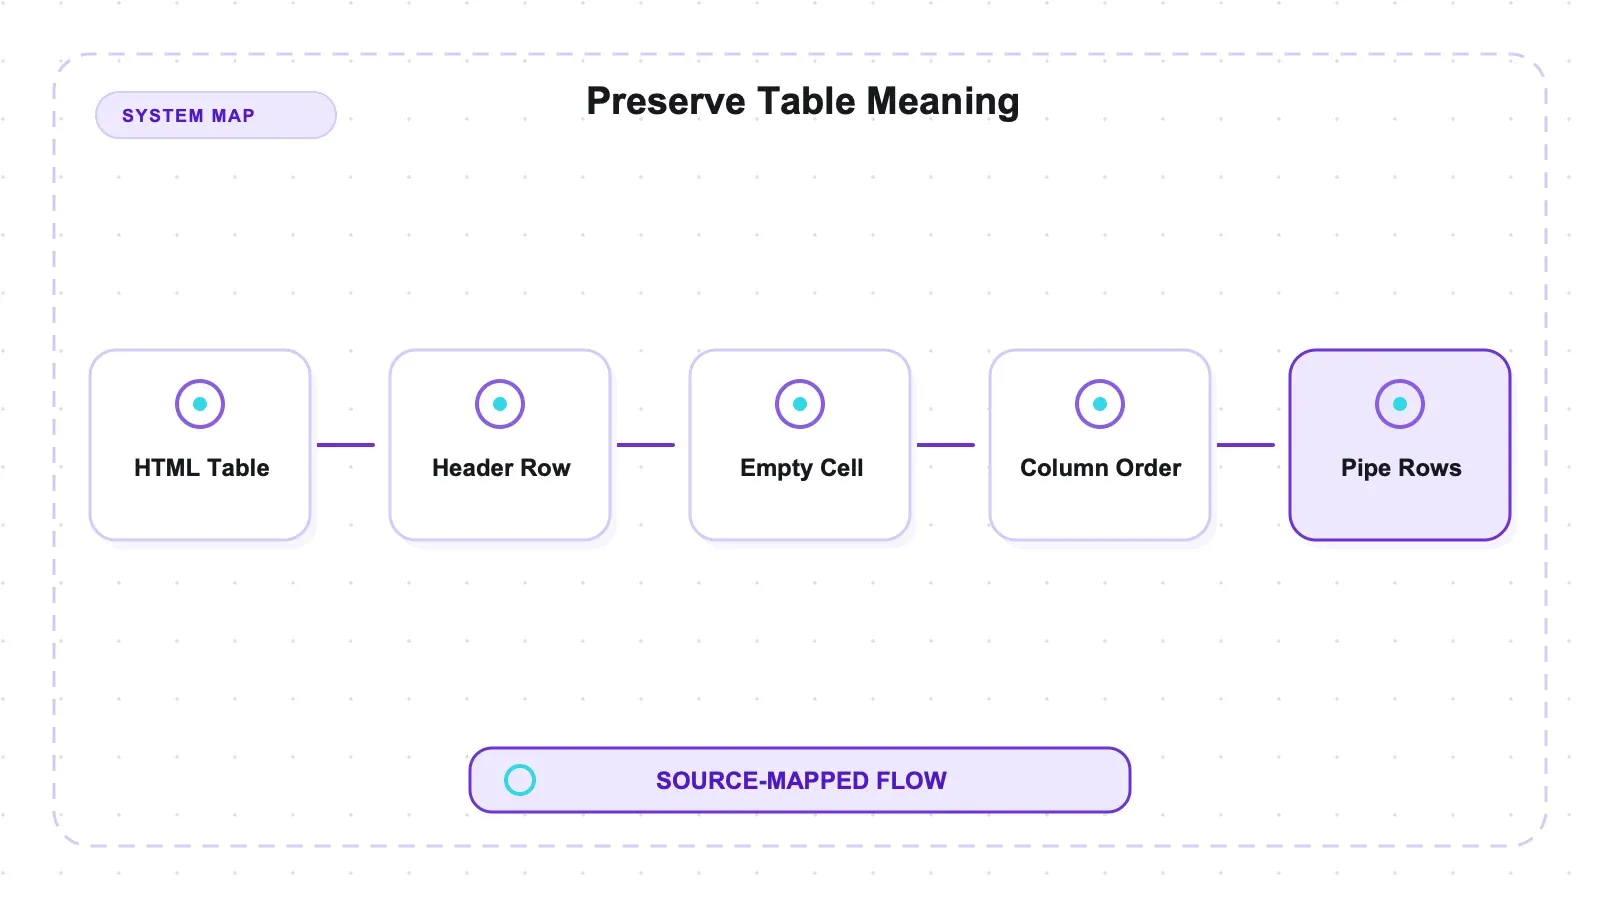
turndown trên cùng đầu vào lại biến mọi giá trị thành các đoạn văn riêng lẻ, hoàn toàn không còn cấu trúc cột. html2text tạo ra bảng đúng, nhưng theo một kiểu khác, không dùng dấu | bao ngoài.
Nếu Markdown đó được đưa vào mô hình, chính các dấu | và việc giữ nguyên ô trống mới giúp nó trả lời “Boston thua bao nhiêu trận” thay vì phải đoán.
Hai thứ nó loại bỏ mà turndown không loại bỏ
Độ chính xác của bảng là khác biệt dễ thấy. Nhưng có một điểm còn lớn hơn và ít người nhắc tới.
markdownify loại bỏ nội dung trong <script> và <style>. turndown thì không. Khi đếm bằng các marker chỉ xuất hiện bên trong hai phần tử này, output của markdownify trên các bộ mẫu có 0 marker script và 0 marker style; còn turndown có 10 và 84. Trên bộ mẫu Wikipedia, chênh lệch này là giữa 59.561 ký tự và 74.939 — và 8 dòng cấu hình JavaScript nội tuyến cùng CSS của MediaWiki chiếm 14.644 ký tự, tức 95% của phần chênh lệch đó (script-style-stripping.json).
Đối với bất kỳ đầu ra nào dùng cho mô hình, đây là phần đắt nhất trong toàn bộ phép so sánh: một khối cấu hình JavaScript tốn token nhưng không mang thông tin hữu ích nào. markdownify tự động loại bỏ nó. html2text cũng vậy.
Theo từng bộ mẫu, markdownify và html2text trùng khớp chính xác ở nơi bảng đơn giản, và bắt đầu khác nhau khi bảng phức tạp hơn:
| Bộ mẫu | markdownify | html2text |
|---|---|---|
| Thống kê khúc côn cầu | 27 dòng | 27 dòng |
| Wikipedia | 9 dòng | 5 dòng |
| Nothing but tables (bộ chẩn đoán riêng) | 62 dòng | 59 dòng |
markdownify tạo ra nhiều dòng được nhận diện hơn ở cả hai bài kiểm tra chẩn đoán. Riêng với Wikipedia, nó giữ 9 dòng trong khi html2text chỉ giữ 5 theo bộ đếm này. Điều đó là lời nhắc hữu ích rằng bạn nên kiểm tra các bảng lồng nhau và bất quy tắc trên dữ liệu đại diện trước khi chọn, chứ không phải bằng chứng rằng mọi ô được xuất ra đều đúng về mặt ngữ nghĩa.
Cài đặt và giấy phép, đặt cạnh các lựa chọn khác
| Thư viện | Số gói | Dung lượng | Cold import | Giấy phép | Sao | Phát hành gần nhất |
|---|---|---|---|---|---|---|
| markdownify | 5 | 1,8 MiB | 0,046 s | MIT | 2.235 | 2026-06-30 |
| html2text | 1 | 0,2 MiB | 0,077 s | GPL-3.0-or-later | 2.168 | 2025-04-15 |
| turndown | 3 (npm) | 8,8 MiB | 0,056 s | MIT | 11.386 | 2026-04-03 |
Tài liệu chính thức: markdownify trên PyPI.
install-and-import.json và metadata-snapshot.json. Mỗi thư viện được cài vào một môi trường trống riêng.
html2text nhỏ hơn tới 9 lần trên đĩa, nhưng lại dùng giấy phép GPL-3.0-or-later. Với một sản phẩm phân phối ra ngoài, đây là điểm cần người phụ trách giấy phép kiểm tra; bài viết này không phải tư vấn pháp lý. markdownify dùng MIT, nhìn chung dễ chấp nhận hơn, nhưng vẫn nên đi qua quy trình rà soát tuân thủ thông thường.
Mức 1,8 MiB cũng chỉ mang tính tương đối nếu dự án của bạn vốn đã dùng BeautifulSoup — điều này đúng với rất nhiều dự án scraping Python — khi đó markdownify gần như không tạo thêm chi phí đáng kể.
Về nhịp phát hành, markdownify là thư viện khỏe nhất trong ba lựa chọn: 44 lần phát hành và có bản cập nhật cách thời điểm đo sáu tuần, trong khi lần phát hành gần nhất của html2text là vào tháng 4/2025.
Một dòng Python thực sự mang lại điều gì
Toàn bộ thư viện chỉ là markdownify(html), và đáng nói rõ nó quyết định thay bạn những gì, vì ba trong số các quyết định đó chính là trọng tâm của bài so sánh này.
Nó phân tích bằng BeautifulSoup, xóa <script> và <style> mà không cần nhắc, và xuất bảng kiểu GFM với dấu | bao ngoài cùng các ô trống được giữ nguyên. Chỉ dựa vào parser không đủ để đảm bảo hành vi với HTML lỗi, nên câu hỏi đó được đo riêng ở phần bên dưới.
Không có tùy chọn nào trong số đó cần bạn tự cấu hình. Đó là hành vi mặc định, và trong một nhóm mà mặc định của turndown giữ nguyên JavaScript còn mặc định của html2text tự ngắt dòng cứng ở độ dài 78 ký tự, thì một thư viện chạy đúng ngay từ đầu đáng giá theo cách riêng của nó.
Khi cần, bạn vẫn có các tùy chọn — heading_style, bullets, code_language, strip và convert cho danh sách cho phép và danh sách loại trừ phần tử, cùng MarkdownConverter để ghi đè theo từng phần tử. Nhưng mọi phép đo ở đây đều không dùng đến các tùy chọn đó.
Bộ nhớ, và HTML hỏng ảnh hưởng ra sao
Bối cảnh kiểm thử tải rộng hơn nằm trong so sánh bộ nhớ và HTML lỗi của mười thư viện.
Hai thứ mà mọi bài đánh giá trong nhóm này trước đó đều ghi là chưa kiểm tra, giờ đã được đo.
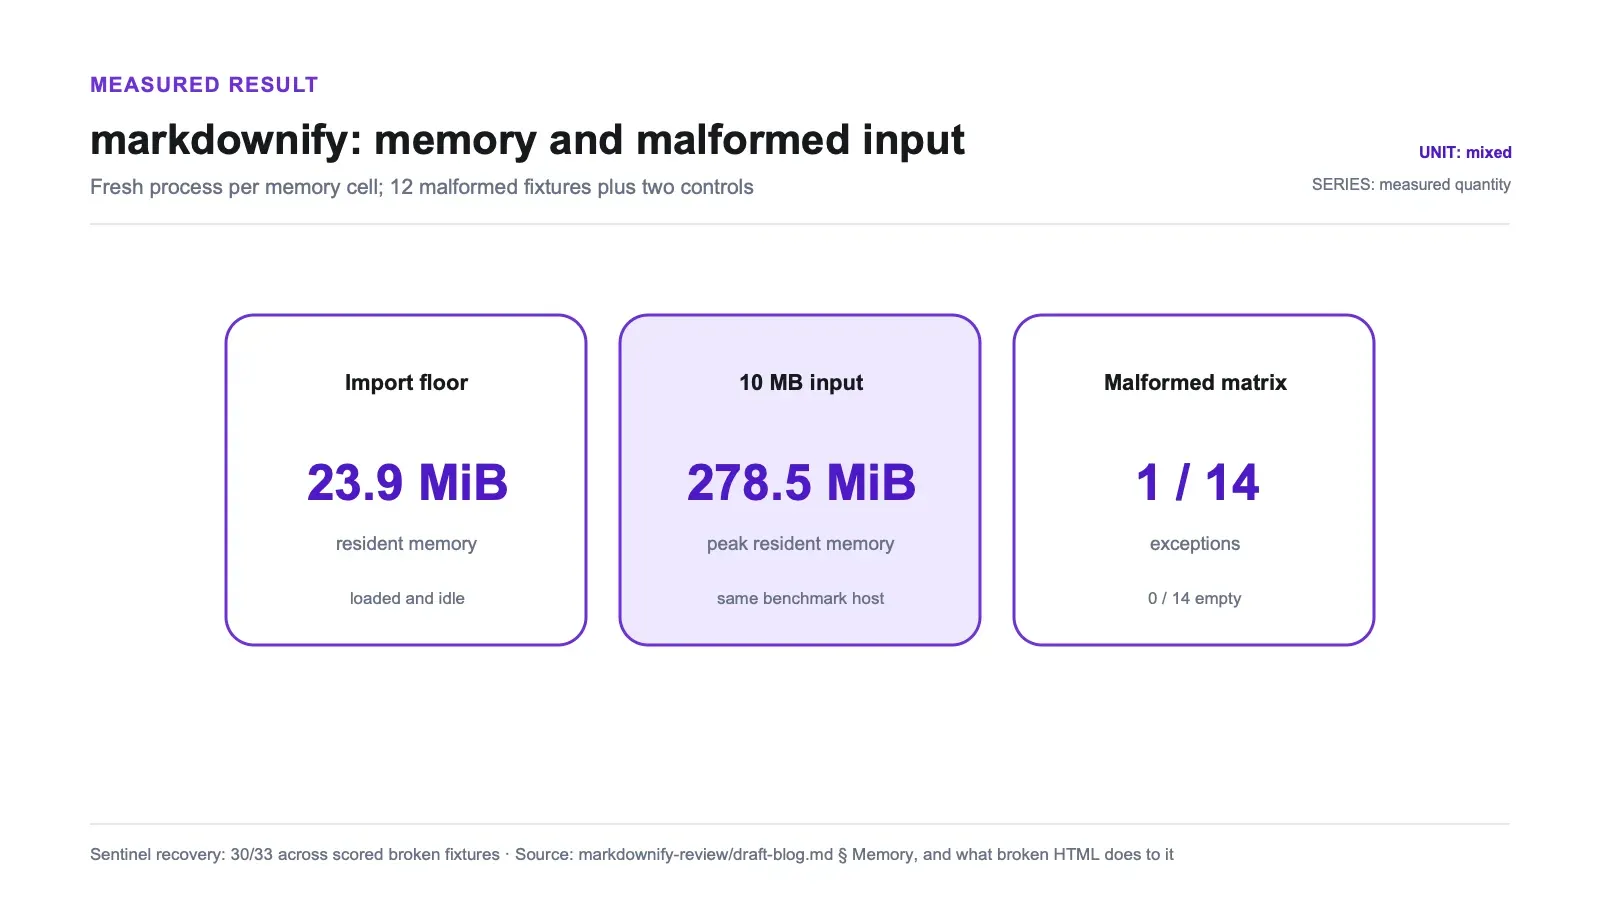
Mức dùng bộ nhớ cư trú tối đa, qua /usr/bin/time -l, mỗi ô là một tiến trình mới — mức nền nhập khẩu là chi phí của thư viện khi đã nạp nhưng đang rỗi, còn đỉnh là bao gồm cả tài liệu.
| Thư viện | Runtime | Mức nền khi import | Đỉnh 226 KB | Đỉnh 10 MB |
|---|---|---|---|---|
| html2text | python3.14 | 18,7 | 19,9 | 71,2 |
| pyquery | python3.14 | 30,3 | 33,9 | 172,5 |
| resiliparse | python3.14 | 20,5 | 25,1 | 225,1 |
| markdownify | python3.14 | 23,9 | 28,9 | 278,5 |
| goose3 | python3.14 | 44,1 | 52,4 | 398,5 |
| cheerio | node22 | 66,8 | 76,5 | 398,5 |
| justext | python3.14 | 30,3 | 36,6 | 431,2 |
| newspaper4k | python3.14 | 52,6 | 61,8 | 668,5 |
| trafilatura | python3.14 | 52,5 | 64,8 | 927,1 |
| turndown | node22 | 47,8 | 68,4 | 2947,1 |
memory-results.json. Mốc nền của Python và Node không thể so trực tiếp với nhau; trình thông dịch đã nằm bên trong cả hai.
markdownify nằm ở giữa: mức nền 23,9 MiB và 278,5 MiB trên tài liệu 10 MB. Đó là gấp 3,9 lần đỉnh của html2text và khoảng một phần mười của turndown, đổi lại là việc sử dụng BeautifulSoup bên dưới.
HTML lỗi. Mười hai tài liệu, mỗi tài liệu phá vỡ đúng một thứ — thẻ chưa đóng, phần tử inline lồng sai, thuộc tính không có dấu ngoặc kép nhưng có khoảng trắng, thẻ đóng thừa, không có <html> nào, thuộc tính trùng lặp, tài liệu bị cắt ngang giữa thẻ, entity lỗi, <script> chưa đóng, khai báo charset sai lệch, comment chứa markup, và 600 lớp lồng nhau — cộng thêm hai mẫu chuẩn hợp lệ có kích thước tương ứng, vì “nó trả về rỗng” chỉ nói được điều gì đó về mức độ lỗi nếu thư viện đó không im lặng cả với một tài liệu sạch cùng kích thước.
markdownify báo lỗi ở 1/14 và không trả về gì ở 0 trường hợp, khôi phục 30/33 sentinel trên các bộ lỗi (malformed-results.json). Một bộ mẫu bị loại khỏi phép đếm đó: theo HTML5, mọi thứ sau một <script> chưa đóng đều là nội dung script, nên mất nó trong trường hợp đó là đúng, còn khôi phục mới là lệch chuẩn.
Ưu và nhược điểm
Điểm mạnh. Độ chính xác bảng ngang với markitdown, đếm bằng cùng một quy tắc. Số token thấp nhất trong bốn công cụ. MIT. 1,8 MiB, và chi phí tăng thêm gần như bằng không nếu BeautifulSoup đã nằm trong cây phụ thuộc của bạn. Cold import nhanh nhất, 0,046 s. Đang được phát hành tích cực. Giữ nguyên ô trống trong bảng. Có thể ghi đè chuyển đổi theo từng phần tử qua MarkdownConverter. Cách gọi một dòng đơn giản là cách gọi đúng.
Điểm yếu. Phụ thuộc vào BeautifulSoup, nên nếu bạn chưa có nó thì dung lượng trên đĩa lớn hơn html2text khoảng 9 lần. 2.235 sao nghĩa là cộng đồng nhỏ hơn turndown — ít ví dụ thực chiến hơn khi bạn gặp tình huống lạ. Chỉ dùng cho Python, nên không giúp gì trong stack Node. Và còn 42 vấn đề đang mở.
Ai nên dùng, ai không nên dùng
Hãy bắt đầu với markdownify nếu bạn đang xử lý workload Python giống các bộ mẫu này. Nó ngang markitdown về số dòng bảng đầu ra theo bộ đếm này, nằm trong nhóm token thấp nhất, và dùng MIT. Nếu bạn đã phụ thuộc vào BeautifulSoup, chi phí cài đặt tăng thêm có thể rất nhỏ; hãy kiểm tra chênh lệch phụ thuộc thực tế trong môi trường của bạn.
Hãy cân nhắc html2text nếu ngân sách phụ thuộc được tính bằng vài trăm kilobyte và kiểu output của nó phù hợp với trang của bạn. Cần rà soát GPL-3.0-or-later với người phụ trách giấy phép trước khi phát hành.
Hãy cân nhắc markitdown nếu bạn đã dùng nó để chuyển PDF hoặc tài liệu Office. Ở đây kết quả HTML của họ có cùng số dòng bảng được nhận diện, nhưng chưa chứng minh được độ tương đương fidelity rộng hơn.
Bỏ qua nó trong Node, nơi turndown là lựa chọn tự nhiên — nhưng nên cài thêm turndown-plugin-gfm, vì core của turndown không tạo ra bảng nào cả.
Một API được quản lý phù hợp ở đâu
markdownify chuyển đổi HTML mà bạn đã có sẵn. Nó không tự tải trang, không render JavaScript, không xử lý lớp chống bot — cả bốn trình chuyển đổi ở đây đều không làm được, và với nhiều mục tiêu thực tế thì đó mới là nửa khó hơn của công việc.
Để xem cùng những bộ mẫu này trên cả năm trình chuyển đổi, hãy xem so sánh HTML sang Markdown năm chiều.
Bộ công cụ dành cho nhà phát triển của chúng tôi tại Thunderbit giải quyết phần việc ở phía trước đó: POST /distill lấy một URL và trả về Markdown, còn POST /extract trả về JSON theo schema. Cả hai đều có qua MCP server và CLI; giá được công bố trên trang giá Thunderbit. Các endpoint lưu trữ này chưa được benchmark so với các trình chuyển đổi cục bộ ở đây, nên đây là sự khác biệt về hạng mục, không phải so sánh hiệu năng.
Nói thật ngắn gọn: nếu bạn đã có HTML và chỉ muốn Markdown, markdownify là miễn phí và làm việc tốt ngang bất kỳ công cụ nào ở đây. Nếu bạn cần tự lấy trang, hoặc cần bảng dữ liệu thay vì văn xuôi, thì đó là một lựa chọn mua khác.
Để tham khảo rộng hơn, bài tổng hợp API web scraping tốt nhất bao gồm các lựa chọn hosted, còn trụ cột scraper mã nguồn mở nói về các giải pháp tự host. Chuyển HTML sang Markdown trong Python là hướng dẫn thực hành.
Dùng thử Thunderbit để trích xuất dữ liệu web
Có nên dùng markdownify không?
Với Python, đây là ứng viên rất mạnh nếu dữ liệu đầu vào của bạn giống các bộ mẫu ở đây; hãy thử trên bảng thực tế và các trang HTML lỗi của bạn trước khi đặt nó làm mặc định.
Nó ngang markitdown về số dòng bảng đầu ra, nằm trong nhóm token thấp nhất, import nhanh nhất trong lần đo này, và dùng giấy phép MIT. Đổi lại, nó dùng nhiều bộ nhớ hơn html2text, chỉ dành cho Python, và báo lỗi ở một bộ mẫu HTML lỗi. Dung lượng và giấy phép là các yếu tố lựa chọn bổ sung, không phải lý do duy nhất.
Điều khiến tôi chú ý là số sao. turndown có gấp năm lần mức độ chú ý, nhưng mặc định lại không chuyển được bất kỳ bảng nào mà markdownify xử lý đúng. Mức độ phổ biến trong nhóm này không phản ánh đúng hành vi đo được — đó cũng là lý do lớn khiến phép so sánh này đáng làm.
Dùng thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
markdownify có thực sự tốt ngang markitdown trên HTML không? Trên bốn bộ mẫu này, cả hai đều tạo ra 36 dòng bảng Markdown được nhận diện, khôi phục đủ 16 chuỗi đã kiểm tra, và chênh lệch đầu ra theo số ký tự chỉ trong khoảng 0,2%. Đây không phải là kiểm tra tương đương ở mức từng ô hay mức rendering. markitdown còn xử lý PDF và Office, nên so sánh này chỉ nói về đầu ra HTML đã đo.
Nó có cần BeautifulSoup không? Có — đó là parser của nó, và cũng là phần lớn của 1,8 MiB. Nếu dự án của bạn đã dùng BeautifulSoup, chi phí tăng thêm của markdownify là nhỏ. Nếu chưa, và dung lượng thực sự quan trọng, html2text chỉ 0,2 MiB với một gói duy nhất, đổi lại là giấy phép GPL-3.0-or-later.
Nó xử lý ô trống trong bảng thế nào? Nó giữ nguyên ô trống. Trong bộ mẫu có khoảng trống dữ liệu, output giữ ô trống đúng vị trí, nên mọi giá trị phía sau vẫn ở cột đúng. Một trình chuyển đổi bỏ qua ô trống sẽ tạo ra bảng nhìn vẫn hợp lệ nhưng mọi giá trị bị lệch sang trái một cột — đó là kiểu lỗi tệ hơn vì không có dấu hiệu cảnh báo nào.
Tôi nên dùng hàm hay lớp?
Dùng hàm markdownify() cho trường hợp thông thường. Dùng MarkdownConverter khi bạn cần ghi đè cách một phần tử cụ thể được chuyển đổi — mọi phép đo ở đây đều dùng hàm đơn giản với tùy chọn mặc định.
Những gì chưa được kiểm tra ở đây? Bốn bộ mẫu chung cộng thêm một bộ chẩn đoán chỉ về bảng không phải là một tập dữ liệu đại diện đầy đủ. Bộ HTML lỗi riêng đã bao phủ 12 kiểu hỏng được đặt tên và hai mẫu chuẩn, nhưng không phải mọi dạng HTML lỗi. Danh sách lồng nhau, danh sách định nghĩa, footnote, toán học, round-trip Markdown sang HTML, tương đương bảng ở mức từng ô, và các biến thể cấu hình đều chưa được so sánh. Tốc độ chuyển đổi cũng chưa được so sánh.




