
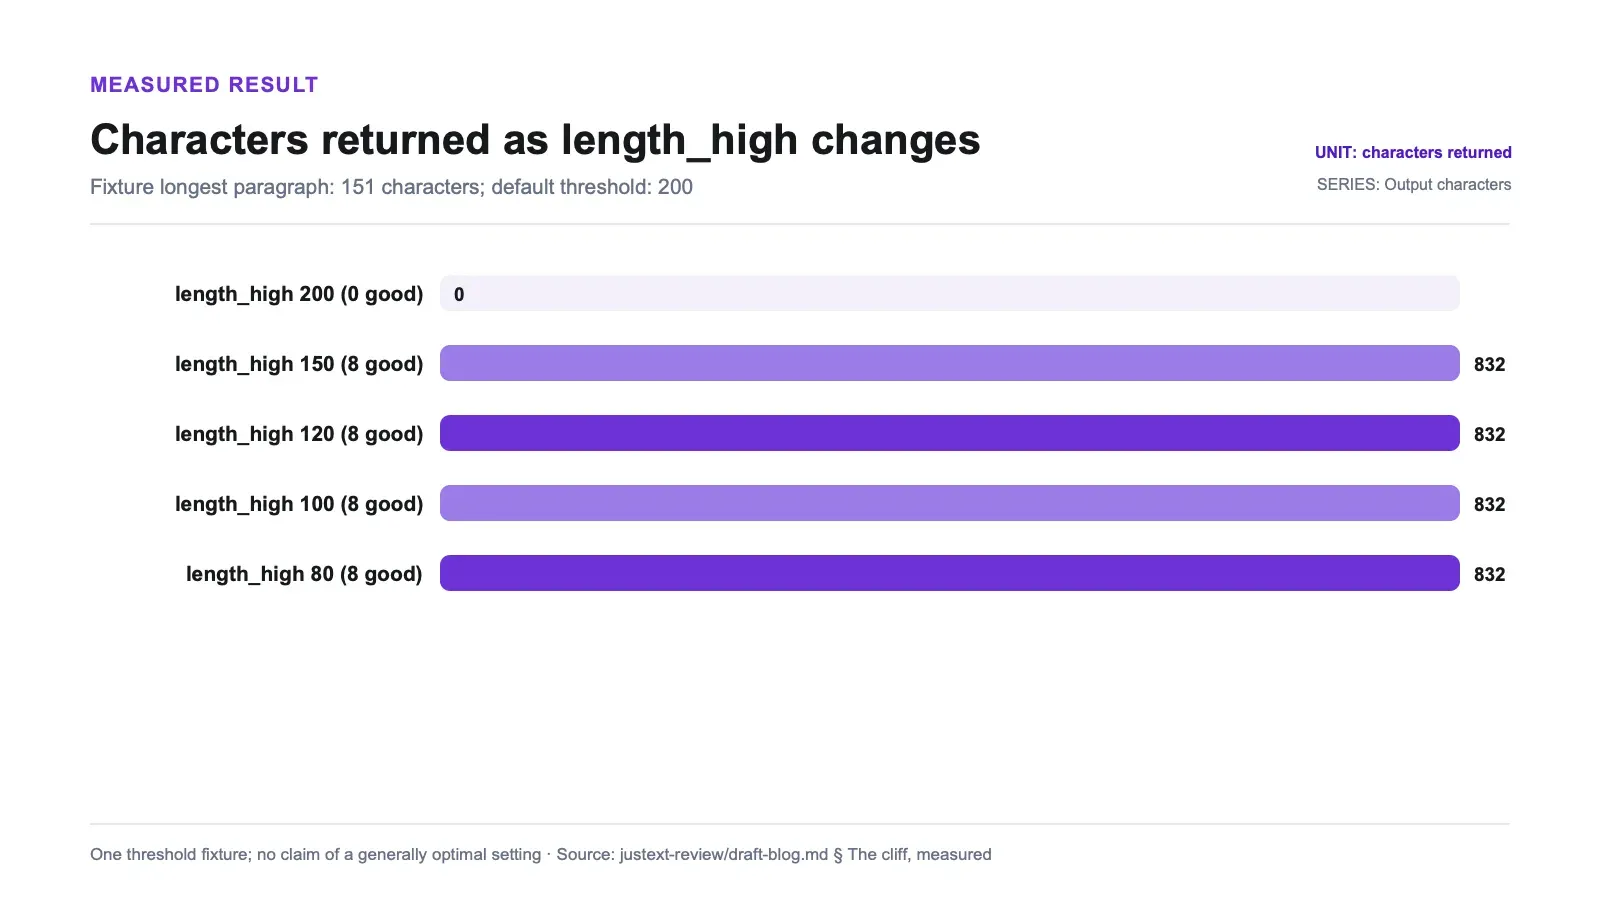
Trên một tài liệu mà đoạn văn dài nhất chỉ 151 ký tự, jusText ở cấu hình mặc định trả về 0 ký tự. Không phải trích xuất dang dở — mà là một chuỗi rỗng. Chỉ cần hạ một ngưỡng để đúng một đoạn vượt qua, tài liệu y hệt đó sẽ trả về 832 ký tự. Hạ thấp hơn nữa thì kết quả vẫn là 832.
Trên bộ kiểm thử này, hành vi của jusText giống như một vách đá hơn là một đường dốc. Cấu hình mặc định có “đứng sai phía” hay không còn tùy vào độ dài đoạn văn và cách phân bố phần nội dung rác trong tập dữ liệu mục tiêu.
jusText là gì, và vì sao mật độ từ vựng lại quan trọng
So với các bộ trích xuất khác trong bộ kiểm thử này, jusText phụ thuộc khá mạnh vào mật độ stopword theo từng ngôn ngữ. Một khối có tỷ lệ cao các từ chức năng — the, and, of, was — thường được xem là văn bản chính hơn. Tín hiệu từ vựng đó không phải là toàn bộ bộ phân loại: độ dài đoạn, mật độ liên kết, ranh giới khối suy ra từ HTML, khoảng cách tới tiêu đề, các lớp lân cận, và một lượt xử lý theo ngữ cảnh cũng đều ảnh hưởng đến kết quả.
Tài liệu tham chiếu chính thức: repository chính thức của jusText.
Vì bộ phân loại cần một danh sách stopword theo ngôn ngữ, jusText đi kèm 100 bộ stoplist. Dấu ấn nổi bật nhất của nó trong so sánh này chính là lớp tín hiệu từ vựng đặc thù cho từng ngôn ngữ, dù bài kiểm tra này không đánh giá chất lượng đa ngôn ngữ.
Phiên bản đã kiểm thử: 3.0.2, BSD 2-Clause, 822 sao GitHub. Python 3.14.2.
“Vách đá” được đo như thế nào
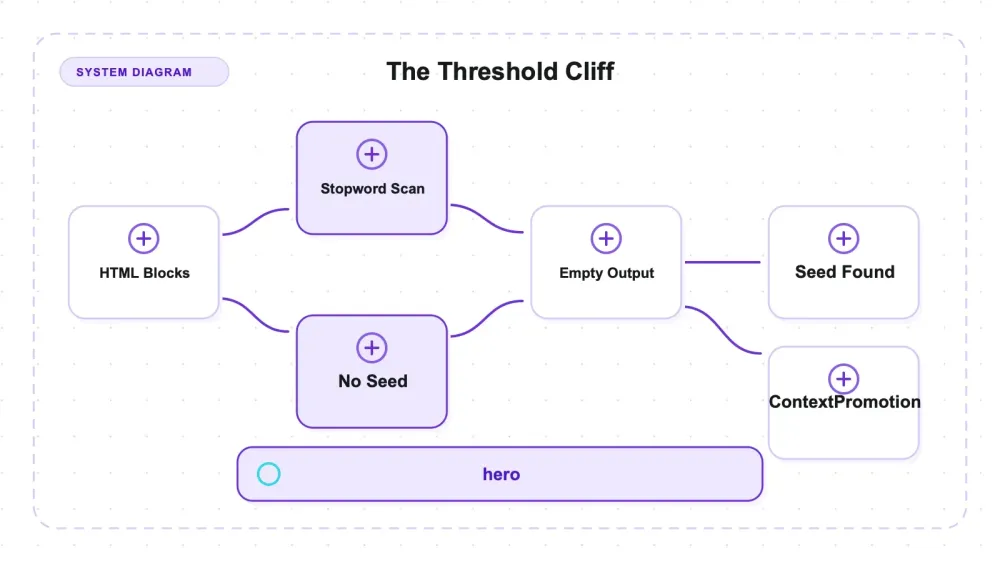
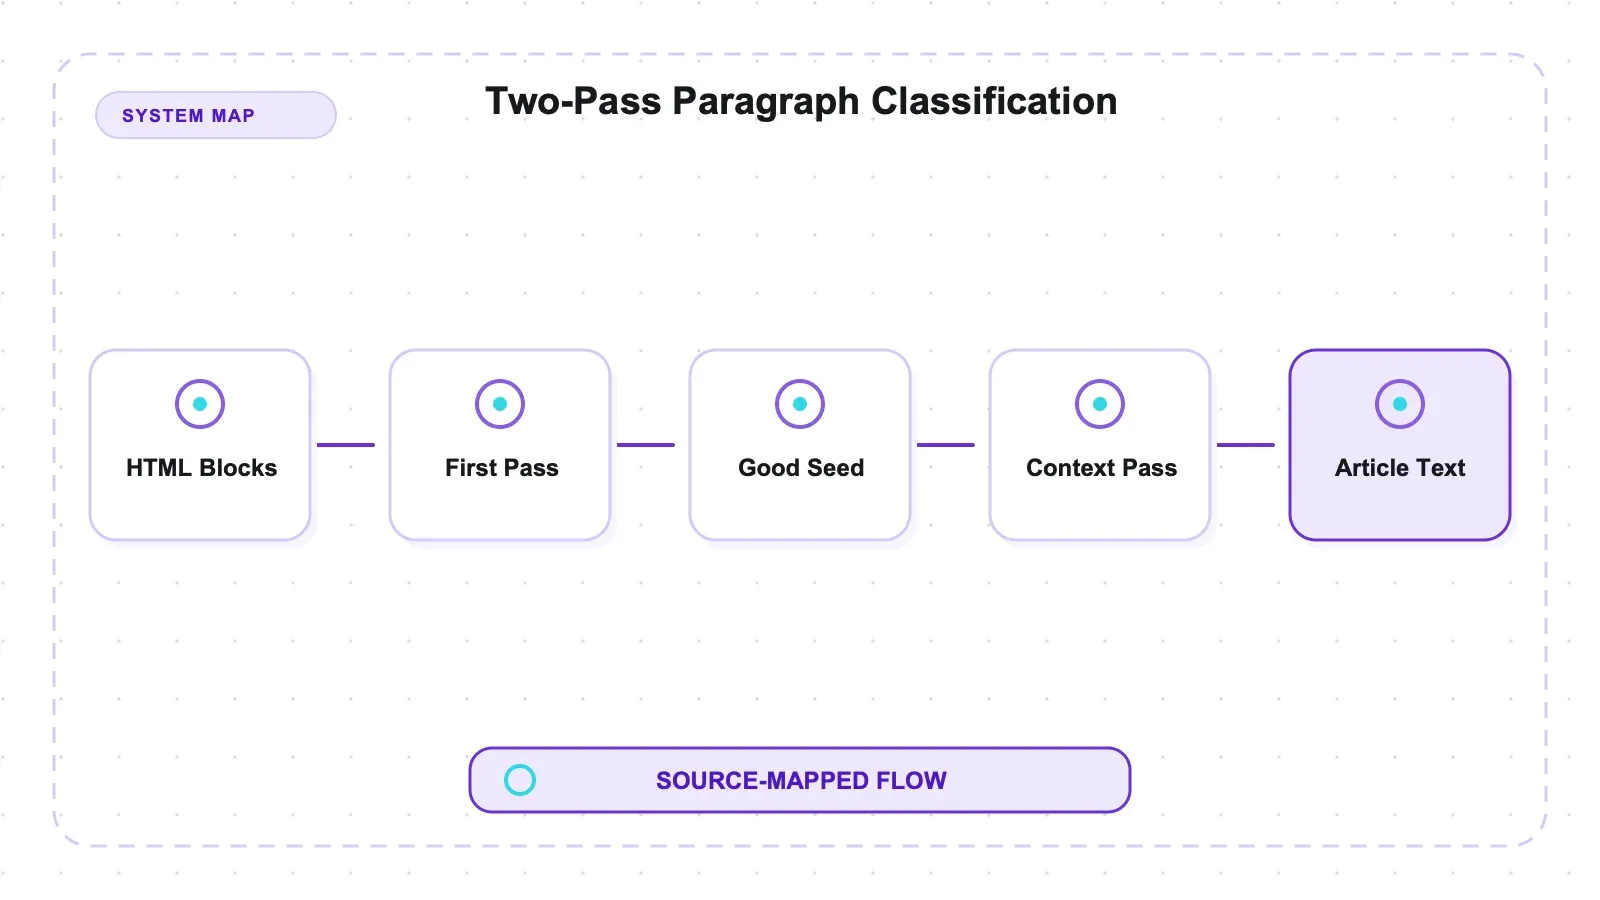
Bộ phân loại của jusText chạy qua hai lượt. Lượt đầu, không xét ngữ cảnh, gán mỗi đoạn vào một trong các nhãn good, bad, short hoặc neargood. Lượt thứ hai, có xét ngữ cảnh, sẽ nâng neargood thành good — nhưng chỉ khi nó đứng cạnh một khối đã là good. Và một đoạn chỉ tự đạt good khi nó vượt qua length_high, mặc định là 200 ký tự.
Trên một tài liệu mà không có đoạn nào vượt mốc 200, sẽ không có “mầm” nào để lan truyền việc nâng hạng, và mọi khối neargood đều rơi về phần nội dung rác. Cả trang kết quả vì thế trở thành rỗng.
Tôi quét ngưỡng trên một bộ kiểm thử có đoạn dài nhất 151 ký tự:
length_high | Số đoạn được phân loại là good | Số ký tự trả về |
|---|---|---|
| 200 (mặc định) | 0 | 0 |
| 150 | 8 | 832 |
| 120 | 8 | 832 |
| 100 | 8 | 832 |
| 80 | 8 | 832 |
justext-length-threshold.json.
Trên bộ kiểm thử theo ngưỡng này, chỉ cần một đoạn vượt qua ranh giới là toàn bộ tám đoạn mục tiêu đều được xuất ra, và hạ thêm nữa cũng không làm tăng thêm gì. Dấu vết kết quả này phù hợp với việc bước xét ngữ cảnh nâng các khối neargood đủ điều kiện ở quanh một khối good có sẵn; điều đó không có nghĩa là mọi hàng xóm đều luôn được nâng trên mọi trang bất kỳ.
Trước khi quy nguyên nhân cho length_high, tôi cũng quét length_low qua bốn giá trị kết hợp với max_link_density qua hai giá trị: tám tổ hợp, tất cả đều trả về 0. Thay đổi hai thiết lập này không giúp lấy lại kết quả trên bộ kiểm thử này.
Xét toàn bộ 22 bộ kiểm thử, mẫu hình vẫn giữ nguyên: 2 trên 22 bộ cho ra kết quả ở length_high=200, 9 trên 22 ở 150, và 15 trên 22 ở 120.
Có hai điều kết quả này không nói lên. Nó không có nghĩa jusText trích xuất kém — trên một trang ngôn ngữ tự nhiên thực sự, ở mặc định, nó trả về 1.190 ký tự văn bản bài viết sạch, vì một đoạn tin tức thật thường vượt 200 ký tự ngay từ lần đầu. Và nó cũng không có nghĩa mặc định là sai; nó chỉ nói rằng mặc định đang giả định các đoạn văn dài, và bạn nên kiểm tra xem tập dữ liệu của mình có đúng như vậy hay không trước khi chạy.
Mặt còn lại của bộ kiểm thử này: rò rỉ cao hơn ở mặc định
Trên bộ kiểm thử gán nhãn này ở cấu hình mặc định, jusText có mức rò rỉ phần nội dung rác cao nhất trong các công cụ được đo.
| Thư viện | Độ recall bài viết (cả 22) | Rò rỉ boilerplate | Precision token nội dung | Số token gây nhiễu |
|---|---|---|---|---|
| Readability | 1.0000 | 0.2353 | 0.9109 | 35 |
| trafilatura | 0.9865 | 0.0588 | 0.9411 | 4 |
| newspaper4k | 0.9865 | 0.0000 | 0.9452 | 0 |
| resiliparse | 0.9054 | 0.0588 | 0.9381 | 7 |
| jusText | 0.8378 | 0.4706 | 0.8760 | 74 |
| goose3 | 0.8243 | 0.0000 | 1.0000 | 0 |
sixway-scores.json. Một bộ kiểm thử, một bộ chấm điểm, và mọi đơn vị đều được gắn một sentinel riêng để việc phục hồi chỉ là kiểm tra chứa chuỗi con chính xác.
Rò rỉ 47% boilerplate và 74 token gây nhiễu — gấp đôi tỷ lệ rò rỉ của Readability và hơn gấp đôi mức nhiễu trên bộ dữ liệu tổng hợp đã gán nhãn này. Đây là kết quả chẩn đoán ở cấu hình mặc định, không phải một thứ hạng ổn định cho toàn bộ sản phẩm.
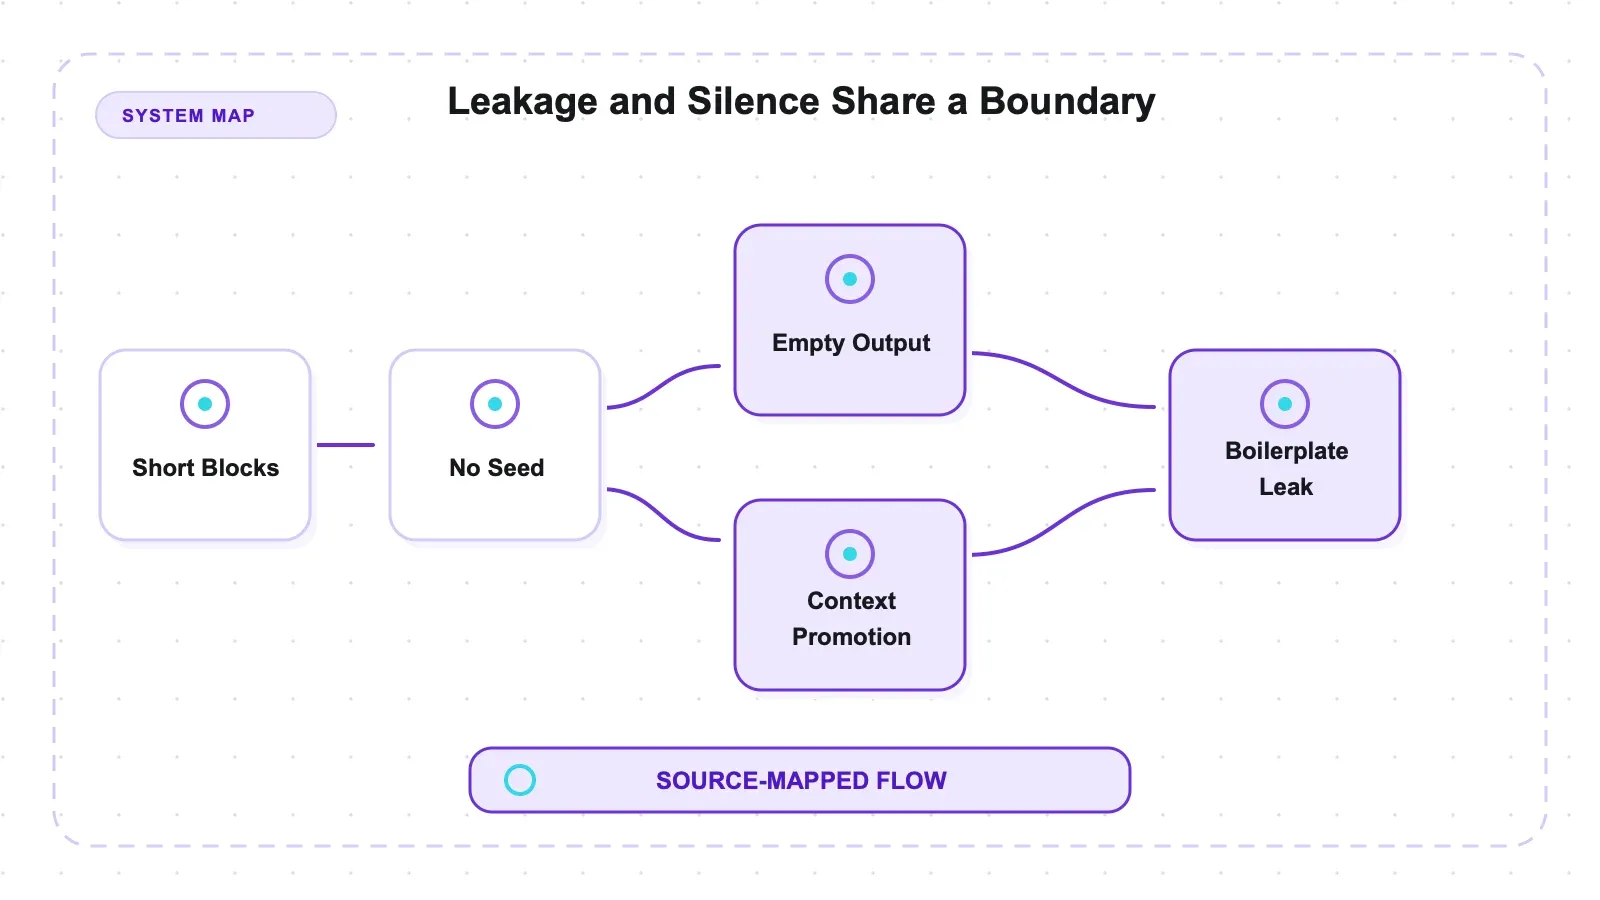
Mức rò rỉ quan sát được phù hợp với chính bước xét ngữ cảnh nói trên, cũng là thứ liên quan đến “vách đá” ở phần trước. Các khối neargood đủ điều kiện có thể được nâng khi lớp khối xung quanh và các quy tắc khoảng cách cho phép; vì vậy một đoạn quảng cáo hay bình luận giống văn xuôi đặt cạnh phần bài viết vẫn có thể vượt ranh giới. Kết quả trên bộ kiểm thử cho thấy những khối nào bị rò rỉ, còn cơ chế đơn giản hóa vẫn phụ thuộc vào đúng các quy tắc ngữ cảnh của jusText.
Recall của nó là 0.8378, đứng thứ ba từ dưới lên, và toàn bộ phần mất mát đều đến từ ngưỡng: nó không lấy được gì ở một bài viết dài 129 ký tự, không lấy được gì ở một trang gồm mười đoạn ngắn, và cũng không lấy được gì ở tài liệu gần như trống.
Kho stoplist theo ngôn ngữ
Chín mươi chín bộ stoplist còn lại.
justext.get_stoplists() trả về 100 ngôn ngữ. Bộ phân loại được thiết kế theo ngôn ngữ, chứ không phải chỉ là bản dịch của một heuristic tiếng Anh, và việc đổi ngôn ngữ chỉ là một đối số:
import justext
paragraphs = justext.justext(html, justext.get_stoplist("Czech"))
text = "\n".join(p.text for p in paragraphs if not p.is_boilerplate)
trafilatura và goose3 cũng có hành vi liên quan đến ngôn ngữ, nhưng bài review này không chấm điểm extractor nào trên dữ liệu chuẩn không phải tiếng Anh. 100 stoplist đi kèm của jusText khiến nó trở thành ứng viên rõ ràng cho đánh giá đa ngôn ngữ; bản thân danh mục này chưa chứng minh được chất lượng trích xuất giữa các ngôn ngữ, cũng không chứng minh rằng đối thủ hỗ trợ kém hơn.
API chỉ gồm hai hàm và chín hằng số có thể tinh chỉnh — length_low 70, length_high 200, stopwords_low 0.30, stopwords_high 0.32, max_link_density 0.20, max_heading_distance 200, cùng với phần xử lý mã hóa. Gọn, dễ đọc, và mọi thứ đều được mô tả rõ trong chữ ký hàm.
Cài đặt và tốc độ
pip install justext kéo về 3 gói — ít nhất trong so sánh — và 22.4 MiB, dưới hai giây.
Tài liệu chính thức: jusText trên PyPI.
| Thư viện | Số gói | site-packages | Cold import | Extraction p50 |
|---|---|---|---|---|
| resiliparse | 5 | 21.0 MiB | 0.015 s | 0.06 ms |
| jusText | 3 | 22.4 MiB | 0.777 s | 0.56 ms |
| goose3 | 16 | 44.3 MiB | 2.181 s | 1.85 ms |
| newspaper4k | 22 | 47.5 MiB | 2.812 s | 2.69 ms |
| trafilatura | 17 | 69.9 MiB | 1.584 s | 0.51 ms |
install-and-import.json. Mỗi thư viện nằm trong một virtualenv trống riêng.
Ba gói và 22.4 MiB là một mức phụ thuộc nhỏ trong so sánh này, và mức trích xuất trung vị 0.56 ms khá sát với 0.51 ms của trafilatura trong khung đo này. Phép đo môi trường không tách kích thước gói theo loại tệp, nên không thể nói bao nhiêu dung lượng đĩa đến từ stoplist.
Câu chuyện bảo trì, nhìn một cách cẩn trọng
Các thước đo bảo trì theo mốc thời gian ở đây dùng lần đẩy mã cuối cùng của repository và lần phát hành PyPI cuối cùng, đều là 2025-02-25. Tính đến lúc kiểm thử, mốc đó là mười bảy tháng trước. Tổng cộng 8 bản phát hành, 91 fork, 9 issue đang mở, chưa bị lưu trữ.
Các bộ phân loại của PyPI ghi hỗ trợ Python đến 3.9. Tôi đã chạy nó trên 3.14.2 và nó vẫn cài được, import trong 0.777 s, và trích xuất trên 19 trong số 22 bộ kiểm thử mà không hề phát sinh ngoại lệ nào.
Vì vậy, metadata đang chậm hơn thực tế năm phiên bản Python, còn thực tế là nó vẫn hoạt động. Đây là điểm khác biệt hữu ích: một repository lặng lẽ là tín hiệu về hỗ trợ, chứ không tự động là tín hiệu về chức năng. Với một thư viện mà toàn bộ thuật toán chỉ là một phương pháp công bố từ năm 2011 cộng với một bộ danh sách từ, trạng thái “đã hoàn thiện” là hoàn toàn hợp lý — không còn nhiều thứ để thay đổi, và stoplist cũng không bị mục nát như một workaround chống bot.
Nhưng repository lặng lẽ cũng có nghĩa là: nếu bạn gặp lỗi, bạn sẽ tự sửa hoặc tự fork. Hãy cân nhắc điều đó cùng với 9 issue đang mở, vì đây không phải kiểu profile của một thư viện đang chìm ngập trong đống vấn đề chưa xử lý.
Bộ nhớ, và HTML hỏng sẽ làm gì với nó
Hai câu hỏi vận hành được đo tách riêng ở đây.
Bối cảnh stress test rộng hơn nằm trong bài so sánh bộ nhớ và HTML lỗi ở mười thư viện.
Bộ nhớ cư trú cực đại, đo qua /usr/bin/time -l, mỗi ô là một tiến trình mới — mức nền import là chi phí khi thư viện đã tải và đang rảnh, còn các mức đỉnh bao gồm cả tài liệu.
| Thư viện | Runtime | Mức nền import | Đỉnh 226 KB | Đỉnh 10 MB |
|---|---|---|---|---|
| html2text | python3.14 | 18.7 | 19.9 | 71.2 |
| pyquery | python3.14 | 30.3 | 33.9 | 172.5 |
| resiliparse | python3.14 | 20.5 | 25.1 | 225.1 |
| markdownify | python3.14 | 23.9 | 28.9 | 278.5 |
| goose3 | python3.14 | 44.1 | 52.4 | 398.5 |
| cheerio | node22 | 66.8 | 76.5 | 398.5 |
| justext | python3.14 | 30.3 | 36.6 | 431.2 |
| newspaper4k | python3.14 | 52.6 | 61.8 | 668.5 |
| trafilatura | python3.14 | 52.5 | 64.8 | 927.1 |
| turndown | node22 | 47.8 | 68.4 | 2947.1 |
memory-results.json. Mức nền của Python và Node không thể so sánh trực tiếp với nhau; trình thông dịch nằm bên trong cả hai.
Mức nền của jusText là 30.3 MiB và đỉnh trên bộ kiểm thử 10 MB này là 431.2 MiB, tức khoảng 14.2 lần mức nền import và 43.1 lần kích thước đầu vào nếu nhìn theo RSS tuyệt đối. Một bộ kiểm thử và một tiến trình không thể khẳng định một đường cong mở rộng tổng quát; các mức nền của Python và Node cũng vẫn không thể so trực tiếp.
HTML hỏng. Mười hai tài liệu, mỗi tài liệu chỉ hỏng đúng một thứ — thẻ chưa đóng, phần tử inline bị lồng sai, thuộc tính không có dấu ngoặc kép nhưng có khoảng trắng, dấu đóng dư, không có <html> nào cả, thuộc tính trùng lặp, tài liệu bị cắt ngang ngay giữa thẻ, entity sai, một <script> không đóng, khai báo charset nói dối, một comment chứa markup, và 600 tầng lồng nhau — cộng thêm hai mẫu chuẩn hợp lệ ở kích thước tương ứng, vì “nó không trả về gì” chỉ nói được điều gì đó về mức độ lỗi nếu thư viện không cũng im lặng trên một tài liệu sạch cùng kích thước.
justext ném lỗi ở 0 trên 14 và trả về rỗng ở 13, phục hồi 0/33 sentinel được chấm trên các bộ hỏng (malformed-results.json). Mẫu chuẩn ngắn hợp lệ cũng trả về 0 ký tự; mẫu chuẩn dài hợp lệ là kết quả duy nhất có nội dung, với 1.333 ký tự. Cả mười hai bộ hỏng đều vẫn rỗng, và trường hợp <script> chưa đóng bị loại khỏi phần chấm điểm sống sót của sentinel. Vì vậy, loạt kiểm thử này cho thấy khả năng chịu lỗi của parser — không ném ngoại lệ — nhưng không thể quy sự im lặng cho HTML hỏng thay vì cho ngưỡng kích thước đã được đo ở phần trước.
Ưu và nhược điểm
Điểm mạnh. 100 stoplist theo ngôn ngữ, và bộ phân loại thực sự được xây quanh chúng chứ không chỉ dịch sang chúng. Số lượng phụ thuộc ít nhất trong so sánh: 3 gói. Extraction trung vị 0.56 ms. Chín hằng số tinh chỉnh có tài liệu rõ ràng. BSD 2-Clause. Chạy ổn trên Python 3.14 dù bộ phân loại PyPI chỉ dừng ở 3.9.
Điểm yếu. Mức rò rỉ boilerplate cao nhất trong thử nghiệm tổng hợp này ở mặc định: 47%, với 74 token gây nhiễu. Bộ kiểm thử đoạn văn ngắn trả về chuỗi rỗng khi không có đoạn nào vượt length_high. Recall là 0.8378 trên bộ này. Lần đẩy mã và phát hành gần nhất đã cách thời điểm kiểm thử mười bảy tháng, nên cần cân nhắc trách nhiệm bảo trì.
Ai nên dùng, và ai không nên dùng
Nên đánh giá jusText cho các tập dữ liệu đa ngôn ngữ vì bề mặt stoplist theo ngôn ngữ là rõ ràng và rộng. Bài kiểm thử này đã kiểm kê 100 stoplist nhưng chưa đo chất lượng đa ngôn ngữ. Nó cũng là một ứng viên tốt khi phụ thuộc chỉ gồm 3 gói và các ngưỡng cấu hình rõ ràng phù hợp với môi trường triển khai.
Không nên dùng nếu bạn đưa dữ liệu vào mô hình theo từng token, vì 74 token gây nhiễu so với 0 của goose3 và newspaper4k là một chi phí trực tiếp. Cũng nên tránh nếu trang của bạn chủ yếu là đoạn ngắn — mô tả sản phẩm, danh sách, changelog, mục FAQ — trừ khi bạn chủ động chỉnh length_high. Và bỏ qua nó nếu bạn cần một phụ thuộc được duy trì tích cực vì lý do tuân thủ hay mua sắm nội bộ, vì đó là ràng buộc rất thực tế ngay cả khi mã vẫn chạy tốt.
Nếu vẫn dùng, hãy tinh chỉnh length_high trên một mẫu kiểm định đã gán nhãn thay vì bê nguyên mặc định hoặc quy tắc theo percentile. Hãy quét các ngưỡng hợp lý và đo cả article recall lẫn boilerplate precision; giảm ngưỡng có thể cứu được văn bản ngắn, nhưng cũng có thể kéo theo các khối lân cận không mong muốn.
API được quản lý phù hợp ở đâu
jusText làm việc với HTML bạn đã có sẵn, giống như mọi công cụ trong so sánh này. Không công cụ nào ở đây tự đi lấy trang, render JavaScript, hay xử lý một lớp chống bot.
Để xem cùng một bộ kiểm thử trên cả sáu extractor, hãy xem so sánh trích xuất giữa sáu thư viện.
Một dịch vụ hosted có fetch/render/extraction, bao gồm cả Thunderbit của chúng tôi, sẽ chịu trách nhiệm ở một lớp khác. Thunderbit không được benchmark ở đây. Sự khác biệt nằm ở chỗ: phân loại văn xuôi từ HTML được cung cấp sẵn, so với một dịch vụ tự đi lấy và xử lý URL; bài viết này không cung cấp so sánh chất lượng theo cùng thước đo.
Cách nhìn trung thực nhất: stoplist đa ngôn ngữ của jusText là một năng lực thật và miễn phí. Nếu vấn đề của bạn là thu thập trang ở nhiều ngôn ngữ chứ không phải phân loại văn xuôi trong chúng, đó là một bài toán mua giải pháp khác.
Ở phạm vi rộng hơn, bài tổng hợp web scraping API bao quát các lựa chọn hosted, còn bài tổng quan open-source scraper bao quát các giải pháp tự host. Nếu đầu ra sẽ đi vào mô hình, chuyển HTML sang Markdown trong Python là nơi phần lớn độ trung thực bị mất đi.
Dùng thử Thunderbit để trích xuất dữ liệu web
Có nên dùng jusText không?
Nó là một ứng viên nếu tập dữ liệu có nhiều ngôn ngữ hoặc phân bố độ dài đoạn của bạn được hưởng lợi từ việc tinh chỉnh ngưỡng rõ ràng. Hãy kiểm tra cả hai đặc tính trước khi triển khai.
100 stoplist đi kèm là một đặc điểm thiết kế thật, nhưng độ chính xác đa ngôn ngữ chưa được kiểm thử. “Vách đá” ngưỡng là thứ có thể điều chỉnh; việc hạ ngưỡng có chấp nhận được hay không còn tùy vào recall và boilerplate precision đo trên mẫu đã gán nhãn.
Trên bộ dữ liệu tổng hợp tiếng Anh này ở mặc định, newspaper4k không làm rò rỉ bất kỳ đơn vị boilerplate nào đã gán nhãn và phục hồi 0.9865 đơn vị bài viết. Điều đó khiến nó trở thành một ứng viên đáng so sánh cho khối công việc này, chứ không phải khuyến nghị thay thế cho mọi trường hợp.
Dùng thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
Vì sao jusText trả về chuỗi rỗng thay vì trích xuất một phần?
Bộ phân loại của nó chạy qua hai lượt. Một đoạn chỉ tự đạt nhãn good khi vượt length_high (mặc định 200 ký tự); lượt thứ hai mới nâng các khối neargood ở lân cận. Nếu không có đoạn nào vượt ngưỡng, sẽ không có điểm khởi phát, nên mọi ứng viên đều rơi về boilerplate và kết quả trở thành rỗng. Đây là thiết kế kiểu “có hoặc không”, chứ không phải do không tìm ra được một phần câu trả lời.
jusText có bị bỏ rơi rồi không? Lần đẩy mã cuối cùng và lần phát hành PyPI cuối cùng đều là 2025-02-25 — tức mười bảy tháng trước khi kiểm thử — và bộ phân loại trên PyPI chỉ dừng ở Python 3.9. Nhưng nó vẫn cài và chạy trên Python 3.14.2 mà không có ngoại lệ nào, và 9 issue mở cũng chưa phải một hàng đợi quá lớn. Hãy đọc các mốc thời gian như rủi ro bảo trì chứ không phải bằng chứng của lỗi chức năng; rủi ro thực tế là bạn có thể phải tự sửa lỗi của chính mình.
Vì sao nó rò rỉ boilerplate nhiều hơn Readability? Trên bộ kiểm thử này, các khối lân cận mang dáng dấp văn xuôi đủ điều kiện đã vượt qua ranh giới đầu ra theo các quy tắc ngữ cảnh mặc định. Việc nâng hạng phụ thuộc vào lớp khối, khoảng cách và ngữ cảnh chứ không phải tự động cho mọi hàng xóm. Kết quả đo được là 47% rò rỉ đơn vị boilerplate và 74 token gây nhiễu ở cấu hình mặc định.
Làm sao dùng nó cho ngôn ngữ khác?
justext.justext(html, justext.get_stoplist("German")). get_stoplists() trả về đầy đủ 100 bộ hiện có. Stoplist là đầu vào từ vựng đặc thù ngôn ngữ cho một bộ phân loại còn dùng thêm độ dài đoạn, mật độ liên kết, phân đoạn suy ra từ HTML, khoảng cách đến tiêu đề, và ngữ cảnh khối lân cận. Điều này chỉ thay đổi đầu vào ngôn ngữ; nó không tự xác nhận chất lượng trích xuất tiếng Đức.
Những gì chưa được kiểm thử ở đây là gì?
Không phải các trang thực tế — đây đều là các bộ kiểm thử có kiểm soát với đơn vị được gán nhãn. Năng lực đa ngôn ngữ, vốn là điểm bán hàng chính của thư viện, mới chỉ được kiểm kê ở mức 100 stoplist chứ chưa được chấm trên văn bản ngoài tiếng Anh. Các góc cạnh về mã hóa, dù jusText có cung cấp các tham số encoding, default_encoding và enc_errors. Và max_heading_distance cùng hai ngưỡng tỷ lệ stopword vẫn được giữ nguyên mặc định trong suốt quá trình.




