
Hãy viết đoạn bảo vệ mà ai cũng viết:
try:
    r = requests.get(url, timeout=0.5)
except requests.exceptions.Timeout:
    retry()
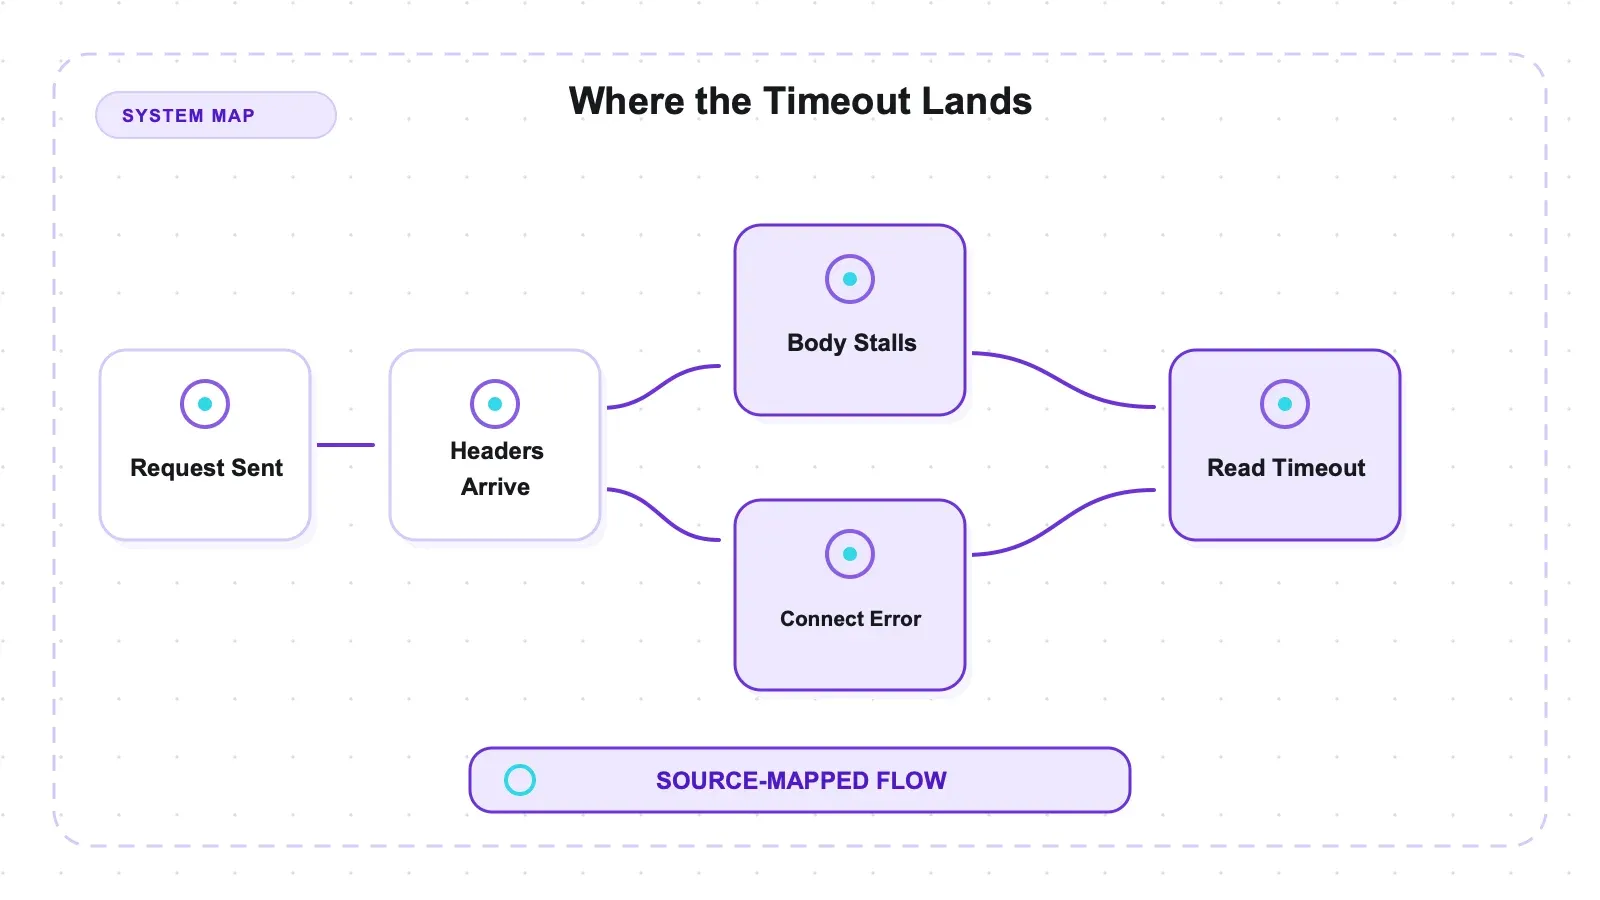
Trỏ nó tới một server gửi ngay dòng trạng thái và header, rồi đứng hình trước khi trả body. Lúc này read bị timeout. Nhưng đoạn bảo vệ không hề chạy. Ngoại lệ bật ra là ConnectionError, và ConnectionError không phải là lớp con của Timeout.
Nếu gặp cùng kiểu đứng hình đó với httpx, nó sẽ ném ReadTimeout, mà ReadTimeout lại thuộc TimeoutException, nên guard tương đương sẽ bắt được.
Tôi đi tìm xem httpx khác requests ở những điểm nào có thể làm hỏng scraper, ban đầu nghĩ sẽ viết về async. Cuối cùng thì async lại là thứ ít thú vị nhất trong danh sách.
Tôi đã kiểm tra gì và kiểm tra như thế nào
Tám phép thử trên một server fixture cục bộ, vì client nói rằng nó đã làm gì không phải là bằng chứng cho việc nó thật sự đã làm như vậy. Server đếm TCP connections — tăng một lần cho mỗi socket được chấp nhận, trước khi bất kỳ request line nào được parse — và đếm các path thực sự được fetch. Việc tái sử dụng connection và theo redirect đều là câu chuyện ở tầng wire, nên wire mới là nơi kiểm chứng.
httpx 0.28.1 với extra http2, requests 2.34.2, Python 3.14.2, macOS arm64. Tất cả chạy trong một virtualenv mới để không bên nào “kéo theo” footprint của bên kia. Kết quả thô: httpx-probes.json.
Sáu dự đoán được đưa vào harness trước lần chạy đầu tiên và giữ nguyên sau đó. Ba dự đoán đúng, hai dự đoán sai, một dự đoán đúng với trường hợp tôi nghĩ tới nhưng bỏ lỡ trường hợp quan trọng. prediction-scorecard.json có phần ghi chép chi tiết.
Những mặc định đổi ngầm dưới chân bạn
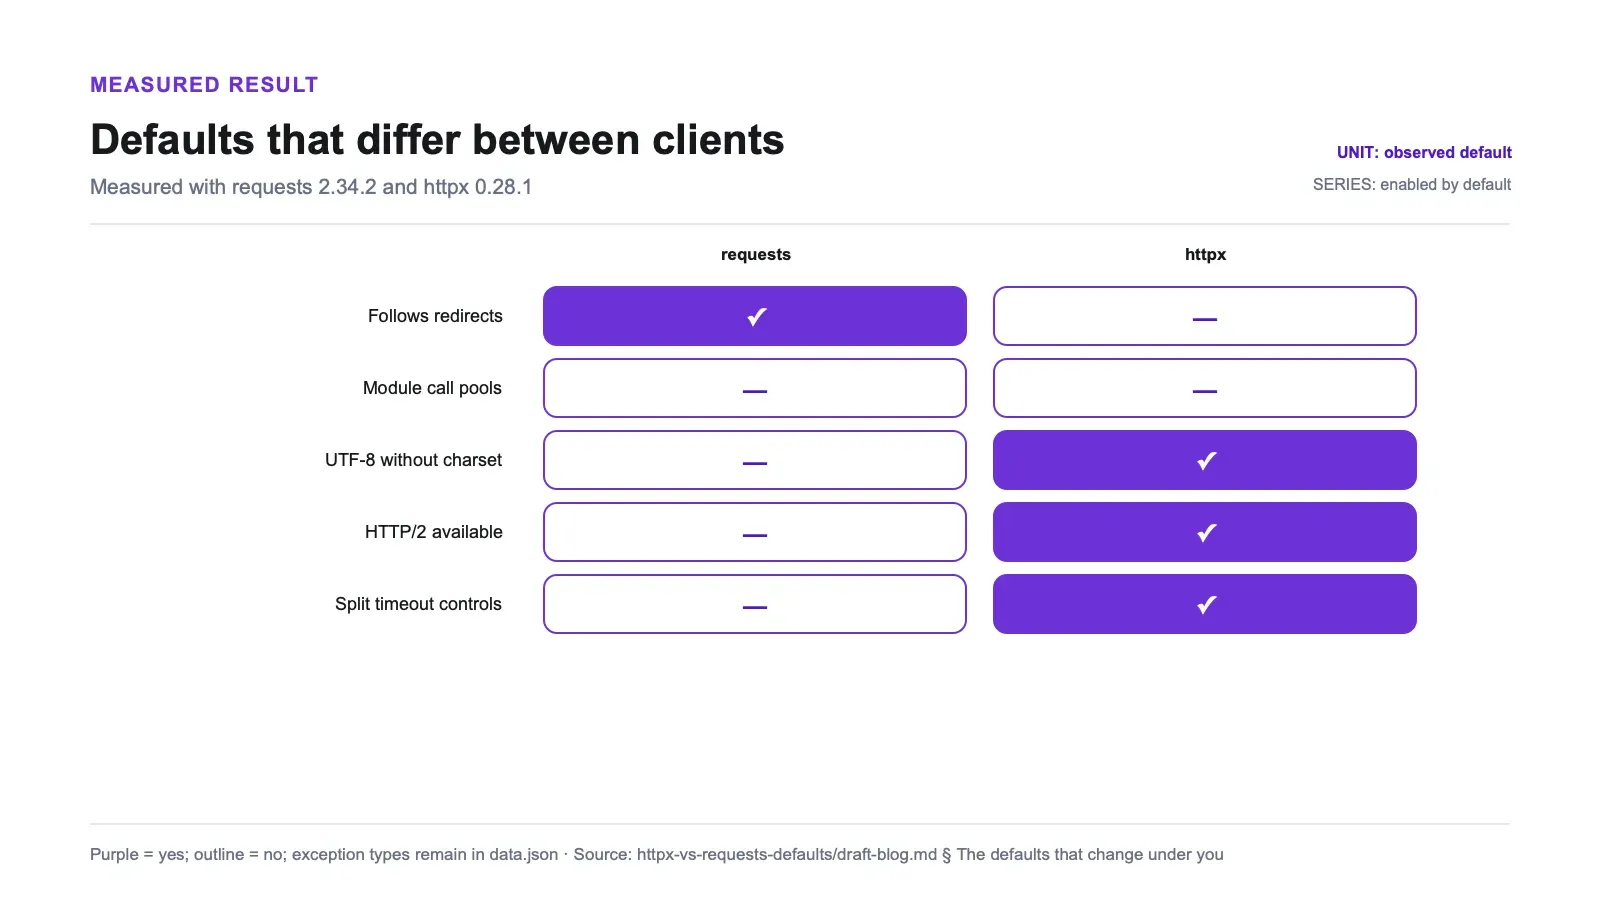
| Hành vi | requests 2.34.2 | httpx 0.28.1 |
|---|---|---|
| Tự động theo redirect mặc định | có | không |
| Gọi ở mức module có tái sử dụng connection | không | không |
| Kẹt trước headers | ReadTimeout | ReadTimeout |
| Kẹt giữa body | ConnectionError | ReadTimeout |
| Không khai báo charset | ISO-8859-1 | utf-8 |
| HTTP/2 | không có | có thể bật, hoạt động |
| Timeout tách riêng cho connect/read/write/pool | không | có |
Redirect, tái sử dụng socket, kết quả ngoại lệ, giải mã ký tự và đàm phán giao thức đều được quan sát qua các probe. Hình dạng API của timeout và việc requests không có cờ HTTP/2 là các quan sát về khả năng của API. httpx-probes.json.
Ba dòng trong số này sẽ làm code của bạn đổi hành vi vào ngày bạn chuyển sang, mà không báo trước.
Redirect: tắt mặc định, và server chứng minh điều đó
Một chuỗi redirect 4 chặng, kết thúc ở /ok:
| Client | Server thấy | Status trả về |
|---|---|---|
| requests | 5 requests | 200 |
| httpx | 1 request | 302 |
httpx, follow_redirects=True | 5 requests | 200 |
Số 5 là bốn chặng cộng với đích cuối. Dự đoán của tôi ghi là 4, do tôi tính nhẩm mà không kiểm lại; điều đáng nói là hướng kết luận đúng, còn con số thì được sửa ở đây thay vì lặng lẽ sửa trong văn bản.
Đây là hành vi đã được httpx ghi nhận và cũng là một lựa chọn thiết kế có lý — redirect là thứ người gọi có thể muốn biết. Nhưng nó cũng là cách dễ nhất để migration hỏng mà không nổ lỗi. Code của bạn nhận 302, response.text trống, parser không tìm thấy hàng nào, còn log thì nói 200 OK… thực ra nó sẽ nói 302, chỉ là trước đây với requests chẳng ai buộc phải nhìn status code cả.
Phát hiện về timeout, và đây là chỗ tôi đoán ngược
Tôi đoán httpx sẽ gọi tên đúng phase bị lỗi còn requests sẽ gom cả hai thành một class. Thực tế thì ngược lại.
Tài liệu chính thức: Requests timeout documentation.
Tài liệu chính thức: HTTPX timeout documentation.
| Trạng thái kẹt | requests | httpx |
|---|---|---|
| Trước status line | ReadTimeout | ReadTimeout |
| Giữa body, sau khi headers đã gửi | ConnectionError | ReadTimeout |
httpx gọi cùng một tên chính xác cho cả hai trường hợp. requests thì tách chúng ra — và tách qua đúng ranh giới mà code retry đang dựa vào.
Hệ quả không phải là suy luận từ cây thừa kế của class. Tôi đã chạy guard:
| Trạng thái kẹt | except requests.exceptions.Timeout | except httpx.TimeoutException |
|---|---|---|
| Trước status line | bắt được | bắt được |
| Giữa body | lọt ra dưới dạng ConnectionError | bắt được |
timeout-retry-guard.json. requests.exceptions.ConnectionError không phải là subclass của requests.exceptions.Timeout; httpx.ReadTimeout là subclass của httpx.TimeoutException.
Thông báo lỗi của requests ghi Read timed out. bên trong ConnectionError. Thư viện biết chuyện gì đã xảy ra. Chỉ là nó không nói điều đó với type system, mà except của bạn lại đang hỏi type system.
Trường hợp đo được ở đây là cụ thể: headers đến trước, rồi dòng body bị dừng đủ lâu để vượt quá read timeout. Một response vẫn tiếp tục đẩy chunk trong cửa sổ timeout, kể cả stream có chủ đích, có thể hành xử khác và không được kiểm tra trong bài này.
Connection pooling: khác biệt nằm trọn trong API client
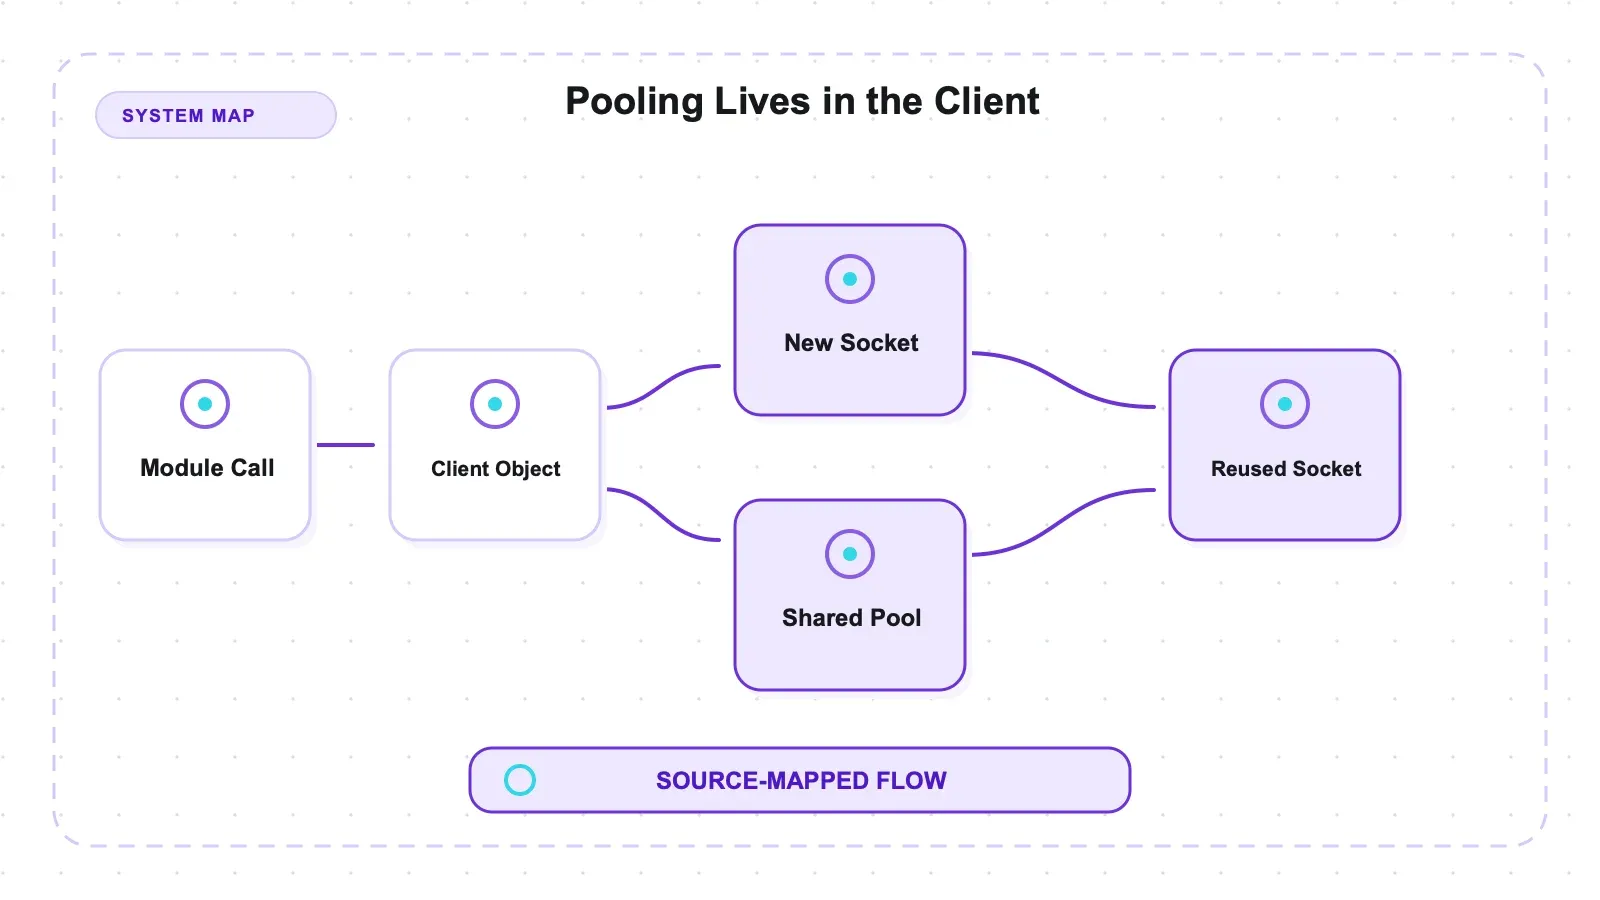
Mười GET, bốn cách, socket được server đếm:
| Cách làm | Số socket mở |
|---|---|
httpx.get() × 10 | 10 |
requests.get() × 10 | 10 |
httpx.Client() | 1 |
requests.Session() | 1 |
Kết quả y hệt, và đáng nói vì đây là hiểu lầm phổ biến nhất về cặp này — rằng httpx có pool còn requests thì không. Thực ra ở mức module, cả hai đều không pool. Cả hai chỉ pool thông qua object client. Nếu hôm nay bạn đang gọi requests.get() trong vòng lặp, thì chuyển sang httpx.get() trong vòng lặp không thay đổi gì về mức độ churn socket.
HTTP/2 phải bật rõ ràng và cần extra
Trên một endpoint HTTP/2 công khai được ghi trong artifact:
Tài liệu chính thức: RFC 9113: HTTP/2.
| Client | Đàm phán được |
|---|---|
httpx.Client(http2=True) | HTTP/2 |
httpx.Client(http2=False) | HTTP/1.1 |
| requests | HTTP/1.1, không có cờ nào |
Bạn cần extra httpx[http2]. Tôi tưởng chỉ cần pip install httpx là đủ để client lặng lẽ thương lượng xuống 1.1, và đã đi kiểm tra trước khi viết ra:
ImportError: Using http2=True, but the 'h2' package is not installed.
Make sure to install httpx using `pip install httpx[http2]`.
Nó báo lỗi ngay lúc tạo Client, trước khi gửi bất kỳ request nào, và message còn chỉ luôn cách sửa. Đây là kiểu lỗi “đẹp” của case này, và tôi đã đoán ngược nó (http2-extra-missing.json).
Probe này chỉ chứng minh việc đàm phán giao thức thành công trên endpoint đó. Nó không chứng minh lợi ích về tốc độ scrape; tôi không test một workload HTTP/1.1 tương ứng.
Thông lượng fixture: tuần tự so với đồng thời
Hai mươi request tới một endpoint ngủ 0.3 giây:
| Chế độ | Thời gian thực tế | Socket |
|---|---|---|
Sync, một Client | 6.138 s | 1 |
Async, một AsyncClient | 0.357 s | 20 |
Lần chạy đồng thời hoàn tất trong 0.357 giây, so với 6.138 giây của lần chạy tuần tự. Nó cũng mở 20 connection trong khi synchronous client chỉ tái sử dụng 1 connection, nên thí nghiệm này đang thay đổi mô hình thực thi và mức độ đồng thời hiệu dụng, chứ không tách riêng tốc độ thư viện.
Đó mới là cách diễn giải trung thực cho con số này. Đây là phép đo concurrency trên một endpoint cố tình chậm, không phải phép đo riêng của httpx. Bất kỳ client nào có async hoạt động tốt đều sẽ rơi vào cùng khu vực này, và với một endpoint nhanh thì khoảng cách sẽ co lại.
Trường hợp charset mà tôi không nghĩ ra để dự đoán
Tôi dự đoán rằng một response có header nói dối — charset=iso-8859-1 trong khi body là bytes utf-8 — sẽ tạo ra mojibake giống hệt ở cả hai. Đúng là như vậy. Cả hai đều trả Café Ubersetzung â naïve résumé trong khi nguồn gốc là Café Ubersetzung — naïve résumé.
Điều tôi không đoán ra là trường hợp quan trọng hơn:
| Response | requests giải mã | httpx giải mã |
|---|---|---|
charset=utf-8, bytes utf-8 | đúng | đúng |
charset=iso-8859-1, bytes utf-8 | mojibake | mojibake |
| không có charset nào | mojibake | đúng |
requests quay về ISO-8859-1 khi header không nói gì, còn httpx mặc định là utf-8. Trong fixture thiếu charset, hai client vì thế cho ra text giải mã khác nhau qua .text; còn người dùng response.content thì vẫn giữ nguyên bytes gốc.
Bộ nhớ, vì đo cái này rất rẻ
Peak RSS, /usr/bin/time -l, mỗi ô là một process mới:
| Ô chạy | requests | httpx |
|---|---|---|
| Chỉ import | 36.0 MiB | 30.6 MiB |
| Import và thêm một GET | 35.8 MiB | 40.7 MiB |
Đây là snapshot của từng process riêng lẻ, và giá trị one-GET của requests thấp hơn nhẹ so với import-only cho thấy độ nhiễu của lần chạy. Chúng không đủ để kết luận xu hướng bộ nhớ; cần nhiều mẫu và khoảng giá trị hơn.
Ý nghĩa khi bạn chọn
Đang tìm bug trong code requests hiện có? Hãy rà lại giả định về redirect, các handler chỉ bắt requests.exceptions.Timeout nhưng lại nghĩ là bao phủ được kẹt giữa body, và các consumer .text nhận response không có charset.
Đang migrate cơ học sang httpx? Đổi namespace exception sang httpx.TimeoutException hoặc các class phase hẹp hơn, quyết định có bật follow_redirects hay không, và kiểm tra lại các giả định về decoding. Handler requests hiện tại vốn đã bỏ sót case kẹt giữa body ở trên; migration không tạo ra bug đó.
Đang viết thứ mới để fetch nhiều URL? httpx là ứng viên tốt khi bạn cần AsyncClient và timeout tách riêng cho connect, read, write, và pool. Các phase này cho bạn biết đang chờ ở đâu — thiết lập kết nối, tiến trình đọc body, upload request, hay chờ lấy connection từ pool — chứ không nói vì sao remote host lại cư xử như vậy.
Đang viết thứ nhỏ, đồng bộ? requests vẫn ổn và có mặt ở khắp nơi. Lý do để chuyển không phải là tốc độ.
Dù chọn gì, hãy dùng object client thay vì hàm ở mức module. Đó là thay đổi duy nhất trong danh sách này mà cả hai thư viện đều thắng rõ ràng.
Khi nào nên dùng API được quản lý
Tất cả những gì ở trên đều là tầng fetch, và tầng fetch là phần dễ. Nó không render JavaScript, không xử lý anti-bot challenge, và cũng không biến HTML thành những dòng dữ liệu bạn muốn.
Ghi chú của tác giả: Thunderbit là lựa chọn được quản lý của chúng tôi cho việc render và trích xuất từ URL. Nó không được test trong bộ benchmark HTTP client này. Chỉ nên cân nhắc loại giải pháp này khi vấn đề bạn cần loại bỏ là việc lấy trang hoặc trích xuất có cấu trúc — chứ không phải semantics của HTTP client.
Nếu bạn chỉ fetch trang thông thường rồi tự parse, cả hai client vẫn đều phù hợp. Dịch vụ được quản lý là một quyết định build-versus-buy riêng, không phải bằng chứng để chọn giữa hai thư viện này.
Với bức tranh rộng hơn, bài web scraping API roundup của chúng tôi bao quát các lựa chọn hosted, còn open-source scraper pillar bao quát các lựa chọn tự host.
Dùng thử Thunderbit để trích xuất dữ liệu web
Kết luận
Với một lớp fetch Python mới cần concurrency async, timeout theo từng phase, và fallback UTF-8, httpx là lựa chọn mặc định của tôi trong các ràng buộc đã test ở đây. requests vẫn rất ổn cho code đồng bộ đã trưởng thành, nơi rủi ro migration lớn hơn lợi ích đó. Proxy, retry policy, TLS fingerprinting, streaming, upload, và biến thiên mạng thực tế đều chưa được kiểm tra, nên đây không phải bảng xếp hạng scraper-client cho mọi trường hợp.
Điểm phải cẩn thận nhất là mặc định redirect, và đây là một rủi ro thật sự chính vì nó lại là một quyết định thiết kế tốt. Rõ ràng luôn tốt hơn ngầm định — cho đến khi thứ “ngầm định” đó lại là phần chịu tải trong code bạn đã ship.
Bảng điểm đã đăng ký trước kết thúc với ba dự đoán đúng, hai dự đoán sai, và một dự đoán chưa trọn vẹn. Chỉnh sửa hữu ích nhất là class ngoại lệ của case kẹt giữa body; phần còn lại của quyết định nên đi từ hành vi quan sát được chứ không phải từ câu chuyện quanh scorecard.
Dùng thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
httpx thật sự không tự theo redirect à?
Đúng, không phải mặc định. Server chỉ đếm 1 request cho chuỗi 4 chặng, và response trả về là 302. Hãy truyền follow_redirects=True ở từng lần gọi, hoặc đặt một lần trên Client. Đây là hành vi được ghi tài liệu và là chủ đích thiết kế; nhưng nó vẫn là thứ dễ hỏng âm thầm nhất khi migration, vì thất bại ở đây là parse ra rỗng chứ không phải exception.
except requests.exceptions.Timeout thật sự chưa đủ sao?
Không đủ nếu server đứng hình sau khi gửi headers. Trường hợp đó ném ConnectionError, mà ConnectionError không phải subclass của Timeout, nên guard sẽ bỏ sót — đây là kết quả được chứng minh trực tiếp, không phải suy ra. Hãy bắt requests.exceptions.RequestException nếu bạn muốn bao hết, và chấp nhận rằng bạn cũng sẽ bắt cả những lỗi không phải timeout.
httpx có nhanh hơn requests không? Không đáng kể, nếu chỉ xét từng request đơn lẻ — vì đó không phải mục đích của nó. Con số 17.2× trong bài test này là phép đo 20 request đồng thời trên endpoint 0.3 giây, tức là đo concurrency. Nếu workload của bạn tuần tự, đừng kỳ vọng tăng tốc; hãy chọn dựa trên mặc định phù hợp hơn.
Tôi có cần extra http2 không?
Chỉ khi bạn muốn HTTP/2 — và nếu bật http2=True mà không có nó, httpx sẽ ném ImportError ngay lúc tạo Client, kèm thông báo bảo cài httpx[http2]. Không có chuyện âm thầm hạ cấp xuống giao thức thấp hơn. Tôi đã đoán là có và đã đi kiểm tra thay vì viết bừa.
Những gì nào không được test ở đây? Hành vi proxy, vốn cực kỳ quan trọng với scraping và cần bộ harness riêng. Retry — httpx không ship logic retry, còn requests lấy từ urllib3, nên so sánh công bằng thực ra là so sánh hai thư viện retry. TLS fingerprinting, thứ mà anti-bot systems thực sự nhìn vào và cả hai thư viện đều không xử lý. Streaming và file upload. Và toàn bộ bài này đều chạy trên một máy, một phiên bản Python, và localhost cho sáu trong tám probe — các số latency từ server fixture là phép đo thiết kế, không phải mạng của bạn.




