
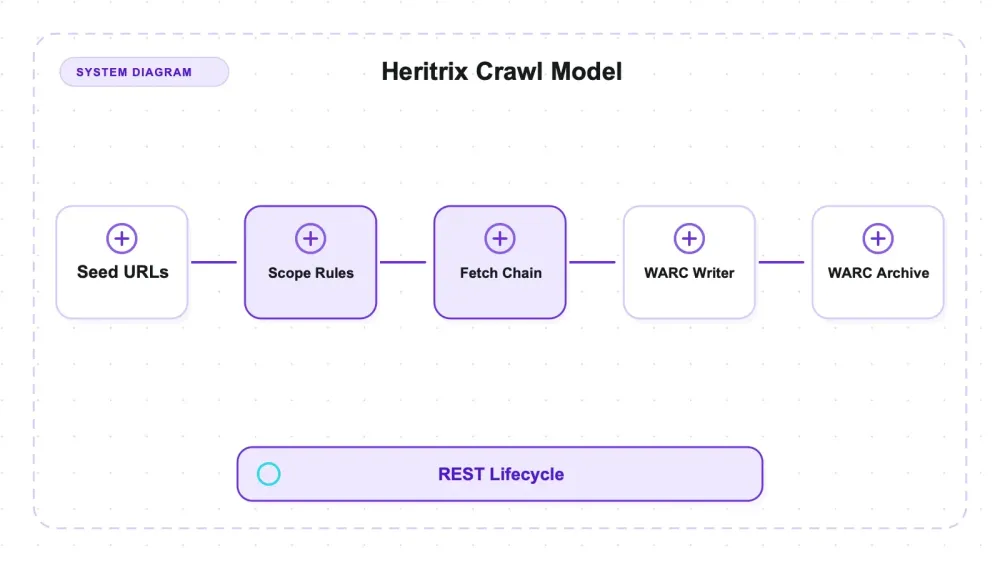
Heritrix là trình thu thập lưu trữ mã nguồn mở của Internet Archive — dòng phần mềm đứng sau Wayback Machine, đã chạy bền bỉ suốt hai thập kỷ. Nhiệm vụ của nó là lưu lại chính xác nội dung mà một website đã phục vụ, đóng gói vào các tệp WARC để nhiều năm sau vẫn có thể phát lại. Bên trong, đây là một bộ máy Java, trong đó mỗi lần crawl là một đồ thị Spring bean viết bằng XML, và toàn bộ vòng đời job được điều khiển qua REST API. Nó không phải scraper: không có cú pháp chọn phần tử, không ánh xạ field dữ liệu, và cũng không có hàng dòng nào ở cuối.
Tôi đã kiểm thử bản 3.16.0 trên một fixture cục bộ có kiểm soát và đếm chính xác từng bản ghi mà nó ghi ra. Điểm nổi bật nhất là mức độ đầy đủ: hai mươi URI được fetch tạo ra sáu mươi mốt bản ghi WARC, với digest của payload và địa chỉ IP thu thập trên mọi phản hồi, cùng mọi request đều được liên kết ngược về response tương ứng — tất cả mà không cần chỉnh bất kỳ nút cấu hình nào. Trải nghiệm vận hành thì ngược lại: gói phân phối 41 MB, 114 tệp jar (lib/ chứa 142 tệp; 28 tệp còn lại là LICENSE và NOTICE đi kèm), và một file cấu hình job dài khoảng 750 dòng trước cả khi fetch đầu tiên bắt đầu — dù toàn bộ crawl ở đây đều chạy headless qua curl, không hề bấm giao diện web.
Kết quả lưu trữ còn phơi bày một mặc định ít ai để ý. Hai URL trong fixture trả về nội dung giống hệt từng byte, và profile mặc định vẫn fetch và lưu trữ đầy đủ cả hai: hai response record và không có revisit record nào, dù cả hai phản hồi đều được gán cùng một payload digest. Cơ chế khử trùng lặp theo content-digest chỉ hoạt động sau khi thêm các processor lịch sử; bản stock không bật sẵn, và nó giúp tiết kiệm dung lượng lưu trữ chứ không phải băng thông.
Heritrix thực ra là gì
Lưu trữ không phải là scraping, và đây chính là chỗ dễ nhầm lẫn cần làm rõ. Heritrix không trả cho bạn các dòng dữ liệu. Cuối cùng bạn sẽ không có CSV. Đầu ra của nó là chính cuộc đối thoại HTTP — header, body và metadata thu thập — được lưu trong định dạng dành cho bảo tồn lâu dài, và đây là bản triển khai tham chiếu cho cả nhóm công việc đó. Hỏi nó danh sách giá sản phẩm chẳng khác nào hỏi một thư ký tòa án về bản tóm tắt.
Số liệu hiện tại tính đến 27/07/2026: repo đang có 3.285 sao và 36 issue đang mở, còn 3.16.0 là bản phát hành mới nhất, công bố ngày 2026-07-03. Đó chính là bản tôi đã kiểm thử, nên ở đây không phải là lời phàn nàn về một phiên bản cũ. Phần giấy phép có một điểm cần lưu ý: file LICENSE là Apache-2.0 thuần túy, nhưng bộ phát hiện của GitHub lại báo “Other” vì một số tệp bên thứ ba đi kèm có điều khoản riêng. Nếu Heritrix được đưa vào sản phẩm thương mại, đây là vấn đề đáng để ai đó trong bộ phận pháp lý xem kỹ vài phút thay vì chỉ lướt qua nhãn ở sidebar.
Có một факт cấu trúc chi phối mọi thứ khác: Heritrix không điều khiển trình duyệt. Nó fetch qua HTTP và trích xuất liên kết từ những byte nhận về. Người anh em của nó trong thế giới lưu trữ hiện đại, Browsertrix Crawler, làm điều ngược lại — dùng Chromium thật và ghi lại những gì trình duyệt thực sự làm. Cả hai đều ghi WARC, nhưng bài đánh giá này chỉ đo đường đi không qua trình duyệt của Heritrix; tôi không benchmark quy mô hay thông lượng của bất kỳ hệ thống nào.
Chain, bean và SURT: một crawl được ghép lại như thế nào
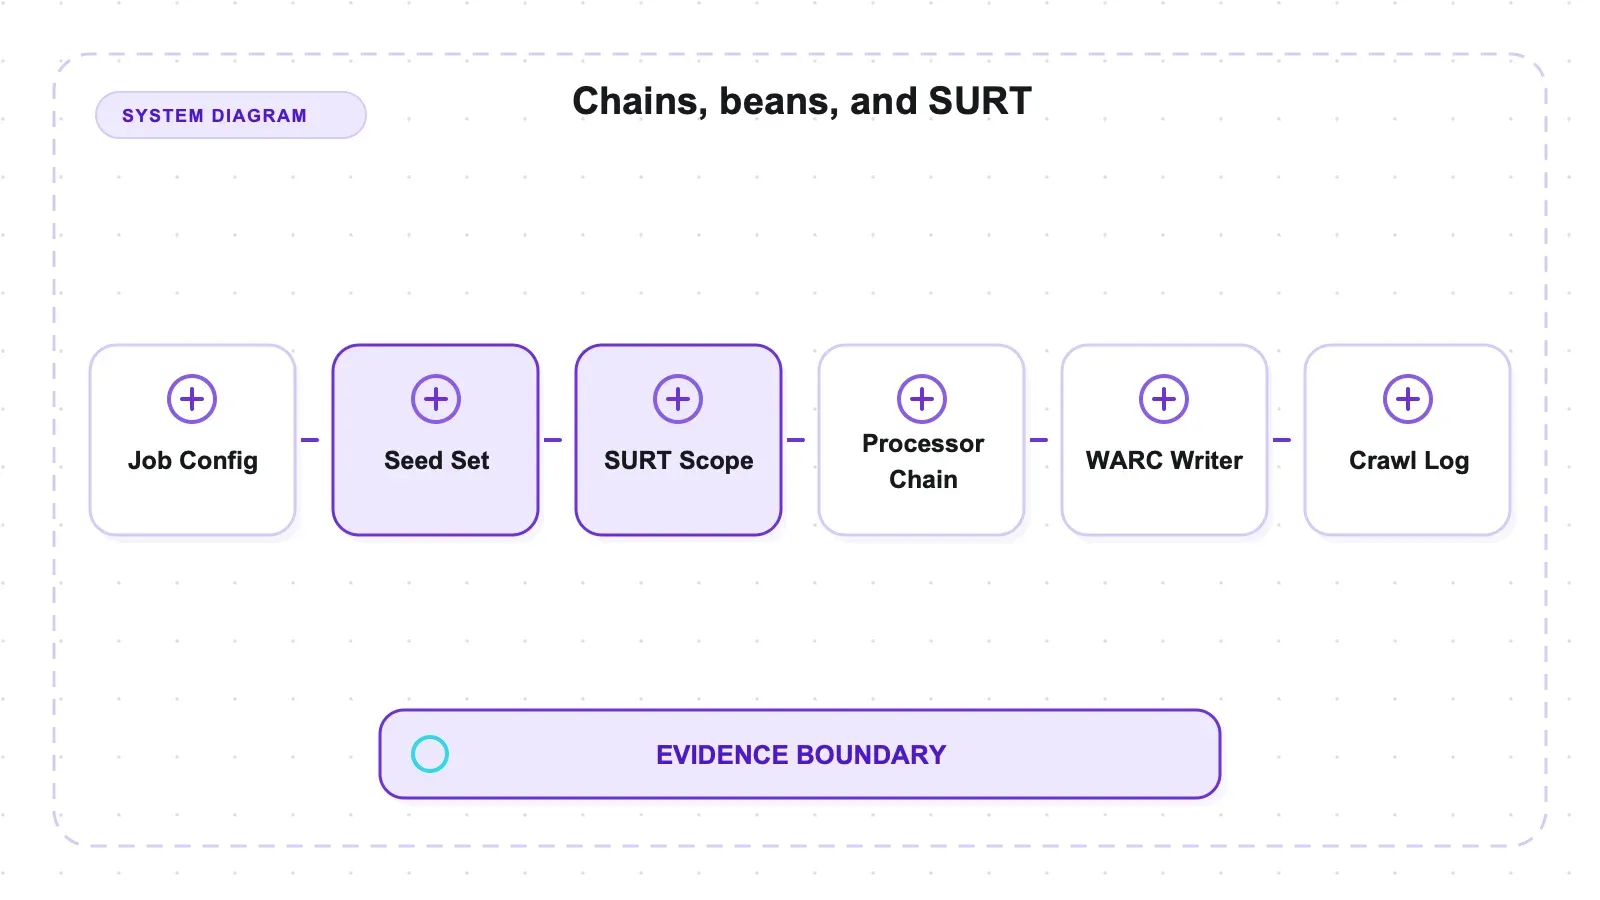
Bên trong, một job của Heritrix là một Spring application context. Không phải là “được cấu hình bằng Spring” — nó chính là một đồ thị Spring bean, viết bằng XML, và mọi thành phần của crawl đều là bean có thể thay thế.
Frontier giữ hàng đợi URI, được chia theo host. Chính việc phân chia này làm cho cơ chế lịch sự hoạt động theo cách nó hoạt động, và điều đó sẽ quan trọng ở phần sau.
Processor chains thực hiện công việc qua ba giai đoạn: candidate chain (URI vừa phát hiện có nên được lên lịch không?), fetch chain (DNS, robots, fetch HTTP, trích xuất liên kết), và disposition chain (ghi vào WARC, cập nhật trạng thái). Muốn thêm năng lực vào Heritrix thì thường là chèn một processor bean vào đúng vị trí trong đúng chain, và đó chính là cách tôi bật dedup.
Scope là một stack các DecideRule hoạt động trên SURT — Sort-friendly URI Reordering Transform, biến http://www.example.com/a thành http://(com,example,www,)/a để phần tiền tố hostname có thể được sắp xếp theo thứ bậc. Scope mặc định được tạo từ SURT prefix của các seed. Các rule lần lượt chấp nhận hoặc từ chối, và rule khớp sau cùng sẽ thắng.
WARC writer nằm trong disposition chain, còn politeness nằm trong frontier dưới dạng ba con số: delayFactor, minDelayMs, maxDelayMs. Robots được tuân thủ bằng một chuỗi chính sách trên fetcher.
Và tất cả đều có thể điều khiển qua một REST API, điều mà cuối cùng hóa ra còn quan trọng hơn tôi tưởng.
Phần cài đặt nặng nhất của toàn bộ trải nghiệm
Những gì bạn phải triển khai, trước cả lần fetch đầu tiên:
| Hạng mục thiết lập | Heritrix 3.16.0 |
|---|---|
| Gói phân phối dạng tarball | khoảng 41 MB |
Số tệp trong lib/ sau khi giải nén | 142 tệp tổng cộng: 114 tệp .jar và 28 tệp LICENSE/NOTICE |
| Khi khởi chạy sẽ mở | một Java engine cùng Jetty web UI nhúng tại https://localhost:8443 phía sau chứng chỉ tự ký |
| Thời gian để sẵn sàng REST trên máy tôi | khoảng mười giây |
Cấu hình job mặc định (crawler-beans.cxml) | khoảng 750 dòng XML Spring bean |
Phần lớn cấu hình job này bạn sẽ chẳng bao giờ chạm tới. Nhưng bạn cũng không thể bỏ qua, và có hai trường bắt buộc trước khi crawler chịu fetch bất cứ thứ gì: seed của bạn, và metadata.operatorContactUrl. Giá trị mặc định chỉ là placeholder, và nó sẽ không crawl cho đến khi bạn thay bằng một URL thật xác định người đang vận hành crawl.
Yêu cầu này tạo ra một điểm gắn trách nhiệm: operator phải cung cấp URL liên hệ trước khi crawler chạy. Nó không chứng minh danh tính là chính xác, crawl đã được cấp phép, hay tuân thủ các quy định áp dụng; nhưng nó biến thông tin liên hệ thành một phần của job, thay vì chỉ là một quy ước tùy chọn.
Có hai kết quả setup khiến tôi thật sự bất ngờ.
Nó chạy được trên JDK mới hơn mức tối thiểu trong tài liệu. Tài liệu Getting Started yêu cầu Java 17 trở lên. Heritrix 3.16.0 vẫn khởi động, phục vụ REST API, và hoàn thành mọi crawl trong fixture này trên OpenJDK 26.0.1, không cần --add-opens, --enable-preview, hay workaround liên quan đến Security Manager. Đây chỉ là kết quả trên macOS arm64, không phải một ma trận tương thích đầy đủ, nhưng nó cho thấy bản build này không bị giới hạn ở JDK 17 trên máy tôi.
Bạn không cần đụng tới web UI. Toàn bộ vòng đời job đều qua REST, và tôi tự động hóa tất cả bằng curl: tạo job, PUT file beans, build, launch, unpause, poll cho đến khi trạng thái controller là FINISHED, terminate, teardown. Đó mới là câu trả lời thực sự cho câu hỏi “Heritrix có vận hành được trong pipeline không?” — có, hoàn toàn headless, không cần bấm UI ở đâu cả. Phần lớn bài viết khác chụp màn hình Jetty UI rồi ngầm coi nó là giao diện chính. Thực ra đó chỉ là tiện ích, không phải yêu cầu.
Một ghi chú triển khai theo host: máy Mac này dùng proxy HTTP toàn hệ thống thông qua Surge. Java client của Heritrix kế thừa proxy đó và đẩy cả traffic fixture 127.0.0.1 qua proxy, khiến kết quả trả về 503 dù OS đã có danh sách ngoại lệ và NO_PROXY. Khởi chạy JVM với -Djava.net.useSystemProxies=false đã biến kết quả từ 2×503 thành 18×200. Đây là tương tác môi trường, không phải lỗi của Heritrix; cờ này chỉ hữu ích khi bạn không muốn kế thừa thiết lập proxy hệ thống.
Thực sự được lưu vào kho lưu trữ là gì
Tôi chạy profile mặc định chuẩn trên một fixture có kiểm soát — một server cục bộ với bộ endpoint đã biết, gồm các trang HTML, chuỗi độ sâu ba tầng, robots.txt và sitemap, cùng các route 404 và 500 cố ý — rồi phân tích WARC tạo ra từng bản ghi một thay vì tin vào một dòng tổng kết.
Hai mươi URI được fetch tạo ra sáu mốt bản ghi:
| Loại WARC record | Số lượng | Nội dung |
|---|---|---|
warcinfo | 1 | thông tin nguồn gốc ở cấp crawl, ghi một lần cho mỗi file |
response | 20 | response HTTP đầy đủ, gồm header và body |
request | 20 | request chính xác mà Heritrix đã gửi |
metadata | 20 | chú thích capture do chính Heritrix tạo ra |
Tỷ lệ 1:1:1 giữa response/request/metadata cho mỗi URI, mặc định có sẵn, không cần tôi cấu hình gì. Và mức độ đầy đủ trên từng bản ghi vẫn vững khi soi kỹ:
| Kiểm tra từng bản ghi | Số lượng | Vì sao quan trọng |
|---|---|---|
Payload digest có tiền tố sha1: trên response | 20/20 | — |
WARC-IP-Address trên response | 20/20 | đây là IP thực sự đã phục vụ nội dung, rất hữu ích nhiều năm sau khi một domain đổi chủ |
Request record liên kết với response của nó qua WARC-Concurrent-To | 20/20 | không phải “phần lớn được liên kết”. Là tất cả. |
Và mã trạng thái HTTP được giữ nguyên đúng như thực tế, kể cả những cái xấu xí: 200 OK, 404 Not Found, và 500 Internal Server Error đều xuất hiện như những status line thật trong response đã lưu, chứ không bị loại bỏ như lỗi.
Điểm cuối cùng này tách lưu trữ khỏi scraping rõ ràng hơn bất cứ điều gì khác. Một scraper xem 500 là lỗi để thử lại hoặc bỏ qua. Một archiver coi đó là điều mà server đã nói vào đúng khoảnh khắc đó, và đó là một факт đáng được lưu giữ. Wiki Heritrix Output mô tả cấu trúc bản ghi này; điều tôi chưa thấy ở đâu là số lượng đo được và liên kết 20/20 trên một bộ endpoint có kiểm soát. Nó đúng như vậy.
Kết quả dedup, đo theo cả hai hướng
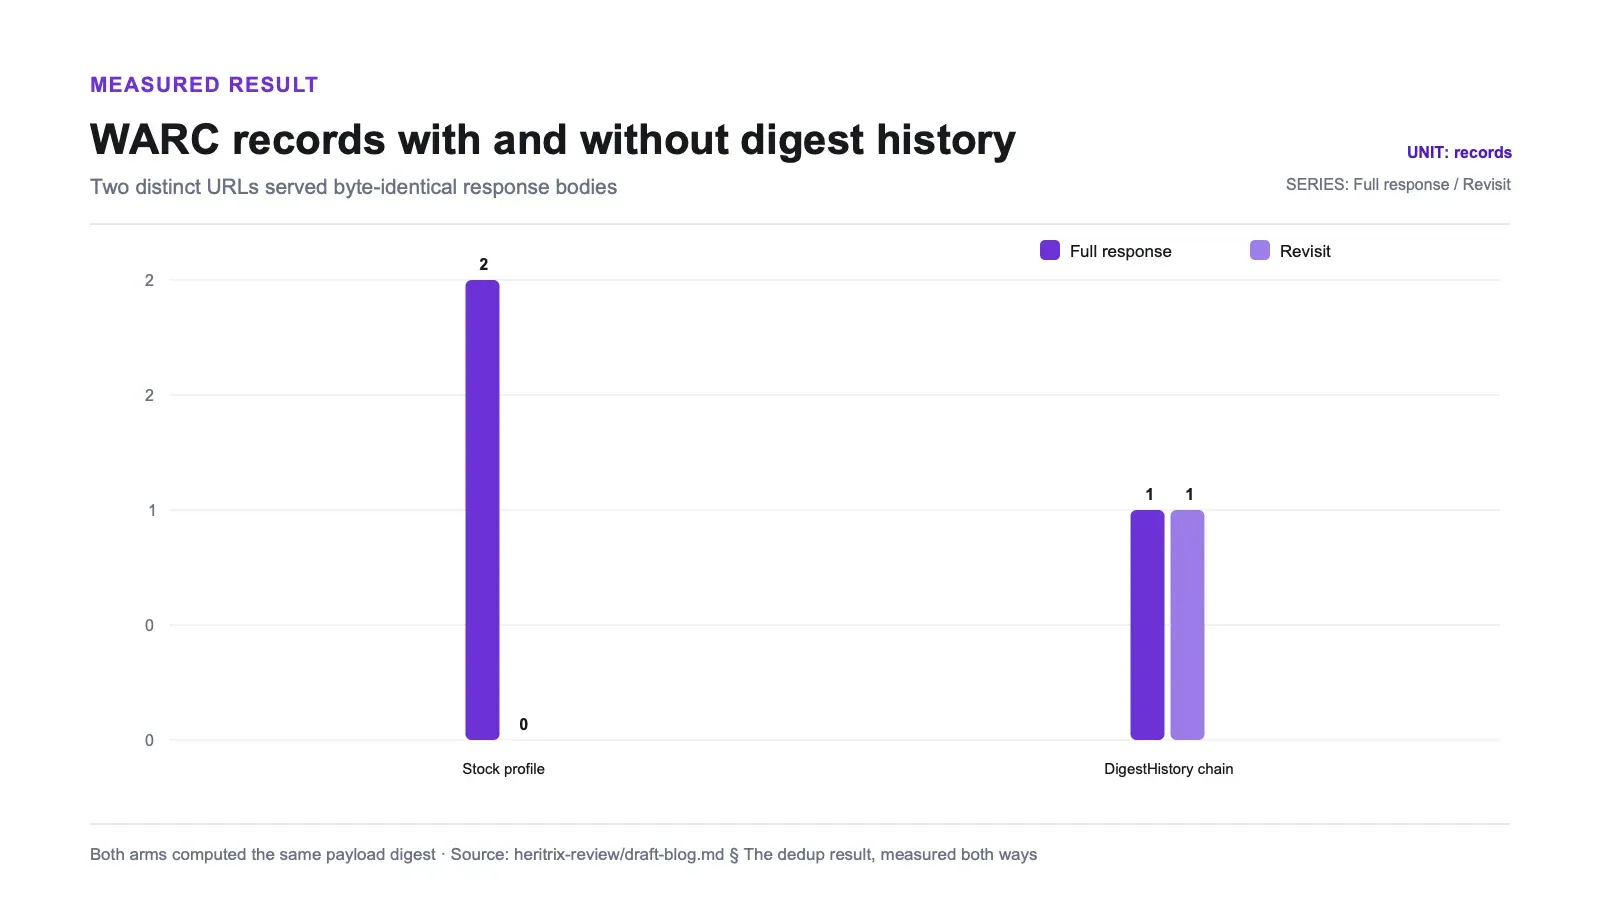
Fixture của tôi phục vụ /dup/one và /dup/two với nội dung giống hệt từng byte. Hai URL khác nhau, cùng một nội dung — đúng kiểu trường hợp content-digest dedup được sinh ra để gộp. Tôi chạy hai lần: một lần với profile mặc định, một lần sau khi chèn chain lịch sử digest (BdbContentDigestHistory, cùng với ContentDigestHistoryLoader trong fetch chain và ContentDigestHistoryStorer sau WARC writer).
| Profile mặc định | Khi có chain ContentDigestHistory | |
|---|---|---|
Full response record được ghi | 2 | 1 |
revisit record được ghi | 0 | 1 |
| Payload digest dùng chung | có (cả hai) | có |
| Revisit profile | — | identical-payload-digest |
Ngay khi xuất xưởng, cả hai response đều nhận cùng một digest, nhưng không có history processor nào xử lý nó và cả hai payload đều được ghi đầy đủ. Khi thêm chain này, capture thứ hai được chuyển thành WARC revisit record trỏ tới payload digest giống hệt, đúng với cách WARC 1.1 specification định nghĩa revisit.
Không có gì bí mật ở đây cả. Trang wiki Duplication Reduction Processors nói rõ skipIdenticalDigests mặc định là false và dedup không phụ thuộc URL cần có các bean loader và storer đó. Đây không phải hành vi ẩn được phát hiện ra; giống gần như mọi thứ tôi đo ở đây, đó là hành vi Heritrix đã được tài liệu hóa, chỉ là có thêm một con số thực tế từ tay tôi. Khoảng cách nằm giữa tài liệu và điều người ta nghĩ là đúng; và theo kinh nghiệm của tôi, điều người ta thường nghĩ là “Heritrix tự dedup”, hết câu, không có dấu sao nào cho cấu hình.
Hai hệ quả đáng khắc sâu:
Dedup diễn ra lúc ghi, không phải lúc tiết kiệm băng thông. Đây là vấn đề cơ chế hơn là một thứ tôi đo lưu lượng riêng, nhưng nó suy ra trực tiếp từ cách content digest hoạt động: chỉ sau khi byte đã về tới nơi bạn mới so sánh digest được, nên URL thứ hai vẫn phải được fetch từ nguồn dù thế nào. Bật chain này sẽ giảm thứ bạn lưu, chứ không giảm thứ bạn truyền hay gánh nặng server đích phải phục vụ. Ai lập ngân sách dedup như một cách giảm băng thông hay tăng lịch sự thì đang hiểu ngược.
Ước tính dung lượng dựa trên giả định “nó sẽ dedup” có thể sai rất nặng. Nếu bạn đang lưu trữ một site có nhiều phần trùng lặp theo template — PDF mirror, landing page kiểu boilerplate, các biến thể print-view của cùng bài viết — và bạn tính ổ đĩa với giả định các body giống nhau sẽ bị gộp, profile mặc định có thể tiêu tốn dung lượng nhiều hơn đáng kể so với ước tính đó. Fixture hai URL chỉ chứng minh hành vi mặc định, không phải ảnh hưởng ở quy mô triệu URI; ảnh hưởng đó còn phụ thuộc vào tỷ lệ trùng, kích thước payload và thiết kế recrawl.
Scope và robots làm đúng những gì chúng hứa
Từ “crawler” về việc nó không fetch cái gì thì không có nhiều giá trị, nên cả hai bài kiểm tra này đều được đo bằng bộ đếm hit phía server — tức chính server đích tự đếm request, độc lập với mọi thứ Heritrix ghi lại.
| Kiểm soát | Điều kiện | Số hit phía server trên đích | Crawl log cho thấy gì |
|---|---|---|---|
| Scope | Scope mặc định; tôi gieo một trang liên kết sang host thứ hai có authority SURT khác biệt | 0 | host ngoài scope không hề xuất hiện — tức nó bị loại ngay lúc phát hiện, chứ không phải được xếp hàng rồi thất bại |
| Robots | Chính sách mặc định là tuân thủ; trang chủ liên kết tới /robots-denied/secret, và robots.txt của fixture chặn đường này | 0 | được ghi là bị chặn (robots.txt vẫn được fetch) |
| Robots | Đối chứng: đổi robotsPolicyName thành ignore, chạy lại | 1 | — |
Scope. Trong khi đó, host nằm trong scope vẫn được crawl bình thường, nên scope hoạt động có kỷ luật chứ không phải crawl bị hỏng. Cần một lưu ý: ở đây tôi chỉ chạy nhánh scope mặc định, không có đối chứng dương với scope nới rộng, nên hãy đọc đây như một xác nhận cho thiết kế đã được tài liệu hóa, chứ không phải bằng chứng hai chiều.
Robots. Liên kết đó luôn có thể truy cập được; chỉ chính sách robots mới ngăn nó lại. Sự tuân thủ là thật và cửa thoát cũng là thật — đó mới là cách sắp xếp đúng, vì một số nhiệm vụ lưu trữ hoàn toàn có lý do hợp lệ để vượt qua robots, và điều đó nên đòi hỏi phải cố ý gõ ignore vào file cấu hình.
Politeness: mất 57,7 giây để crawl hai mươi trang cục bộ
Có một con số sẽ quyết định Heritrix có phù hợp với dự án của bạn hay không.
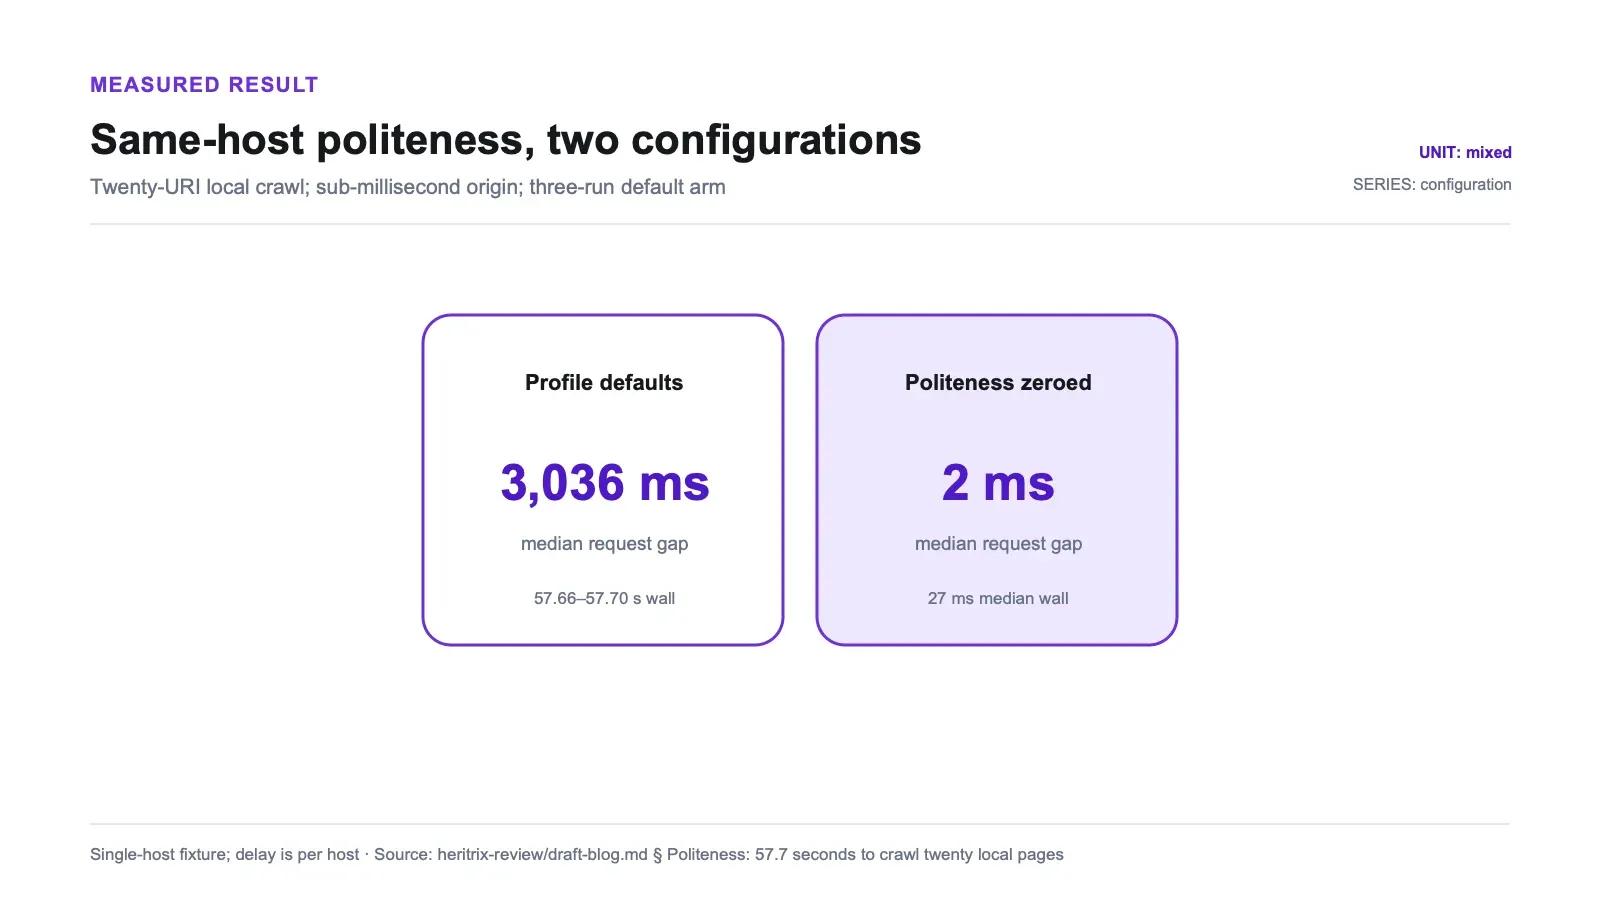
Cùng fixture, cùng cách xử lý ba lần chạy, trên một host cục bộ duy nhất với độ trễ dưới mili-giây:
| Thiết lập politeness | Khoảng cách trung vị giữa hai request cùng host | Thời gian thực, crawl 20 URI đầy đủ |
|---|---|---|
Mặc định của profile (delayFactor 5.0, minDelayMs 3000, maxDelayMs 30000) | 3.036 ms (nhỏ nhất 3.021, lớn nhất 9.107, trên 48 khoảng đo được) | 57,66 s / 57,66 s / 57,70 s (ba lần chạy) |
| Politeness đặt về 0 | 2 ms | 27 ms (trung vị) |
Độ trễ thực tế nằm ngay trên ngưỡng sàn minDelayMs: trên một origin dưới mili-giây, delayFactor × fetch-time là không đáng kể và mức tối thiểu sẽ chi phối hoàn toàn theo thiết kế. Tỷ lệ giữa hai hàng không hữu ích vì mẫu số ở trường hợp không politeness chỉ là vài chục mili-giây và dao động giữa các lần chạy. Kết quả ổn định là ngưỡng tuyệt đối: Heritrix mặc định chờ khoảng ba giây giữa các request tới cùng một host trong fixture này, biến một crawl 20 trang thành khoảng một phút thời gian thực.
Một cách hình dung cụ thể: giả sử một thư viện đại học cần lưu trữ một site chính phủ 50.000 trang trước khi nó bị gỡ xuống, và toàn bộ site nằm trên một host. Với sàn 3 giây mỗi host, bạn đang có 150.000 giây chờ cưỡng bức — khoảng 42 giờ, tức gần một ngày rưỡi, chưa tính thời gian fetch. Đó là phép tính từ ngưỡng đo được 3.036 ms của tôi — 50.000 x 3,036 s = 151.800 s = 42,2 h; ngay cả khi dùng mức tối thiểu cấu hình 3.000 ms thì vẫn là 41,7 h, làm tròn thành 42 chứ không phải 41. Không phải là một crawl được đo trực tiếp, nhưng đó là phép tính mà kế hoạch dự án của bạn sẽ cần.
Công bằng mà nói, politeness của Heritrix là theo host, vì frontier xếp hàng theo host. Một crawl lớn qua hàng nghìn domain sẽ song song hóa trên các hàng đợi đó và không bị trần này áp lên toàn cục. Fixture của tôi chỉ có một host, nên đây là trường hợp tệ nhất cho con số này. Nếu mục tiêu lưu trữ của bạn là một site lớn duy nhất, thì trường hợp tệ nhất ấy chính là trường hợp của bạn.
Và đó là một tính năng. Độ trễ chính là thứ khiến một crawler lưu trữ trở thành công cụ mà chủ site có thể chấp nhận thay vì chặn. Việc giảm nó xuống là quyết định liên quan tới server của người khác, và công cụ này buộc quyết định đó phải được nói ra thay vì mặc định hung hãn.
Những gì tôi không kiểm thử
Các phép đo này chỉ bao phủ kỷ luật crawl trên một fixture có kiểm soát, và không rộng hơn thế. Ngoài phạm vi đó:
- Dedup giữa các crawl và recrawl. Tôi chỉ đo content-digest dedup trong cùng một crawl. Việc lưu cơ sở dữ liệu lịch sử URI qua các crawl riêng biệt (
FetchHistoryProcessor+PersistLog) là cơ chế khác, và tôi không thử. - Quy mô và độ ổn định dài hạn. Không có frontier triệu URI, không checkpoint-and-restore, không chạy nhiều ngày. Fixture của tôi đo kỷ luật, không đo sức bền.
- Capture được render bằng JavaScript. Capture mặc định của Heritrix là không qua trình duyệt, và đó là thứ tôi đo. Các hành vi tùy chọn dựa trên browser ở đây chưa được kiểm thử.
- Politeness trên origin độ trễ cao. Độ trễ cục bộ là dưới mili-giây, nên
minDelayMschi phối hoàn toàn. CáchdelayFactorthay đổi trên một server thực chậm hơn thì dữ liệu của tôi không tách riêng được. - Độ bao phủ từ sitemap. robots.txt đã được request và directive sitemap được theo, nhưng tôi không xác nhận riêng từng mục
<loc>.
Cần làm rõ điều gì trước job production đầu tiên
Profile mặc định thì dài, nhưng những quyết định làm thay đổi ý nghĩa của một kho lưu trữ lại khá gọn. Hãy bắt đầu từ scope. Seed tạo ra các SURT prefix mặc định, và DecideRule có thể nới rộng hoặc thu hẹp chúng theo thứ tự. Hãy rà lại thứ tự rule cuối cùng với các URL đại diện trong scope và ngoài scope, rồi kiểm tra lại bằng traffic phía server hoặc một log request độc lập khác. Chỉ một crawl report thôi thì không thể chứng minh rằng một host bị loại đã hoàn toàn không bị chạm tới.
Tiếp theo, hãy quyết định chính sách robots và danh tính operator có ý nghĩa gì đối với bộ sưu tập. Mặc định đã kiểm thử là tuân thủ rule chặn của fixture, còn việc đổi robotsPolicyName thành ignore khiến đường dẫn bị chặn vẫn được fetch. Công tắc này về mặt cơ học thì đơn giản, nhưng về mặt tổ chức lại rất quan trọng. Hãy ghi lại ai đã phê duyệt nó và vì sao, cùng với một operatorContactUrl hoạt động; URL bắt buộc này cho chủ site một đường liên hệ ngược về operator nhưng không tự mang theo lý do ủy quyền.
Lập kế hoạch lưu trữ cần một quyết định riêng. Nếu các body giống hệt nhau nên trở thành revisit record, hãy thêm và rà soát các processor lịch sử content-digest trước khi ước lượng dung lượng archive. Chain tôi kiểm thử ảnh hưởng tới cách biểu diễn sau khi fetch, nên vẫn phải dự trù traffic từ origin cho cả hai URL. Dedup giữa nhiều crawl là cơ chế riêng và không nên suy diễn từ kết quả một crawl, hai URL này. Một crawl xác thực nhỏ với các body trùng lặp đã biết là cách rẻ để xác nhận rằng đồ thị bean được triển khai tạo ra đúng loại bản ghi mong muốn.
Cuối cùng, hãy xem politeness như một đầu vào cho lịch biểu chứ không phải nút tinh chỉnh phút chót. Trên fixture cục bộ một host, minDelayMs chi phối toàn bộ thời gian. Một dự án thực sự nên tính ngưỡng sàn per-host đã cấu hình theo số host mục tiêu và hạn chót thu thập, rồi kiểm thử trên độ trễ đại diện. Crawl diện rộng và crawl một site đơn lẻ gây áp lực lên frontier chia theo host theo những cách khác nhau; bài đánh giá này chỉ đo trường hợp sau. Hãy giữ vòng đời REST trong runbook: build, launch, unpause, poll, terminate, và teardown đều là các trạng thái riêng đáng theo dõi trong tự động hóa.
Ưu và nhược điểm
Ưu điểm
- Mặc định đã cho độ đầy đủ lưu trữ rất tốt: 20/20 response với payload digest, capture IP và liên kết đầy đủ request↔response, không cần cấu hình.
- Giữ nguyên response lỗi như một факт — các status 200, 404 và 500 đều được lưu verbatim.
- Kỷ luật scope được xác nhận bằng bộ đếm phía server: không có fetch nào ngoài scope trong khi host trong scope vẫn crawl bình thường.
- Tuân thủ robots thực sự ngăn fetch, nhưng vẫn có cửa thoát
ignorekhi cần lưu trữ theo yêu cầu. - Vận hành hoàn toàn headless qua REST — tạo, build, launch, poll, teardown, tất cả qua
curl, không cần bấm UI. - Chạy sạch trên OpenJDK 26.0.1 mà không cần cờ JVM nào, tốt hơn nhiều codebase 20 năm tuổi về mặt “sạch” Java hiện đại.
operatorContactUrlbắt buộc khiến crawler không thể chạy ẩn danh.- Mọi phần của crawl đều là bean có thể thay thế, nên bật dedup chỉ cần chèn ba bean thay vì phải fork.
Nhược điểm
- Content-digest dedup tắt mặc định và ghi toàn bộ payload giống hệt — một cái bẫy thật sự khi lập kế hoạch dung lượng.
- Việc triển khai nặng: bản phân phối 41 MB, 114 jar, một Java engine cộng Jetty, và cấu hình job Spring dài khoảng 750 dòng.
- Politeness mặc định đặt sàn khoảng 3 giây cho mỗi host; crawl 20 URI trên một host mất 57,7 giây.
- Không có render JavaScript trong đường đi mặc định, nên nội dung chỉ có ở phía client sẽ không được capture.
- Bề mặt cấu hình đòi hỏi chuyên môn và không thân thiện với người dùng phổ thông; không có con đường năm phút để có crawl đầu tiên.
- Không có dữ liệu có cấu trúc nào trong output. Việc trích field từ WARC là một dự án riêng.
Ai nên dùng và ai nên tránh
Heritrix dành cho các tổ chức và đội ngũ có đầu ra là chính kho lưu trữ. Thư viện, kho lưu trữ quốc gia, lưu giữ pháp lý và tuân thủ, các nhóm nghiên cứu thu thập web như nguồn chính, bất kỳ ai cần chứng minh sau năm năm rằng một URL đã phục vụ gì vào một ngày cụ thể. Nếu các từ “WARC”, “replay”, và “provenance” đã quen thuộc với bạn, thì đây là công cụ mà cả hệ sinh thái còn lại của bạn được xây quanh, và độ nặng của nó là cái giá phải trả cho khả năng tương tác đó.
Frontier chia theo host và lịch sử sử dụng lâu dài trong web archiving khiến nó trở thành ứng viên hợp lý cho các crawl diện rộng qua nhiều domain. Đó là một cân nhắc về kiến trúc và lịch sử dự án, chứ không phải kết quả quy mô từ fixture này; thông lượng dài hạn, khôi phục checkpoint, và hành vi ở mức triệu URI vẫn chưa được kiểm thử ở đây.
Hãy bỏ qua nó nếu bạn muốn dữ liệu chứ không phải archive. Nếu mục tiêu của bạn là một bảng tính sản phẩm, danh sách, hay liên hệ, Heritrix sẽ làm xuất sắc việc thu thập các trang mà sau đó bạn vẫn phải viết một pipeline riêng để phân tích — và bạn sẽ phải trả giá bằng một Java engine, một file cấu hình Spring, và một sàn politeness 3 giây cho đặc quyền đó. Cũng nên bỏ qua nó nếu mục tiêu của bạn là các ứng dụng SPA render phía client, nơi một fetcher không qua trình duyệt chỉ lưu phần vỏ chứ không lưu nội dung; đó là lúc cần một trình lưu trữ dựa trên browser. Và cũng nên bỏ qua nếu bạn cần có kết quả đầu tiên ngay hôm nay, vì đường cong thiết lập là có thật.
Các lựa chọn thay thế, và vị trí của một API được quản lý
Trong mảng lưu trữ, đối thủ trực tiếp hiện đại là Browsertrix Crawler — một archiver dựa trên browser, điều khiển Chromium và ghi lại những gì browser đã làm. Nó có thể capture nội dung do JavaScript tạo ra mà bản HTTP mặc định của Heritrix không thấy được, nhưng đổi lại là chi phí triển khai và runtime của browser. Bài đánh giá này không chạy benchmark so sánh trực tiếp, nên quyết định phải bắt đầu từ yêu cầu capture: nếu trạng thái do browser tạo ra là cần thiết thì nên chọn browser archiver; còn tài nguyên HTTP truyền thống vẫn là đường đi tự nhiên của Heritrix.
Bài đánh giá liên quan: Đánh giá Browsertrix Crawler.
Với một dạng bài toán khác hoàn toàn — bạn không muốn archive, bạn muốn dữ liệu có cấu trúc từ các trang — hãy so Heritrix với các hệ thống trích xuất theo đầu ra thay vì coi chúng là những crawler tương đương. Heritrix miễn phí và tự host: bạn tự chạy JVM, tự sở hữu file beans, tự tính dung lượng ổ đĩa và tự tinh chỉnh politeness. Mô hình đó phù hợp khi sản phẩm đầu ra là bảo tồn lâu dài.
Tiết lộ: Thunderbit là sản phẩm của đơn vị xuất bản và không được kiểm thử trong fixture Heritrix này. Nó thuộc nhóm trích xuất có quản lý: đầu ra là nội dung trang hoặc bản ghi có cấu trúc, chứ không phải các tệp WARC đạt chuẩn bảo tồn. Hãy chọn archiver khi bạn cần capture có thể phát lại và có provenance; hãy cân nhắc dịch vụ trích xuất khi đầu ra là các dòng dữ liệu hoặc văn bản tài liệu và bạn chấp nhận vận hành được quản lý.
Lưu trữ cũng đi kèm câu hỏi quyền hạn riêng, và nó không giống với scraping. Heritrix tuân thủ robots.txt theo mặc định và yêu cầu bạn xác định danh tính trước khi nó fetch một byte nào, đó là một nền tảng tốt — nhưng một crawl tuân thủ robots không tự động đồng nghĩa với crawl đã được ủy quyền. Bản quyền, điều khoản dịch vụ, dữ liệu cá nhân, và sứ mệnh của chính tổ chức bạn đều nằm phía trên lớp đó, và chính sách ignore tồn tại cho các tổ chức có căn cứ pháp lý để dùng nó, chứ không phải như một công tắc tiện lợi. Nếu bạn đang dựng một chương trình lưu trữ, hãy chốt phạm vi ủy quyền trước khi ổ đĩa đầy, và đọc thêm về khía cạnh pháp lý của web scraping và lưu trữ web nếu đây là vùng đất mới với bạn.
Dùng thử Thunderbit để trích xuất dữ liệu web
Kết luận
Có nên dùng Heritrix không? Có — nếu đầu ra của bạn là một archive và bạn có người sẵn sàng học Spring beans.
Fixture cho thấy một quyết định rất rõ: profile mặc định bảo toàn response, request và metadata capture một cách nhất quán; scope và robots ảnh hưởng tới các fetch phía server đúng như cấu hình; và toàn bộ vòng đời job chạy qua REST. Đây là những thuộc tính hữu ích cho một pipeline lưu trữ, trong phạm vi nhỏ trên một host duy nhất được kiểm thử ở đây.
Chi phí vận hành cũng rõ ràng không kém: một bản phân phối Java và cấu hình Spring lớn, một sàn delay per-host đã chi phối toàn bộ crawl cục bộ này, và dedup theo content-digest cần thêm history processor. Các đội cần độ trung thực WARC có thể chấp nhận những chi phí đó; các đội cần trường dữ liệu trích xuất nên bắt đầu ở một nhóm công cụ khác.
Trước khi crawl production, hãy kiểm tra chain dedup, thiết lập politeness, scope, chính sách robots, danh tính operator, và giả định lưu trữ so với cấu hình job thực tế. Profile mặc định chỉ là điểm khởi đầu, không phải tuyên bố ngầm về những lựa chọn vận hành đó.
Dùng thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
operatorContactUrl có làm cho một crawl được ủy quyền không?
Không. Nó buộc job phải có URL liên hệ, giúp site operator có một đường truy trách nhiệm, nhưng nó không tự xác lập quyền cho phép, độ chính xác danh tính, tình trạng bản quyền hay tuân thủ quy định. Những điều đó vẫn là quyết định triển khai bên ngoài crawler.
Khử trùng lặp theo content-digest có làm giảm số request tới origin không? Không trong cấu hình tôi kiểm thử ở đây. Cả hai URL đều được fetch trước khi digest của payload có thể được so sánh. Chain lịch sử chỉ thay đổi cách payload thứ hai được biểu diễn trong lưu trữ WARC; nó không biến URL thứ hai thành một request mạng bị bỏ qua.
Heritrix có chạy mà không cần web UI không?
Có. Vòng đời đã kiểm thử — tạo, tải cấu hình lên, build, launch, unpause, poll, terminate và teardown — đều chạy qua REST API bằng curl. Jetty UI nhúng không cần thiết.
Profile mặc định của Heritrix có tự dedup các payload giống hệt nhau không? Không trong fixture với cấu hình hiện tại. Profile mặc định lưu cả hai response giống nhau dưới dạng full response record. Khi thêm content-digest history chain, capture thứ hai chuyển thành revisit record, nên dedup là một lựa chọn pipeline cần bạn cấu hình và xác minh, chứ không phải mặc định tự động.
Nên chọn độ trễ politeness như thế nào? Hãy xem các timing cục bộ ở đây như một phép kiểm tra cơ chế, không phải khuyến nghị production. Thiết lập delay dựa trên quy tắc của site đích, thỏa thuận với operator, năng lực server, mục đích crawl, và chính sách retry/concurrency của bạn, rồi kiểm tra lại khoảng cách request cùng host thực tế trong log.




