
Câu trả lời ngắn gọn: GDPR không cấm web scraping. Nhưng khi một scraper thu thập, lưu trữ, sắp xếp hoặc tái sử dụng thông tin về những người có thể nhận diện được, đó là đang xử lý dữ liệu cá nhân. “Dữ liệu công khai rồi” không phải là chiến lược tuân thủ.
Ranh giới này giờ còn không thể xem nhẹ hơn nữa. Tháng 7 năm 2026, Hội đồng Bảo vệ Dữ liệu Châu Âu (EDPB) cho biết GDPR áp dụng cho scraping khi hoạt động này bao gồm các thao tác xử lý dữ liệu cá nhân, đồng thời nhấn mạnh nguyên tắc giới hạn mục đích và tính minh bạch là những điểm then chốt. Bộ hướng dẫn web scraping mới của họ vẫn đang được lấy ý kiến, nhưng định hướng thì đã rất rõ: việc kỹ thuật chỉ thu một trang web mới chỉ là điểm khởi đầu của câu hỏi tuân thủ. Cập nhật từ EDPB
Hướng dẫn này là một khung vận hành thực tế, không phải tư vấn pháp lý. Hãy dùng nó để ra quyết định tốt hơn cho sản phẩm và kỹ thuật, rồi làm việc với luật sư phụ trách quyền riêng tư hoặc DPO của bạn cho những trường hợp có rủi ro thật sự.
Trước hết, hãy tách “có thể scrape” khỏi “có thể sử dụng”
Ba câu hỏi khác nhau thường hay bị gộp chung lại với nhau:
| Câu hỏi | Nội dung cần xác định |
|---|---|
| Truy cập | Bạn có được phép truy cập trang web và thu thập nội dung không? |
| Bảo vệ dữ liệu | Nếu có thể nhận diện cá nhân, bạn có thể xử lý dữ liệu theo GDPR không? |
| Tái sử dụng | Bạn có thể lưu giữ, làm giàu, bán, dùng để huấn luyện, công bố hoặc liên hệ với người đó bằng dữ liệu này không? |
Đạt một điều không có nghĩa là tự động đạt luôn những điều còn lại. Một trang có thể hiển thị công khai nhưng dữ liệu bên trong vẫn là dữ liệu cá nhân. Một lần crawl thành công về mặt kỹ thuật vẫn có thể kéo theo vấn đề về GDPR, hợp đồng, sở hữu trí tuệ, quyền cơ sở dữ liệu, bảo vệ người tiêu dùng hoặc luật marketing.
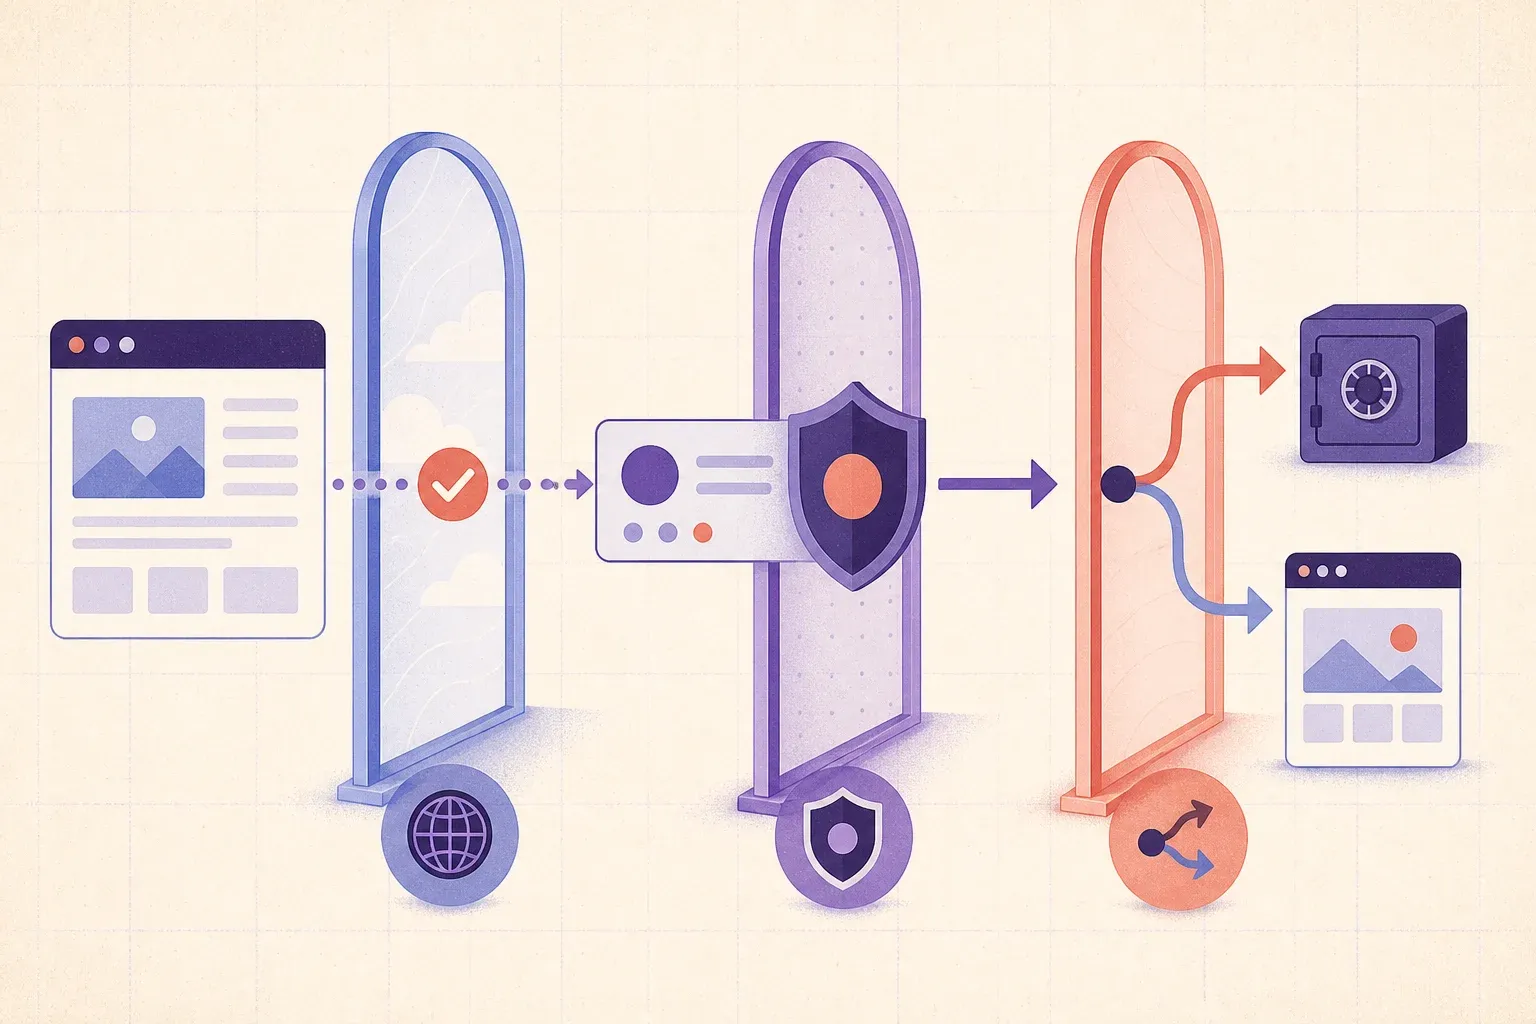
Vì vậy, hãy xem tuân thủ như một quy trình cần chuẩn bị trước khi bắt đầu, chứ không phải một đoạn thêm vào chính sách quyền riêng tư sau khi đã xong việc.
1. Xác định liệu GDPR có áp dụng hay không
Bắt đầu bằng hai câu hỏi.
Bộ dữ liệu có chứa dữ liệu cá nhân không?
Dữ liệu cá nhân không chỉ là tên hay email. Nó bao gồm mọi thông tin liên quan đến một cá nhân đã được xác định hoặc có thể xác định, chẳng hạn như ảnh hồ sơ, tên người dùng có thể lần ra danh tính, vị trí, địa chỉ IP, lịch sử nghề nghiệp, đánh giá, hoặc sự kết hợp của nhiều trường vốn dĩ rất bình thường. Định nghĩa của EDPB
Dữ liệu ở cấp công ty đôi khi có vẻ vô hại. Nhưng một hồ sơ “liên hệ doanh nghiệp” có thể nhanh chóng trở thành dữ liệu cá nhân nếu nó chứa tên hộ kinh doanh cá thể, email trực tiếp của nhân viên, số điện thoại di động hoặc liên kết tới hồ sơ cá nhân. Hãy thiết kế theo bộ dữ liệu thực tế, không phải bộ dữ liệu lý tưởng trong đầu.
GDPR có áp dụng với tổ chức và mục đích của bạn không?
GDPR có thể áp dụng nếu hoạt động xử lý gắn với một cơ sở tại EU. Nó cũng có thể áp dụng với tổ chức ngoài EU nếu tổ chức đó cung cấp hàng hóa hoặc dịch vụ cho người ở EU hoặc theo dõi hành vi của họ. Tổng quan của Ủy ban Châu Âu
Nếu cả hai câu trả lời đều là có, hãy mặc định rằng việc scrape cần một lộ trình GDPR được ghi nhận rõ ràng. Nếu chưa chắc chắn, đừng coi sự mơ hồ là tín hiệu an toàn — hãy đẩy vấn đề lên cấp cao hơn.
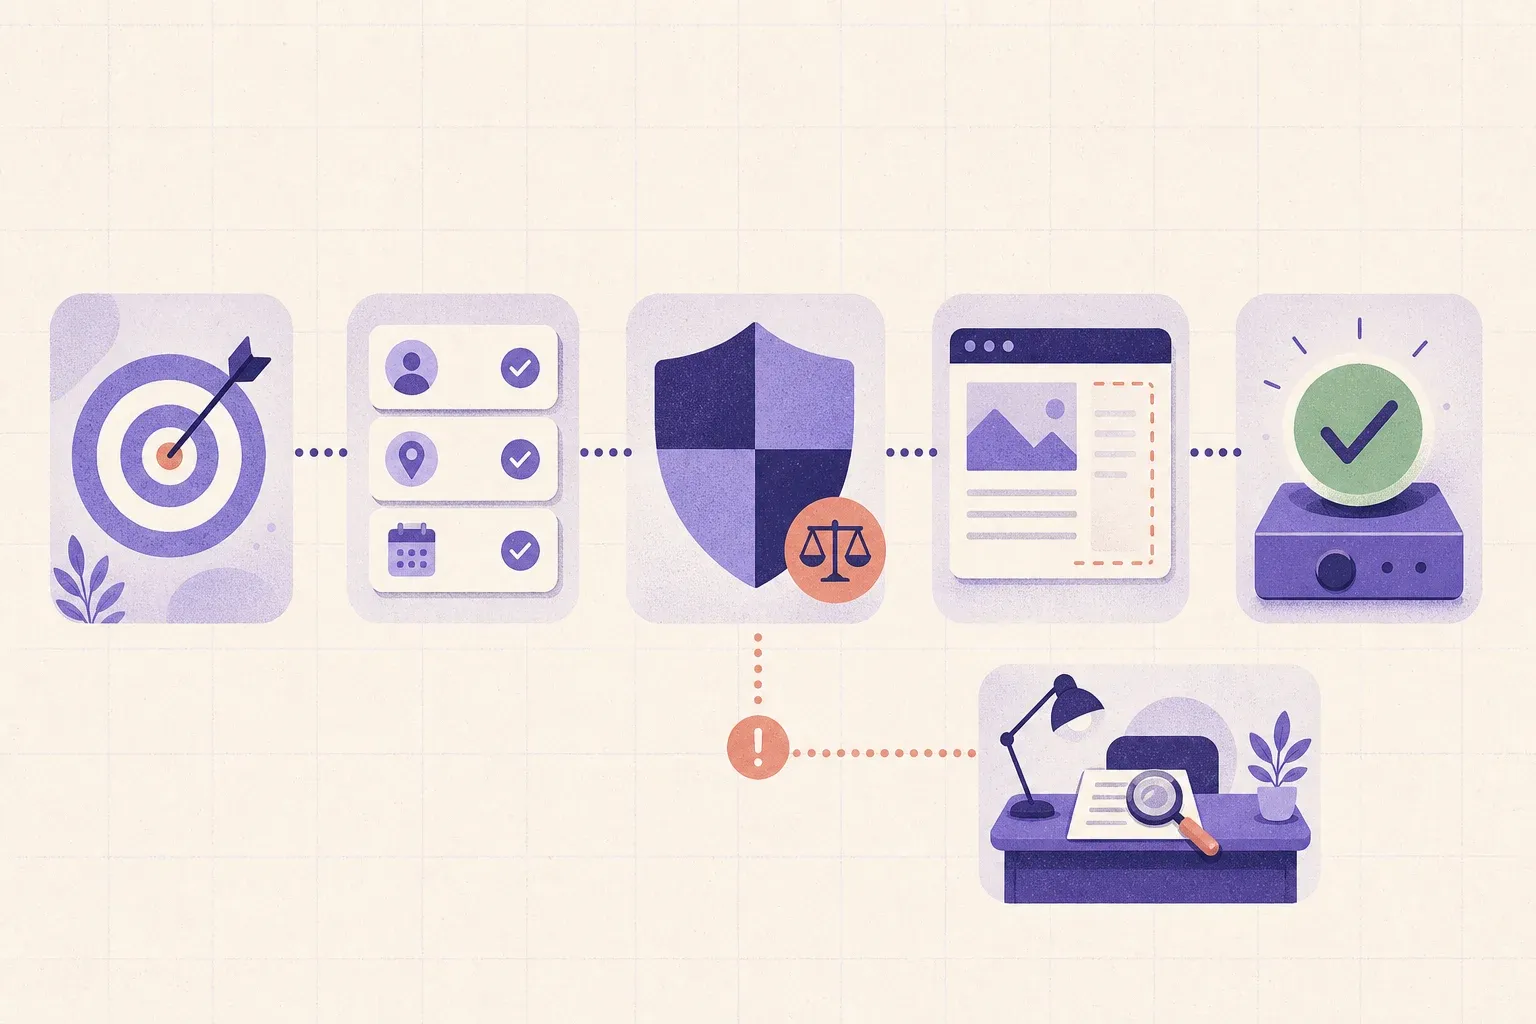
2. Viết bản mô tả thu thập một trang trước khi crawler chạy
Biện pháp kiểm soát đơn giản nhất cũng là biện pháp có giá trị nhất: xác định rõ bạn cần gì trước khi thu thập.
Bản mô tả của bạn nên trả lời:
- Mục đích: Dữ liệu này phục vụ quyết định, dịch vụ hoặc phân tích cụ thể nào?
- Con người và trường dữ liệu: Có thể xuất hiện những nhóm người nào, và những trường nào thực sự cần thiết?
- Nguồn và quyền truy cập: Nội dung có thể truy cập tự do không? Nguồn có phản đối qua điều khoản, robots, trang đăng nhập hoặc các rào cản kỹ thuật khác không?
- Cách dùng và người nhận: Ai sẽ xem kết quả? Dữ liệu có được làm giàu, xuất ra ngoài, chia sẻ, dùng cho marketing trực tiếp hoặc huấn luyện mô hình không?
- Thời gian lưu giữ: Khi nào dữ liệu thô, file làm việc và bản ghi dẫn xuất sẽ bị xóa hoặc rà soát?
- Trách nhiệm sở hữu: Ai là controller, ai là processor, và ai xử lý các yêu cầu liên quan đến quyền dữ liệu?
Đây không phải là thủ tục hành chính vô nghĩa. Các nguyên tắc của GDPR yêu cầu mục đích phải được xác định rõ, và dữ liệu phải đầy đủ, phù hợp, đồng thời giới hạn trong mức cần thiết. Nguyên tắc của Ủy ban Châu Âu
3. Chọn và ghi lại một cơ sở pháp lý — đừng tự suy đoán
Mọi hoạt động xử lý dữ liệu cá nhân đều cần một cơ sở pháp lý. Đồng ý có thể phù hợp với một số sản phẩm, nhưng không phải là câu trả lời mặc định cho dữ liệu web công khai. Với một số tổ chức tư nhân, lợi ích hợp pháp có thể là cơ sở khả dĩ cho các hoạt động scraping được giới hạn rõ ràng và có biện pháp bảo vệ thực tế. Nhưng điều đó không tự động đúng trong mọi trường hợp.
Một bài đánh giá lợi ích hợp pháp đủ sức bảo vệ cần trả lời ba câu hỏi:
- Lợi ích đó có hợp pháp, cụ thể, có thật và đang tồn tại không?
- Việc thu thập này có thực sự cần cho mục đích đó không, hay có cách ít xâm phạm hơn để đạt được cùng kết quả?
- Lợi ích, quyền lợi hoặc kỳ vọng hợp lý của cá nhân có lớn hơn lợi ích của bạn không?
CNIL cho biết dữ liệu công khai được thu thập bằng scraping thường được xem xét dưới góc độ lợi ích hợp pháp, nhưng cần thêm các biện pháp để giảm tác động lên người dùng. Cơ quan này cũng nhấn mạnh phải phân tích theo từng trường hợp, thay vì xin một “giấy phép chung”. Hướng dẫn của CNIL
Hãy ghi lại phân tích, các giả định và biện pháp giảm thiểu bạn đã chọn. “Hồ sơ đó công khai” chỉ là ngữ cảnh cho bài toán cân bằng lợi ích — không phải chính bài toán.
4. Biến tối thiểu hóa thành yêu cầu kỹ thuật
Bản ghi tuân thủ tốt nhất thường là bản ghi mà scraper của bạn chưa từng thu thập.
Hãy đưa các rào chắn sau vào job thu thập:
- Danh sách trường cho phép. Xác định sẵn những trường bạn cần; đừng scrape mọi trường hiển thị chỉ vì nó dễ làm.
- Chặn nhóm dữ liệu nhạy cảm. Loại trừ các tín hiệu về sức khỏe, chính trị, tôn giáo, công đoàn, đời sống tình dục, sinh trắc học và các nhóm đặc biệt khác trừ khi luật sư đã thiết kế một lộ trình pháp lý cụ thể. Văn bản thông thường đôi khi vẫn vô tình tiết lộ các nhóm này.
- Loại bỏ nguồn có rủi ro cao. Duy trì danh sách loại trừ mặc định cho các nhóm hỗ trợ, diễn đàn sức khỏe, không gian dành cho trẻ em và các bối cảnh mà việc tái sử dụng có thể gây bất ngờ hoặc gây hại.
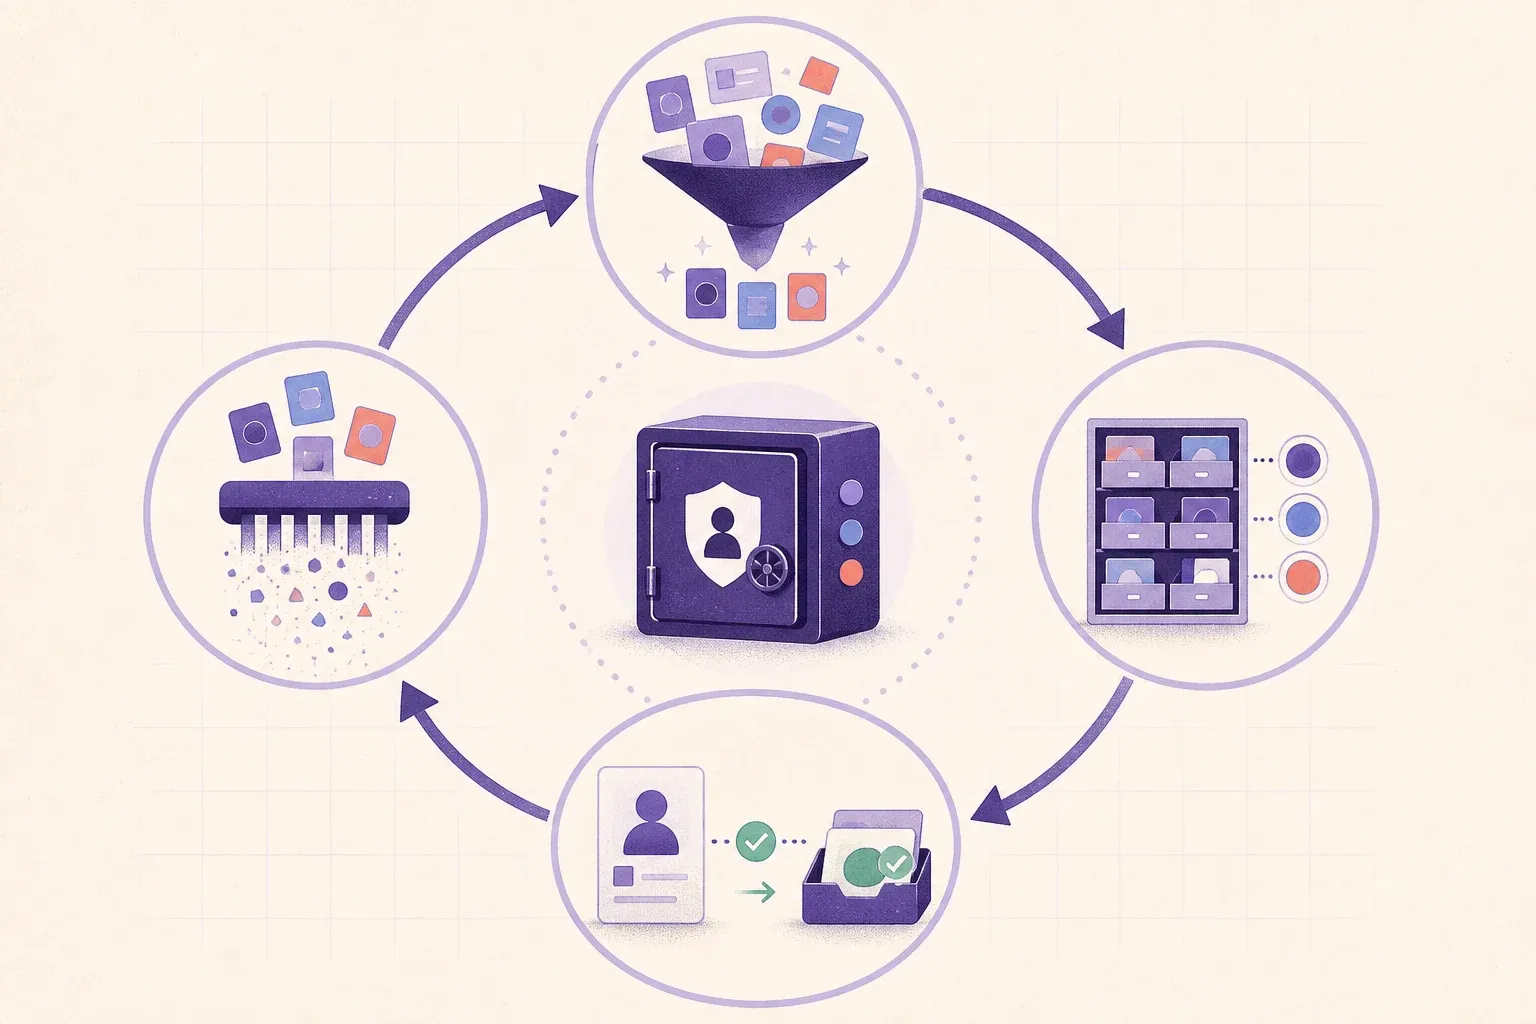
- Xóa phần dư thừa nhanh chóng. Nếu dữ liệu cá nhân không liên quan bị thu vào, hãy tách riêng và xóa nó, thay vì âm thầm giữ lại “phòng khi cần”.
- Ghi lại nguồn gốc. Lưu URL nguồn, ngày thu thập và cấu hình thu thập liên quan cùng với mỗi bộ dữ liệu. Điều này hỗ trợ độ chính xác, xóa dữ liệu và xử lý quyền của chủ thể dữ liệu.
CNIL khuyến nghị rõ ràng rằng nên xác định trước các nhóm dữ liệu phù hợp, lọc bỏ dữ liệu không cần thiết hoặc nhạy cảm, xóa dữ liệu không liên quan và tôn trọng việc phản đối thu thập từ góc độ kỹ thuật hoặc pháp lý. Biện pháp bảo vệ của CNIL
5. Xem minh bạch là một phần của sản phẩm
Dữ liệu lấy từ website thường là dữ liệu thu thập gián tiếp. Điều đó có nghĩa các nghĩa vụ minh bạch theo Điều 14 có thể áp dụng: giải thích bạn là ai, mục đích là gì, các nhóm và nguồn dữ liệu nào được thu thập, cơ sở pháp lý, thời gian lưu giữ, người nhận, việc chuyển dữ liệu và quyền của người dùng.
Tóm tắt của Ủy ban Châu Âu cho biết nếu dữ liệu được lấy từ nguồn khác, thông tin thường phải được cung cấp trong vòng một tháng, tại lần liên hệ đầu tiên hoặc khi tiết lộ lần đầu — tùy trường hợp nào áp dụng. Có ngoại lệ, bao gồm khi việc thông báo là không thể hoặc gây ra gánh nặng không tương xứng, nhưng những ngoại lệ này là có điều kiện và cần được đánh giá, ghi nhận rõ ràng chứ không nên mặc định. Nghĩa vụ theo Ủy ban Châu Âu
Với các bộ dữ liệu lớn, một thông báo công khai rõ ràng, một trang mô tả bộ dữ liệu, một kênh liên hệ riêng và hướng dẫn dễ tìm để phản đối, truy cập, chỉnh sửa và xóa có thể hữu ích hơn nhiều so với một trang pháp lý bị giấu kín. Định dạng phù hợp còn tùy vào cách xử lý và mức độ rủi ro.
6. Xây workflow xóa dữ liệu và xử lý quyền trước khi ra mắt
Scraping quy mô lớn khiến việc dọn dẹp sau này rất tốn kém. Hãy gán mã định danh cho dữ liệu, giữ một bản đồ kiểm soát từ nguồn đến bản ghi, và đảm bảo bạn có thể tìm, gỡ bỏ hoặc che đi dữ liệu của một người trên toàn bộ dữ liệu thô, cơ sở dữ liệu, bản xuất, chỉ mục và các hệ thống xử lý phía sau.
Tối thiểu, hãy xác định:
- ai tiếp nhận và xác minh yêu cầu liên quan đến quyền dữ liệu;
- cách tìm bản ghi mà không yêu cầu thêm thông tin không cần thiết;
- cách việc xóa hoặc phản đối được lan truyền xuống các hệ thống downstream;
- cách ngăn chặn việc thu thập lại ngoài ý muốn;
- thời gian log và backup giữ bản ghi là bao lâu, và quy trình ngoại lệ áp dụng ra sao.
Nếu bộ dữ liệu sẽ dùng cho mô hình, đồ thị làm giàu dữ liệu, profiling hoặc marketing trực tiếp, hãy làm kế hoạch này chặt hơn nữa. Dữ liệu đi càng xa, việc tôn trọng quyền của người dùng càng khó thực chất.
7. Bảo mật bộ dữ liệu và đánh giá sớm các trường hợp rủi ro cao
GDPR yêu cầu các biện pháp tương xứng với rủi ro, bao gồm bảo vệ khỏi truy cập trái phép, mất mát, phá hủy và xử lý bất hợp pháp. Privacy by design và by default nghĩa là chọn các kiểm soát đó ngay từ đầu, chứ không phải sau khi có sự cố. Nghĩa vụ theo Ủy ban Châu Âu
Các kiểm soát nền tảng hữu ích gồm phân quyền theo vai trò, mã hóa khi truyền và khi lưu trữ, quản lý secrets, nhật ký kiểm toán, rà soát nhà cung cấp, kiểm soát xuất dữ liệu và quy trình ứng phó sự cố đã được thử nghiệm. Pseudonymisation có thể giảm rủi ro, nhưng không giống anonymisation và thường không tự động làm mất nghĩa vụ GDPR.
Nên xem xét DPIA trước khi xử lý có khả năng tạo rủi ro cao, đặc biệt khi bạn kết hợp các yếu tố sau:
- thu thập hoặc giám sát trên quy mô lớn;
- profiling hoặc quyết định có ảnh hưởng đến con người;
- dữ liệu thuộc nhóm đặc biệt hoặc mang tính rất riêng tư;
- trẻ em hoặc nhóm dễ bị tổn thương khác;
- kết hợp nhiều bộ dữ liệu để rút ra suy luận mới;
- nhận diện dai dẳng, dữ liệu vị trí hoặc tái sử dụng theo kiểu data broker;
- huấn luyện AI hoặc mô hình có thể ghi nhớ hay làm lộ dữ liệu cá nhân.
Ủy ban Châu Âu xác định việc đánh giá tự động có hệ thống, trên diện rộng; xử lý dữ liệu nhạy cảm quy mô lớn; và giám sát có hệ thống, quy mô lớn là những trường hợp cần DPIA. Hướng dẫn DPIA
Danh sách kiểm tra trước khi ra mắt cho đội web scraping
Trước khi chạy job production, hãy xác nhận tất cả các mục sau:
- Chúng tôi biết việc thu thập có bao gồm dữ liệu cá nhân hay không và vì sao GDPR có hoặc không áp dụng.
- Chúng tôi có mục đích bằng văn bản thật cụ thể và danh sách trường bắt buộc được phép thu thập.
- Chúng tôi đã ghi nhận cơ sở pháp lý và, nếu cần, có bài đánh giá lợi ích hợp pháp.
- Chúng tôi mặc định loại trừ các nguồn hoặc nhóm dữ liệu nhạy cảm và rủi ro cao.
- Chúng tôi đã đánh giá hạn chế từ nguồn và không vượt qua các cơ chế kiểm soát truy cập.
- Chúng tôi có lời giải thích công khai minh bạch và một kênh xử lý yêu cầu quyền dữ liệu cũng như phản đối.
- Chúng tôi biết vai trò controller/processor và có điều khoản với nhà cung cấp phù hợp.
- Chúng tôi có quy trình lưu giữ, xóa, che dữ liệu và lan truyền việc xóa xuống các hệ thống sau.
- Chúng tôi có kiểm soát bảo mật tương xứng và quy trình chịu trách nhiệm khi có sự cố.
- Chúng tôi đã hoàn tất, hoặc ghi rõ lý do không cần, DPIA và đánh giá chuyển dữ liệu xuyên biên giới.
Kết luận thực tế
Tuân thủ GDPR cho web scraper không phải là tìm một câu thần chú trong file robots hay dán một tuyên bố miễn trừ vào sản phẩm. Đó là câu chuyện làm cho việc thu thập tương xứng với một mục đích đã nói rõ, cho người dùng khả năng nhìn thấy và kiểm soát thực chất, và có thể chứng minh các lựa chọn của bạn về sau.
Hãy bắt đầu từ phạm vi nhỏ. Thu thập ít hơn. Giữ lại nguồn và dấu thời gian. Thiết kế sẵn việc xóa trong mô hình dữ liệu. Đưa các trường hợp nhạy cảm, quy mô lớn, profiling và huấn luyện AI lên bước đánh giá trước khi dữ liệu chảy xuống các hệ thống khác. Những thói quen đó giúp scraper đáng tin cậy hơn — và cũng dễ vận hành hơn rất nhiều khi câu hỏi về quyền riêng tư xuất hiện lần đầu.
Bài viết này chỉ cung cấp thông tin chung, không phải tư vấn pháp lý. Hãy tìm tư vấn chuyên môn cho bối cảnh, khu vực pháp lý, loại dữ liệu và mục đích sử dụng cụ thể của tổ chức bạn.
Tìm hiểu thêm
- Web Scraping có hợp pháp ở Mỹ không? Luật thực sự nói gì
- Cách bắt đầu hướng dẫn trích xuất dữ liệu web bằng Thunderbit
- So sánh thực tế 10 API web scraping hàng đầu (2026)
- 10 trình duyệt proxy tốt nhất cho quyền riêng tư trực tuyến
- Những thống kê quan trọng về quyền riêng tư dữ liệu AI cần biết trong 2026




