
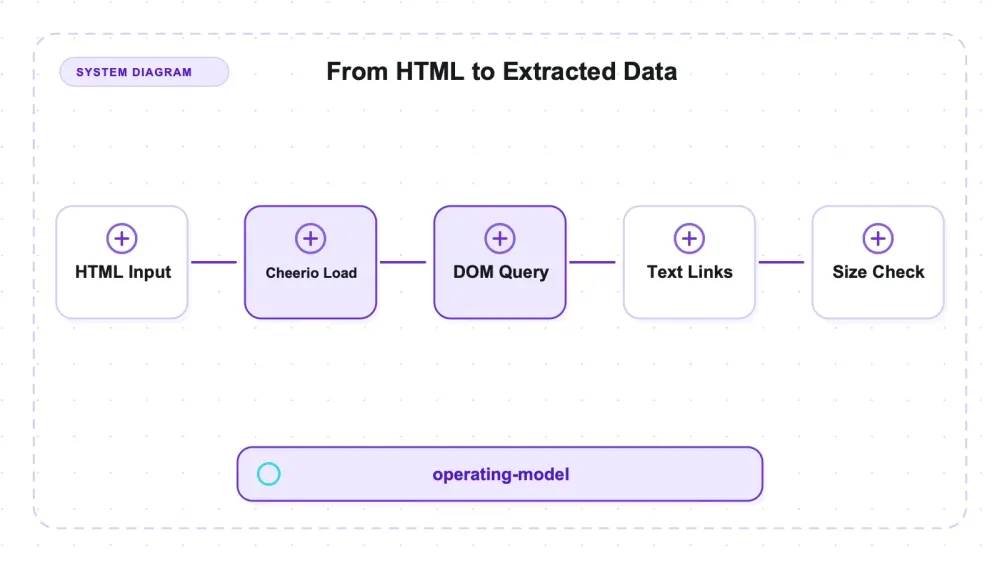
Trên cùng một máy, cheerio trong Node đã phân tích và trích xuất tiêu đề cùng href từ một tài liệu HTML giả lập 10 MB trong 2.927,89 ms. selectolax, chạy qua CPython với bộ phân tích có backend C, hoàn thành cùng tác vụ trích xuất trường trong 158 ms. Chuỗi tiêu đề đã sắp xếp và các mã băm của href khớp nhau. Đây là phép so sánh toàn bộ stack giữa các runtime, không phải phán quyết riêng cho một thuật toán parser.
Với một trang 10 KB, chênh lệch chỉ khoảng 2 lần, và chẳng ai để ý. Câu hỏi thực sự là: trang của bạn đang nằm ở điểm nào trên đường cong đó.
cheerio là gì
cheerio là trình phân tích HTML theo cú pháp jQuery cho Node, và là lựa chọn mặc định trong hệ sinh thái đó vì một lý do chính đáng: 30.449 sao GitHub, giấy phép MIT, và vẫn có cập nhật vào ngày trước khi tôi chạy bài kiểm tra này. Phiên bản được thử nghiệm: 1.2.0.
Tài liệu chính thức: Giới thiệu chính thức về Cheerio.
import * as cheerio from "cheerio";
const $ = cheerio.load(html);
const titles = $("h3.title").map((_, e) => $(e).text()).get();
const hrefs = $("a").map((_, e) => $(e).attr("href")).get();
Nếu bạn đã từng viết jQuery, bạn gần như đã biết cách dùng API này. Chính sự quen tay đó là một trong những lý do lớn giúp nó thắng thế trong hệ sinh thái của mình.
Bên dưới, nó không phải chỉ là một parser đơn lẻ mà là cả một stack: htmlparser2 và parse5 để phân tích, domhandler và domutils cho cây DOM, cheerio-select cho bộ chọn, cùng undici, encoding-sniffer và các gói khác — 11 phụ thuộc trực tiếp, khi giải quyết ra thành 22 gói cấp đầu và 9,0 MiB trên đĩa. Những gói này cung cấp khả năng phân tích và nhận diện mã hóa, đồng thời cũng làm tăng dấu chân phụ thuộc. Bài đánh giá này có kiểm tra đầu ra với đầu vào lỗi định dạng, nhưng không kiểm tra độ đúng của mã hóa hay tách riêng từng backend parser.
Phép đo này là gì, và vì sao đáng tin
Nền tảng nghiên cứu này vốn đã có sẵn một bộ benchmark parser: năm kích cỡ trang từ 1 KB đến 10 MB, 50 vòng lặp, ba lần chạy độc lập, và — phần quan trọng nhất — một cổng đối chiếu tính hàm băm của nội dung trích xuất, gồm tiêu đề đã sắp xếp và href đã sắp xếp, so với parser tham chiếu. Một parser lặng lẽ bỏ sót công việc không thể “ăn gian” để có thời gian nhanh.
Để thêm cheerio vào đó, cần hai bước kiểm tra trước khi bất kỳ con số nào được tính.
Parser tham chiếu có còn cho ra đúng vị trí cũ không? selectolax được chạy lại trong cùng phiên, trên cùng bộ fixture. Mã băm nội dung của nó khớp lại trên 5/5 kích cỡ, và p50 nằm trong khoảng 0,989× đến 1,079× so với số liệu đã công bố. Vì vậy, đây đúng là cùng một máy đã tạo ra bảng gốc.
Cheerio có tạo ra cùng các trường được chấm điểm không? Mã băm nội dung của nó — tính bằng Node với đúng quy tắc giống hệt, SHA-256 trên tiêu đề đã sắp xếp và href đã sắp xếp — khớp với parser tham chiếu ở 5/5 kích cỡ. Điều đó xác nhận tính tương đương cho các trường đã sắp xếp trên bộ fixture này, chứ không khẳng định gì về hình dạng DOM, thứ tự tài liệu, thuộc tính, chuẩn hóa văn bản hay cơ chế phục hồi lỗi.
Chỉ khi đó, các con số thời gian mới thực sự có ý nghĩa.
| Kích cỡ trang | selectolax | lxml | PyQuery | cheerio (Node) | cheerio so với selectolax |
|---|---|---|---|---|---|
| 1 KB | 0.0286 ms | 0.0508 | 0.0456 | 0.1147 ms | 4.0× |
| 10 KB | 0.1725 ms | 0.1802 | 0.1728 | 0.3490 ms | 2.0× |
| 100 KB | 1.4855 ms | 1.4145 | 1.4093 | 3.8399 ms | 2.6× |
| 1 MB | 14.97 ms | 15.03 | 14.96 | 59.37 ms | 4.0× |
| 10 MB | 158.10 ms | 165.25 | 162.86 | 2.927,89 ms | 18.5× |
p50 tính bằng mili giây, là trung vị của ba lần chạy. parser-bench.json. Ba parser Python chạy trong một process; cheerio chạy trên Node 22, nên đây vừa là ranh giới runtime vừa là ranh giới thư viện — xem bên dưới.
Đọc bảng này cho đúng
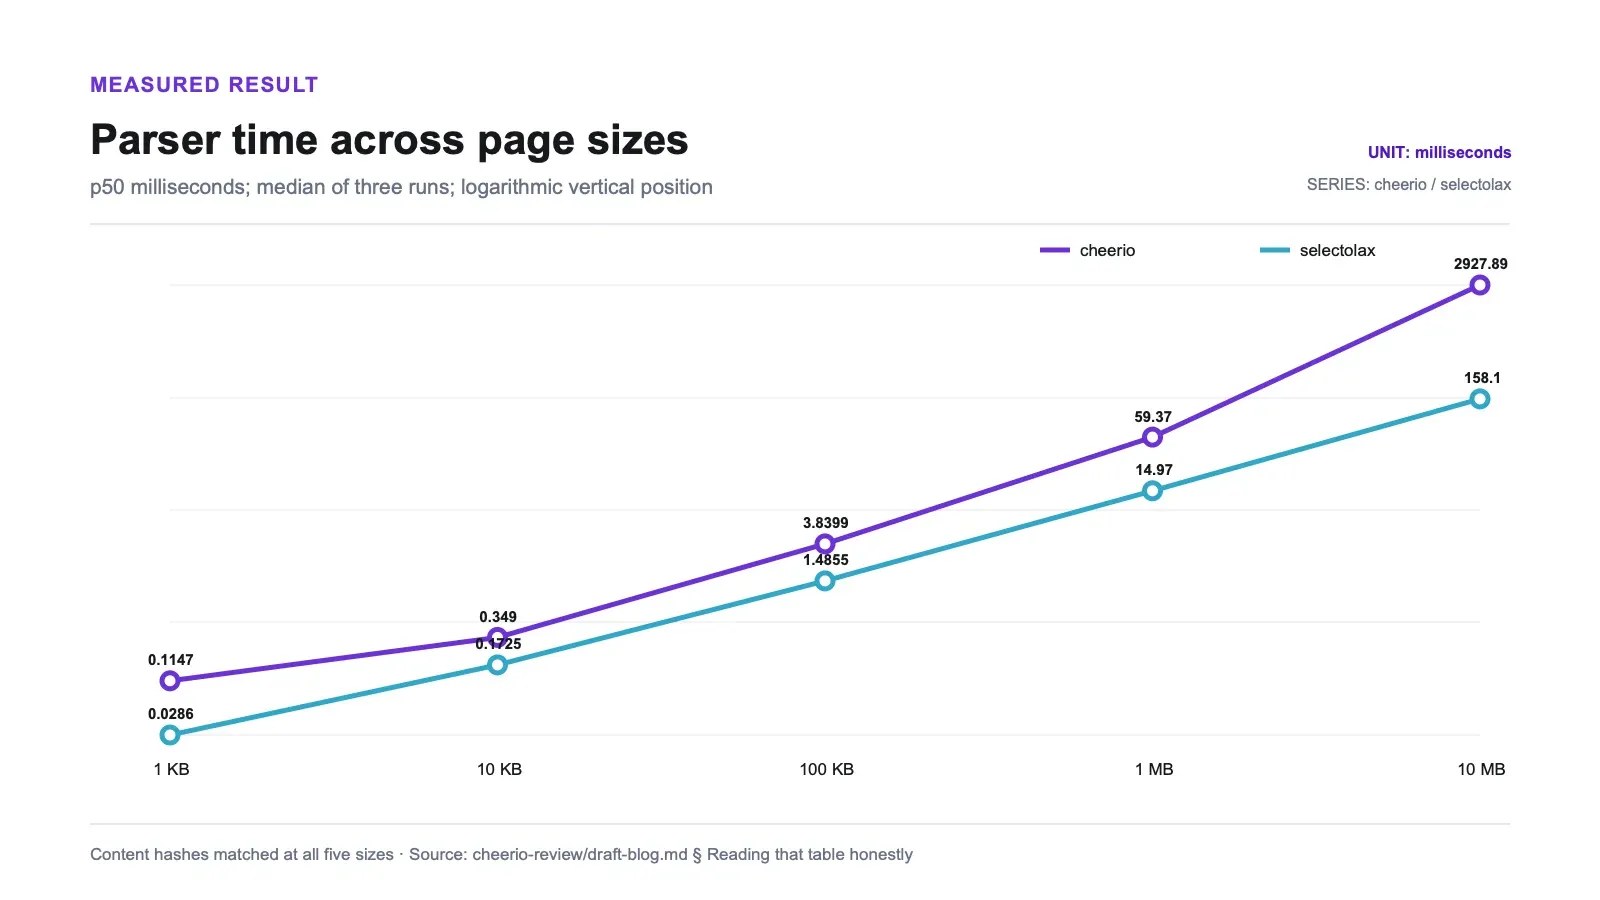
Hàng 1 KB là nhiễu. Trong ba parser Python, độ chênh ở kích cỡ đó là 77,6%, và các lần chạy riêng lẻ chồng lấn rất mạnh — riêng selectolax dao động từ 0,0267 đến 0,0404 ms trong ba lần chạy. Ở mức 28 micro giây, độ phân giải của timer và lịch trình hệ thống chi phối kết quả. Tôi sẽ không xếp hạng gì ở 1 KB, kể cả cheerio.
Phần giữa bảng không có gì quá bất thường. Mức chênh 2× đến 4× trên các trang từ 10 KB đến 1 MB. Với một scraper xử lý vài trăm trang, đó là 45 mili giây mỗi trang thay vì 15, và bạn sẽ không bao giờ nhận ra.
Hàng 10 MB không phải nhiễu. Ba lần chạy của cheerio lần lượt là 2.839, 2.928 và 2.954 ms — khá sát nhau, và tách biệt rõ khỏi các hàng nhỏ hơn. Kết quả end-to-end ở 10 MB lệch hẳn khỏi mô hình ở kích cỡ nhỏ hơn. Năm điểm dữ liệu không đủ để kết luận độ phức tạp tiệm cận hay chỉ ra lớp nào trong runtime, parser, selector, cấp phát bộ nhớ hoặc garbage collection tạo ra bước nhảy này.
Nó nằm trong cùng vùng với BeautifulSoup. Bộ benchmark đã công bố đo thêm bốn parser khác trên cùng fixture 10 MB, và đặt con số 2.927,89 ms của cheerio bên cạnh chúng là điều hữu ích nhất trong bài này:
| Parser (10 MB) | p50 |
|---|---|
| selectolax (lexbor) | 159.93 ms |
| lxml | 172.93 ms |
| parsel | 231.85 ms |
| selectolax (modest) | 247.95 ms |
| BeautifulSoup + lxml | 2.261.56 ms |
| BeautifulSoup + html.parser | 2.788.75 ms |
| cheerio | 2.927,89 ms |
Bốn hàng Python là số liệu đã công bố từ bench_parse.json; số liệu của cheerio là từ lần chạy này. Parser tham chiếu tái tạo trong khoảng 0,989×–1,079× giữa hai lần chạy, nên hãy xem các khác biệt nhỏ hơn khoảng 8% là nằm trong sai số đó — cheerio so với backend html.parser của BeautifulSoup (chênh 5%) thì nằm trong vùng này, còn cheerio so với selectolax (18×) thì không.
BeautifulSoup là thư viện mà người ta thường chọn khi muốn tiện và chấp nhận rằng nó chậm — nó là cái mà mọi thread tối ưu Python đều bảo nên thay thế. Trên tài liệu 10 MB, cheerio đứng ở đáy của cùng một dải đó, chứ không nằm trong dải của những parser có backend C mà nó thường bị đặt cạnh.
Câu hỏi về lựa chọn thay thế ở phía Node vẫn còn bỏ ngỏ trong bài này. Các lựa chọn Node mới hơn chưa được thử nghiệm, nên kết quả này không thể nói rằng việc đổi thư viện là không thể hay gạt chúng sang một bên là kém trưởng thành hơn. Nó chỉ cho thấy đường đi của cheerio được đo đạc so với các stack Python đã liệt kê.
Đây vừa là so sánh runtime vừa là so sánh thư viện. Các mili giây của cheerio đến từ JIT và garbage collector của Node; các thư viện còn lại đến từ CPython gọi vào parser có backend C. Mã băm nội dung chứng minh cùng một công việc đã được thực hiện, và cả hai con số đều là thứ mà người phát triển khi chọn stack sẽ trực tiếp trải nghiệm — nhưng không ai nên đọc thành “thuật toán của cheerio tệ hơn selectolax 18 lần”. Đây là điều đã xảy ra, trên máy này, trong runtime gốc của từng thư viện.
Thực tế khi triển khai
| Thư viện | Gói | Dung lượng đĩa | Giấy phép | Sao | Lần push gần nhất |
|---|---|---|---|---|---|
| cheerio | 22 (npm) | 9,0 MiB | MIT | 30.449 | 2026-08-11 |
| PyQuery | 3 (pip) | 20,1 MiB | BSD | 2.380 | 2026-07-27 |
Tài liệu chính thức: Tài liệu cấu hình Cheerio.
metadata-snapshot.json, được lấy vào ngày viết bài.
npm install cheerio mất chưa đến hai giây và kéo về 9,0 MiB. Cold import đo được 0,056 giây trong một lần chuyển đổi riêng trên cùng máy.
Mười một phụ thuộc trực tiếp là khá nhiều đối với một parser, và đáng để biết nếu bạn audit cây phụ thuộc của mình: htmlparser2, parse5, parse5-htmlparser2-tree-adapter, parse5-parser-stream, domhandler, domutils, dom-serializer, cheerio-select, encoding-sniffer, undici và whatwg-mimetype. Có hai bộ parser hoàn chỉnh trong đó, vì cheerio có thể dùng một trong hai tùy theo bạn yêu cầu gì.
Ba mươi nghìn sao và một lần push vào ngày trước khi kiểm tra là tín hiệu bảo trì rất tốt trong nhóm công cụ này.
Bộ nhớ và HTML hỏng làm gì với nó
Dung lượng bộ nhớ và hành vi với HTML lỗi ảnh hưởng trực tiếp đến triển khai và xử lý sự cố, nên ở đây cả hai đều được đo riêng.
Bối cảnh kiểm tra tải rộng hơn nằm trong so sánh bộ nhớ và HTML lỗi của mười thư viện.
Bộ nhớ cư trú đỉnh, qua /usr/bin/time -l, mỗi ô là một process mới — mức nền import là chi phí thư viện khi đã nạp nhưng đang nhàn rỗi, còn mức đỉnh bao gồm cả tài liệu.
| Thư viện | Runtime | Mức nền import | Đỉnh 226 KB | Đỉnh 10 MB |
|---|---|---|---|---|
| html2text | python3.14 | 18.7 | 19.9 | 71.2 |
| pyquery | python3.14 | 30.3 | 33.9 | 172.5 |
| resiliparse | python3.14 | 20.5 | 25.1 | 225.1 |
| markdownify | python3.14 | 23.9 | 28.9 | 278.5 |
| goose3 | python3.14 | 44.1 | 52.4 | 398.5 |
| cheerio | node22 | 66.8 | 76.5 | 398.5 |
| justext | python3.14 | 30.3 | 36.6 | 431.2 |
| newspaper4k | python3.14 | 52.6 | 61.8 | 668.5 |
| trafilatura | python3.14 | 52.5 | 64.8 | 927.1 |
| turndown | node22 | 47.8 | 68.4 | 2947.1 |
memory-results.json. Mức nền Python và Node không thể so sánh trực tiếp với nhau; interpreter nằm trong cả hai.
cheerio có mức nền import cao nhất trong bảng hỗn hợp này ở 66,8 MiB, bao gồm runtime Node và các phụ thuộc. Process của nó đạt đỉnh 398,5 MiB trên fixture 10 MB. Các hàng còn lại bao gồm parser, bộ chuyển đổi và công cụ trích xuất bài viết đang làm những việc chính khác nhau, nên hãy xem chúng như bối cảnh về dấu chân process chứ không phải bảng xếp hạng ngang hàng. Hàng turndown cùng runtime có đỉnh cao hơn nhiều, nhưng nó thực hiện chuyển đổi chứ không phải hợp đồng chọn lọc tiêu đề và href như cheerio được đo ở đây.
HTML hỏng. Mười hai tài liệu, mỗi tài liệu cố tình phá đúng một thứ — thẻ chưa đóng, inline lồng sai, thuộc tính không có dấu ngoặc kép nhưng chứa khoảng trắng, thẻ đóng lạc chỗ, không có <html> luôn, thuộc tính trùng lặp, tài liệu bị cắt ngang giữa thẻ, entity lỗi, <script> chưa đóng, khai báo charset nói dối, comment chứa markup, và 600 tầng lồng nhau — cộng thêm hai tài liệu chuẩn làm đối chứng ở kích cỡ tương ứng, vì “nó trả về rỗng” chỉ nói lên điều gì đó về mức độ lỗi nếu thư viện cũng im lặng trên một tài liệu sạch cùng kích cỡ.
cheerio ném lỗi trên 0/14 và không trả về rỗng trên 0 trường hợp, đồng thời phục hồi 11/22 sentinel được chấm trên các fixture lỗi (malformed-results.json). Với parser, bộ chấm điểm kiểm tra các sentinel của heading và link trên mười một tài liệu lỗi có thể chấm điểm; nó không chấm sentinel đoạn văn, và fixture <script> chưa đóng bị loại trừ. Không có baseline cùng hợp đồng ở phần này, nên 11/22 không phải là xếp hạng chất lượng. Kết luận có thể chấp nhận là cheerio đã trả về đầu ra không rỗng mà không ném lỗi trên cả mười bốn đầu vào lỗi và đối chứng, đồng thời khôi phục được một nửa số marker được chấm.
Ưu và nhược điểm
Điểm mạnh. Cú pháp jQuery quen thuộc. MIT. Tín hiệu bảo trì có dấu thời gian với 30.449 sao và hoạt động repository ngay trước khi test. Có hai backend parser và các gói liên quan đến mã hóa, dù khả năng phục hồi của backend và độ chính xác mã hóa chưa được tách riêng ở đây. Mã băm tiêu đề cộng href đã sắp xếp khớp với parser tham chiếu ở mọi kích cỡ fixture.
Điểm yếu. Chậm hơn 18,5 lần so với selectolax trên tài liệu 10 MB, và chậm 4 lần trên 1 MB. Có 11 phụ thuộc trực tiếp, gồm hai bộ parser hoàn chỉnh. Chỉ chạy trên Node. Và tài liệu của nó không nói rõ đến kích cỡ nào thì nó ngừng là lựa chọn hiển nhiên.
Ai nên dùng, ai không nên dùng
Nên dùng cheerio nếu bạn đang ở Node, API kiểu jQuery là thứ có giá trị với bạn, và các trang đại diện có kích cỡ gần với phạm vi được thử nghiệm cho tới 1 MB. 1 MB là điểm lớn nhất đã được thử trước cú nhảy mạnh ở 10 MB; bài viết này không xác định ngưỡng giữa hai mốc đó, cũng không khẳng định bao nhiêu phần của web nằm dưới ngưỡng ấy.
Nên benchmark trước khi dùng nếu bạn xử lý các tài liệu HTML rất lớn như báo cáo được tạo tự động, dump danh mục sản phẩm, hay các trang danh sách dài. Hành vi với XML sitemap chưa được kiểm tra. Trên fixture HTML 10 MB, 2,9 giây cho mỗi tài liệu là một chi phí đáng kể và sẽ cộng dồn rất nhanh.
Nếu bạn đang ở Python, so sánh này cho thấy điều khác: selectolax, lxml và PyQuery gần như hòa nhau từ 10 KB trở lên (chênh trong khoảng 0,5% đến 5,4%, với các khoảng chạy chồng lấn), nên hãy chọn theo API chứ không phải tốc độ. Khoảng cách của cheerio so với cả ba mới là con số đáng chú ý, không phải sự khác biệt giữa chính ba thư viện đó.
Vị trí của một API được quản lý
cheerio phân tích HTML mà bạn đã có sẵn. Nó không tự fetch, không render JavaScript, cũng không xử lý lớp chống bot — và trên rất nhiều mục tiêu thực tế, đó mới là nửa khó hơn của công việc.
Một dịch vụ quản lý theo mô hình fetch/render/extract, bao gồm cả Thunderbit của chúng tôi, nằm ở một ranh giới trách nhiệm khác. Thunderbit không được benchmark trong bài này. Phân biệt quan trọng là giữa việc phân tích HTML đã được cung cấp bằng selectors và việc thuê ngoài khâu thu thập, render và trích xuất; bài viết này không đưa ra so sánh cùng thước đo về chất lượng, độ trễ hay chi phí.
Cách nhìn công bằng: nếu bạn đã có HTML và biết selector của mình, cheerio là miễn phí và dễ chịu để dùng. Nếu bạn đang thu thập trang ở quy mô lớn, hoặc muốn mô tả dữ liệu thay vì mô tả DOM, thì đó là một lựa chọn mua khác.
Ở bức tranh rộng hơn, tổng quan các API web scraping của chúng tôi bao quát các lựa chọn hosted, còn bài trụ cột về scraper mã nguồn mở bao quát các giải pháp tự host. Nếu đầu ra đã phân tích sẽ được đưa vào mô hình, chuyển HTML sang Markdown trong Python sẽ nói rõ chỗ nào bị mất fidelity.
Dùng thử Thunderbit để trích xuất dữ liệu web
Có nên dùng cheerio không?
Có, trong Node, khi sự phù hợp của API là điều quan trọng và các tài liệu đại diện vẫn nằm gần dải kích cỡ nhỏ đến 1 MB đã được thử nghiệm.
Sự quen thuộc của API và các tín hiệu bảo trì hiện tại đều là những tiêu chí chọn lựa hợp lý. Benchmark này không chứng minh rằng có một phương án hỗ trợ cụ thể nào đó hay rằng phân bố kích cỡ trang đã thử giống với dữ liệu thực tế trong sản xuất.
Con số cần nhớ là con số ở 10 MB. Ở đâu đó giữa 1 MB và 10 MB, chi phí của cheerio không còn đi theo các thư viện còn lại nữa mà bắt đầu nhân lên — 4× thành 18,5×. Nếu bộ dữ liệu của bạn có những tài liệu lớn như vậy, hãy benchmark trước khi chốt, vì thư viện sẽ không cảnh báo bạn điều đó.
Dùng thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
So sánh cheerio với parser Python có công bằng không? Đây là so sánh stack, không phải so sánh thuật toán. Cả bốn đều tạo ra cùng tiêu đề đã sắp xếp và href theo quy tắc hash trên 5/5 kích cỡ trang. Điều đó không chứng minh mọi parser đều tương đương hoàn toàn. Thời gian của cheerio bao gồm hành vi runtime của Node, còn các thư viện kia bao gồm CPython gọi vào parser có backend C; so sánh mô tả những lựa chọn end-to-end đó.
Vì sao hàng 1 KB không được xếp hạng? Vì ở mức 28 micro giây, phép đo bị nhiễu chi phối. Trong ba lần chạy, các parser Python chênh tới 77,6%, với các lần chạy riêng lẻ chồng lấn lên nhau. Bất kỳ thứ tự nào ở kích cỡ đó đều chỉ là artefact. Từ 10 KB trở lên thì kết quả đủ ổn để đọc.
Điều gì gây ra bước nhảy ở 10 MB? Bài test này không nói được. Điều nó chứng minh là bước nhảy đó có thật chứ không phải nhiễu: ba lần chạy của cheerio nằm ở 2.839, 2.928 và 2.954 ms, tách biệt rõ khỏi mọi thứ khác, trong khi chênh ở 1 MB chỉ là 4×. Muốn tìm nguyên nhân thì phải profiling riêng từng backend parser của cheerio, mà đó không nằm trong phạm vi của bài này.
Nó thực sự có bao nhiêu phụ thuộc?
11 phụ thuộc trực tiếp, 22 gói cấp đầu sau khi resolve, và 9,0 MiB trên đĩa. Trong số đó có hai bộ parser hoàn chỉnh — htmlparser2 và parse5 — vì cheerio có thể dùng một trong hai. Đó là cái giá của việc hỗ trợ cả chế độ phân tích dễ dãi lẫn đúng chuẩn, và rất đáng biết nếu bạn audit dependency tree.
Những gì không được kiểm tra ở đây?
Bài test có đo đỉnh bộ nhớ process trên một tài liệu 226 KB và một tài liệu 10 MB, cộng với bộ 14 đầu vào lỗi + đối chứng, trong đó cheerio không ném lỗi ở trường hợp nào, không trả về rỗng ở trường hợp nào, và phục hồi được 11/22 sentinel được chấm. Nó không kiểm tra streaming qua parse5-parser-stream, độ đúng của mã hóa, khả năng phục hồi riêng của từng backend, vị trí chính xác của bước nhảy hiệu năng giữa 1 và 10 MB, phân tích XML, hay các lựa chọn Node mới hơn.




