
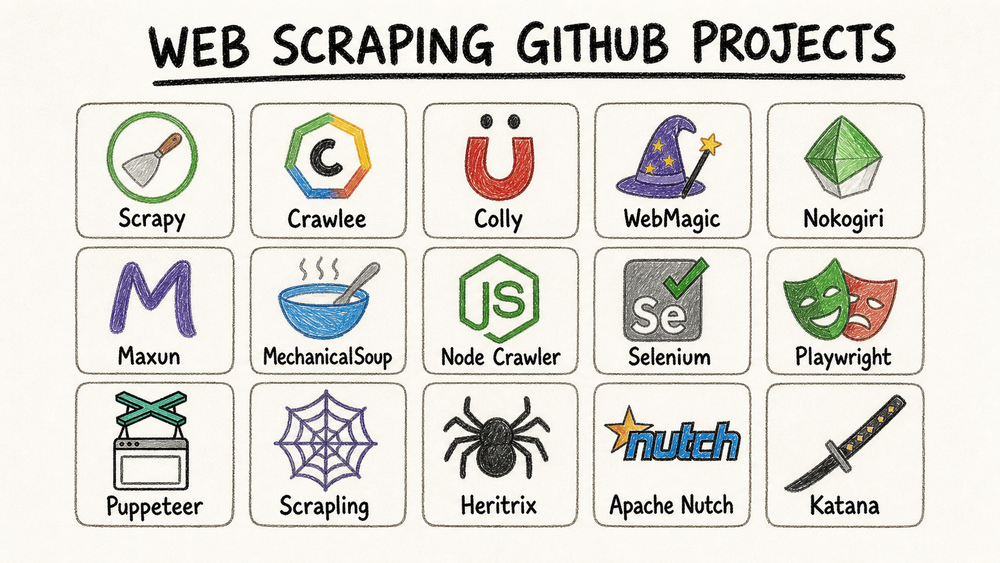
Web hiện nay đến năm 2026 vẫn đầy ắp dữ liệu giá trị, nhưng đa số team thật ra không cần “một scraper” theo nghĩa chung chung. Họ cần câu trả lời rất thực tế cho một trong ba câu hỏi: dự án mã nguồn mở nào còn đáng để tiếp tục xây dựng, bộ công cụ nào xử lý tốt được những website hiện đại nặng JavaScript, và liệu người không biết lập trình có nên bỏ qua GitHub để dùng luôn một quy trình no-code hay không.
Bản cập nhật này được làm ra đúng quanh lộ trình đó. Tôi đã kiểm tra lại các trang repo GitHub công khai, số sao, và activity commit-feed vào ngày 6/8/2026, rồi so sánh các dự án bên dưới theo độ phức tạp khi cài đặt, khả năng hỗ trợ JavaScript, tín hiệu bảo trì, mức độ tiện khi xuất dữ liệu, và mức độ phù hợp với từng nhóm người dùng.
Câu Trả Lời Nhanh
- Chọn Scrapy nếu bạn muốn framework Python trưởng thành nhất cho scraping có cấu trúc và quy mô lớn.
- Chọn Crawlee nếu team của bạn làm với JavaScript hoặc TypeScript và muốn một bộ công cụ duy nhất cho cả HTTP lẫn scraping bằng trình duyệt.
- Chọn Playwright hoặc Puppeteer nếu website nặng JavaScript và tự động hóa trình duyệt thật sự là yêu cầu cốt lõi.
- Chọn Maxun nếu bạn muốn một lớp no-code mã nguồn mở, trực quan, có thể tự host thay vì phải tự viết code scraping từ đầu.
- Chọn Heritrix, Apache Nutch, hoặc Katana chỉ khi công việc của bạn rất đặc thù: crawling lưu trữ, crawling phân tán, hoặc trinh sát bảo mật.
- Chọn Thunderbit nếu bạn không định xây trên GitHub và chỉ muốn có dữ liệu trong Sheets, Airtable, Notion, CSV, hoặc JSON thật nhanh.
Dùng thử một công cụ scrape no-code trước khi cam kết với bộ công cụ code
So Sánh Nhanh
Số sao GitHub và tín hiệu commit gần nhất bên dưới được đối chiếu với các trang repo công khai và commit feed vào ngày 6/8/2026.
| Dự án | Ngôn ngữ / Mô hình | Thiết lập | Hỗ trợ JS | Phù hợp nhất cho | Sao GitHub | Tín hiệu commit gần nhất |
|---|---|---|---|---|---|---|
| Scrapy | Framework Python | Trung bình | Không hỗ trợ JS gốc | Spider quy mô lớn, ecommerce, tin tức | 63.7k | 6/8/2026 |
| Crawlee | Framework Node.js / TypeScript | Trung bình | Có | Kết hợp scraping tĩnh + động trong một bộ công cụ | 25.2k | 6/8/2026 |
| Maxun | Nền tảng no-code mã nguồn mở | Triển khai trung bình, dễ dùng với người dùng | Có | Người dùng doanh nghiệp vẫn muốn kiểm soát theo kiểu mã nguồn mở | 17.1k | 5/8/2026 |
| MechanicalSoup | Thư viện Python | Dễ | Không | Form, phiên đăng nhập, và các website tĩnh đơn giản | 4.9k | 4/8/2026 |
| Node Crawler | Crawler Node.js | Trung bình | Không | Crawling tĩnh tốc độ cao và gom feed | 6.8k | 18/6/2026 |
| Heritrix | Crawler lưu trữ bằng Java | Nâng cao | Không | Lưu trữ web và thu thập quy mô domain | 3.3k | 5/8/2026 |
| Apache Nutch | Crawler phân tán bằng Java | Nâng cao | Không | Crawling kiểu search và big data | 3.3k | 5/8/2026 |
| Selenium | Tự động hóa trình duyệt đa ngôn ngữ | Trung bình | Có | Luồng tương tác phức tạp và độ chân thực trình duyệt cao | 34.3k | 6/8/2026 |
| Playwright | Tự động hóa trình duyệt đa ngôn ngữ | Trung bình | Có | Website động hiện đại và scripting ổn định | 94.1k | 6/8/2026 |
| Puppeteer | Tự động hóa trình duyệt Node.js | Trung bình | Có | Tự động hóa và scraping ưu tiên Chrome | 95.4k | 6/8/2026 |
| Scrapling | Bộ công cụ stealth scraping Python | Trung bình | Có | Scraping bằng trình duyệt cho target nhạy cảm với anti-bot | 72.8k | 30/7/2026 |
| Katana | Go crawler / CLI | Trung bình | Tùy chọn headless | Crawling bảo mật và phát hiện URL | 17.3k | 5/8/2026 |
| Colly | Framework Go | Trung bình | Không | Scraping tĩnh hiệu năng cao | 25.4k | 18/6/2026 |
| WebMagic | Framework Java | Trung bình | Không hỗ trợ JS gốc | Pipeline scraping Java nói chung | 11.7k | 20/12/2025 |
| Nokogiri | Bộ phân tích cú pháp Ruby | Dễ | Không | Ứng dụng Ruby và quy trình parse tùy chỉnh | 6.3k | 3/8/2026 |
| Thunderbit | Tiện ích Chrome no-code dùng AI | Cắm là chạy | Có | Đội ngũ không kỹ thuật muốn có dữ liệu dùng được thật nhanh | N/A | Sản phẩm được quản lý, cập nhật liên tục |
Trước Khi Chọn Dự Án GitHub, Hãy Tự Hỏi Bạn Có Thực Sự Muốn Làm Việc Theo Quy Trình Code Không
Thunderbit không phải là một dự án GitHub, và chính điều đó lại khiến nó có mặt trong bài hướng dẫn quyết định này. Rất nhiều người tìm kiếm “best web scraping GitHub projects” thực ra không muốn duy trì cả một bộ crawler. Họ chỉ muốn có dữ liệu có cấu trúc từ một website đang hoạt động ngay hôm nay.
Thunderbit là lối thoát gọn nhất từ nghiên cứu scraping thiên về code sang thực thi sẵn sàng cho công việc:
- Phù hợp nhất cho: tìm kiếm khách hàng tiềm năng, theo dõi ecommerce, thu thập dữ liệu bất động sản, nghiên cứu tuyển dụng, và các tác vụ vận hành ưu tiên trình duyệt.
- Điểm nổi bật: gợi ý trường bằng AI, làm giàu dữ liệu từ trang con, xử lý trang động, và xuất sang Sheets, Airtable, Notion, CSV, JSON mà không cần viết logic scraping.
- Điểm cần lưu ý: nếu công việc của bạn là một nền tảng crawl nội bộ dài hạn với hạ tầng tùy biến, framework mã nguồn mở vẫn cho bạn nhiều quyền kiểm soát hơn.
Nếu bạn muốn xem hướng no-code trước khi quyết định đi hẳn vào GitHub, bài hướng dẫn Thunderbit hiện tại là cách kiểm chứng nhanh nhất:
Dùng thử Thunderbit AI Web Scraper miễn phí
Cách Tôi Đánh Giá Các Dự Án Scraping Trên GitHub Này
Không phải mọi dự án scraping trên GitHub đều có thể đem ra so sánh trực tiếp. Có dự án là framework đầy đủ. Có dự án là thư viện tự động hóa trình duyệt. Có dự án là parser. Có dự án lại là crawler ngách dành cho lưu trữ hoặc team bảo mật.
Để danh sách này thật sự hữu ích, tôi ưu tiên những dự án vẫn đạt bốn bộ lọc thực tế sau:
- Vẫn có giá trị thị trường thật.
Số sao cao thôi là chưa đủ, nhưng ít người dùng cộng với bảo trì cũ kỹ thường là tín hiệu xấu. - Vẫn có chuyển động dự án rõ ràng.
Với bản cập nhật này, tôi kiểm tra lại hoạt động commit-feed công khai vào ngày 6/8/2026 thay vì chỉ tin vào các con số tổng hợp cũ. - Giải quyết một bài toán scraping thực tế.
Tôi loại bỏ các repo tuy hay nhưng quá khó áp dụng, không khớp tốt với quy trình làm việc thực tế của doanh nghiệp hoặc nghiên cứu. - Đủ khác biệt để lọc shortlist.
Mục tiêu không phải liệt kê 50 repo. Mục tiêu là giúp bạn chọn giữa framework, bộ công cụ browser, công cụ open-source no-code, và crawler chuyên dụng.
Các chiều so sánh cũng chính là những yếu tố thường quyết định thành bại trong thực tế:
- Độ phức tạp khi thiết lập: người mới có thể chạy được một bản scrape hoạt động trong bao lâu.
- Hỗ trợ JavaScript: dự án có xử lý được các website render ở phía client hiện đại hay không.
- Sức khỏe dự án: repo còn đủ sống để tin cậy hay không.
- Xử lý dữ liệu: dự án có xuất ra dữ liệu có cấu trúc hay bắt bạn tự làm thêm nhiều bước.
- Mức độ phù hợp với người dùng: dự án đó thật sự dành cho người mới, kỹ sư dữ liệu, team bảo mật, hay người vận hành không kỹ thuật.
Độ Phức Tạp Khi Thiết Lập: Bạn Có Thể Bắt Đầu Nhanh Đến Mức Nào?
Phân loại mức thiết lập đó vẫn còn nguyên giá trị, nhưng cách nhìn hữu ích hơn trong năm 2026 là thế này:
- Cắm là chạy: Thunderbit cho người dùng doanh nghiệp; MechanicalSoup hoặc Nokogiri cho các script code-first nhẹ.
- Trung bình: Scrapy, Crawlee, Maxun, Selenium, Playwright, Puppeteer, Colly, Katana, Scrapling, WebMagic, và Node Crawler đều cần một chút code, CLI, hoặc công đoạn triển khai.
- Nâng cao: Heritrix và Apache Nutch chỉ thật sự hợp lý nếu bạn thật sự cần crawling lưu trữ hoặc crawling phân tán dựa trên Java.
Maxun xứng đáng được nhắc riêng ở đây vì nó nằm giữa hai thế giới. Bản thân nền tảng cần triển khai, nhưng trải nghiệm của người dùng cuối nhẹ hơn nhiều so với việc làm việc trực tiếp với Scrapy hoặc Playwright.
Hỗ Trợ Nội Dung Động: Dự Án Nào Xử Lý Được Web Hiện Đại?
Website hiện đại đầy React, Vue, infinite scroll, các API chạy ngầm, và luồng đăng nhập phức tạp. Đây là ranh giới phân biệt giữa “tôi lấy được HTML” và “tôi lấy được đúng dữ liệu mình cần.”
Các dự án trong danh sách này chia thành ba nhóm:
- Tự động hóa trình duyệt đầy đủ: Selenium, Playwright, và Puppeteer thực thi JavaScript trọn vẹn và vẫn là lựa chọn đáng tin nhất cho các website nhiều tương tác.
- Hỗ trợ lai hoặc dạng wrapper: Crawlee có thể chuyển đổi giữa crawling HTTP nhẹ và scraping có trình duyệt. Scrapling bổ sung các công cụ thiên về stealth cho những mục tiêu khó hơn. Maxun dùng cách tiếp cận dựa trên trình duyệt phía sau giao diện trực quan.
- Mặc định chỉ xử lý HTML tĩnh: Scrapy, MechanicalSoup, Node Crawler, Colly, WebMagic, Nokogiri, Heritrix, và Apache Nutch tự thân không giải quyết vấn đề render hiện đại một cách gốc.
Nếu băn khoăn lớn nhất của bạn là “stack này có xử lý được trang nặng JavaScript mà tôi không phải tự viết từng bước trình duyệt không?”, bài hướng dẫn scraping bằng Playwright hiện tại là phép kiểm chứng thực tế tốt nhất ở phần giữa bài này:
Sức Khỏe Dự Án: Repo Nào Vẫn Đáng Tin Trong Năm 2026?
Phiên bản 2025 của bài viết này dựa khá nhiều vào số sao và vài ghi chú cập nhật đã cũ. Giờ thì như vậy là chưa đủ nữa. Tôi đã kiểm tra cả số sao hiện tại lẫn tín hiệu commit gần đây vào ngày 6/8/2026.
Bức tranh lành mạnh trông như sau:
- Rõ ràng đang hoạt động mạnh: Scrapy, Crawlee, Maxun, MechanicalSoup, Heritrix, Apache Nutch, Selenium, Playwright, Puppeteer, Scrapling, Katana, và Nokogiri đều có commit công khai trong vòng hai tuần trước thời điểm kiểm tra này.
- Vẫn sống nhưng chậm hơn: Colly và Node Crawler đều có lần commit gần nhất vào ngày 18/6/2026. Chúng vẫn dùng được, nhưng cập nhật theo từng đợt thay vì đều đặn hàng tuần như Playwright hay Crawlee.
- Cần thận trọng hơn: WebMagic là khoảng trống thực sự duy nhất trong danh sách này. Tín hiệu commit công khai gần nhất mà tôi kiểm tra được là 20/12/2025, nên tôi sẽ xem nó là ổn định hơn là đang tiến hóa mạnh.
Điều đó rất quan trọng vì kiểu bảo trì nên ảnh hưởng đến shortlist của bạn:
- Nếu bạn muốn một lựa chọn an toàn cho dự án kỹ thuật mới, hãy ưu tiên các repo đang hoạt động rõ ràng hơn.
- Nếu công cụ đơn giản và use case của bạn hẹp, dự án chậm hơn vẫn chấp nhận được.
- Nếu dự án mang tính chuyên biệt, hãy đánh giá theo độ phù hợp trước, không phải chỉ theo việc nó có phát hành hằng tuần hay không.
15 Dự Án Web Scraping GitHub Tốt Nhất Năm 2026
Framework cho Scraping Quy Mô Lớn Hoặc Mục Đích Chung
1. Scrapy
Scrapy vẫn là câu trả lời Python mặc định khi công việc lớn hơn một script nhanh. Nếu bạn cần spider, pipeline, middleware, throttling, retries, và một hệ sinh thái trưởng thành, đây vẫn là lựa chọn open-source an toàn nhất trong danh sách này.
- Thiết lập: Trung bình
- Phù hợp nhất cho: danh mục ecommerce, scraping thư mục, crawling tin tức, và các hệ thống scraping nội bộ dài hạn
- Hỗ trợ JS: Không render gốc; có thể ghép với Playwright hoặc Selenium khi cần
- Vì sao nên chọn: kiến trúc trưởng thành, tài liệu mạnh, và một trong những tỷ lệ sức mạnh/cộng đồng tốt nhất trong mảng open-source scraping
- Điểm cần lưu ý: độ dốc học tập khá rõ nếu bạn chưa từng làm việc bên trong một crawler framework
Nếu bạn muốn tự đánh giá xem con đường Scrapy có hợp với mình không trước khi cam kết, bài hướng dẫn cho người mới này vẫn rất hữu ích:
2. Crawlee
Crawlee đã trở thành lựa chọn framework JavaScript hoặc TypeScript hấp dẫn nhất khi bạn muốn một dự án có thể bao phủ cả crawling nhẹ lẫn scraping dựa trên trình duyệt. Khả năng chuyển đổi giữa luồng ưu tiên HTTP và luồng chạy bằng Playwright hoặc Puppeteer là lợi thế rất thật.
- Thiết lập: Trung bình
- Phù hợp nhất cho: team JS và TS, target lai giữa tĩnh và động, và các công cụ nội bộ nặng tự động hóa
- Hỗ trợ JS: Có
- Vì sao nên chọn: mô hình runtime linh hoạt, trợ thủ chống chặn, và trải nghiệm browser tốt hơn nhiều stack crawler cũ chỉ dùng crawler
- Điểm cần lưu ý: hợp lý nhất khi team của bạn đã quen với Node.js
3. Colly
Colly vẫn là một trong những lựa chọn Go gọn gàng và hiệu năng cao nhất cho các team không cần render bằng trình duyệt theo mặc định. Nó nhanh, thanh lịch, và thực dụng khi nút thắt là khối lượng chứ không phải độ phức tạp giao diện.
- Thiết lập: Trung bình
- Phù hợp nhất cho: lập trình viên Go xây crawler tĩnh tốc độ cao
- Hỗ trợ JS: Không render gốc
- Vì sao nên chọn: kiểm soát đồng thời, rate limiting, và API dễ chịu cho tác vụ lưu lượng cao
- Điểm cần lưu ý: không phù hợp khi tự động hóa trình duyệt mới là yêu cầu thật sự
4. WebMagic
WebMagic vẫn là phiên bản tương đương cho Java của những team thích mô hình Scrapy nhưng muốn ở trong hệ sinh thái JVM. Nó vẫn có lý cho các shop Java, dù độ phổ biến xung quanh không lớn bằng các lựa chọn Python hay Node.
- Thiết lập: Trung bình
- Phù hợp nhất cho: pipeline scraping dựa trên Java
- Hỗ trợ JS: Không render gốc
- Vì sao nên chọn: scheduler, pipeline, và cấu trúc framework khá thẳng thắn
- Điểm cần lưu ý: hệ sinh thái yên tĩnh hơn các lựa chọn Python và Node lớn hơn, và tín hiệu commit công khai mới nhất tôi tìm được là 20/12/2025, nên hãy xem nó là ổn định hơn là đang phát triển mạnh
5. Nokogiri
Nokogiri không phải framework crawler. Nó là bộ parser mà lập trình viên Ruby vẫn dùng khi cần xử lý HTML hoặc XML gọn gàng trong một script tùy biến hay luồng ứng dụng.
- Thiết lập: Dễ
- Phù hợp nhất cho: ứng dụng Ruby và Rails cần parse thay vì một framework crawler đầy đủ
- Hỗ trợ JS: Không
- Vì sao nên chọn: nhanh, ổn định, và mặc định an toàn khi phân tích cú pháp
- Điểm cần lưu ý: bạn vẫn phải tự lo lớp HTTP, session, hoặc trình duyệt
Dự Án Nhẹ, Tĩnh, Và Thân Thiện Với Người Mới
6. Maxun
Maxun là câu trả lời mã nguồn mở cho những ai thích ý tưởng scraping no-code nhưng vẫn muốn self-host và có quyền kiểm soát kiểu GitHub. Nó dễ tiếp cận với người không phải lập trình viên hơn một framework thuần túy, nhưng vẫn là một dự án open-source đúng nghĩa chứ không phải SaaS đóng.
- Thiết lập: Trung bình khi triển khai, dễ hơn cho người dùng cuối sau khi đã cài xong
- Phù hợp nhất cho: team muốn giao diện trực quan nhưng vẫn kiểm soát theo kiểu open-source
- Hỗ trợ JS: Có
- Vì sao nên chọn: trích xuất bằng thao tác point-and-click, luồng nhiều bước, và dễ tiếp cận hơn nhiều so với việc viết code từ đầu
- Điểm cần lưu ý: bước triển khai vẫn nặng hơn một tiện ích trình duyệt được quản lý hoàn toàn
7. MechanicalSoup
MechanicalSoup vẫn xứng đáng có mặt ở đây vì không phải mọi tác vụ scrape đều cần headless browser. Nếu vấn đề thực sự là xử lý session, gửi form, hoặc đi qua một luồng tĩnh phía sau đăng nhập, nó vẫn nhỏ gọn và dễ hiểu một cách dễ chịu.
- Thiết lập: Dễ
- Phù hợp nhất cho: form đơn giản, trang tĩnh có bảo vệ đăng nhập, và script tự động hóa Python nhanh
- Hỗ trợ JS: Không
- Vì sao nên chọn: ít ma sát, code dễ đọc, và là lối vào nhẹ nhàng cho người dùng Python
- Điểm cần lưu ý: nhanh chóng mất tác dụng trên các site nặng JS
8. Node Crawler
Node Crawler vẫn có chỗ đứng nếu mục tiêu của bạn là HTML tĩnh và bạn chủ yếu quan tâm đến concurrency, hàng đợi, và parsing kiểu Cheerio. Tôi sẽ không chọn nó cho một dự án browser-heavy mới, nhưng nó vẫn có thể là lựa chọn ổn cho việc gom dữ liệu kiểu feed và site tĩnh.
- Thiết lập: Trung bình
- Phù hợp nhất cho: crawling và gom dữ liệu tĩnh tốc độ cao
- Hỗ trợ JS: Không
- Vì sao nên chọn: kiểm soát đồng thời và quy trình parse quen thuộc giống jQuery
- Điểm cần lưu ý: tín hiệu commit công khai mới nhất tôi tìm được là 18/6/2026, và khoảng cách giữa các lần cập nhật khá dài, nên tôi sẽ không chọn nó làm điểm khởi đầu cho một stack site động dài hạn mới
Dự Án Dành Cho Website Động Và Tự Động Hóa Trình Duyệt
9. Selenium
Selenium cũ hơn Playwright, nhưng vẫn rất đáng giá khi hành vi trình duyệt chính xác và độ chân thực của tương tác quan trọng hơn sự gọn gàng. Nó đặc biệt hữu ích ở nơi scraping giao thoa với QA, tự động hóa regression, hoặc các website yêu cầu hành vi trình duyệt rất “nguyên bản”.
- Thiết lập: Trung bình
- Phù hợp nhất cho: luồng nhiều tương tác, tự động hóa trình duyệt legacy, và team đã dùng Selenium để test
- Hỗ trợ JS: Có
- Vì sao nên chọn: hỗ trợ trình duyệt rộng, hệ sinh thái rất lớn, và độ trưởng thành lâu năm
- Điểm cần lưu ý: các bộ tự động hóa mới thường sạch và nhanh hơn cho công việc scraping từ đầu
10. Playwright
Playwright là khuyến nghị hiện đại mặc định của tôi cho các team phát triển cần scraping trang động. Sự kết hợp giữa hỗ trợ đa trình duyệt, cơ chế chờ tốt, và API sạch khiến nó là dự án tự động hóa trình duyệt dễ đề xuất nhất trong danh sách này.
- Thiết lập: Trung bình
- Phù hợp nhất cho: ứng dụng web hiện đại, luồng đăng nhập, và target nặng JavaScript
- Hỗ trợ JS: Có
- Vì sao nên chọn: điều khiển đa trình duyệt, primitive tự động hóa mạnh, và bảo trì tích cực
- Điểm cần lưu ý: bạn vẫn phải tự lo selector, hạ tầng trình duyệt, retry, và chất lượng đầu ra
11. Puppeteer
Puppeteer vẫn là lựa chọn kinh điển ưu tiên Chrome. Nếu team của bạn đã dùng Node.js và chủ yếu nhắm vào luồng tương thích Chromium, đây vẫn là một lựa chọn thực dụng và rất quen thuộc.
- Thiết lập: Trung bình
- Phù hợp nhất cho: tự động hóa thiên về Chrome, chụp màn hình, PDF, và trích xuất nội dung động
- Hỗ trợ JS: Có
- Vì sao nên chọn: khả năng điều khiển trình duyệt phong phú và vô số ví dụ từ cộng đồng
- Điểm cần lưu ý: Playwright đã trở thành lựa chọn mặc định mạnh hơn nếu bạn muốn phủ trình duyệt rộng hơn hoặc câu chuyện cross-browser hiện đại hơn
12. Scrapling
Scrapling là cái tên hiện đại chuyên biệt nhất trong nhóm này. Nó dành cho những người đã biết rõ rằng render bằng trình duyệt không phải là vấn đề duy nhất. Họ còn cần stealth, nhận biết proxy, và tư thế chống bot tốt hơn.
- Thiết lập: Trung bình
- Phù hợp nhất cho: stealth scraping, target nhạy cảm với anti-bot, và công việc site động ưu tiên Python
- Hỗ trợ JS: Có
- Vì sao nên chọn: phát triển tích cực và tập trung hơn vào những ma sát scraping mà các framework đơn giản thường bỏ qua
- Điểm cần lưu ý: quá mức cần thiết cho site tĩnh thuần túy và kém thân thiện với người mới hơn MechanicalSoup hoặc Scrapy
Crawler Chuyên Dụng Cho Công Việc Nghiên Cứu, Bảo Mật, Và Hạ Tầng
13. Heritrix
Heritrix không phải scraper để so sánh sản phẩm. Đây là crawler lưu trữ được xây dựng cho các tổ chức coi trọng việc bảo tồn toàn bộ website và thu thập theo chuẩn lưu trữ.
- Thiết lập: Nâng cao
- Phù hợp nhất cho: kho lưu trữ, thư viện, và quy trình bảo tồn quy mô lớn
- Hỗ trợ JS: Không
- Vì sao nên chọn: nền tảng từ Internet Archive và quy trình lưu trữ hướng WARC
- Điểm cần lưu ý: không phải công cụ phù hợp cho việc scrape danh sách hay giá có mục tiêu
14. Apache Nutch
Apache Nutch vẫn hợp lý cho những team nghĩ theo hướng crawling phân tán, indexing, hoặc thu thập dữ liệu kiểu search thay vì scraping kinh doanh một lần.
- Thiết lập: Nâng cao
- Phù hợp nhất cho: crawling phân tán, bộ dữ liệu nghiên cứu, và thu thập kiểu công cụ tìm kiếm
- Hỗ trợ JS: Không
- Vì sao nên chọn: mô hình plugin và sự quen thuộc theo kiểu doanh nghiệp của Apache
- Điểm cần lưu ý: quá nặng đối với hầu hết các công việc ưu tiên spreadsheet hoặc ưu tiên trình duyệt
15. Katana
Katana xuất hiện ở đây vì crawling bảo mật là một bài toán riêng. Nếu công việc là trinh sát, phát hiện endpoint, hoặc nhanh chóng phơi bày cấu trúc của một target, Katana phù hợp hơn nhiều so với một framework scraping mục đích chung.
- Thiết lập: Trung bình
- Phù hợp nhất cho: trinh sát bảo mật, phát hiện liên kết, và tạo danh mục URL
- Hỗ trợ JS: Chế độ headless tùy chọn
- Vì sao nên chọn: tốc độ, concurrency, và mô hình crawling tập trung vào bảo mật
- Điểm cần lưu ý: không được thiết kế như một bộ trích xuất dữ liệu doanh nghiệp hoàn chỉnh
Danh Sách Rút Gọn Theo Loại Đội Ngũ
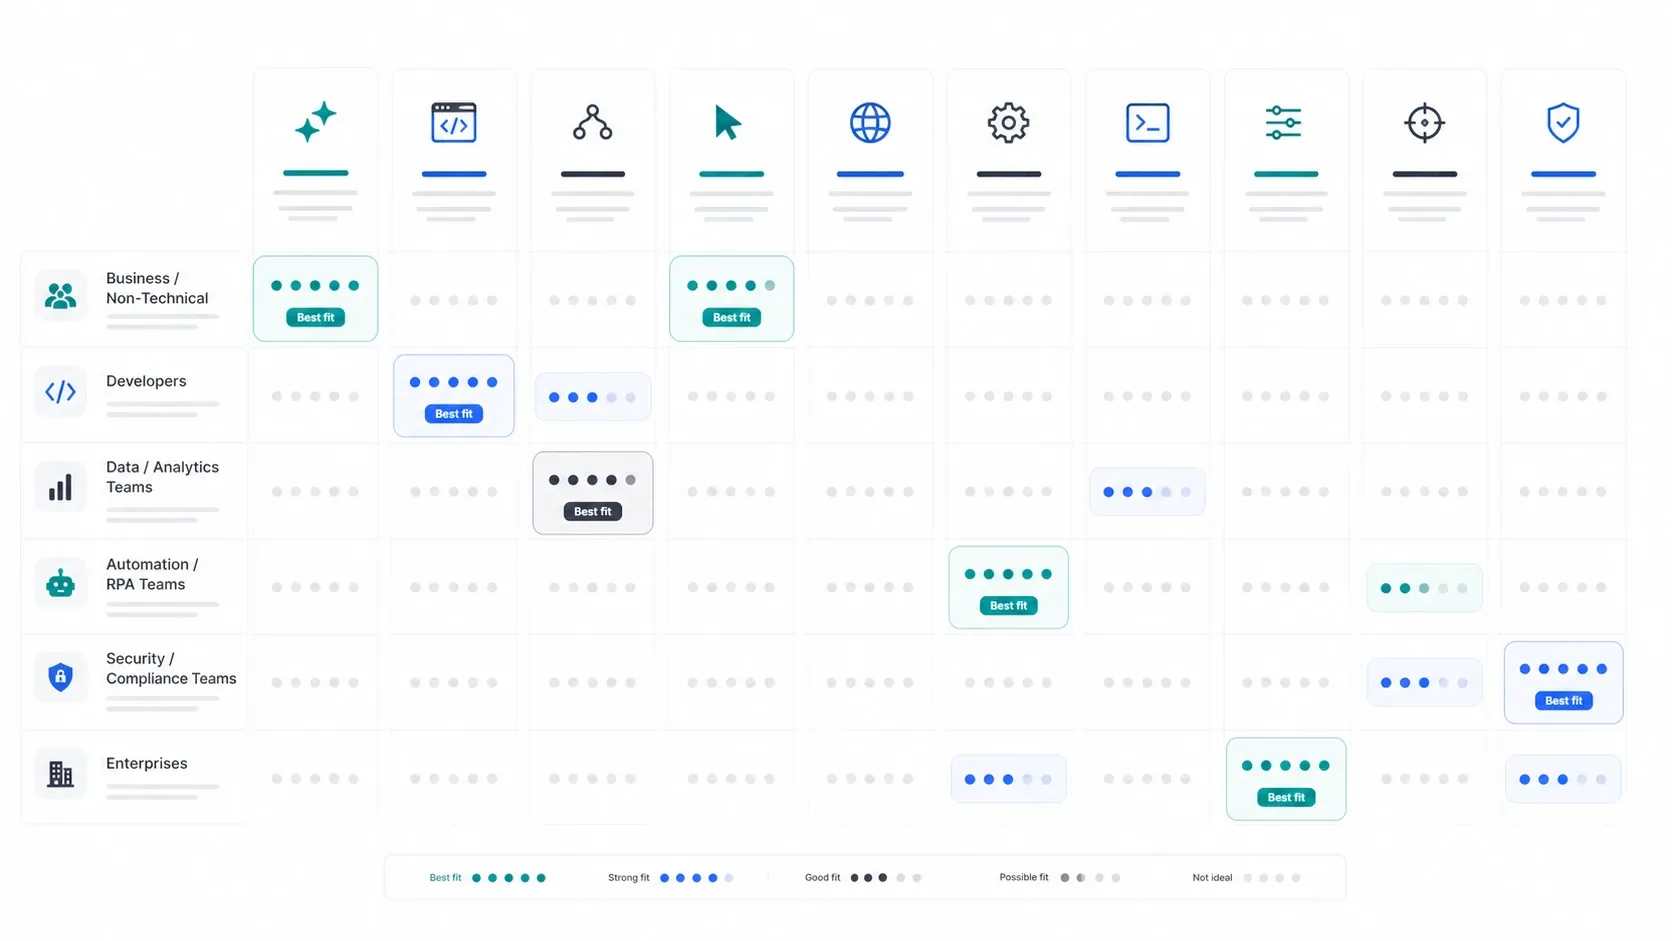
- Lập trình viên Python: bắt đầu với Scrapy cho framework, MechanicalSoup cho các luồng tĩnh nhỏ hơn, và Scrapling nếu stealth hoặc anti-bot đã là một phần của vấn đề.
- Đội JavaScript hoặc TypeScript: bắt đầu với Crawlee cho framework, Playwright cho tự động hóa trình duyệt, và Puppeteer nếu workflow ưu tiên Chrome là đủ.
- Đội Go: Colly cho scraping, Katana cho crawling bảo mật nặng discovery.
- Đội Java: WebMagic cho crawling tổng quát, Heritrix cho lưu trữ, Apache Nutch cho crawling phân tán kiểu search.
- Người vận hành không kỹ thuật: Maxun nếu bạn muốn self-host mã nguồn mở, hoặc Thunderbit nếu bạn muốn quy trình no-code được quản lý và cho ra kết quả dùng được nhanh hơn.
Thực Ra Hầu Hết Mọi Người Nên Bắt Đầu Với Dự Án Nào?
Câu trả lời thực dụng là:
- Nếu bạn muốn xây và sở hữu một scraper, hãy bắt đầu với Scrapy hoặc Crawlee.
- Nếu bạn cần điều khiển một trình duyệt thật, hãy bắt đầu với Playwright.
- Nếu bạn cần một lớp trực quan, mã nguồn mở, hãy bắt đầu với Maxun.
- Nếu bạn cần crawling chuyên biệt cho lưu trữ hoặc bảo mật, chỉ chọn Heritrix, Nutch, hoặc Katana khi use case của bạn thực sự đòi hỏi chúng.
- Nếu bạn muốn bỏ qua code và có dữ liệu ngay, đừng ép mình phải vào GitHub trước. Hãy dùng Thunderbit.
Kết Luận Cuối Cùng
Dự án web scraping GitHub tốt nhất trong năm 2026 phụ thuộc ít hơn vào số sao thô, mà nhiều hơn vào gánh nặng nào bạn sẵn sàng tự gánh. Scrapy vẫn là mặc định an toàn nhất cho framework Python. Crawlee là lựa chọn framework JavaScript hiện đại tốt nhất. Playwright là mặc định mạnh nhất cho tự động hóa trình duyệt. Maxun là con đường no-code mã nguồn mở thú vị nhất. Heritrix, Apache Nutch, và Katana là các công cụ chuyên biệt, rất xuất sắc chỉ khi bài toán của bạn cũng chuyên biệt.
Điều quan trọng là đừng nhầm giữa “mạnh nhất” và “phù hợp nhất”. Nếu team của bạn chỉ cần dữ liệu sạch trong bảng tính, GitHub có thể không phải điểm khởi đầu đúng ngay từ đầu.
Bỏ qua gánh nặng bảo trì và bắt đầu scraping nhanh hơn Get Started Free



