
Dự án scraping đầu tiên của tôi là một script Python tự viết, một proxy dùng chung và… cầu nguyện. Cứ ba ngày là nó lại hỏng.
Đến năm 2026, phần khó không còn là lấy được một trang web nữa. Vấn đề là chọn đúng workflow có thể hiển thị các website hiện đại, trả về đúng định dạng hệ thống cần, chịu được thay đổi giao diện, và mở rộng quy mô mà không biến mỗi lần website đổi layout thành một ticket kỹ thuật.
Workflow đó có thể là ứng dụng no-code, API scraping, code tùy chỉnh hoặc dịch vụ quản lý trọn gói. Lựa chọn đúng phụ thuộc vào ai sẽ vận hành, dữ liệu đầu ra cần đi đâu, và đội ngũ của bạn muốn kiểm soát hay gánh bao nhiêu phần bảo trì.
Dưới đây là 11 API và nền tảng scraping mà tôi đã dùng hoặc đánh giá — mỗi công cụ mạnh ở điểm nào, yếu ở đâu, và phù hợp với kiểu đội nhóm nào.
Quyết Định Scraping Năm 2026: Giao Diện, API, Code Hay Dịch Vụ?
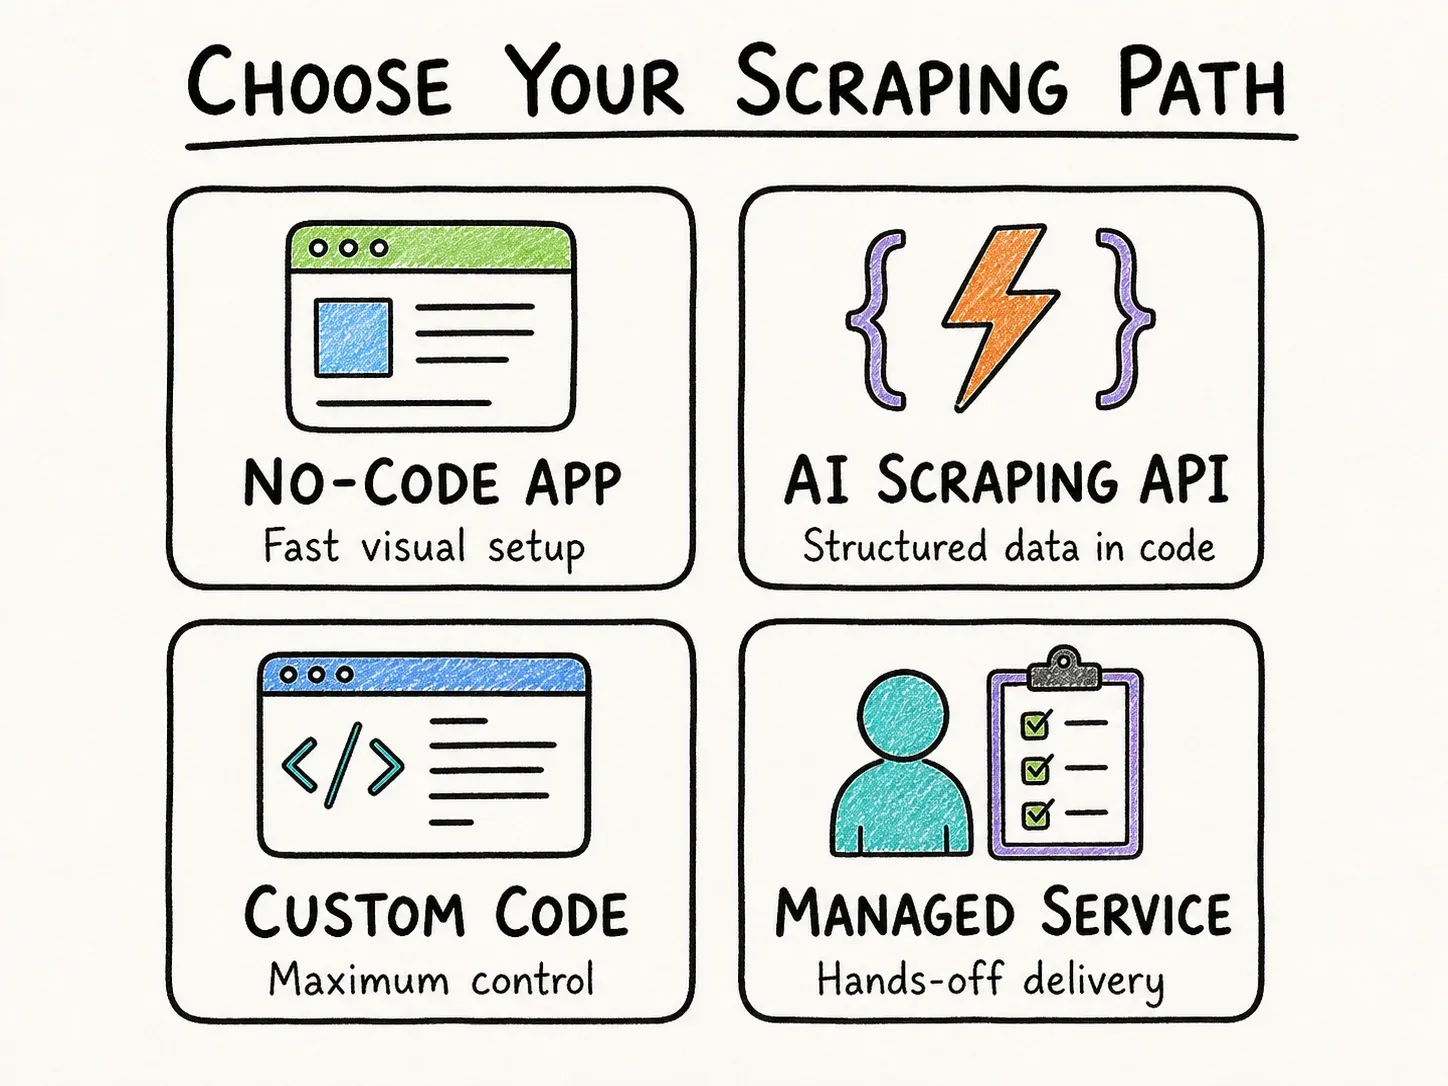
Trước khi so sánh nhà cung cấp, hãy xác định mô hình vận hành bạn thực sự cần:
- Ứng dụng no-code: Phù hợp nhất khi người dùng kinh doanh cần tự định nghĩa trường dữ liệu bằng giao diện, xem lại kết quả và xuất dữ liệu mà không phải duy trì code.
- AI scraping API: Phù hợp nhất khi sản phẩm, agent, pipeline RAG hoặc dịch vụ nội bộ cần nội dung web trực tiếp hoặc JSON theo cấu trúc schema.
- Custom code: Phù hợp nhất khi bạn cần kiểm soát ở mức trình duyệt, tương tác đặc thù hoặc hành vi hạ tầng mà API được quản lý không cung cấp.
- Dịch vụ quản lý trọn gói: Phù hợp nhất khi kết quả quan trọng hơn công cụ, và bạn muốn nhà cung cấp chịu trách nhiệm thiết lập, giám sát và bàn giao dữ liệu.
Các nhóm này ngày càng chồng lấn lên nhau. Một số nền tảng kết hợp giao diện trực quan với API cho nhà phát triển, trong khi số khác tập trung vào điều khiển proxy cấp thấp hoặc dịch vụ đầu-cuối được quản lý hoàn toàn. Danh sách dưới đây so sánh các sản phẩm theo workflow mà chúng hỗ trợ ở thời điểm hiện tại.
API Trích Xuất Dữ Liệu Là Gì?
Quay lại kiến thức cơ bản một chút nhé. Data scraping API là công cụ cho phép bạn trích xuất dữ liệu từ website theo cách lập trình — mà không cần tự xây scraper từ đầu. Có thể hiểu nó như một robot bạn gửi đi để lấy giá mới nhất, review hay danh sách sản phẩm, rồi mang dữ liệu về dưới dạng gọn gàng, có cấu trúc (thường là JSON hoặc CSV).
Chúng hoạt động thế nào? Phần lớn API scraping xử lý luôn các phần rườm rà như xoay proxy, giải CAPTCHA, render JavaScript — để bạn tập trung vào thứ mình thật sự cần: dữ liệu. Bạn gửi một request (thường kèm URL và vài tham số), rồi API trả lại nội dung sẵn sàng cho quy trình kinh doanh của bạn.
Lợi ích chính:
- Tốc độ: API có thể scrape hàng nghìn trang mỗi phút.
- Khả năng mở rộng: Cần theo dõi 10.000 sản phẩm? Không thành vấn đề.
- Tích hợp: Kết nối vào CRM, BI tool hoặc data warehouse gần như không tốn công.
Nhưng như bạn sẽ thấy, không phải API nào cũng giống nhau — và cũng không phải cái nào đúng như lời quảng cáo “thiết lập một lần, dùng mãi mãi”.
Tôi Đánh Giá Những API Này Như Thế Nào
Tôi đã có khá nhiều thời gian “lăn lộn” trong thực chiến — test, phá lỗi, và đôi khi vô tình DDoS chính server của mình (đừng nói với đội IT cũ nhé). Trong danh sách này, tôi tập trung vào:
- Độ tin cậy: Nó có thật sự chạy được không, kể cả trên những website khó nhằn?
- Tốc độ: Nó trả kết quả nhanh đến đâu khi chạy ở quy mô lớn?
- Giá cả: Có phù hợp với startup và vẫn mở rộng tốt cho enterprise không?
- Khả năng mở rộng: Có xử lý được hàng triệu request, hay mới 100 request đã gục?
- Thân thiện với developer: Tài liệu có rõ ràng không? Có SDK và code mẫu không?
- Hỗ trợ: Khi mọi thứ đi chệch hướng (và chắc chắn sẽ có lúc như vậy), có ai giúp không?
- Phản hồi người dùng: Review thực tế ngoài thị trường, chứ không chỉ là lời marketing bóng bẩy.
Tôi cũng dựa nhiều vào test trực tiếp, phân tích review và phản hồi từ cộng đồng Thunderbit (một nhóm khá “khó tính”).
11 Nền Tảng Đáng Cân Nhắc Trong Năm 2026
Sẵn sàng vào phần chính chưa? Đây là danh sách rút gọn hiện tại của tôi về các API và nền tảng web scraping dành cho người dùng doanh nghiệp và developer trong năm 2026.
1. Thunderbit
Tổng quan:
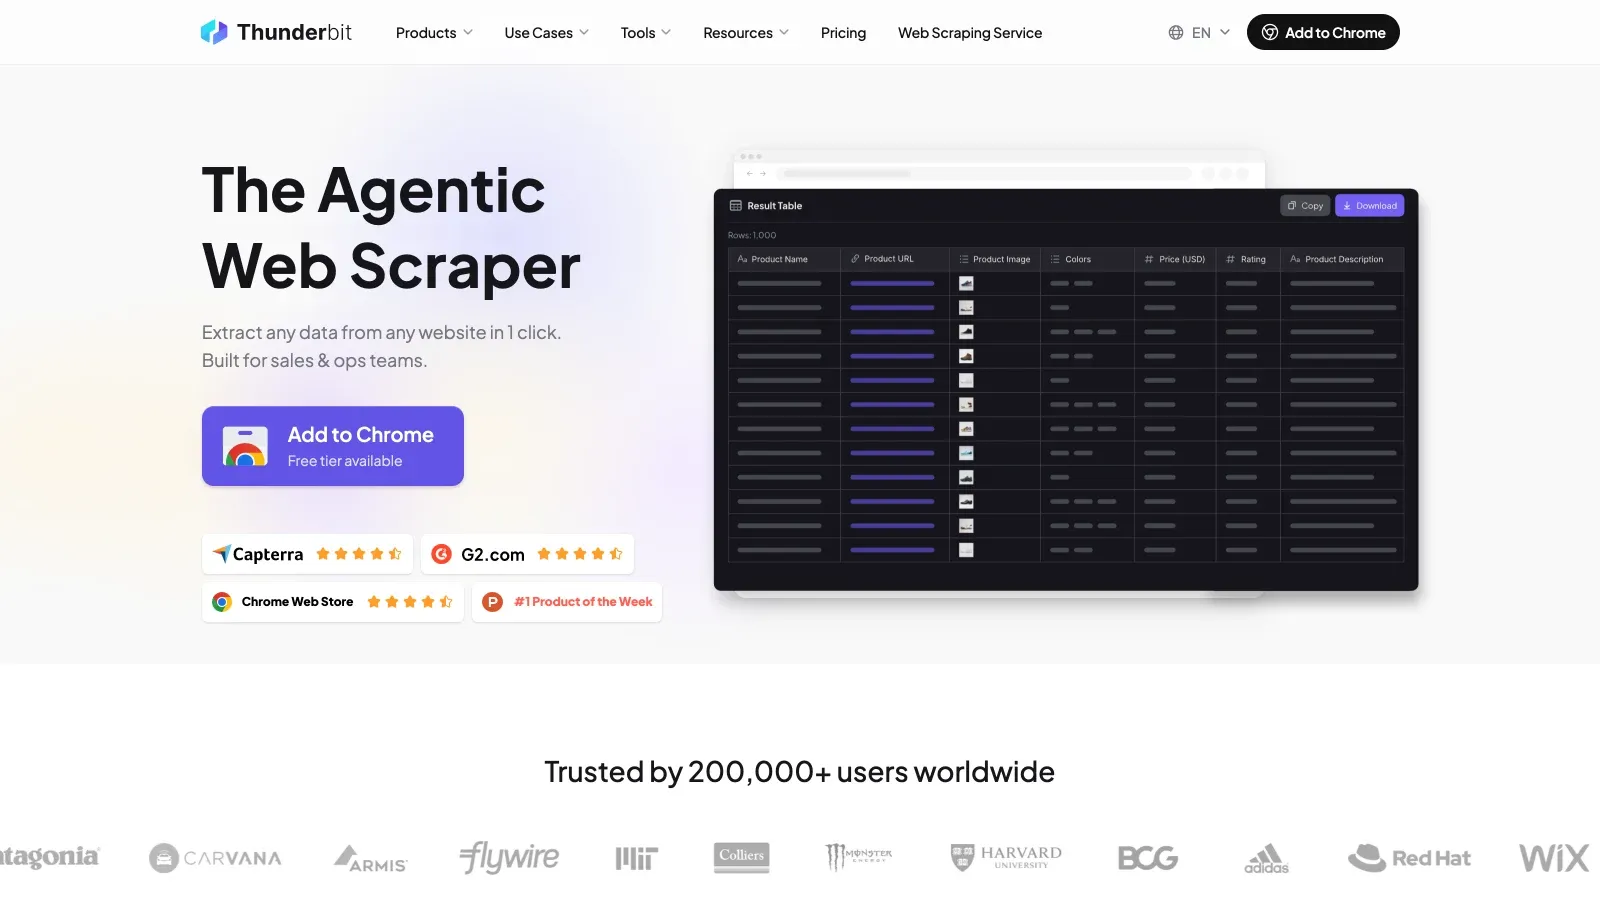
Thunderbit hiện cung cấp cả AI web scraper no-code lẫn Web Scraper API dành cho developer. Với người dùng API, hai endpoint cốt lõi tách riêng giữa truy xuất nội dung và trích xuất có cấu trúc: Distill biến một URL thành Markdown sạch, còn Extract dùng JSON Schema để trả về dữ liệu có cấu trúc đã được xác thực. Điều này khiến nó rất hữu ích cho nạp dữ liệu vào RAG, công cụ agent, làm giàu cơ sở dữ liệu, theo dõi giá và bộ dữ liệu đa nguồn.
Tính năng chính:
- Distill chuyển URL thành Markdown, hỗ trợ render JavaScript và tùy chọn lấy links, images, metadata, summaries, answers và highlights
- Extract trả về JSON theo schema, không cần CSS selector hay rule phân tích riêng cho từng website
- Hỗ trợ gọi đồng bộ cho từng trang và batch job bất đồng bộ; Batch Distill nhận tối đa 100 URL và Batch Extract tối đa 50 URL
- Xác thực bằng bearer key, trạng thái batch theo từng URL, xử lý lỗi có cơ chế retry, polling và webhook có ký số
- Có tài liệu cho CLI, SDK, MCP, automation và tích hợp agent cho các workflow kỹ thuật
Giá:
API có hạn mức miễn phí một lần là 600 units. Distill tốn 1 unit mỗi trang và Extract tốn 20 units mỗi trang. Gói Starter là $16/tháng nếu thanh toán theo năm, bao gồm 60.000 units/năm và 30 request đồng thời; gói Pro bắt đầu từ $40/tháng nếu thanh toán theo năm, bao gồm 600.000 units/năm và 50 request đồng thời. Hãy kiểm tra Thunderbit API pricing trước khi xuất bản vì giới hạn sử dụng và giá gói có thể thay đổi.
Phù hợp nhất cho:
Các đội nhóm muốn trích xuất bằng AI mà không phải duy trì selector, đặc biệt khi cùng một tổ chức cần cả workflow trực quan cho người vận hành lẫn API cho developer.
Điểm đánh đổi chính:
Thunderbit tối ưu cho việc trích xuất theo ý định và schema hơn là điều khiển proxy hay trình duyệt ở mức thấp. Nếu use case của bạn phụ thuộc vào việc tinh chỉnh từng phiên proxy hoặc viết script cho các tương tác trang đặc biệt, một API ưu tiên proxy hoặc stack tự động hóa trình duyệt tùy chỉnh có thể phù hợp hơn.
Khám phá Thunderbit Web Scraper API
2. Oxylabs
 Tổng quan:
Oxylabs là “ông lớn” trong lĩnh vực trích xuất dữ liệu web cấp enterprise. Với kho proxy khổng lồ và các API chuyên biệt từ SERP đến e-commerce, đây là lựa chọn quen thuộc của Fortune 500 và bất kỳ ai cần độ tin cậy ở quy mô lớn.
Tính năng chính:
- Mạng proxy cực lớn (residential, datacenter, mobile, ISP) tại hơn 195 quốc gia
- Scraper API với chống bot, giải CAPTCHA và render bằng headless browser
- Geo-targeting, giữ phiên làm việc và độ chính xác dữ liệu cao (tỷ lệ thành công 95%+)
- OxyCopilot: trợ lý AI tự sinh code phân tích và truy vấn API
Giá:
Bắt đầu từ khoảng $49/tháng cho một API đơn lẻ, $149/tháng cho gói all-in-one. Có dùng thử miễn phí 7 ngày với tối đa 5.000 request.
Phản hồi người dùng:
Thường xuyên được đánh giá cao trên G2 về độ tin cậy và hỗ trợ. Nhược điểm chính? Giá cao — nhưng đúng là “tiền nào của nấy”.
3. ScrapingBee
 Tổng quan:
ScrapingBee là “người bạn thân” của developer — đơn giản, dễ tiếp cận và tập trung vào đúng việc. Bạn gửi URL, nó xử lý headless Chrome, proxy và CAPTCHA, rồi trả về trang đã render hoặc đúng phần dữ liệu bạn cần.
Tính năng chính:
- Render bằng headless browser (hỗ trợ JavaScript)
- Tự động xoay IP và giải CAPTCHA
- Proxy pool ẩn danh cho các website khó
- Thiết lập tối giản — chỉ cần gọi API
Giá:
Có gói miễn phí với 1.000 API credits, không cần thẻ tín dụng. Gói trả phí bắt đầu từ $49/tháng (gói Freelance, 250.000 credits) theo scrapingbee.com/pricing.
Phản hồi người dùng:
Luôn được review tốt trên G2. Developer rất thích sự đơn giản; còn người không biết code có thể thấy nó hơi “tối giản quá mức”.
4. Apify
 Tổng quan:
Apify giống như con dao đa năng Thụy Sĩ của web scraping. Bạn có thể tự xây scraper (“Actors”) bằng JavaScript hoặc Python, hoặc dùng thư viện khổng lồ các actor dựng sẵn cho những website phổ biến. Nó linh hoạt đến mức nào là do bạn quyết định.
Tính năng chính:
- Scraper tùy chỉnh và dựng sẵn (Actors) cho gần như mọi website
- Bao gồm hạ tầng cloud, lên lịch chạy và quản lý proxy
- Xuất dữ liệu sang JSON, CSV, Excel, Google Sheets và nhiều định dạng khác
- Cộng đồng năng động và hỗ trợ qua Discord
Giá:
Có gói miễn phí kèm $5 credit nền tảng. Gói trả phí bắt đầu từ $29/tháng (Starter) cộng thêm phí theo mức sử dụng theo apify.com/pricing.
Phản hồi người dùng:
Được đánh giá tốt trên G2 và Capterra. Developer thích sự linh hoạt; người mới thì sẽ phải vượt qua một đường cong học tập khá rõ.
Xem Apify so với Thunderbit thế nào
5. Decodo (trước đây là Smartproxy)
 Tổng quan:
Decodo (thương hiệu mới của Smartproxy, hiện đã triển khai đầy đủ tại decodo.com) tập trung vào giá trị sử dụng và sự dễ dàng. Nó kết hợp mạng proxy lớn với các API scraping cho web tổng quát, SERP, e-commerce và mạng xã hội — tất cả trong một subscription; bộ Web Scraping API mới được làm lại còn đi kèm hơn 100 template dựng sẵn và AI Parser.
Tính năng chính:
- Một API thống nhất cho tất cả endpoint (không còn phải mua add-on riêng)
- Scraper chuyên biệt cho Google, Amazon, TikTok và nhiều nền tảng khác
- Dashboard thân thiện với playground và code generator
- Hỗ trợ live chat 24/7
Giá:
Bắt đầu khoảng $50/tháng cho 25.000 request. Dùng thử miễn phí 7 ngày với 1.000 request.
Phản hồi người dùng:
Được khen về “giá trị trên chi phí” và hỗ trợ phản hồi nhanh.
6. Octoparse
 Tổng quan:
Octoparse là nhà vô địch của no-code. Nếu bạn ghét code nhưng thích dữ liệu, ứng dụng desktop point-and-click này (kèm tính năng cloud) cho phép bạn tạo scraper bằng giao diện trực quan và chạy local hoặc trên cloud.
Tính năng chính:
- Trình dựng workflow trực quan — chỉ cần click để chọn các trường dữ liệu
- Trích xuất trên cloud, lập lịch và tự động xoay IP
- Template cho website phổ biến và marketplace cho scraper tùy chỉnh
- Octoparse AI: tích hợp RPA và ChatGPT để làm sạch dữ liệu và tự động hóa workflow
Giá:
Có gói miễn phí cho tối đa 10 tác vụ local. Gói trả phí bắt đầu từ $83/tháng, hoặc $69/tháng nếu thanh toán theo năm (tính năng cloud, tác vụ không giới hạn). Có dùng thử 14 ngày cho tính năng cao cấp.
Phản hồi người dùng:
4.4/5 trên G2. Được người không biết code rất thích, nhưng người dùng nâng cao có thể chạm trần giới hạn.
7. Bright Data
 Tổng quan:
Bright Data là “trùm cuối” — nếu bạn cần quy mô, tốc độ và gần như mọi tính năng có thể nghĩ tới, đây là nền tảng dành cho bạn. Với mạng proxy lớn nhất thế giới và một scraping IDE mạnh mẽ, nó được xây cho enterprise.
Tính năng chính:
- 400M+ IP (residential, mobile, ISP, datacenter)
- Web Scraper IDE, bộ thu thập dữ liệu dựng sẵn và data set có thể mua ngay
- Chống bot nâng cao, giải CAPTCHA và hỗ trợ headless browser
- Tập trung vào compliance và pháp lý (sáng kiến Ethical Web Data)
Giá:
Mô hình pay-as-you-go cho Web Scraper API là $1.50 cho mỗi 1.000 bản ghi; gói Scale là $499/tháng gồm 384.000 bản ghi và $1.30 cho mỗi 1.000 bản ghi vượt mức. Bạn chỉ trả cho các bản ghi được giao thành công. Có gói miễn phí 5.000 bản ghi/tháng mà không cần thẻ tín dụng. Các sản phẩm proxy được bán riêng theo GB. Xem brightdata.com/pricing/web-scraper để biết số liệu mới nhất.
Phản hồi người dùng:
Được khen về hiệu năng và tính năng, nhưng giá và độ phức tạp có thể là rào cản với đội nhóm nhỏ.
Xem các giải pháp của Bright Data
8. WebAutomation
 Tổng quan:
WebAutomation là nền tảng cloud được thiết kế cho người không phải developer. Với marketplace các extractor dựng sẵn và trình xây dựng no-code, nó rất hợp cho người dùng doanh nghiệp muốn dữ liệu, không muốn code.
Tính năng chính:
- Extractor dựng sẵn cho các website phổ biến (Amazon, Zillow, v.v.)
- Trình xây extractor no-code với giao diện point-and-click
- Bao gồm lịch chạy cloud, giao dữ liệu và bảo trì
- Mô hình giá theo số dòng (trả theo lượng dữ liệu bạn trích xuất)
Giá:
Gói Project từ $74/tháng (~400k dòng/năm), pay-as-you-go $1 cho mỗi 1.000 dòng. Dùng thử miễn phí 14 ngày với 10 triệu credits.
Phản hồi người dùng:
Người dùng thích sự dễ dùng và mức giá minh bạch. Hỗ trợ hữu ích, còn việc bảo trì thì đội ngũ lo hết.
9. ScrapeHero
 Tổng quan:
ScrapeHero khởi đầu là một đơn vị tư vấn scraping tùy chỉnh, và giờ đã có thêm nền tảng cloud tự phục vụ. Bạn có thể dùng scraper dựng sẵn cho các website phổ biến hoặc yêu cầu dịch vụ quản lý toàn phần.
Tính năng chính:
- ScrapeHero Cloud: scraper dựng sẵn cho Amazon, Google Maps, LinkedIn và nhiều website khác
- Vận hành no-code, lên lịch và giao dữ liệu trên cloud
- Giải pháp tùy chỉnh cho nhu cầu đặc thù
- Có API để tích hợp theo chương trình
Giá:
Gói cloud bắt đầu thấp tới $5/tháng. Dự án tùy chỉnh từ $550 cho mỗi website (một lần).
Phản hồi người dùng:
Được khen về độ tin cậy, chất lượng dữ liệu và hỗ trợ. Rất phù hợp khi bạn muốn đi từ tự làm sang giải pháp được quản lý.
10. Sequentum
 Tổng quan:
Sequentum là “con dao đa năng” cho enterprise — được xây cho compliance, khả năng audit và quy mô lớn. Nếu bạn cần chứng nhận SOC-2, audit trail và cộng tác nhóm, đây là công cụ dành cho bạn.
Tính năng chính:
- Trình thiết kế agent low-code (point-and-click kết hợp scripting)
- Triển khai cloud SaaS hoặc on-premise
- Quản lý proxy tích hợp, giải CAPTCHA và headless browser
- Audit trail, phân quyền theo vai trò và tuân thủ SOC-2
Giá:
Pay-as-you-go ($6/giờ runtime, $0.25/GB xuất dữ liệu), gói Starter $199/tháng. Có $5 credit miễn phí khi đăng ký.
Phản hồi người dùng:
Doanh nghiệp rất thích các tính năng compliance và khả năng mở rộng. Có đường cong học tập, nhưng hỗ trợ và đào tạo thì thuộc hàng rất tốt.
11. Grepsr
 Tổng quan:
Grepsr là dịch vụ trích xuất dữ liệu được quản lý trọn gói — bạn chỉ cần nói mình cần gì, họ sẽ xây, chạy và duy trì scraper cho bạn. Rất phù hợp cho doanh nghiệp muốn có dữ liệu mà không muốn đau đầu kỹ thuật.
Tính năng chính:
- Trích xuất được quản lý (“Grepsr Concierge”) — họ thiết lập và duy trì mọi thứ
- Dashboard cloud để lên lịch, giám sát và tải dữ liệu
- Nhiều định dạng đầu ra và tích hợp (Dropbox, S3, Google Drive)
- Tính phí theo từng bản ghi dữ liệu, không phải theo request
Giá:
Gói Starter $350 (trích xuất một lần), các gói thuê bao định kỳ sẽ báo giá riêng.
Phản hồi người dùng:
Khách hàng thích trải nghiệm “không phải động tay” và hỗ trợ phản hồi nhanh. Rất hợp với đội nhóm không thiên về kỹ thuật và những ai coi trọng thời gian hơn việc mày mò.
Bảng So Sánh Nhanh: Các API Web Scraping Hàng Đầu
Đây là bảng tóm tắt cho cả 11 nền tảng:
| Nền tảng | Loại dữ liệu hỗ trợ | Giá khởi điểm | Dùng thử miễn phí | Mức độ dễ dùng | Hỗ trợ | Tính năng nổi bật |
|---|---|---|---|---|---|---|
| Thunderbit | Trang web, Markdown, JSON có cấu trúc | Miễn phí / $16/tháng thanh toán theo năm | 600 units một lần | API + no-code | Cơ bản/ưu tiên theo gói | Distill, trích xuất JSON Schema, batch job, webhook |
| Oxylabs | Web, SERP, e-commerce, bất động sản | $49/tháng | 7 ngày/5k request | Thiên về developer | 24/7, enterprise | OxyCopilot AI, proxy pool khổng lồ, geo-targeting |
| ScrapingBee | Web tổng quát, JS, CAPTCHA | $49/tháng | 1k credits | API đơn giản | Email, forum | Headless Chrome, proxy ẩn danh |
| Apify | Mọi loại web, dựng sẵn/tùy chỉnh | Miễn phí/$29/tháng + usage | Mãi mãi miễn phí | Linh hoạt, phức tạp | Cộng đồng, Discord | Marketplace Actor, hạ tầng cloud, tích hợp |
| Decodo | Web, SERP, e-commerce, social | $50/tháng | 7 ngày/1k request | Thân thiện với người dùng | Live chat 24/7 | API thống nhất, playground code, giá trị tốt |
| Octoparse | Mọi loại web, no-code | Miễn phí/$69/tháng | 14 ngày | Trực quan, no-code | Email, forum | Giao diện point-and-click, cloud, Octoparse AI |
| Bright Data | Mọi loại web, datasets | $1.50/1k records | 5K bản ghi/tháng | Mạnh, phức tạp | 24/7, enterprise | Mạng proxy lớn nhất, IDE, data set dựng sẵn |
| WebAutomation | Dữ liệu có cấu trúc, e-commerce, bất động sản | $74/tháng | 14 ngày/10M dòng | No-code, template | Email, chat | Extractor dựng sẵn, giá theo số dòng |
| ScrapeHero | E-commerce, bản đồ, việc làm, tùy chỉnh | $5/tháng | Có | No-code, được quản lý | Email, ticket | Cloud scraper, dự án tùy chỉnh, giao qua Dropbox |
| Sequentum | Mọi loại web, enterprise | $0/$199/tháng | $5 credit | Low-code, trực quan | Hỗ trợ chuyên sâu | Audit trail, SOC-2, on-prem/cloud |
| Grepsr | Mọi dữ liệu có cấu trúc, được quản lý | $350 một lần | Chạy mẫu | Được quản lý toàn phần | Chuyên viên phụ trách riêng | Thiết lập concierge, trả theo dữ liệu, tích hợp |
Chọn Công Cụ Web Scraping Phù Hợp Cho Doanh Nghiệp
Vậy nên chọn công cụ nào? Đây là cách tôi thường chia cho các đội nhóm mà tôi tư vấn:
-
Nếu bạn muốn không cần code, triển khai nhanh và trích xuất trường dữ liệu bằng AI:
Hãy dùng Thunderbit AI Web Scraper khi người vận hành cần định nghĩa, xem lại và xuất dữ liệu bằng giao diện trực quan. Octoparse và WebAutomation cũng rất đáng thử nếu bạn thích workflow trực quan truyền thống hoặc marketplace các extractor dựng sẵn.
-
Nếu bạn cần nội dung web sạch hoặc JSON có cấu trúc trong một sản phẩm hay agent:
Hãy bắt đầu với Thunderbit Web Scraper API khi bạn ưu tiên trích xuất theo schema và giảm tối đa công bảo trì selector. ScrapingBee là API render khá dễ tiếp cận; Apify là nền tảng lập trình linh hoạt hơn; còn Oxylabs và Bright Data mang lại hạ tầng proxy và enterprise sâu hơn.
-
Nếu bạn cần kiểm soát trình duyệt hoặc proxy ở mức tối đa:
Hãy chọn API ưu tiên proxy hoặc một stack tự động hóa trình duyệt tùy chỉnh. Bạn sẽ phải tự gánh nhiều hơn về thiết lập và bảo trì, nhưng bù lại có thể tinh chỉnh phiên làm việc và tương tác ở mức thấp hơn.
-
Nếu bạn cần compliance, khả năng audit hoặc tính năng enterprise:
Sequentum được sinh ra cho nhu cầu này. Giá cao hơn, nhưng rất đáng nếu bạn làm trong ngành có quy định chặt chẽ.
-
Nếu bạn chỉ muốn người khác lo toàn bộ:
Grepsr hoặc dịch vụ quản lý của ScrapeHero là lựa chọn phù hợp. Bạn trả nhiều hơn một chút, nhưng sức khỏe tinh thần sẽ được cảm ơn đấy.
Và nếu bạn vẫn chưa chắc chắn, hầu hết các nền tảng này đều có bản dùng thử miễn phí — cứ thử rồi sẽ rõ!
Điểm Chính Cần Nhớ
- API web scraping giờ đã trở thành công cụ thiết yếu cho doanh nghiệp dựa trên dữ liệu — báo cáo 2026 của Mordor Intelligence định giá thị trường ở mức 1,03 tỷ USD vào năm 2025 và dự báo sẽ gần như tăng gấp đôi vào năm 2030, trong đó dữ liệu huấn luyện AI, intelligence cho e-commerce và giám sát SERP là các động lực tăng trưởng chính.
- Workflow quan trọng hơn cái nhãn. Dùng ứng dụng no-code cho công việc do operator điều phối, API cho workflow nhúng hoặc do agent dẫn dắt, custom code khi cần kiểm soát trình duyệt đặc biệt, và dịch vụ quản lý khi bạn muốn thuê ngoài khâu giao dữ liệu.
- Mỗi API/nền tảng đều có thế mạnh riêng:
- Thunderbit cho Distill bằng AI và workflow Extract theo schema
- Oxylabs và Bright Data cho quy mô và độ tin cậy
- Apify cho tính linh hoạt
- Decodo cho giá trị sử dụng
- WebAutomation cho no-code
- Sequentum cho compliance
- Grepsr cho dữ liệu được quản lý trọn gói
- Thunderbit hiện nằm trong cả hai nhóm no-code và API. Scraper trực quan phục vụ operator, còn Distill, Extract, batch job và webhook hỗ trợ workflow cho developer và agent.
- Công cụ tốt nhất là công cụ khớp với workflow, ngân sách và kỹ năng kỹ thuật của bạn. Đừng ngại thử nghiệm!
Nếu bạn muốn thử hướng API, hãy bắt đầu với Thunderbit Distill hoặc Extract. Nếu bạn thích workflow trực quan, hãy dùng Thunderbit AI Web Scraper. Để xem thêm hướng dẫn triển khai, hãy ghé Thunderbit Blog.
Và hãy nhớ: trong thế giới dữ liệu web, thứ thay đổi nhanh hơn cả chính website là công nghệ chúng ta dùng để scrape chúng. Hãy tò mò, hãy tự động hóa, và mong rằng proxy của bạn sẽ không bao giờ bị chặn.




