
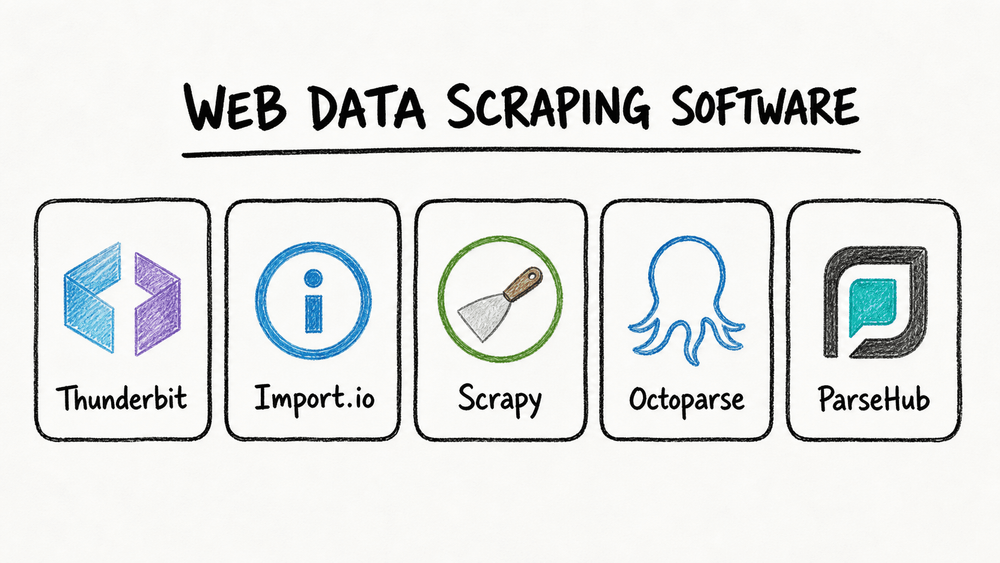
Web đang ngập tràn dữ liệu, và trong năm 2026, cuộc đua biến mớ hỗn độn đó thành giá trị kinh doanh còn nóng hơn bao giờ hết. Tôi đã thấy các team sales, ecommerce và operations thay đổi hẳn cách làm việc nhờ tự động hóa những thao tác trước đây tốn hàng giờ chỉ để copy-paste đến phát ngán. Nếu đến giờ bạn vẫn chưa dùng phần mềm thu thập dữ liệu web, thì không chỉ là đang chậm chân — có khi bạn vẫn còn mắc kẹt trong “địa ngục spreadsheet”, trong khi đối thủ đã kịp uống xong ly cà phê thứ hai.
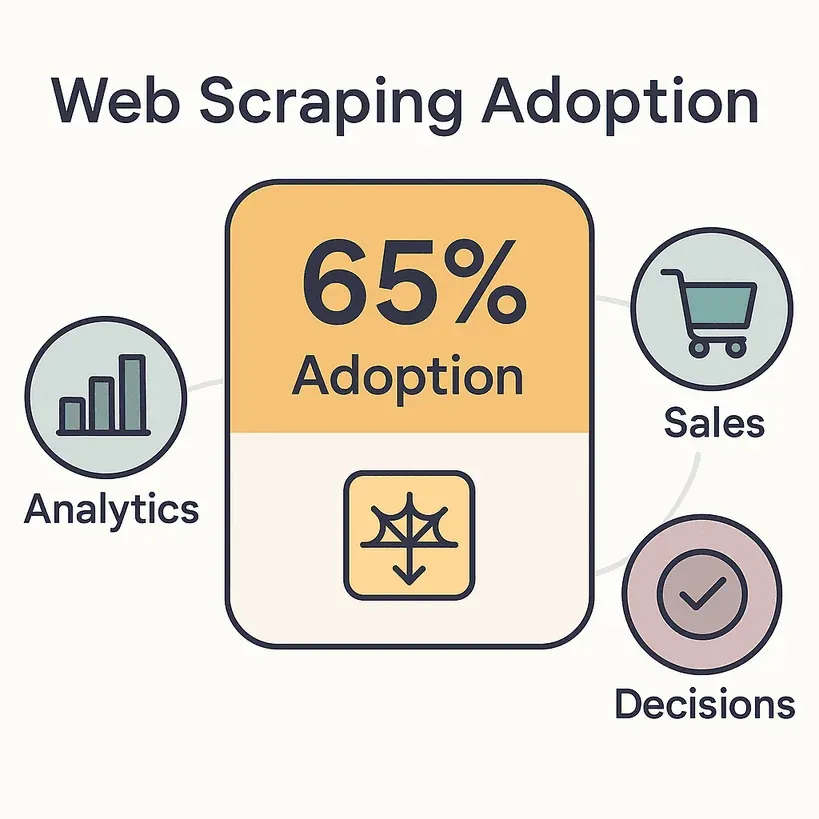
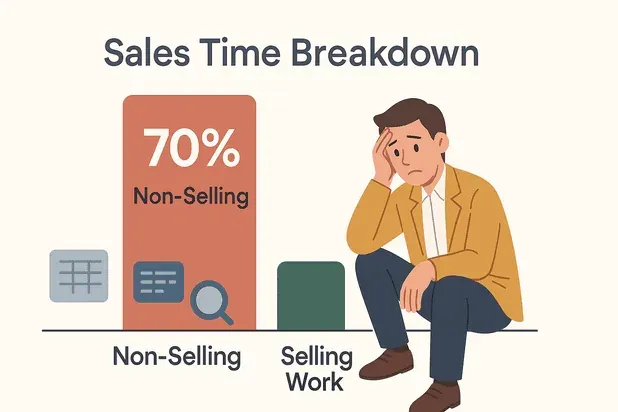
Thực tế là: 65% doanh nghiệp hiện đã sử dụng các công cụ web scraping để phục vụ phân tích, bán hàng và ra quyết định. Thị trường trích xuất dữ liệu web toàn cầu hiện đã có giá trị hơn 1 tỷ USD, và dự kiến sẽ tăng gấp đôi vào năm 2030. Nhân viên sales cũng đang mất một phần lớn thời gian trong tuần cho những việc không trực tiếp tạo doanh số như nhập liệu và nghiên cứu. Đó là rất nhiều thời gian lẽ ra có thể dùng để chốt deal — hoặc ít nhất là ăn trưa đàng hoàng hơn một chút.
Vậy đâu là phần mềm thu thập dữ liệu web tốt nhất cho năm 2026? Tôi đã đào sâu vào 5 công cụ hàng đầu đang làm thay đổi cuộc chơi cho các team ở mọi quy mô và trình độ kỹ thuật. Dù bạn là người không biết code nhưng chỉ muốn bấm là chạy, hay là developer cần độ linh hoạt tối đa, bài viết này đều có lựa chọn phù hợp.
Điều gì làm nên phần mềm thu thập dữ liệu web tốt nhất?
Data Scraping là gì và làm thế nào để thực hiện trong năm 2025 Get Started Free
Nói thật nhé: không phải web scraper nào cũng giống nhau. Phần mềm thu thập dữ liệu web tốt nhất năm 2026 phải giúp việc lấy dữ liệu trở nên nhanh, ổn định và dễ tiếp cận với mọi người — chứ không chỉ dành cho những ai “nghĩ bằng Python”.
Đây là những tiêu chí cốt lõi tôi luôn xem xét (và cũng là điều người dùng doanh nghiệp quan tâm nhất):
- Dễ sử dụng: Người không rành kỹ thuật có thể thiết lập một tác vụ scraping trong vài phút không? Giao diện no-code và AI gần như là điều bắt buộc với đa số team.
- Linh hoạt với nhiều nguồn dữ liệu: Công cụ có xử lý được trang web, PDF, hình ảnh và nội dung động (như cuộn vô hạn hay AJAX) không? Càng hỗ trợ nhiều nguồn càng tốt.
- Tự động hóa & lập lịch: Có thể chạy định kỳ, xử lý phân trang và tự động đi qua các trang con không? Tự động hóa là ranh giới giữa “thiết lập xong, quên luôn” và “thiết lập xong rồi phải canh chừng liên tục”.
- Tích hợp & xuất dữ liệu: Có xuất thẳng sang Excel, Google Sheets, Notion, Airtable hay qua API không? Càng ít thao tác thủ công thì team càng đỡ mệt.
- Yêu cầu kỹ năng kỹ thuật: Công cụ có thật sự no-code không, hay bạn vẫn phải lục lại kiến thức regex? Công cụ tốt phải phục vụ cả người không biết code lẫn người dùng nâng cao.
- Khả năng mở rộng: Có thể xử lý hàng trăm hay hàng nghìn trang mà không “đuối” không?
- Hỗ trợ & cộng đồng: Tài liệu có đầy đủ không, hỗ trợ có nhanh không, cộng đồng người dùng có sôi động không?
Những tiêu chí này không chỉ là “có thì tốt” — chúng là thứ phân biệt giữa công cụ giúp bạn tiết kiệm hàng giờ và công cụ khiến bạn mất cả ngày. Trong năm 2026, khi gần một nửa lưu lượng internet đến từ bot, việc có một scraper phù hợp là một lợi thế cạnh tranh rất lớn.
Giờ thì cùng đi vào top 5 nhé.
Top 5 phần mềm thu thập dữ liệu web tốt nhất năm 2026
- Thunderbit cho scraping no-code, dùng AI, hỗ trợ đa nguồn
- Import.io cho pipeline dữ liệu tích hợp, chuẩn doanh nghiệp
- Scrapy cho độ linh hoạt mã nguồn mở, thiên về developer
- Octoparse cho scraping trực quan, no-code, có lập lịch
- ParseHub cho trích xuất dữ liệu thân thiện, thao tác bấm chọn đơn giản
1. Thunderbit: Phần mềm thu thập dữ liệu web dễ dùng nhất, vận hành bằng AI
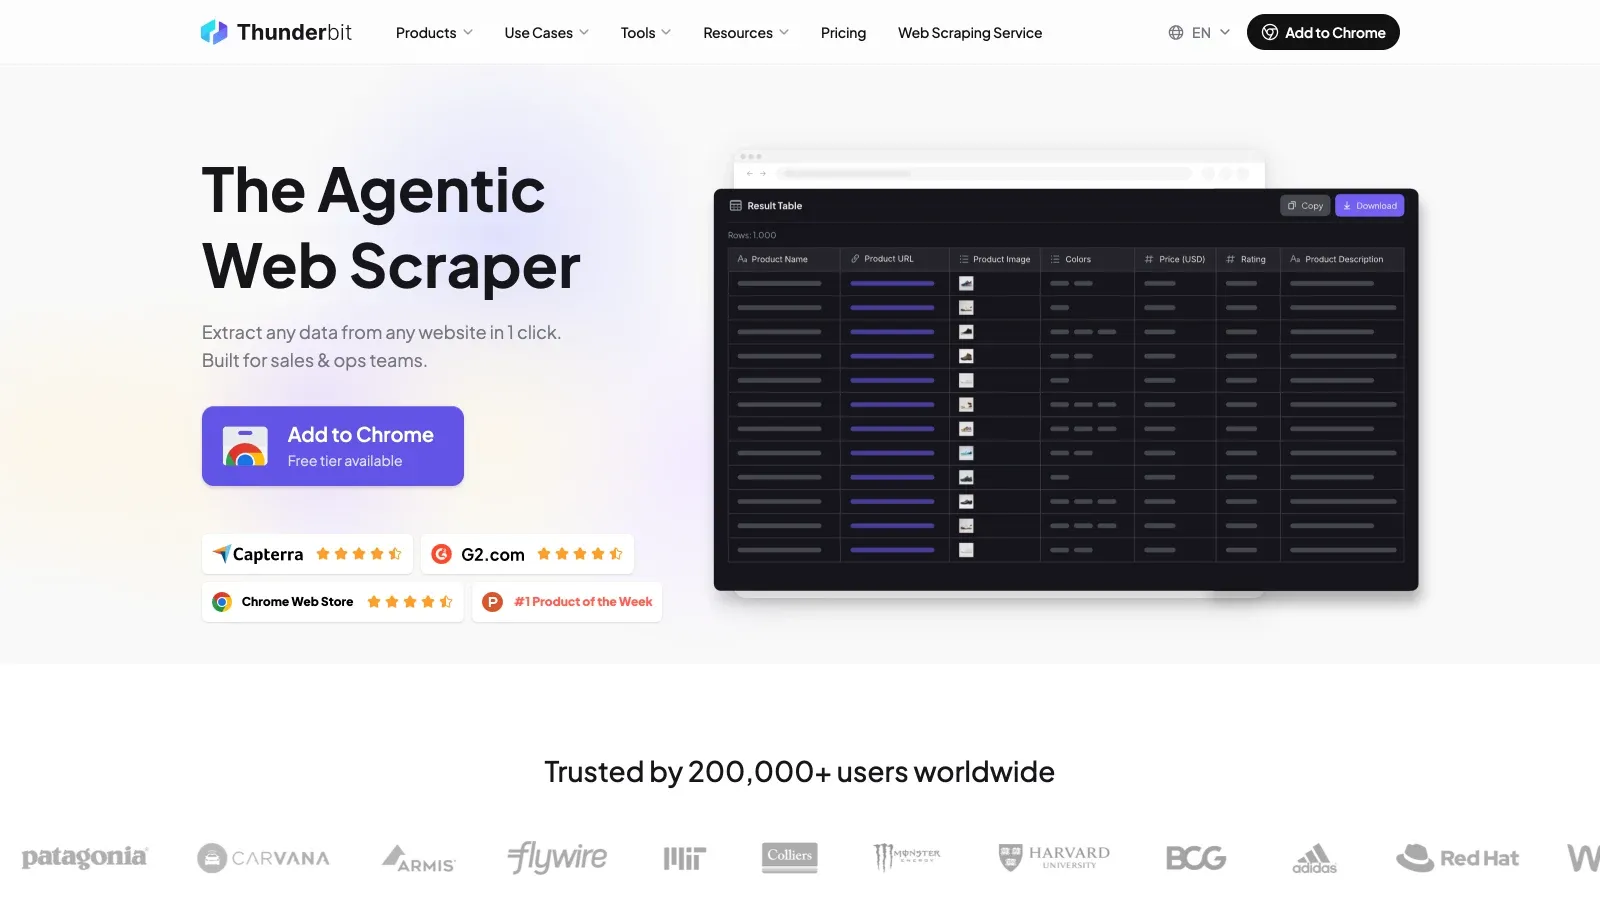
Trích xuất dữ liệu từ bất kỳ website nào bằng AI Get Started Free
Thunderbit là lựa chọn tôi thường khuyên cho bất kỳ ai muốn thu thập dữ liệu web mà không cần viết dù chỉ một dòng code. Và đúng là tôi có hơi thiên vị — vì tôi cũng tham gia xây dựng nó. Nhưng hãy nghe tôi nói hết: Thunderbit được tạo ra cho người dùng doanh nghiệp muốn có kết quả, chứ không muốn đau đầu.
Điều gì làm Thunderbit nổi bật?
- AI Suggest Fields: Chỉ cần bấm “AI Suggest Fields”, AI của Thunderbit sẽ đọc trang, gợi ý nên trích xuất gì, và tự thiết lập scraper cho bạn. Không cần selector, không cần template, không rườm rà.
- Thu thập đa nguồn: Không chỉ lấy dữ liệu từ trang web mà còn từ PDF và hình ảnh. Thunderbit có thể trích xuất văn bản, link, email, số điện thoại và hình ảnh — chỉ trong 2 cú nhấp.
- Tự động hóa trang con & phân trang: Cần lấy chi tiết từ từng sản phẩm hoặc hồ sơ? Tính năng scraping trang con của Thunderbit sẽ lần theo link, lấy thêm thông tin và gom lại vào bảng của bạn. Nó cũng xử lý cuộn vô hạn và phân trang rất mượt.
- Scraping hàng loạt & theo lịch: Dán vào danh sách URL, đặt lịch chạy định kỳ và để Thunderbit lo phần nặng — từ theo dõi giá hằng ngày đến cập nhật lead hằng tuần.
- Xuất dữ liệu tức thì: Xuất thẳng sang Excel, Google Sheets, Airtable, Notion, CSV hoặc JSON. Chấm dứt cảnh copy-paste lặp đi lặp lại.
- Custom AI Prompts: Muốn phân loại, dịch hoặc gắn nhãn dữ liệu ngay trong lúc scrape? Chỉ cần thêm hướng dẫn tùy chỉnh, AI của Thunderbit sẽ làm nốt phần còn lại.
- Chế độ Cloud hoặc Browser: Chạy trên cloud để tăng tốc (50 trang cùng lúc) hoặc chạy cục bộ cho những website cần đăng nhập.
Thunderbit hiện được hơn 200.000 người dùng trên toàn thế giới tin dùng, từ đội sales, môi giới bất động sản đến các shop ecommerce độc lập. Gói miễn phí cho phép bạn scrape tối đa 6 trang mỗi tháng, và bạn chỉ trả theo mức sử dụng — 1 credit cho mỗi dòng dữ liệu đầu ra.
Vì sao tôi thích nó: Thunderbit là công cụ hiếm hoi mà một người không rành kỹ thuật có thể đi từ “Tôi cần dữ liệu này” đến “Đây là file spreadsheet của tôi” chỉ trong chưa đầy 5 phút. Giao diện thực sự thân thiện (chúng tôi đã ám ảnh về điều đó), và AI có thể thích ứng khi website thay đổi, nên bạn không phải liên tục sửa scraper bị hỏng.
Phù hợp nhất cho: Sales, ecommerce, operations và bất kỳ ai muốn scraping no-code, dùng AI, không phải bảo trì lằng nhằng.
Dùng thử tiện ích Thunderbit trên Chrome
Xem thêm Thunderbit Blog để có thêm nhiều hướng dẫn hữu ích.
2. Import.io: Thu thập dữ liệu web chuẩn doanh nghiệp và tích hợp sâu
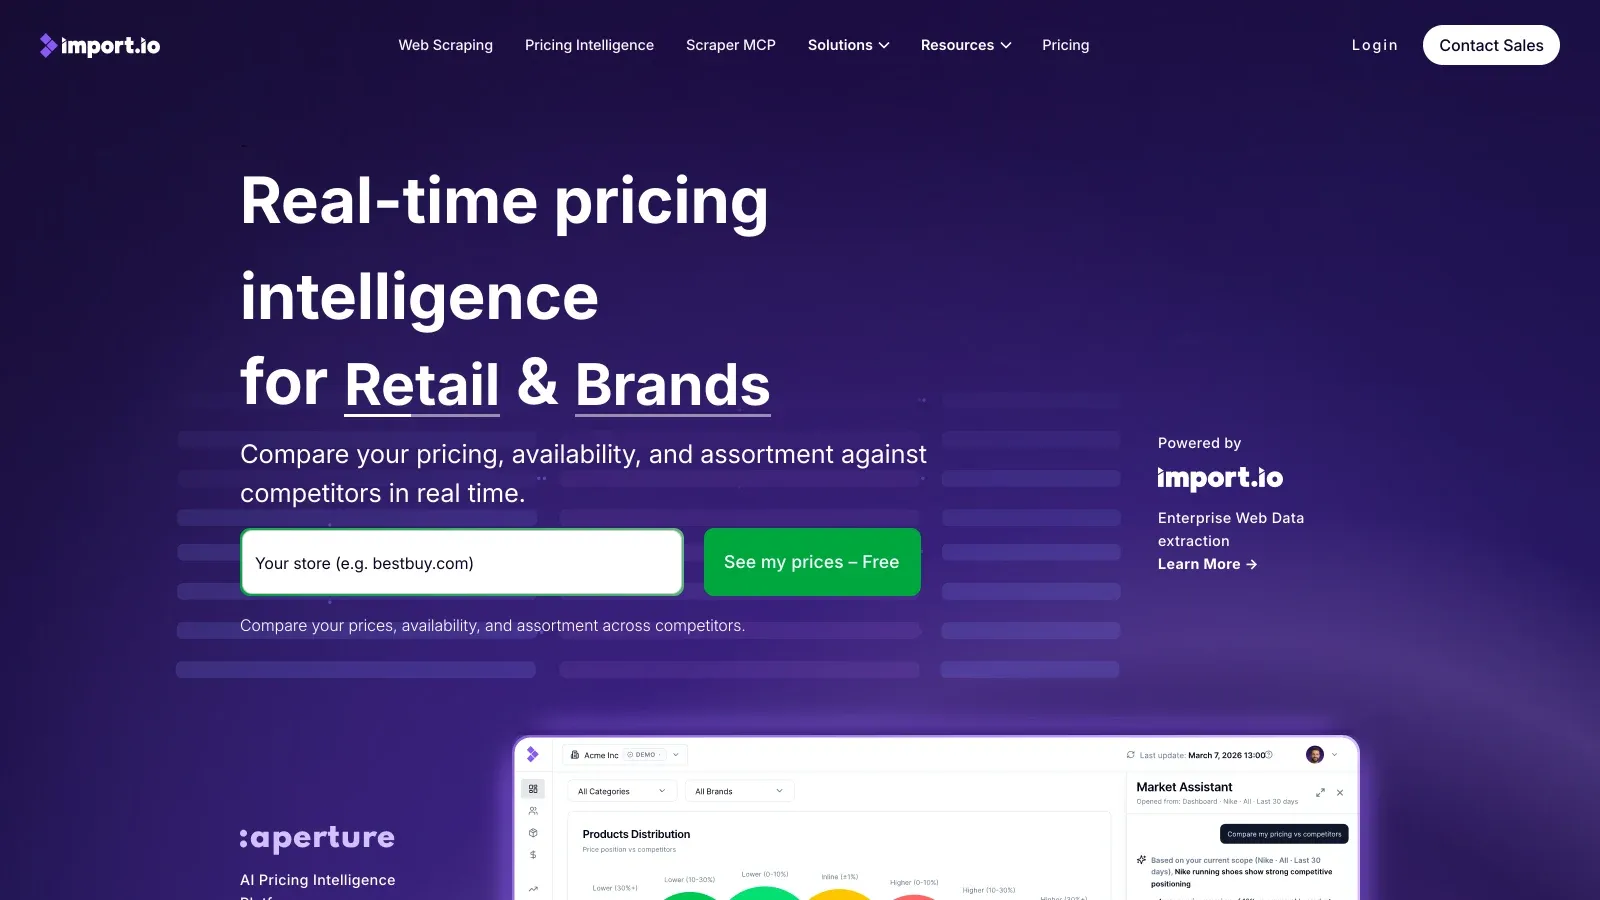
Import.io là “ông lớn” dành cho các doanh nghiệp cần dữ liệu web ở quy mô lớn — và cần đẩy thẳng vào các hệ thống nghiệp vụ.
Điểm mạnh của Import.io là gì?
- Pipeline sẵn sàng cho doanh nghiệp: Import.io không chỉ là một scraper; đây là một nền tảng tích hợp dữ liệu web đầy đủ. Hãy hình dung như “data-as-a-service” với luồng dữ liệu tự động, chạy liên tục.
- AI tự phục hồi: Nếu website thay đổi, AI của Import.io sẽ cố gắng tự ánh xạ lại các trường dữ liệu để pipeline không bị gãy qua đêm.
- Tự động hóa mạnh mẽ: Có thể lên lịch chạy theo giờ, theo ngày hoặc theo khoảng thời gian tùy chỉnh. Nhận cảnh báo nếu có lỗi hoặc nếu dữ liệu trông bất thường.
- Quy trình tương tác: Xử lý được site có đăng nhập, form hoặc nhiều bước điều hướng. Import.io có thể ghi lại và phát lại những chuỗi thao tác phức tạp.
- Tuân thủ & quản trị: Tự động phát hiện PII, che dữ liệu, và ghi log kiểm toán — rất quan trọng với các ngành có yêu cầu quy định chặt chẽ.
- API & tích hợp: Đẩy dữ liệu trực tiếp vào Google Sheets, Excel, Tableau, Power BI, cơ sở dữ liệu hoặc ứng dụng riêng qua API.
Import.io được nhiều thương hiệu như Unilever, Volvo và RedHat tin dùng. Đây là lựa chọn phổ biến cho các nhu cầu như theo dõi giá trên hàng nghìn website ecommerce, phân tích thị trường, hoặc cung cấp dữ liệu web mới cho mô hình AI/ML.
Giá: Import.io là giải pháp cao cấp, giá khởi điểm khoảng 199 USD/tháng cho gói tự phục vụ. Có bản dùng thử miễn phí, nhưng không có gói miễn phí dài hạn. Nếu dữ liệu web là yếu tố sống còn với bạn, khoản đầu tư này là xứng đáng.
Phù hợp nhất cho: Doanh nghiệp và tổ chức dữ liệu-centric cần độ tin cậy, quy mô, tuân thủ và tích hợp sâu.
3. Scrapy: Framework web scraping mã nguồn mở dành cho developer
Scrapy là “cỗ máy” mã nguồn mở dành cho developer muốn kiểm soát tối đa. Nếu bạn (hoặc team của bạn) biết code Python, Scrapy chính là con dao đa năng của thế giới web scraping.
Vì sao developer thích Scrapy:
- Tùy biến toàn diện: Viết spider (script) để crawl, parse và xử lý dữ liệu đúng theo cách bạn muốn. Xử lý luồng nhiều trang, logic tùy chỉnh và làm sạch dữ liệu phức tạp.
- Bất đồng bộ & tốc độ cao: Kiến trúc của Scrapy được thiết kế để chạy nhanh và mở rộng tốt — có thể scrape hàng trăm trang mỗi phút, hoặc hàng triệu trang với hệ thống crawler phân tán.
- Khả năng mở rộng tốt: Hệ sinh thái plugin và middleware rất lớn cho proxy, headless browser (Splash/Playwright) và các tích hợp khác.
- Miễn phí & mã nguồn mở: Không mất phí bản quyền. Chạy trên máy riêng hoặc cloud, và mở rộng theo nhu cầu.
- Hỗ trợ từ cộng đồng: Hơn 55.000 sao trên GitHub và cộng đồng người dùng cực lớn. Nếu bạn gặp vấn đề, gần như chắc chắn đã có người từng giải quyết nó.
Lưu ý: Scrapy cần kỹ năng Python và sự thoải mái khi dùng dòng lệnh. Nó không có giao diện kéo-thả — đây là sân chơi của code-first. Nhưng với dự án tùy chỉnh, dữ liệu huấn luyện AI, hoặc các chiến dịch crawl quy mô lớn, rất khó có công cụ nào vượt qua nó.
Phù hợp nhất cho: Tổ chức có developer nội bộ, pipeline dữ liệu tùy chỉnh hoặc nhu cầu scraping phức tạp ở quy mô lớn.
4. Octoparse: Thu thập dữ liệu web trực quan, đơn giản hơn bao giờ hết
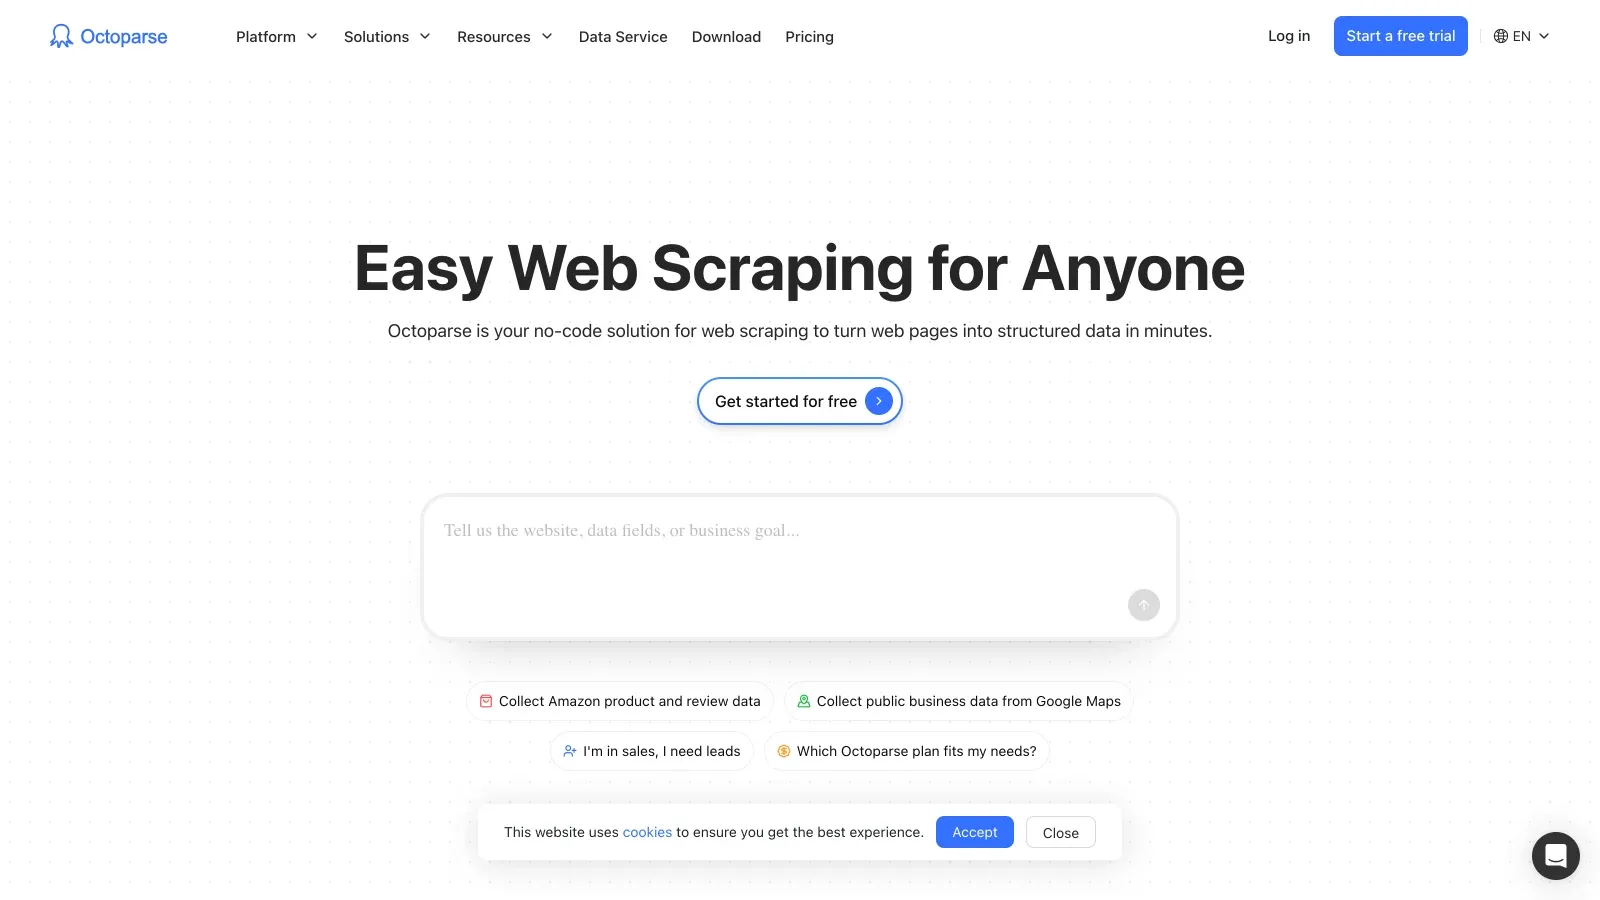
Octoparse là lựa chọn được nhiều người không biết code yêu thích vì nó mạnh mẽ nhưng lại có giao diện trực quan, bấm chọn là làm.
Vì sao Octoparse được ưa chuộng:
- Trình xây dựng workflow trực quan: Chỉ cần click vào phần tử trong trình duyệt tích hợp, Octoparse sẽ tự nhận diện mẫu dữ liệu. Không cần code, chỉ cần chọn và trích xuất.
- Xử lý nội dung động: Scrape được AJAX, cuộn vô hạn và các website cần đăng nhập. Có thể mô phỏng click, cuộn và gửi form.
- Scraping trên cloud & lập lịch: Chạy tác vụ trên cloud (nhanh hơn, song song hơn) và lên lịch cho các công việc lặp lại để luôn có dữ liệu mới.
- Template dựng sẵn: Hàng trăm template cho các website phổ biến (Amazon, Twitter, Zillow, v.v.) giúp bạn bắt đầu ngay lập tức.
- Xuất dữ liệu & API: Tải kết quả xuống dưới dạng CSV, Excel, JSON hoặc lấy dữ liệu qua API. Tích hợp với Google Sheets hoặc database.
Octoparse thường được mô tả là “rất dễ dùng, ngay cả với người mới bắt đầu”. Gói miễn phí bị giới hạn, nhưng các gói trả phí (khởi điểm khoảng 69 USD/tháng) mở khóa chạy cloud, lập lịch và tốc độ cao hơn.
Phù hợp nhất cho: Người không chuyên kỹ thuật, marketer, researcher và các team nhỏ cần thu thập dữ liệu định kỳ, tự động mà không cần code.
5. ParseHub: Trích xuất dữ liệu thân thiện cho các tác vụ hằng ngày
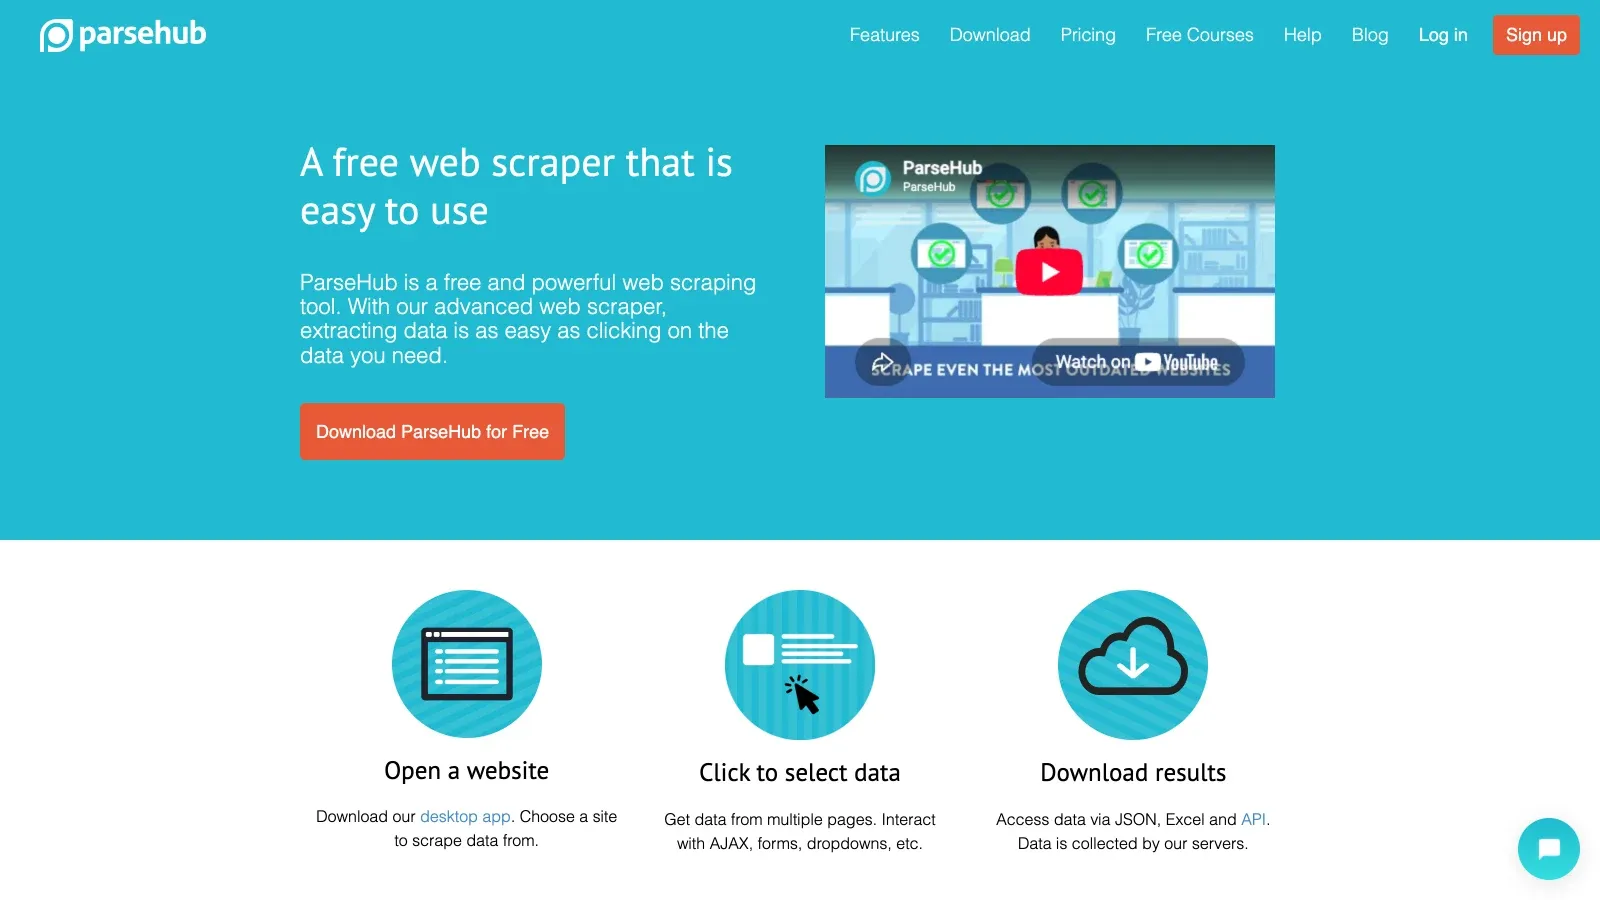
ParseHub cũng là một lựa chọn no-code được yêu thích, đặc biệt phù hợp với doanh nghiệp nhỏ và freelancer muốn tự động hóa những việc liên quan đến dữ liệu mỗi ngày.
Điểm nổi bật của ParseHub:
- Đơn giản kiểu bấm là chọn: Chọn dữ liệu bằng cách click vào các phần tử trong giao diện trình duyệt. Xây dựng workflow bằng hình ảnh — không cần code.
- Xử lý site dùng JS & nội dung động: Có thể scrape các trang nặng JavaScript, cuộn vô hạn và điều hướng nhiều bước.
- Chạy cloud & chạy cục bộ: Có thể chạy scrape trên máy tính hoặc trên cloud. Lên lịch tác vụ định kỳ và truy cập kết quả qua API (ở các gói cao hơn).
- Tùy chọn xuất dữ liệu: Tải dữ liệu dưới dạng CSV, Excel hoặc JSON. Có API để tự động hóa.
- Đa nền tảng: Dùng được trên Windows, Mac và Linux.
Gói miễn phí của ParseHub khá hạn chế (200 trang/lần chạy), nhưng các gói trả phí (khởi điểm khoảng 189 USD/tháng) mở ra nhiều sức mạnh hơn, tốc độ cao hơn và quyền truy cập API.
Phù hợp nhất cho: Doanh nghiệp nhỏ, freelancer và team có nhu cầu scraping đơn giản, muốn một công cụ trực quan, ổn định.
Bảng so sánh: Phần mềm thu thập dữ liệu web tốt nhất trong nháy mắt
| Công cụ | Dễ sử dụng | Nguồn dữ liệu | Tự động hóa & lập lịch | Tích hợp & xuất dữ liệu | Kỹ năng kỹ thuật | Giá |
|---|---|---|---|---|---|---|
| Thunderbit | No-code, dùng AI | Web, PDF, Hình ảnh | Trang con, phân trang, theo lịch, chạy hàng loạt | Excel, Sheets, Notion, Airtable, CSV, JSON | Không cần | Freemium (trả theo số dòng) |
| Import.io | Giao diện bấm chọn | Web (tĩnh/động, đăng nhập) | Tự phục hồi, theo lịch, cảnh báo | API, công cụ BI, Sheets, Excel, DB | Thấp–Trung bình | Từ 199 USD/tháng |
| Scrapy | Cần code | Web, API, (JS qua add-on) | Tự động hóa hoàn toàn bằng code | Bất kỳ (qua code) | Dev Python | Miễn phí (mã nguồn mở) |
| Octoparse | Trực quan, no-code | Web (động, đăng nhập) | Lập lịch cloud, template | CSV, Excel, JSON, API | Không cần | Từ 69 USD/tháng |
| ParseHub | Trực quan, no-code | Web (JS, động) | Cloud/cục bộ, theo lịch | CSV, Excel, JSON, API | Không cần | Từ 189 USD/tháng |
Cách chọn phần mềm thu thập dữ liệu web tốt nhất cho doanh nghiệp của bạn
Chưa chắc công cụ nào hợp với mình? Đây là “phao cứu sinh” của tôi:
- Người không rành kỹ thuật, cần kết quả nhanh: Chọn Thunderbit hoặc Octoparse. Thunderbit vượt trội nếu bạn cần scraping tức thì bằng AI và hỗ trợ đa nguồn (web, PDF, hình ảnh). Octoparse rất tốt cho scraping trực quan và chạy theo lịch.
- Tích hợp doanh nghiệp, tuân thủ và mở rộng quy mô: Import.io là lựa chọn đáng tin nhất. Công cụ này được xây dựng cho pipeline dữ liệu liên tục, ổn định và tích hợp sâu.
- Developer, dự án tùy chỉnh hoặc crawl khối lượng lớn: Scrapy là con đường phù hợp. Bạn cần biết Python, nhưng đổi lại là sự linh hoạt gần như vô hạn.
- Doanh nghiệp nhỏ, freelancer hoặc tác vụ hằng ngày: ParseHub là lựa chọn chắc chắn, thân thiện, phù hợp với scraping bấm-chọn và tự động hóa ở mức vừa phải.
Mẹo chọn công cụ phù hợp:
- Chọn công cụ khớp với kỹ năng kỹ thuật và nhu cầu dữ liệu của team.
- Cân nhắc độ phức tạp của website cần scrape (nội dung động? có đăng nhập?).
- Nghĩ về cách bạn sẽ dùng dữ liệu — cần xuất thẳng sang Sheets hay cần tích hợp API sâu?
- Bắt đầu bằng bản dùng thử miễn phí hoặc gói freemium để test các tác vụ thực tế.
- Đừng xem nhẹ giá trị của tài liệu hướng dẫn tốt và hỗ trợ nhanh.
Bắt đầu scraping với Thunderbit
Kết luận: Mở khóa giá trị kinh doanh với phần mềm thu thập dữ liệu web tốt nhất
Dữ liệu web là nhiên liệu cho những quyết định kinh doanh thông minh hơn trong năm 2026. Phần mềm thu thập dữ liệu web phù hợp có thể giúp bạn tiết kiệm hàng giờ, giảm lỗi và tạo lợi thế rõ rệt cho team — dù bạn đang xây danh sách lead, theo dõi đối thủ hay nạp dữ liệu cho hệ thống phân tích.
Tóm lại:
- Thunderbit là scraper no-code, dùng AI, dễ dùng nhất cho người làm kinh doanh.
- Import.io là giải pháp chuẩn doanh nghiệp cho pipeline dữ liệu tích hợp, chạy liên tục.
- Scrapy là bộ công cụ mã nguồn mở dành cho developer muốn kiểm soát toàn diện.
- Octoparse và ParseHub giúp scraping trực quan, no-code trở nên dễ tiếp cận với mọi người.
Hầu hết các công cụ này đều có bản dùng thử hoặc gói freemium — nên hãy thử trực tiếp. Tự động hóa những việc nhàm chán, mở ra insight mới, và để team của bạn tập trung vào những việc thực sự quan trọng.
Chúc bạn scraping vui vẻ — và mong dữ liệu của bạn luôn mới, có cấu trúc rõ ràng và sẵn sàng hành động.
Câu hỏi thường gặp
1. Phần mềm thu thập dữ liệu web được dùng để làm gì?
Phần mềm thu thập dữ liệu web tự động hóa việc trích xuất thông tin từ website, PDF và hình ảnh. Nó thường được dùng cho tạo lead, theo dõi giá, nghiên cứu thị trường, tổng hợp nội dung và nhiều mục đích khác.
2. Thu thập dữ liệu web có hợp pháp không?
Web scraping là hợp pháp khi bạn thu thập dữ liệu công khai và tuân thủ điều khoản sử dụng cũng như luật bảo mật của website. Luôn kiểm tra chính sách của trang và sử dụng dữ liệu một cách có trách nhiệm.
3. Có cần biết code để dùng phần mềm thu thập dữ liệu web không?
Không nhất thiết! Các công cụ như Thunderbit, Octoparse và ParseHub được thiết kế cho người không biết code. Với dự án phức tạp hoặc tùy chỉnh sâu, bạn có thể cần công cụ dành cho developer như Scrapy.
4. Làm sao để xuất dữ liệu scrape sang Excel hoặc Google Sheets?
Hầu hết các scraper hiện đại (Thunderbit, Octoparse, ParseHub) đều hỗ trợ xuất chỉ với một cú nhấp sang Excel, Google Sheets, CSV, hoặc thậm chí tích hợp trực tiếp với Notion và Airtable.
5. Phần mềm thu thập dữ liệu web có xử lý được site động hoặc trang yêu cầu đăng nhập không?
Có — các công cụ hàng đầu như Import.io, Octoparse và ParseHub đều có thể xử lý nội dung động (AJAX, cuộn vô hạn) và các website cần đăng nhập. Thunderbit cũng hỗ trợ scrape trang động và trang con.
Muốn xem web scraping hiện đại trông như thế nào? Tải tiện ích Chrome của Thunderbit hoặc khám phá Thunderbit Blog để có thêm mẹo, hướng dẫn và các bài phân tích chuyên sâu về thế giới trích xuất dữ liệu bằng AI.
Dùng thử AI Web Scraper Get Started Free




