
Trustpilot hiện có 361 triệu review đang hoạt động trên 1,27 triệu doanh nghiệp — và phần lớn các công cụ được tạo ra để lấy dữ liệu này đã hỏng từ nhiều tháng trước. Nếu gần đây bạn từng thử kéo review, rất có thể bạn đã gặp bức tường đăng nhập ở trang 10 khét tiếng và chỉ nhận về lỗi thay vì dữ liệu.
Trong vài tuần qua, tôi đã dành thời gian kiểm tra, nghiên cứu và so sánh các công cụ vẫn có thể trích xuất dữ liệu review Trustpilot một cách ổn định trong năm 2026. Bối cảnh đã thay đổi rất nhiều: cơ chế chống bot của Trustpilot mạnh tay hơn, giao diện Next.js tạo ra các tên class thay đổi theo từng lần triển khai, và quan trọng nhất là — nếu không xác thực đăng nhập, bạn chỉ có thể xem tối đa 10 trang review. Một thread trên Reddit từ cuối năm 2025 đã nói lên đúng nỗi bực bội đó: “không có actor nào trên store chạy được.”
Vậy công cụ nào thật sự hoạt động? Tôi đã đánh giá 5 lựa chọn dựa trên cách chúng xử lý bức tường đăng nhập, các biện pháp chống bot, chi phí bảo trì, và nhu cầu thực tế của cả marketer lẫn developer.
Vì sao lấy review Trustpilot khó hơn bạn nghĩ trong năm 2026
Trustpilot không phải một website tĩnh đơn giản, nơi bạn chỉ cần gửi một HTTP request cơ bản rồi parse bằng BeautifulSoup. Đây là một nền tảng hiện đại, render động, xây trên Next.js, và hệ thống phòng vệ của nó đã siết chặt đáng kể trong năm qua.
Bạn thực sự đang phải đối mặt với:
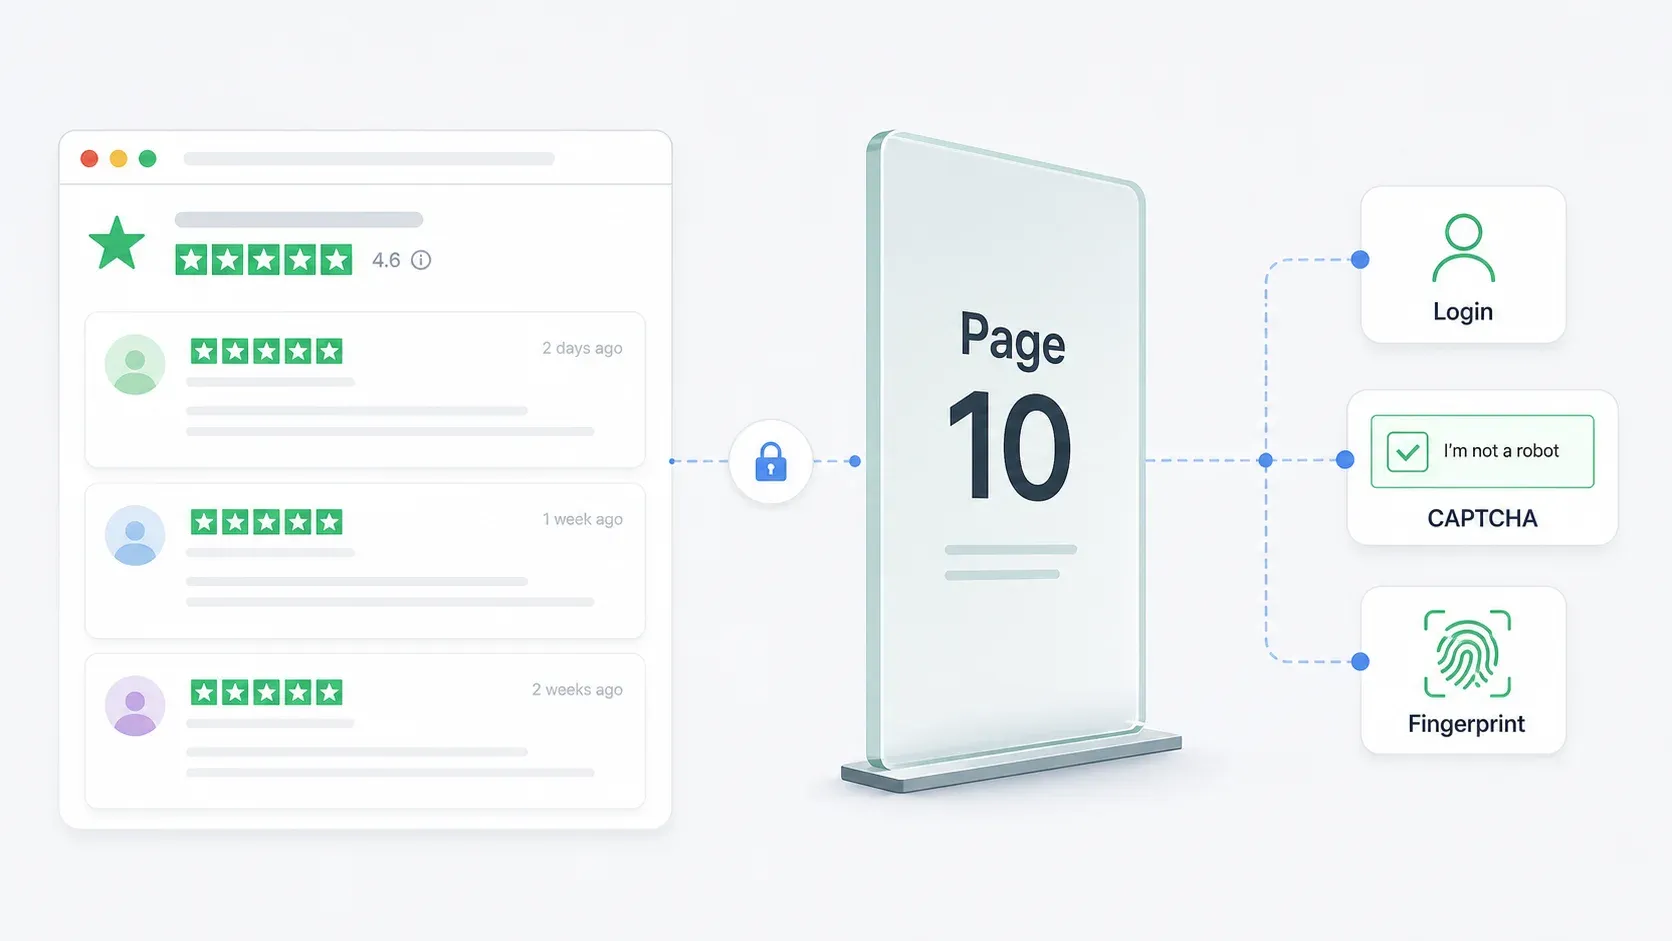
Bức tường đăng nhập ở trang 10. Đây là điểm nghẽn lớn nhất. Hướng dẫn Trustpilot tháng 3/2026 của Web Scraper xác nhận rằng Trustpilot chỉ cho xem 10 trang review đầu tiên trước khi hiện lời nhắc đăng nhập. Với một doanh nghiệp có 2.000 review (khoảng 100 trang nếu mỗi trang 20 review), bạn sẽ mất quyền truy cập tới 90% dữ liệu nếu không có phiên đăng nhập hợp lệ.
Cơ chế chống bot. Trustpilot dùng reCAPTCHA, chặn theo phiên, lọc request ở tầng CDN, và fingerprint trình duyệt. Trang About của họ nêu rõ website được “bảo vệ bởi reCAPTCHA” và thu thập tín hiệu từ thiết bị lẫn tương tác người dùng.
Tên class CSS động. Vì Trustpilot dùng Next.js với CSS modules, các class như styles_reviewCardInner__EwDq2 được sinh ra lúc build và sẽ đổi mỗi khi Trustpilot triển khai bản cập nhật. Tutorial của ScraperAPI đang dựa đúng vào các selector này — nghĩa là bất kỳ đoạn code nào làm theo hướng dẫn đó sẽ gãy ngay khi Trustpilot thay đổi frontend.
Thay đổi cấu trúc DOM. Không chỉ class name, cả cấu trúc HTML cũng có thể đổi. Các phần tử có thể được lồng khác đi, wrapper mới xuất hiện, và component phân trang cũng có thể được sắp xếp lại.
Các scraper dựa vào CSS selector — dù là Apify Actors, workflow của Octoparse hay script Python tự viết — đều rất mong manh trên Trustpilot. Chạy được hôm nay, nhưng ngày mai thì chưa chắc. Và “chưa chắc” ở đây thường được tính bằng vài tuần, không phải vài tháng.
Chúng tôi tìm gì ở những công cụ trích xuất review Trustpilot tốt nhất
Tôi không đánh giá các công cụ này theo tiêu chí chung chung kiểu “có trích xuất được một trang web không”. Công cụ nào trong danh sách này cũng có thể lấy dữ liệu từ một trang HTML đơn giản.
Câu hỏi thật sự là: nó có xử lý được Trustpilot, với toàn bộ điểm khó của nền tảng này, trong năm 2026 không?
Những tiêu chí quan trọng nhất:
| Tiêu chí | Vì sao quan trọng với Trustpilot |
|---|---|
| Xử lý bức tường đăng nhập (trang 10+) | Phần lớn doanh nghiệp có nhiều hơn 200 review. Bị giới hạn 10 trang đồng nghĩa với việc bạn bỏ lỡ phần lớn dữ liệu lịch sử. |
| Cách vượt/chống bot | reCAPTCHA, chặn theo phiên và lọc qua CDN sẽ khiến những scraper ngây thơ bị dừng ngay lập tức. |
| Độ bền của selector / chi phí bảo trì | Class CSS được sinh tự động sẽ làm hỏng các công cụ phụ thuộc selector thường xuyên. Công cụ có tự sửa lỗi không? |
| Hỗ trợ phân trang | Review có thể trải dài hàng trăm trang. Không thể làm thủ công từng trang một. |
| No-code hay cần code | Marketer cần giao diện bấm-chọn; developer muốn toàn quyền kiểm soát. |
| Giá / gói miễn phí | Các đội nhóm cần cân nhắc ngân sách trước khi quyết định. |
| Tùy chọn xuất dữ liệu | Người dùng doanh nghiệp cần Google Sheets, Airtable, Notion — không chỉ JSON thô. |
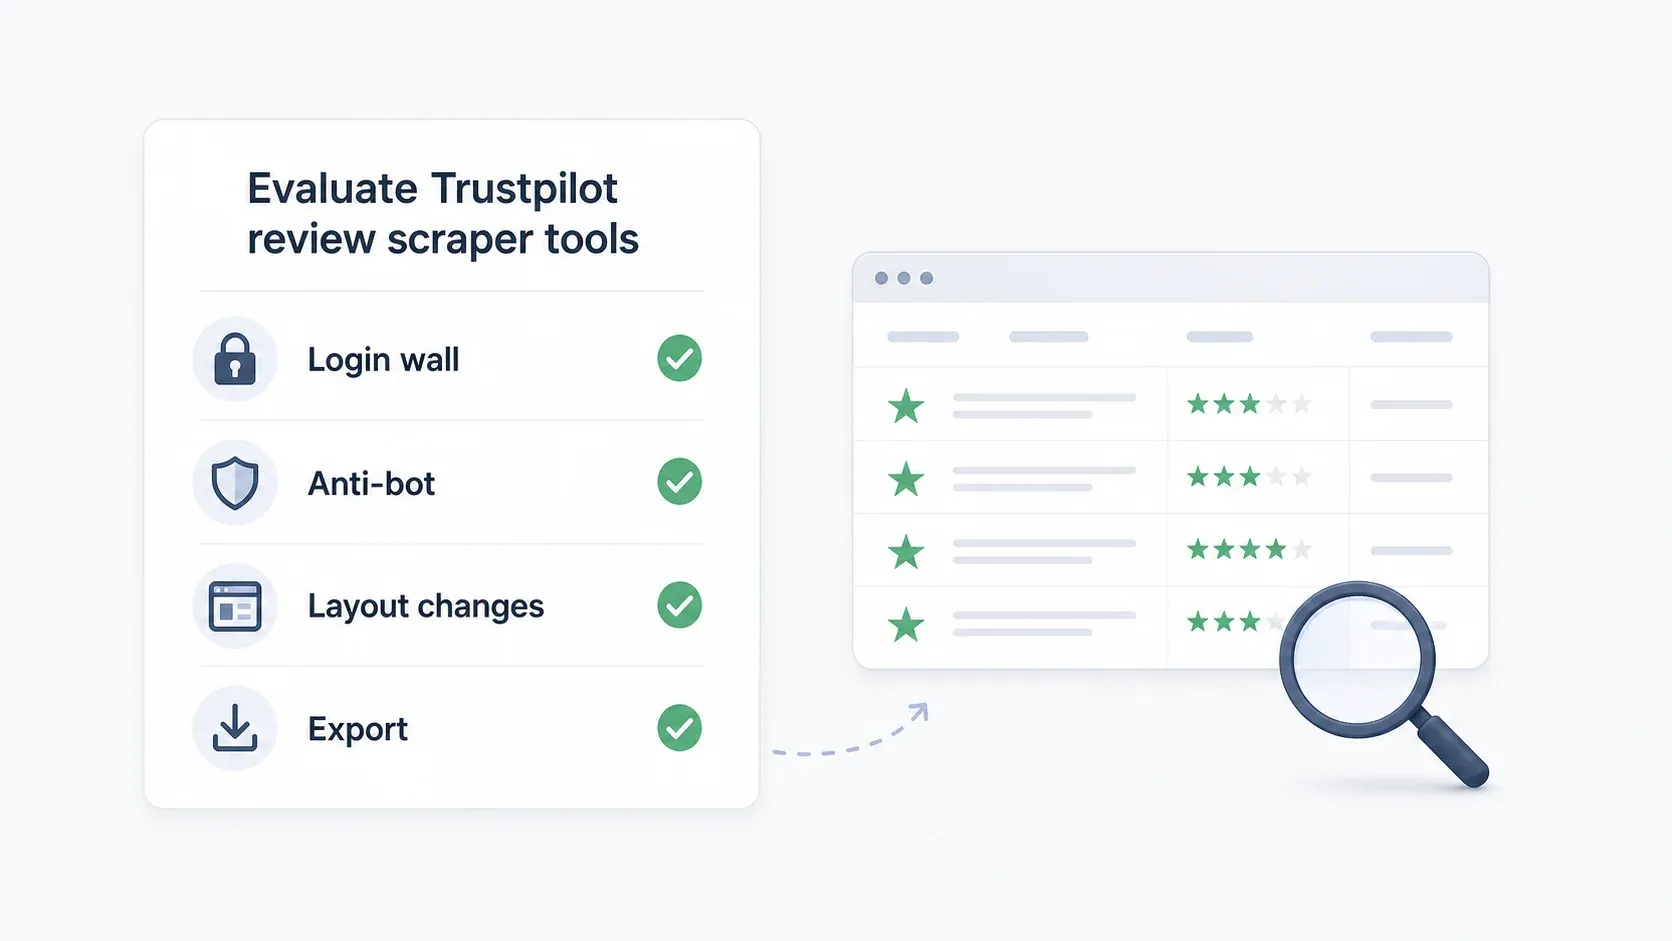
Bức tường đăng nhập là yếu tố quyết định.
Nếu một công cụ không qua được trang 10 — hoặc ít nhất không cung cấp được đường đi rõ ràng để truy cập khi đã đăng nhập — thì nó chưa thể coi là một scraper Trustpilot khả thi trong năm 2026.
So sánh nhanh các công cụ trích xuất review Trustpilot tốt nhất
Bảng so sánh đầy đủ:
| Công cụ | Mức độ kỹ năng | Xử lý bức tường đăng nhập | Cách tiếp cận chống bot | Phân trang | Gói miễn phí | Tùy chọn xuất dữ liệu |
|---|---|---|---|---|---|---|
| Thunderbit | No-code | Chế độ trình duyệt (dùng phiên Chrome đã đăng nhập của bạn) | AI trích xuất theo ngữ nghĩa, tự thích ứng khi bố cục thay đổi | Tự động phát hiện, nhiều trang | 6 trang miễn phí/tháng | Excel, Sheets, Airtable, Notion, CSV, JSON |
| Apify | Low-code | Phụ thuộc vào từng Actor; một số cần cấu hình cookie cho trang >10 | Xoay proxy tích hợp, tùy Actor | Có thể cấu hình theo Actor | $5/tháng credit nền tảng miễn phí | JSON, CSV, Excel, XML, RSS |
| Octoparse | No-code (trực quan) | Cần cấu hình cookie/phiên thủ công | Xoay IP, proxy residential, giải CAPTCHA (trả phí) | Workflow click/scroll | Gói miễn phí + dùng thử premium 14 ngày | CSV, Excel, JSON, HTML, XML, cơ sở dữ liệu |
| Web Scraper | No-code (sitemap) | Hạn chế — hướng dẫn chính thức ghi nhận giới hạn 10 trang review | Cloud + proxy ở gói trả phí | Có thể cấu hình; nên dùng click bằng JS | Tiện ích Chrome miễn phí | CSV, XLSX |
| ScraperAPI | Developer (Python) | Quản lý session/cookie ở mức code | Hơn 40 triệu proxy residential, render JS, xử lý CAPTCHA | Dựa trên code | Dùng thử 7 ngày, 5.000 credit API | Do developer tự định nghĩa (CSV, JSON, v.v.) |
1. Thunderbit

Thunderbit là một tiện ích Chrome tích hợp AI, được tạo cho các đội ngũ kinh doanh cần dữ liệu có cấu trúc từ website mà không phải viết code. Riêng với Trustpilot, Thunderbit có mẫu trích xuất review chuyên dụng có thể lấy tên người đánh giá, điểm số, tiêu đề review, nội dung review, ngày tháng và phản hồi của doanh nghiệp chỉ bằng một cú nhấp.
Tôi có thiên vị đôi chút — vì tôi làm ở đây — nhưng lý do chúng tôi xây Thunderbit theo cách này gắn trực tiếp với việc vì sao scrape Trustpilot lại khó. AI của chúng tôi đọc trang theo ngữ nghĩa thay vì bám vào CSS selector. Khi Trustpilot đổi class name hoặc sắp xếp lại DOM, Thunderbit vẫn thích nghi vì nó tìm ý nghĩa của các phần tử trên trang chứ không phụ thuộc vào địa chỉ HTML cụ thể của chúng.
Thử Thunderbit để scrape Trustpilot
Thunderbit xử lý bức tường đăng nhập ở trang 10 như thế nào
Đây là lúc chế độ trình duyệt phát huy tác dụng. Thunderbit hoạt động ngay trong Chrome của bạn — chính trình duyệt nơi bạn đã đăng nhập Trustpilot. Khi chuyển sang chế độ browser scraping, tiện ích sẽ đọc những trang đang hiển thị trong phiên đăng nhập của bạn. Không cần xoay proxy. Không cần chèn cookie. Không cần Playwright session pool.
Quy trình thực tế: đăng nhập Trustpilot trong Chrome, mở trang review bạn muốn lấy dữ liệu, rồi mở tiện ích. Chỉ một cú nhấp là AI sẽ nhận diện các trường review trên trang và tự trích xuất. Muốn lấy dữ liệu theo cách khác? Chỉ cần mô tả yêu cầu, AI sẽ làm theo. Việc phân trang diễn ra tự động từ đó — Thunderbit sẽ đi qua mọi trang mà phiên Chrome của bạn có thể truy cập.
Vì sao Thunderbit không hỏng khi Trustpilot thay đổi
Trang template Trustpilot của chúng tôi so sánh rất trực diện: scraper truyền thống sẽ gãy khi bố cục thay đổi và selector CSS cần cập nhật. Thunderbit dùng AI ngữ nghĩa, hiểu nội dung mà không phụ thuộc vào CSS cụ thể, xử lý nội dung động và tự động phân trang.
So với code trong tutorial của ScraperAPI, vốn parse theo class name như styles_reviewCardInner__EwDq2, selector đó sẽ gãy ngay lần Trustpilot triển khai tiếp theo. AI của Thunderbit sẽ hỏi “nội dung review nằm ở đâu trên trang này?” thay vì “nội dung nằm trong div class nào?”.
Các tính năng nổi bật cho việc scrape Trustpilot
- AI tự nhận diện trường dữ liệu: tiện ích tự phát hiện các trường review (tên, điểm, ngày, tiêu đề, nội dung, phản hồi doanh nghiệp) mà không cần cấu hình thủ công — hoặc nếu bạn muốn bộ trường khác, chỉ cần nói rõ
- Quy trình một cú nhấp: một cú nhấp → bảng dữ liệu hoàn chỉnh. Xong.
- Chế độ trình duyệt cho trang cần đăng nhập: hoạt động ngay trong phiên Chrome đã xác thực để truy cập trang 10+
- Tự động phân trang: xử lý bộ review nhiều trang mà không cần can thiệp thủ công
- Trích xuất trang con: có thể đi vào từng profile người đánh giá để bổ sung dữ liệu
- Lập lịch scrape: thiết lập theo dõi review hàng tuần hoặc hàng tháng cho mục đích theo dõi uy tín thương hiệu
- Xuất dữ liệu: Google Sheets, Airtable, Notion, CSV, JSON — đều miễn phí
Giá
- Gói miễn phí: 6 trang/tháng, không cần thẻ tín dụng
- Hệ thống credit: 1 credit = 1 dòng đầu ra
- Gói trả phí: $15/tháng, hoặc khoảng ~$9/tháng nếu thanh toán theo năm (trang giá)
Phù hợp nhất cho: Các đội marketing, vận hành và người dùng doanh nghiệp cần review Trustpilot mà không đụng vào code — và không muốn phải bảo trì một scraper cứ vài tuần lại hỏng.
2. Apify
Apify là một nền tảng scrape trên cloud với marketplace gồm các “Actor” dựng sẵn — tức các mẫu scrape do cộng đồng và đội ngũ Apify tạo ra. Với Trustpilot, store có nhiều Actor được cộng đồng duy trì, nhưng độ ổn định khác nhau khá nhiều.
Điểm đánh đổi của Apify là: nó mạnh, nhưng bị phân mảnh. Có Actor chạy được. Có Actor đã lỗi thời. Có Actor cần cookie cho trang >10. Và lời than phiền trên Reddit rằng “không có actor nào trong store chạy được” là có thật — nó phản ánh tốc độ Trustpilot thay đổi nhanh đến mức nào có thể làm hỏng logic riêng của từng Actor.
Actor Trustpilot và những giới hạn đã biết
Apify Store có một số Actor cho Trustpilot. Ít nhất một Actor (của developer “burbn”) ghi rõ là cần input cookie để đi qua các trang sau trang 10. Một số Actor khác có đánh giá 0.0, số người dùng rất thấp, hoặc thời gian sửa đổi gần đây quá mới — đều là dấu hiệu cho thấy quá trình bảo trì đang diễn ra và độ tin cậy không đồng đều.
Các Actor đã bị ngừng hỗ trợ cũng đáng chú ý. Có một Actor cũ đọc trực tiếp JSON __NEXT_DATA__ được nhúng trong Trustpilot — một cách làm khá thông minh, nhanh hơn parse DOM, nhưng vẫn gãy khi Trustpilot đổi cấu trúc dữ liệu.
Xử lý bức tường đăng nhập và chống bot
- Bức tường đăng nhập: phụ thuộc hoàn toàn vào Actor bạn chọn. Một số hỗ trợ chèn cookie cho trang 10+, số khác thì không.
- Chống bot: nền tảng của Apify có xoay proxy và hạ tầng tính theo compute unit. Proxy residential có sẵn với giá $8/GB trên gói Free/Starter.
- Bảo trì: khi một Actor hỏng, bạn либо chờ người duy trì sửa, либо đổi sang Actor khác, либо thuê dựng một private Actor riêng.
Giá
- Gói miễn phí: $5/tháng credit sử dụng trả trước, không cần thẻ tín dụng
- Starter: $9/tháng + trả theo mức dùng
- Scale: $99/tháng + trả theo mức dùng
- Xuất dữ liệu: JSON, CSV, Excel, XML, RSS (tùy Actor)
Phù hợp nhất cho: Người dùng có nền tảng kỹ thuật, biết đánh giá nhiều Actor, cấu hình cookie và xử lý sự cố khi hỏng. Không lý tưởng cho đội muốn giải pháp bật lên là chạy mãi.
3. Octoparse
Octoparse là một công cụ scrape trên desktop, no-code, với trình dựng workflow trực quan kiểu bấm-chọn. Nó nằm giữa sự đơn giản một cú nhấp của Thunderbit và khả năng kiểm soát toàn diện của ScraperAPI — bạn có cấu hình trực quan mà không cần code, nhưng vẫn phải tự xây và duy trì workflow.
Thiết lập scrape Trustpilot trong Octoparse
Quy trình khá thẳng nhưng vẫn cần thao tác thủ công:
- Dán URL review doanh nghiệp trên Trustpilot
- Chọn trực quan các phần tử review (tiêu đề, nội dung, điểm, ngày, tên người đánh giá)
- Thiết lập vòng lặp phân trang bằng nút trang tiếp theo
- Cấu hình thời gian chờ (khuyến nghị 2–5 giây để tránh reCAPTCHA)
- Chạy cục bộ cho mẫu nhỏ hoặc chạy trên cloud cho job lớn hơn
Việc thiết lập mất khoảng 10–15 phút với người đã quen công cụ. Vấn đề là: vì Octoparse dùng selector trực quan gắn với phần tử DOM, bạn sẽ phải cập nhật workflow mỗi khi Trustpilot thay đổi cấu trúc trang.
Xử lý bức tường đăng nhập và chống bot
- Bức tường đăng nhập: cần đăng nhập/cookie/phiên được cấu hình thủ công. Không tự xử lý.
- Chống bot: gói trả phí bao gồm xoay IP, proxy residential ($3/GB), và tự động giải CAPTCHA ($1–1.5 cho mỗi nghìn).
- Bảo trì: mức trung bình. Hãy chuẩn bị tinh thần sửa lại workflow khi Trustpilot cập nhật frontend.
Giá
- Gói miễn phí: miễn phí vĩnh viễn, 10 tasks, 1 thiết bị, trích xuất cục bộ, tối đa 50.000 dòng/tháng
- Standard: $69/tháng (thanh toán theo năm)
- Professional: $149/tháng
- Dùng thử premium 14 ngày: bao gồm trích xuất cloud, lập lịch, API và template
- Xuất dữ liệu: Excel, CSV, JSON, HTML, XML; cơ sở dữ liệu và Google Sheets ở các gói cao hơn
Phù hợp nhất cho: Người dùng thích kiểm soát workflow bằng giao diện trực quan, không ngại thời gian cài đặt ban đầu, và sẵn sàng duy trì workflow khi trang thay đổi. Hợp với đội cần tùy biến nhiều hơn một tool một cú nhấp nhưng ít phức tạp hơn việc tự viết Python.
4. Web Scraper
Web Scraper là một tiện ích Chrome kèm nền tảng cloud, hoạt động theo hướng sitemap khi scrape. Điểm mạnh nhất cho Trustpilot của nó là mẫu trang doanh nghiệp dựng sẵn có thể lấy dữ liệu cấp công ty: tên doanh nghiệp, danh mục, địa chỉ, điểm số, số lượng review, TrustScore và URL website.
Riêng với trích xuất review, Web Scraper có một giới hạn đã được ghi nhận rõ ràng.
Mẫu dựng sẵn vs. cấu hình tùy chỉnh
Template trên marketplace hoạt động tốt cho việc tìm doanh nghiệp — scrape hồ sơ công ty trong các danh mục của Trustpilot. Nếu muốn trích xuất review tùy chỉnh, Sitemap Wizard cho phép bạn dựng scraper trực quan ngay trong Chrome extension.
Hướng dẫn tháng 3/2026 của Web Scraper khuyến nghị dùng click pagination bằng JavaScript thay vì phân trang theo URL, vì Trustpilot có thể sắp xếp lại nội dung một cách động giữa các trang, làm kết quả bị lệch.
Xử lý bức tường đăng nhập và chống bot
Nói thẳng thì: hướng dẫn chính thức của Web Scraper nêu rõ Trustpilot chỉ cho xem 10 trang review đầu tiên trước khi hiện lời nhắc đăng nhập. Họ ghi nhận đây là một giới hạn đã biết, chứ không đưa ra cách обход.
- Bức tường đăng nhập: hỗ trợ hạn chế. Giới hạn 10 trang review được chính tài liệu của họ ghi rõ.
- Chống bot: các gói cloud có hỗ trợ proxy; hướng dẫn khuyến nghị chờ 2–5 giây và giảm độ đồng thời.
- Phân trang: có thể cấu hình, nhưng trên thực tế bị giới hạn ở 10 trang review đầu tiên nếu không xác thực.
Giá
- Tiện ích Chrome miễn phí: scrape cục bộ, chức năng hạn chế
- Project: $50/tháng (5.000 URL credits)
- Professional: $100/tháng (20.000 URL credits)
- Scale: từ $200/tháng (URL credits không giới hạn có điều kiện)
- Dùng thử miễn phí 7 ngày trên các gói cloud trả phí
- Xuất dữ liệu: CSV, XLSX
Phù hợp nhất cho: Người dùng muốn có template sẵn để scrape hồ sơ doanh nghiệp Trustpilot, hoặc chỉ cần review từ 10 trang đầu tiên. Không phù hợp nếu bạn cần lịch sử review đầy đủ của các doanh nghiệp có nhiều review.
5. ScraperAPI
ScraperAPI là hạ tầng scrape dành cho developer — không phải công cụ bấm-chọn, mà là lớp proxy/render giúp xử lý chống bot trong khi bạn tự viết logic parse. Trang giải pháp Trustpilot của họ quảng bá khả năng render JS, xử lý CAPTCHA và hơn 40 triệu proxy.
Nếu bạn là developer Python muốn toàn quyền kiểm soát logic trích xuất, ScraperAPI sẽ lo phần hạ tầng.
Nhưng bạn cũng sẽ phải tự gánh phần bảo trì.
Tự xây scraper Trustpilot với ScraperAPI
Hướng dẫn tháng 1/2026 của ScraperAPI minh họa workflow Python + BeautifulSoup:
import requests
from bs4 import BeautifulSoup

payload = {
    "api_key": "YOUR_API_KEY",
    "url": "https://www.trustpilot.com/review/example.com",
    "render": "true",
    "keep_headers": "true",
}

html = requests.get("https://api.scraperapi.com", params=payload).text
soup = BeautifulSoup(html, "html.parser")
Đoạn code hoàn chỉnh trong tutorial đặt pages_to_scrape = 10 — ngầm thừa nhận giới hạn trang công khai. Với trang 10+, developer phải tự quản lý session đăng nhập, cookie và token.
Xử lý bức tường đăng nhập và chống bot
- Bức tường đăng nhập: cần quản lý session/cookie ở mức code. ScraperAPI xử lý proxy và render; bạn xử lý logic xác thực.
- Chống bot: pool proxy residential với xoay IP tự động, render JS qua
render=true, xử lý CAPTCHA bằng xoay proxy thông minh. Có ở mọi gói. - Bảo trì: khi Trustpilot đổi class name (điều này xảy ra khá thường xuyên), bạn phải tự cập nhật code parse. Selector
styles_reviewCardInner__EwDq2trong tutorial đã là một quả bom hẹn giờ.
Giá
- Dùng thử 7 ngày: 5.000 API credits miễn phí, không cần thẻ tín dụng
- Hobby: $49/tháng (100.000 API credits)
- Startup: $149/tháng (1.000.000 credits)
- Business: $299/tháng (3.000.000 credits)
- Xuất dữ liệu: do code của bạn tạo ra (thường là CSV, JSON, ghi vào database)
Phù hợp nhất cho: Developer muốn tùy biến hoàn toàn, có thể tự duy trì script parse của mình, và cần kiểm soát được session, logic phân trang và cấu trúc dữ liệu bằng code. Không dành cho người dùng không kỹ thuật.
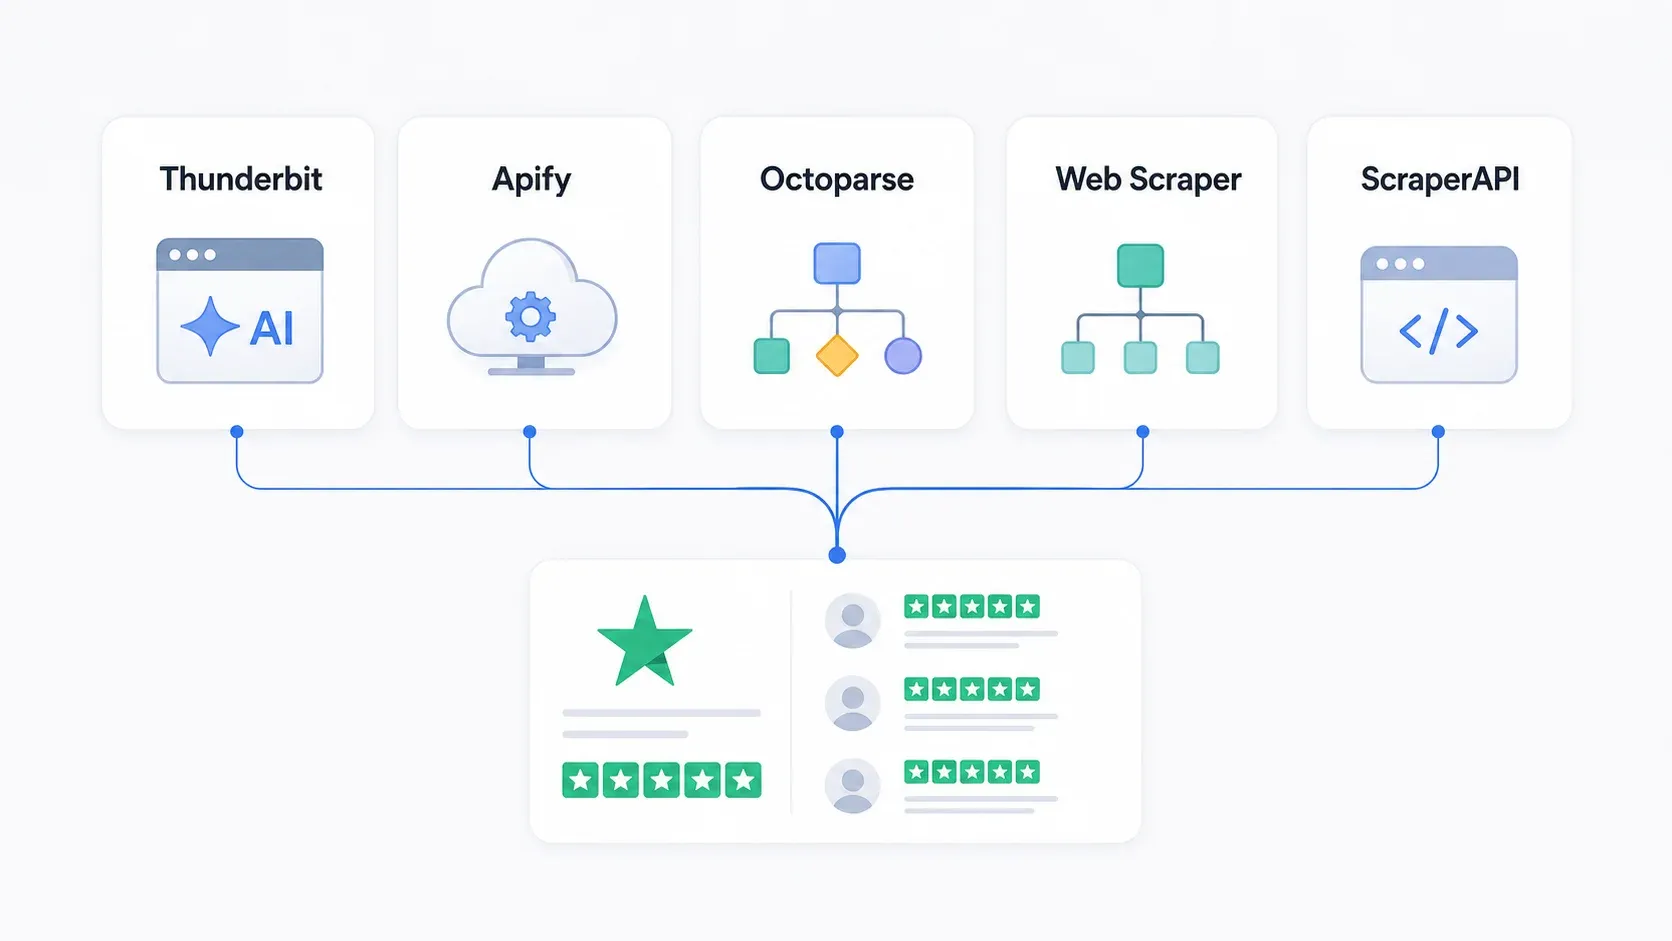
Vì sao scraper Trustpilot cứ hỏng hoài (và cách chọn công cụ ít bị hỏng hơn)
Đây là yếu tố thường bị đánh giá thấp nhất khi chọn scraper Trustpilot. Câu hỏi không phải là “công cụ này có chạy được hôm nay không?” mà là “nó có còn chạy được sau 3 tuần nữa không?”
Scraper hay hỏng trên Trustpilot vì 4 lý do lặp đi lặp lại:
-
Class CSS được sinh tự động thay đổi. CSS modules của Next.js tạo ra các class như
styles_reviewCardInner__EwDq2. Những class này đổi mỗi lần frontend được triển khai. Bất kỳ scraper nào nhắm vào các class này đều sẽ hỏng. -
Cấu trúc DOM thay đổi. Trustpilot có thể sắp xếp lại cấu trúc HTML — lồng review card theo cách khác, đổi wrapper, hoặc chuyển metadata sang vị trí khác.
-
Ngưỡng chống bot thay đổi. Ngưỡng reCAPTCHA có thể dịch chuyển. Việc xoay token phiên có thể mạnh tay hơn. Quy tắc lọc CDN cũng có thể được cập nhật.
-
Thay đổi về xác thực/phiên đăng nhập. Bức tường đăng nhập ở trang 10 được giới thiệu (hoặc được siết chặt hơn) vào cuối năm 2025. Những giới hạn truy cập khác hoàn toàn có thể xuất hiện bất cứ lúc nào.
Khác biệt kiến trúc cốt lõi nằm giữa trích xuất dựa trên selector và trích xuất theo ngữ nghĩa:
-
Công cụ dựa trên selector (Apify Actors, workflow Octoparse, script ScraperAPI, sitemap Web Scraper) hỏi: “Hãy tìm phần tử nằm đúng tại đường dẫn CSS này.” Khi đường dẫn đổi, chúng sẽ lỗi âm thầm hoặc trả về dữ liệu rỗng.
-
Công cụ semantic/AI (Thunderbit) hỏi: “Hãy tìm nội dung review, điểm số và ngày tháng trên trang này.” AI diễn giải nội dung theo ý nghĩa chứ không theo địa chỉ. Bố cục thay đổi không làm nó hỏng vì ý nghĩa của dữ liệu vẫn vậy.
Khuyến nghị của tôi:
- Gần như không muốn bảo trì? → Dùng AI (Thunderbit)
- Chấp nhận bảo trì chút ít, muốn tự động hóa trên cloud? → Apify (chọn Actor phù hợp và theo dõi)
- Muốn kiểm soát bằng giao diện trực quan, bảo trì mức vừa? → Octoparse
- Muốn làm theo template, phạm vi hẹp? → Web Scraper
- Muốn toàn quyền kiểm soát, tự làm mọi thứ? → ScraperAPI
Làm gì với dữ liệu review Trustpilot đã scrape
Trích xuất review mới chỉ là bước đầu. Câu hỏi tôi thường thấy trên các diễn đàn là: “Tôi có dữ liệu rồi — giờ làm gì tiếp?”
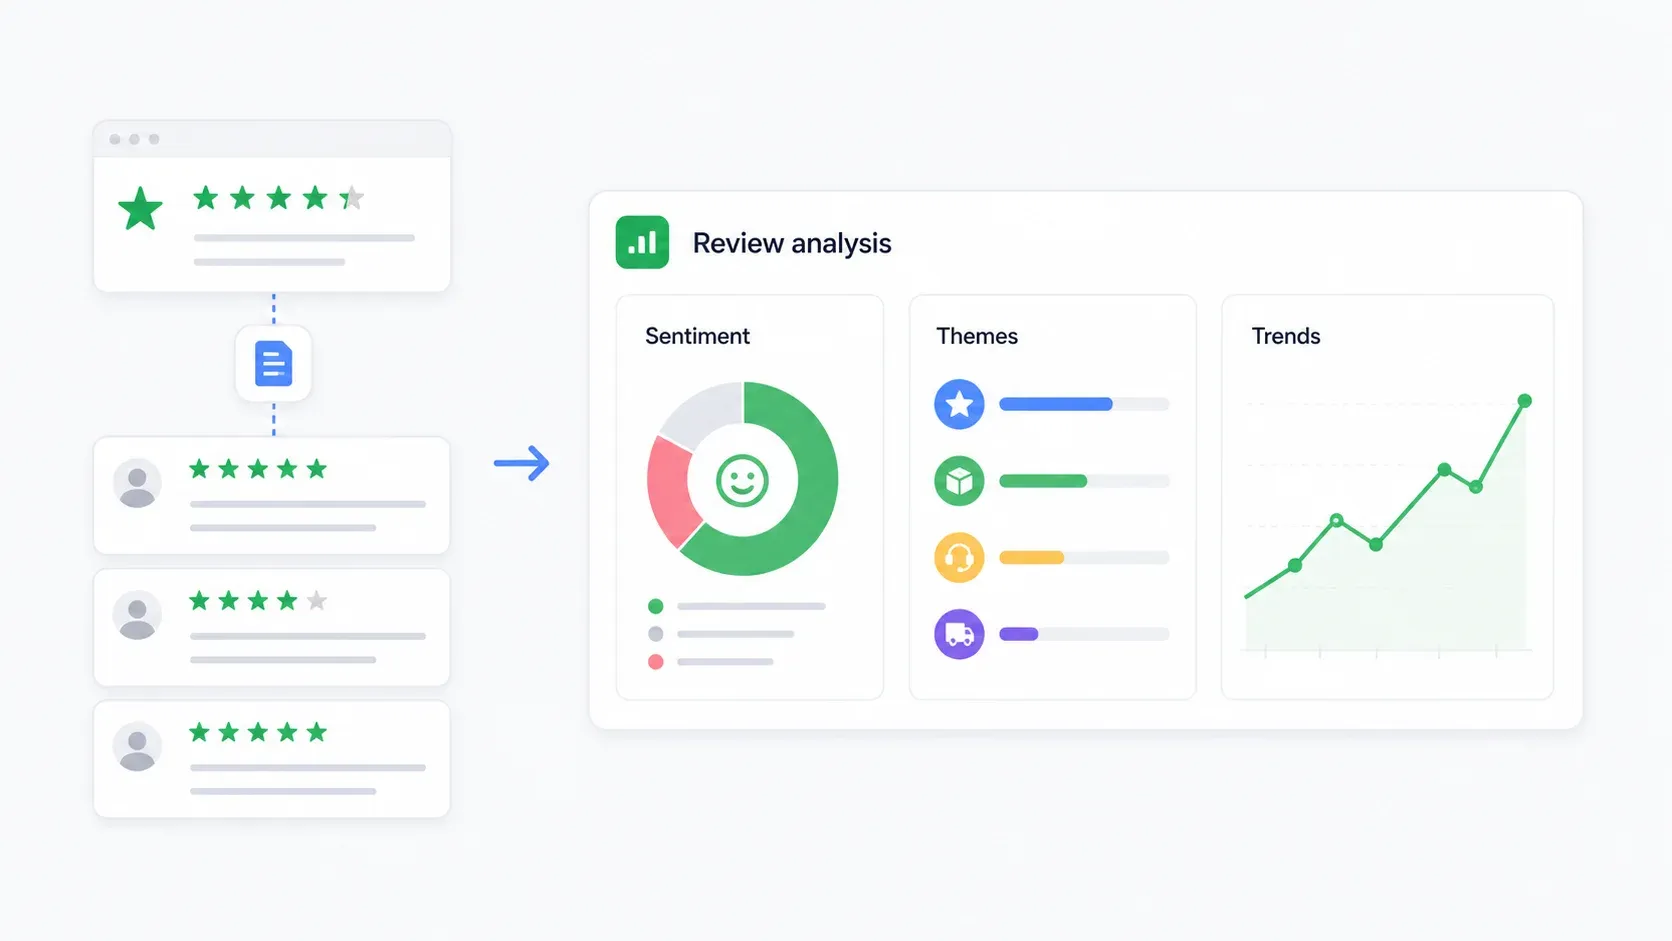
Phân tích cảm xúc
Workflow đơn giản nhất: xuất review sang Google Sheets, rồi dùng một công cụ AI (ChatGPT, Claude, hoặc hàm AI trong Sheets) để phân loại từng review là tích cực, trung tính hay tiêu cực. Thêm các cột cho nhóm khiếu nại, mức độ khẩn cấp và mức ưu tiên hành động đề xuất.
Với bộ dữ liệu lớn hơn, hãy upload file CSV lên ChatGPT và yêu cầu tóm tắt: “Phân loại các review này theo cảm xúc và xác định 5 chủ đề khiếu nại lớn nhất kèm trích dẫn đại diện.”
Theo dõi đối thủ
Dùng tính năng scheduled scraping của Thunderbit để kéo review của đối thủ hàng tuần hoặc hàng tháng. Theo dõi:
- Xu hướng điểm trung bình theo thời gian
- Tỷ lệ review 1 sao và 2 sao
- Mức thay đổi số lượng review (họ đang nhận nhiều hay ít review hơn?)
- Các chủ đề khiếu nại phổ biến nhất
- Tỷ lệ và tốc độ phản hồi của doanh nghiệp
Một dashboard Google Sheets đơn giản với pivot table theo điểm và ngày tháng sẽ cho bạn một nguồn tình báo cạnh tranh tự cập nhật.
Trích xuất chủ đề
Nhóm review theo các danh mục phổ biến: giao hàng/vận chuyển, hỗ trợ khách hàng, hoàn tiền, chất lượng sản phẩm, thanh toán, mức độ dễ dùng của ứng dụng, giá trị so với chi phí, và lo ngại về gian lận. Kết quả nên là một bảng gồm: chủ đề, số lượng, điểm trung bình, trích dẫn đại diện và hành động doanh nghiệp được đề xuất.
Cách này hữu ích hơn word cloud. Nó cho bạn biết điều gì thực sự đang tạo ra sự hài lòng hay không hài lòng.
Phân tích hàng loạt nhiều doanh nghiệp
Đối với nghiên cứu ở cấp danh mục, hãy scrape review của nhiều doanh nghiệp trong cùng một danh mục Trustpilot. So sánh khối lượng review, điểm số, phân bố số sao và mức độ xuất hiện của từng chủ đề trên toàn bộ một phân khúc thị trường. Template danh sách doanh nghiệp của Web Scraper hữu ích cho việc tìm công ty; Thunderbit hoặc ScraperAPI có thể xử lý sampling ở cấp review cho từng công ty.
Các cân nhắc pháp lý và đạo đức khi scrape Trustpilot
Tôi không phải luật sư, và đây không phải là tư vấn pháp lý. Nhưng thực tế về tuân thủ ở đây rất quan trọng.
Điều khoản sử dụng của Trustpilot rất rõ ràng. Họ cấm người dùng truy cập hoặc thu thập nội dung “bằng bất kỳ phương thức nào khác ngoài những gì được cung cấp hoặc được Trustpilot chấp thuận rõ ràng,” và nêu cụ thể việc text mining, data mining và web scraping nếu không có sự cho phép rõ ràng.
Mức độ rủi ro có thể hình dung như sau:
- Rủi ro thấp hơn: Xuất review của chính công ty bạn để phân tích nội bộ, đặc biệt khi dùng công cụ chính thức của Trustpilot cho doanh nghiệp hoặc API.
- Rủi ro trung bình: Scrape các trang công khai của đối thủ ở quy mô nhỏ cho mục đích nghiên cứu thị trường. Vẫn chịu ràng buộc bởi Điều khoản sử dụng và nghĩa vụ về quyền riêng tư.
- Rủi ro cao hơn: Scrape nội dung phía sau lớp đăng nhập ở trang 10+, vượt qua các biện pháp kỹ thuật, phân phối lại dữ liệu người đánh giá, hoặc dùng review đã scrape để huấn luyện mô hình AI.
Lưu ý GDPR: Tên người đánh giá, link profile, nội dung review và dữ liệu vị trí có thể được xem là dữ liệu cá nhân theo luật quyền riêng tư của EU. Các biện pháp an toàn thực tế gồm: chỉ thu thập trường thực sự cần thiết, băm tên người đánh giá cho phân tích nội bộ, đặt thời hạn lưu trữ dữ liệu, và không tái xuất bản nội dung review thô ở quy mô lớn.
Dữ liệu công khai vs. dữ liệu xác thực: Có một khác biệt pháp lý và đạo đức đáng kể giữa việc scrape những trang ai cũng xem được (10 trang review đầu tiên) và dữ liệu nằm sau bức tường xác thực. Những công cụ chỉ làm việc với dữ liệu công khai thường có rủi ro tuân thủ thấp hơn so với công cụ cần thông tin đăng nhập.
Đây nên là một yếu tố trong quyết định chọn công cụ của bạn. Chế độ browser của Thunderbit làm việc với các trang đang hiển thị trong phiên của chính bạn — nó không tự ý vượt qua xác thực. ScraperAPI cho developer toàn quyền kiểm soát, nhưng đồng thời cũng đặt toàn bộ trách nhiệm về tính hợp pháp của quản lý session lên bạn.
Cách chọn scraper review Trustpilot phù hợp
Khung ra quyết định theo từng nhóm người dùng:
- Marketer không rành kỹ thuật nhưng cần review mà không dùng code? → Thunderbit. Một cú nhấp, AI xử lý phần còn lại, xuất sang Sheets/Notion/Airtable.
- Người dùng low-code thoải mái với cấu hình và debug? → Apify. Chọn Actor, cấu hình cookie cho trang 10+, theo dõi lỗi.
- Người thích dựng workflow bằng giao diện trực quan? → Octoparse. Thiết lập bấm-chọn, nhưng hãy chuẩn bị bảo trì khi Trustpilot thay đổi.
- Cần dữ liệu ở cấp doanh nghiệp hoặc chỉ lấy 10 trang đầu? → Web Scraper. Template dựng sẵn rất mạnh cho hồ sơ doanh nghiệp.
- Developer muốn tùy biến toàn diện? → ScraperAPI. Tự quản lý logic parse, session và pipeline dữ liệu.
Nếu mức chịu đựng bảo trì là ưu tiên số một, thang lựa chọn sẽ chạy từ Thunderbit (gần như không cần bảo trì) tới ScraperAPI (bạn phải tự bảo trì mọi thứ). Về ngân sách, mọi công cụ trong danh sách này đều có điểm bắt đầu miễn phí — hãy thử trước khi cam kết.
Kết luận
Dữ liệu review Trustpilot thực sự rất giá trị cho tình báo cạnh tranh, theo dõi danh tiếng và hiểu khách hàng.
Nhưng trong năm 2026, muốn trích xuất ổn định thì bạn cần một công cụ có thể xử lý bức tường đăng nhập ở trang 10, thích nghi với thay đổi DOM và quản lý chống bot mà không phải can thiệp thủ công liên tục.
Với hầu hết người dùng doanh nghiệp, Thunderbit là con đường ít trở ngại nhất — một cú nhấp, tự nhận diện trường bằng AI, chế độ browser cho trang cần đăng nhập, và không phải bảo trì gì khi Trustpilot đổi frontend. Bạn có thể dùng thử miễn phí với 6 trang/tháng và không cần thẻ tín dụng.
Với developer muốn toàn quyền kiểm soát, ScraperAPI cung cấp hạ tầng phù hợp. Với những người ở giữa, Apify, Octoparse và Web Scraper mỗi công cụ phục vụ một ngách riêng. Điều quan trọng là ghép đúng công cụ với mức độ thoải mái về kỹ thuật, khả năng chấp nhận bảo trì và yêu cầu tuân thủ của bạn.
Nếu bạn muốn xem Thunderbit xử lý Trustpilot cụ thể ra sao, chúng tôi có video hướng dẫn trên kênh YouTube. Còn nếu bạn muốn bối cảnh rộng hơn về web scraping không cần code hoặc web scraping thực chất là gì, các bài viết đó sẽ giải thích rất nền tảng.
Câu hỏi thường gặp
1. Có thể scrape review Trustpilot sau trang 10 không?
Có, nhưng chỉ khi có đường truy cập đã xác thực. Trustpilot chặn truy cập chưa đăng nhập sau 10 trang review đầu tiên. Chế độ browser của Thunderbit hoạt động trong phiên Chrome đã đăng nhập của bạn, nên có thể truy cập những trang bạn nhìn thấy. ScraperAPI cần quản lý session/cookie ở mức code. Apify Actors cần cấu hình cookie. Octoparse cần thiết lập đăng nhập/cookie thủ công. Tài liệu của Web Scraper cũng thừa nhận giới hạn 10 trang mà không đưa ra cách xử lý sẵn có.
2. Scrape review Trustpilot có hợp pháp không?
Điều khoản sử dụng của Trustpilot cấm thu thập dữ liệu tự động nếu không có sự cho phép rõ ràng. Mức rủi ro pháp lý thay đổi theo phương thức và mục đích sử dụng: scrape review công khai của chính bạn thường ít rủi ro hơn việc vượt qua cổng xác thực để lấy dữ liệu đối thủ. GDPR cũng áp dụng với dữ liệu người đánh giá ở EU. Đây không phải tư vấn pháp lý — hãy hỏi luật sư nếu bạn làm scraping quy mô lớn hoặc cho mục đích thương mại.
3. Có thể trích xuất những dữ liệu nào từ Trustpilot?
Các trường phổ biến gồm: tên người đánh giá, số sao, tiêu đề review, nội dung review, ngày đăng, ngày trải nghiệm, trạng thái mua hàng đã xác minh, vị trí người đánh giá, nội dung phản hồi của doanh nghiệp, tên công ty, TrustScore, tổng số review, phân bố số sao và URL review.
4. Scraper Trustpilot thường hỏng bao lâu một lần?
Các công cụ dựa trên selector (Apify Actors, workflow Octoparse, script Python tự viết) có thể hỏng bất cứ khi nào Trustpilot đổi class CSS hoặc cấu trúc DOM — điều này có thể xảy ra nhiều lần mỗi tháng. Công cụ AI-semantic như Thunderbit tự thích nghi vì chúng hiểu ý nghĩa của trang thay vì nhắm vào selector cụ thể. Tuy nhiên, không có công cụ nào miễn nhiễm với những thay đổi lớn về kiểm soát truy cập như bức tường đăng nhập ở trang 10.
5. Có thể scrape review Trustpilot miễn phí không?
Mỗi công cụ trong danh sách này đều có điểm bắt đầu miễn phí: Thunderbit có 6 trang miễn phí/tháng, ScraperAPI tặng 5.000 credit dùng thử trong 7 ngày, Web Scraper có tiện ích Chrome miễn phí để dùng cục bộ, Octoparse có gói miễn phí vĩnh viễn (10 tasks, 50.000 dòng/tháng), và Apify có $5/tháng credit nền tảng miễn phí. Với nhu cầu thử nghiệm hoặc lấy mẫu nhỏ, bất kỳ công cụ nào trong số này cũng có thể dùng mà không cần trả phí.
Thử Thunderbit để scrape review Trustpilot Get Started Free
Tìm hiểu thêm



