
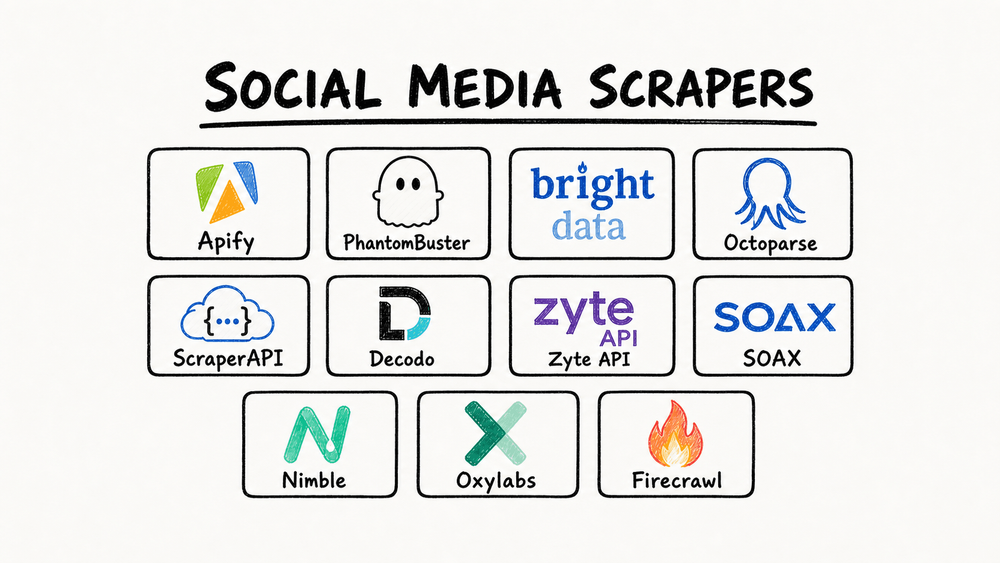
Tính đến tháng 4 năm 2026, thế giới có 5,79 tỷ danh tính người dùng mạng xã hội. Đây là một kho dữ liệu công khai khổng lồ — hồ sơ, bài đăng, bình luận, chỉ số của nhà sáng tạo — đang nằm sẵn ở đó, chờ được biến thành lead, insight cạnh tranh và thông tin thị trường.
Vấn đề là gì? Tất cả các nền tảng mạng xã hội lớn đều đã bắt đầu phản kháng. Instagram, LinkedIn, TikTok và Facebook đều đầu tư mạnh vào hệ thống chống bot, giới hạn tần suất và công nghệ nhận diện dấu vân tay trình duyệt. Tôi đã chứng kiến nhiều team trong thế giới SaaS mất hàng tuần xây scraper, để rồi chỉ cần một lần nền tảng cập nhật là mọi thứ vỡ tan. Những script chạy ngon lành tháng trước, hôm nay chỉ còn trả về trang chặn. Và nếu bạn chọn sai công cụ — hoặc dùng đúng công cụ theo cách sai — tài khoản sẽ bị gắn cờ, IP bị chặn, và đường ống dữ liệu của bạn sẽ chậm như rùa bò.
Vì vậy, tôi đã tổng hợp bài hướng dẫn này về 11 công cụ thu thập dữ liệu mạng xã hội tốt nhất năm 2026, không chỉ dựa trên tính năng và giá, mà còn dựa trên điều quan trọng nhất: bạn có thể tiếp tục scraping mà không bị khóa hay không? Dù bạn là marketer, developer đang xây AI agent, hay team dữ liệu ở doanh nghiệp, ở đây đều có một công cụ phù hợp với quy trình làm việc và mức chịu rủi ro của bạn.
Điều gì tạo nên một Social Media Scraper tốt nhất (và vì sao đa số công cụ lại khiến bạn bị khóa)
Không phải scraper nào cũng sống sót khi dùng thực tế trên những nền tảng có cơ chế chống bot gắt gao. Tôi đã thấy rất nhiều công cụ nhìn cực ổn trong demo, nhưng vừa thử scrape 500 hồ sơ Instagram hoặc phân trang qua kết quả tìm kiếm LinkedIn là hỏng ngay. Khi đánh giá 11 công cụ này, tôi tập trung vào 9 yếu tố thực sự quan trọng đối với việc thu thập dữ liệu mạng xã hội:
| Tiêu chí | Vì sao quan trọng |
|---|---|
| Nền tảng được hỗ trợ | Instagram, LinkedIn, TikTok, X/Twitter, YouTube, Facebook — không phải công cụ nào cũng hỗ trợ hết |
| No-code vs API vs Code | Phù hợp với từng nhóm người dùng (marketer, developer hay enterprise) |
| Tính năng chống khóa / chống bot | Xử lý CAPTCHA, xoay proxy, quản lý fingerprint, xử lý session |
| Gói miễn phí / credit miễn phí | Nhiều người muốn thử trước khi quyết định mua |
| Giá (quy đổi theo 1K request) | Mỗi nhà cung cấp tính theo credit, page, row, compute unit hoặc GB — rất khó so sánh trực tiếp |
| Tùy chọn xuất dữ liệu | CSV, JSON, Excel, Google Sheets, Airtable, Notion |
| Xử lý AI sau khi scraping | Gắn nhãn, phân loại, dịch ngay lúc trích xuất |
| Lập lịch / scraping định kỳ | Theo dõi liên tục, không chỉ xuất một lần |
| Dễ thiết lập (thời gian đến lần scrape đầu tiên) | Cực kỳ quan trọng với người không chuyên kỹ thuật |
Việc thu thập dữ liệu mạng xã hội khó hơn hẳn hầu hết website khác. Bạn phải đối mặt cùng lúc với nội dung JavaScript động, tường đăng nhập, giới hạn tốc độ truy cập, thay đổi giao diện thường xuyên và các hệ thống chống bot có khả năng nhận diện fingerprint.
Mẫu lỗi điển hình thì rất quen thuộc: script chạy ngon trên trang công khai, nhưng hỏng ở bước phân trang. Selector ngừng khớp sau khi giao diện được thiết kế lại. Hoặc bạn bắt đầu gặp màn CAPTCHA thay vì dữ liệu.
Đó là lý do danh sách này ưu tiên độ tin cậy chống khóa và chi phí bảo trì hơn là số lượng tính năng thuần túy.
Và nhu cầu kinh doanh là có thật. Báo cáo State of Sales 2025 của HubSpot cho thấy 35% đội sales coi mạng xã hội là nguồn lead chất lượng cao hàng đầu, và 42% cho rằng social mang lại tỷ lệ phản hồi cold outreach cao nhất. Nếu bạn chưa đưa dữ liệu social vào quy trình làm việc, bạn đang bỏ lỡ tiền bạc.
Social Media Scraper nào thắng trên từng nền tảng? Bảng chọn công cụ tốt nhất
Một điều tôi nhận ra khi nghiên cứu bài này là gần như chẳng ai map công cụ theo từng nền tảng mạng xã hội cụ thể. Trong khi đó, người dùng trên các diễn đàn cứ liên tục hỏi “tool nào scrape Instagram tốt nhất?” hay “cái gì thực sự hoạt động trên LinkedIn?” — và điều đó hoàn toàn có lý do. Mỗi nền tảng gặp lỗi vì những nguyên nhân khác nhau.
| Nền tảng | Độ khó | Lựa chọn hàng đầu | Vì sao |
|---|---|---|---|
| 🔴 Khó | Apify, Bright Data, Decodo | Chống bot mạnh, khó login, giới hạn tốc độ, render JS nặng | |
| 🔴 Rất khó | PhantomBuster, Bright Data | Bị chặn sau đăng nhập, hồ sơ riêng tư, rất nhạy cảm với nguy cơ khóa tài khoản | |
| TikTok | 🔴 Khó | Apify, Bright Data, Zyte | Giao diện thay đổi nhanh, nội dung động, áp lực chống bot cao |
| X / Twitter | 🟡 Trung bình | Apify, Firecrawl, ScraperAPI | Nội dung công khai vẫn truy cập được, nhưng vẫn có rate limit và chống bot |
| YouTube | 🟢 Dễ hơn | Apify, Firecrawl | Phần lớn nội dung là công khai và cấu trúc khá ổn định |
| Facebook Groups | 🔴 Rất khó | PhantomBuster | Cần đăng nhập, phụ thuộc session, rất nhạy với hành vi tự động hóa |
Với những nền tảng yêu cầu đăng nhập như LinkedIn hay Facebook Groups, browser-based scraping — tức công cụ dùng chính phiên đăng nhập trình duyệt của bạn — thường là cách đáng tin cậy nhất. Các cloud scraper либо không nhìn thấy nội dung, либо kích hoạt cơ chế khóa quá nhanh. Session của bạn, cookie của bạn, quyền truy cập của bạn — scraper chỉ đọc những gì bạn vốn đã thấy.
Cẩm nang sinh tồn chống khóa: Scrape mạng xã hội thế nào để không bị chặn
Đây là phần tôi ước gì mình đã có khi mới bắt đầu làm công cụ dữ liệu web. Phần lớn bài listicle chỉ tick vào ô “hỗ trợ CAPTCHA ✅, xoay IP ✅” rồi kết thúc. Nhưng câu hỏi thật sự là: làm sao để tránh bị khóa trong thực tế?
Các hệ thống chống bot năm 2026 không nhìn một tín hiệu đơn lẻ. Chúng chấm điểm đồng thời tốc độ request, uy tín IP, hành vi session, độ nhất quán của trình duyệt, và ngữ cảnh đăng nhập. Báo cáo bot security 2025 của DataDome cho thấy chỉ 2,8% website được kiểm thử là được bảo vệ hoàn toàn — nhưng những bot né phát hiện thành công ngày càng phụ thuộc vào browser automation, residential IP và chiến lược fingerprint tinh vi. Báo cáo device intelligence 2026 của Fingerprint bổ sung rằng 4,4% nhận diện trên desktop có dấu hiệu trình duyệt bị can thiệp, và 96% hành vi automation desktop bị phát hiện có liên quan đến mô hình lạm dụng.
Cách làm thực tế sẽ như sau:
Giới hạn tốc độ và nhịp request theo từng nền tảng
Không có một mức RPM “an toàn” chung cho mọi nền tảng social, nhưng kinh nghiệm cộng đồng thường là: đi chậm, tránh spam theo đợt, và giữ session thật nhất quán. Các trang trợ giúp của Pinterest là một mô hình hữu ích — họ cảnh báo rõ về hành động lặp lại và lưu lượng từ mạng dùng chung.
| Nền tảng | Khuyến nghị nhịp truy cập |
|---|---|
| Chậm và thận trọng nhất; session trình duyệt và quota theo ngày quan trọng hơn RPM thuần túy | |
| Facebook Groups | Rất thận trọng; tránh hoàn toàn kiểu truy cập dồn dập |
| Thận trọng; trang công khai dễ hơn các thao tác gắn với tài khoản | |
| TikTok | Trung bình; nội dung công khai dễ hơn quy trình cần xác thực |
| X / Twitter | Trung bình; có API thay thế và trang công khai, nhưng rate limit vẫn rất đáng lưu ý |
| YouTube | Dễ chịu hơn với trang công khai, nhưng vẫn nên điều tiết khi phân trang |
Residential proxy vs. datacenter proxy: Khi nào nên dùng loại nào
Kinh tế proxy hiện nay đã đủ rõ để có thể tóm gọn như sau:
- Dùng residential proxy cho LinkedIn, Facebook, Instagram và các nền tảng nhạy cảm khác. Chúng giống lưu lượng người dùng thật hơn và khó bị hệ thống chống bot phát hiện hơn nhiều.
- Dùng datacenter proxy hoặc proxy tiêu chuẩn cho các mục tiêu công khai dễ hơn (YouTube, bài đăng X công khai) hoặc khi test ít rủi ro mà chi phí quan trọng hơn tính ẩn danh.
- Dùng managed scraping API khi bạn không muốn tự xây logic proxy, retry và fingerprint.
Để tham khảo, bảng giá hiện tại của Decodo cho thấy $0,50/1K request thường, $0,75/1K có JS, $2,00/1K với premium proxy, và $2,50/1K cho premium + JS. Web Data API của SOAX bắt đầu khoảng $2,30/1K request ở gói nhập môn. Oxylabs định giá target chung khoảng $1,15/1K không có JS và $1,35/1K có JS. Bài học rút ra: “scraping rẻ” sẽ tăng chi phí rất nhanh khi cần render JavaScript và dùng pool IP mạnh hơn.
Vì sao scraper dựa trên AI sống lâu hơn công cụ CSS selector truyền thống
Đây là điều tôi rất tin, sau khi chứng kiến nhiều team vật lộn với selector hỏng suốt nhiều năm. Scraper truyền thống thường bị overfit vào một DOM cố định. Nền tảng mạng xã hội không chỉ đổi tên class — họ còn đổi cấu trúc card, cách lazy-load, và cả UX xác thực. Điều đó khiến tool chỉ dựa trên selector trở nên rất mong manh.
Scraper dựa trên AI tiếp cận khác đi: thay vì hardcode selector trước, chúng đọc trang và tự đề xuất field theo cấu trúc hiện tại, rồi có thể mở rộng sang các trang con nếu cần. Khi nền tảng cập nhật giao diện, AI sẽ đọc lại trang và thích nghi. Với team không chuyên kỹ thuật, khác biệt giữa hai cách này chính là “scraper lại hỏng rồi” và “nó cứ thế mà chạy”.
Khung quyết định rất đơn giản:
- Cloud scraping cho dữ liệu công khai khi cần tốc độ
- Browser scraping cho nền tảng yêu cầu đăng nhập, nơi ngữ cảnh session là bắt buộc
1. Apify
 Apify là lựa chọn marketplace cloud linh hoạt nhất vì nó kết hợp hệ sinh thái actor rộng, lịch chạy, dataset, truy cập API và các hook tự động hóa. Có thể hiểu nó như một app store cho scraper: có hàng chục nghìn “Actor” dựng sẵn, nhiều cái chuyên cho Instagram, TikTok, LinkedIn, YouTube và X.
Ưu thế thật sự của Apify nằm ở độ phủ. Chỉ riêng nhóm Pinterest đã có nhiều actor đang hoạt động, xử lý board, profile, tìm kiếm, bình luận hoặc pin. Mẫu hình này lặp lại ở hầu hết các nền tảng social lớn. Đổi lại, chất lượng actor sẽ phụ thuộc vào từng nhà phát hành — “Apify” không phải một scraper duy nhất mà là marketplace các sản phẩm scraping, nên mức độ bảo trì giữa các actor không đồng đều.
Tính năng nổi bật
- Marketplace actor lớn với scraper theo từng nền tảng
- Lịch chạy trên cloud và dataset API
- Nhiều định dạng xuất dữ liệu (JSON, CSV, Excel, API)
- Webhook và hook tự động hóa
- Thiết lập từ no-code đến low-code tùy actor
Giá
Giá Apify bắt đầu từ gói Free (credit $5/tháng), sau đó là Starter $29/tháng, Scale $199/tháng, và Business $999/tháng. Mô hình tính theo compute unit có thể hơi khó hiểu vì mỗi actor tiêu credit ở mức khác nhau.
Phù hợp nhất cho: Người muốn dùng sẵn một cloud scraper cho nền tảng cụ thể mà không cần xây từ đầu.
Ưu và nhược điểm
- Ưu điểm: Thư viện cực lớn, mở rộng tốt, tài liệu mạnh, rất hợp với các actor social dựng sẵn
- Nhược điểm: Chất lượng actor không đồng đều, giá theo compute unit dễ gây rối, có thể hơi quá tay cho việc scrape hồ sơ đơn giản
2. PhantomBuster
 PhantomBuster nằm giữa scraping và tự động hóa outbound. Điểm mạnh nhất của nó là không chỉ lấy dữ liệu — mà còn biến dữ liệu đó thành quy trình tạo lead hoặc outreach. Scrape hồ sơ LinkedIn, rồi tự động gửi lời mời kết nối. Lấy followers Instagram, rồi xuất ra để làm email outreach.
PhantomBuster dùng session cookie để hành động thay mặt người dùng, và chạy theo lịch trên cloud. Công ty còn công bố tài liệu chi tiết về giới hạn tốc độ theo từng nền tảng để giúp người dùng tránh bị khóa — điều này tự nó đã cho thấy rủi ro thực tế lớn đến mức nào.
Tính năng nổi bật
- Hơn 100 Phantom cho LinkedIn, Instagram, X/Twitter, Facebook
- Ghép workflow (kết hợp scraping với hành động outreach)
- Lập lịch chạy trên cloud
- Xuất CSV, JSON và tích hợp API
- Credit xử lý CAPTCHA trên gói trả phí
Giá
PhantomBuster cung cấp bản dùng thử 14 ngày, sau đó là các gói trả phí theo mức sử dụng với thời gian thực thi, slot, AI credits và CAPTCHA credits. Tất cả gói trả phí đều có xuất CSV/JSON không giới hạn, truy cập API và tối đa 100 thành viên workspace.
Phù hợp nhất cho: Đội sales và marketing muốn kết hợp scraping mạng xã hội với outreach tự động.
Ưu và nhược điểm
- Ưu điểm: Rất trực quan cho lead gen, nhiều automation theo từng nền tảng, tài liệu tốt
- Nhược điểm: Có rủi ro với account/session nếu bỏ qua rate limit, quota thời gian thực thi có thể khá mơ hồ, kém linh hoạt nếu cần logic trích xuất tùy biến
3. Bright Data
 Bright Data là bộ stack enterprise hoàn chỉnh nhất trong danh sách này. Công ty định vị quanh hơn 20.000 khách hàng, hơn 400 triệu IP và uptime 99,99%. Họ cung cấp cả dataset dựng sẵn lẫn scraper API cho các mục tiêu social.
Bộ công cụ Pinterest là ví dụ rất rõ về độ sâu: có scraper API riêng, dataset riêng, xử lý anti-bot rõ ràng, và xuất sang JSON, NDJSON, CSV, XLSX, Parquet, cùng các đích lưu trữ cloud. Giá ở mức cao cấp nhưng minh bạch: Pinterest scraper khoảng $2,50/1K records theo mô hình pay-as-you-go, còn dataset bắt đầu từ $350/100K records.
Tính năng nổi bật
- Mạng proxy khổng lồ (400M+ IP, residential, datacenter, mobile)
- Bộ thu thập dữ liệu mạng xã hội dựng sẵn và datasets
- Web Scraper IDE để thiết lập no-code
- Xử lý CAPTCHA, chống phát hiện, geo-targeting
- Tích hợp sẵn khung tuân thủ và pháp lý
Giá
Mức cao cấp; có gói enterprise tùy chỉnh. Có giá pay-as-you-go và giá dataset cho từng mục tiêu social cụ thể.
Phù hợp nhất cho: Tổ chức lớn cần pipeline dữ liệu quy mô petabyte, tuân thủ chặt chẽ và uptime được đảm bảo.
Ưu và nhược điểm
- Ưu điểm: Hạ tầng proxy không đối thủ, độ tin cậy enterprise, dataset có sẵn giúp tiết kiệm thời gian, chú trọng compliance
- Nhược điểm: Giá cao, phức tạp với team nhỏ, đường cong học tập dốc
4. Octoparse
 Octoparse là công cụ scraper trực quan truyền thống dễ nhận diện nhất trong danh sách này. Nó có trình dựng workflow kiểu point-and-click rất thân thiện với người không chuyên — bạn chỉ cần click vào dữ liệu muốn lấy, và Octoparse sẽ tự tạo logic trích xuất.
Giá của Octoparse bắt đầu từ gói Free (10 task, 1 thiết bị, xuất 50K dữ liệu/tháng), sau đó là Standard $69/tháng và Professional $249/tháng. Tùy chọn xuất dữ liệu rất đa dạng: Excel, CSV, JSON, HTML, XML, Google Sheets và xuất sang database. Proxy và hỗ trợ CAPTCHA có thể mua thêm.
Tính năng nổi bật
- Trình dựng workflow trực quan (kéo-thả)
- Mẫu scraping dựng sẵn cho mạng xã hội
- Chạy trên cloud và local
- Scraping theo lịch và định kỳ
- Xoay IP tích hợp trong gói cloud
Phù hợp nhất cho: Người không chuyên kỹ thuật thích trình dựng workflow trực quan hơn là viết code.
Ưu và nhược điểm
- Ưu điểm: Giao diện trực quan, rất dễ cho người mới, template giúp khởi tạo nhanh, có lịch chạy
- Nhược điểm: Cần desktop app để dùng đầy đủ tính năng, có thể chậm với tác vụ lớn, xử lý AI sau scraping còn hạn chế so với công cụ mới hơn
5. ScraperAPI
 ScraperAPI là một trong những API dễ giải thích nhất: gửi một URL, nhận lại HTML hoặc JSON, còn dịch vụ sẽ lo việc xoay IP, render, retry và xử lý ban. Đây là công cụ dành cho developer đúng nghĩa.
Bảng giá hiện tại cho thấy dùng thử 7 ngày với 5.000 API credits, gói miễn phí 1.000 credits/tháng, rồi đến Hobby $49/tháng (100K credits), Startup $149/tháng (1M credits), và Business $299/tháng (3M credits). Điểm cần lưu ý là: mục tiêu có bảo vệ mạnh sẽ tiêu nhiều credit hơn, nên scraping mạng xã hội có thể tốn hơn bạn nghĩ ban đầu.
Tính năng nổi bật
- Tự động xoay IP và xử lý CAPTCHA
- Render JavaScript cho nội dung mạng xã hội động
- Tích hợp REST API đơn giản
- Geo-targeting (Mỹ, EU và nhiều nơi khác)
- Khả năng concurrency mở rộng
Phù hợp nhất cho: Developer muốn tích hợp HTTP/REST đơn giản mà không phải tự quản hạ tầng proxy.
Ưu và nhược điểm
- Ưu điểm: Rất ổn định, giá minh bạch, tích hợp API dễ, mở rộng tốt
- Nhược điểm: Cần biết code, không có giao diện no-code tích hợp sẵn, không có xử lý AI sau scraping
6. Decodo (trước đây là Smartproxy)
 Decodo (trước đây là Smartproxy) là lựa chọn đáng tiền trong danh sách này. Giá Web Scraping API của họ bắt đầu với gói miễn phí (2K request thường), sau đó là các mức $19/tháng, $49/tháng và $99/tháng, với chi phí request từ $0,50/1K request thường giảm còn khoảng $0,14/1K ở các tầng cao hơn. Các route có JS và premium proxy sẽ đắt hơn, nhưng nhìn chung vẫn cạnh tranh tốt.
Decodo cũng có bảng giá riêng cho social media với geo-targeting 195 vị trí và mô hình chỉ tính tiền khi request thành công. Các benchmark độc lập cho thấy tỷ lệ thành công 99%+ trên những target social như Instagram.
Tính năng nổi bật
- Social media scraper API với endpoint dựng sẵn
- Geo-targeting 195 vị trí
- Mô hình chỉ trả tiền cho request thành công
- Tích hợp xoay proxy và chống bot
- Dùng thử 100MB miễn phí
Phù hợp nhất cho: Người cần cân bằng giữa độ tin cậy, geo-targeting và hiệu quả chi phí.
Ưu và nhược điểm
- Ưu điểm: Rất đáng tiền, tỷ lệ thành công cao, geo-targeting rộng, dùng thử hào phóng
- Nhược điểm: Chỉ có API (cần chút kiến thức kỹ thuật), ít tùy chọn no-code, tốc độ phản hồi có thể chậm trên target phức tạp
7. Zyte API
 Zyte (trước đây là Scrapinghub, nhà sáng tạo Scrapy) là một trong những engine API-first mạnh nhất nếu bạn ưu tiên tự động hóa chống khóa và tốc độ. Giá của Zyte bắt đầu từ $0,06 cho mỗi 1.000 HTTP response thành công ở các mức cam kết cao hơn, và từ khoảng $0,13–$0,27/1K request theo mô hình pay-as-you-go, trong khi request render bằng browser dao động khoảng $1,01–$6,08/1K tùy độ khó. Zyte có credit miễn phí $5 khi đăng ký và chỉ tính phí cho response thành công.
Tính năng nổi bật
- Trích xuất tự động (đầu ra dữ liệu có cấu trúc bằng AI)
- Chống khóa thông minh với quản lý proxy và fingerprint
- Tốc độ phản hồi rất nhanh (thuộc nhóm nhanh nhất trong benchmark độc lập)
- Tích hợp Scrapy cho developer Python
- Định dạng đầu ra linh hoạt
Phù hợp nhất cho: Team cần scraping nhanh, ổn định với trích xuất tự động và chống phát hiện mạnh.
Ưu và nhược điểm
- Ưu điểm: Rất nhanh, công nghệ chống khóa mạnh, có tùy chọn auto-extraction bằng AI, tích hợp tốt với hệ sinh thái Scrapy
- Nhược điểm: Người không chuyên sẽ cần thời gian làm quen, chi phí có thể tăng nhanh ở quy mô lớn, giao diện no-code còn hạn chế
8. SOAX
 SOAX ngày càng được định vị như một Web Data API sẵn sàng cho AI hơn là chỉ một nhà cung cấp proxy. Công ty nói rằng họ có hơn 191 triệu IP tại hơn 195 quốc gia, tỷ lệ thành công trên 99,5%, và các gói Web Data API đi kèm bắt đầu từ $90/tháng (
$2,30/1K request), sau đó là $270/tháng ($2,25/1K), $740/tháng ($2,10/1K), và $1.600/tháng ($0,90/1K).
Tính năng nổi bật
- Tùy chọn proxy residential, mobile và datacenter
- Social media scraping API với tính năng chống khóa
- Geo-targeting đa quốc gia
- Truy cập dữ liệu thời gian thực
- Tích hợp qua API
Phù hợp nhất cho: Người muốn có proxy đa dạng và tính năng chống khóa ổn định mà không phải trả giá enterprise đầy đủ.
Ưu và nhược điểm
- Ưu điểm: Đa dạng proxy mạnh, tỷ lệ thành công tốt trên target social, geo-targeting linh hoạt
- Nhược điểm: Thiên về API (cần code), giá đôi khi khó hiểu, mức độ phổ biến với scraper chuyên social chưa bằng nhóm dẫn đầu
9. Nimble (trước đây là Nimbleway)
 Nimble là một nền tảng web intelligence với scraping bằng AI và đầu ra dữ liệu có cấu trúc. Bảng giá Nimble cho thấy bản dùng thử miễn phí với 5.000 trang web, sau đó các API Extract/Crawl/Map ở mức $0,90/1K URL cho trang tiêu chuẩn, $1,30/1K cho render JS, và $1,45/1K cho render + stealth. Agent API bắt đầu từ $3/1K trang được quét. Các gói platform kiểu enterprise bắt đầu quanh $7.000/tháng nếu thanh toán theo năm.
Tính năng nổi bật
- Phân tích và cấu trúc dữ liệu bằng AI theo thời gian thực parsing and structuring
- Pipeline dữ liệu thời gian thực
- Chống fingerprint và xử lý CAPTCHA
- Sản phẩm dữ liệu mạng xã hội dựng sẵn
- SLA enterprise và hỗ trợ concurrency cao
Phù hợp nhất cho: Team muốn AI tự động xử lý parsing và cấu trúc dữ liệu mạng xã hội.
Ưu và nhược điểm
- Ưu điểm: AI parsing mạnh, hiệu năng tốt, sẵn sàng cho enterprise, công nghệ chống khóa tốt
- Nhược điểm: Giá enterprise cao, ít tùy chọn tự phục vụ, tài liệu cộng đồng chưa nhiều
10. Oxylabs
 Oxylabs là nhà cung cấp proxy và scraping API cao cấp với một trong những mạng proxy lớn nhất thị trường. Web Scraper API của họ có bản dùng thử miễn phí tối đa 2.000 kết quả, sau đó các gói bắt đầu từ $49/tháng. Các target “other” chung hiện được định giá khoảng $1,15/1K kết quả không có JS và $1,35/1K có JS, với mức thấp hơn khi cam kết tháng lớn hơn.
Tính năng nổi bật
- Pool proxy residential hơn 175M+
- Web Scraper API chuyên cho các target mạng xã hội
- Công nghệ chống khóa (adaptive parsing, fingerprinting, CAPTCHA solving)
- Geo-targeting tại 195 quốc gia
- SLA enterprise và quản lý tài khoản riêng
Phù hợp nhất cho: Tổ chức lớn chạy scraping mạng xã hội liên tục, khối lượng cao và có yêu cầu tuân thủ.
Ưu và nhược điểm
- Ưu điểm: Mạng proxy khổng lồ, tỷ lệ thành công rất cao, hỗ trợ enterprise, chú trọng compliance
- Nhược điểm: Giá cao, quá mạnh tay cho team nhỏ, cần tích hợp kỹ thuật
11. Firecrawl
 Firecrawl là công cụ “LLM workflow” nhất trong danh sách này. Nó được thiết kế để chuyển trang web thành Markdown sạch hoặc dữ liệu có cấu trúc, và đặc biệt hấp dẫn với developer xây dựng RAG pipeline, luồng agent, hoặc hệ thống giám sát AI. Firecrawl có mặt ở đây không phải vì nó là scraper chuyên social media, mà vì rất nhiều developer hiện muốn nội dung trang social ở dạng Markdown hoặc trích xuất có cấu trúc thay vì CSV truyền thống.
Tính năng nổi bật
- Chuyển trang web sang Markdown sạch
- Trích xuất dữ liệu có cấu trúc qua API
- Render JavaScript và xử lý anti-bot
- Thiết kế tối ưu cho tích hợp AI/LLM (RAG pipeline, agent workflow)
- Hỗ trợ xử lý theo lô
Phù hợp nhất cho: Developer xây AI agent hoặc RAG pipeline cần dữ liệu mạng xã hội ở định dạng sẵn sàng cho LLM.
Ưu và nhược điểm
- Ưu điểm: Rất hợp cho pipeline AI, đầu ra Markdown sạch, tài liệu thân thiện với developer, có gói miễn phí
- Nhược điểm: Chỉ dành cho developer (không có no-code), tính năng chuyên social còn hạn chế, còn khá mới nên mức độ “thử lửa” ở quy mô enterprise chưa nhiều
So sánh các Social Media Scraper tốt nhất: Bảng tổng hợp
Đây là bảng so sánh đầy đủ mà tôi không tìm thấy ở đâu khác trong quá trình nghiên cứu chủ đề này:
| Công cụ | Phù hợp nhất cho | Nền tảng | No-code / API / Code | Chống khóa | Gói miễn phí | Tín hiệu giá | Tùy chọn xuất | AI sau scraping | Lập lịch | Độ dễ thiết lập |
|---|---|---|---|---|---|---|---|---|---|---|
| Apify | Workflow cloud dựng sẵn | Rộng qua marketplace | Low-code + API | Phụ thuộc actor | Có ($5 credit) | Theo mức sử dụng | JSON, CSV, Excel, API | Trung bình | Có | Trung bình |
| PhantomBuster | Lead gen + outreach | LinkedIn, IG, X, FB | No-code | Session cookie, CAPTCHA credit | Trial | Trung bình | CSV, JSON, API | Trung bình | Có | Dễ |
| Bright Data | Quy mô enterprise | Rộng + datasets | API + no-code IDE | Hạ tầng mạnh nhất | Trial | Cao cấp | JSON, NDJSON, CSV, XLSX, Parquet | Trung bình | Có | Khó hơn |
| Octoparse | Scraping trực quan | Rộng | No-code | Proxy, hỗ trợ CAPTCHA | Có | Trung bình | CSV, Excel, JSON, HTML, XML, DB, Sheets | Yếu | Có | Trung bình |
| ScraperAPI | Developer | Mục tiêu công khai rộng | API | Xoay IP, render, xử lý ban | Có (1K/tháng) | Trung bình | HTML, JSON, text, Markdown | Yếu | Gián tiếp | Trung bình |
| Decodo | API đáng tiền nhất | Rộng | API | Xoay proxy, JS, premium route | Có (2K request) | Rất đáng tiền | Đầu ra API | Yếu | Gián tiếp | Trung bình |
| Zyte | API tốc độ cao | Rộng | API | Phát hiện ban thông minh, trích xuất | Có ($5 credit) | Theo mức sử dụng | HTML, đầu ra trích xuất | Trung bình | Gián tiếp | Trung bình |
| SOAX | Gói proxy/API | Rộng | API | Pool IP lớn, bypass anti-bot | Trial | Trung bình–cao cấp | Đầu ra API | Yếu | Gián tiếp | Trung bình |
| Nimble | Enterprise có cấu trúc | Rộng | API / platform | Stealth driver, JS, AI parsing | Trial (5K trang) | Cao cấp | Đầu ra API có cấu trúc | Mạnh | Có | Trung bình–khó |
| Oxylabs | Hạ tầng cao cấp | Rộng | API | CAPTCHA, render, proxy premium | Trial (2K kết quả) | Cao cấp | Đầu ra API | Yếu | Có | Khó hơn |
| Firecrawl | Pipeline AI/RAG | Trang công khai rộng | API | Render + chuẩn hóa nội dung | Có | Theo mức sử dụng | Markdown, dữ liệu có cấu trúc | Mạnh | Batch | Trung bình |
No-code vs API vs custom script: Social Media Scraper nào hợp với trình độ của bạn?
Một trong những sai lầm lớn nhất tôi thấy là chọn công cụ không khớp với năng lực kỹ thuật của mình. Marketer không nên phải debug Python script, và developer cũng không nên bị bó buộc trong giao diện point-and-click.
| Nếu bạn là… | Bạn cần… | Lựa chọn tốt nhất |
|---|---|---|
| Marketer / agency (không code) | Browser extension hoặc nền tảng no-code | PhantomBuster, Octoparse |
| Growth hacker (biết chút code) | API có tài liệu tốt, tích hợp webhook | Apify, ScraperAPI, Firecrawl |
| Developer xây AI agent | API có thể lập trình, đầu ra Markdown/JSON | Firecrawl, Bright Data |
| Enterprise / quy mô lớn | Proxy được quản lý, SLA, concurrency cao | Bright Data, Oxylabs, Zyte, Nimble |
Các Social Media Scraper miễn phí và tiết kiệm: Bạn nhận được gì mà không phải trả tiền?
Tôi thấy câu hỏi này xuất hiện liên tục trên forum: “Mình biết có công cụ trả phí nhưng muốn dùng miễn phí.” Hoàn toàn hợp lý. Đây là những gì bạn thực sự có thể dùng miễn phí:
| Công cụ | Gói miễn phí | Bạn nhận được gì miễn phí | Giới hạn chính |
|---|---|---|---|
| Apify | ✅ Có | Credit miễn phí $5/tháng | Compute unit thay đổi theo actor |
| PhantomBuster | ✅ Trial | Dùng thử 14 ngày, số phantom giới hạn | Có giới hạn thời gian, sau đó phải trả phí |
| Octoparse | ✅ Có | 10 task, xuất 50K dữ liệu/tháng | Hạn chế concurrency và tính năng |
| ScraperAPI | ✅ Có | 1.000 credit/tháng + trial 5.000 credit | Target được bảo vệ sẽ tiêu credit rất nhanh |
| Decodo | ✅ Có | 2K request miễn phí | Chỉ API |
| Zyte | ✅ Có | Credit miễn phí $5 | Giá thay đổi theo độ phức tạp |
| SOAX | ✅ Trial | Lộ trình dùng thử nhập môn | Gói trả phí bắt đầu từ mức cao hơn hobby |
| Nimble | ✅ Trial | 5.000 trang miễn phí | Sau trial sẽ nghiêng về enterprise |
| Oxylabs | ✅ Trial | 2.000 kết quả | Sau trial là mức cao cấp |
| Firecrawl | ✅ Có | Thử nghiệm cho developer miễn phí | Chỉ API |
Từ dữ liệu thô đến insight thật: Workflow sau scraping cho dữ liệu mạng xã hội
Đây là phần gần như chẳng ai viết, nhưng lại là phần quan trọng nhất. Tôi đã nói chuyện với hàng chục team scrape 10.000 bài đăng social rồi ngồi nhìn spreadsheet mà không biết làm gì tiếp. Scraping là phần dễ. Phần khó là biến hàng loạt dòng dữ liệu thành quyết định.
Bốn workflow sau scraping cụ thể nhưng rất hiệu quả:
| Use case | Workflow | Công cụ trong pipeline |
|---|---|---|
| Chiến lược sáng tạo / nghiên cứu khán giả | Scrape bài đăng/bình luận → AI phân loại pain point → tài liệu brief | Scraper → Google Sheets → phân tích AI |
| Tạo lead | Scrape hồ sơ → enrich bằng dữ liệu từ trang con → CRM | Scraper → xuất sang Airtable/Notion |
| Tìm influencer | Scrape hồ sơ creator → lọc theo engagement → danh sách outreach | Scraper → CSV → công cụ lọc |
| Theo dõi đối thủ | Scrape theo lịch → theo dõi giá/SKU → cảnh báo | Scraper theo lịch → Google Sheets |
Với người xây pipeline AI, đầu ra Markdown của Firecrawl là lựa chọn rất hợp khi mục tiêu cuối cùng là đưa nội dung vào LLM thay vì spreadsheet.
Lưu ý nhanh về pháp lý và đạo đức khi scrape dữ liệu mạng xã hội
Phần này cố ý ngắn gọn — không phải trọng tâm, nhưng rất quan trọng. Việc scrape dữ liệu công khai thường được nhìn nhận khác với scrape dữ liệu riêng tư hoặc dữ liệu yêu cầu đăng nhập. Các vụ án như hiQ v. LinkedIn vẫn có ảnh hưởng đến cách luật Mỹ nhìn nhận việc scrape dữ liệu công khai theo CFAA. Nhưng điều đó không xóa bỏ điều khoản dịch vụ, các yêu cầu hợp đồng hay nghĩa vụ về quyền riêng tư.
Hướng dẫn thực tế:
- Ưu tiên dữ liệu công khai thay vì dữ liệu cá nhân riêng tư hoặc yêu cầu đăng nhập
- Tôn trọng Terms of Service và rate limit của nền tảng
- Tránh thu thập dữ liệu cá nhân nhạy cảm nếu không có căn cứ pháp lý rõ ràng
- Tuân thủ GDPR, CCPA và các quy định quyền riêng tư tại địa phương
- Cần có tư vấn pháp lý cho trường hợp enterprise hoặc ngành được quản lý chặt
Những công cụ có tính năng compliance tích hợp sẵn — như Bright Data và Oxylabs — có thể được ưu tiên bởi các team enterprise có yêu cầu pháp lý nghiêm ngặt. Ví dụ, Terms of Service của Pinterest nêu rõ việc scraping mà không có quyền là bị cấm, phản ánh thái độ chặt chẽ của nhiều nền tảng lớn.
Cách chọn Social Media Scraper tốt nhất cho nhu cầu của bạn
Sau nhiều năm test, nghiên cứu và xây dựng trong lĩnh vực này, đây là tóm tắt thật lòng của tôi:
- Tự động hóa social dựng sẵn kèm outreach → PhantomBuster
- Marketplace scraper dựng sẵn → Apify
- Enterprise quy mô lớn với mạng proxy khổng lồ → Bright Data, Oxylabs
- API đáng tiền nhất → Decodo
- Tốc độ phản hồi nhanh nhất → Zyte
- Developer API cho pipeline AI → Firecrawl
- Trình dựng trực quan point-and-click → Octoparse
Lời khuyên mạnh nhất của tôi: hãy test gói miễn phí hoặc bản trial trên nền tảng mục tiêu của bạn trước khi quyết định mua. Công cụ scraping social hiếm khi thất bại theo cùng một kiểu. Chúng hỏng khác nhau tùy target là công khai, yêu cầu đăng nhập, giới hạn tốc độ hay thay đổi giao diện liên tục.
Bắt đầu nhỏ. Kiểm tra đầu ra. Rồi mới mở rộng.
Câu hỏi thường gặp
Social media scraper là gì?
Social media scraper là công cụ trích xuất dữ liệu công khai hoặc có thể truy cập từ các nền tảng mạng xã hội — hồ sơ, bài đăng, bình luận, chỉ số của creator, hoặc metadata của trang — rồi xuất ra các định dạng như CSV, JSON, Google Sheets hoặc Markdown. Một số scraper là extension trình duyệt, một số là nền tảng cloud (như Apify), và một số là API dành cho developer (như ScraperAPI hoặc Firecrawl).
Scrape dữ liệu mạng xã hội có hợp pháp không?
Điều này phụ thuộc vào bạn scrape dữ liệu gì, truy cập như thế nào và hoạt động ở đâu. Dữ liệu công khai thường được đối xử khác với dữ liệu riêng tư hoặc dữ liệu cần xác thực theo án lệ Mỹ (đáng chú ý là các quyết định hiQ v. LinkedIn), nhưng Terms of Service của nền tảng và luật riêng tư như GDPR và CCPA vẫn áp dụng. Cách an toàn nhất là chỉ scrape dữ liệu công khai, tôn trọng rate limit, và tham khảo tư vấn pháp lý cho trường hợp enterprise hoặc ngành được quản lý.
Nền tảng mạng xã hội nào khó scrape nhất?
Theo mức độ khó thực tế, LinkedIn và Facebook Groups thường đứng đầu (yêu cầu đăng nhập, khóa rất gắt), tiếp theo là Instagram và TikTok (chống bot mạnh, thay đổi giao diện thường xuyên), rồi đến X/Twitter (mức trung bình — API bị trả phí nhưng dữ liệu công khai vẫn truy cập được), còn YouTube thì tương đối dễ hơn ở các bề mặt công khai. Với những nền tảng khó nhất, browser-based scraping bằng phiên đăng nhập của chính bạn thường là cách đáng tin cậy duy nhất.
Tôi có thể scrape dữ liệu mạng xã hội miễn phí không?
Có — một số công cụ có gói miễn phí hoặc bản dùng thử. Apify cung cấp $5 credit mỗi tháng. ScraperAPI cho 1.000 credit miễn phí mỗi tháng. Decodo cung cấp 2.000 request miễn phí. Giới hạn sẽ khác nhau, nhưng bạn hoàn toàn có thể bắt đầu scrape mạng xã hội mà không cần trả tiền.
Sự khác nhau giữa cloud scraping và browser scraping cho mạng xã hội là gì?
Cloud scraping chạy từ hạ tầng từ xa và phù hợp nhất cho dữ liệu công khai ở quy mô lớn — nhanh hơn và có thể xử lý nhiều trang song song. Browser scraping chạy trong chính phiên trình duyệt của bạn và phù hợp hơn cho các nền tảng yêu cầu đăng nhập hoặc nhạy cảm cao như LinkedIn và Facebook Groups, vì nó dùng cookie xác thực của bạn và mô phỏng hành vi người dùng thật. Nhiều team dùng cả hai: cloud cho dữ liệu công khai, browser cho những gì nằm sau lớp đăng nhập.
Tìm hiểu thêm



