
Google mỗi ngày xử lý hơn 85 tỷ lượt tìm kiếm — thậm chí có ước tính cho rằng gần 140 tỷ — và con số này vẫn còn đang tăng đều. Với các đội SEO, sales ops, nhà phân tích thương mại điện tử, và ngày càng nhiều AI agent cần bằng chứng web theo thời gian thực, dữ liệu tìm kiếm này đúng là một mỏ vàng. Vấn đề là: đến năm 2026, chọn một SERP API không còn giống chọn công cụ nữa, mà giống như đang giải một mê cung đầy trang giá, hệ thống credit, và những lời mô tả mơ hồ về “structured JSON”.
Trong vài tuần qua, tôi đã đi sâu test 8 nhà cung cấp SERP API — từ tốc độ phản hồi, chi phí thực sau khi quy đổi các mô hình tính phí phức tạp, cho đến việc mỗi bên thực sự parse được những gì từ SERP thành field cấu trúc. Mục tiêu rất rõ: đưa cho bạn một bài đánh giá thật sự có thể so sánh ngang hàng, kiểu mà những bài khác thường không có. Chúng ta sẽ nhìn vào tốc độ, chi phí thực khi scale, độ phủ parsing, mức độ phù hợp với AI agent, và độ ổn định trong môi trường production. Nếu bạn cũng từng bị câu “bạn đang so sánh trang giá chứ không phải chi phí thực” làm cho đau đầu — đây là một bình luận có thật tôi thấy trên Reddit thread — thì bài này là dành cho bạn.
Why you need a SERP API in 2026, and why it’s so hard to choose one
SERP API về cơ bản là một dịch vụ được quản lý: nó gửi truy vấn tìm kiếm của bạn đến công cụ tìm kiếm rồi trả về trang kết quả ở dạng máy đọc được — thường là JSON. Bạn không cần tự lo xoay proxy, xử lý CAPTCHA, render browser hay viết parser; chỉ cần gọi API là lấy được dữ liệu có cấu trúc. Nghe thì đơn giản, nhưng thị trường lại cực kỳ phức tạp.
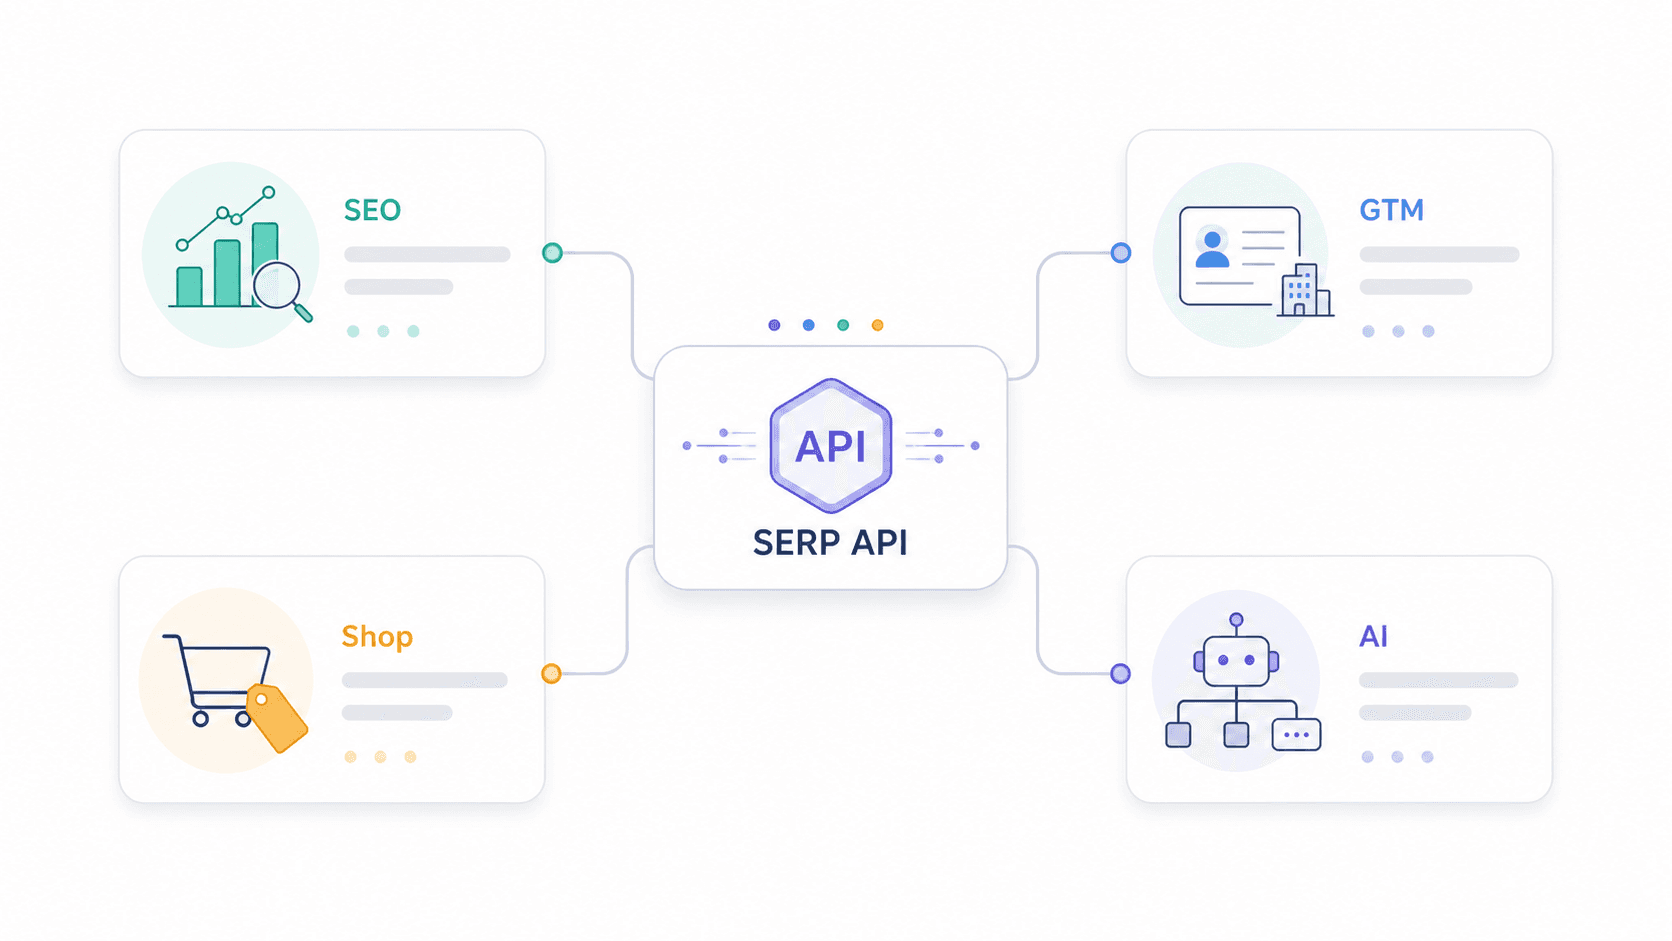
Use case giờ không chỉ còn là theo dõi thứ hạng nữa:
- SEO team cần thứ hạng, featured snippet, People Also Ask và khả năng hiển thị của đối thủ.
- Sales và GTM team dùng SERP để tìm công ty, trang review, directory và tín hiệu mua hàng.
- Ecommerce team theo dõi Google Shopping, quảng cáo trả phí và giá đối thủ.
- AI developer thì đưa dữ liệu SERP vào LLM agent, RAG workflow, và các công cụ như n8n, LangChain.
Thị trường web scraping dự kiến sẽ đạt 2,23 tỷ USD vào năm 2031, với tốc độ tăng trưởng kép khoảng 13,78% mỗi năm. SERP API là một phần rất lớn của miếng bánh đó.
Điểm đau cốt lõi là: nhà cung cấp nào cũng nói họ xuất được “structured JSON”, nhưng mức độ parse thật sự giữa các phần tử SERP — PAA, knowledge panel, local pack, shopping ads, featured snippet và nhiều thứ khác — lại khác nhau rất xa. Giá cả cũng rối không kém. Có bên tính theo request, có bên tính theo credit, có bên tính theo kết quả, và có bên còn thay đổi giá theo tốc độ hoặc khu vực địa lý. Một người dùng Reddit đã tóm gọn khá chính xác: “SerpApi tính theo lượt tìm kiếm thành công, ScraperAPI gộp mọi thứ vào credit, còn Serperdev trông thì rẻ cho đến khi bạn đổi credit ra khối lượng công việc thực tế.”
Bài viết này bù vào khoảng trống mà tôi không tìm thấy ở nơi khác: ma trận parsing cho biết API nào thực sự trả về gì, giá quy đổi theo 1K/10K/100K query, mức phù hợp với AI agent, và dữ liệu sẵn sàng cho production.
How we tested: the criteria for choosing the best SERP API
Tôi đánh giá mỗi nhà cung cấp theo 8 tiêu chí, tất cả đều phản ánh đúng điều mà người dùng production thật sự quan tâm. Phần lớn bài so sánh ngoài kia chỉ nhắc qua 2–3 tiêu chí rồi dừng lại. Tôi muốn đi đủ cả 8, và phải có căn cứ rõ ràng.
Tốc độ và thời gian phản hồi. Tôi tham chiếu các benchmark bên thứ ba — đặc biệt là so sánh của HasData — cùng tài liệu chính thức của từng bên. Tốc độ cực kỳ quan trọng, nhất là khi bạn làm dashboard thời gian thực hoặc gọi tool cho AI agent, vì không ai muốn chờ 30 giây cả.
Chi phí khi scale (1K, 10K, 100K query). Tôi quy đổi toàn bộ giá sang chi phí trên mỗi 1,000 lần truy vấn thành công. Đây là cách duy nhất để so sánh công bằng giữa mô hình credit, gói subscription và pay-as-you-go.
Khả năng parse SERP features, không chỉ organic results. Tôi kiểm tra tài liệu và sample response để xem API có thực sự trả về các phần tử SERP dưới dạng field cấu trúc hay không, chứ không chỉ nhả raw HTML.
Free tier và khả năng dùng pay-as-you-go. Mức thử thấp là rất quan trọng. Nếu bạn còn chưa test được workflow thật của mình mà đã phải bỏ ra vài trăm đô, đó là dấu hiệu đáng lo.
Khả năng tích hợp AI và automation. Đến 2026, nhiều team cần SERP API để nối vào AI agent hơn là chỉ để xem dashboard. Schema ổn định, output sạch, hỗ trợ chuyển sang Markdown — tất cả đều quan trọng với downstream LLM.
Hỗ trợ nhiều search engine. Phần lớn bài viết chỉ xoay quanh Google. Tôi sẽ xem nhà cung cấp nào hỗ trợ Bing, Yandex, DuckDuckGo, Baidu, v.v.
Rate limit và khả năng chạy production. Gần như không có bài so sánh nào nói kỹ về giới hạn request, chiến lược retry hay SLA. Nhưng với đội chạy hàng nghìn query mỗi ngày, đây lại là thứ rất đáng tiền.
Độ thân thiện với developer. Chất lượng tài liệu, SDK, và thời gian để lấy được kết quả đầu tiên.
1. Thunderbit
Thunderbit đi theo một hướng rất khác so với SERP API truyền thống. Thay vì cung cấp endpoint cố định để parse sẵn các phần tử SERP, Thunderbit cho bạn tự định nghĩa JSON Schema trong Extract API, rồi AI sẽ trích xuất dữ liệu từ bất kỳ trang kết quả tìm kiếm nào theo đúng field bạn chỉ định. Distill API của nó thì biến bất kỳ URL nào thành Markdown sạch, rất hợp cho LLM.
Điều đó có nghĩa là Thunderbit có thể dùng cho Google, Bing, Yandex, DuckDuckGo hoặc bất kỳ search engine nào khác — AI sẽ đọc lại trang mỗi lần, thay vì phụ thuộc vào selector được viết cứng. SERP thay đổi liên tục, và bạn không phải chờ nhà cung cấp cập nhật parser.
Các tính năng chính
- Extract API: Bạn tự định nghĩa JSON Schema tùy chỉnh (organic results, PAA questions, local business info, shopping products — muốn gì cũng được), rồi lấy lại các field có cấu trúc đó.
- Distill API: Chuyển bất kỳ SERP page nào thành Markdown sạch, cực hợp cho RAG workflow và LLM summary.
- Hỗ trợ đa search engine gốc: Không chỉ Google; hễ page truy cập được là dùng được.
- Xử lý hàng loạt: Có thể chạy song song nhiều URL.
- Chống scraping có sẵn: Bao gồm xử lý CAPTCHA, JS rendering và xoay proxy.
- Rate limit theo gói: Free tier (600 units một lần, 2 concurrency), Starter (60,000 units/tháng, 30 concurrency), Pro (600,000 units/tháng, 50 concurrency).
Giá
Dùng mô hình tính theo credit. Distill là 1 credit mỗi trang; Extract là 20 credit mỗi trang. Có credit miễn phí để thử. Tính theo gói năm, chi phí biên của Distill có thể thấp đến khoảng 0.80 USD cho mỗi 1K trang, còn Extract khi chạy full load vào khoảng 16 USD cho mỗi 1K trang. Giá trị của Extract nằm ở chỗ bạn lấy luôn schema downstream cần, khỏi phải xử lý lại.
Xem Thunderbit Pricing để biết gói mới nhất.
Dùng thử Thunderbit, trải nghiệm AI SERP extraction
Phù hợp nhất với
AI agent workflow, RAG pipeline, scraping đa search engine, team cần schema linh hoạt thay vì output cố định, và bất kỳ ai đã chán chờ nhà cung cấp thêm support cho một SERP feature mới.
2. SerpApi
SerpApi là tay chơi kỳ cựu trong lĩnh vực này, hoạt động từ năm 2016 và có bộ endpoint dành riêng cho Google toàn diện nhất. Nó bao phủ Google Search, Maps, Shopping, Scholar, News, Jobs, Trends, Images, Videos, v.v.
Các tính năng chính
- Có endpoint riêng cho từng sản phẩm Google, với geolocation khá chín, chính xác đến cấp thành phố.
- Parse được PAA, knowledge panel, local pack, ads, shopping results, featured snippet, answer box và related searches thành field cấu trúc.
- Tài liệu được duy trì tốt và có thư viện client cho nhiều ngôn ngữ.
Giá
Có 250 lượt search miễn phí mỗi tháng. Gói Starter: 25 USD/tháng cho 1,000 search (tương đương 25 USD mỗi 1K). Gói Developer, được gắn nhãn “Most popular”: 75 USD/tháng cho 5,000 search (khoảng 15 USD mỗi 1K). Gói Big Data: 275 USD/tháng cho 30,000 search (khoảng 9.17 USD mỗi 1K). Không có tùy chọn pay-as-you-go đơn giản — mô hình chủ yếu là subscription.
Tốc độ và độ tin cậy
Benchmark của HasData cho thấy thời gian phản hồi trung bình khoảng 5.49 giây — không phải nhanh nhất, nhưng khá ổn định. SerpApi công bố SLA uptime 99.95% cho các gói trả phí, và giới hạn concurrency thay đổi theo gói.
Phù hợp nhất với
Team cần độ phủ Google rộng nhất, đặc biệt là Maps, Scholar, Shopping, Jobs, và yêu cầu cao về độ chính xác lẫn schema ổn định. Hợp với các dự án enterprise có ngân sách tốt.
3. Serper
Serper tập trung vào tốc độ và chi phí thấp. Đây là một cái tên còn khá mới, chuyên thu thập Google SERP nhanh, giá cạnh tranh mạnh; cộng đồng n8n và LangChain cũng ngày càng chuộng vì dễ tích hợp vào AI agent.
Các tính năng chính
- Cung cấp JSON sạch cho Google Search, News, Scholar, Images, Shopping, Videos, Places, Patents và Autocomplete.
- Thiết lập cực đơn giản, thường chưa tới một phút là bắt đầu lấy kết quả được.
- Đủ đơn giản để framework cho AI agent có thể tích hợp native.
Giá
Đăng ký là có ngay 2,500 query miễn phí. Giá khởi điểm khoảng 0.001 USD mỗi search, và có thể giảm xuống khoảng 0.00075 USD ở quy mô lớn. Rất hợp với pay-as-you-go. Một điểm cần nhớ: nếu query yêu cầu hơn 10 kết quả, có thể bị tính 2 credit (hãy kiểm tra rule mới nhất trong console).
Tốc độ và độ tin cậy
Trong benchmark, nó thuộc nhóm nhanh nhất — HasData ghi nhận trung bình khoảng 2.87 giây. Hỗ trợ chủ yếu qua email, và độ hiện diện công khai của team cũng khá thấp, điều này có thể khiến một số người ngại. Ở mức concurrency cực cao, đã có vài người dùng phản ánh vấn đề ổn định, nhưng với đa số workload thì nó vẫn rất ổn.
Phù hợp nhất với
Dự án nhạy cảm về ngân sách, startup, và tích hợp AI agent cần dữ liệu Google SERP nhanh, rẻ. Đặc biệt phù hợp khi chi phí là ràng buộc lớn nhất trong việc theo dõi thứ hạng tần suất cao.
4. Scrapingdog
Scrapingdog đã có mặt trên thị trường hơn 5 năm và thường được xếp vào nhóm nhanh nhất trong các benchmark bên thứ ba. HasData đo được thời gian phản hồi trung bình khoảng 1.25 giây, với tỷ lệ thành công 100%.
Các tính năng chính
- Google SERP API trả về organic results, PAA, featured snippet, ads và local results dưới dạng JSON cấu trúc.
- Cung cấp cả raw HTML lẫn JSON đã parse.
- Tài liệu đa ngôn ngữ, kèm ví dụ code cho hầu hết ngôn ngữ lập trình — bắt đầu chỉ mất vài phút chứ không phải vài giờ.
- Hỗ trợ 24/7.
Giá
200 credit miễn phí mỗi tháng. Gói trả phí bắt đầu khoảng 40 USD/tháng. Giá theo request khởi điểm từ khoảng 0.001 USD và giảm đáng kể khi lưu lượng tăng — một số so sánh thậm chí ghi nhận mức thấp tới 0.000058 USD ở gói cao nhất.
Tốc độ và độ tin cậy
Dữ liệu tốc độ thực sự rất ấn tượng. Nếu workflow của bạn nhạy với độ trễ và đang làm trích xuất Google SERP tần suất cao với schema cố định, Scrapingdog gần như rất khó bị vượt qua ở khoản phản hồi.
Phù hợp nhất với
Các công cụ SEO chạy tần suất cao và rank tracker cần độ trễ thấp, chi phí thấp. Hợp với team đang xây hệ thống production và từng mili-giây phản hồi API đều quan trọng.
5. DataForSEO
DataForSEO không chỉ là một SERP API — nó là cả bộ API được thiết kế cho các công ty xây sản phẩm SEO. Nó bao phủ SERP, keyword, backlink, business data, Google Ads, Trends và nhiều thứ khác.
Các tính năng chính
- Parse SERP feature rất đầy đủ: organic results, paid results, local pack, knowledge graph, PAA, featured snippets, shopping, images, videos, top stories và nhiều hơn nữa.
- Có hai chế độ: Live (sync) cho dashboard thời gian thực; Standard (async) cho batch process, nơi bạn xếp hàng rồi lấy kết quả sau.
- Hỗ trợ nhiều search engine: Google, Bing, Yahoo, Baidu, Naver, Seznam, v.v.
Giá
Pay-as-you-go, nhưng chi phí thay đổi theo endpoint, engine, device, priority và mode. Giá SERP thường nằm trong khoảng 0.0006 đến 0.002 USD cho mỗi task, tùy vào Google organic search, Standard/Live và mức ưu tiên. Tài liệu khá dày — nên dành thời gian xem kỹ price calculator. DataForSEO Pricing.
Tốc độ và độ tin cậy
Chế độ Standard async có thể chậm hơn một chút, khoảng 10 giây, vì task cần xếp hàng. Live / high-speed mode đắt hơn, nhưng phù hợp với dashboard thời gian thực. Đây là dịch vụ đã được kiểm chứng lâu năm trên thị trường, ổn định, và có hỗ trợ cấp enterprise.
Phù hợp nhất với
Các công ty SaaS đang xây platform SEO, rank tracker dashboard và keyword research tool. Cũng hợp với team sẵn sàng xử lý tài liệu phức tạp và hạ tầng cấp enterprise.
6. Bright Data
Bright Data là một “ông lớn” cấp enterprise. SERP API chỉ là một trong nhiều sản phẩm của họ — còn có proxy, dataset, Web Unlocker và các công cụ scraping khác. Điểm mạnh cốt lõi nằm ở quy mô, độ tin cậy và hạ tầng.
Các tính năng chính
- Có endpoint riêng cho Google Maps, Shopping và search tổng quát — đồng thời cũng hỗ trợ nhiều engine như Bing, Yahoo, Yandex và DuckDuckGo thông qua hạ tầng proxy.
- Tuyên bố đạt tỷ lệ thành công 100% nhờ công nghệ giải chặn tích hợp.
- Điểm mạnh thật sự của Bright Data là geolocation cấp enterprise, khả năng concurrency, và sức mạnh giải chặn ở quy mô lớn.
Giá
Nhắm đến enterprise. Giá công khai cho thấy có cả pay-as-you-go và subscription, và nhiều bài so sánh nói rằng mức khởi điểm thường vào khoảng 499 USD/tháng. Chi phí mỗi request có thể bắt đầu từ 0.005 USD, rồi giảm theo volume. Bright Data Pricing. Có free tier với 5,000 credit/tháng, không cần thẻ tín dụng.
Tốc độ và độ tin cậy
Benchmark thường nằm trong khoảng 2 đến 5.58 giây. Lý do mua Bright Data không phải vì độ trễ trung vị thấp nhất, mà vì SLA enterprise, hỗ trợ chuyên biệt, và hạ tầng có thể xử lý hàng triệu request song song mà không tụt chất lượng đáng kể. Tài liệu rate limit cũng khuyên nên tăng lưu lượng dần dần.
Phù hợp nhất với
Các team enterprise thu thập hàng triệu SERP mỗi tháng. Tổ chức cần dữ liệu Google Maps / local business ở quy mô lớn. Những team đã dùng Bright Data proxy rồi và muốn đồng bộ nhà cung cấp.
7. ScraperAPI
ScraperAPI là một API scraping đa dụng, đồng thời cũng có endpoint Google SERP có cấu trúc. Nó đi theo hướng “một công cụ lo được nhiều việc” — dễ tích hợp, và có hơn 40 triệu IP proxy.
Các tính năng chính
- Có endpoint dữ liệu cấu trúc cho Google Search, Shopping, News và Jobs.
- Chống chặn và xử lý CAPTCHA bằng machine learning, trong khi JavaScript rendering không bị tính thêm phí.
- Hỗ trợ geolocation, phù hợp để lấy kết quả theo khu vực.
Giá
Có bản dùng thử 7 ngày với 5,000 credit. Gói trả phí bắt đầu khoảng 49 USD/tháng. Cần lưu ý: credit dùng cho SERP có thể khác với credit cho scraping thông thường, nên bạn phải quy đổi theo đúng query SERP thành công thực tế. ScraperAPI Pricing.
Tốc độ và độ tin cậy
Nói thẳng thì benchmark của HasData cho thấy SERP query trung bình khoảng 33.66 giây. Đây là chậm hơn rất nhiều so với các SERP API chuyên dụng. Dù tỷ lệ thành công rất cao (99.9%), độ trễ này khiến nó không thật sự hợp cho ứng dụng thời gian thực, mà phù hợp hơn với batch processing.
Phù hợp nhất với
Team cần một giải pháp scraping web tổng quát, trong đó SERP chỉ là một năng lực bổ sung. Dự án không quá nhạy về tốc độ nhưng coi trọng sự ổn định và dễ triển khai. Developer đang dùng ScraperAPI cho các task scraping khác và muốn gom về một nhà cung cấp duy nhất.
8. Apify
Apify không phải là SERP API thuần. Đây là một nền tảng scraping và automation xoay quanh “Actors” — những script có thể tái sử dụng để làm Google search scraping, map extraction và workflow automation. Bạn có thể xem nó như một marketplace: bạn chọn hoặc tự xây scraper phù hợp nhất cho nhu cầu hiện tại.
Các tính năng chính
- Có marketplace Google SERP Actors dựng sẵn, với phạm vi tính năng khác nhau.
- Rất tùy biến — bạn có thể xây workflow riêng, nối nhiều actor lại, và lên lịch chạy tự động.
- Output là JSON; có thể cấu hình actor để parse các SERP feature cụ thể.
- Hợp khi muốn kết hợp SERP extraction với những tác vụ scraping / automation khác.
Giá
Có gói free gồm platform credit hàng tháng, trị giá khoảng 5 USD, roughly tương đương 1,400 kết quả. Gói trả phí bắt đầu khoảng 29 USD/tháng. Chi phí ở cấp actor khác nhau — có cái tính theo kết quả, có cái tính theo compute units. So sánh bên thứ ba thường ước tính chi phí nhỏ lẻ của Apify vào khoảng 0.003 USD mỗi search. Apify Pricing.
Tốc độ và độ tin cậy
HasData ghi nhận trung bình khoảng 8.2 giây. Kiến trúc dựa trên actor khiến nó có thêm overhead so với endpoint SERP chuyên dụng. Phù hợp hơn cho workflow định kỳ / batch, không phải query thời gian thực.
Phù hợp nhất với
Team cần workflow scraping + automation tùy chỉnh vượt ra ngoài dữ liệu SERP đơn thuần. Dự án muốn kết hợp SERP extraction với các tác vụ web scraping khác. Developer muốn tối đa hóa độ linh hoạt trên nền endpoint dựng sẵn.
SERP feature parsing matrix: mỗi API thực sự trả về gì
Đây là phần so sánh mà tôi không tìm thấy ở chỗ khác. Bên nào cũng nói mình xuất được “structured JSON”, nhưng mức độ parse thành field gốc của từng SERP element lại chênh lệch rất lớn. Tôi đã kiểm tra tài liệu và sample response của từng bên.
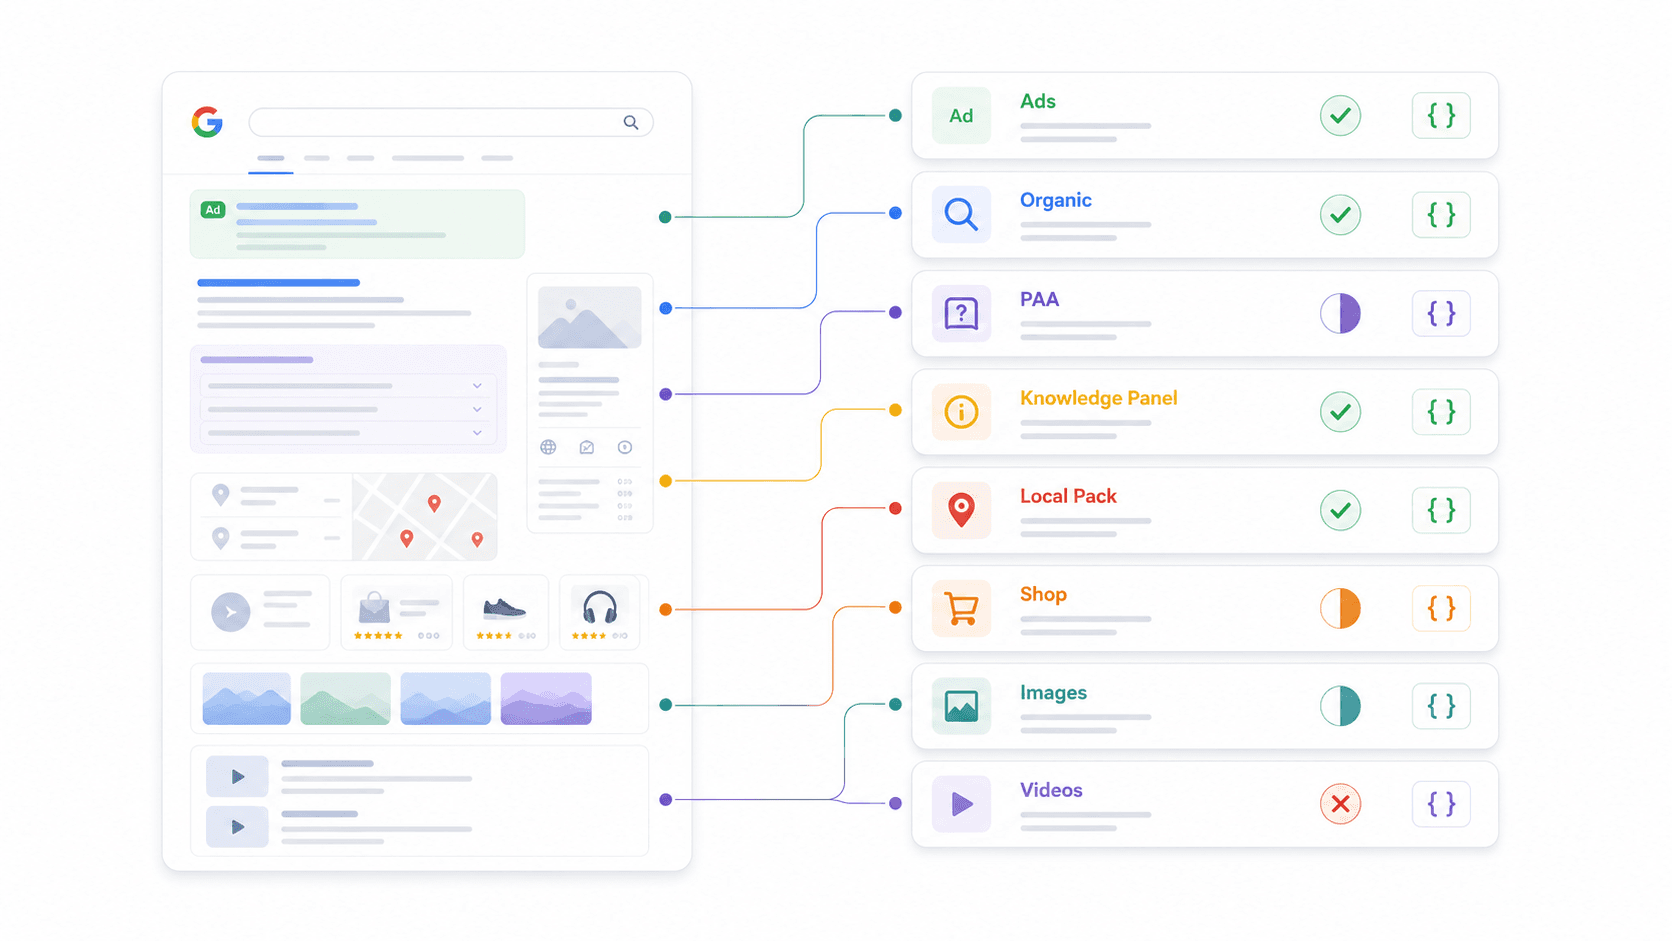
| SERP feature | Thunderbit | SerpApi | Serper | Scrapingdog | DataForSEO | Bright Data | ScraperAPI | Apify |
|---|---|---|---|---|---|---|---|---|
| Organic results | Custom Schema | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | Tùy Actor |
| People Also Ask | Custom Schema | ✅ | ✅ | ✅ | ✅ | Một phần | Một phần | Tùy Actor |
| Knowledge panel | Custom Schema | ✅ | Một phần | Một phần | ✅ | Một phần | Một phần | Tùy Actor |
| Local pack / maps | Custom Schema | ✅ | ✅ | Một phần | ✅ | ✅ | Một phần | Tùy Actor |
| Shopping results | Custom Schema | ✅ | ✅ | Một phần | ✅ | ✅ | ✅ | Tùy Actor |
| Featured snippet | Custom Schema | ✅ | Một phần | ✅ | ✅ | Một phần | Một phần | Tùy Actor |
| Ads (top / bottom) | Custom Schema | ✅ | Một phần | ✅ | ✅ | Một phần | Một phần | Tùy Actor |
| Image results | Custom Schema | ✅ | ✅ | ✅ | ✅ | Một phần | Một phần | Tùy Actor |
| Video results | Custom Schema | ✅ | ✅ | Một phần | ✅ | Một phần | Một phần | Tùy Actor |
“Custom Schema” trong Thunderbit nghĩa là gì: Nó không ép bạn phải chọn trước những SERP feature nào được parse. Thay vào đó, bạn tự định nghĩa JSON Schema để trích chính xác field mình cần. Bạn muốn PAA question, answer snippet, và cả tín hiệu ý định thương mại? Chỉ cần khai báo schema, AI sẽ trả đúng những gì bạn cần. Nhờ tính linh hoạt này, Thunderbit có thể dùng với bất kỳ search engine nào, chứ không chỉ Google.
Vì sao điều đó quan trọng: Nếu bạn cần dữ liệu PAA cho chiến lược nội dung, hãy kiểm tra xem nhà cung cấp có thực sự parse PAA hay không. Nếu bạn làm giám sát quảng cáo ecommerce, cũng phải chắc rằng có field shopping có cấu trúc. Đừng mặc định rằng “structured JSON” đồng nghĩa với độ phủ đầy đủ.
Chi phí thực khi scale: so sánh giá trên mỗi query
Giá công bố trên website chưa bao giờ nói hết câu chuyện. Tôi đã quy đổi toàn bộ phương án sang chi phí trên mỗi 1,000 query thành công ở ba mức quy mô.
| Nhà cung cấp | Chi phí 1K query | Chi phí 10K query | Chi phí 100K query | Pay-as-you-go? | Free tier |
|---|---|---|---|---|---|
| Thunderbit (Distill) | ~0.80–3.20 USD | ~8–32 USD | ~80–320 USD | Credit package | Free credit |
| Thunderbit (Extract) | ~16–64 USD | ~160–640 USD | ~1,600–6,400 USD | Credit package | Free credit |
| SerpApi | 25 USD (Starter) | ~150 USD (Developer) | ~917 USD (Big Data) | Không (subscription) | 250 lần/tháng |
| Serper | ~1 USD | ~10 USD | ~75–100 USD | Có | 2,500 query |
| Scrapingdog | ~1 USD | ~10 USD hoặc thấp hơn | Có thể thấp hơn rất nhiều so với 10 USD | Gói / credit | 200 credit/tháng |
| DataForSEO | ~0.60–2 USD | ~6–20 USD | ~60–200 USD | Có | Credit dùng thử |
| Bright Data | ~0.50–5+ USD | Tùy báo giá | Hợp hơn ở quy mô lớn | Có / subscription | Free tier (5,000 credit/tháng) |
| ScraperAPI | Phụ thuộc credit | Phụ thuộc credit | Phụ thuộc credit | Gói / credit | 5,000 credit dùng thử |
| Apify | ~3 USD (quy mô nhỏ) | Tùy Actor | Tùy Actor | Platform credit | Credit miễn phí hàng tháng |
Chi phí ẩn cần lưu ý:
- Serper có thể trừ thêm 2 credit nếu một query yêu cầu hơn 10 kết quả.
- DataForSEO có giá khác nhau giữa Standard và Live / high-priority mode.
- ScraperAPI có tỷ lệ credit khác nhau giữa SERP và scraping thông thường.
- Bright Data có thể có ngưỡng chi tiêu tối thiểu ở cấp enterprise.
Cách nhìn giá trị theo từng quy mô:
- Dự án phụ / side project dưới 50 USD mỗi tháng: Serper hoặc Scrapingdog, rất hợp cho Google SERP JSON có format cố định.
- Team đang tăng trưởng, 10K–50K query mỗi tháng: Serper, Scrapingdog hoặc DataForSEO, tùy độ sâu parsing.
- Enterprise, trên 100K query mỗi tháng: DataForSEO, Bright Data hoặc SerpApi Big Data.
- AI-first extraction: Thunderbit, vì schema của nó tự nhiên hợp hơn với nhu cầu downstream của agent, không cần hậu xử lý nhiều.
Best SERP API for AI agents và LLM workflows năm 2026
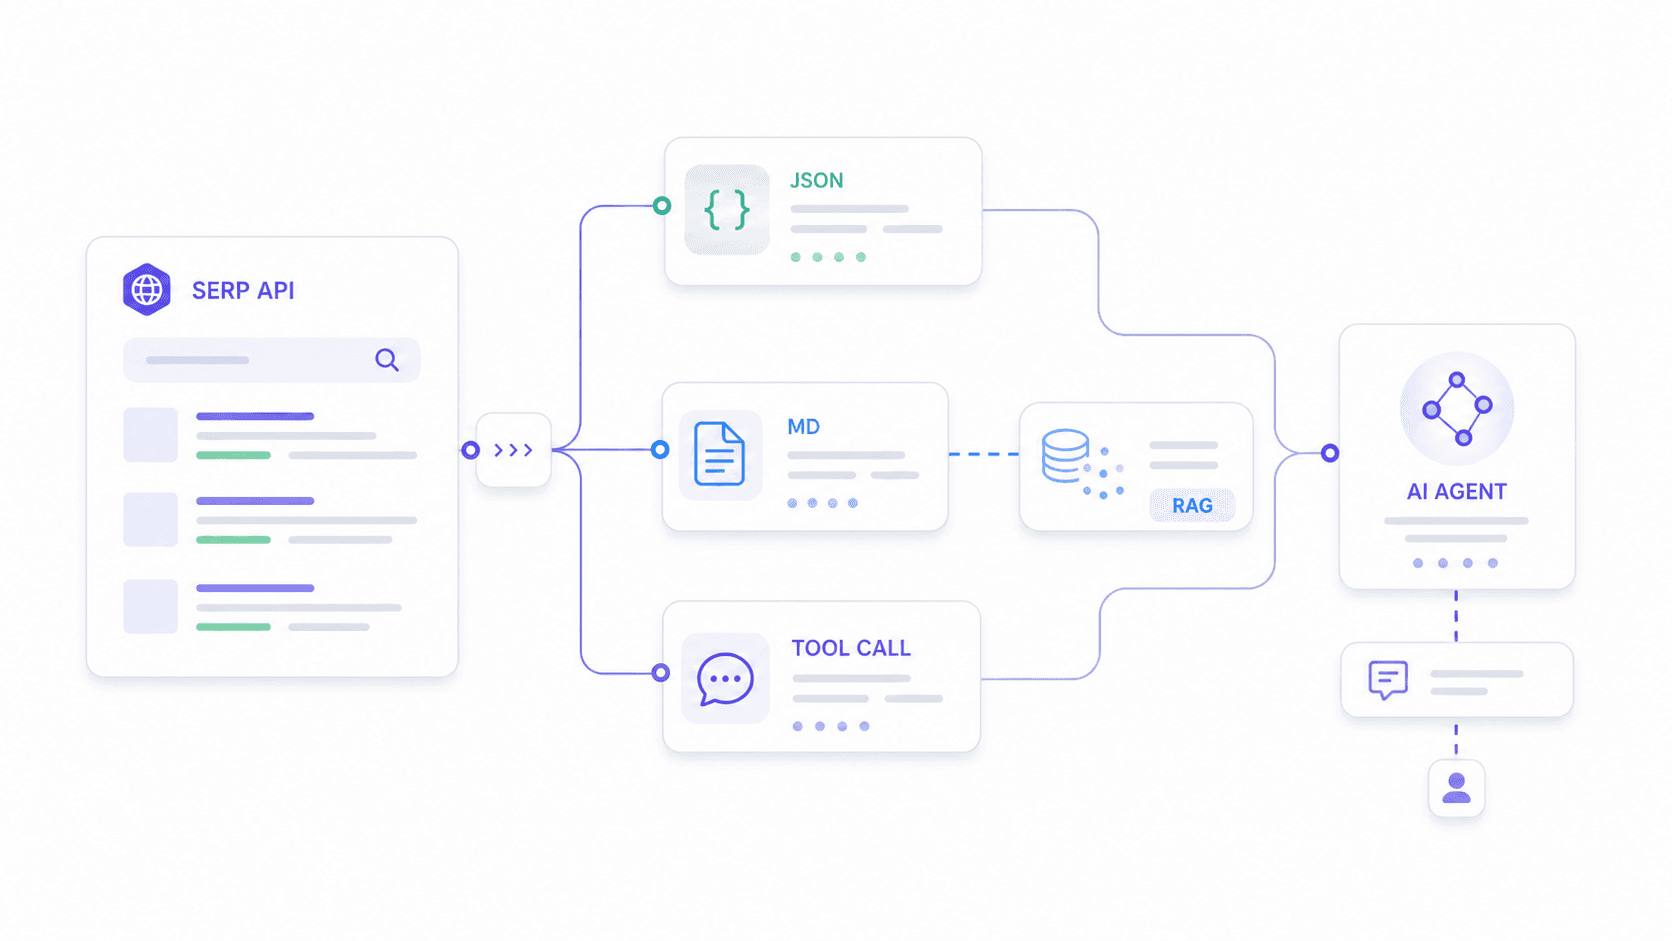
Đây là use case mà ít bài giải thích cho rõ. Tôi đã tìm thấy ít nhất 3 Reddit thread nơi người dùng đang cố nối SERP API vào n8n workflow và AI agent, và có một người còn nói thẳng là “chưa hiểu làm sao để nó chạy ổn với AI agent”.
AI agent cần những thứ khác với dashboard theo dõi thứ hạng. Chúng cần:
- JSON có cấu trúc ổn định, để khi nhà cung cấp đổi format output thì logic parse không bị gãy.
- Custom output field, khớp với kỳ vọng của model downstream, thay vì đổ mọi thứ vào một cục.
- Markdown hoặc text sạch, để phục vụ RAG và embedding pipeline.
- Độ trễ đủ thấp, để hỗ trợ tool calling theo thời gian thực.
Cách từng nhà cung cấp phù hợp với AI agent stack
| Nhà cung cấp | Mức phù hợp với AI agent | Lý do |
|---|---|---|
| Thunderbit | Rất tốt | Extract API hỗ trợ JSON Schema tùy chỉnh, Distill API xuất Markdown hợp cho RAG. Tốt nhất khi cần trích field theo nhu cầu agent. |
| Serper | Rất tốt | JSON sạch, tốc độ cao, rất phổ biến trong cộng đồng n8n / LangChain, phù hợp với tool search cơ bản và giá rẻ. |
| SerpApi | Tốt | Schema ổn định, tài liệu tốt. Hợp khi agent cần dữ liệu Google vertical như Maps, Scholar, Shopping. |
| DataForSEO | Tốt | Mạnh nhất khi agent là một phần của pipeline SEO lớn hơn. |
| Scrapingdog | Tốt | Nhanh, rẻ, schema Google SERP ổn định. |
| Bright Data | Tốt | Hợp cho thu thập dữ liệu mới, quy mô lớn, đa engine, đa khu vực. |
| ScraperAPI | Trung bình | Hợp hơn khi agent còn cần scraping web tổng quát. |
| Apify | Trung bình đến tốt | Linh hoạt nhưng chậm hơn, phù hợp workflow batch theo lịch. |
Ví dụ thực tế với Thunderbit: Giả sử AI agent của bạn cần phân tích ý định tìm kiếm của từ khóa “best CRM for real estate”. Bạn có thể định nghĩa một Schema yêu cầu trả về organic results (title, URL, snippet, rank), các câu hỏi PAA kèm answer snippet, và phân loại intent thương mại. Extract API của Thunderbit sẽ trả đúng cấu trúc đó — không thừa, không thiếu. Nhờ vậy, agent không phải tốn token để lọc field không liên quan, cũng không phải dọn rác HTML.
Với RAG workflow, Distill API của Thunderbit có thể chuyển SERP page thành Markdown sạch để đem đi embedding ngay. Phần lớn SERP API chuyên dụng chỉ trả về schema JSON cố định; còn cách của Thunderbit cho phép developer điều chỉnh output theo đúng nhu cầu của model downstream.
Use case decision matrix: nếu bạn cần X, hãy chọn Y
Người trong forum lúc nào cũng hỏi: có thể gắn khuyến nghị trực tiếp với workflow thật không, thay vì nói chung chung “tùy trường hợp”? Vậy nên tôi làm bảng này.
| Use case của bạn | Lựa chọn tốt nhất | Lựa chọn thứ hai | Lý do |
|---|---|---|---|
| SEO rank tracking (tần suất cao) | DataForSEO | Scrapingdog | Endpoint SEO gốc, giá batch, parsing đầy đủ |
| Google Maps / local business data | SerpApi | Bright Data | Maps endpoint rất chín; Bright Data hợp cho local scraping cấp enterprise |
| AI agent / n8n automation | Thunderbit | Serper | Custom Schema + Markdown hợp cho RAG; Serper hợp cho gọi search đơn giản, nhanh và rẻ |
| MVP / side project tiết kiệm (<50 USD/tháng) | Serper | Scrapingdog | Free tier tốt, pay-as-you-go, thiết lập đơn giản |
| Đa engine (Bing, Yandex, DuckDuckGo) | Thunderbit | DataForSEO | Thunderbit có thể dùng cho bất kỳ search engine nào nhờ AI extraction; DataForSEO có endpoint đa engine |
| Google Reviews aggregation | SerpApi | DataForSEO | Có endpoint parse review chuyên dụng |
| Ecommerce / product monitoring | SerpApi | DataForSEO | Độ phủ Google Shopping mạnh, field cấu trúc tốt |
| Custom scraping workflow | Apify | ScraperAPI | Actor linh hoạt; ScraperAPI hợp khi cần scraping tổng quát + SERP |
Gợi ý nhanh theo nhóm người dùng:
- SEO team: Nếu bạn xây dashboard, hãy xem DataForSEO trước; nếu bạn ưu tiên độ phủ Google vertical và chất lượng tài liệu, chọn SerpApi.
- Sales team: Nếu workflow đi qua SERP, directory và enrich data, chọn Thunderbit; nếu chỉ cần tìm lead đơn giản, chọn Serper.
- AI tool developer: Cần custom schema / RAG thì chọn Thunderbit; muốn gọi search rẻ và nhanh thì dùng Serper; cần dữ liệu Google vertical ổn định thì SerpApi.
- Indie hacker: Bắt đầu từ free tier của Serper, Scrapingdog, SerpApi và Thunderbit. Chạy thử 20 query sát với production thật rồi hãy quyết định có trả phí hay không.
So sánh rate limit, độ tin cậy và mức sẵn sàng cho production
Lần đầu tôi đánh giá nhà cung cấp cho workflow production, tôi ước gì đã có phần này. Các team phải chạy hàng nghìn query mỗi ngày cần rate limit dự đoán được, retry tự động và đảm bảo uptime — và gần như không có bài so sánh nào ngoài kia nói hệ thống về mấy chuyện này.
| Nhà cung cấp | Rate limit | Concurrency | Retry khi lỗi | SLA / Uptime |
|---|---|---|---|---|
| Thunderbit Free | 600 units một lần | 2 | Có sẵn (chống scraping, CAPTCHA) | — |
| Thunderbit Starter | 60,000 units/tháng | 30 | Có sẵn | — |
| Thunderbit Pro | 600,000 units/tháng | 50 | Có sẵn | — |
| SerpApi | Theo gói (search mỗi giờ) | Theo gói | Nhà cung cấp xử lý proxy / CAPTCHA | SLA 99.95% |
| Serper | Theo tài khoản / gói | Không công khai rộng | Nên retry phía client | Không công bố SLA |
| Scrapingdog | Theo gói | Tùy điều khoản gói | Có chống chặn sẵn | Không phải lúc nào cũng công khai |
| DataForSEO | Mỗi endpoint / mode đều có mô tả | Thay đổi theo mode | Async hỗ trợ polling / retry | Hỗ trợ enterprise |
| Bright Data | Có tài liệu, khuyên tăng lưu lượng dần | Concurrency cấp enterprise | Có sẵn giải chặn | Enterprise SLA |
| ScraperAPI | Concurrency theo gói | Phụ thuộc credit | Xử lý retry / proxy | Có tùy chọn hỗ trợ trả phí |
| Apify | Phụ thuộc Actor / memory / compute | Theo giới hạn nền tảng | Cấu hình ở cấp actor | Độ tin cậy theo nền tảng |
Checklist trước khi lên production:
- Hỏi rõ: request bị fail hoặc bị chặn có bị tính phí hay không.
- Xác nhận concurrency, số request mỗi phút, và quy tắc khi burst traffic.
- Kiểm tra geolocation, mobile vs. desktop, và JS rendering có làm thay đổi mức tiêu credit không.
- Lưu 20–50 sample JSON từ query thật, rồi so sánh field name ở các ngày khác nhau để xem schema có ổn định không.
- Nếu dữ liệu SERP là yếu tố sống còn với business, hãy thêm retry và timeout budget ở client.
Nhìn một phát là hiểu: 8 SERP API tóm tắt so sánh
| Nhà cung cấp | Tốc độ trung bình | Chi phí mỗi 1K | Free tier | Độ phủ parsing | Mức phù hợp AI | Đa engine | Kết luận |
|---|---|---|---|---|---|---|---|
| Thunderbit | Trung bình (AI extraction) | Distill thấp, Extract cao hơn | Có | Tùy chỉnh (mọi feature) | Rất tốt | Rất tốt | Tốt nhất cho SERP extraction kiểu AI-native và RAG |
| SerpApi | ~5.5 giây | Cao | 250 lần/tháng | Rất mạnh (cố định) | Tốt | Google vertical rất rộng | Độ phủ Google trưởng thành nhất |
| Serper | ~2–3 giây | Rất thấp | 2,500 query | Tốt | Rất tốt | Chủ yếu Google | Rẻ, nhanh, hợp AI / MVP |
| Scrapingdog | ~1.25 giây | Rất thấp ở quy mô lớn | 200 credit/tháng | Tốt | Tốt | Cần kiểm tra support engine | Combo tốc độ / chi phí tốt nhất |
| DataForSEO | Trung bình đến chậm (Standard) | Thấp đến trung bình | Credit dùng thử | Rất mạnh | Tốt | Rất mạnh | Tốt nhất cho hạ tầng SEO platform |
| Bright Data | ~2–5.5 giây | Cấp enterprise | Free tier (5,000 credit/tháng) | Tốt (tùy sản phẩm) | Tốt | Rất mạnh | Tốt nhất cho thu thập dữ liệu enterprise |
| ScraperAPI | ~33 giây | Phụ thuộc credit | 5,000 credit dùng thử | Trung bình | Trung bình | Google endpoint | Nếu SERP chỉ là một phần của hệ thống scraping lớn hơn, đây là lựa chọn ổn |
| Apify | ~8 giây | Tùy Actor | Credit hàng tháng | Tùy Actor | Trung bình đến tốt | Tùy Actor | Tốt nhất cho workflow automation tùy chỉnh |
Cách Thunderbit hòa vào workflow SERP của bạn
Để nói thêm một chút về lý do đội ngũ chúng tôi thiết kế API Thunderbit như hiện tại. Mô hình SERP API truyền thống — endpoint cố định, field output định sẵn, chỉ hỗ trợ Google — thì ổn cho việc theo dõi thứ hạng đơn giản. Nhưng chỉ cần nhu cầu lệch đi một chút, ví dụ bạn muốn PAA answer có kèm sentiment, local pack có review count, hoặc shopping data phải được format theo schema database riêng, thì bạn sẽ phải xử lý hậu kỳ hoặc đổi nhà cung cấp.
Extract API của Thunderbit lật ngược mô hình đó. Bạn nói với nó mình muốn gì bằng JSON Schema, và AI sẽ tự quyết định cách trích xuất từ trang tìm kiếm bạn đưa vào. Hôm nay là Google, ngày mai là Bing, tuần sau là một vertical search engine nào đó — vẫn cùng một API, cùng một cách dùng.
Distill API giải quyết một bài toán khác: biến SERP page lộn xộn thành Markdown sạch để LLM có thể đọc thật sự, không bị HTML noise, navigation element hay tracking script làm rối. Nếu bạn đang xây một RAG workflow cần bằng chứng tìm kiếm theo thời gian thực, đây là đường nhanh nhất từ “SERP live” đến “nội dung có thể embedding”.
Cả hai endpoint này đều có sẵn chống scraping, xử lý CAPTCHA và JS rendering. Bạn không phải trả thêm phí — tất cả đã nằm trong credit cost.
Dùng thử Thunderbit Chrome Extension
Bạn có thể tự trải nghiệm: Thunderbit Chrome Extension để scrape ngay trong browser; hoặc gọi API trực tiếp để xây workflow tự động. Nếu bạn muốn xem cách nó hoạt động trước khi viết code, kênh YouTube của chúng tôi cũng có video demo.
Một lưu ý nhỏ về tính hợp pháp
Đây gần như là câu hỏi xuất hiện ở mọi FAQ, nên tôi nói ngắn gọn: tính hợp pháp của SERP scraping phụ thuộc vào tình huống cụ thể và khu vực pháp lý. Vụ hiQ v. LinkedIn xác nhận rằng việc scrape dữ liệu công khai không nhất thiết là hành vi phạm luật máy tính, nhưng điều đó không có nghĩa là muốn scrape gì cũng được. Google cũng từng kiện SerpApi vì vấn đề scraping SERP, cho thấy áp lực thương mại quanh chuyện truy cập dữ liệu vẫn còn rất lớn.
Lời khuyên thực tế: dùng API theo điều khoản của nhà cung cấp, tránh thu thập dữ liệu cá nhân nếu không thật sự cần, và hỏi rõ nhà cung cấp họ xử lý compliance như thế nào. Đừng mặc định rằng SERP scraping là không có rủi ro.
Kết luận
Không có nhà cung cấp nào thắng ở mọi tiêu chí; lựa chọn tốt nhất sẽ phụ thuộc vào use case, ngân sách và stack kỹ thuật của bạn. Sau khi quy đổi giá, test tốc độ, map độ phủ parsing và đánh giá mức phù hợp với AI agent, khung ra quyết định của tôi như sau:
- Cần linh hoạt + hợp AI agent? → Thunderbit
- Cần độ phủ Google toàn diện? → SerpApi
- Cần tốc độ + chi phí thấp nhất? → Serper hoặc Scrapingdog
- Đang xây SEO platform? → DataForSEO
- Cần quy mô enterprise và SLA? → Bright Data hoặc DataForSEO
- Cần scraping tổng quát + thỉnh thoảng dùng SERP? → ScraperAPI hoặc Apify
Hãy bắt đầu từ free tier. Chạy 20–50 query thật giống production của bạn. So sánh JSON trả về. Tính đúng chi phí thực sau credit và hệ số nhân. Rồi mới quyết định có đầu tư chính thức hay không.
Thị trường này đổi giá rất nhanh — bài so sánh này được quy đổi từ các trang công khai tính đến tháng 5/2026. Nếu bạn quay lại xem bài này sau vài tháng, hãy kiểm tra lại trước khi mua.
Nếu bạn muốn tìm hiểu thêm về AI Web Scraper và sự khác biệt của nó so với cách truyền thống, chúng tôi đã có khá nhiều bài viết liên quan. Nếu bạn đang cân nhắc web scraping không cần code, Chrome Extension của Thunderbit cũng làm tốt phần đó.
Câu hỏi thường gặp
1. SERP API là gì, và ai cần nó?
SERP API là dịch vụ gửi truy vấn tìm kiếm đến các search engine như Google, Bing hoặc Yandex, rồi trả kết quả về dưới dạng dữ liệu có cấu trúc, thường là JSON. Người làm SEO dùng nó để theo dõi thứ hạng, team sales dùng để tìm lead, team ecommerce dùng để theo dõi giá, còn AI developer thì đưa dữ liệu tìm kiếm thời gian thực vào agent và RAG workflow.
2. Tốn bao nhiêu tiền để lấy 1,000 kết quả Google search qua API?
Giá rất khác nhau — từ khoảng 0.60 USD mỗi 1K ở gói DataForSEO Standard, đến khoảng 25 USD mỗi 1K ở SerpApi Starter. Mức giảm theo volume cũng khác nhau rất nhiều giữa các bên. Hãy luôn so sánh theo 1,000 truy vấn thành công, đừng chỉ nhìn giá niêm yết.
3. Tôi có thể dùng SERP API trong LangChain hoặc n8n cho AI agent không?
Có. Serper được cộng đồng n8n dùng khá nhiều cho các tác vụ search đơn giản. Thunderbit mạnh nhất khi agent cần JSON Schema tùy chỉnh hoặc Markdown cho RAG. SerpApi lại rất hợp với agent cần dữ liệu Google vertical ổn định như Maps, Scholar, Shopping.
4. SERP API nào có free tier tốt nhất để test?
Serper cho ngay 2,500 query miễn phí khi đăng ký — hào phóng nhất nếu chỉ xét số lượng. SerpApi cho 250 lần/tháng, Scrapingdog cho 200 credit/tháng, ScraperAPI cho 5,000 credit dùng thử trong 7 ngày, và Thunderbit cũng có free credit để làm prototype. Apify cũng có khoảng 5 USD platform credit miễn phí mỗi tháng.
5. Trước khi mua, tôi nên kiểm tra nhà cung cấp parse được những SERP feature nào?
Đừng mặc định rằng “structured JSON” nghĩa là có đủ mọi thứ. Bạn nên kiểm tra xem API có trả về có cấu trúc cho các field này không: People Also Ask, knowledge panel, local pack / maps, shopping results, featured snippet, ads ở trên / dưới, image results và video results. Hãy dùng ma trận parsing trong bài này làm checklist, rồi test bằng query thật trước khi quyết định trả tiền.
Dùng thử Thunderbit, trải nghiệm AI web scraping Get Started Free
Tìm hiểu thêm



