
Dữ liệu web là đầu vào mặc định cho sales, marketing và vận hành. Nếu bạn vẫn đang copy-paste thủ công, bạn đã chậm một nhịp rồi.
Nhưng vấn đề của các công cụ scraping “miễn phí” là gì? Phần lớn chúng không thật sự miễn phí. Hoặc chỉ là bản dùng thử với giới hạn rất chặt, hoặc những tính năng bạn cần nhất lại bị khóa sau paywall.
Tôi đã đánh giá 12 công cụ để tìm ra đâu là những lựa chọn cho phép bạn làm việc thực sự ở gói miễn phí. Tôi đã scrape danh sách Google Maps, các trang động có yêu cầu đăng nhập, và cả PDF. Có công cụ làm rất tốt. Có công cụ thì chỉ khiến tôi mất cả buổi chiều.
Dưới đây là phần đánh giá thẳng thắn nhất — bắt đầu với những công cụ mà tôi thật sự khuyên dùng.
Vì Sao Công Cụ Scraper Miễn Phí Ngày Càng Quan Trọng
Nói thật nhé: trong năm 2026, web scraping không còn là sân chơi riêng của hacker hay data scientist. Nó đã trở thành một phần quen thuộc của doanh nghiệp hiện đại, và số liệu cũng chứng minh điều đó. Thị trường phần mềm web scraping đã đạt 1,01 tỷ USD vào năm 2024 và được dự đoán sẽ tăng hơn gấp đôi vào năm 2032. Vì sao? Vì từ đội sales đến môi giới bất động sản, ai cũng đang dùng dữ liệu web để tăng tốc.
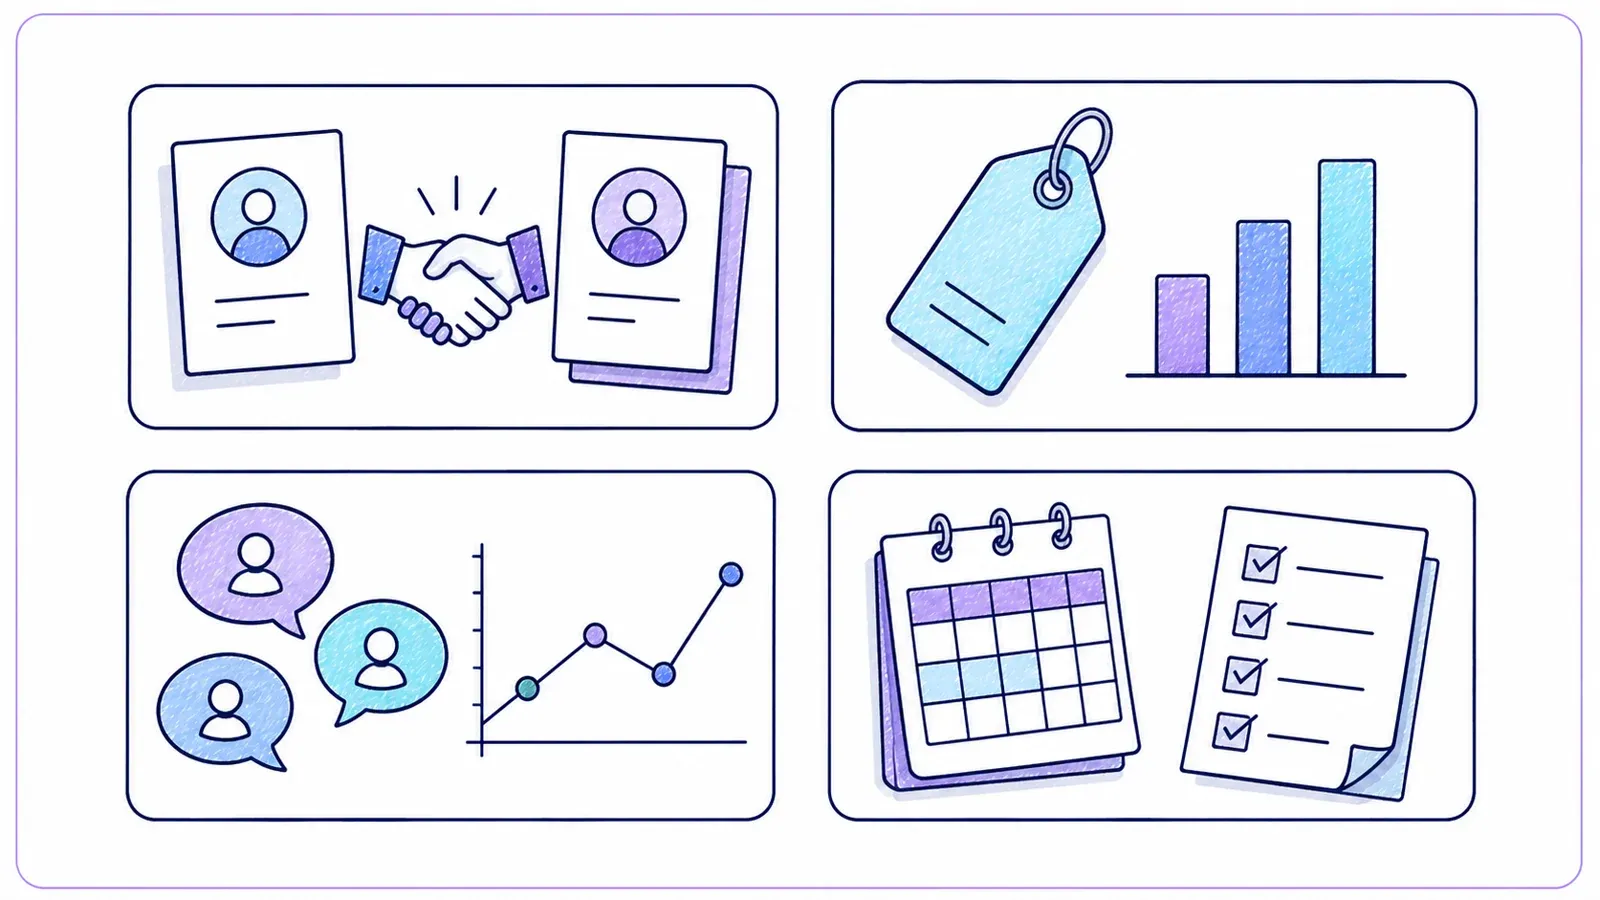
- Tạo lead: Đội sales scrape danh bạ, Google Maps và mạng xã hội để xây dựng danh sách khách hàng tiềm năng đúng mục tiêu — không còn phải mò thủ công nữa.
- Theo dõi giá & nghiên cứu đối thủ: Các đội ecommerce và bán lẻ theo dõi SKU, giá bán và review của đối thủ để luôn đi trước một bước (và đúng vậy, 82% công ty thương mại điện tử đang scrape vì lý do này).
- Nghiên cứu thị trường & phân tích cảm xúc: Marketer tổng hợp review, tin tức và thảo luận trên mạng xã hội để nắm xu hướng và quản lý danh tiếng thương hiệu.
- Tự động hóa quy trình: Đội vận hành tự động hóa mọi thứ, từ kiểm tra tồn kho đến báo cáo định kỳ, tiết kiệm hàng giờ mỗi tuần.
Và đây là một con số khá thú vị: các công ty dùng AI web scraper đang tiết kiệm 30–40% thời gian so với cách làm thủ công. Đó không chỉ là tiết kiệm một chút thời gian — mà là khác biệt giữa tan làm lúc 6 giờ hay 9 giờ tối.
Cách Chúng Tôi Chọn Ra Những Công Cụ Data Scraper Miễn Phí Tốt Nhất
Tôi đã thấy rất nhiều danh sách “web scraper tốt nhất” chỉ lặp lại đúng những câu marketing. Danh sách này thì không. Với bài này, tôi xem xét:
- Tính hữu dụng thật sự của gói miễn phí: Gói miễn phí có cho bạn làm việc thực tế không, hay chỉ là mồi nhử?
- Mức độ dễ dùng: Người không biết code có thể ra kết quả trong vài phút không, hay phải có bằng PhD về Regex?
- Loại website được hỗ trợ: Trang tĩnh, trang động, phân trang, cần đăng nhập, PDF, mạng xã hội — công cụ có xử lý được tình huống thực tế không?
- Tùy chọn xuất dữ liệu: Bạn có thể đưa dữ liệu vào Excel, Google Sheets, Notion hoặc Airtable mà không phải vòng vo không?
- Tính năng bổ sung: Trích xuất bằng AI, lập lịch, template, xử lý sau khi lấy dữ liệu, tích hợp.
- Phù hợp với nhóm người dùng nào: Công cụ này dành cho business user, analyst hay developer?
Tôi cũng đào sâu tài liệu của từng công cụ, thử quy trình onboarding và so sánh giới hạn của gói miễn phí — vì “free” không phải lúc nào cũng miễn phí như nghe có vẻ.
Nhìn Nhanh: So Sánh 12 Công Cụ Free Data Scraper
Dưới đây là bảng so sánh nhanh để bạn dễ chọn ra công cụ phù hợp nhất với nhu cầu.
| Công cụ | Nền tảng | Giới hạn gói miễn phí | Phù hợp nhất cho | Định dạng xuất | Tính năng nổi bật |
|---|---|---|---|---|---|
| Thunderbit | Tiện ích Chrome | 6 trang/tháng | Người không biết code, doanh nghiệp | Excel, CSV | Prompt AI, scrape PDF/hình ảnh, crawl trang con |
| Browse AI | Cloud | 50 credit/tháng | Người dùng no-code | CSV, Sheets | Robot kéo-thả, lập lịch |
| Octoparse | Desktop | 10 tác vụ, 50k dòng/tháng | No-code, bán kỹ thuật | CSV, Excel, JSON | Workflow trực quan, hỗ trợ site động |
| ParseHub | Desktop | 5 dự án, 200 trang/lượt chạy | No-code, bán kỹ thuật | CSV, Excel, JSON | Giao diện trực quan, hỗ trợ site động |
| Webscraper.io | Tiện ích Chrome | Dùng local không giới hạn | No-code, tác vụ đơn giản | CSV, XLSX | Dựa trên sitemap, template cộng đồng |
| Apify | Cloud | 5 USD credit/tháng | Team, bán kỹ thuật, dev | CSV, JSON, Sheets | Chợ Actor, lập lịch, API |
| Scrapy | Thư viện Python | Không giới hạn (mã nguồn mở) | Developer | CSV, JSON, DB | Toàn quyền code, mở rộng tốt |
| Puppeteer | Thư viện Node.js | Không giới hạn (mã nguồn mở) | Developer | Tùy chỉnh (code) | Headless browser, hỗ trợ JS động |
| Selenium | Đa ngôn ngữ | Không giới hạn (mã nguồn mở) | Developer | Tùy chỉnh (code) | Tự động hóa trình duyệt, hỗ trợ nhiều browser |
| Zyte | Cloud | 1 spider, 1 giờ/job, lưu 7 ngày | Dev, đội vận hành | CSV, JSON | Scrapy được host sẵn, quản lý proxy |
| SerpAPI | API | 100 lượt tìm kiếm/tháng | Dev, analyst | JSON | API cho công cụ tìm kiếm, chống chặn |
| Diffbot | API | 10.000 credit/tháng | Dev, dự án AI | JSON | Trích xuất bằng AI, knowledge graph |
Thunderbit: Lựa Chọn Hàng Đầu Cho Web Scraping Thân Thiện, Dùng AI
Scrape data from any website using AI Thunderbit's agentic web scraper reads any website's tables and listings itself and extracts them in one click, for free. Get Started Free
Hãy nói về lý do tại sao Thunderbit đứng đầu danh sách của tôi. Tôi không chỉ nói vậy vì tôi là một phần của team — tôi thật sự tin Thunderbit là thứ gần nhất với một trợ lý AI thực thụ, biết lắng nghe (và không đòi cà phê nghỉ giải lao).
Thunderbit không phải kiểu công cụ mà bạn phải “học trước rồi mới scrape”. Nó giống như đang giao việc cho một trợ lý thông minh: bạn chỉ cần mô tả thứ mình muốn (“Lấy toàn bộ tên sản phẩm, giá và link từ trang này”), và AI của Thunderbit sẽ lo phần còn lại. Không cần XPath, không cần CSS selector, không phải đau đầu với Regex. Nếu bạn muốn scrape các trang con (như trang chi tiết sản phẩm hoặc link liên hệ của công ty), Thunderbit có thể tự động bấm qua và làm giàu bảng dữ liệu của bạn — cũng chỉ bằng một nút bấm.
Điểm làm Thunderbit khác biệt nhất là những gì diễn ra sau khi scrape xong. Bạn cần tóm tắt, dịch, phân loại hay làm sạch dữ liệu? Tính năng AI hậu xử lý tích hợp sẵn của Thunderbit sẽ lo tất cả. Bạn không chỉ nhận được dữ liệu thô — mà là dữ liệu có cấu trúc, sẵn sàng dùng ngay cho CRM, bảng tính hoặc dự án tiếp theo.
Gói miễn phí: Bản dùng thử miễn phí của Thunderbit cho phép bạn scrape tối đa 6 trang (hoặc 10 trang nếu có trial boost), bao gồm PDF, hình ảnh và cả template cho mạng xã hội. Bạn có thể xuất sang Excel hoặc CSV miễn phí, đồng thời thử các tính năng như trích xuất email/số điện thoại/hình ảnh. Với nhu cầu lớn hơn, gói trả phí sẽ mở thêm số trang, xuất trực tiếp sang Google Sheets/Notion/Airtable, scrape theo lịch và template tức thì cho các site phổ biến như Amazon, Google Maps và Instagram.
Nếu bạn muốn xem Thunderbit hoạt động thực tế, hãy xem Thunderbit Chrome Extension hoặc ghé kênh YouTube để xem video hướng dẫn nhanh.
Try Thunderbit Free Free plan covers 6 pages a month, no credit card required — try Thunderbit before you pay for anything. Get Started Free
Những Tính Năng Nổi Bật Của Thunderbit
- One Click Extract: Chỉ cần bấm một lần — AI của Thunderbit sẽ đọc trang, xác định cột phù hợp và tự xây logic trích xuất.
- Scrape trang con: Tự động bấm qua các trang chi tiết hoặc link liên quan để làm giàu bảng dữ liệu chính — không cần thiết lập thủ công.
- Template tức thì: Scraper một chạm cho Amazon, Google Maps, Instagram và nhiều nền tảng khác.
- Scrape PDF & hình ảnh: Trích xuất bảng và dữ liệu từ PDF, hình ảnh bằng AI — không cần công cụ bổ sung.
- Hỗ trợ đa ngôn ngữ: Scrape và xử lý dữ liệu bằng 34 ngôn ngữ.
- Xuất trực tiếp: Đẩy dữ liệu thẳng sang Excel, Google Sheets, Notion hoặc Airtable (ở gói trả phí).
- AI hậu xử lý: Tóm tắt, dịch, phân loại và làm sạch dữ liệu ngay trong lúc scrape.
- Trích xuất email/số điện thoại/hình ảnh miễn phí: Lấy thông tin liên hệ hoặc hình ảnh từ bất kỳ website nào chỉ với một cú nhấp.
Thunderbit là cầu nối giữa “chỉ lấy dữ liệu” và “lấy được dữ liệu thực sự hữu ích”. Đây là thứ gần nhất mà tôi từng thấy với một trợ lý dữ liệu AI đúng nghĩa dành cho người dùng doanh nghiệp.
Phần Còn Lại Của Top 12: Đánh Giá Các Công Cụ Data Scraper Miễn Phí
Hãy cùng phân tích phần còn lại, chia theo nhóm người dùng phù hợp nhất.
Dành Cho Người Dùng No-Code & Doanh Nghiệp
Thunderbit
Đã được giới thiệu ở trên. Đây là lựa chọn dễ vào nhất cho người không biết code, với tính năng AI và template tức thì.
Webscraper.io
- Nền tảng: Tiện ích Chrome
- Phù hợp nhất cho: Site đơn giản, tĩnh; người không biết code nhưng chấp nhận thử sai một chút.
- Tính năng chính: Scrape dựa trên sitemap, hỗ trợ phân trang, xuất CSV/XLSX.
- Gói miễn phí: Dùng local không giới hạn, nhưng không có chạy cloud hay lập lịch. Chỉ thao tác thủ công.
- Hạn chế: Không có xử lý sẵn cho đăng nhập, PDF hay nội dung động phức tạp. Chỉ có hỗ trợ từ cộng đồng.
ParseHub
- Nền tảng: Ứng dụng desktop (Windows, Mac, Linux)
- Phù hợp nhất cho: Người không biết code và người dùng bán kỹ thuật sẵn sàng dành thời gian học.
- Tính năng chính: Trình xây workflow trực quan, hỗ trợ site động, AJAX, đăng nhập, phân trang.
- Gói miễn phí: 5 dự án công khai, 200 trang mỗi lượt chạy, chỉ chạy thủ công.
- Hạn chế: Dự án ở gói miễn phí là công khai (cẩn thận với dữ liệu nhạy cảm), không có lập lịch, tốc độ trích xuất chậm hơn.
Octoparse
- Nền tảng: Ứng dụng desktop (Windows/Mac), Cloud (trả phí)
- Phù hợp nhất cho: Người không biết code và analyst muốn sức mạnh lẫn tính linh hoạt.
- Tính năng chính: Kéo-thả trực quan, hỗ trợ nội dung động, template cho các site phổ biến.
- Gói miễn phí: 10 tác vụ, tối đa 50.000 dòng/tháng, chỉ chạy trên desktop (không cloud/lập lịch).
- Hạn chế: Không có API, xoay IP hay lập lịch ở gói miễn phí. Học khá vất vả với site phức tạp.
Browse AI
- Nền tảng: Cloud
- Phù hợp nhất cho: Người dùng no-code muốn tự động hóa các tác vụ scraping và monitoring đơn giản.
- Tính năng chính: Robot ghi lại thao tác kéo-thả, lập lịch, tích hợp (Sheets, Zapier).
- Gói miễn phí: 50 credit/tháng, 1 website, tối đa 5 robot.
- Hạn chế: Khối lượng sử dụng hạn chế, ban đầu có thể hơi khó với site phức tạp.
Dành Cho Developer & Người Dùng Kỹ Thuật
Scrapy
- Nền tảng: Thư viện Python (mã nguồn mở)
- Phù hợp nhất cho: Developer muốn toàn quyền kiểm soát và khả năng mở rộng.
- Tính năng chính: Tùy biến cao, hỗ trợ crawl quy mô lớn, middleware, pipeline.
- Gói miễn phí: Không giới hạn (mã nguồn mở).
- Hạn chế: Không có giao diện kéo-thả, cần viết code Python. Không dành cho người không biết code.
Puppeteer
- Nền tảng: Thư viện Node.js (mã nguồn mở)
- Phù hợp nhất cho: Developer scrape site động, nhiều JavaScript.
- Tính năng chính: Tự động hóa trình duyệt headless, toàn quyền kiểm soát điều hướng và trích xuất.
- Gói miễn phí: Không giới hạn (mã nguồn mở).
- Hạn chế: Cần code JavaScript, không có GUI.
Selenium
- Nền tảng: Đa ngôn ngữ (Python, Java, v.v.), mã nguồn mở
- Phù hợp nhất cho: Developer tự động hóa trình duyệt để scrape hoặc test.
- Tính năng chính: Hỗ trợ nhiều browser, tự động click, cuộn trang, đăng nhập.
- Gói miễn phí: Không giới hạn (mã nguồn mở).
- Hạn chế: Chậm hơn các thư viện headless, cần viết script.
Zyte (Scrapy Cloud)
- Nền tảng: Cloud
- Phù hợp nhất cho: Developer và đội vận hành triển khai spider Scrapy ở quy mô lớn.
- Tính năng chính: Scrapy được host sẵn, quản lý proxy, lập lịch job.
- Gói miễn phí: 1 spider đồng thời, 1 giờ/job, lưu dữ liệu 7 ngày.
- Hạn chế: Không có lập lịch nâng cao ở gói miễn phí, cần biết Scrapy.
Dành Cho Nhóm & Doanh Nghiệp
Apify
- Nền tảng: Cloud
- Phù hợp nhất cho: Team, người dùng bán kỹ thuật và developer muốn dùng scraper có sẵn hoặc tự xây.
- Tính năng chính: Chợ Actor (bot dựng sẵn), lập lịch, API, tích hợp.
- Gói miễn phí: 5 USD credit/tháng (đủ cho tác vụ nhỏ), lưu dữ liệu 7 ngày.
- Hạn chế: Có độ khó nhất định, mức sử dụng bị giới hạn bởi credit.
SerpAPI
- Nền tảng: API
- Phù hợp nhất cho: Developer và analyst cần dữ liệu từ công cụ tìm kiếm (Google, Bing, YouTube).
- Tính năng chính: API tìm kiếm, chống chặn, đầu ra JSON có cấu trúc.
- Gói miễn phí: 100 lượt tìm kiếm/tháng.
- Hạn chế: Không dùng cho website bất kỳ, chỉ hoạt động qua API.
Diffbot
- Nền tảng: API
- Phù hợp nhất cho: Developer, đội AI/ML và doanh nghiệp cần dữ liệu web có cấu trúc ở quy mô lớn.
- Tính năng chính: Trích xuất bằng AI, knowledge graph, API cho bài viết/sản phẩm.
- Gói miễn phí: 10.000 credit/tháng.
- Hạn chế: Chỉ qua API, cần kỹ năng kỹ thuật, tốc độ bị giới hạn.
Giới Hạn Gói Miễn Phí: “Miễn Phí” Thực Sự Nghĩa Là Gì Với Từng Công Cụ
Nói thật nhé — “miễn phí” có thể có nghĩa từ “dùng thoải mái cho hobby” đến “chỉ đủ để bạn tò mò rồi muốn nâng cấp”. Đây là phần tóm tắt những gì bạn thực sự nhận được:
| Công cụ | Trang/dòng mỗi tháng | Định dạng xuất | Lập lịch | Truy cập API | Giới hạn miễn phí đáng chú ý |
|---|---|---|---|---|---|
| Thunderbit | 6 trang | Excel, CSV | Không | Không | One Click Extract bị giới hạn, không xuất trực tiếp Sheets/Notion ở gói miễn phí |
| Browse AI | 50 credit | CSV, Sheets | Có | Có | 1 website, 5 robot, lưu 15 ngày |
| Octoparse | 50.000 dòng | CSV, Excel, JSON | Không | Không | Chỉ chạy desktop, không cloud/lập lịch |
| ParseHub | 200 trang/lượt chạy | CSV, Excel, JSON | Không | Không | 5 dự án công khai, tốc độ chậm |
| Webscraper.io | Local không giới hạn | CSV, XLSX | Không | Không | Chạy thủ công, không có cloud |
| Apify | 5 USD credit (~khá nhỏ) | CSV, JSON, Sheets | Có | Có | Lưu 7 ngày, bị giới hạn credit |
| Scrapy | Không giới hạn | CSV, JSON, DB | Không | N/A | Cần viết code |
| Puppeteer | Không giới hạn | Tùy chỉnh (code) | Không | N/A | Cần viết code |
| Selenium | Không giới hạn | Tùy chỉnh (code) | Không | N/A | Cần viết code |
| Zyte | 1 spider, 1 giờ/job | CSV, JSON | Hạn chế | Có | Lưu 7 ngày, 1 job đồng thời |
| SerpAPI | 100 lượt tìm kiếm | JSON | Không | Có | Chỉ dành cho API tìm kiếm |
| Diffbot | 10.000 credit | JSON | Không | Có | Chỉ API, bị giới hạn tốc độ |
Kết luận ngắn gọn: Với các dự án thực tế, Thunderbit, Browse AI và Apify là những lựa chọn dùng thử miễn phí hữu ích nhất cho người dùng doanh nghiệp. Với scraping thường xuyên hoặc quy mô lớn, bạn sẽ nhanh chóng chạm giới hạn và phải nâng cấp hoặc chuyển sang giải pháp mã nguồn mở/dựa trên code.
Công Cụ Data Scraper Nào Phù Hợp Nhất Với Bạn? (Hướng Dẫn Theo Loại Người Dùng)
Đây là bảng cheat sheet giúp bạn chọn đúng công cụ theo vai trò và mức độ thoải mái với công nghệ:
| Loại người dùng | Công cụ tốt nhất (miễn phí) | Vì sao |
|---|---|---|
| Người không biết code (Sales/Marketing) | Thunderbit, Browse AI, Webscraper.io | Dễ học nhất, kéo-thả, có AI hỗ trợ |
| Bán kỹ thuật (Ops/Analyst) | Octoparse, ParseHub, Apify, Zyte | Mạnh hơn, xử lý site phức tạp tốt hơn, có thể viết script ở mức nào đó |
| Developer/Kỹ sư | Scrapy, Puppeteer, Selenium, Diffbot, SerpAPI | Toàn quyền kiểm soát, không giới hạn, ưu tiên API |
| Team/Doanh nghiệp | Apify, Zyte | Hợp tác nhóm, lập lịch, tích hợp |
So Sánh Tính Linh Hoạt Trong Các Tình Huống Web Scraping Thực Tế
Hãy xem những công cụ này thể hiện thế nào trong 5 tình huống scraping phổ biến:
| Tình huống | Thunderbit | Browse AI | Octoparse | ParseHub | Webscraper.io | Apify | Scrapy | Puppeteer | Selenium | Zyte | SerpAPI | Diffbot |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Danh sách có phân trang | Dễ | Dễ | Trung bình | Trung bình | Trung bình | Dễ | Dễ | Dễ | Dễ | Dễ | N/A | Trung bình |
| Danh sách Google Maps | Dễ* | Khó | Trung bình | Trung bình | Khó | Dễ | Khó | Khó | Khó | Khó | Dễ | N/A |
| Trang cần đăng nhập | Dễ | Trung bình | Trung bình | Trung bình | Thủ công | Trung bình | Dễ | Dễ | Dễ | Dễ | N/A | N/A |
| Trích xuất dữ liệu từ PDF | Dễ | Không | Không | Không | Không | Trung bình | Khó | Khó | Khó | Khó | Không | Hạn chế |
| Nội dung mạng xã hội | Dễ* | Một phần | Khó | Khó | Khó | Dễ | Khó | Khó | Khó | Khó | YouTube | Hạn chế |
- Thunderbit và Apify có sẵn template/Actor cho Google Maps và scraping mạng xã hội, nên những tình huống này dễ hơn nhiều cho người không chuyên.
Plugin vs. Desktop vs. Cloud: Trải Nghiệm Dùng Web Scraper Nào Tốt Nhất?
- Tiện ích Chrome (Thunderbit, Webscraper.io):
- Ưu điểm: Bắt đầu rất nhanh, chạy ngay trong trình duyệt, hầu như không cần thiết lập.
- Nhược điểm: Phải thao tác thủ công, dễ bị ảnh hưởng khi website thay đổi, tự động hóa hạn chế.
- Lợi thế của Thunderbit: AI xử lý thay đổi cấu trúc, điều hướng qua trang con, thậm chí cả scraping PDF/hình ảnh — mạnh hơn nhiều so với extension truyền thống.
- Ứng dụng desktop (Octoparse, ParseHub):
- Ưu điểm: Mạnh, workflow trực quan, xử lý tốt site động và login.
- Nhược điểm: Đường học khá dốc, gói miễn phí không có tự động hóa cloud, phụ thuộc hệ điều hành.
- Nền tảng cloud (Browse AI, Apify, Zyte):
- Ưu điểm: Lập lịch, cộng tác nhóm, mở rộng quy mô tốt, dễ tích hợp.
- Nhược điểm: Gói miễn phí thường bị giới hạn bởi credit, cần thiết lập nhất định, đôi khi phải biết API.
- Thư viện mã nguồn mở (Scrapy, Puppeteer, Selenium):
- Ưu điểm: Không giới hạn, tùy biến cao, rất hợp cho developer.
- Nhược điểm: Cần code, không phù hợp với người dùng doanh nghiệp không kỹ thuật.
Xu Hướng Web Scraping 2026: Điều Gì Khiến Công Cụ Hiện Đại Khác Biệt?
Web scraping năm 2026 xoay quanh AI, tự động hóa và tích hợp. Đây là những điểm mới nổi bật:
- Nhận diện cấu trúc bằng AI: Các công cụ như Thunderbit dùng AI để tự động phát hiện trường dữ liệu, giúp người không biết code thiết lập cực nhanh.
- Trích xuất đa ngôn ngữ: Thunderbit và một số công cụ khác hỗ trợ scrape và xử lý dữ liệu bằng hàng chục ngôn ngữ.
- Tích hợp trực tiếp: Xuất dữ liệu scrape thẳng sang Google Sheets, Notion hoặc Airtable — không cần phải loay hoay với CSV nữa.
- Scrape PDF/hình ảnh: Thunderbit dẫn đầu ở mảng này, cho phép trích xuất bảng từ PDF và hình ảnh bằng AI.
- Lập lịch & tự động hóa: Công cụ cloud (Apify, Browse AI) cho phép bạn cài một lần rồi để đó, tự động chạy định kỳ.
- Hậu xử lý: Tóm tắt, dịch, phân loại và làm sạch dữ liệu ngay trong quá trình scrape — không còn bảng tính lộn xộn.
Thunderbit, Apify và SerpAPI đang ở tuyến đầu của các xu hướng này, nhưng Thunderbit nổi bật ở chỗ làm cho web scraping dùng AI trở nên dễ tiếp cận với tất cả mọi người, không chỉ developer.
Không Chỉ Là Scraping: Tính Năng Xử Lý Dữ Liệu & Tăng Giá Trị
Không chỉ là lấy dữ liệu — mà còn phải biến nó thành thứ hữu ích. Dưới đây là mức độ hỗ trợ hậu xử lý của các công cụ hàng đầu:
| Công cụ | Làm sạch | Dịch | Phân loại | Tóm tắt | Ghi chú |
|---|---|---|---|---|---|
| Thunderbit | Có | Có | Có | Có | AI hậu xử lý tích hợp sẵn |
| Apify | Một phần | Một phần | Một phần | Một phần | Phụ thuộc Actor được dùng |
| Browse AI | Không | Không | Không | Không | Chỉ dữ liệu thô |
| Octoparse | Một phần | Không | Một phần | Không | Có xử lý trường dữ liệu ở mức nào đó |
| ParseHub | Một phần | Không | Một phần | Không | Có xử lý trường dữ liệu ở mức nào đó |
| Webscraper.io | Không | Không | Không | Không | Chỉ dữ liệu thô |
| Scrapy | Có* | Có* | Có* | Có* | Nếu developer viết code xử lý |
| Puppeteer | Có* | Có* | Có* | Có* | Nếu developer viết code xử lý |
| Selenium | Có* | Có* | Có* | Có* | Nếu developer viết code xử lý |
| Zyte | Một phần | Không | Một phần | Không | Có một số tính năng tự động trích xuất |
| SerpAPI | Không | Không | Không | Không | Chỉ dữ liệu tìm kiếm có cấu trúc |
| Diffbot | Có | Có | Có | Có | Dùng AI, nhưng chỉ qua API |
- Developer phải tự triển khai logic xử lý.
Thunderbit là công cụ duy nhất cho phép người dùng không chuyên đi từ dữ liệu web thô đến insight có cấu trúc, có thể hành động — tất cả trong cùng một workflow.
Cộng Đồng, Hỗ Trợ Và Tài Nguyên Học Tập: Bắt Nhịp Nhanh Hay Chậm
Tài liệu và onboarding quan trọng — rất quan trọng. Dưới đây là cách các công cụ so sánh với nhau:
| Công cụ | Tài liệu & hướng dẫn | Cộng đồng | Template | Độ khó học |
|---|---|---|---|---|
| Thunderbit | Xuất sắc | Đang phát triển | Có | Rất thấp |
| Browse AI | Tốt | Tốt | Có | Thấp |
| Octoparse | Xuất sắc | Lớn | Có | Trung bình |
| ParseHub | Xuất sắc | Lớn | Có | Trung bình |
| Webscraper.io | Tốt | Forum | Có | Trung bình |
| Apify | Xuất sắc | Lớn | Có | Trung bình-cao |
| Scrapy | Xuất sắc | Rất lớn | N/A | Cao |
| Puppeteer | Tốt | Lớn | N/A | Cao |
| Selenium | Tốt | Rất lớn | N/A | Cao |
| Zyte | Tốt | Lớn | Có | Trung bình-cao |
| SerpAPI | Tốt | Trung bình | N/A | Cao |
| Diffbot | Tốt | Trung bình | N/A | Cao |
Thunderbit và Browse AI là dễ nhất cho người mới. Octoparse và ParseHub có tài nguyên rất tốt nhưng cần nhiều kiên nhẫn hơn. Apify và các công cụ dành cho developer thì khó hơn nhưng tài liệu khá đầy đủ.
Kết Luận: Chọn Công Cụ Data Scraper Miễn Phí Nào Cho Năm 2026
See How Thunderbit Stacks Up See how Thunderbit's agentic web scraper stacks up: one click extraction, free extractors, and free exports to Sheets or Excel. Get Started Free
Kết luận ngắn gọn là: không phải công cụ data scraper “miễn phí” nào cũng dùng được như nhau, và lựa chọn của bạn nên phụ thuộc vào vai trò, mức độ thoải mái với công nghệ, và nhu cầu scraping thực tế.
- Nếu bạn là business user hoặc người không biết code nhưng muốn lấy dữ liệu nhanh — đặc biệt từ website khó, PDF hoặc hình ảnh — Thunderbit là nơi tốt nhất để bắt đầu. Cách tiếp cận bằng AI, prompt ngôn ngữ tự nhiên và tính năng hậu xử lý khiến nó gần nhất với một trợ lý dữ liệu AI thực thụ. Hãy thử Thunderbit Chrome Extension miễn phí và xem bạn có thể đi từ “tôi cần dữ liệu này” đến “đây là bảng tính của tôi” nhanh đến mức nào.
- Nếu bạn là developer hoặc cần scraping không giới hạn, tùy biến cao, các công cụ mã nguồn mở như Scrapy, Puppeteer và Selenium là lựa chọn tốt nhất.
- Nếu bạn làm việc theo nhóm hoặc là người dùng bán kỹ thuật, Apify và Zyte cung cấp giải pháp mở rộng tốt, hỗ trợ cộng tác, với gói miễn phí khá hào phóng cho các tác vụ nhỏ.
Dù quy trình làm việc của bạn là gì, hãy bắt đầu bằng công cụ phù hợp với kỹ năng và nhu cầu của mình. Và nhớ rằng: trong năm 2026, bạn không cần phải là coder mới tận dụng được sức mạnh của dữ liệu web — bạn chỉ cần một trợ lý phù hợp (và có lẽ thêm chút hài hước khi robot bắt đầu làm nhanh hơn bạn).
Muốn tìm hiểu sâu hơn? Hãy xem thêm các hướng dẫn và bài so sánh khác trên Thunderbit Blog, bao gồm:
- Data Scraping là gì và cách thực hiện trong năm 2026
- Cách scrape dữ liệu website vào Excel bằng AI
- Những công cụ & phần mềm web scraping tốt nhất năm 2026
Start Scraping with Thunderbit Set Thunderbit to scrape subpages automatically so a single click covers an entire site section. Get Started Free
Try Agentic Web Scraper Get Started Free



