Wikipedia Bilgilerini Infobox, Kaynaklar ve Bölümlerle Çekme Aracı













Wikipedia Makalelerini Araştırma İçin Düzenleyin
Makale bilgilerini, infobox değerlerini, kaynakları ve bölüm bağlamını ayrı alanlarda tutun.
Wikipedia Verilerini Tek Tıkla Çekin
Açtığınız sayfa için sütunları önerir ve yakalamayı tek çalıştırmada tamamlar. İsterseniz alanları doğal dille düzenleyin veya yeniden adlandırın, sonra tekrar çalıştırın.
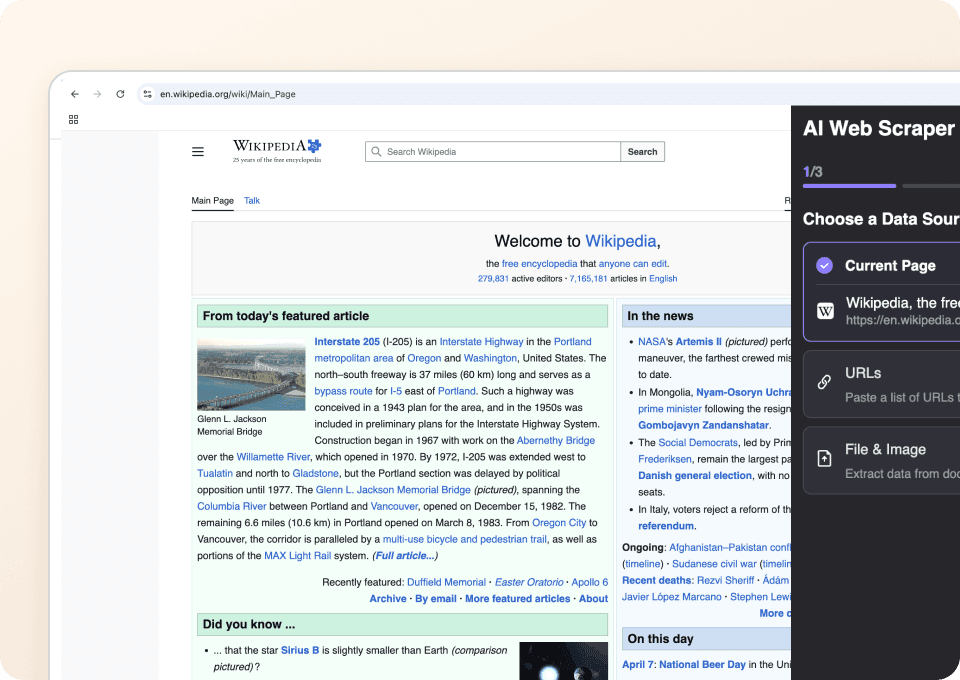
Farklı Wikipedia Sayfa Türlerinde Çalışın
Ajan, erişebildiğiniz sayfadaki değerleri eşlemek için görünen etiketleri, başlıkları ve bölüm isimlerini okur. Bir alan yoksa sütun boş kalır.
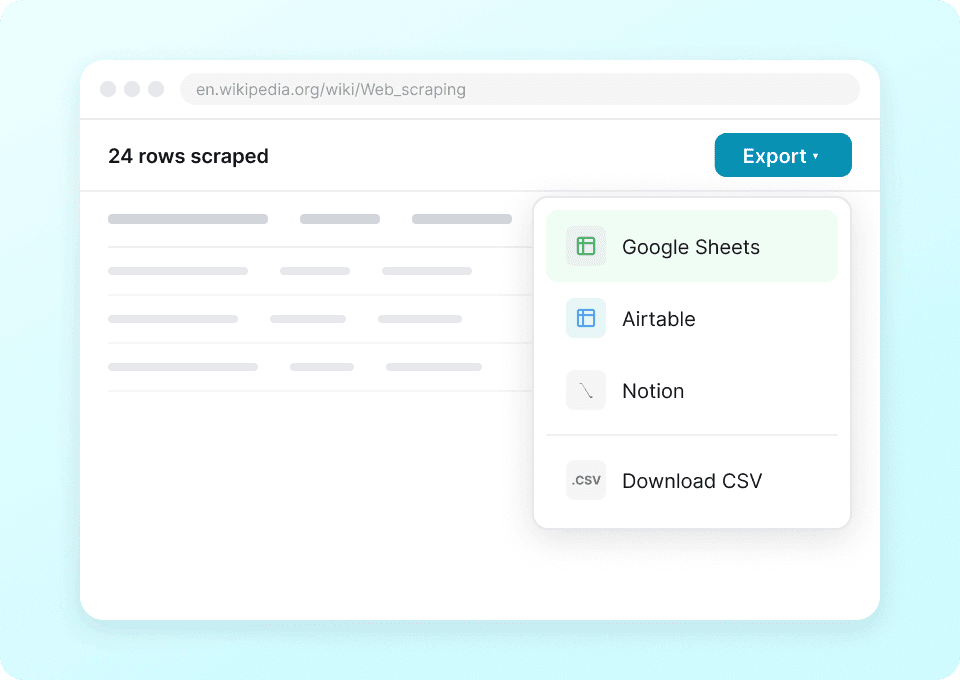
Wikipedia Verilerini Doğrudan Dışa Aktarın
Araştırmanıza Google Sheets, Excel, Airtable, Notion ya da indirilen bir CSV ile devam edin.
Bir Scraper Oluşturmadan Wikipedia Araştırma Verilerini Toplayın
Wikipedia araştırması için seçici bakımını azaltın.
Manuel veya seçici tabanlı kurulum
Kuralları güncel tutmaya harcanan zamanThunderbit AI Agent
Alan önerileri ve tek çalıştırmaMakale bilgileri, infobox, kaynaklar ve bölümler için sütunlar
Sütunlar yalnızca erişebildiğiniz sayfada göründüklerinde çıkar.
- page_title
- page_url
- lead_paragraph
- first_sentence
- infobox_image_url
- infobox_image_caption
- birth_name
- birth_date
- death_date
- birth_place
- death_place
- nationality
- occupation
- years_active
- employer
- alma_mater
- spouse
- children
- website
- notable_works
- latitude
- longitude
- categories
- reference_titles
- reference_links
- external_links
- article_sections
- table_of_contents
- hatnotes
- page_last_edited_date
See researchers capture structured facts from open pages
In user-recorded videos, researchers pick page facts, check the rows, and move the result into their own tools.


Wikipedia araştırma işlemleri hakkında sorular
Wikipedia’daki Agent Mode için kısa yanıtlar.
When your research spans Wikimedia projects
Pair Wikipedia articles with Wikidata items, Commons groups, or media pages.
Framer Scraper
Thunderbit’in Framer Scraper aracı, Framer’daki şablon listelemelerini ve Showcase örneklerini yapay zekâ ile çıkarmanıza yardımcı olur. Portföy şablonları gibi kategorileri çekebilir, ardından her bir şablonun veya Showcase alt sayfasının içine girerek başlık, etiketler, önizleme bağlantıları ve meta veriler gibi ayrıntıları toplayabilirsiniz. Sonuçları yalnızca birkaç tıklamayla Excel, Google Sheets, Airtable veya Notion’a aktarın.
Daha fazla bilgi ->
WordPress.org Scraper
Thunderbit’in WordPress.org Scraper aracı, yapay zekâ ile WordPress eklenti dizini ve blok desen (block pattern) kütüphanesinden yapılandırılmış verileri çıkarmanıza yardımcı olur. Liste sayfalarını kazıyabilir, eklenti istatistikleri, sürümler, puanlar ve desen metaverileri gibi alt sayfa ayrıntılarıyla sonuçları zenginleştirebilir; ardından verileri Excel, Google Sheets, Airtable veya Notion’a aktarabilirsiniz.
Daha fazla bilgi ->
CoinMarketCap veri çekici
CoinMarketCap’ten kripto verilerini — fiyat, piyasa değeri ve 24 saatlik hacim — sadece 2 tıklamayla alın. Herhangi bir sayfayı açın, AI alanları otomatik olarak tanısın ve verileri doğrudan Excel, Google Sheets veya Notion’a aktarın.
Daha fazla bilgi ->
GoDaddy Scraper
Herhangi bir GoDaddy alan adı, uygunluk durumu veya fiyatın üzerine gelin — Thunderbit’in yapay zekâsı verileri 2 tıklamada çıkarır ve anında Excel, Google Sheets veya Notion’a aktarır.
Daha fazla bilgi ->
Pixiv Scraper
Pixiv’deki eser başlıklarını, sanatçı adlarını, etiketleri ve görüntülenme sayılarını 2 tıklamayla çekin — kod yazmadan, kurulum gerektirmeden Excel, Google Sheets veya Notion’a aktarın.
Daha fazla bilgi ->
Happymh.com Scraper
The Thunderbit Happymh.com Scraper lets you extract comics and comments data from Happymh.com in just two clicks. Use AI-powered field suggestions to gather comic titles, ranks, authors, and reader feedback for analysis or research. Ideal for marketers, researchers, and content creators seeking structured data from Happymh.com.
Daha fazla bilgi ->Veri çıkarma sürecini hızlandırmaya hazır mısın?
Web scraping iş akışlarını otomatikleştirmek için Thunderbit kullanan 200.000+ profesyonele katıl.
Ücretsiz deneme, 8 web sayfası için sınırsız kredi sunar.


