Baidu Arama Sonuçları ve Makaleler İçin Scraper













Baidu sonuçlarını temiz ve kullanışlı verilere dönüştürün
Arama sonuçlarını ve mevcut makale ayrıntılarını tek bir net tabloda tutun.
Toplarken Baidu verilerini düzenleyin
Thunderbit; görünen başlıkları, URL’leri, özetleri, tarihleri ve kaynakları net sütunlara yerleştirir. Bir sonuç herhangi bir alan göstermiyorsa, hücre boş kalır.

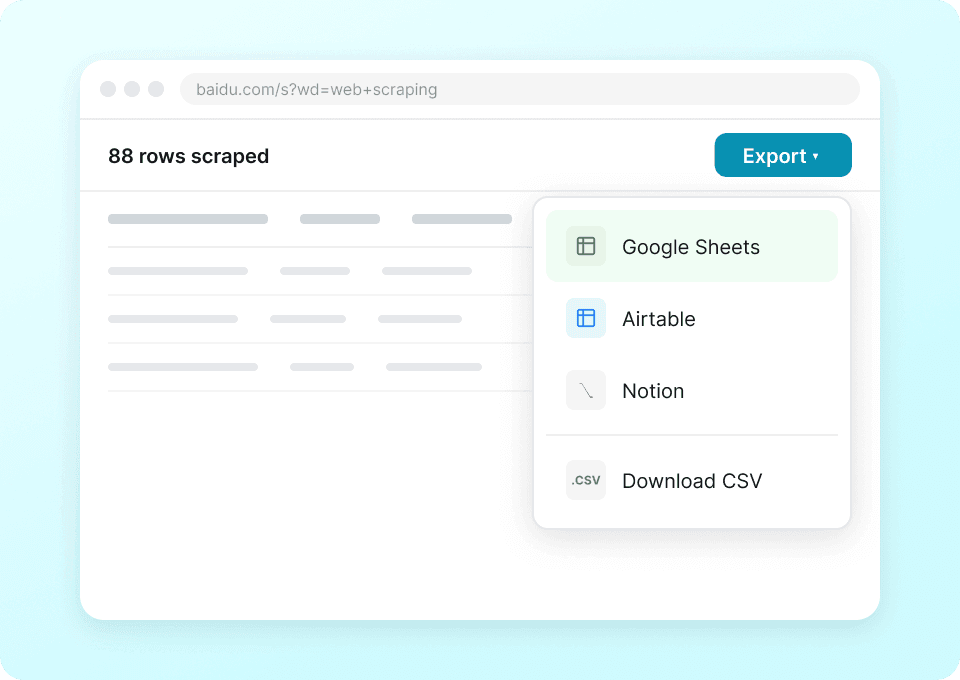
Baidu araştırmasını tek tıkla dışa aktarın
Her çalıştırmayı bir arama sonuçları inceleme sayfasına gönderin. Sıralamalar, kaynaklar, tarihler ve bağlı sayfa ayrıntıları ilgili Baidu sonucunun yanında kalır.
Aynı iş akışını her sitede kullanın
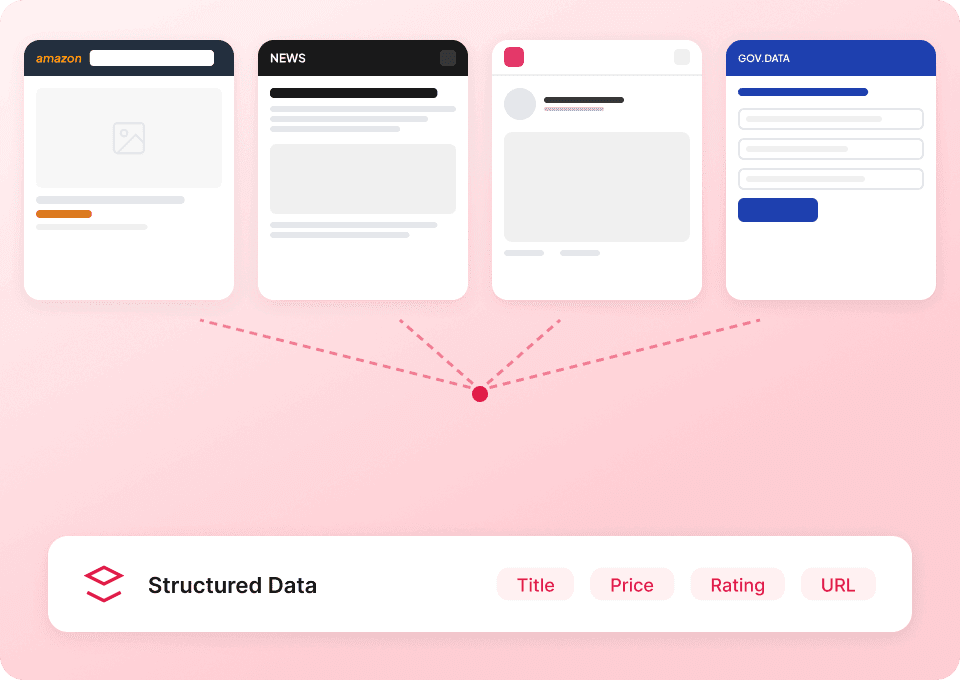
Thunderbit, alanları bir Baidu düzenine göre değil, anlamına göre okur. Araştırmanız yeni bir kaynağa ulaştığında aynı yaklaşımı erişilebilir herkese açık herhangi bir sitede kullanın.
Her Baidu sonucunun bağlamını koruyun
Bağlantı listesi bağlamı kaybeder. Thunderbit, görünür ayrıntıları her sonucun yanında tutar.
Kopyalanmış bağlantılar ve dağınık notlar
Sonuç ayrıntıları birbirinden ayrılırYapılandırılmış Baidu araştırması
Görünen bağlam her sonuçla birlikte kalırBaidu’dan hangi verileri çekebilirsiniz?
Bu herkese açık ve görünür alanlar arasından seçim yapın. Sonuç modülleri ve bağlı sayfalar, her sorgu için tüm alanları göstermeyebilir.
- Arama Sorgusu
- Sonuç Sırası
- Sonuç Başlığı
- Sonuç URL’si
- Görünen URL
- Sonuç Özeti
- Sonuç Tarihi
- Sonuç Site Simgesi
- İlgili Arama İfadesi
- Yazım Önerisi
- Pinyin Önerisi
- Arama Sonucu Sayfa Numarası
- Kaynak Site
- Kaynak Alan Adı
- Makale Yazarı
- Makale Yayın Tarihi
- Makale Özeti
- Belge Adı
- Belge Açıklaması
- Belge Kırıntı Yolu
- Belge Türü
- Belge Dosya Formatı
- Belge Sayfa Sayısı
- Belge Yükleme Zamanı
- Belge URL’si
- Sonuç İçerik Türü
- Görsel Küçük Resmi
- Video Küçük Resmi
- Konum Adresi
- Baidu Özellik Modülü
See how researchers track Chinese search results
These user feedback videos show how people review Chinese search results, track sources, and check linked articles.
Baidu arama verilerini toplama hakkında sorular
Kullanılabilir alanlar; sorguya, sonuç türüne ve bağlı sayfalarda gösterilen bilgilere göre değişir.
Continue from Baidu results to source-page research
Explore article and website scrapers when you need full page text or other details beyond the fields shown in Baidu results.
Framer Scraper
Thunderbit’in Framer Scraper aracı, Framer’daki şablon listelemelerini ve Showcase örneklerini yapay zekâ ile çıkarmanıza yardımcı olur. Portföy şablonları gibi kategorileri çekebilir, ardından her bir şablonun veya Showcase alt sayfasının içine girerek başlık, etiketler, önizleme bağlantıları ve meta veriler gibi ayrıntıları toplayabilirsiniz. Sonuçları yalnızca birkaç tıklamayla Excel, Google Sheets, Airtable veya Notion’a aktarın.
Daha fazla bilgi ->
WordPress.org Scraper
Thunderbit’in WordPress.org Scraper aracı, yapay zekâ ile WordPress eklenti dizini ve blok desen (block pattern) kütüphanesinden yapılandırılmış verileri çıkarmanıza yardımcı olur. Liste sayfalarını kazıyabilir, eklenti istatistikleri, sürümler, puanlar ve desen metaverileri gibi alt sayfa ayrıntılarıyla sonuçları zenginleştirebilir; ardından verileri Excel, Google Sheets, Airtable veya Notion’a aktarabilirsiniz.
Daha fazla bilgi ->
CoinMarketCap veri çekici
CoinMarketCap’ten kripto verilerini — fiyat, piyasa değeri ve 24 saatlik hacim — sadece 2 tıklamayla alın. Herhangi bir sayfayı açın, AI alanları otomatik olarak tanısın ve verileri doğrudan Excel, Google Sheets veya Notion’a aktarın.
Daha fazla bilgi ->
GoDaddy Scraper
Herhangi bir GoDaddy alan adı, uygunluk durumu veya fiyatın üzerine gelin — Thunderbit’in yapay zekâsı verileri 2 tıklamada çıkarır ve anında Excel, Google Sheets veya Notion’a aktarır.
Daha fazla bilgi ->
Pixiv Scraper
Pixiv’deki eser başlıklarını, sanatçı adlarını, etiketleri ve görüntülenme sayılarını 2 tıklamayla çekin — kod yazmadan, kurulum gerektirmeden Excel, Google Sheets veya Notion’a aktarın.
Daha fazla bilgi ->
Happymh.com Scraper
The Thunderbit Happymh.com Scraper lets you extract comics and comments data from Happymh.com in just two clicks. Use AI-powered field suggestions to gather comic titles, ranks, authors, and reader feedback for analysis or research. Ideal for marketers, researchers, and content creators seeking structured data from Happymh.com.
Daha fazla bilgi ->Veri çıkarma sürecini hızlandırmaya hazır mısın?
Web scraping iş akışlarını otomatikleştirmek için Thunderbit kullanan 200.000+ profesyonele katıl.
Ücretsiz deneme, 8 web sayfası için sınırsız kredi sunar.



