
Web, veriyle dolup taşıyor; kabul edelim, binlerce ürün listesini ya da rakip fiyat sayfasını tek tek kopyalayıp yapıştıracak kimsenin vakti yok. Çoğu otomasyon ve geliştirme işimde Linux kullanan biri olarak, bu platformun veri odaklı ekipler için ne kadar güçlü olduğunu zaten biliyorsunuzdur. Hatta Unix ailesi sistemler, işletim sistemi bilinen web sitelerinin %91,9’unu çalıştırıyor; bu alanda en büyük pay da açık ara Linux’a ait. Ama işin zor kısmı şu: İster teknik olmayan bir iş kullanıcısı olun ister tam anlamıyla bir kod bağımlısı, iş akışınıza gerçekten uyan doğru Linux web scraper’ı bulmak samanlıkta iğne aramaya benzeyebiliyor.
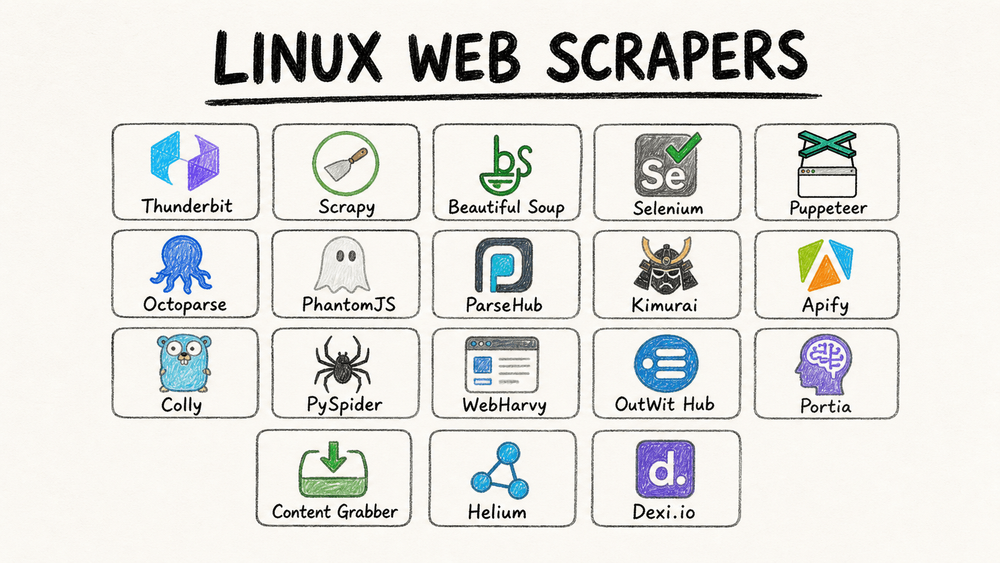
Bu yüzden 2026 için en iyi 18 Linux web scraping aracını detaylı biçimde ele aldığım bu rehberi hazırladım. Thunderbit gibi yapay zekâ destekli, kodsuz çözümlerden (evet, ekip olarak geliştirdiğimiz araç) Scrapy ve Beautiful Soup gibi klasik geliştirici çatılarına kadar bu liste, deneme-yanılma stresine girmeden ihtiyacınıza uygun en iyi Linux web scraper’ı seçmeniz için kısa yol sunuyor.
Linux Web Scraping Araçları İş Kullanıcıları İçin Neden Önemli?
Bir Aracı Seçmeden Önce Kopyala-Yapıştır Döngüsünü Bitirin Thunderbit, Linux masaüstünüzde Chrome içinde çalışır — paket yok, sürücü yok, tek tıkla düzenli bir tablo. Get Started Free
Gelin gerçeği konuşalım: Manuel veri toplama, verimliliğin katilidir. Araştırmalar, kopyala-yapıştır yöntemine bel bağlayan ekiplerin her hafta saatlerce zaman kaybettiğini ve yaklaşık %5 hata oranına ulaştığını gösteriyor; bu da pahalı hatalar ve kaçan fırsatlar için birebir (Thunderbit Blog). Linux ise sağlamlığı, güvenliği ve esnekliği sayesinde 7/24 çalışması gereken scraper’ları çalıştırmak için ideal platformdur — ister masaüstünde, ister sunucuda, ister bulutta olun.
Linux web scraping araçları için yaygın iş kullanım senaryoları:
- Lead üretimi: Satış ekipleri, dizinlerden, sosyal medyadan veya inceleme sitelerinden yeni iletişim bilgileri toplar; manuel uğraşı atlar (Thunderbit Blog).
- Fiyat takibi: E-ticaret ekipleri rakip fiyatlarını ve stok verilerini otomatik çeker; kendi fiyatlarını güncel ve rekabetçi tutar.
- Rakip analizi: Pazarlama ve operasyon ekipleri ürün lansmanlarını, yorumları ve SEO anahtar kelimelerini takip eder — artık körlemesine hareket etmek yok.
- Pazar istihbaratı: Analistler haberleri, forumları ve sosyal verileri birleştirerek trendleri gerçek zamanlı yakalar.
- İş akışı otomasyonu: Bazı araçlar, özellikle yapay zekâ destekli olanlar, Linux makineniz üzerinden form doldurma veya panel içinde gezinme gibi web iş akışlarını bile otomatikleştirebilir.
En güzel tarafı ne? Doğru Linux web scraping aracı, yalnızca kod yazanları değil, teknik olmayan kullanıcıları da web verisine erişip bunu daha akıllı ve daha hızlı iş kararlarına dönüştürme konusunda güçlendirir.
Linux İçin En İyi Web Scraper’ı Nasıl Seçtik?
Özellikle Linux tarafında her scraper aynı değildir. Ben şu kriterlere baktım:
- Linux uyumluluğu: Buradaki her araç Linux üzerinde yerel çalışıyor, tarayıcı üzerinden erişiliyor ya da basit bir geçici çözümle kullanılabiliyor (Wine veya bulut erişimi gibi).
- Kullanım kolaylığı: Doğal dilde AI komutlarından görsel tıkla-seç arayüzlerine kadar, kod bilmeyenlerin hızlı sonuç almasını sağlayan araçları öne çıkardım; ama tam kontrol isteyen ileri kullanıcıları da unutmadım.
- Veri çıkarma gücü: Dinamik içerik, sayfalama, alt sayfalar ve farklı veri türleriyle başa çıkabiliyor mu? Anti-scraping önlemlerini aşabiliyor mu?
- Ölçeklenebilirlik ve otomasyon: Zamanlama, bulutta scraping, dağıtık tarama — ciddi veri projeleri için bunlar olmazsa olmazdır.
- Entegrasyon ve dışa aktarma: CSV, Excel, Google Sheets, API’ler — veriyi dışarı çıkaramıyorsanız bunun ne anlamı var?
- Fiyat ve lisanslama: Ücretsiz, açık kaynak ya da ücretli — tek başına çalışan kuruculardan kurumsal ekiplere kadar her bütçeye uygun seçenek var.
- Topluluk ve destek: Aktif kullanıcı topluluğu, iyi dokümantasyon ve hızlı destek, takıldığınızda büyük fark yaratır.
Bu araçları seçerken gerçek kullanıcı geri bildirimlerini, sektör incelemelerini ve kendi uygulamalı deneyimimi de harmanladım. Hadi listeye geçelim.
1. Thunderbit
 Thunderbit, iş kullanıcıları için gerçekten kullanımı kolay bir Linux web scraper arayanlar adına benim ilk tercihim. Bir yapay zekâ destekli Chrome uzantısı olarak Linux üzerinde kusursuz çalışır (Chrome veya Chromium açmanız yeterli) ve herhangi bir web sitesinden tek tıkla veri çekmenizi sağlar.
Thunderbit’i öne çıkaran özellikler:
- Doğal dil komutları: Sadece ne istediğinizi yazın (“Bu sayfadaki tüm ürün adlarını ve fiyatlarını çıkar”) Thunderbit’in AI’ı gerisini halleder.
- AI alan önerisi: Tek tıklamayla sayfayı tarar, sütun ve veri türü önerir — alanları tek tek seçmenize gerek yok.
- Alt sayfa ve sayfalama desteği: Daha fazla ayrıntıya mı ihtiyacınız var? Thunderbit her alt sayfayı (ör. ürün detay sayfaları) ziyaret edip tablonuzu otomatik zenginleştirebilir.
- Bulut veya yerel scraping: Bulutta aynı anda 50 sayfaya kadar çekim yapabilir veya giriş gerektiren siteler için tarayıcı modunu kullanabilirsiniz.
- Anında dışa aktarma: Excel, Google Sheets, Airtable, Notion, CSV veya JSON’a tek tıkla aktarım — her zaman ücretsiz.
- Ek araçlar: E-posta, telefon numarası ve görsel çıkarma tek tıkla yapılabilir. AI autofill ile form doldurma da otomatikleşir.
Fiyatlandırma: Ücretsiz plan (ayda 6 sayfa), ücretli planlar 500 satır için aylık 15$’dan başlar (Thunderbit Pricing). Kullanıcılar “öğrenme eğrisi olmamasını” ve “saatler süren işi dakikalara indirmesini” seviyor (Product Hunt Reviews). Büyük işler için görevleri bölmeniz gerekebilir, ancak çoğu iş senaryosu için ciddi zaman kazandırır.
Linux uyumluluğu: %100. Linux masaüstünüzde ya da sunucunuzda Chrome/Chromium yeterli.
Kimler için uygun: En hızlı ve en kolay kurulumu isteyen teknik olmayan iş kullanıcıları (satış, pazarlama, operasyon).
Thunderbit’i Linux’ta Ücretsiz Deneyin Her Linux masaüstünde Chrome içinde çalışır — derlenecek paket yok, kurulacak sürücü yok, tek tıkla veri çıkarma. Get Started Free
2. Scrapy
 Scrapy, esnek ve ölçeklenebilir bir Linux web scraper isteyen Python geliştiricileri için altın standarttır. Açık kaynaklıdır, çok hızlıdır (asenkron tarama) ve basit scraping işlerinden devasa, dağıtık taramalara kadar her şeyi kaldırabilir.
Temel özellikler:
- Asenkron, yüksek hızlı tarama — binlerce sayfayı çekmek için idealdir.
- Yüksek düzeyde genişletilebilir: Proxy, CAPTCHA ve daha fazlası için eklentiler.
- Python veri ekosistemiyle entegre olur: JSON, CSV, veritabanı veya pandas’a çıktı verebilir.
- Çerez, oturum ve otomatik hız kontrolünü destekler.
Fiyatlandırma: %100 ücretsiz ve açık kaynak.
Linux uyumluluğu: Yerel destek (pip ile kurulur). Sunucularda ve container’larda çok iyi çalışır.
Kimler için uygun: Büyük ölçekli özel scraper geliştiren yazılımcılar.
Not: Kod bilmeyenler için öğrenme eğrisi vardır; ama Python biliyorsanız Scrapy’yi geçmek zor.
3. Beautiful Soup
 Beautiful Soup, HTML ve XML ayrıştırma için hafif bir Python kütüphanesidir. Hızlı ve pratik scraping işleri ya da dağınık web sayfalarını temizlemek için en çok başvurulan araçtır.
Temel özellikler:
- Basit ve anlaşılır API — yeni başlayanlar için harika.
- Sayfa çekmek için requests ile çok iyi çalışır.
- Bozuk HTML’yi sorunsuz işler.
Fiyatlandırma: Ücretsiz ve açık kaynak.
Linux uyumluluğu: %100 (saf Python).
Kimler için uygun: Küçük ve orta ölçekli scraping veya parse işleri yapan geliştiriciler ve veri bilimcileri.
Sınırlama: JavaScript veya dinamik içerik işlemez — buna ihtiyacınız varsa Selenium veya Puppeteer ile birlikte kullanın.
4. Selenium
 Selenium, klasik tarayıcı otomasyon çerçevesidir. Dinamik, JavaScript ağırlıklı siteleri scrape etmek için Chrome, Firefox veya diğer tarayıcıları kontrol etmenizi sağlar.
Temel özellikler:
- Gerçek tarayıcıları otomatikleştirir — giriş yapabilir, tıklayabilir, kaydırabilir ve insan gibi etkileşime girebilir.
- Python, Java, C# ve daha fazlasını destekler.
- Linux sunucularda çalışmak için headless modu vardır.
Fiyatlandırma: Ücretsiz ve açık kaynak.
Linux uyumluluğu: Tam destek (yalnızca uygun tarayıcı sürücüsünü kurmanız gerekir).
Kimler için uygun: QA mühendisleri, scraping geliştiricileri ve kullanıcı davranışını simüle etmesi gereken herkes.
Not: Kaynak tüketimi yüksektir ve saf HTTP scraper’lara göre yavaştır; ama bazen ihtiyacınız olan veriye ulaşmanın tek yolu budur.
5. Puppeteer
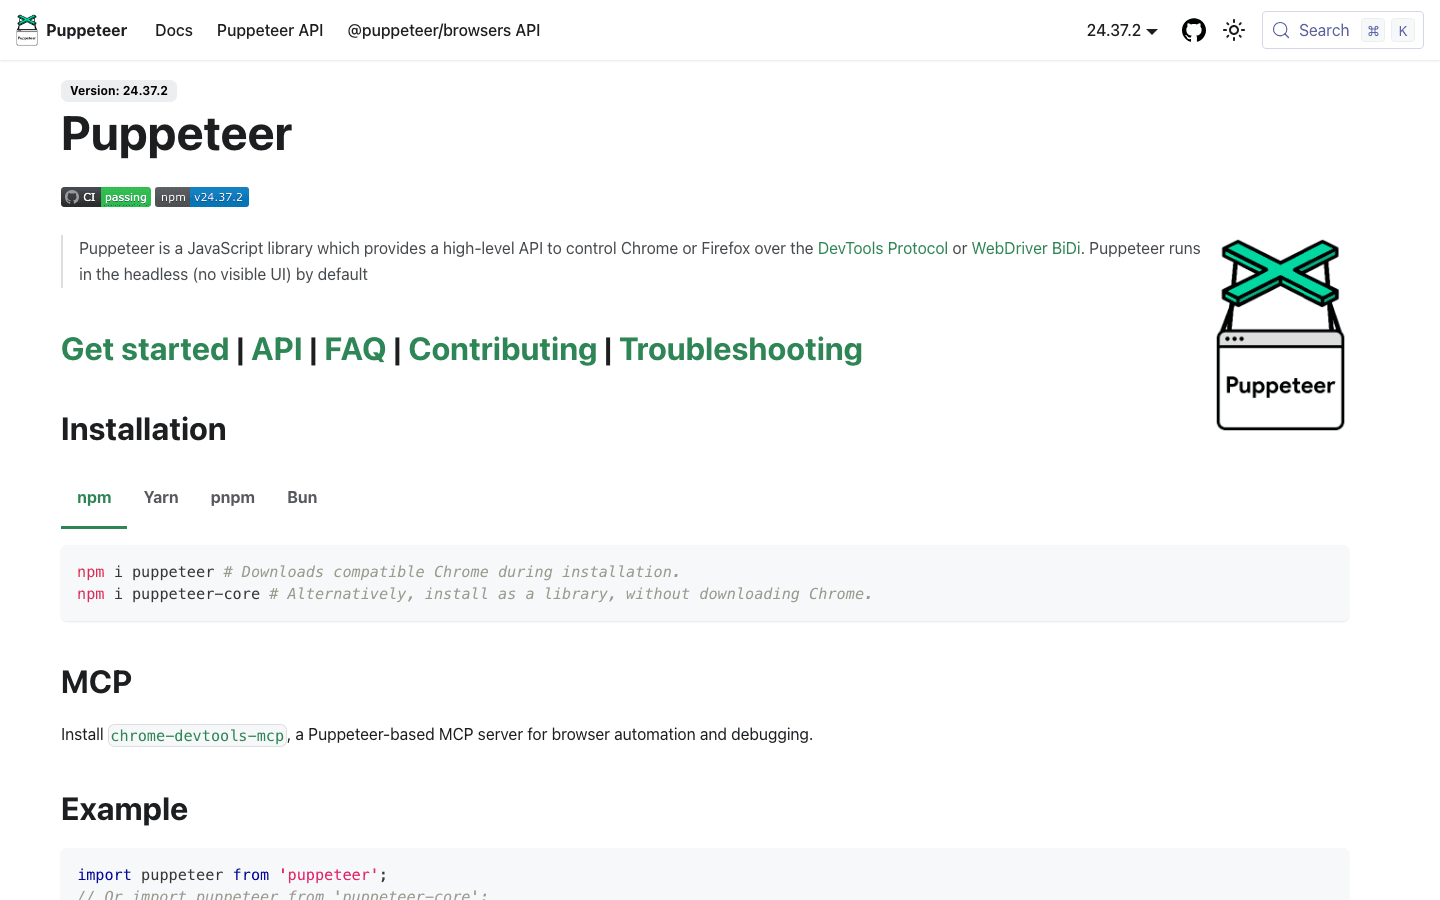 Puppeteer, Google’ın headless Chrome/Chromium kontrolü için sunduğu bir Node.js kütüphanesidir. Selenium’a benzer, ancak modern bir JavaScript API’si ve Chrome özellikleriyle sıkı entegrasyon sağlar.
Temel özellikler:
- JavaScript çalıştırır, dinamik içeriği işler ve ekran görüntüsü alır.
- Hızlı, kararlı ve Node.js geliştiricileri için kullanımı kolaydır.
- Ağ isteklerini yakalayabilir ve istenmeyen kaynakları engelleyebilir.
Fiyatlandırma: Ücretsiz ve açık kaynak.
Linux uyumluluğu: Chromium’u otomatik kurar; varsayılan olarak headless çalışır.
Kimler için uygun: Modern web uygulamalarını veya tek sayfalı siteleri scrape eden geliştiriciler.
6. Octoparse
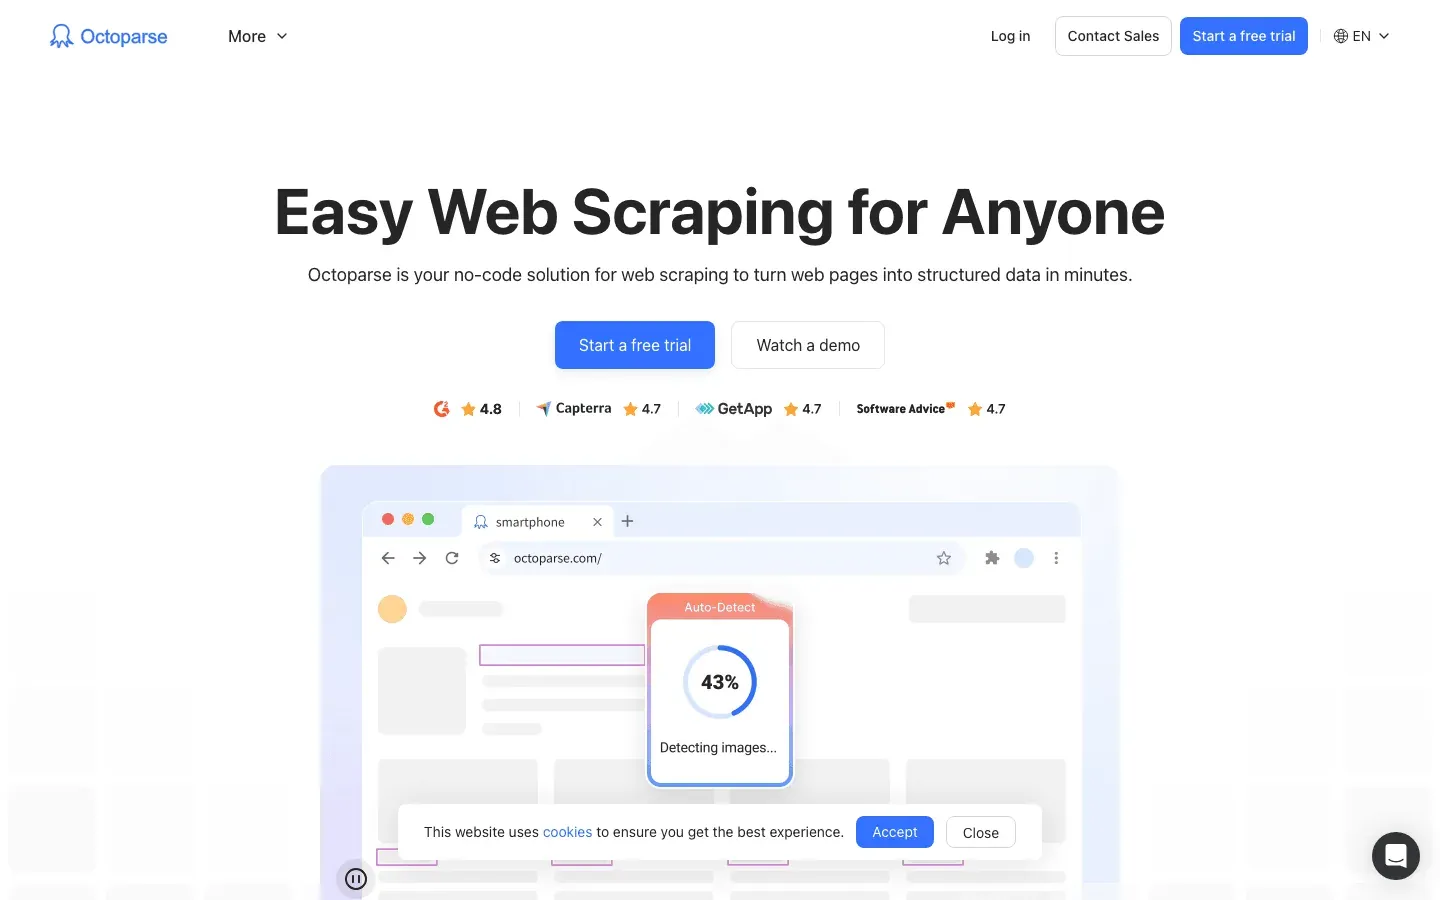 Octoparse, sürükle-bırak arayüzü ve çok sayıda hazır şablon sunan kodsuz bir web scraper’dır. Masaüstü uygulaması yalnızca Windows/Mac için olsa da, Linux kullanıcıları Octoparse’un bulut platformuna tarayıcı üzerinden erişebilir veya Windows uygulamasını Wine ile çalıştırabilir.
Temel özellikler:
- Amazon, eBay, Zillow vb. için 100’den fazla hazır scraping şablonu
- Görsel iş akışı tasarlayıcı — scraper’ınızı tıklayarak oluşturun.
- Bulut scraping ve zamanlama — ağır işi Octoparse sunucuları üstlenir.
- Excel, CSV, JSON ve veritabanlarına dışa aktarma.
Fiyatlandırma: Ücretsiz plan (10 görev, ayda yaklaşık 50K satır). Ücretli planlar, yıllık faturalandırmada Aylık 69$’dan başlar; Professional planı 249$/aydır. (Octoparse Pricing)
Linux uyumluluğu: Bulut/web erişimi; masaüstü uygulaması Wine üzerinden.
Kimler için uygun: E-ticaret veya pazar yeri verisini hızlıca almak isteyen kod bilmeyenler.
7. PhantomJS
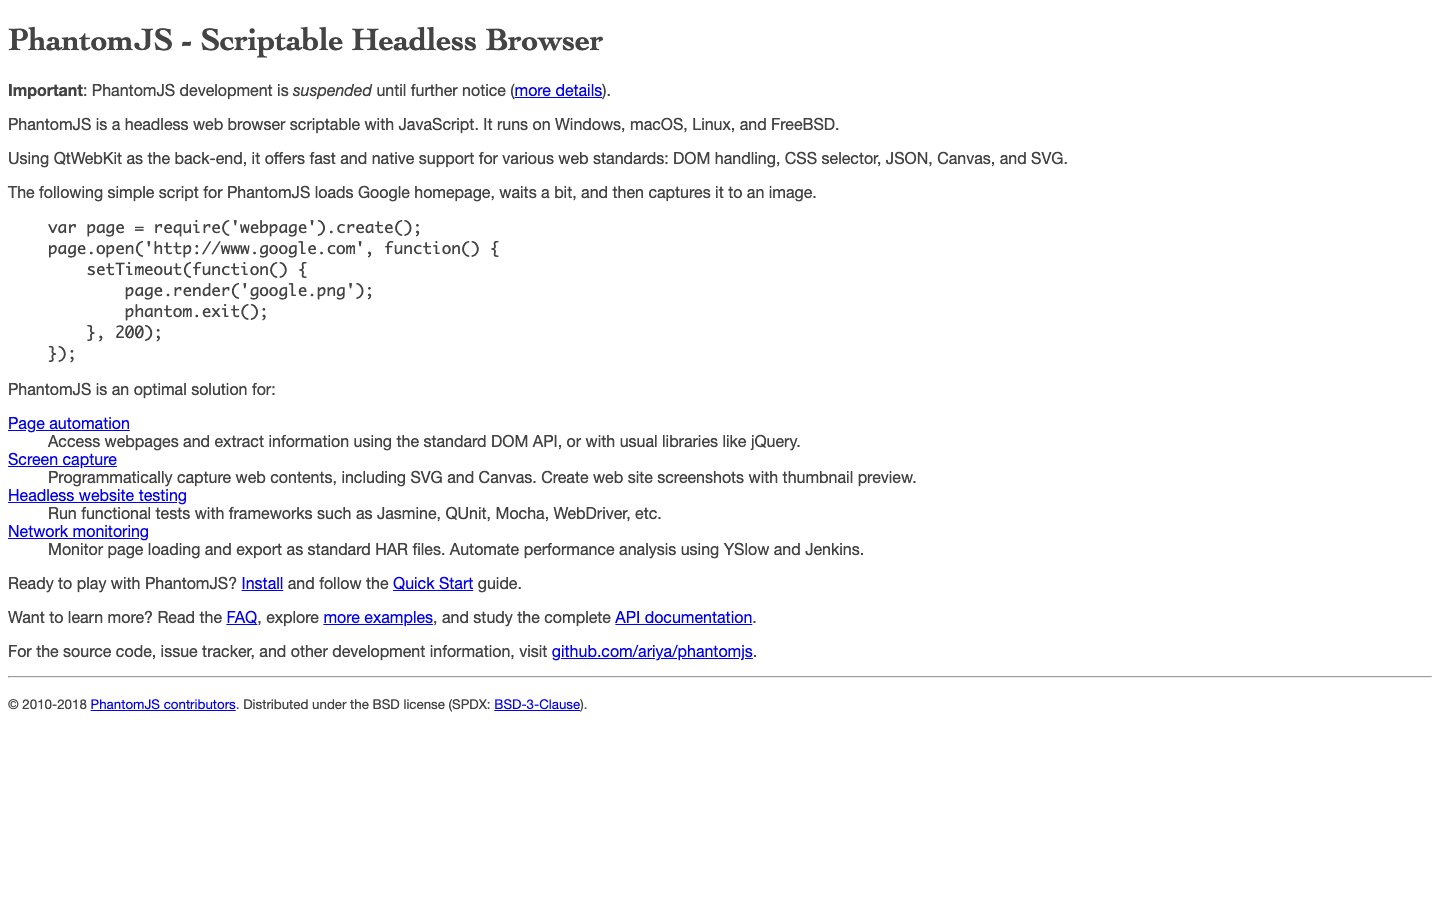 PhantomJS, bir zamanlar hafif tarayıcı otomasyonu için tercih edilen headless WebKit tarayıcısıydı. Artık geliştirilmediği halde, eski sistemlerde veya basit görevlerde Linux üzerinde hâlâ çalışır.
Temel özellikler:
- JavaScript ile betiklenebilir.
- Orta düzey JavaScript’i işler ve ekran görüntüsü/PDF alır.
- GUI gerektirmez.
Fiyatlandırma: Ücretsiz ve açık kaynak.
Linux uyumluluğu: Yerel binary.
Kimler için uygun: Eski projeler veya Chrome kurmanın mümkün olmadığı ortamlar.
Uyarı: 2017’de resmen kullanımdan kaldırıldı, geliştirme Mart 2018’de durdu; son sürüm v2.1.1. Güvenlik yaması yok, modern JS motoru yok, güncel sitelerin çoğunda çalışmaz. Yeni bir proje için Puppeteer veya Playwright kullanın. Burada yer almasının sebebi, devralacağınız eski Linux scraping yığınlarında hâlâ karşınıza çıkabilmesidir.
8. ParseHub
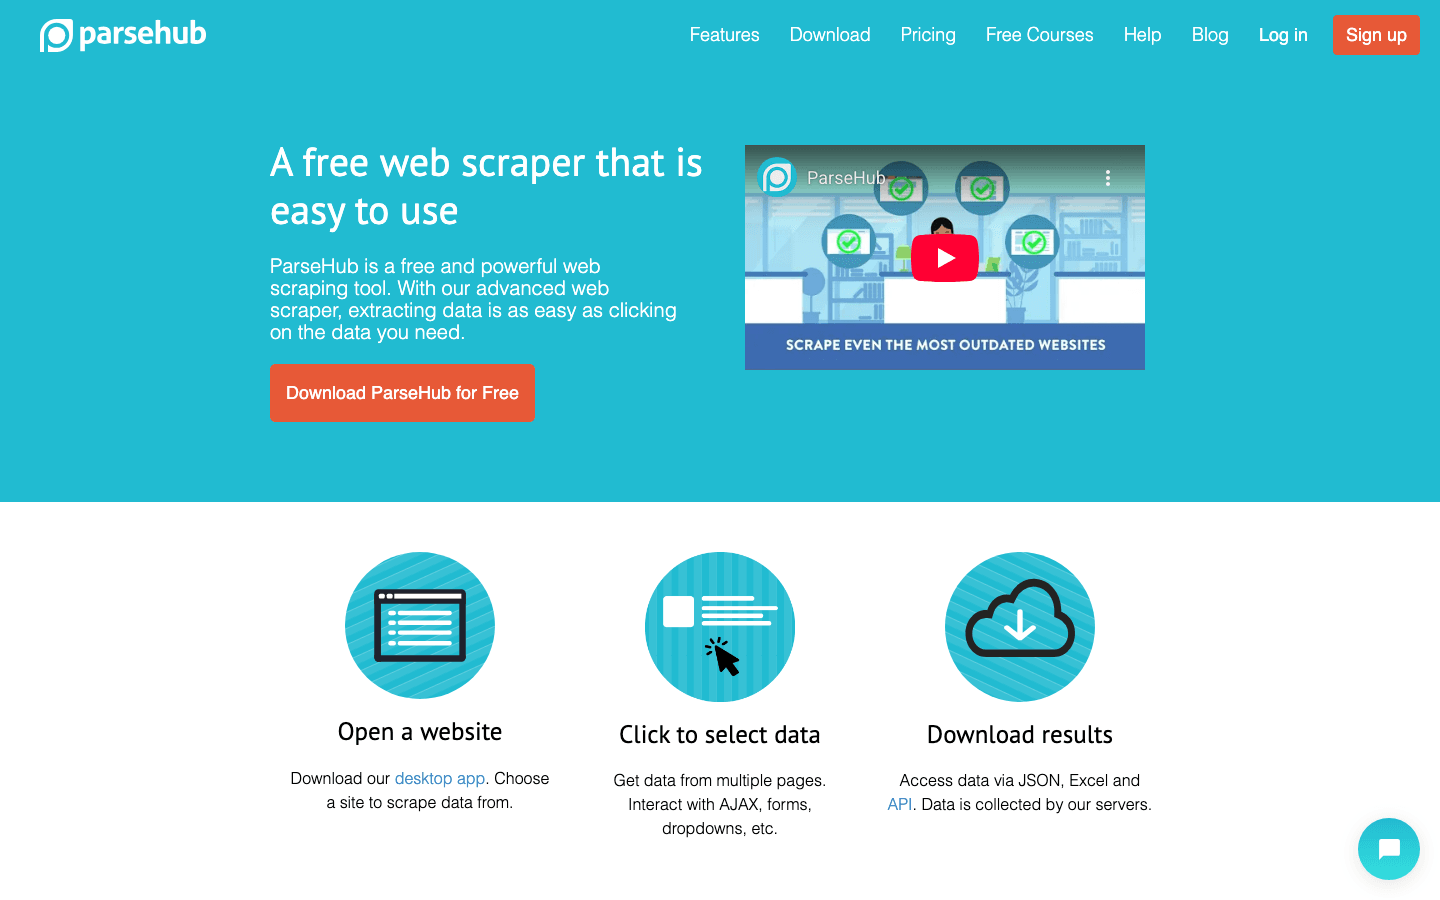 ParseHub, yerel Linux uygulaması olan görsel ve platformlar arası bir web scraper’dır. Karmaşık ve dinamik siteleri scrape etmek isteyen kod bilmeyenler için çok uygundur.
Temel özellikler:
- Tıkla-seç arayüzü — öğeleri seçin, iş akışlarını görsel olarak kurun.
- Dinamik içerik, haritalar, sonsuz kaydırma ve daha fazlasını işler.
- Bulut çalıştırma ve zamanlama.
- CSV, JSON veya API üzerinden dışa aktarma.
Fiyatlandırma: Ücretsiz plan (5 proje), ücretli planlar aylık 189$’dan başlar.
Linux uyumluluğu: Linux, Windows ve Mac için yerel uygulama.
Kimler için uygun: Kod yazmadan kontrol isteyen analistler ve yarı teknik kullanıcılar.
9. Kimurai
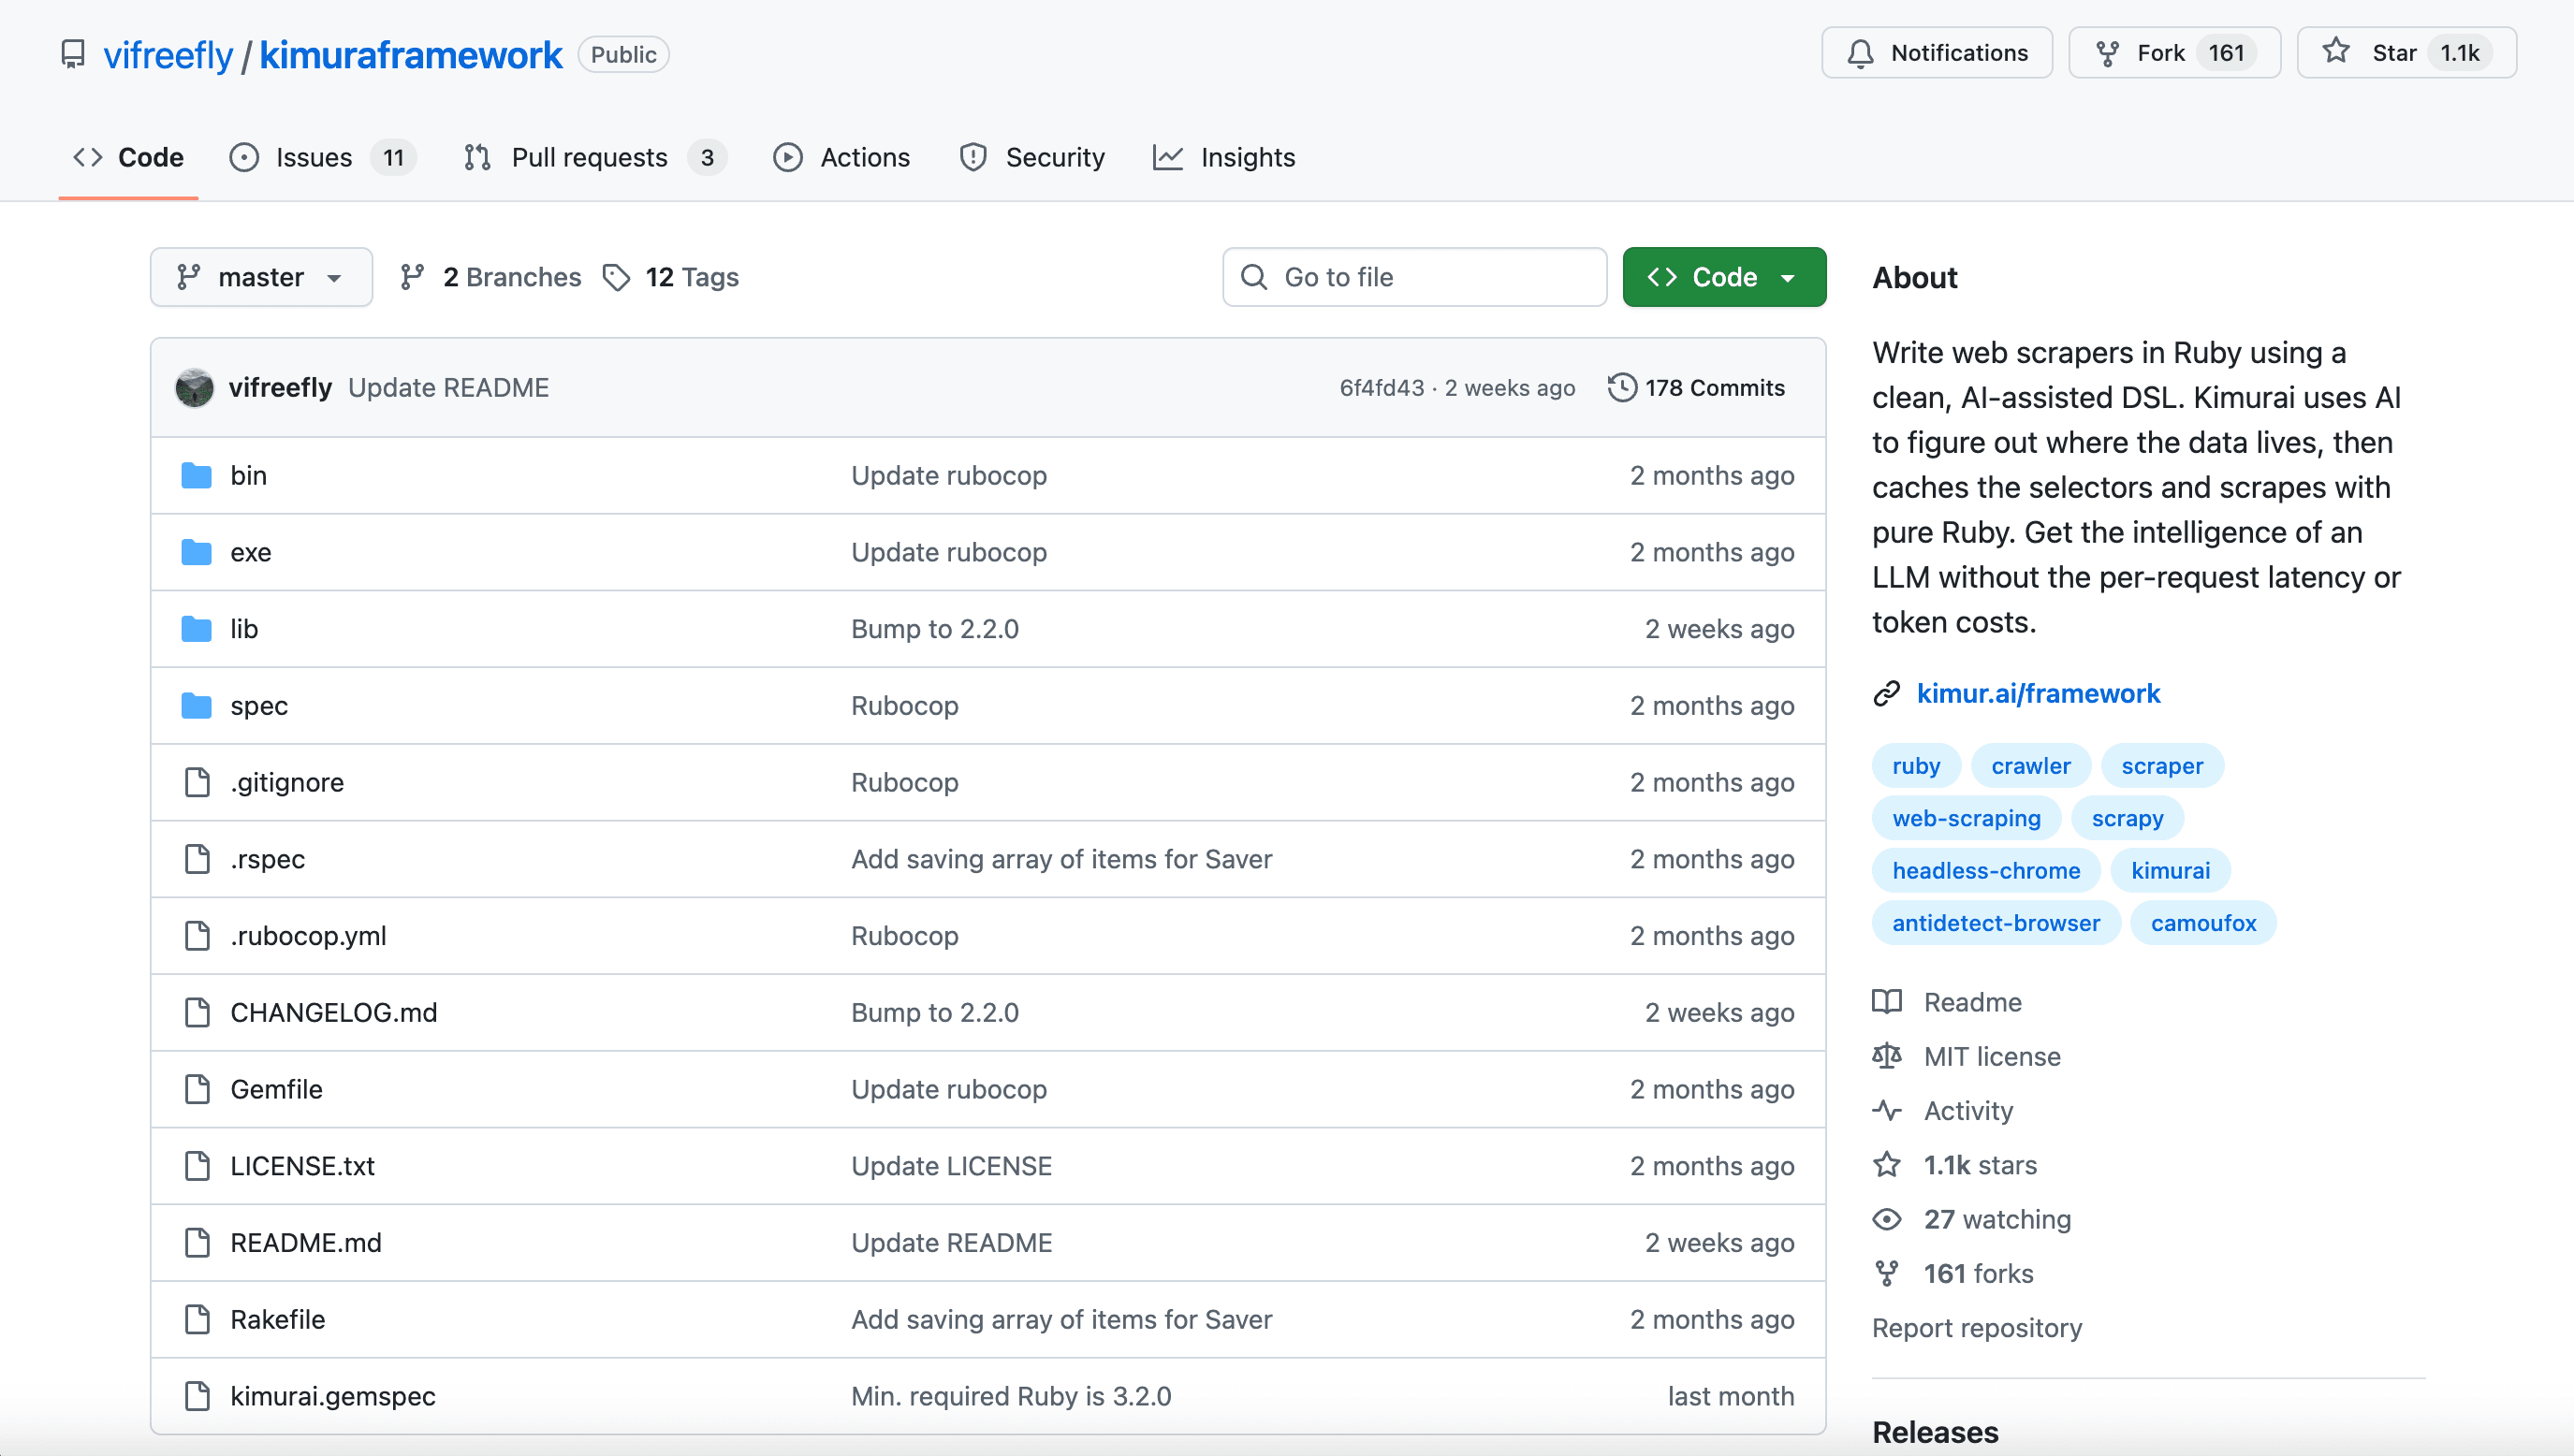 Kimurai, Linux’u yerel olarak destekleyen bir Ruby web scraping çerçevesidir. Ruby geliştiricileri için Scrapy’ye benzer.
Temel özellikler:
- Çoklu tarayıcı desteği: Headless Chrome, Firefox, PhantomJS veya düz HTTP.
- Yüksek eşzamanlılık için asenkron işleme.
- Spider yazımı için temiz Ruby DSL.
Fiyatlandırma: Ücretsiz ve açık kaynak.
Linux uyumluluğu: %100 (Ruby).
Kimler için uygun: Özel ve yüksek eşzamanlılıklı scraping ihtiyacı olan Ruby geliştiricileri veya Rails ekipleri.
10. Apify
 Apify, açık kaynak SDK’ları ve hazır “actor” pazaryeri olan bulut tabanlı bir web scraping platformudur. Scraper’ları Linux makinenizde ya da bulutta çalıştırabilirsiniz.
Temel özellikler:
- Node.js, Python ve daha fazlası için SDK’lar.
- Hazır scraper pazaryeri.
- Bulutta çalıştırma, zamanlama ve API entegrasyonu.
Fiyatlandırma: Ücretsiz plan, bulut kullanımı için kullandıkça öde.
Linux uyumluluğu: CLI/SDK Linux’ta çalışır; bulut platformuna tarayıcıdan erişilir.
Kimler için uygun: Özel kodlama ile hazır bulut altyapısını birlikte isteyen geliştiriciler.
11. Colly
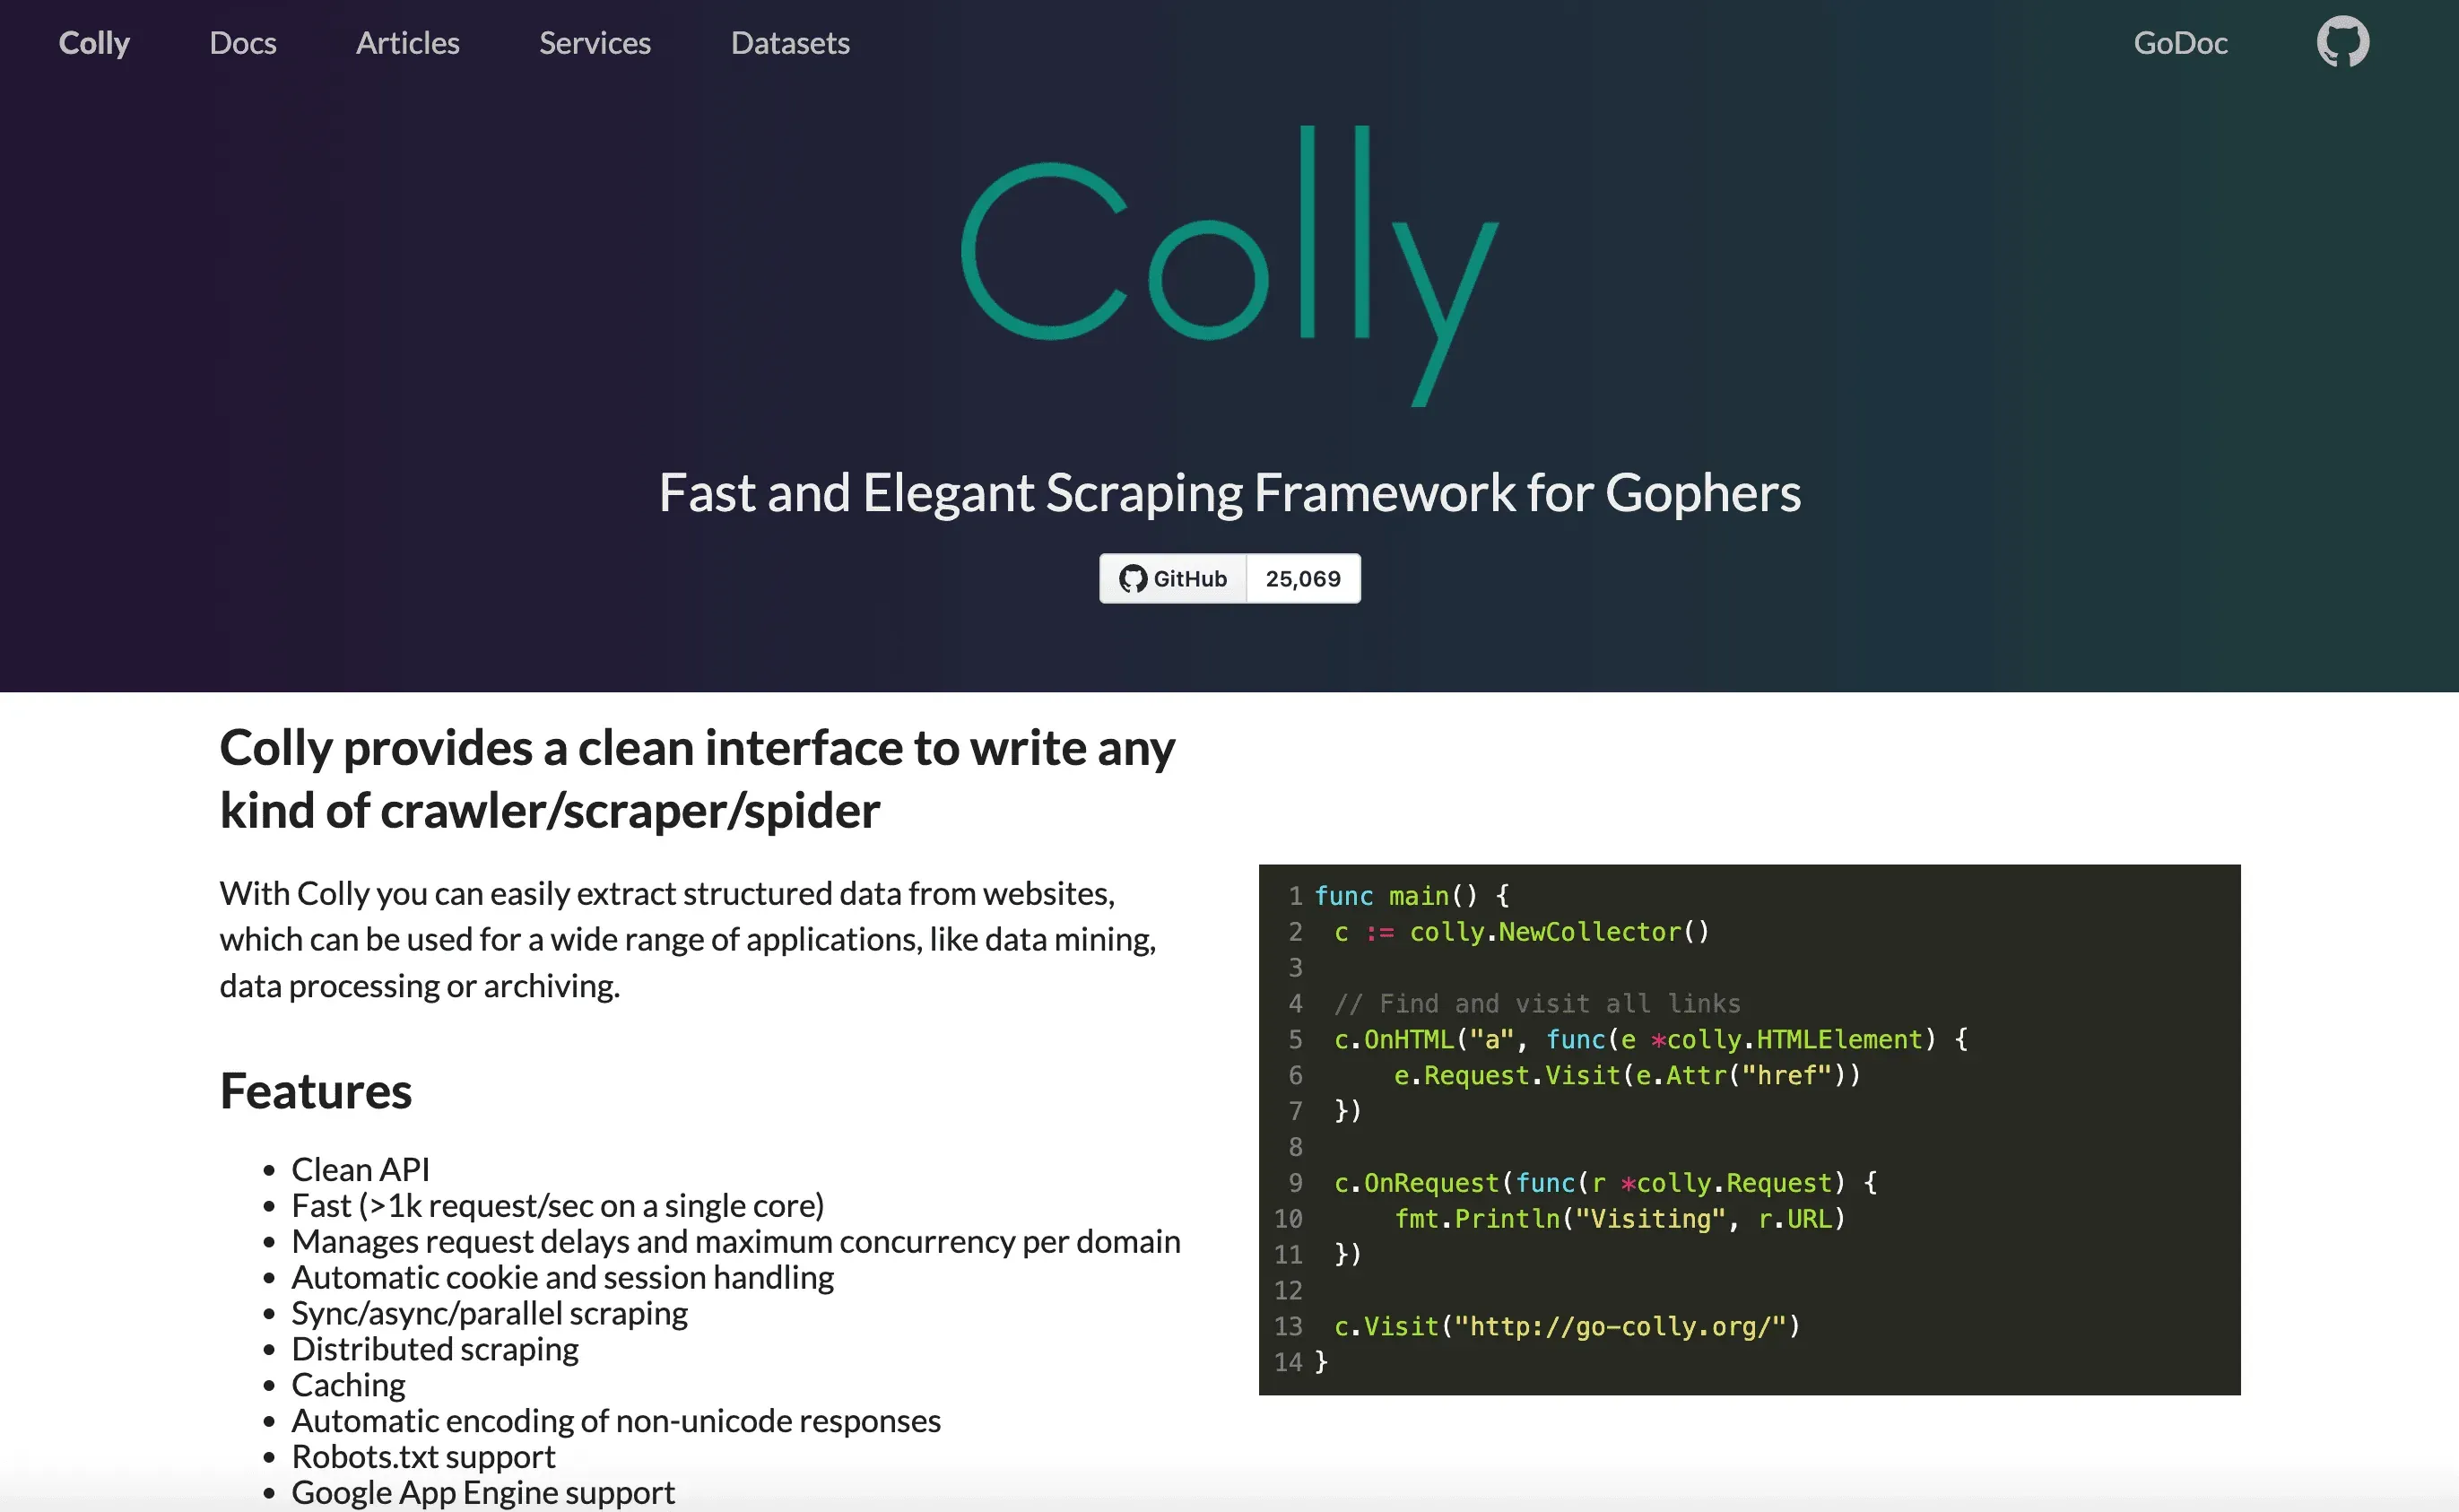 Colly, hız ve verimlilik için geliştirilmiş Go tabanlı bir web scraping çerçevesidir. Go geliştiricisiyseniz tam size göredir.
Temel özellikler:
- Çok hızlı, eşzamanlı scraping — tek çekirdekte saniyede 1.000’den fazla istek.
- Nazik tarama (robots.txt’ye saygı), oturum/çerez yönetimi.
- Düşük bellek kullanımı.
Fiyatlandırma: Ücretsiz ve açık kaynak.
Linux uyumluluğu: Yerel Go binary’leri.
Kimler için uygun: Yüksek performanslı scraping’e ihtiyaç duyan Go geliştiricileri.
12. PySpider
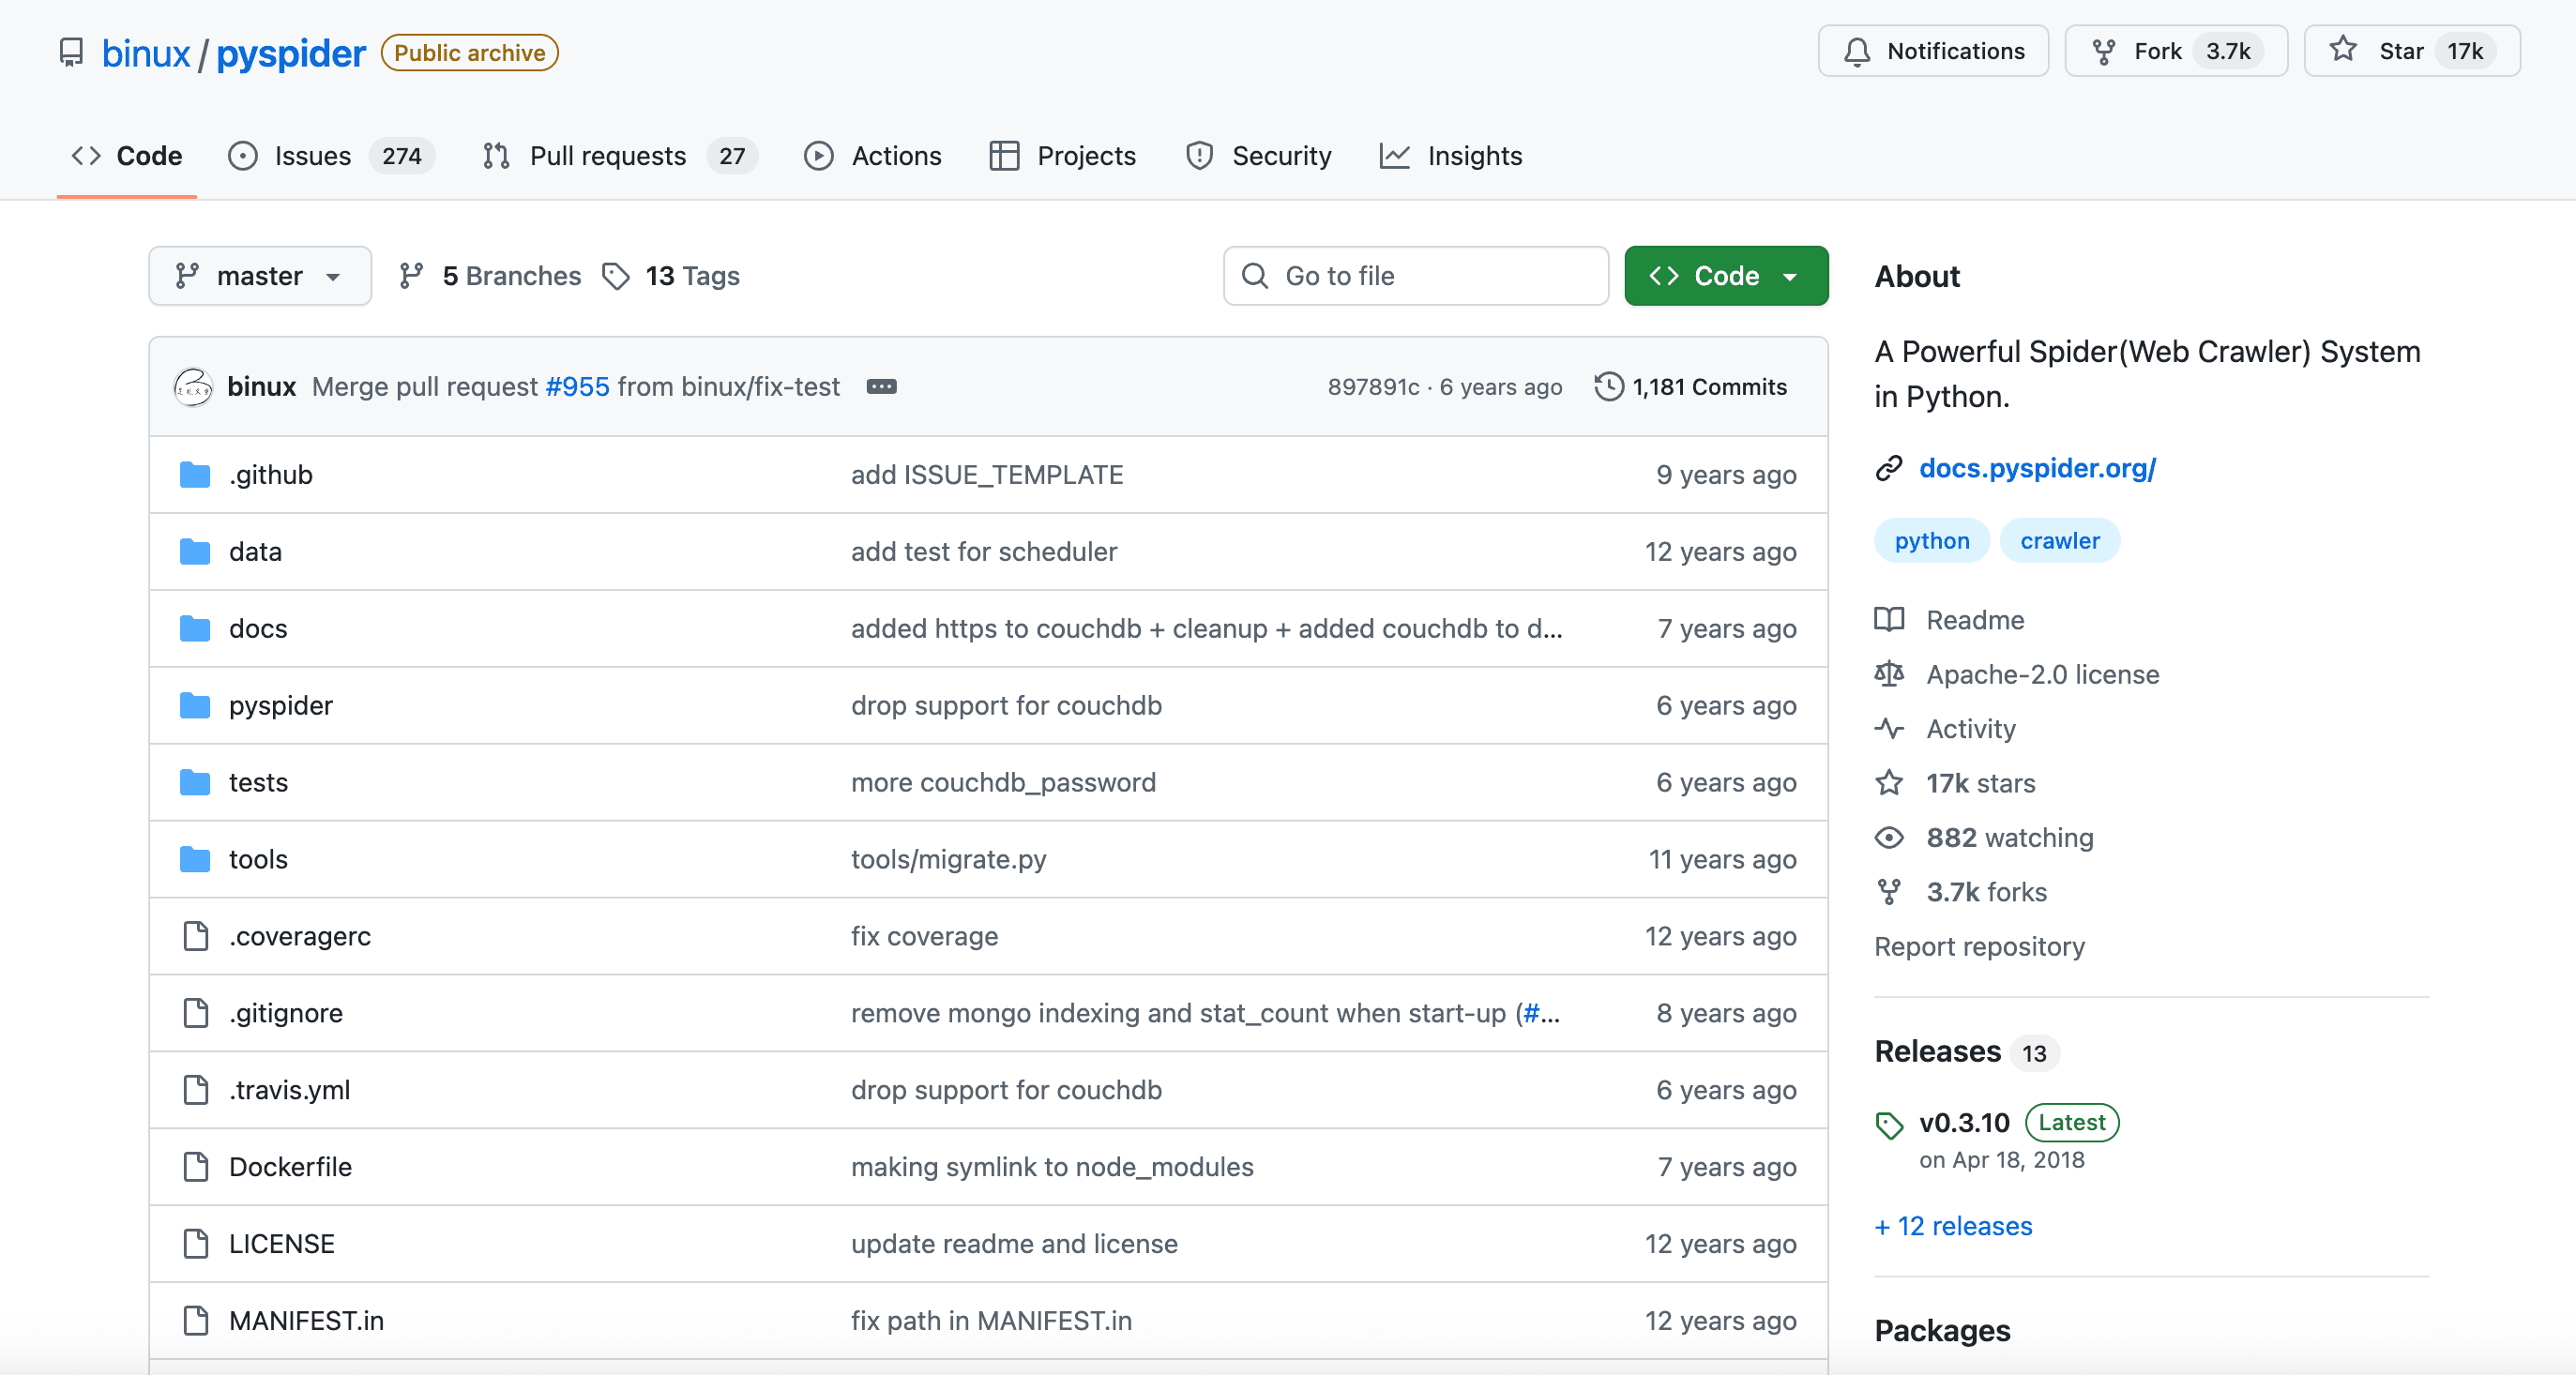 PySpider, web arayüzlü bir Python web crawler sistemidir — taramaları tarayıcıdan yönetebilir, zamanlayabilir ve izleyebilirsiniz. En baştan belirtmekte fayda var: depo GitHub’da herkese açık arşiv olarak işaretlenmiş durumda ve orijinal geliştirici yeni sürüm yayınlamıyor; yani gördüğünüz şey olduğu gibi. Linux’ta yalnızca arayüz/pano mantığına ihtiyacınız varsa hâlâ çalışır; ama uzun vadede bağımlı olmayı planladığınız bir şeyse bunu eski çözüm olarak değerlendirin.
Temel özellikler:
- Betik yazma ve izleme için web tabanlı arayüz.
- Dağıtık tarama, zamanlama ve yeniden deneme.
- Veritabanları ve mesaj kuyruklarıyla entegrasyon.
Fiyatlandırma: Ücretsiz ve açık kaynak.
Linux uyumluluğu: Linux dağıtımı için tasarlanmıştır.
Kimler için uygun: Çok projeli scraping için bir web arayüzünü çatallayıp kendi başına sürdürebilecek ekipler (üst projeden düzeltme beklemeyin).
13. WebHarvy
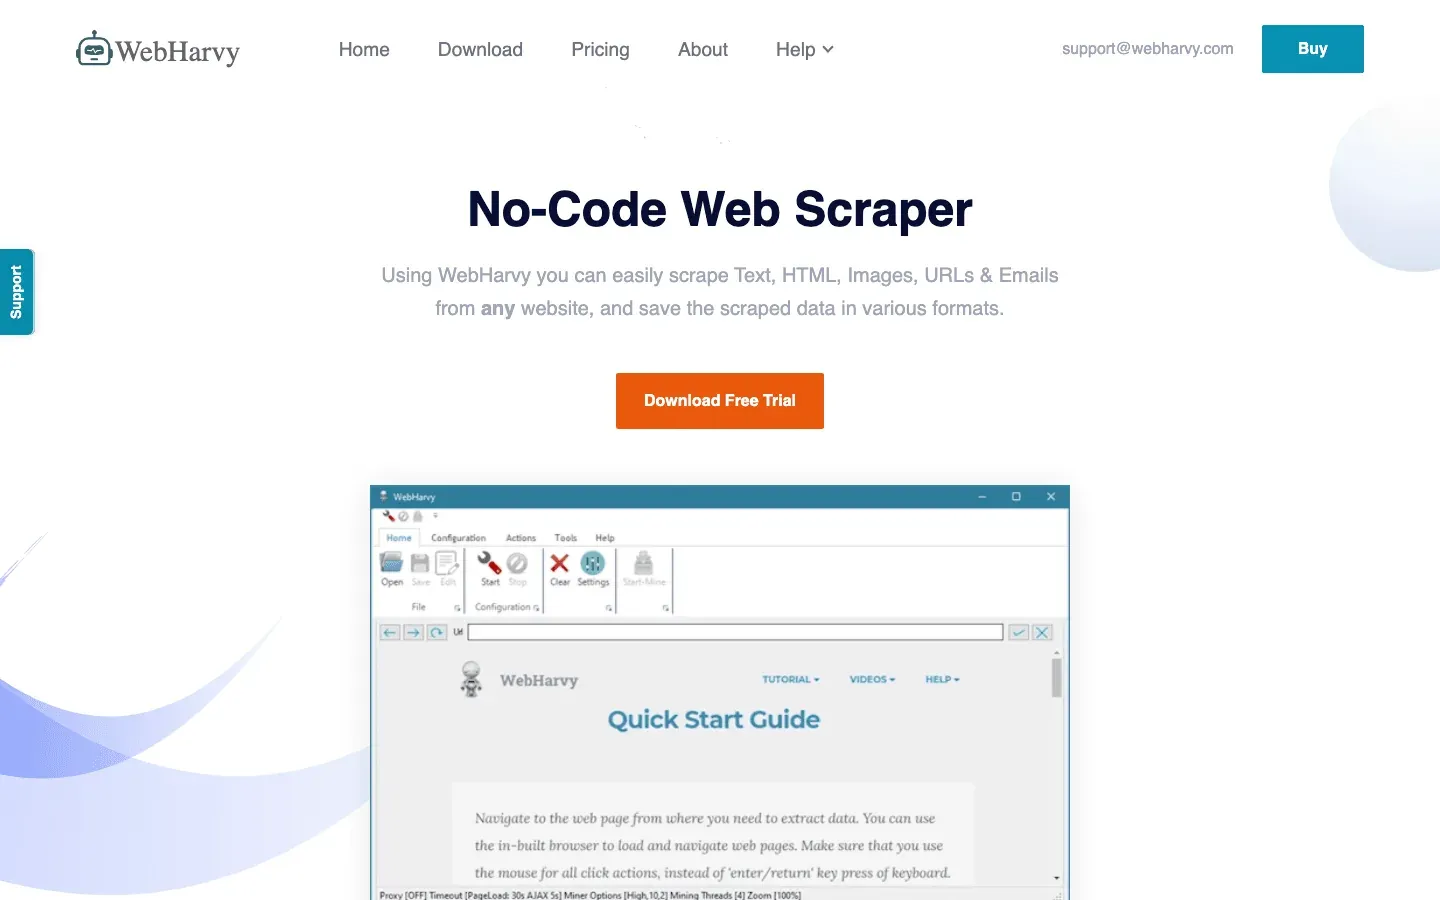 WebHarvy, Windows için bir görsel tıkla-seç scraper’dır; ancak Linux kullanıcıları bunu Wine üzerinden çalıştırabilir. Desen tanıma özelliği ve tek seferlik satın alma modeliyle bilinir.
Temel özellikler:
- Veri seçmek için gezinip tıklayın — kodlama yok.
- Listeler için otomatik desen algılama.
- CSV, JSON, XML, SQL’e dışa aktarma.
Fiyatlandırma: Yaklaşık 129$ tek seferlik lisans.
Linux uyumluluğu: Wine veya sanal makine üzerinden çalışır.
Kimler için uygun: Hızlı ve görsel bir scraper isteyen yeni başlayanlar veya tek başına çalışan profesyoneller.
14. OutWit Hub
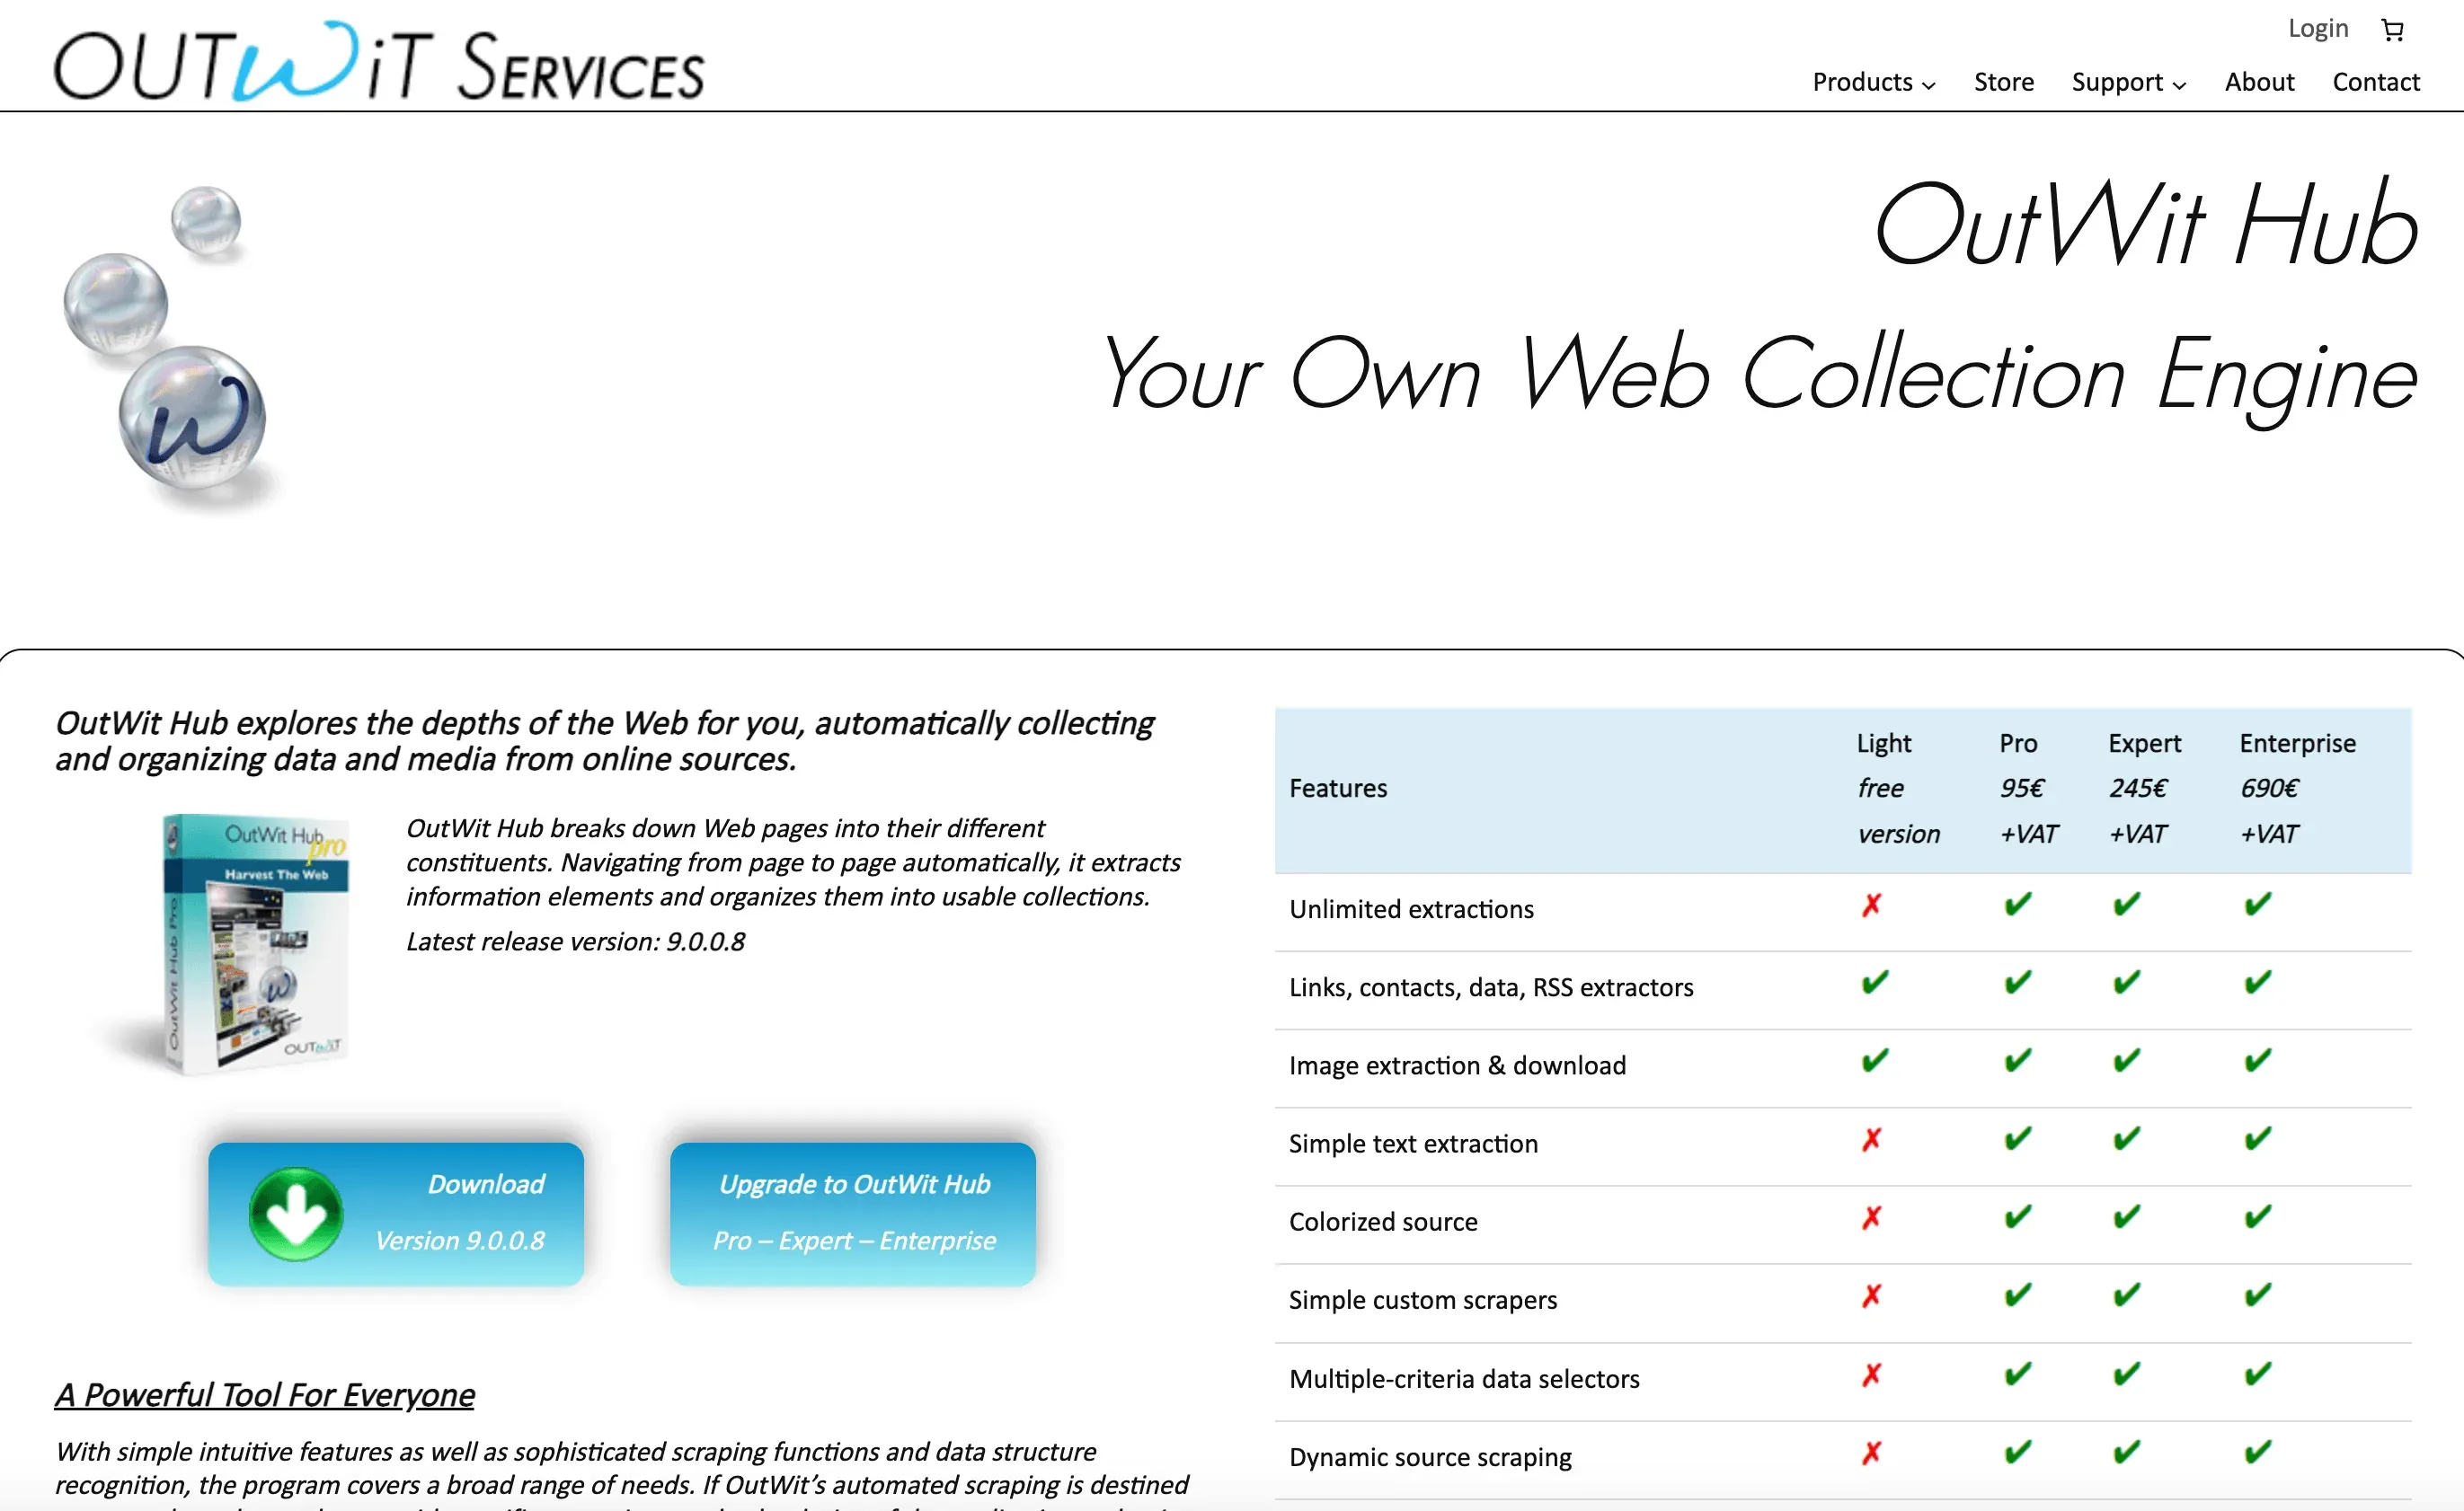 OutWit Hub, web scraping için yerel Linux GUI uygulamasıdır. Veri kalıplarını otomatik tanır ve güçlü çıkarım ile otomasyon özellikleri sunar.
Temel özellikler:
- Bağlantıları, görselleri, tabloları, e-postaları ve daha fazlasını otomatik algılar.
- Özel çıkarım için script editörü.
- Makro otomasyonu ve zamanlama.
Fiyatlandırma: Ücretsiz sürüm (kısıtlı); ücretli Pro lisansı — güncel fiyat için satıcı mağazasına bakın.
Linux uyumluluğu: Linux, Windows ve Mac için yerel uygulama.
Kimler için uygun: Masaüstü GUI scraper isteyen, biraz teknik yönü olan kod bilmeyen kullanıcılar.
15. Portia
 Portia, Scrapinghub’dan çıkan açık kaynaklı, görsel bir web scraper’dır. Tarayıcı içinde çalışır ve sayfaları işaretleyerek scraper eğitmenize olanak tanır — ancak açık konuşayım, depo bir yıldan uzun süredir gerçek bir geliştirme görmedi; yani artık biraz “kendi riskinle kullan” kategorisinde. Görsel işaretleme fikrini aktif geliştirme ile istiyorsanız, daha temiz seçenekler ParseHub veya Thunderbit olur.
Temel özellikler:
- Görsel çıkarım için tarayıcı tabanlı arayüz.
- Özel projeler için Scrapy ile entegre olur.
- Açık kaynak ve genişletilebilir.
Fiyatlandırma: Ücretsiz ve açık kaynak.
Linux uyumluluğu: Tarayıcı tabanlı; her işletim sisteminde çalışır.
Kimler için uygun: Scrapy entegrasyonu olan açık kaynaklı, görsel scraping isteyen kullanıcılar.
16. Sequentum Enterprise (eski adıyla Content Grabber)
 Sequentum Enterprise, Windows için kurumsal seviyede bir görsel scraper’dır; ancak Wine veya sanallaştırma ile Linux üzerinde de çalıştırılabilir.
Temel özellikler:
- Görsel düzenleyici + gelişmiş mantık için C# betikleme.
- Çoklu ajan yönetimi ve zamanlama.
- Veritabanları, API’ler ve daha fazlasıyla entegrasyon.
Fiyatlandırma: Kurumsal lisanslama, dağıtım başına teklif usulü.
Linux uyumluluğu: Wine veya sanal makine üzerinden.
Kimler için uygun: Birden çok scraping projesi yöneten ajanslar ve büyük ekipler.
17. Helium
 Helium, Selenium otomasyonunu sadeleştiren bir Python kütüphanesidir. Tarayıcı betiklerini daha insan dostu hale getirmek için tasarlanmıştır.
Temel özellikler:
click("Login")veyawrite("email")gibi sezgisel komutlar.- Chrome ve Firefox’u otomatikleştirir.
- Hızlı betikleme ve otomasyon işleri için idealdir.
Fiyatlandırma: Ücretsiz ve açık kaynak.
Linux uyumluluğu: Linux’ta çalışır (Selenium tabanlıdır).
Kimler için uygun: Selenium’u fazla hantal bulan Python kullanıcıları.
18. Dexi.io
 Dexi.io, bulut tabanlı bir veri çıkarma ve otomasyon platformudur. Tarayıcı üzerinden erişildiği için Linux kullanıcıları bunu hiçbir kurulum yapmadan kullanabilir.
Temel özellikler:
- Scraping ve otomasyon için görsel iş akışı tasarlayıcı.
- Zamanlama, veri dönüştürme ve API entegrasyonu.
- Kurumsal ölçekte ölçeklenebilirlik ve destek.
Fiyatlandırma: Şimdi Mozenda altında satılıyor: 14 günlük ücretsiz deneme, Pilot aylık 500$, kurumsal plan teklif usulü.
Linux uyumluluğu: Web uygulaması — her işletim sisteminde çalışır.
Kimler için uygun: Ölçeklenebilir ve entegre web veri çıkarımı isteyen profesyoneller ve kurumlar.
Linux Web Scraping Araçlarına Hızlı Bakış: Karşılaştırma Tablosu
| Araç | Tür / Temel Özellikler | Kimler İçin İdeal | Fiyatlandırma | Linux Uyumluluğu |
|---|---|---|---|---|
| Thunderbit | AI Chrome Uzantısı, tek tık, alt sayfa, bulut/yerel | Teknik olmayan iş kullanıcıları | Ücretsiz, 15$/ay’dan başlar | ✔ Linux’ta Chrome |
| Scrapy | Python çerçevesi, asenkron, CLI, yüksek genişletilebilirlik | Geliştiriciler, büyük ölçekli özel scraper’lar | Ücretsiz | ✔ Yerel |
| Beautiful Soup | Python kütüphanesi, basit HTML/XML ayrıştırma | Geliştiriciler, veri bilimcileri, küçük işler | Ücretsiz | ✔ Yerel |
| Selenium | Tarayıcı otomasyonu, JS ağırlıklı siteler | QA, geliştiriciler, dinamik içerik | Ücretsiz | ✔ Yerel |
| Puppeteer | Node.js, headless Chrome, JS render etme | Node geliştiricileri, modern web uygulamaları | Ücretsiz | ✔ Yerel |
| Octoparse | Kodsuz, sürükle-bırak, bulut şablonları | Kod bilmeyenler, e-ticaret | Ücretsiz, 69$/ay’dan başlar | ◐ Bulut/Wine |
| PhantomJS | Headless WebKit, JavaScript ile betiklenebilir | Eski sistemler, hafif kullanım, Chrome’suz ortam | Ücretsiz | ✔ Yerel |
| ParseHub | Görsel, platformlar arası, tıkla-seç | Analistler, yarı teknik kullanıcılar | Ücretsiz, 189$/ay’dan başlar | ✔ Yerel |
| Kimurai | Ruby çerçevesi, çoklu tarayıcı, asenkron | Ruby geliştiricileri, yüksek eşzamanlılık | Ücretsiz | ✔ Yerel |
| Apify | Bulut platformu, SDK’lar, pazaryeri | Geliştiriciler, hibrit özel/bulut | Ücretsiz plan, kullanıma göre | ✔ Yerel/Bulut |
| Colly | Go çerçevesi, hızlı, eşzamanlı | Go geliştiricileri, yüksek performans | Ücretsiz | ✔ Yerel |
| PySpider | Python, web arayüzü, zamanlama, dağıtık | Ekipler, birden fazla proje | Ücretsiz | ✔ Yerel |
| WebHarvy | Görsel, desen algılama, tek seferlik lisans | Yeni başlayanlar, tek başına çalışan profesyoneller | Yaklaşık 129$ tek seferlik | ◐ Wine/VM |
| OutWit Hub | Yerel GUI, veri algılama, betikleme | Kod bilmeyenler, masaüstü GUI | Ücretsiz; ücretli Pro (satıcıya bakın) | ✔ Yerel |
| Portia | Açık kaynak, görsel, tarayıcı tabanlı | Açık kaynak, Scrapy entegrasyonu | Ücretsiz | ✔ Tarayıcı |
| Sequentum Enterprise | Kurumsal, görsel, betikleme, çoklu ajan | Ajanslar, büyük ekipler | $$$, teklif usulü | ◐ Wine/VM |
| Helium | Python, sadeleştirilmiş Selenium, sezgisel API | Python kullanıcıları, hızlı otomasyon | Ücretsiz | ✔ Yerel |
| Dexi.io | Bulut, görsel iş akışı, zamanlama, API | Kurumsal kullanım, ölçeklenebilir otomasyon | Mozenda üzerinden 500$/ay’dan | ✔ Tarayıcı |
Linux İçin Doğru Web Scraper Nasıl Seçilir: Temel Kriterler
Hangi Pakete İhtiyacınız Olduğundan Emin Değil misiniz? Kolay Tarafla Başlayın Selector’ları yönetmek istemiyorsanız, alanları AI’ın otomatik çıkarmasına izin verin — tek tıkla, ardından Sheets, Excel, Airtable veya Notion’a aktarın. Get Started Free
Doğru aracı seçmek, ihtiyaçlarınızı ve becerilerinizi eşleştirmekle ilgilidir:
- Teknik seviye: Kod bilmeyenler Thunderbit, ParseHub, Octoparse veya OutWit Hub’a yönelmelidir. Geliştiriciler ise Scrapy, Puppeteer, Colly veya Kimurai ile daha fazla güç elde eder.
- Veri karmaşıklığı: Statik sayfalar için Beautiful Soup veya Colly hızlı ve basittir. Dinamik, JavaScript ağırlıklı siteler için Selenium, Puppeteer veya JS destekleyen görsel bir araç gerekir.
- Ölçek ve sıklık: Tek seferlik işler için kodsuz araçlar veya bulut scraper’ları yeterlidir. Zamanlanmış, büyük ölçekli taramalar için Scrapy, PySpider veya Apify tercih edin.
- Entegrasyon ihtiyacı: Excel, Sheets veya bir veritabanına aktarmanız gerekiyorsa, aracın iş akışınızı desteklediğinden emin olun.
- Bütçe: Geliştiriciler için bolca ücretsiz ve açık kaynak seçenek var. İş kullanıcıları için Thunderbit ve ParseHub uygun başlangıç noktaları sunarken, kurumsal ekipler Dexi.io veya Sequentum Enterprise’a yatırım yapabilir.
- Destek ve topluluk: Açık kaynak araçların büyük toplulukları vardır; ticari araçlar ise özel destek sunar.
Profesyonel ipucu: Araçları birlikte kullanmaktan çekinmeyin. Thunderbit’i prototip ve veri kalıbı keşfi için kullanıp, üretim ölçeğindeki taramalar için Scrapy’ye geçebilirsiniz. Ya da oturum açmak ve oturum çerezlerini almak için Selenium kullanıp, ardından yüksek hızlı scraping için işi Colly veya Scrapy’ye devredebilirsiniz.
Sonuç: 2026 İçin En İyi Linux Web Scraping Aracınızı Bulun
2026’da Linux kullanıcılarının seçenekleri gerçekten bol. İster dakikalar içinde sonuç veren kodsuz ve AI destekli bir araç (Thunderbit), ister güçlü bir geliştirici çerçevesi (Scrapy, Colly), ister kurumsal düzeyde bir platform (Dexi.io) arıyor olun; ihtiyaçlarınıza ve iş akışınıza uygun bir Linux web scraper mutlaka var.
Öne çıkan çıkarımlar:
- Linux, modern veri altyapısının bel kemiğidir — çoğu üst düzey scraper yerel ya da tarayıcı üzerinden çalışır.
- AI ve kodsuz araçlar, iş kullanıcıları için web scraping’i daha erişilebilir hale getiriyor.
- Esneklik, hız ve ölçek konusunda geliştirici çerçeveleri hâlâ lider.
- Satın almadan önce deneyin — çoğu araç ücretsiz plan veya deneme sunuyor.
Başlamaya hazır mısınız? Thunderbit’i indirin ya da web scraping, otomasyon ve veri odaklı büyüme hakkında daha fazla rehber için Thunderbit Blog’a göz atın.
Thunderbit’in AI Web Scraper’ını Keşfedin Betik yazmayı ve cron işleriyle uğraşmayı bırakın — AI’ın sayfayı okumasına ve size tek tıkla bir tablo sunmasına izin verin. Get Started Free
SSS
1. Kod bilmiyorsam Linux için en kolay web scraper hangisi?
Thunderbit, teknik olmayan kullanıcılar için en iyi tercihtir. Linux’ta Chrome uzantısı olarak çalışır, her şeyi AI ile otomatikleştirir ve tek tıkla veri çekmenizi sağlar.
2. Büyük ölçekli ve özel projeler için en iyi Linux web scraper hangisi?
Geliştiriciler için Scrapy ilk tercihtir. Hızlıdır, ölçeklenebilirdir ve çok özelleştirilebilir — büyük ve tekrarlayan taramalar için idealdir.
3. Linux’ta JavaScript ağırlıklı veya dinamik siteleri scrape edebilir miyim?
Evet! Dinamik içeriği almak için gerçek tarayıcıları kontrol etmek üzere Selenium veya Puppeteer kullanabilirsiniz. ParseHub ve Thunderbit gibi görsel araçlar da dinamik siteleri destekler.
4. İş kullanımı için ücretsiz Linux web scraping araçları var mı?
Kesinlikle var. Scrapy, Beautiful Soup, Selenium, Colly, PySpider ve Kimurai ücretsiz ve açık kaynak. Thunderbit ve ParseHub da daha küçük işler için ücretsiz planlar sunuyor.
5. Kodsuz ve kod tabanlı Linux scraper’lar arasında nasıl seçim yaparım?
Hız ve sadelik istiyorsanız kodsuz araçlara yönelin (Thunderbit, ParseHub, Octoparse). Esneklik, otomasyon veya diğer sistemlerle entegrasyon gerekiyorsa, kod tabanlı araçlar (Scrapy, Puppeteer, Colly) daha doğru seçimdir.
Keyifli scraping’ler — Linux gücüyle çalışan veri projeleriniz yeni bir Ubuntu kurulumu kadar pürüzsüz ilerlesin. Daha fazla web scraping ipucu için Thunderbit Blog’a göz atabilir veya uygulamalı eğitimler için YouTube kanalımıza abone olabilirsiniz.
Linux için AI Web Scraper’ı Deneyin Get Started Free
Daha Fazla Bilgi



