
CRM’iniz, ona beslediğiniz veriler kadar iyidir. En iyi veriler ise pahalı üçüncü taraf veri tabanlarında değil, herkese açık web sitelerinde bulunur.
web extractor araçları, dağınık web verisini temiz ve düzenli tablolara dönüştürür. İyi olanlar bunu kod yazmadan, dakikalar içinde yapar.
Bu araçları gerçek projelerde kullandım: lead listeleri oluşturma, rakip fiyatlarını takip etme, ürün kataloglarını çekme. İşte gerçek iş görevlerinde ne kadar iyi çalıştıklarına göre sıraladığım 12 araç.
Web Extractor’lar Neden İş Dünyası İçin Bir Zorunluluk?
Dürüst olalım: web, dünyanın en büyük ve en dağınık veri tabanı. 2026’da bu karmaşayı içgörüye dönüştürmeyi bilen şirketler öne çıkıyor. Veriye dayalı firmalar, hem verimlilik hem de kârlılık tarafında rakiplerini düzenli olarak geride bırakıyor. Bu avantaj gerçek — tabii veriye gerçekten ulaşabiliyorsanız.
web extractor araçları (bazı yerlerde web page extractor ya da web extracting çözümleri diye de anılır) işte burada devreye giriyor. Satış ekiplerinin herkese açık dizinleri, sosyal medyayı ve şirket web sitelerini tarayarak hedefli potansiyel müşteri listeleri oluşturmasına yardımcı olur — artık güncelliğini yitirmiş lead listeleri satın almak ya da stajyerinizin kopyala-yapıştır maratonunun ortasında işi bırakmaması için dua etmek yok (Thunderbit Blog). Pazarlama ve e-ticaret ekipleri ise web extractor’ları rakip fiyatlarını izlemek, stok durumunu takip etmek ve ürünleri gerçek zamanlı kıyaslamak için kullanır — örneğin John Lewis, daha akıllı fiyatlama sayesinde elde edilen %4’lük satış artışını web scraping’e bağlıyor (Thunderbit Blog).
Ama mesele sadece rakamlar değil. web extractor’lar çok büyük zaman tasarrufu sağlar (bir kullanıcı, veri toplamayı otomatikleştirerek “yüzlerce saat” kazandığını bildirdi) ve insan hatasını ortadan kaldırır (Thunderbit Blog). Operasyon ekipleri artık stajyerlerin haftalar sürecek işi için scraper kuruyor — eskiden sıkıcı kopyala-yapıştır işlerine giden saatler geri kazanılıyor (Thunderbit Blog). Yapay zekâ destekli extractor’larla teknik olmayan kullanıcılar bile web sitelerini analiz için yapılandırılmış veriye dönüştürebiliyor (Box Piper).
Kısacası? 2026’da bir web extractor kullanmıyorsanız, muhtemelen içgörüleri ve parayı masada bırakıyorsunuz.
En İyi 12 Web Extractor’ı Nasıl Seçtik?
Bu kadar çok web extracting aracı varken doğru olanı nasıl seçersiniz? Yüzlerce seçeneğe baktım ama bu listeye yalnızca 12 tanesi girdi. Şunlara odaklandım:
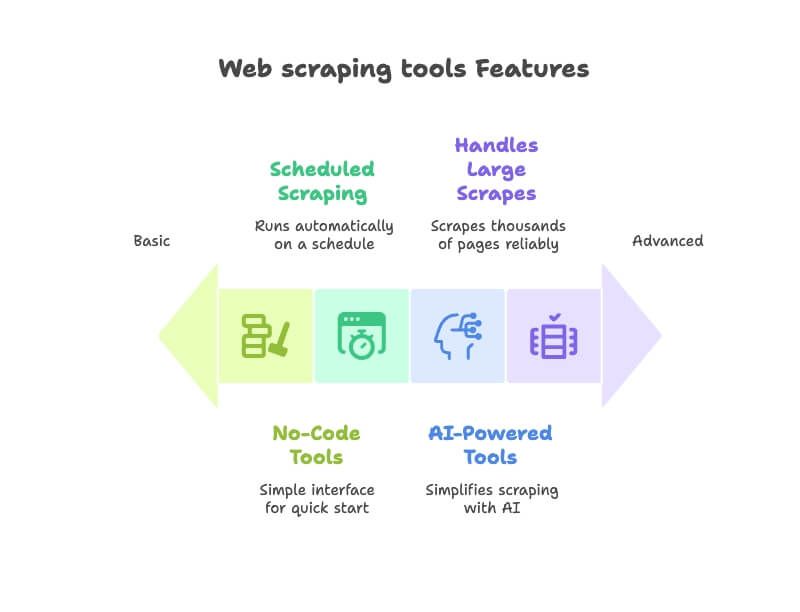
- Kullanım Kolaylığı: Teknik bilgisi olmayan biri kod yazmadan hızlıca başlayabiliyor mu? Sezgisel arayüze sahip, no-code ya da low-code araçları önceliklendirdim (Thunderbit Blog).
- Yapay Zekâ Yetkinlikleri: Verileri otomatik algılama, site içinde yön bulma ya da ihtiyaçlarınızı sade İngilizce ile tarif etme gibi işleri kolaylaştıran yeni nesil AI destekli araçlar (Thunderbit Blog).
- Otomasyon ve Zamanlama: En iyi web extractor’lar kendi kendine çalışır. Tekrarlayan veri çekme işlemlerini zamanlayabilen veya web sitelerini izleyebilen araçları seçtim (Thunderbit Blog).
- Veri Dışa Aktarma ve Entegrasyon: Excel, Google Sheets, Airtable veya Notion’a kolayca aktarabiliyor musunuz? İş akışı entegrasyonları ise ekstra artı puan (Thunderbit Blog).
- Ölçeklenebilirlik ve Güvenilirlik: İster tek sayfa ister binlerce sayfa çekin, bu araçlar işin altından kalkabiliyor mu? Güvenilirlik için kullanıcı yorumlarını da dikkate aldım.
- İş Odaklı Kullanım Senaryoları: Sadece geliştiriciler değil, satış, pazarlama, e-ticaret ve operasyon ekipleri arasında popüler olan araçlara ağırlık verdim.
Buradaki bazı araçlar AI destekli yeni oyuncular, bazıları ise sektörün klasiklerinden. Hepsinin amacı aynı: web’i kendi iş veri tabanınıza dönüştürmenizi sağlamak — üstelik baş ağrısı olmadan.
Hızlı Karşılaştırma: Web Extractor Araçlarına Kısa Bakış
İşte ele alacağım 12 web extractor aracının kısa bir özeti; böylece hangilerinin öne çıktığını hemen görebilirsiniz:
| Araç | AI Otomasyonu | Kullanım Kolaylığı | En İyi Kullanım Senaryosu |
|---|---|---|---|
| Thunderbit | Evet – AI alanları önerir ve sayfaları otomatik işler | Çok kolay (Chrome uzantısı, kod yok) | Dakikalar içinde sonuç almak isteyen teknik olmayan kullanıcılar için lead, fiyat vb. hızlı veri çekme. |
| Octoparse | Sınırlı (şablon tabanlı, AI yok) | Çoğu kullanıcı için kolay (görsel sürükle-bırak arayüzü) | Kod yazmadan kontrol isteyen analistler için özel scraping iş akışları (girişler, sayfalama). |
| Browse AI | Kısmi – nokta ve tıkla "robotlar" | Kolay (no-code, bulut tabanlı) | Takvimli çalışan ve uyarı veren, fiyatlar/listelemeler gibi verilerin otomatik izlenmesi. |
| WebScraper.io | Hayır (manuel yapılandırma) | Orta (site haritası kurulumu olan tarayıcı uzantısı) | Adımları kendisi yapılandırmaya razı kullanıcılar için çok katmanlı sitelerin görsel olarak taranması. |
| ScraperAPI | N/A (API hizmeti, proxy’leri API üzerinden yönetir) | Kodlama gerektirir (API entegrasyonu) | Teknoloji ekipleri için yüksek hacimli web veri çekme — büyük ölçekli taramalarda proxy ve CAPTCHA yönetimiyle. |
| Data Miner | Hayır | Çok kolay (tek tıkla şablonlar sunan tarayıcı uzantısı) | Özellikle tablo veya listeleri sayfadan CSV/Excel’e hızlı ve tek seferlik aktarma. |
| Simplescraper | Hayır (bazı AI destekli özellikler var) | Kolay (nokta ve tıkla recipe oluşturucu) | Google Sheets, Airtable veya API’ye web verisi göndermek için ideal no-code scraping. |
| Instant Data Scraper | Evet – veri tablolarını otomatik algılar | Çok kolay (sadece tıkla, kurulum yok) | Herkes için HTML tablo ve listelerin anında ücretsiz çekimi (hızlı veri almak için ideal). |
| ScrapeStorm | Evet – AI sayfa öğelerini tanır | Kolay (görsel arayüz; çapraz platform uygulama) | Zamanlanmış taramalar dahil, kod yazmadan büyük ölçekli veya karmaşık scraping projeleri. |
| Apify | Kısmen – hazır "actor" botlar mevcut | Orta (web arayüzü; kod opsiyonel) | Hazır ya da özel script’lerle ölçeklenebilir bulut scraping ve otomasyon. |
| ParseHub | Hayır (script yazmadan ama manuel kurulumla) | Temel kullanım için kolay (görsel editör; masaüstü uygulama) | Dinamik veya karmaşık siteleri (AJAX içeriği) no-code arayüzle çekme. |
| OutWit Hub | Hayır | Kolay (masaüstü GUI uygulaması) | Küçük projeler için basit, çevrimdışı veri çekme ve içerik arşivleme. |
Çoğu araç ücretsiz plan ya da deneme sürümü ile katmanlı abonelikler sunar. Burada odak, maliyetten çok yetenekler ve kullanım senaryolarıdır.
Thunderbit: Herkes İçin Yapay Zekâ Destekli Web Extractor

Yapay zekâ ile herhangi bir siteden veri çekin Seçici ayarı yok, kurulum yok — AI sayfayı okur ve tek tıkla size yapılandırılmış bir tablo verir. Get Started Free
İlk olarak Thunderbit’ten başlayalım — evet, bu benim bebeğim; ama bir dinleyin. web extracting sektörü, “kendi scraper’ını kendin yapılandır” anlayışından, “AI’ye ne istediğini söyle” yaklaşımına kayıyor. Thunderbit, benim gördüğüm ve geliştirilmesine yardımcı olduğum ilk araçlardan biri; gerçekten sadece bir “crawler” değil, tam anlamıyla bir AI veri asistanı gibi hissettiriyor.
Thunderbit ile XPath, CSS selector ya da regular expression ile uğraşmazsınız. Tek yapmanız gereken, istediğiniz veriyi sade bir dille tarif etmek — örneğin “bu sayfadaki başlığı, yazarı ve tarihi al” demek — gerisini Thunderbit’in AI’si halleder (Thunderbit Blog). “AI Suggest Fields”e tıklayın; Thunderbit sayfayı okur, sütunları önerir ve alt sayfalar ile sayfalama işlemlerini bile otomatik yönetir (Thunderbit Blog).
Ama mesele sadece veri almak değil. Thunderbit, veriyi çekerken temizleyebilir, dönüştürebilir, kategorize edebilir ve hatta çevirebilir. Telefon numaralarını standartlaştırmak, açıklamaları özetlemek ya da ürün adlarını çevirmek mi gerekiyor? Kısa bir talimat yeterli; AI işi halleder. İşiniz bittiğinde veriyi doğrudan Excel, Google Sheets, Airtable veya Notion’a aktarabilirsiniz (Thunderbit Blog).
Thunderbit’i gerçekten farklı kılan şey sıfır kurulum, sıfır öğrenme eğrisi. Bir Chrome uzantısı olduğu için saniyeler içinde kullanmaya başlarsınız. Eklenti yok, yapılandırma yok, teknik jargon yok. Bu yüzden sonuçlarını hızlı isteyen satış, pazarlama ve operasyon ekipleri arasında favori hâline geldi (Thunderbit Blog). Ücretsiz plan, tam iş akışını denemenize imkân verir; ücretli planlar da çoğu ekip için oldukça erişilebilir seviyededir.
AI web extracting deneyimini görmek istiyorsanız, Thunderbit Chrome Extension’ı indirin ve bir deneyin. Kopyala-yapıştır günleriniz bitebilir.
Octoparse: Özel İş Akışları İçin Görsel Web Extractor
Octoparse, görsel web scraping dünyasının klasiklerinden biridir. Nokta ve tıkla arayüzüne sahip bir masaüstü uygulamasıdır — sayfayla etkileşir, istediğiniz veriyi seçer ve Octoparse arka planda iş akışını oluşturur (Thunderbit Blog). Giriş işlemlerini yönetebilir, sayfalama kurabilir ve form gönderimlerini bile kod yazmadan otomatikleştirebilirsiniz.
Octoparse’ın güçlü yanlarından biri, Amazon, Twitter, LinkedIn gibi popüler siteler için sunduğu 500’den fazla hazır şablon kütüphanesidir; çoğu zaman bir şablonu yükleyip hemen veri çekmeye başlayabilirsiniz (Thunderbit Blog). Daha karmaşık sitelerde ise manuel moda geçip her adımı görsel olarak ayarlayabilirsiniz. Octoparse, tıklama veya kaydırma sonrası yüklenen içerikleri destekler; zor işler için proxy ve CAPTCHA çözümleriyle de çalışabilir. Ayrıca planlanmış görevler ve büyük ölçekli çalıştırmalar için bulut tabanlı bir seçenek de vardır.
Dezavantajı mı? Özellikle gelişmiş senaryoları yönetmek istiyorsanız hafif bir öğrenme eğrisi var. Yine de kod yazmadan kişiselleştirilmiş bir scraping iş akışı isteyen teknik olmayan kullanıcılar ve veri analistleri için Octoparse sağlam bir tercihtir (Dev.to).
Browse AI: Hazır Robotlarla Otomatik Web Extracting
Browse AI eğlenceli bir yaklaşım sunuyor: istediğiniz veriyi işaretleyip tıklayarak bir “robot” eğitiyorsunuz; ardından benzer sayfalarda aynı veriyi çekmeyi öğreniyor (Thunderbit Blog). Tamamen bulut tabanlı ve no-code olduğu için script ya da sunucu derdi yok.
Browse AI’ı öne çıkaran şey otomasyon ve izleme tarafı. Robotlarınızı belirli aralıklarla çalışacak şekilde zamanlayabilir ve veri değiştiğinde uyarı alabilirsiniz (örneğin rakip fiyat düşürürse ya da yeni bir iş ilanı çıkarsa). Ayrıca yaygın görevler için hazır robot kütüphanesi de sunuyorlar; yani çoğu zaman sıfırdan başlamak yerine hazır bir çözümü alıp ihtiyaca göre uyarlayabilirsiniz (ToolsForHumans).
Browse AI, Zapier ve Make üzerinden binlerce uygulama ile entegre olabilir; veriyi doğrudan Google Sheets’e ya da API/webhook aracılığıyla aktarabilir (Thunderbit Blog). Özellikle sürekli izleme ve tekrarlayan veri toplama için, hands-off uyarılar ve entegrasyonlar istiyorsanız çok uygundur.
WebScraper.io: Tarayıcı Tabanlı Web Page Extractor
WebScraper.io (çoğu zaman sadece “Web Scraper” diye anılır), bir web sitesinde nasıl gezileceğini ve hangi öğelerin çekileceğini görsel olarak planlamanızı sağlayan bir tarayıcı uzantısıdır; buna “site map” denir (Thunderbit Blog). İhtiyacınız olan veriler ve izlenecek bağlantılar için selector’lar tanımlarsınız (örneğin “sayfalamak için sonraki butona tıkla” veya “detaylar için her ürün bağlantısını ziyaret et”).
Biraz öğrenme eğrisi vardır, ancak kod yazmanız gerekmez — sadece sayfa öğelerini seçer ve çekme adımlarını belirlersiniz. Web Scraper, çok katmanlı gezinme, sayfalama ve hatta sonsuz kaydırma destekler (ama bu adımları manuel olarak belirtmeniz gerekir). Esnektir ve tarayıcıda çalışır; bu nedenle giriş gerektiren sitelere de kendi oturumunuzla erişip veri çekebilirsiniz.
WebScraper.io, web sayfası yapılarıyla rahat çalışan ve ücretsiz, esnek bir araç isteyen “citizen data analyst”’ler için idealdir. Kendi site haritalarınızı kurmaya hazırsanız güvenilir bir iş atıdır.
ScraperAPI: Geliştiriciler ve Ekipler İçin API-Öncelikli Web Extractor
Her ekip nokta ve tıkla arayüzü istemez — bazen web verisini doğrudan uygulamalarınıza veya veri tabanlarınıza akıtacak bir arka uç çözümüne ihtiyaç duyarsınız. ScraperAPI, API öncelikli bir web extractor’dır: ona bir URL verirsiniz, o da ham HTML’yi veya çekilmiş veriyi geri döner; proxy, coğrafi IP rotasyonu, headless browser’lar ve CAPTCHA gibi zor işleri sizin yerinize halleder (ScraperAPI Pricing).
ScraperAPI, 50 ülkede 40 milyon proxy havuzunu yönetir ve 10.000’den fazla şirket için milyarlarca isteği işlediğini belirtir. Güvenilirlik ve engel aşma kabiliyetinin kritik olduğu büyük ölçekli, otomatik scraping işleri için en uygun seçeneklerden biridir. Kullanmak için biraz kod bilgisi gerekir; ancak veri boru hatları kuruyor ya da scraping’i ürününüze entegre ediyorsanız, ScraperAPI güçlü bir tercihtir.
Data Miner: Hızlı Web Page Extracting İçin Chrome Uzantısı
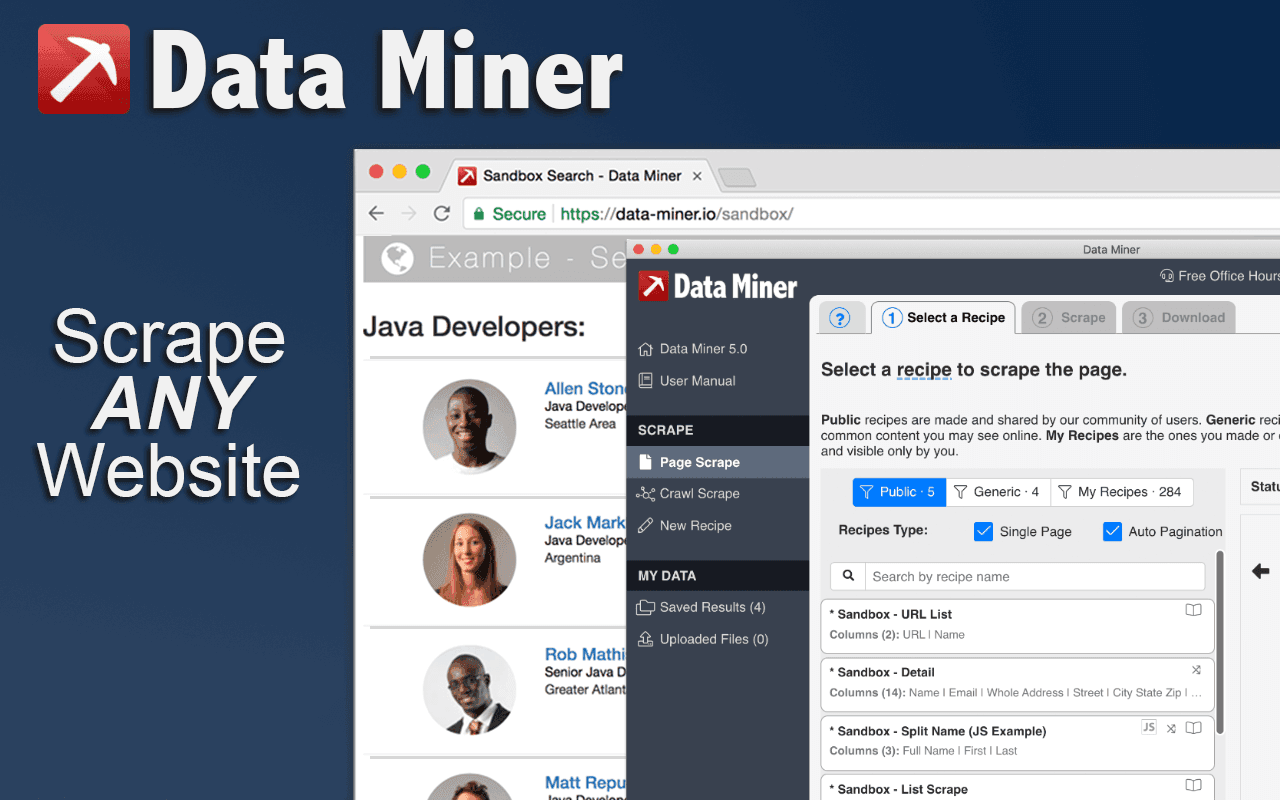
Data Miner, veriyi hızlıca çekmesi gereken iş kullanıcıları ve araştırmacılar için geliştirilmiş bir Chrome uzantısıdır. Nokta ve tıkla scraping deneyimi ve tablo, liste ya da belirli siteler gibi yaygın yapılar için hazır scraping “recipe”leri sunar (Dev.to).
Uzantıyı yükleyin, hedef sayfaya gidin ve Data Miner simgesine tıklayın. Bir recipe seçin ya da sayfadaki öğeleri seçerek kendi kuralınızı oluşturun. Özellikle tek seferlik işler veya hızlı veri ihtiyaçları için harikadır — örneğin satış temsilcisinin çevrimiçi bir dizinden lead listesi çıkarması ya da bir e-ticaret yöneticisinin rakip fiyatlarını kopyalaması gibi.
Data Miner basit, tarayıcıya entegre ve etkileşimli, talep üzerine scraping için çok uygundur.
Simplescraper: Anında Sonuç Veren No-Code Web Extractor
Simplescraper, adının hakkını veriyor. Bir sayfadaki veriyi görsel olarak seçip çekme işlemi için bir “recipe” oluşturmanıza izin veren no-code bir Chrome uzantısı ve web uygulamasıdır (Thunderbit Blog). Bağlantıları takip ederek alt sayfaları çekebilir, sayfalama yapabilir ve hatta scraping işleminizi tek tıkla bir API endpoint’ine dönüştürebilirsiniz.
Simplescraper’ın en güçlü tarafı entegrasyon seçenekleridir — veriyi doğrudan Google Sheets, Airtable veya Zapier gibi araçlara gönderebilirsiniz (Thunderbit Blog). Tekrarlayan işler için bulut scraping ve zamanlama da mevcut; ayrıca GPT ile verinizi temizlemek veya analiz etmek için bir “AI Enhance” özelliği var.
Hızlı sonuçlar ve kolay entegrasyonlar istiyorsanız, Simplescraper hafif web scraping için İsviçre çakısı gibidir.
Instant Data Scraper: Tablo ve Listeler İçin Hızlı Web Extracting
Bazen veriyi hemen istersiniz; kurulumla uğraşmak istemezsiniz. İşte Instant Data Scraper (IDS) tam burada devreye girer. Tablolu veriyi tek tıkla çekmesiyle bilinen ücretsiz bir Chrome uzantısıdır (Thunderbit Blog). Uzantıyı açtığınızda IDS sayfadaki tablo veya listeleri otomatik algılar. Hatta tüm sayfaları otomatik tıklayarak sayfalama ve sonsuz kaydırmayı da yönetir.
IDS %100 ücretsizdir; kayıt yok, kod yok, bekleme yok. Gündelik ya da acil scraping ihtiyaçları için mükemmeldir — örneğin bir satış temsilcisinin hızlıca lead listesi alması ya da bir öğrencinin Wikipedia tablolarından veri çekmesi gibi. Verinizi bulursa, saniyeler içinde elinizde olur.
ScrapeStorm: AI Destekli Bulut Tabanlı Web Extractor
ScrapeStorm, görsel arayüzü güçlü AI algoritmalarıyla birleştiren AI destekli bir web scraping aracıdır (AI Tools Inc.). Bir URL girersiniz; AI’si veri alanlarını otomatik olarak tanımlar — listeler, tablolar, sonraki sayfa butonları ve daha fazlası.
ScrapeStorm, çapraz platform kullanımını destekler (Windows, Mac, Linux) ve hem masaüstü hem de bulut tabanlı scraping sunar. Görevleri zamanlayabilir, aynı anda birden çok işi çalıştırabilir ve veriyi Excel, CSV, JSON formatlarında dışa aktarabilir ya da doğrudan bir veri tabanına yükleyebilirsiniz (AI Tools Inc.). Özellikle e-ticaret ve pazar araştırması için popülerdir; hatta AI kullanarak görsellerden veya PDF’lerden veri ayrıştırabilir.
Büyük ölçekli veya karmaşık scraping projeleri için akıllı bir yardımcı arıyorsanız, ScrapeStorm’a göz atmaya değer.
Apify: Web Extractor Pazaryeri ve Otomasyon Platformu
Apify sadece bir scraper değil; aynı zamanda bir web scraping ve otomasyon platformu. Scraping ya da tarayıcı otomasyonu için script’ler olan “actor”’ları çalıştırabilirsiniz. Asıl büyü ise Apify’nin yaygın görevler için sunduğu hazır actor pazaryeri (Dev.to). Bir e-ticaret sitesindeki tüm yorumları mı çekmek istiyorsunuz? Büyük ihtimalle bunun için bir actor vardır.
Geliştiriciler için Apify, kendi scraper’larınızı Node.js veya Python ile yazıp buluta dağıtmanıza izin verir. Ölçeklenebilir, otomasyona uygun ve API üzerinden entegre edilebilir. Apify, web verisini kritik bir kaynak olarak gören güç kullanıcıları ve kurumlar için en uygunudur — özellikle sürekli, büyük ölçekli scraping ya da scraping’i veri boru hattına entegre etme senaryolarında.
ParseHub: Karmaşık Siteler İçin Görsel Web Page Extractor
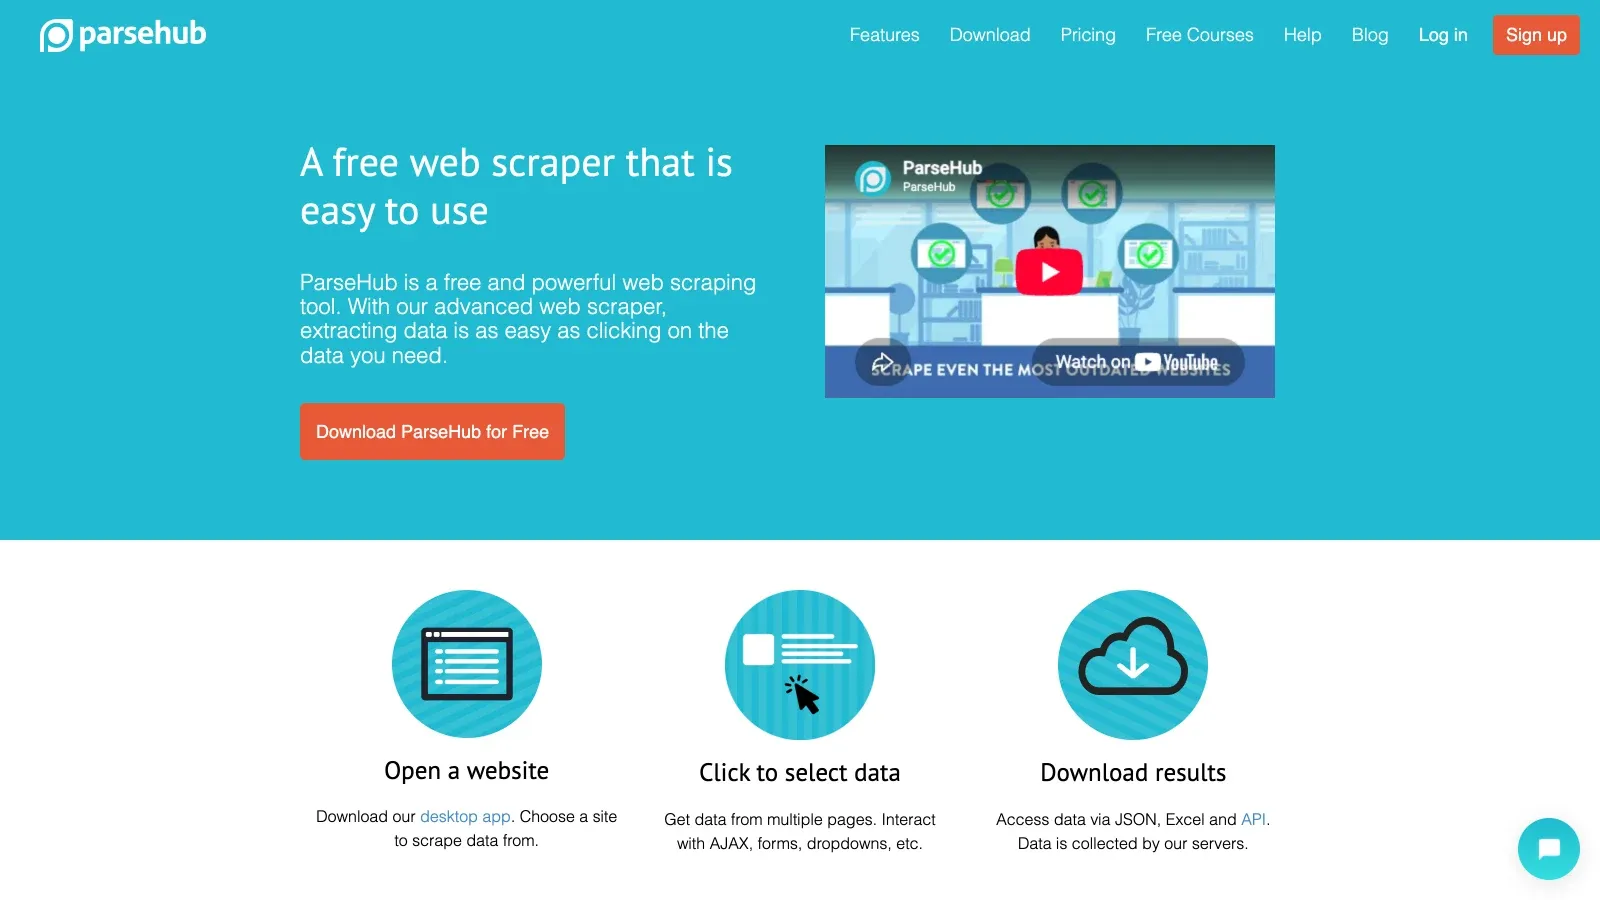
ParseHub, karmaşık ve dinamik web sitelerini yönetebilmesiyle bilinen bir masaüstü uygulamasıdır (bulut seçenekleriyle birlikte). Tarayıcı benzeri bir arayüzde site içinde dolaşır, veri noktalarına tıklarsınız ve ParseHub scraper’ınızı oluşturur (Dev.to). Koşullu mantık, iç içe scraping, AJAX içeriği ve daha fazlasını destekler.
Başka araçların doğru çekemediği sitelerde genellikle ParseHub tercih edilir. Araştırmacılar, analistler ve küçük işletme sahipleri tarafından zorlu siteleri çözmek için kullanılır. Biraz öğrenme gerektirir, ancak karmaşık bir siteyi çekmeniz gerekiyorsa ve kod yazmak istemiyorsanız, ParseHub en iyi seçeneklerden biridir.
OutWit Hub: İçerik Arşivleme İçin Masaüstü Web Extractor
OutWit Hub biraz eski usul kalıyor ama çok çeşitli içerikleri (bağlantılar, görseller, e-posta adresleri vb.) toplamak ve düzenlemek için harika bir masaüstü uygulaması (Scrapeless). Tarayıcı ile tablo karışımı gibi çalışır — bir sayfaya gidin, OutWit Hub tabloları, listeleri, görselleri ve daha fazlasını çıkarabilir.
Özellikle içerik arşivleme veya araştırma için kullanışlıdır — örneğin bir forumdaki tüm gönderileri çekmek veya bir dosya koleksiyonunu indirmek gibi. Yerel olarak çalışan bir masaüstü araç olduğu için veriniz gizli kalır. OutWit Hub, düz ve anlaşılır bir masaüstü arayüzü isteyen küçük ve orta ölçekli scraping işleri için uygundur.
İhtiyacınıza En Uygun Web Extractor Hangisi?
On iki araç, binlerce kullanım senaryosu. Peki hangi web extractor’ı seçmelisiniz? İşte kısa rehberim:
-
Tamamen yeni başlayanlar veya tek seferlik hızlı işler için:
Temel tablo ve listeler için Instant Data Scraper’ı deneyin (ücretsiz ve anında). Benzer sayfaları sık sık çekiyorsanız daha fazla şablon sunan Data Miner da kullanıcı dostu bir seçenektir.
-
Sürekli scraping veya entegrasyon ihtiyacı olan teknik olmayan kullanıcılar için:
Thunderbit, AI odaklı yaklaşımıyla en kolay iş akışını sunar — hızlı ve sık sonuç almak isteyen iş kullanıcıları için idealdir. Browse AI, sürekli izleme ve uyarılar için harikadır. Scraped veriyi Google Sheets’e ya da API üzerinden dahili bir uygulamaya akıtmak istiyorsanız Simplescraper çok uygundur.
-
Kodsuz şekilde karmaşık web siteleri veya özel iş akışları için:
Octoparse veya ParseHub gibi görsel scraper’ları seçin. Octoparse kullanıcı dostudur ve çok sayıda şablonla gelir. ParseHub çok karmaşık dinamik siteleri yönetir ve ince ayar olanağı sağlar. Kendi site haritanızı oluşturmakta rahatsanız WebScraper.io da çok güçlüdür.
-
Ölçek ihtiyacı olan geliştiriciler veya veri mühendisleri için:
ScraperAPI, web scraping’i yazılımınıza gömmek veya büyük ölçekli projeler yürütmek için birebir. Hazır ya da özel script’lerden oluşan pazaryeriyle ölçeklenebilir bir platform gerektiğinde Apify mükemmeldir.
-
İçerik ağırlıklı çekim veya çevrimdışı kullanım için:
Özellikle gizlilik veya kontrol nedeniyle masaüstü araç tercih ediyorsanız, içerik toplama ve arşivleme için OutWit Hub sağlam bir seçimdir.
AI’nin kendi sayfanızda neleri yakaladığını görün Gerçekten önemsediğiniz bir sayfayı açın ve Thunderbit’in sütunları kendi başına okumasına izin verin — tek tıkla yapılandırılmış tablo, ücretsiz plan dahil. Get Started Free
Açık konuşmak gerekirse, birçok ekip işe göre birden fazla araç kullanıyor. Basit bir şey için Instant Data Scraper ile başlayıp, daha kapsamlı bir proje için Thunderbit veya Octoparse’a geçebilir, süreci kurumsallaştırmanız gerektiğinde ScraperAPI veya Apify kullanabilirsiniz. İyi haber şu ki, bu araçların çoğunda ücretsiz plan ya da deneme var; yani deneyip size neyin uyduğunu görebilirsiniz.
Sonuç: İş Ekipleri İçin Web Extracting’in Geleceği
Web extractor araçları çok yol kat etti. 2026’da artık tamamen ana akım hâline geldiler. Büyük trend ne? Web scraping daha kolay, daha otomatik ve günlük iş akışlarına daha entegre bir yapıya dönüşüyor (HubSpot Blog). AI destekli scraper’lar sayesinde karmaşık ve dinamik web siteleri bile özel uzmanlık gerektirmeden kontrol altına alınabiliyor. Bir veri mühendisi bunu şöyle özetliyor: “AI web scraping araçları piyasaya çıktığında, işleri çok daha hızlı ve daha büyük ölçekte tamamlayabildim... AI ile [veri temizleme] otomatik olarak iş akışıma dahil oluyor.”
Bir diğer büyük değişim ise scraping, izleme ve otomasyon arasındaki çizgilerin bulanıklaşması. Browse AI ve Thunderbit gibi araçlar sadece veri çekmekle kalmıyor, veriyi güncel tutuyor ve hatta işlem bile yapabiliyor (örneğin form doldurma ya da uyarı tetikleme). Benimseme tarafındaki artış da gerçek — büyük bir platformda aylık aktif kullanıcı sayısı bir yılda %140’tan fazla arttı (Apify Blog). Her ölçekte şirket, herkese açık web verisine etik ve yasal şekilde erişmenin rekabette kalmanın anahtarlarından biri olduğunu fark ediyor.
İş ekipleri için ana mesaj güçlenme. Bir geliştiriciyi haftalarca beklemek ya da sezgilere dayalı kararlarla yetinmek zorunda değilsiniz. Bu listedeki araçlar, satış, pazarlama, operasyon ve daha fazlasında gerçek kullanım senaryolarına uyarlanmış arayüzler ve özelliklerle web verisinin gücünü elinize veriyor. Üstelik işlerin gidişatına bakılırsa yakın gelecekte daha da kullanıcı dostu arayüzler, daha akıllı AI ve BI/analitik platformlarla daha derin entegrasyonlar göreceğiz.
Sadece şunu unutmayın: sitelerin kullanım şartlarına ve robots.txt kurallarına saygı gösterin, ayrıca veri gizliliği yasalarına uyduğunuzdan emin olun. Etik scraping, bu uygulamaların sürdürülebilirliği için önemlidir.
İster ücretsiz bir uzantıyla başlayın ister kurumsal seviyede bir scraping filosu kurun, web’in bilgisini eyleme dönüştürmek için bundan daha iyi bir zaman olmadı. Web extractor devrimi burada — bir araç seçin, deneyin ve gözünüzün önündeki değeri ortaya çıkarın. Veriye dayalı geleceğiniz sadece bir tık uzağınızda.
SSS
1. Web extractor nedir ve işletmeler için neden önemlidir?
Web extractor, web sitelerinden yapılandırılmış veriyi otomatik olarak toplayan bir araçtır. İşletmelerin dağınık çevrimiçi bilgileri eyleme dönüştürülebilir içgörülere çevirmesini sağladığı için kritiktir — verimliliği artırır, kârlılığı destekler ve manuel veri toplama ihtiyacını ortadan kaldırır.
2. Web extractor’ları kimler kullanabilir — teknik bilgi gerekir mi?
Modern web extractor’ların çoğu için teknik bilgi gerekmez. Thunderbit, Browse AI ve Instant Data Scraper gibi araçlar, sezgisel arayüzler, AI destekli otomasyon ve no-code iş akışları ile teknik olmayan kullanıcılar için tasarlanmıştır.
3. Satış, pazarlama ve operasyon ekipleri web extractor’lardan nasıl faydalanır?
Satış ekipleri çevrimiçi dizinlerden lead listeleri oluşturabilir, pazarlama ekipleri rakip fiyatlarını izleyebilir, operasyon ekipleri ise veri toplama süreçlerini otomatikleştirebilir. Bu araçlar zaman kazandırır, hataları azaltır ve stratejik kararlar için taze ve güvenilir içgörüler sunar.
4. Bir web extractor aracı seçerken nelere dikkat etmeliyim?
Önemli kriterler arasında kullanım kolaylığı, AI yetenekleri, otomasyon/zamanlama özellikleri, Google Sheets veya Airtable gibi araçlarla entegrasyon, ölçeklenebilirlik ve kullanım senaryonuza uygunluk (ör. lead toplama, fiyat izleme, içerik arşivleme) yer alır.
5. Ücretsiz veya düşük maliyetli web extractor araçları var mı?
Evet, birçok web extractor ücretsiz planlar veya uygun fiyatlı paketler sunar. Instant Data Scraper temel ihtiyaçlar için tamamen ücretsizdir; Thunderbit, Simplescraper ve Data Miner gibi araçlar da ihtiyaç oldukça yükseltme yapılabilen cömert ücretsiz planlar sunar.
Web extracting, AI scraping veya web sitelerini ekibinizin bir sonraki büyük avantajına dönüştürme hakkında daha fazla bilgi mi istiyorsunuz? Veri otomasyonunun ön saflarından daha fazla rehber, ipucu ve gerçek dünya hikâyesi için Thunderbit Blog sayfasına göz atın.
Thunderbit AI Web Extractor’ı Deneyin Get Started Free



