
Web, benim kahve bağımlılığımdan bile daha hızlı büyüyor, ki bu gerçekten çok şey ifade ediyor. 2026'ya geldiğimizde, web'den veri çekme sadece veri meraklılarının niş bir becerisi olmaktan çıkıp, iş zekasının, yapay zeka eğitiminin ve otomasyonun temel taşı haline gelecek. İster pazar trendlerini takip ediyor, ister yeni nesil büyük dil modelinizi (LLM) besliyor, ister rakiplerinizin fiyatlandırmasına ayak uydurmaya çalışıyor olun, gerçek zamanlı, yapılandırılmış web verilerine olan ihtiyaç hiç bu kadar yüksek olmamıştı. Peki bu veri altın madeninin kalbinde ne mi var? Tabii ki Python. Geniş ekosistemi ve kolay sözdizimiyle Python, hızlı tek seferlik betiklerden endüstriyel ölçekli tarayıcılara kadar her şeye güç veren web kazıma için vazgeçilmez bir dil olmaya devam ediyor.
Ancak asıl mesele şu: Doğru Python web kazıma paketlerini seçmek, projenizi ya zirveye taşır ya da dibe batırır. Ekiplerin yanlış araçla anti-bot duvarlarıyla boğuşarak günlerini boşa harcadığını veya daha akıllı bir kütüphanenin dakikalar içinde halledebileceği dağınık HTML'yi ayrıştırmak için saatler harcadığını gördüm. Bu yüzden, SaaS, otomasyon ve yapay zeka alanında yıllar geçiren (ve herkes için kazımayı kolaylaştırmak amacıyla Thunderbit’i kuran) biri olarak, 2026 için en iyi 12 Python web kazıma paketini bir araya getirdim. Her birinin kendine özgü güçlü yönleri, incelikleri ve ideal kullanım senaryoları var. Haydi dalalım ve bir sonraki veri maceranız için mükemmel eşleşmeyi bulalım.
Doğru Python Web Kazıma Paketleri Neden Bu Kadar Önemli?
Yapay Zeka Kullanarak Herhangi Bir Web Sitesinden Veri Kazıyın Get Started Free
Dürüst olalım: tüm web kazıma projeleri eşit yaratılmamıştır. Bazen sadece statik bir sayfadan birkaç ürün fiyatı almanız gerekir. Diğer zamanlarda ise, banyo zamanında bir kediden daha inatçı olan JavaScript ağırlıklı bir siteyle uğraşırsınız. Doğru paket, size saatler (hatta günler) kazandırabilir, hataları azaltabilir ve anti-bot engelleri veya bozuk HTML gibi yaygın tuzaklardan kaçınmanıza yardımcı olabilir.
Python'ın web kazımadaki popülaritesi sadece bir abartı değil. requests ve urllib3 gibi kütüphaneler ayda 1 milyardan fazla indirme görüyor ve neredeyse her büyük kazıma aracı Python önceliklidir. Ancak büyük güçle birlikte büyük sorumluluk da gelir: yanlış aracı seçerseniz, kendinizi çevirmeli ağdan daha yavaş bir projede sıkışmış bulabilirsiniz. Akıllıca seçin ve kahveniz soğumadan temiz, yapılandırılmış verilere boğulacaksınız.
En İyi Python Web Kazıma Paketlerini Nasıl Seçtik?
Sadece bir PyPI tablosuna dart atmadım. Her paketi nasıl değerlendirdiğimi aşağıda bulabilirsiniz:
- Performans ve Eşzamanlılık: Yüzlerce (veya binlerce) sayfayı hızlı bir şekilde getirebilir mi?
- Kullanım Kolaylığı: Başlangıç dostu mu, yoksa bilgisayar bilimleri alanında doktora gerektiriyor mu?
- HTML Ayrıştırma Gücü: Bozuk işaretlemeyi işleyebilir mi, XPath/CSS seçicilerini destekliyor mu ve veri çıkarmayı zahmetsiz hale getiriyor mu?
- Dinamik İçerik Desteği: JavaScript ağırlıklı sitelerle başa çıkabilir mi, yoksa sadece statik sayfalar için mi?
- Topluluk ve Dokümantasyon: Gelişen bir kullanıcı tabanı ve sağlam belgeler var mı, yoksa Stack Overflow arafında mı sıkışıp kalacaksınız?
- En İyi Kullanım Durumu: Hızlı betikler, büyük ölçekli tarayıcılar veya ikisi arasında bir şey için mi?
Ayrıca gerçek dünya geliştirici geri bildirimlerini, son karşılaştırmaları ve alandaki kendi (bazen acı verici) deneyimlerimi de göz önünde bulundurdum. Şimdi, rakiplerle tanışalım.
1. Thunderbit
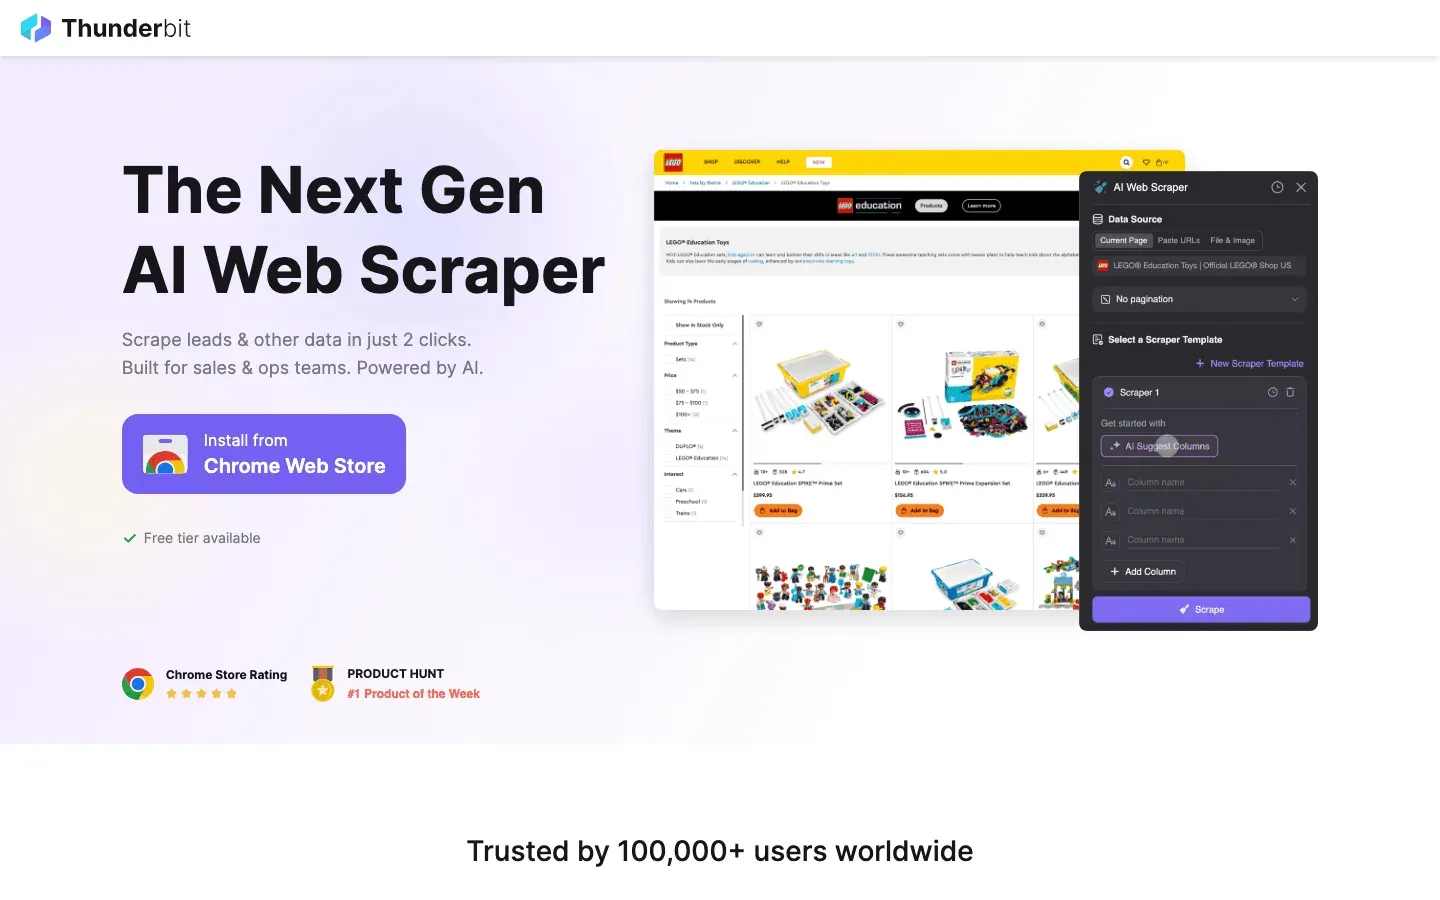
Thunderbit, tipik bir Python kütüphanesi değildir; web kazıma için, özellikle hız, doğruluk ve yapay zeka dokunuşu isteyen Python geliştiricileri için oyunu değiştiren yapay zeka destekli bir Chrome uzantısıdır. Thunderbit'i öne çıkaran nedir? Yapay zekaya hangi verileri istediğinizi doğal dil talimatlarıyla söylemenizi sağlar ve ardından her şeyi halleder: alan önerileri, alt sayfa navigasyonu, sayfalama ve hatta Excel, Google E-Tablolar, Notion veya Airtable'a dışa aktarma.
Thunderbit, karmaşık, yapılandırılmamış verileri kazımak için bir cankurtarandır; dağınık dizinler, ürün listeleri veya HTML'nin “yapılandırılmış belge”den çok “soyut sanat” olduğu siteler gibi. AI Alan Önerileri özelliği, sayfayı okur ve en iyi sütunları önerirken, Alt Sayfa Kazıma otomatik olarak bağlantılı detay sayfalarını ziyaret ederek veri kümenizi zenginleştirmenizi sağlar. Ve anti-bot baş ağrılarından sıkıldıysanız, Thunderbit'in tarayıcı tabanlı ve bulut kazıma seçenekleri sizi korur.
Python geliştiricileri, hızlı prototipleme, potansiyel müşteri oluşturma ve pazar araştırması için Thunderbit'i sever. Çıktısını doğrudan Python veri hattınızda kullanabilir veya API'si ile kazıma iş akışlarını otomatikleştirebilirsiniz. Geleneksel bir kod kütüphanesi değildir, ancak daha az kodlama ve daha fazla veri analizi yapmak isteyen herkes için hızla favori haline gelmektedir.
Temel Özellikler:
- Yapay zeka destekli alan önerisi ve veri çıkarma
- Alt sayfaları, sayfalama ve hatta PDF'leri/görselleri işler
- CSV, Excel, Google E-Tablolar, Notion, Airtable'a dışa aktarır
- Kodlama gerektirmez; hem teknik olmayan kullanıcılar hem de hızlı hareket etmek isteyen Python profesyonelleri için mükemmeldir
- Ücretsiz katman mevcuttur; ücretli planlar ihtiyaçlarınıza göre ölçeklenir
En İyisi: Potansiyel müşteri oluşturma, pazar araştırması, hızlı prototipleme ve karmaşık veya dağınık web verilerini kazıma.
Thunderbit AI Web Scraper'ı Ücretsiz Deneyin
2. Beautiful Soup
Beautiful Soup, Python'daki HTML ayrıştırmanın OG'sidir. Yeni başlıyorsanız veya statik web sayfalarından veri çıkarmanız gerekiyorsa, bu sizin en iyi arkadaşınızdır. Beautiful Soup, kötü yapılandırılmış HTML'yi ("etiket çorbası") gezinme ve ayrıştırmada mükemmeldir, kurallara uymayan siteleri kazımak için bir cankurtarandır.
API, başlangıç dostudur; .find(), .select() ve .text gibi düşünün; ve web sayfalarını getirmek için requests ile mükemmel bir şekilde eşleşir. Altında, farklı ayrıştırıcılar (hız için lxml veya maksimum uyumluluk için html5lib gibi) seçebilirsiniz. Dokümantasyon birinci sınıftır ve topluluk çok büyüktür.
Temel Özellikler:
- HTML/XML'de gezinmek için sezgisel, Pythonik API
- Bozuk veya tutarsız işaretlemeyi sorunsuz bir şekilde işler
- Hız veya uyumluluk için birden fazla ayrıştırıcı ile çalışır
- Büyük topluluk ve tonlarca eğitim
En İyisi: Hızlı betikler, statik sayfa kazıma ve nazik bir öğrenme eğrisi isteyen yeni başlayanlar.
Beautiful Soup hakkında daha fazla bilgi edinin
3. Scrapy
Scrapy, büyük ölçekli, otomatik web taraması için ağır sıklet şampiyonudur. Yüzlerce veya binlerce sayfayı kazımanız, işlem hatlarını yönetmeniz veya tekrarlayan işleri planlamanız gerekiyorsa, Scrapy çoğu ekibin tercih ettiği çerçevedir. Hala altında bir Twisted reaktörü çalışır, ancak 2.14 sürümünden itibaren asenkron iç yapısının büyük bir kısmı yerel asyncio korutinleri olarak yeniden yazıldı ve artık modern Python asenkron ekosisteminin geri kalanıyla uyumlu AsyncCrawlerProcess / AsyncCrawlerRunner giriş noktaları bulunmaktadır. Hızlıdır, eşzamanlı taramayı, veri temizleme için öğe işlem hatlarını destekler ve JSON, CSV veya veritabanlarına dışa aktarır.
Scrapy, proxy'ler, önbelleğe alma ve hatta sınırlı JavaScript oluşturma (Splash veya Selenium entegrasyonu aracılığıyla) için eklentilerle genişletilebilir. Öğrenme eğrisi Beautiful Soup'tan daha diktir, ancak büyük ölçekte web verileri konusunda ciddiyseniz, Scrapy'ye geçiş yaparsınız.
Temel Özellikler:
- Twisted reaktörü + yerel
asynciokorutinleri (Scrapy 2.14+, Python 3.10+) aracılığıyla asenkron tarama - Veri temizleme ve depolama için yerleşik işlem hatları
- Birden fazla formata dışa aktarma (JSON, CSV, DB)
- Büyük, aktif topluluk ve eklenti ekosistemi
En İyisi: Büyük ölçekli, tekrarlayan kazıma projeleri, veri işlem hatları ve hız ile güvenilirlik isteyen herkes.
4. Selenium
Selenium, JavaScript ağırlıklı veya etkileşimli siteleri kazımak için vazgeçilmez bir araçtır. Gerçek tarayıcıları (Chrome, Firefox vb.) otomatikleştirir, tıklamalar, kaydırma ve form gönderme gibi kullanıcı eylemlerini simüle etmenizi sağlar. İhtiyacınız olan veriler yalnızca JavaScript çalıştıktan sonra görünüyorsa, Selenium bunu alabilir; site ne kadar inatçı olursa olsun.
Dezavantajı mı? Selenium yavaş ve kaynak yoğundur. Her kazıma için tam bir tarayıcı çalıştırıyorsunuz, bu yüzden dakikada binlerce sayfa işlemeyi beklemeyin. Ancak "başka hiçbir aracın yapamayacağı" senaryolar için Selenium bir cankurtarandır.
Temel Özellikler:
- Tam tarayıcı otomasyonu (Chrome, Firefox, Edge vb. destekler)
- JavaScript tarafından oluşturulan içeriği ve etkileşimli öğeleri işler
- Daha hızlı, UI'siz kazıma için başsız modu destekler
- Büyük topluluk ve kapsamlı dokümantasyon
En İyisi: Dinamik, JavaScript ağırlıklı siteleri kazıma, oturum açma akışlarını otomatikleştirme ve CAPTCHA'ları veya karmaşık kullanıcı etkileşimlerini işleme.
Selenium'un güçlü ve zayıf yönleri hakkında daha fazla bilgi edinin
5. PyQuery
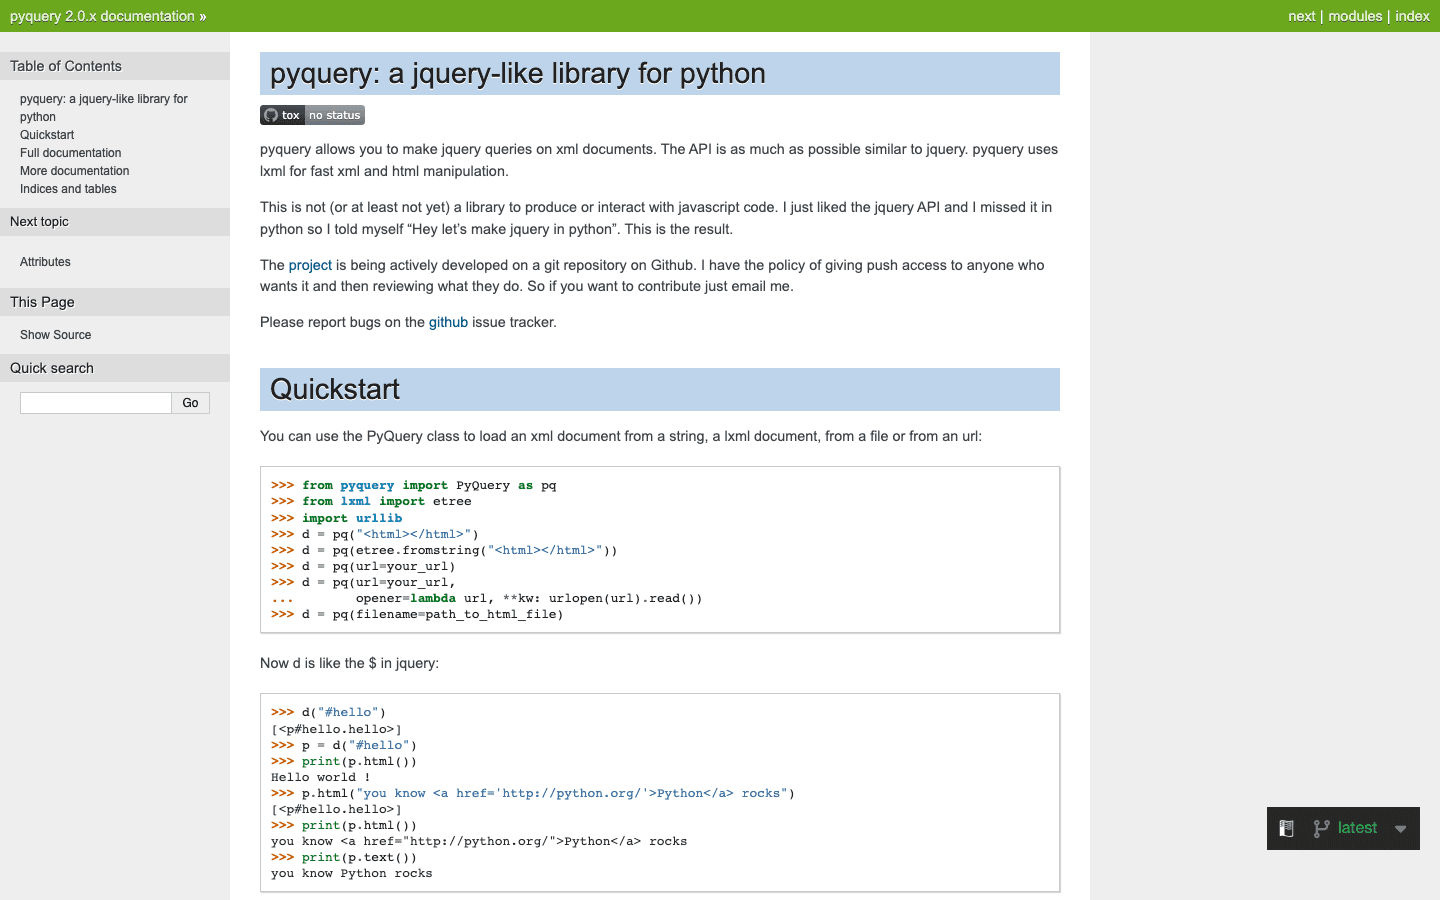
PyQuery, Python'a jQuery tarzı sözdizimi getirerek, JavaScript'te jQuery ile çalışmış herkese HTML ayrıştırmayı tanıdık hissettirir. Hızlı lxml ayrıştırıcısını sarar ve öğeleri bulmak için $('div.classname') gibi CSS seçicilerini kullanmanıza olanak tanır.
PyQuery, hızlı prototipleme ve özlü, okunabilir kod yazmak isteyen geliştiriciler için harikadır. Karmaşık sorgular için Beautiful Soup'tan daha hızlıdır ve daha gelişmiş iş akışları için asenkron araçlar veya Selenium ile kolayca entegre olur.
Temel Özellikler:
- Python'da jQuery benzeri seçiciler ve sözdizimi
- lxml arka ucu ile hızlı ayrıştırma
- JavaScript'ten geçiş yapan geliştiriciler için harika
- Zincirleme ve özlü sorguları destekler
En İyisi: Prototipleme, jQuery hayranları ve HTML ayrıştırma için daha az kod yazmak isteyen herkes.
PyQuery eğitimi ve karşılaştırması
6. LXML
LXML, Python'daki HTML ve XML ayrıştırmanın hız canavarıdır. C kütüphaneleri libxml2 ve libxslt üzerine inşa edilmiş olup, performansı ve XPath ile CSS seçicileri için güçlü desteğiyle tanınır. Büyük belgelerle uğraşıyorsanız veya karmaşık sorgular çalıştırmanız gerekiyorsa, lxml en iyi seçeneğinizdir.
Doğrudan kullanılabilir veya Beautiful Soup veya PyQuery için arka uç olarak kullanılabilir. API biraz daha gelişmiştir, ancak büyük işler için hız ve esneklik buna değerdir.
Temel Özellikler:
- Python'da mevcut en hızlı ayrıştırma
- XPath ve CSS seçicileri için tam destek
- Büyük ve karmaşık belgeleri verimli bir şekilde işler
- Bağımsız olarak veya diğer kütüphaneler için ayrıştırıcı olarak kullanılabilir
En İyisi: Yüksek performanslı ayrıştırma, büyük ölçekli kazıma ve gelişmiş sorgulama gerektiren projeler.
lxml'nin ayrıştırma için neden öne çıktığı
7. Requests
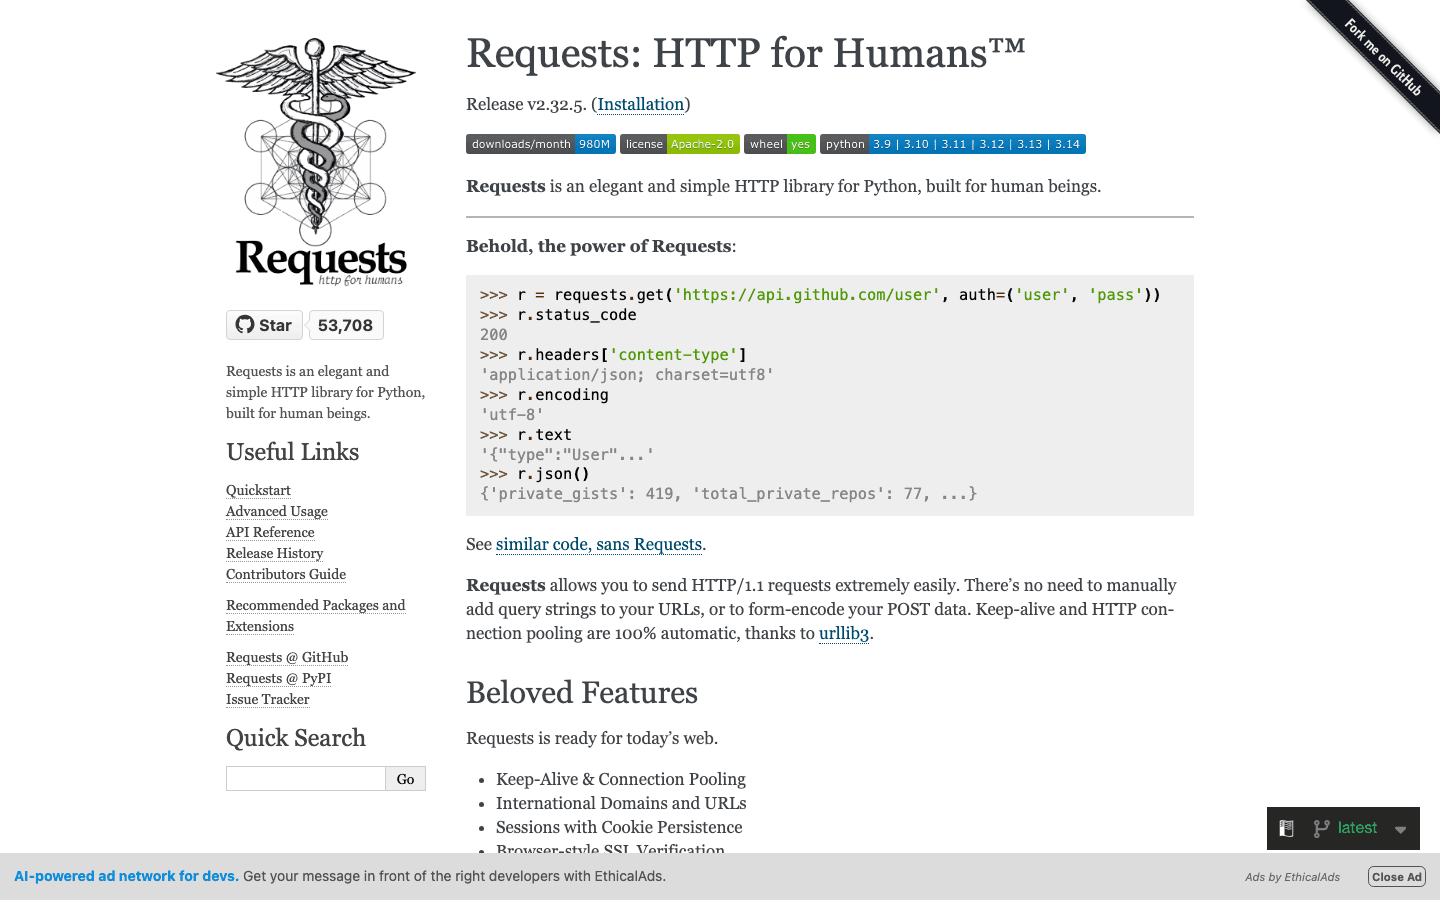
Requests, Python'da HTTP istekleri yapmak için fiili standarttır. Temiz, sezgisel API'si, web sayfalarını requests.get(url) kadar kolay hale getirir. Çerezleri, oturumları ve hatta JSON kod çözmeyi kutudan çıktığı gibi işler.
Requests senkron olsa da (her istek tamamlanmayı bekler), hızlı betikler ve küçük ölçekli kazıma için mükemmeldir. Klasik bir kazıma iş akışı için Beautiful Soup veya lxml ile eşleştirin.
Temel Özellikler:
- HTTP istekleri için basit, Pythonik API
- Çerezleri, oturumları ve yönlendirmeleri işler
- Ayrıştırma kütüphaneleriyle sorunsuz bir şekilde entegre olur
- Büyük topluluk ve dokümantasyon
En İyisi: Basit betikler, statik sayfa kazıma ve hızlı başlamak isteyen yeni başlayanlar.
Requests'in neden bu kadar popüler olduğunu görün
8. MechanicalSoup
MechanicalSoup, tam bir tarayıcı başlatmadan basit tarayıcı etkileşimlerini – form doldurma veya çok adımlı oturum açma akışlarında gezinme gibi – otomatikleştiren hafif bir kütüphanedir. requests ve Beautiful Soup'u sarar, bu da onu JavaScript'e yoğun bir şekilde dayanmayan siteler için Selenium'dan çok daha hızlı ve hafif hale getirir.
Oturum açmanız, form göndermeniz veya birkaç sayfayı tıklamanız gerekiyorsa (ve site çok dinamik değilse), MechanicalSoup harika bir orta yoldur.
Temel Özellikler:
- Form doldurma ve navigasyonu otomatikleştirir
- Requests ve Beautiful Soup üzerine inşa edilmiştir
- Hafif ve hızlı (tarayıcı yükü yok)
- Orta düzeyde etkileşim için kullanımı kolay
En İyisi: Oturum açma veya form gönderme gerektiren siteler, basit otomasyon görevleri ve Selenium'un yükünden kaçınmak isteyen herkes.
MechanicalSoup eğitimi
9. Aiohttp
Aiohttp, yüksek hızlı, eşzamanlı web istekleri için asenkron güç merkezidir. Yüzlerce sayfayı hızlı bir şekilde kazımanız gerekiyorsa, aiohttp istekleri paralel olarak göndermenizi sağlayarak toplam çalışma süresini önemli ölçüde azaltır. Bir karşılaştırmada, 50 sayfalık bir kazıma aiohttp ile sadece 3 saniye sürerken, senkron istekler kullanılarak 16 saniye sürmüştür (performans farkını görün).
Aiohttp, async def kodu yazmayı ve await kullanmayı gerektirir, ancak büyük ölçekli işler için hız kazanımları buna değerdir.
Temel Özellikler:
- Asenkron HTTP istemci/sunucu çerçevesi
- Oturumları, çerezleri ve HTTP/2'yi destekler
- Eşzamanlı istekler için büyük hız artışı
- Asenkron ayrıştırma kütüphaneleriyle entegre olur
En İyisi: Yüksek hızlı, büyük ölçekli kazıma, API toplama ve asenkron programlamaya aşina olan herkes.
10. Twisted
Twisted, Scrapy'ye güç veren olay odaklı ağ motorudur. Kendi başına bir kazıma kütüphanesi olmasa da, gelişmiş kullanıcılar özel tarayıcılar oluşturmak, HTTP dışı protokolleri işlemek veya hiper-eşzamanlı örümcekler uygulamak için Twisted'ı doğrudan kullanabilirler.
Twisted güçlüdür ancak dik bir öğrenme eğrisi ile gelir. Son derece özel senaryolar veya sıfırdan çerçeveler oluştururken en iyisidir.
Temel Özellikler:
- HTTP, WebSockets, SSH ve daha fazlası için olay odaklı ağ iletişimi
- SSL, eşzamanlılık ve özel protokolleri destekler
- Scrapy'nin asenkron motorunun temelini oluşturur
- Gelişmiş kullanım durumları için son derece esnek
En İyisi: Özel protokoller, kazıma çerçeveleri oluşturma ve maksimum kontrol isteyen gelişmiş kullanıcılar.
11. Grab
Grab, HTTP isteklerini, ayrıştırmayı, otomasyonu, proxy rotasyonunu ve CAPTCHA işlemeyi birleştiren hepsi bir arada bir kazıma araç setidir. Scrapy'ye benzer bir ruha sahiptir ancak proxy'ler, önbelleğe alma ve asenkron örümcekler için yerleşik destekle öğrenmesi ve kullanması daha kolay olmayı hedefler.
Grab'ın öne çıkan özelliği, multicurl kullanarak binlerce isteği paralel olarak çalıştırabilen Grab:Spider sistemidir. Scrapy'den daha az kurulumla hepsi bir arada bir çözüme ihtiyacınız varsa, Grab'a bir göz atmaya değer.
Temel Özellikler:
- Proxy'ler, kullanıcı aracısı rotasyonu ve önbelleğe alma için yerleşik destek
- Yüksek eşzamanlılık için asenkron örümcek sistemi
- XPath ayrıştırma ve modüler mimari
- Büyük ölçekli kazıma için üretimde kullanılır
En İyisi: Hepsi bir arada kazıma projeleri, proxy ağırlıklı görevler ve Scrapy'nin karmaşıklığı olmadan güç isteyen kullanıcılar.
12. Urllib3
Urllib3, Requests dahil birçok Python istemcisine güç veren düşük seviyeli HTTP motorudur. Bağlantı havuzu, iş parçacığı güvenliği, yeniden denemeler ve HTTP bağlantıları üzerinde ince ayar kontrolü sunar. Çoğu geliştirici bunu dolaylı olarak kullanırken, urllib3 maksimum performans veya daha yüksek seviyeli kütüphaneler oluşturmanız gerektiğinde başvuracağınız yerdir.
Requests kadar başlangıç dostu değildir, ancak savaşta test edilmiş ve son derece güvenilirdir.
Temel Özellikler:
- Bağlantı havuzu ve iş parçacığı güvenliği
- HTTP bağlantıları üzerinde ince kontrol
- Birçok diğer kütüphane için temel olarak kullanılır
- Tekrarlanan istekler için yüksek performans
En İyisi: Özel HTTP istemcileri, çok iş parçacıklı tarayıcılar ve Python HTTP yığını üzerine inşa eden geliştiriciler.
urllib3'ün kazımadaki rolünü görün
Karşılaştırma Tablosu: Python Web Kazıma Paketlerine Bir Bakış
| Paket | Kullanım Kolaylığı | Performans | Dinamik İçerik | Ayrıştırma Gücü | Topluluk/Belgeler | En İyisi |
|---|---|---|---|---|---|---|
| Thunderbit | ★★★★☆ (GUI/AI) | Hızlı (bulut/yerel) | Evet (AI aracılığıyla) | Otomatik alanlar, alt sayfa | Büyüyen (AI trendi) | Potansiyel müşteri oluşturma, pazar araştırması, kodsuz kullanıcılar |
| Beautiful Soup | ★★★★★ (kolay) | Orta | Hayır | HTML/XML, hoşgörülü | Büyük | Statik sayfalar, yeni başlayanlar |
| Scrapy | ★★☆☆☆ (dik) | ★★★★★ (çok yüksek) | Yalnızca eklentiler | CSS/XPath, işlem hatları | Büyük, aktif | Büyük ölçekli, tekrarlayan kazıma |
| Selenium | ★★☆☆☆ (orta) | ★☆☆☆☆ (yavaş) | Evet (tam) | Tam DOM, JS | Olgun | JS ağırlıklı, etkileşimli siteler |
| PyQuery | ★★★★☆ (jQuery) | Hızlı (lxml) | Hayır* | jQuery seçicileri | Orta | Prototipleme, jQuery geliştiricileri |
| LXML | ★★★☆☆ (gelişmiş) | ★★★★★ (en hızlı) | Hayır | XPath/CSS, XML | Orta | Büyük belgeler, gelişmiş sorgular |
| Requests | ★★★★★ (çok kolay) | ★★☆☆☆ (senkron) | Hayır | HTTP, JSON | Büyük | Basit betikler, statik sayfalar |
| MechanicalSoup | ★★★★☆ (kolay) | ★★☆☆☆ (senkron) | Hayır | Formlar, navigasyon | Küçük | Oturum açma akışları, form otomasyonu |
| Aiohttp | ★★☆☆☆ (asenkron) | ★★★★★ (eşzamanlı) | Hayır | Asenkron HTTP | Büyük (asenkron) | Yüksek hızlı, eşzamanlı kazıma |
| Twisted | ★☆☆☆☆ (karmaşık) | ★★★★★ (özel) | Hayır | Ağ iletişimi, protokoller | Niş | Özel çerçeveler, gelişmiş kullanıcılar |
| Grab | ★★★☆☆ (modüler) | ★★★★☆ (asenkron) | Hayır | Proxy'ler, XPath | Küçük | Hepsi bir arada, proxy/captcha ağırlıklı |
| Urllib3 | ★★★★☆ (düşük seviye) | ★★★★☆ (havuzlu) | Hayır | HTTP, havuzlama | Büyük | Özel istemciler, çok iş parçacıklı tarayıcılar |
*PyQuery, dinamik siteler için Selenium ile birleştirilebilir.
İhtiyaçlarınız İçin Doğru Python Web Kazıma Paketini Nasıl Seçersiniz?
Veri Kazıma Nedir ve 2026'da Nasıl Yapılır? Get Started Free
Peki, hangi paketi seçmelisiniz? İşte benim kopya kağıdım:
- Statik sayfalar, küçük işler veya kazımaya yeni başlıyorsanız: Requests + Beautiful Soup ile başlayın.
- Büyük ölçekli, tekrarlayan veya üretim kazıma: Scrapy veya Grab (hepsi bir arada ihtiyaçlar için).
- JavaScript ağırlıklı veya etkileşimli siteler: Selenium (veya yapay zeka destekli, kodsuz kazıma istiyorsanız Thunderbit).
- Yüksek hızlı, eşzamanlı kazıma: Aiohttp (asenkron konusunda rahatsanız).
- Form otomasyonu veya oturum açma akışları: MechanicalSoup (basit siteler için), Selenium (karmaşık JS için).
- Gelişmiş ayrıştırma veya büyük belgeler: LXML veya PyQuery.
- Özel ağ iletişimi veya protokol çalışması: Twisted.
- Hızlı prototipleme, potansiyel müşteri oluşturma veya dağınık/yapılandırılmamış veriler: Thunderbit.
Ve karıştırmaktan ve eşleştirmekten korkmayın; birçok iş akışı maksimum verimlilik için bu araçları birleştirir. Örneğin, bir sayfayı oluşturmak için Selenium'u kullanabilir, ardından HTML'yi ayrıştırma için Beautiful Soup veya PyQuery'ye geçirebilirsiniz.
Sonuç: Doğru Python Araçlarıyla Web Kazımanızı Süper Şarj Edin
2026'da web kazıma, her zamankinden daha güçlü ve daha gerekli. Doğru Python web kazıma paketleriyle, web'in kaosunu işiniz, araştırmanız veya bir sonraki büyük fikriniz için temiz, eyleme geçirilebilir verilere dönüştürebilirsiniz. İster deneyimli bir geliştirici olun, ister veri havuzuna yeni dalıyor olun, bu listede ihtiyaçlarınıza uygun bir araç var.
Yapay zeka destekli, kodsuz kazımanın nasıl göründüğünü görmek isterseniz, Thunderbit'i deneyin. Ve daha fazla ipucu, derinlemesine inceleme ve eğitim için can atıyorsanız, web kazıma, otomasyon ve veri odaklı iş akışlarındaki en son gelişmeler için Thunderbit Blog'a göz atın.
Thunderbit AI Web Scraper'ı Ücretsiz Deneyin
Mutlu kazımalar; ve seçicileriniz her zaman eşleşsin, proxy'leriniz asla başarısız olmasın ve verileriniz kodunuz kadar temiz olsun.
Sıkça Sorulan Sorular
1. Yeni başlayanlar için en iyi Python web kazıma paketi hangisidir? Çoğu yeni başlayan için, Requests ve Beautiful Soup kombinasyonu başlamanın en kolay yoludur. Her ikisi de sezgisel API'lere, tonlarca eğitime sahiptir ve çoğu statik sayfa kazıma görevini halleder.
2. Python ile JavaScript ağırlıklı web sitelerini nasıl kazırım? Gerçek bir tarayıcıyı otomatikleştirmek için Selenium kullanın veya dinamik içeriği işleyebilen yapay zeka destekli, kodsuz kazıma için Thunderbit'i deneyin. Büyük ölçekli ihtiyaçlar için Scrapy, Splash veya Selenium ile birleştirilebilir.
3. Büyük ölçekli, yüksek hızlı kazıma için hangi paket en iyisidir? Scrapy, büyük ölçekli, asenkron tarama için inşa edilmiştir. Daha da fazla hıza ihtiyacınız varsa ve asenkron koda aşina iseniz, aiohttp eşzamanlı istekler için en iyi seçimdir.
4. Bu paketleri iş akışımda birleştirebilir miyim? Kesinlikle! Birçok geliştirici, sayfaları getirmek için Requests veya Selenium'u kullanır, ardından Beautiful Soup, lxml veya PyQuery ile ayrıştırır. Thunderbit'in dışa aktarımları, daha fazla analiz için Python betiklerine beslenebilir.
5. Thunderbit bir Python kütüphanesi mi yoksa bağımsız bir araç mı? Thunderbit, geleneksel bir Python kütüphanesi değil, yapay zeka destekli bir Chrome uzantısı ve platformudur. Ancak, çıktısı (CSV, Excel, E-Tablolar, Notion, Airtable) Python veri işlem hatlarına sorunsuz bir şekilde entegre olur ve bu da onu Python geliştiricileri için güçlü bir yardımcı yapar.
6. Yapay zeka kodlama ajanları 2026'da Python kazıma kütüphanelerinin yerini alıyor mu? Henüz değil, ancak onları bilmeye değer. Claude Code ve OpenAI Codex gibi araçlar, saniyeler içinde düz İngilizce bir istemden çalışan bir Requests + Beautiful Soup veya Scrapy betiği oluşturabilir, bu da tek seferlik işler ve prototipleme için gerçekten kullanışlıdır. Doğal dil tarayıcı akışları (oturum açma, dinamik JS, çok adımlı navigasyon) için, Browser Use insanların başvurduğu açık kaynak seçeneğidir ve Firecrawl, amaç temiz markdown'ı bir LLM'ye beslemek olduğunda popülerdir. Bunların hiçbiri zor kısımları ortadan kaldırmaz; anti-bot savunmaları, hız sınırları ve TOS hala geçerlidir; ve büyük ölçekli üretim tarayıcıları için Scrapy + aiohttp hala maliyet ve kontrol açısından kazanır. Yapay zeka ajanlarını, kazıyıcıyı yazmanın daha hızlı bir yolu olarak görün, bu listedeki kütüphanelerin yerine geçen bir şey olarak değil.
Web kazıma dünyasında önde olmak ister misiniz? Thunderbit YouTube Kanalı'na abone olun ve daha fazla rehber, karşılaştırma ve otomasyon ipucu için Thunderbit Blog'u takip edin.
Thunderbit AI Web Scraper'ı Ücretsiz Deneyin Get Started Free
Daha Fazla Bilgi Edinin




