
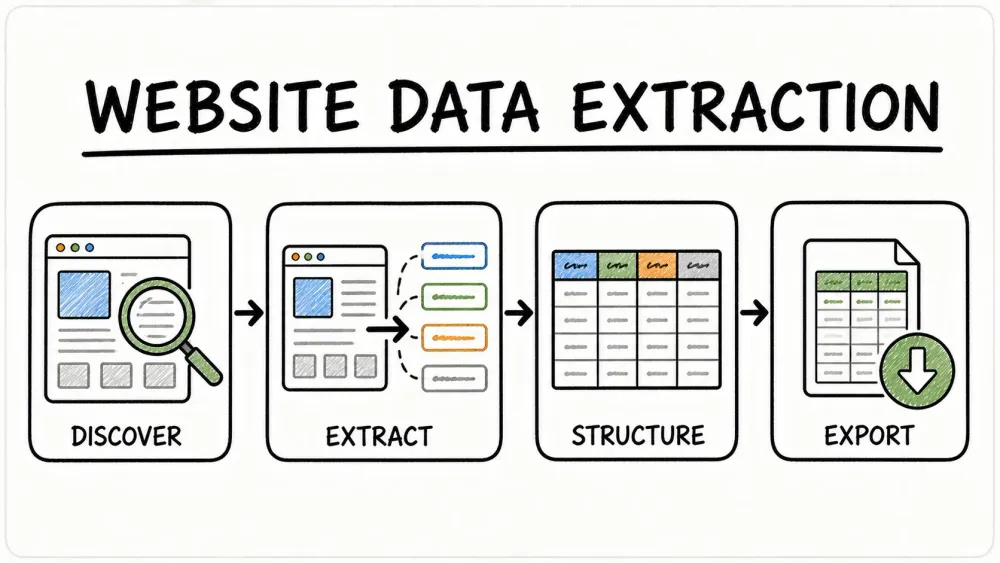
İnternet bilgiyle kaynıyor; asıl mesele bu karmaşayı gerçekten işe yarar iş verisine çevirmek. İşte tam da burada hem büyük fırsat hem de ciddi zorluk ortaya çıkıyor. SaaS ve otomasyon araçları geliştirdiğim yıllar boyunca, dünyanın karar alma biçiminin sezgiden veri temelli yaklaşıma doğru nasıl evrildiğini birebir gördüm. Artık yalnızca teknoloji devleri değil; küçük ekipler bile satış, pazarlama, fiyatlandırma ve ürün kararlarını desteklemek için web sitesi verilerini çekmeye hızla yöneliyor. Ama web büyüdükçe daha da dağınık ve dinamik bir hâl alıyor; buradan temiz, uyumlu ve gerçekten kullanılabilir veri çıkarmak artık bambaşka bir iş.
Gelin konuyu pratik bir dille ele alalım: Modern işletmeler için web sitesinden veri çıkarmanın neden bu kadar kritik olduğunu, karşınıza çıkacak en büyük engelleri ve bunu doğru şekilde yapmanız için en iyi uygulamaları — Thunderbit ekibinin sahada öğrendikleri de dâhil — hukuka uygun, verimli ve ölçeklenebilir biçimde anlatacağım. İster yapılandırılmamış içeriklerle uğraşıyor olun, ister GDPR yüzünden temkinli davranın, ister Excel’e kopyala-yapıştır yapmaktan kurtulmak isteyin; bu rehber tam size göre.
Web Sitesinden Veri Çıkarmak Neden Modern İşletmeler İçin Önemli?
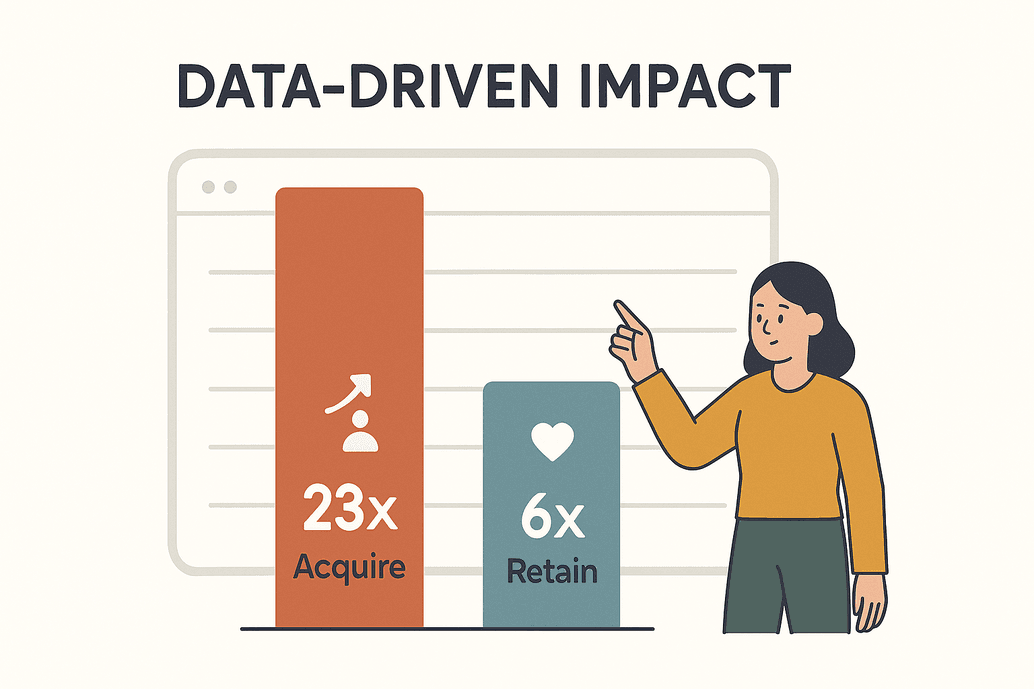 Veri sadece moda bir kelime değil; bugünün rekabetçi iş dünyasının adeta can damarı. McKinsey araştırmasına göre veri odaklı organizasyonların müşteri kazanma olasılığı 23 kat, müşteri elde tutma olasılığı ise 6 kat daha yüksek. Bu sadece etkileyici değil, aynı zamanda hayati. 2025’e gelindiğinde işletmeler analiz, yapay zekâ modelleri ve gerçek zamanlı karar alma süreçlerini beslemek için her gün milyarlarca web sayfasını tarayacak (kanhasoft.com).
Peki bu gerçek hayatta ne anlama geliyor? Her hafta karşıma çıkan birkaç örnek şöyle:
| İş Uygulaması | Açıklama ve Faydalar | Örnek / İstatistik |
|---|---|---|
| Fiyat Takibi | Rakip fiyatlarını, stok durumunu ve kampanyaları gerçek zamanlı izleyin; önde kalmak için stratejinizi güncelleyin. | En büyük çevrimiçi perakendecilerin %80’inden fazlası rakip fiyatlarını her gün tarıyor (kanhasoft.com). |
| Lead Oluşturma | Dizinler, sosyal medya veya inceleme sitelerinden yeni potansiyel müşteriler ve iletişim bilgileri toplayın. | Otomatik veri çıkarma, CRM sistemlerini manuel araştırmadan çok daha hızlı doldurur. |
| Pazar Eğilimi Analizi | Eğilimleri veya duygu değişimlerini erken fark etmek için yorumları, forumları ve haberleri bir araya getirin. | Tarama faaliyetlerinin %26’sı trend içgörüleri için sosyal medyaya odaklanıyor (blog.apify.com). |
| İçerik Toplama | Haberleri, ürün listelerini veya etkinlikleri birden fazla siteden toplayarak kolay erişim sağlayın. | Medya ekipleri, hedef kitleleri için içerik akışlarını derliyor. |
| Ürün ve Araştırma Verileri | Analiz ve geliştirme için ürün detayları, yorumlar veya araştırma verileri toplayın. | Yatırım danışmanlarının %67’si alternatif web verisi kullanıyor (scrap.io). |
| Yapay Zekâ Eğitim Verisi | Yapay zekâ modellerini eğitmek için büyük hacimde metin, görsel veya kayıt çekin. | Büyük yapay zekâ modellerinin yaklaşık %70’i taranmış web verisine dayanıyor (kanhasoft.com). |
Web sitesinden veri çekmiyorsanız, sadece geride kalmış olmuyorsunuz; pazarda görünmez hâle geliyorsunuz. E-ticaret ekiplerinin rakip fiyat taramasını otomatikleştirerek yalnızca altı ay içinde ROI’lerini üç katına çıkardığını gördüm (kanhasoft.com). Kısacası: web verisi stratejik bir varlıktır ve onu doğru şekilde çıkarmak artık temel bir gereklilik.
Herhangi Bir Web Sitesinden Veri Çıkarırken Karşılaşılan Temel Zorluklar
Tabii her şey güllük gülistanlık değil. Web vahşi bir alan ve web sitesinden veri çıkarmanın ciddi zorlukları var:
- Yapılandırılmamış Veri: Çevrimiçi verinin yaklaşık %80’i yapılandırılmamış durumda; dağınık HTML içinde olabilir, sayfalar arasında serpilmiş olabilir ya da etkileşimli öğelerin arkasına saklanmış olabilir. Bunu temiz bir tabloya çevirmek hiç de kolay değildir (scrapingapi.ai).
- Değişen Web Siteleri: Siteler tasarımlarını sürekli güncelliyor. Hedef sitenin tasarımındaki küçük bir değişiklik yüzünden bir tarayıcının yalnızca bir ay içinde 15 kez bozulduğunu gördüm (scrap.io).
- Hacim ve Ölçek: İşletmelerin yüzlerce hatta binlerce sayfadan, çoğu zaman belirli bir takvimle veri çıkarması gerekir. Elle kopyala-yapıştır bu hıza yetişemez.
- Scraping Karşıtı Önlemler: CAPTCHA’lar, hız limitleri, giriş duvarları… Siteler botları engelleme konusunda giderek daha akıllı hâle geliyor. Tüm web trafiğinin artık üçte birinden fazlası botlardan oluşuyor (scrap.io), buna karşı geliştirilen teknolojiler de hızla ilerliyor.
- Manuel Hatalar: İnsan eliyle kopyala-yapıştır yavaş ve hataya açıktır. Tek bir yanlış seçici, yanlış veri çekmenize ya da hiçbir şey alamamanıza neden olabilir.
Geleneksel yöntemler ölçeklenemez. Bu yüzden daha fazla ekip akıllı, otomatik çözümlere yöneliyor; ben de bu yüzden yapay zekâ destekli araçlara fazlasıyla güveniyorum.
Web Sitesi Veri Çıkarma İçin Hukuki, Uyum ve Güvenlik En İyi Uygulamaları
Bunu açıkça söyleyelim: Bir web sitesinden veri çıkarabiliyor olmanız, bunu mutlaka yapmanız gerektiği anlamına gelmez — en azından hukuki ve etik tarafı düşünmeden değil. Her işletmenin bilmesi gerekenler şunlar:
- Herkese Açık vs. Özel Veri: Genel erişime açık bilgileri taramak pek çok yerde genellikle yasaldır. Ancak giriş arkasındaki her şey yasaklı alandır. Kimlik doğrulamayı aşmak kesinlikle kabul edilemez (xbyte.io).
- Kullanım Şartları: Bir sitenin kullanım şartlarını mutlaka kontrol edin. Tarama yasaksa dava riskiyle veya engellenmeyle karşılaşabilirsiniz. Emin değilseniz izin isteyin ya da resmi API’leri kullanın.
- Gizlilik Yasaları (GDPR, CCPA): Kişisel veri topluyorsanız hukuki bir dayanağınız olmalı (örneğin meşru menfaat), yalnızca gerekli minimum veriyi toplamalı ve istenirse veriyi silmeye hazır olmalısınız. Uyumsuzluk ağır para cezaları doğurabilir (xbyte.io).
- robots.txt’ye Saygı Gösterin: Hukuken bağlayıcı olmasa da iyi bir dijital nezakettir. Crawl-delay kurallarına uyun ve sunucuları gereksiz yere zorlamayın.
- Veri Güvenliği: Taranan veriyi hassas kabul edin. Güvenli saklayın, erişimi sınırlayın ve kullanmadan önce temizleyin.
Uyumluluk Kontrol Listesi:
| Değerlendirme Noktası | En İyi Uygulama |
|---|---|
| Hukuka Uygun Erişim | Yalnızca herkese açık veriyi tarayın; giriş engellerini hiçbir zaman aşmayın (xbyte.io). |
| Kullanım Şartları | Sitenin kullanım şartlarını inceleyin ve saygı gösterin; tarama yasaksa API kullanın. |
| Kişisel Veri | Mümkünse kaçının; gerekiyorsa minimumda tutun ve GDPR/CCPA ile uyumlu olun. |
| robots.txt ve Crawl Gecikmeleri | Site kurallarına uyun; istek hızını sınırlayın. |
| Veri Güvenliği | Şifreleyin, erişimi kısıtlayın ve ihtiyaç kalmadığında silin. |
Verimliliği Artırmak: Yapay Zekâ Web Sitesi Veri Çıkarmayı Nasıl Güçlendirir?
İşte işin heyecanlı kısmı burası. Yapay zekâ, web sitesinden veri çıkarma yöntemini tamamen değiştirdi. Seçicilerle boğuşmak ya da kırılgan betikler yazmak yerine, artık sayfayı “okuyan” ve neyin çıkarılacağını kendi anlayan AI destekli araçları kullanabilirsiniz — çoğu zaman yalnızca birkaç tıklamayla.
Bu pratikte ne anlama geliyor?
- Minimum Kurulum: Thunderbit gibi yapay zekâ destekli tarayıcılar alanları otomatik algılayabilir. Sadece “Tek Tıkla Çıkar”a basın; araç doğru sütunları önerir — kod yok, deneme-yanılma yok.
- Uyarlanabilirlik: Yapay zekâ tarayıcılar sabit düzenleri değil, kalıpları tanır. Bir site değiştiğinde çoğu zaman yapay zekâ kendini otomatik olarak uyarlar. Bu da daha az bakım, daha az gece yarısı acil durum demektir.
- Doğruluk: Yapay zekâ, gürültüyü ayıklayabilir, tekrarları kaldırabilir ve tarama sırasında dağınık veriyi temizleyebilir. Bazı ekipler, yapay zekâ tabanlı çıkarıcılarda %99,5’e varan doğruluk oranları rapor ediyor (scrapingapi.ai).
- Dinamik İçerik: Yapay zekâ tarayıcılar JavaScript ağırlıklı siteleri, sonsuz kaydırmayı ve hatta görseller veya PDF’lerden metin çıkarmayı bile yönetebilir.
- Anında İşleme: Tarama yaparken veriyi çevirmek, kategorize etmek veya özetlemek mi istiyorsunuz? Yapay zekâ bunları tek geçişte yapabilir.
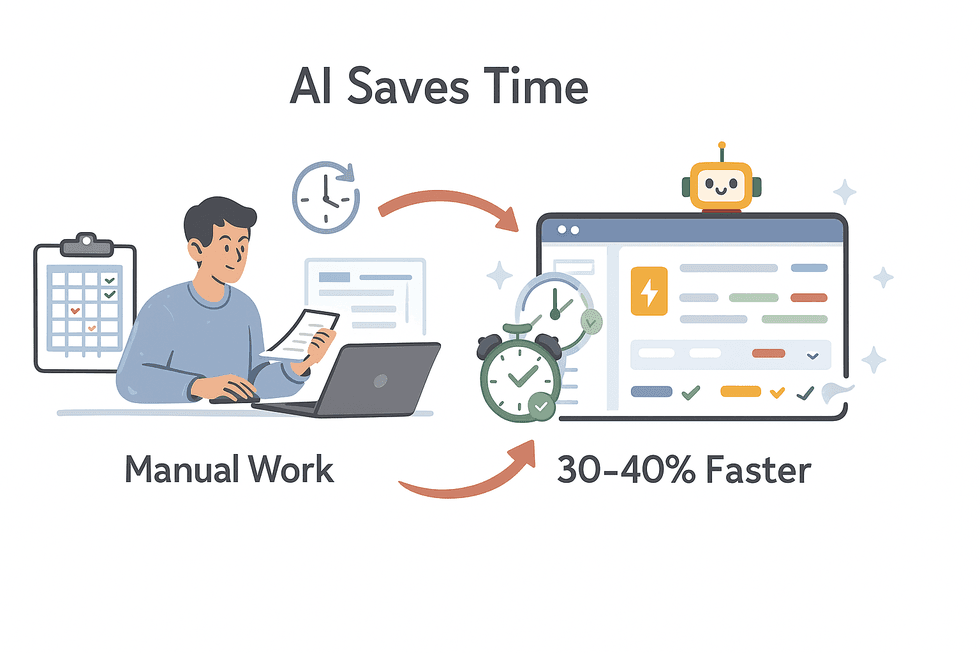 Ekiplerin sırf yapay zekâ destekli araçlara geçerek veri çıkarma süresinin %30–40’ını tasarruf ettiğini gördüm (scrapingapi.ai). Bu sadece verimlilik artışı değil, aynı zamanda rekabet avantajıdır.
Herhangi Bir Web Sitesinden Yapay Zekâ ile Veri Çıkarın Thunderbit'in agentic web scraper'ı herhangi bir web sitesini kendi başına okur ve tek tek tıklayarak çıkarılacak alanları seçer. Get Started Free
Thunderbit, kod yazmamış kişiler için bile veri çıkarmayı kolay, doğru ve erişilebilir hâle getirmeye odaklanıyor. (Evet, annem de kullanabiliyor. Netflix konusunda hâlâ çalışıyor gerçi.)
Thunderbit Agentic Web Scraper: İş Kullanıcıları İçin Temel Özellikler
Thunderbit’te geliştirdiklerimizi biraz övmeme izin verin (sonuçta hakkım var, değil mi?). Thunderbit; satış, operasyon, pazarlama ve emlak gibi alanlarda çalışan, sorun değil sonuç isteyen iş kullanıcıları için tasarlandı. Onu öne çıkaran özellikler şunlar:
- Tek Tıkla Çıkarma: Bir kez tıklayın; Thunderbit’in yapay zekâsı sayfayı tarar, sütunları önerir ve tarayıcıyı sizin için kurar. Seçicilerle uğraşmak yok.
- 2 Tıkta Tarama: Alanlar belirlendikten sonra sadece “Tarama”ya basın ve temiz bir tablo alın — kodlama yok, kurulum yok.
- Alt Sayfa Tarama: Daha fazla ayrıntı mı gerekiyor? Thunderbit, her alt sayfayı (ürün veya profil sayfaları gibi) otomatik ziyaret ederek tablonuzu ek bilgilerle zenginleştirebilir.
- Hazır Şablonlar: Amazon, Zillow, Instagram, Shopify vb. popüler siteler için bir şablon seçip başlayın — kurulum gerektirmez.
- Her Yere Dışa Aktarma: Excel, Google Sheets, Airtable, Notion veya CSV’ye ücretsiz dışa aktarma. Gizli ücret yok.
- Zamanlanmış Tarama: Tekrarlayan taramaları otomatikleştirin — yalnızca aralığı tanımlayın (“her Pazartesi sabah 8’de”) ve gerisini Thunderbit halleder.
- Bulut veya Tarayıcı Üzerinden Tarama: Hız için Thunderbit’in bulut sunucularını kullanın ya da giriş gerektiren siteler için kendi tarayıcınızı kullanın.
- Çok Dilli Destek: İngilizce, İspanyolca, Çince ve daha fazlası dâhil 34 dilde tarama yapın.
Thunderbit Agentic Web Scraper’ı Ücretsiz Deneyin Ücretsiz plan ayda 6 sayfayı kapsar, kredi kartı gerekmez — hedef sitenizde veri çıkarma test etmek için iyi bir başlangıç. Get Started Free
Otomatikleştirin ve Ölçekleyin: Zamanlama ve Entegrasyon Araçlarıyla Veri Çıkarma
Manuel tarama artık 2015’te kaldı. Asıl değer, veri çıkarmayı iş akışlarınıza entegre edip otomatikleştirdiğinizde ortaya çıkar:
- Zamanlanmış Tarama: Thunderbit’i günlük, haftalık veya istediğiniz herhangi bir aralıkta tarama yapacak şekilde ayarlayın. Fiyat takibi, lead oluşturma veya haber toplama için idealdir.
- Doğrudan Entegrasyon: Çekilen veriyi doğrudan Google Sheets, Excel, Airtable veya Notion’a aktarın. Dosya indirip yeniden yüklemeye gerek kalmaz.
- CRM ve Analitik Entegrasyonu: Veriyi CRM veya BI araçlarınıza aktararak gerçek zamanlı panolar, uyarılar veya otomatik erişim süreçleri kurun.
Örnek: Otomatik Fiyat Takip İş Akışı
- Thunderbit’i bir rakibin ürün sayfasına kurun.
- Ürün adı, fiyat ve URL’yi çekmek için “Tek Tıkla Çıkar”ı kullanın.
- Taramayı her sabah 7’de çalışacak şekilde zamanlayın.
- Sonuçları bir panoya bağlı Google Sheets’e aktarın.
- Fiyat yöneticisi değişiklikleri inceler ve rakipler durumu anlamadan stratejiyi günceller.
Otomasyon sayesinde sadece daha hızlı olmazsınız; her zaman güncel kalırsınız.
Web Sitesinden Veri Çıkarırken Yapılandırılmamış Verileri Yönetmenin En İyi Yolları
Gerçekçi olalım: Web verisinin çoğu düzenli ve tertipli değildir. Yapılandırılmamış, tutarsız ve bazen de tam anlamıyla gariptir. İşte onu şekle sokmanın yolları:
- Yapıyı Yapay Zekâya Belirletin: Tek Tıkla Çıkarma veya bir şablon kullanarak düzeni dayatın — yapay zekâ sütunları ve veri türlerini çözer, siz de gerekirse sonradan düzeltirsiniz.
- Alan Bazlı AI Komutları: Thunderbit, her alan için özel talimat eklemenize izin verir. Ürünleri kategorize etmek, telefon numaralarını biçimlendirmek veya açıklamaları çevirmek mi istiyorsunuz? Yapay zekâya ne istediğinizi söylemeniz yeterli.
- NLP’den Yararlanın: Yorumlar, kullanıcı mesajları veya makaleler için yerleşik NLP özellikleriyle özetleme, duygu analizi veya anahtar kelime çıkarımı yapın.
- Veriyi Normalize Edin: Tarihleri, fiyatları ve telefon numaralarını sonradan değil, tarama sırasında standartlaştırın. Tutarlılık çok önemlidir.
- Tekrarları Kaldırın ve Doğrulayın: Yinelenen kayıtları temizleyin ve sonuçları örnekleme yoluyla kontrol edin. Bir şeyler ters görünüyorsa prompt’ları veya ayarları değiştirin.
Alan Bazlı AI Komutları: Daha İyi Sonuçlar İçin Veri Çıkarmayı Özelleştirme
Bu, en sevdiğim özelliklerden biri. Alan düzeyinde AI komutlarıyla şunları yapabilirsiniz:
- Etiketleyin ve Kategorize Edin: “Bu ürünü açıklamasına göre Elektronik, Mobilya veya Giyim olarak sınıflandır.”
- Formatları Zorlayın: “Tarihi YYYY-AA-GG formatında çıktı ver.” “Sadece sayısal fiyatı çıkar.”
- Anında Çevirin: “Ürün açıklamasını Türkçeye çevir.”
- Gürültüyü Temizleyin: “Kullanıcı biyografisini, ‘Devamını oku’ bağlantılarını veya reklamları yok sayarak çıkar.”
- Alanları Birleştirin: “Adres satırlarını tek bir alanda birleştir.”
Bu, tarayıcınızın içine yerleştirilmiş genç bir analiste sahip olmak gibi; hem de kahve molalarından hiç şikâyet etmeyen birine.
Web Sitesi Veri Çıkarmada Veri Kalitesi ve Tutarlılığı Nasıl Sağlanır?
Harika bir veri çıkarma işi, “Dışa Aktar”a bastığınız anda bitmez. Verinizi temiz ve güvenilir tutmanın yolları şunlar:
- Doğrulama Kontrolleri: Hata yakalamak için aralık kontrolleri, zorunlu alanlar ve benzersiz anahtarlar kullanın.
- Örnek Denetimi: Özellikle kurulumdan sonra veya site değiştiğinde, çekilen verinin bir örneğini kaynak siteyle manuel karşılaştırın.
- Hata Yönetimi: Başarısız taramaları kaydedin ve anormal durumlar için uyarılar kurun (örneğin satır sayısında ani düşüş gibi).
- Sürekli Temizlik: Boşlukları silmek, kodlamayı düzeltmek ve metni standardize etmek için tablo araçları veya betikler kullanın.
- Şema Tutarlılığı: Alan adlarınızı ve biçimlerinizi zaman içinde sabit tutun. Değişiklikleri belgeleyin ki ekibiniz tahmin yürütmek zorunda kalmasın.
Verinize duyulan güven her şeydir. Baştan gösterilecek biraz özen, sonradan büyük sorunları önler.
Thunderbit’in Nasıl Karşılaştırıldığını Görün Thunderbit'in tek tıkla, yapay zekâ destekli veri çıkarma yaklaşımının pazardaki diğer web scraping araçları arasında nerede durduğunu görün. Get Started Free
Çıkarma Araçlarını Karşılaştırmak: Bir Çözüm Seçerken Nelere Bakmalı?
Tüm web scraping araçları aynı değildir. Şunları değerlendirin:
| Araç | Güçlü Yönler | Dikkat Edilmesi Gerekenler |
|---|---|---|
| Thunderbit | Teknik bilgisi olmayan kullanıcılar için en kolay seçenek; yapay zekâ ile alan algılama; alt sayfa tarama; hazır şablonlar; ücretsiz dışa aktarma; uygun fiyatlı planlar (Thunderbit Blog). | Aşırı büyük, geliştirici ağırlıklı projeler için tasarlanmamıştır; kredi sistemi kullanır. |
| Browse AI | Kodsuz kullanım, değişiklik izleme için iyi; Google Sheets entegrasyonu; toplu çıkarma. | Başlangıç planları daha pahalıdır; kurulum zaman alabilir. |
| Octoparse | Güçlüdür, dinamik siteleri yönetir; teknik kullanıcılar için gelişmiş özellikler sunar. | Öğrenme eğrisi diktir; fiyatlandırması daha yüksektir. |
| Web Scraper (webscraper.io) | Küçük projeler için ücretsizdir; görsel kurulum; güçlü topluluk. | Manuel kurulum kafa karıştırıcı olabilir; sınırlı yapay zekâ desteği vardır. |
| Diffbot | Yapay zekâ desteklidir, API üzerinden yapılandırılmamış sayfaları ayrıştırır; geliştiriciler için çok iyidir. | Pahalıdır, API tabanlıdır ve teknik olmayan kullanıcılar için uygun değildir. |
Benim tavsiyem: Hızlı ve doğru sonuç isteyen bir iş kullanıcısıysanız, Thunderbit tam size göre. Güç kullanıcıları veya geliştiriciler için Octoparse ya da Diffbot daha fazla karmaşıklığa rağmen değerlendirilebilir. Karar vermeden önce mutlaka ücretsiz planı veya deneme sürümünü test edin.
Sonuç: Web Sitesi Veri Çıkarma En İyi Uygulamalarını Hayata Geçirmek
Web sitesinden veri çıkarmak artık “olsa da olur” bir şey değil; rekabette kalmak isteyen her işletme için zorunluluk. Umarım şu mesajları almışsınızdır:
- Değer: Web verisi daha akıllı, daha hızlı kararları besler. Bunu masada bırakmayın.
- Zorlukların Üstesinden Gelin: Yapılandırılmamış veriyi, hacmi ve site değişikliklerini yönetmek için yapay zekâ destekli araçlar kullanın.
- Yasal Kalın: Gizlilik yasalarına, site kurallarına ve veri güvenliğine saygı gösterin.
- Otomatikleştirin: Veri çıkarmayı zamanlayın ve günlük iş akışlarınıza entegre edin.
- Önce Kalite: Verinizin güvenilirliğini korumak için doğrulayın, temizleyin ve izleyin.
Ne kadar kolay olabileceğini görmek ister misiniz? Thunderbit Chrome Uzantısını indirin ve bir sonraki veri projenizde deneyin. Daha da derine inmek isterseniz, daha fazla rehber, ipucu ve gerçek dünya örneği için Thunderbit Blog sayfasına göz atın.
Mutlu taramalar — ve veriniz hep yapılandırılmış, uyumlu ve kullanıma hazır olsun.
Thunderbit ile Veri Çıkarmaya Başlayın Thunderbit'in ücretsiz Chrome uzantısını kurun ve tek tıkla herhangi bir sayfadan yapılandırılmış veri çıkarmaya başlayın. Get Started Free
SSS
1. Herhangi bir web sitesinden veri çıkarmak yasal mı?
Genel olarak herkese açık veriyi taramak pek çok hukuk sisteminde yasaldır; ancak giriş engellerini veya güvenlik önlemlerini aşmamalısınız. Her zaman sitenin kullanım şartlarını inceleyin ve GDPR ile CCPA gibi gizlilik yasalarına uyun (xbyte.io).
2. Yapay zekâ, web sitelerinden veri çıkarma sürecini nasıl iyileştirir?
Thunderbit gibi yapay zekâ destekli araçlar alanları otomatik algılayabilir, değişen düzenlere uyum sağlayabilir, veriyi temizleyip biçimlendirebilir ve hatta dinamik içerik ya da çevirileri bile yönetebilir — üstelik minimum kurulum ve yüksek doğrulukla (scrapingapi.ai).
3. Yapılandırılmamış veriyi yönetmek için en iyi yöntemler nelerdir?
Veri yapınızı en başta belirleyin, çıkarımı yönlendirmek için alan bazlı AI komutları kullanın, tarama sırasında formatları standardize edin ve sonuçlarınızı doğrulayın. Thunderbit gibi araçlar veriyi anında kategorize etmeyi, biçimlendirmeyi ve etiketlemeyi kolaylaştırır.
4. Web sitesi veri çıkarmayı nasıl otomatikleştirip ölçeklendirebilirim?
Düzenli aralıklarla tarama yapmak için zamanlama özelliklerini kullanın ve çıktıları doğrudan Google Sheets, Airtable veya CRM’iniz gibi araçlara bağlayın. Otomasyon, verinizin güncel kalmasını sağlar ve manuel emeği azaltır.
5. Çıkarılan verinin kalitesini ve tutarlılığını nasıl sağlarım?
Doğrulama kontrolleri uygulayın, örnekleri düzenli olarak denetleyin, hataları düzgün yönetin ve şemanızı zaman içinde tutarlı tutun. Güvenilir veriyi korumanın anahtarı sürekli iyileştirme ve izlemedir.
Bu en iyi uygulamaların pratikte nasıl çalıştığını görmek ister misiniz? Thunderbit’in ücretsiz planını deneyin ve web veri çıkarmanın ne kadar kolay, yasal ve ölçeklenebilir olabileceğini deneyimleyin.
Agentic Web Scraper’ı Deneyin Get Started Free
Daha Fazla Öğrenin




