
Craigslist, 2003’ten beri neredeyse hiç değişmemiş gibi görünebilir; ama o sade metin ilanların içinde saklı duran veri gerçekten çok değerlidir. Aylık yaklaşık 127 milyon ziyaret ve her ay on milyonlarca yeni ilan ile, ABD’nin en büyük ilan platformlarından biri olmaya devam ediyor — üstelik kullanabileceğiniz herkese açık bir API de yok.
Thunderbit üzerinde yıllardır otomasyon araçları geliştiriyorum ve satış, operasyon ve emlak ekiplerinden sürekli aynı cümleyi duyuyorum: “Craigslist verisini bir tabloya aktarmam gerekiyor ama üç saat kopyala-yapıştır yapmak istemiyorum.” Sorun şu ki, çoğu “en iyi Craigslist scraper” rehberi ya güncelliğini yitiriyor, ya işin zor kısmını atlıyor (mesela bot engelleri), ya da araçları gerçekten karşılaştırmadan sadece isim listeliyor.
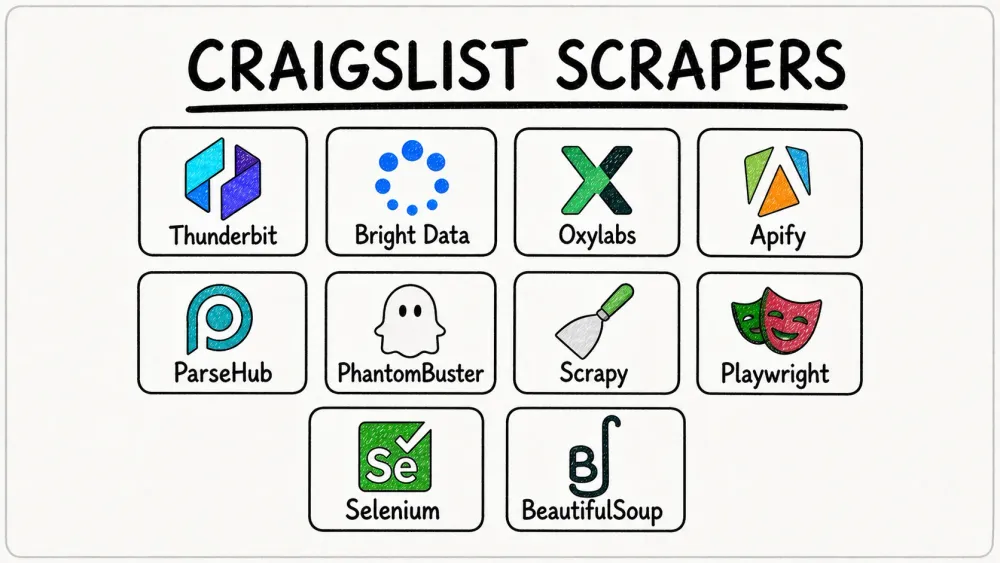
Bu yüzden 2026’da gerçekten hâlâ çalışan 10 aracı bir araya getirdim — kod yazmadan kullanılan Chrome eklentilerinden kurumsal proxy platformlarına ve açık kaynak Python kütüphanelerine kadar. İster hayatında tek satır kod yazmamış bir iş kullanıcısı olun, ister Python ile içli dışlı bir geliştirici, burada size uygun bir seçenek var.
Neden 2026'da Craigslist Scrape Edilir? İş Ekipleri İçin Başlıca Kullanım Senaryoları
Craigslist eski moda görünebilir, ama cazibesinin ve değerinin bir kısmı da tam olarak burada. Hâlâ ilan siteleri arasında küresel olarak #3 sırada yer alıyor ve resmi dizininde ABD ve bölge genelinde 416 farklı lokasyon sunuyor. Bu da başka hiçbir yerde tek noktada bulamayacağınız kadar çok yerel envanter anlamına geliyor.
Ekiplerin tekrar tekrar ihtiyaç duyduğu kullanım alanları şunlar:
- Lead oluşturma: Hizmet ve iş ilanlarında çoğu zaman işletme açıklaması, lokasyon ve Craigslist yönlendirme iletişim yolu bulunur; satış ekipleri için yerel bir lead listesi çıkarmaya yeterlidir.
- Emlak takibi: Konut sayfalarında kira, mahalle, oda/banyo sayısı, metrekare ve zaman damgası yer alır; kira karşılaştırması ve müsaitlik takibi için idealdir.
- Rekabetçi fiyat analizi: Satılık ilanlar başlık, fiyat, durum ve lokasyon bilgisi verir; ikinci el satış veya arbitraj araştırması için altın değerindedir.
- İşe alım ve iş gücü takibi: Jobs ve gigs kategorileri; yerel yetenek piyasasını taramak için ücret, çalışma türü ve rol açıklamaları sunar.
- Çok bölgeli pazar analizi: Craigslist alt alan adları ve şehirlere göre ayrıldığı için fiyat, hacim veya kategori karmasını bölge bölge inceleyebilirsiniz.
- İş akışı otomasyonu: Pek çok kullanıcı Craigslist verisinin elle gezmeden CSV, Google Sheets, Airtable ya da bir CRM'e akmasını ister.
Bir kullanıcı, eskiden 60–90 dakika süren günlük Craigslist çekimini otomasyonla yaklaşık 5 dakikaya düşürdüğünü söyledi. Zaman tasarrufu açısından fark gerçekten çok büyük.
Craigslist verisini AI ile çekin Thunderbit'in ajan tabanlı web scraper'ı Craigslist ilan sayfalarını kendi başına okur ve fiyat, açıklama ve iletişim bilgilerini tek tıkla çeker. Get Started Free
En İyi Craigslist Scraper'ları Nasıl Seçtik: Değerlendirme Kriterlerimiz
Her Craigslist scraper aynı değildir; “en iyi” araç, büyük ölçüde sizin kim olduğunuza ve neye ihtiyacınız olduğuna bağlıdır. Her aracı altı ölçüte göre değerlendirdim:
- Kurulum kolaylığı — Başlangıç seviyesi için uygun mu (kod yazmadan), yoksa geliştirici mi gerektiriyor?
- Craigslist bot engeli yönetimi — Yerleşik proxy rotasyonu, CAPTCHA çözümü veya browser fingerprinting sunuyor mu?
- Fiyatlandırma seviyesi — Ücretsiz, freemium, ücretli veya kurumsal mı?
- Veri dışa aktarma seçenekleri — CSV, Excel, Google Sheets, Airtable, Notion, JSON, veritabanı?
- Çok bölgeli destek — Tüm 416 ABD Craigslist sitesini tarayabiliyor mu, yoksa tek şehirle mi sınırlı?
- Bakım eforu — Craigslist sayfa yapısını değiştirdiğinde araç kırılıyor mu, yoksa otomatik uyum sağlıyor mu?
Bulabildiğim hiçbir karşılaştırmalı yazı bu kriterlerle yan yana kıyas yapmıyordu; eğer siz de muğlak “ilk 10” listelerinden sıkıldıysanız, bu rehber tam size göre.
En İyi 10 Craigslist Scraper'a Hızlı Bakış
Her aracı tek tek anlatmadan önce, genel karşılaştırma tablosuna bakalım. Bunları üç gruba ayırdım: iş kullanıcıları için kodsuz araçlar, ölçek için kurumsal platformlar ve geliştiriciler için açık kaynak kütüphaneler.
| Araç | Tür | Ücretsiz Katman? | Proxy / Bot Engeli Desteği | CAPTCHA Yönetimi | Dışa Aktarma Formatları | En İyi Olduğu Alan |
|---|---|---|---|---|---|---|
| Thunderbit | Kodsuz Chrome eklentisi | Evet (ayda 6 sayfa) | Browser modu (orta ölçekli kullanımda proxy gerekmez) | N/A (browser oturumu) | Excel, Sheets, Airtable, Notion, CSV, JSON | Teknik olmayan iş kullanıcıları |
| Bright Data | Kurumsal scraper + proxy + dataset | Deneme sürümü | Yönetilen engel aşma, proxy'ler, yeniden deneme, render | Evet (otomatik çözüm) | JSON, NDJSON, CSV, Parquet, XLSX, API | Kurumsal ölçekte veri toplama |
| Oxylabs | API + proxy altyapısı | Deneme sürümü | Yönetilen engel aşma, residential/ISP proxy'ler | Evet | HTML, ekran görüntüsü, API çıktıları | Kurumsal altyapı isteyen geliştiriciler |
| Apify | Bulut actor pazaryeri | Evet ($5/ay kredi) | Proxy rotasyonu (actor'a bağlı) | Kısmi / actor'a özgü | JSON, CSV, XML, Excel, JSONL | Esnek düşük kodlu bulut otomasyonu |
| ParseHub | Kodsuz görsel scraper | Evet | Ücretli proxy rotasyonu, bulut çalıştırma | Temel özellik değil | CSV, JSON, API/S3/Dropbox (ücretli) | Bütçe dostu kodsuz kullanıcılar |
| Phantombuster | Bulut otomasyon platformu | Evet (sınırlı) | Proxy desteği var | Kredi / iş akışı bazlı | CSV, JSON (ücretli) | Çok platformlu satış otomasyonu |
| Scrapy | Açık kaynak Python crawler | Ücretsiz (OSS) | Proxy/middleware'i kendiniz sağlamalısınız | Hayır | JSON, JSONL, CSV, XML, DB | Üretim seviyesinde crawler'lar |
| Playwright | Açık kaynak browser otomasyonu | Ücretsiz (OSS) | Browser/proxy'yi kendiniz sağlamalısınız | Hayır | Özel dışa aktarma | Browser seviyesinde kontrol |
| Selenium | Açık kaynak browser otomasyonu | Ücretsiz (OSS) | Browser/proxy'yi kendiniz sağlamalısınız | Hayır | Özel dışa aktarma | Eski nesil çok dilli stack'ler |
| BeautifulSoup | Açık kaynak HTML ayrıştırıcı | Ücretsiz (OSS) | Tek başına yok | Hayır | Özel dışa aktarma | Hafif ayrıştırma |
Burada üç net grup öne çıkıyor:
- Kodsuz araçlar (Thunderbit, ParseHub, Phantombuster): Mühendislik yükü olmadan veri almak isteyen iş kullanıcıları için.
- Kurumsal platformlar (Bright Data, Oxylabs, Apify): Ölçek, bot engeli altyapısı ve yönetilen teslimat isteyen ekipler için.
- Açık kaynak geliştirici araçları (Scrapy, Playwright, Selenium, BeautifulSoup): En yüksek kontrol için — ama kurulum, bakım ve proxy yönetimi pahasına.
Şimdi detaylara geçelim.
1. Thunderbit
 Thunderbit, Craigslist dahil herhangi bir siteden yapılandırılmış veri almak isteyen ama kod yazmak ya da proxy ayarlamak istemeyen kişiler için geliştirilmiş AI destekli bir Chrome eklentisidir.
Burada biraz taraflıyım (ürünü biz geliştirdik), ama Thunderbit’i ilk sıraya koymamın nedeni, Craigslist scraping’in teknik olmayan kullanıcılar için yarattığı spesifik sorunları çözmesi: kategoriler arasında değişen sayfa düzenleri, detay sayfalarından veri zenginleştirme ve CSS seçiciler değiştiğinde oluşan sürekli kırılmalar.
Craigslist üzerinde nasıl çalışır:
- Thunderbit Chrome Extension kurun ve herhangi bir Craigslist ilan sayfasını açın (örneğin şehrinizdeki daireler).
- “One Click Extract” butonuna tıklayın — Thunderbit’in AI’sı sayfayı okur, yapısını çözer, hangi sütunların uygun olduğuna karar verir ve veriyi tek geçişte tabloya aktarır. Konut için Title, Price, Sqft, Bedrooms, Location, Date Posted, Link alanlarını alırsınız. İş ilanlarında ise Title, Compensation, Job Type vb. gelir. Elle seçici ayarı gerekmez.
- Sayfalama işlemini yönetin — Thunderbit, Craigslist’in tıklama tabanlı sayfalama yapısıyla uyumludur.
- Her bir ilan sayfasını ziyaret edip yalnızca detay sayfasında yer alan alanları çekmek için “Scrape Subpages” özelliğini kullanın: tam açıklama, tüm görseller, gömülü iletişim bilgileri ve daha fazlası.
- Google Sheets, Excel, Airtable, Notion veya CSV’ye — ücretsiz — dışa aktarın.
Öne çıkan özellikler:
- AI destekli alan algılama: Farklı Craigslist kategorilerine otomatik uyum sağlar — konutta sqft/bedrooms sütunları, işlerde compensation/job type, satılıkta condition/price. Sıfır manuel CSS işi.
- Alt sayfa scraping: Sonuç sayfasını çektikten sonra her ilanı ziyaret ederek detay sayfası alanlarını alır (tam açıklama, görseller, iletişim bilgileri).
- Browser tabanlı scraping modu: Kendi Chrome oturumunuz içinde çalışır, bu yüzden orta hacimlerde proxy gerekmez. Bu tek başına büyük bir maliyet ve karmaşıklık katmanını ortadan kaldırır.
- Sıfır bakım: AI sayfayı her seferinde yeniden okur. Craigslist düzenini değiştirdiğinde bile scraper bozulmaz.
- Ücretsiz dışa aktarma: Excel, Google Sheets, Airtable, Notion, CSV, JSON — dışa aktarmada ücret duvarı yok.
Fiyatlandırma: Ücretsiz katman (ayda 6 sayfa), ücretsiz deneme (10 sayfa), daha yüksek hacimler için ücretli planlar.
En iyi olduğu alan: Craigslist hizmet/gig ilanlarından lead çeken satış ekipleri, kira fiyatlarını izleyen emlak ekipleri, geliştirici desteği olmadan yapılandırılmış Craigslist verisine ihtiyaç duyan operasyon ekipleri ve veriyi tek adımda çekmek, etiketlemek ve dışa aktarmak isteyen herkes.
Craigslist scraping için Thunderbit'i deneyin Ücretsiz plan ayda 6 sayfa sunar — ücretli plana geçmeden önce Craigslist scraping'i test etmek için yeterlidir. Get Started Free
2. Bright Data
 Bright Data kurumsal taraftaki ağır siklet seçenektir. Bu listedeki hem özel bir Craigslist Scraper ürün sayfasına hem de Craigslist Dataset pazarına sahip tek platformdur.
Her gün ABD’nin tüm bölgelerinde binlerce Craigslist ilanı çekmeniz gerekiyorsa, Bright Data tam da bu ölçek için tasarlanmıştır. Web Unlocker IP’leri, yeniden denemeleri, render etmeyi ve engelleri yönetir — CAPTCHA’ları varsayılan olarak otomatik çözer. Web Scraper IDE ile özel Craigslist toplama iş akışları oluşturabilir ve programatik olarak tüm 416 bölgesel URL üzerinden dolaşabilirsiniz.
Öne çıkan özellikler:
- Devasa residential proxy ağı (milyonlarca IP)
- Yerleşik CAPTCHA çözme ve bot engeli aşma
- Craigslist’e özel scraper ve dataset ürünleri
- Dışa aktarma: JSON, NDJSON, CSV, Parquet, XLSX, API teslimi, webhook’lar
Fiyatlandırma: Craigslist scraper için sayfa yüklemesi başına $0.5 / 1K kullandıkça öde modeli var; 380K page load için $499 gibi planlar mevcut. Residential proxy’ler GB başına $4 seviyesinden başlıyor. Bir haftalık 1K istek ücretsiz deneme var.
En iyi olduğu alan: Yüksek hacimli, çok bölgeli Craigslist verisi toplayıp kesintisiz çalışma ve özel destek isteyen kurumsal ekipler. Bütçeye hassas küçük ekipler başka seçeneklere bakmalı.
3. Oxylabs
 Oxylabs, özel bir Craigslist Scraper API ve Craigslist proxies page ile birlikte gelen, premium bir proxy ve scraping altyapısı sağlayıcısıdır.
Oxylabs, Bright Data’nın tek pakette her şeyi sunan yaklaşımına kıyasla daha çok geliştirici odaklıdır. Web Scraper API ve Web Unblocker, JS render etme, yeniden deneme, oturum yönetimi, fingerprint üretimi ve daha geniş bot engeli yönetimi sunar. Craigslist Scraper API ücretsiz denemesi 2.000 sonuca kadar çıkabilir.
Öne çıkan özellikler:
- Residential ve ISP proxy havuzları (residential GB başına $6 seviyesinden, ISP IP başına $0.60 seviyesinden başlıyor)
- Otomatik fingerprint ve oturum yönetimli Web Unblocker
- Craigslist’e özel API endpoint’i
- 7 günlük ücretsiz deneme
Fiyatlandırma: “Other sites” scraper API, JS olmadan yaklaşık 1K sonuç başına $0.15, JS ile $0.35 seviyesinden başlıyor. Web Unblocker mikro paketleri yaklaşık ayda $75 civarında. Ölçekte residential proxy’ler 1TB’de GB başına $0.50’ye kadar inebilir.
En iyi olduğu alan: Sürekli Craigslist scraping yapan, proxy altyapısını yönetilen API tabanlı iş akışlarıyla isteyen geliştirici ekipler. Diğer projelerde zaten Oxylabs proxy kullanan ekipler için Craigslist eklemek kolaydır.
4. Apify
 Apify, kod yazmadan çalıştırabileceğiniz önceden hazırlanmış “Actor”ların yer aldığı bulut tabanlı bir web scraping ve otomasyon platformudur.
Apify’deki Craigslist ekosistemi ilginçtir: topluluk tarafından sürdürülen birden fazla Craigslist actor’ı vardır ve kalite seviyeleri oldukça değişkendir. ivanvs/craigslist-scraper actor’ı toplam 829 kullanıcı ve 5.0 puana sahipken, automation-lab/craigslist-scraper 44 kullanıcı ve 1.0 puandadır. Kalite tutarsızdır, bu yüzden karar vermeden önce test etmek gerekir.
Öne çıkan özellikler:
- Birden fazla Craigslist actor’ı mevcut (bazıları yerleşik gecikmelerle sayfa başına ~120 ilan çekebiliyor)
- Bulutta çalışma, zamanlanmış görevler, API erişimi, webhook entegrasyonları
- Proxy rotasyonu mevcut
- Dışa aktarma: JSON, CSV, XML, Excel, JSONL
Fiyatlandırma: Ayda $5 kredi veren ücretsiz katman, ücretli planlar yaklaşık ~$49/aydan başlıyor. Yoğun kullanımda compute bazlı fiyatlandırma hızla yükselebilir — CU tüketiminizi takip edin.
En iyi olduğu alan: Altyapı yönetmek istemeyen, bulutta çalışan bir çözüm arayan, düşük kodlu yapılandırma ile rahat olan ve düzenli/tekrarlayan Craigslist çekimleri yapan ekipler.
5. ParseHub
 ParseHub, sayfa öğelerine tıklayarak neyin çekileceğini tanımladığınız masaüstü tabanlı görsel bir web scraping aracıdır.
ParseHub’da Craigslist scraping ayarlamak için ilan başlıklarına, fiyatlara ve linklere tıklayarak araca neyi alacağını öğretirsiniz. AJAX tıklama döngüleriyle sayfalama yapabilir ve ücretli planlarda bulut çalıştırma desteği sunar. Ücretsiz katman 5 projeye kadar izin verir; bu da küçük ölçekli Craigslist işleri için gayet makul.
Öne çıkan özellikler:
- Görsel, tıkla-seç iş akışı oluşturucu
- Sayfalama ve dinamik içerik yönetimi
- Ücretli planlarda bulut çalıştırma ve zamanlama
- Dışa aktarma: CSV, Excel, JSON
Fiyatlandırma: Ücretsiz katman (5 proje), daha fazla sayfa ve zamanlanmış çalıştırma için yaklaşık ~$189/aydan başlayan planlar.
Sınırlamalar: Büyük ölçekli çekimlerde yavaş olabilir, ücretsiz katmanda zamanlanmış görevler sınırlıdır ve en önemlisi CSS seçici tabanlı olduğu için Craigslist düzen değiştirdiğinde manuel bakım gerekir.
En iyi olduğu alan: Görsel, kodsuz bir araç isteyen ama AI destekli alan algılama gerektirmeyen bireysel kullanıcılar veya küçük ekipler.
6. Phantombuster
 Phantombuster, başlangıçta LinkedIn ve sosyal medya scraping için popüler olan bulut tabanlı bir otomasyon platformudur. Craigslist’e özgü bir araç değildir; ancak Web Element Extractor ile CSS seçiciler kullanarak herkese açık sayfaları çekebilir.
Phantombuster’da Craigslist scraping kurmak, özel bir araca göre daha fazla çaba ister — seçicileri belirtmeniz, iş akışını kurmanız ve zamanlamayı ayarlamanız gerekir. Ama zaten LinkedIn ya da sosyal medya lead gen için Phantombuster kullanıyorsanız, Craigslist’i akışınıza eklemek oldukça kolaydır.
Öne çıkan özellikler:
- Hazır otomasyon şablonları ve bulut çalıştırma
- Zamanlama ve CRM entegrasyonları
- Proxy desteği ve CAPTCHA çözme kredileri mevcut
- Dışa aktarma: ücretli planlarda CSV, JSON (ücretsiz katmanda 10 satır sınırı var)
Fiyatlandırma: 5 slot, ayda 2 saat ve 10 satırlık dışa aktarma sınırı olan ücretsiz katman. Ücretli yıllık planlar yıllık faturalandırma ile yaklaşık ~$56/aydan başlıyor.
En iyi olduğu alan: Çok platformlu lead generation için zaten Phantombuster kullanan ve Craigslist’i mevcut akışına eklemek isteyen satış ekipleri.
7. Scrapy
 Scrapy, en popüler açık kaynak Python web scraping çerçevesidir ve Craigslist taramasında maksimum kontrol isteyen geliştirici ekipler için doğal tercihtir.
En güncel kararlı sürüm 2.15.0 (9 Nisan 2026) olarak yayınlanmıştır. Scrapy; çok bölgeli tarama (tüm bölgesel URL’ler arasında gezinme), yerleşik istek zamanlama ve yavaşlatma, proxy rotasyonu için downloader middleware ve CSV, JSON, JSONL, XML ve veritabanı akışlarına feed exports desteği sunar. Gerekirse scrapy-playwright eklentisi ile browser seviyesinde render da eklenebilir.
Öne çıkan özellikler:
- Yüksek derecede özelleştirilebilir, üretim seviyesinde crawler
- Proxy’ler, yeniden denemeler, çerezler ve user-agent rotasyonu için middleware
- Feed dışa aktarma: JSON, JSONL, CSV, XML, veritabanı boru hatları
- Ücretsiz ve açık kaynak
Gizli maliyet: Scrapy’nin kendisi ücretsizdir; ancak Craigslist’te ölçekli çalıştırmak proxy abonelikleri ($50–500+/ay), barındırma/sunucu maliyetleri ve Craigslist HTML yapısını değiştirdikçe süren bakım anlamına gelir.
En iyi olduğu alan: Python deneyimi olan, maksimum esneklik, mevcut proxy altyapısı ve yüksek hacimli çok bölgeli Craigslist taraması isteyen geliştirici ekipler.
8. Playwright
 Playwright, Chromium, Firefox ve WebKit’i programatik olarak kontrol eden Microsoft’un modern browser otomasyon kütüphanesidir. Güncel sürüm temposu oldukça aktiftir — v1.59.1, 1 Nisan 2026’da yayınlandı.
Playwright, geliştirici topluluklarında Craigslist scraping için Selenium’a göre giderek daha çok önerilen seçimdir. Daha hızlıdır, daha güvenilirdir ve playwright-extra gibi topluluk eklentileriyle bot tespitine karşı daha iyi gizlilik sunar. Headless ve headed modları, elementler için otomatik bekleme, ağ yakalama ve ekran görüntüsü/PDF alma özellikleri vardır.
Öne çıkan özellikler:
- Python, JavaScript/TypeScript, Java ve .NET desteği
- Headless ve headed browser modları
- Elementler için otomatik bekleme, ağ yakalama
- Ücretsiz ve açık kaynak
Craigslist avantajı: Playwright, ham HTTP isteklerine göre gerçek kullanıcı davranışını çok daha ikna edici biçimde taklit edebilir; bu da engellenme riskini azaltır. Reddit’teki genel görüş de yeni projelerde Selenium yerine Playwright’ı tercih etme yönündedir.
Gizli maliyetler: Scrapy ile aynı — proxy maliyetleri, barındırma ve seçiciler bozulduğunda bakım.
En iyi olduğu alan: İnce ayarlı browser kontrolüne ihtiyaç duyan geliştiriciler, JavaScript ile render edilen içerikleri yöneten scraper’lar kuran ekipler ve Selenium’a modern bir alternatif arayanlar.
9. Selenium
 Selenium, uzun süredir kullanılan ve yaygın bir browser otomasyon çerçevesidir. En son sürüm 4.43.0 (10 Nisan 2026) ve BiDi ile ağ kontrolü yetenekleri geliştirilmeye devam ediyor.
Selenium; birden fazla dili (Python, Java, C#, JavaScript) ve tüm büyük tarayıcıları destekler. Tam browser oturumlarını simüle edebilir, gerekirse giriş işlemlerini yönetebilir ve sayfalar arasında kaydırma yapabilir. Ancak Playwright’a kıyasla daha yavaştır, daha uzun kod ister ve undetected-chromedriver gibi ek stealth kütüphaneleri olmadan bot olarak tespit edilmesi daha kolaydır.
Öne çıkan özellikler:
- Çok dilli destek (Python, Java, C#, JavaScript)
- Tam browser oturumu simülasyonu
- Geniş dokümantasyona sahip olgun ekosistem
- Ücretsiz ve açık kaynak
Sınırlamalar: 2026’da topluluk yeni projeler için daha çok Playwright’ı öneriyor. Reddit’teki bir başlık, Cloudflare’ın residential proxy kullanılsa bile Selenium’u hâlâ tespit edebildiğini belirtiyordu — yani gizlilik kutudan çıktığı haliyle zor.
En iyi olduğu alan: Zaten Selenium yatırımı yapmış ve taşınmak istemeyen geliştirici ekipler, çok dilli desteğe ihtiyaç duyan projeler (Java, C#) ve eski scraping kurulumları.
10. BeautifulSoup
 BeautifulSoup, HTML ve XML ayrıştırmak için hafif bir Python kütüphanesidir. Güncel PyPI sürümü 4.14.3 (30 Kasım 2025) olarak listeleniyor.
Önemli bir ayrım: BeautifulSoup bir parser’dır, tam bir scraper değil. Web sayfalarını çekmez veya browser otomasyonunu yönetmez. HTTP çekimi için requests kütüphanesi ile birlikte kullanılır ve size verilen HTML’i ayrıştırır. Bu, onu geliştiriciler için en basit başlangıç noktası yapar; ama aynı zamanda en sınırlı seçenek haline de getirir.
Öne çıkan özellikler:
- Öğrenmesi son derece kolay — çok az kod yeterli
- Küçük ölçekli veya tek seferlik Craigslist çekimleri için ideal
- Ücretsiz ve açık kaynak
Sınırlamalar: Yerleşik sayfalama yönetimi yok, JavaScript render desteği yok, proxy rotasyonu yok — hepsini manuel eklemeniz gerekir. Craigslist HTML yapısını değiştirirse seçicileriniz bozulur ve elle düzeltmeniz gerekir.
En iyi olduğu alan: Minimum kurulumla Craigslist scraping denemek isteyen Python başlangıç seviyesindeki kullanıcılar, tek bir kategori veya bölgeden hızlı tek seferlik veri çekmek isteyenler ve sadece hafif bir parser’a ihtiyaç duyan geliştiriciler.
Craigslist Anti-Ban Oyun Planı: Proxy'ler, Rate Limit ve Sizi Ne Engeller?
Çoğu Craigslist scraping rehberinin atladığı ama en önemli olan bölüm burası. Scraperly'nin Nisan 2026 testleri, Craigslist’i özel CAPTCHA, rate limiting ve IP bloklama nedeniyle 3/5 zorluk seviyesinde sınıflandırıyor. Bright Data'nın rehberi, kullanıcıları düz HTTP yerine Web Unlocker ya da Playwright tabanlı bir Scraping Browser kullanmaya yönlendiriyor. Oxylabs'ın proxy sayfası ise Craigslist’in proxy’leri tespit edebildiğini ve en iyi seçimin residential proxy’ler olduğunu söylüyor.
Gerçekte işe yarayanlar şunlar:
| Strateji | Craigslist'te Etkililik | Maliyet | Karmaşıklık |
|---|---|---|---|
| Residential proxy'ler | ✅ Yüksek | $$ (GB başına $4–6) | Orta |
| ISP proxy'ler | ✅ Yüksek | $ (IP başına $0.60–0.80) | Orta |
| Datacenter proxy'ler | ⚠️ Düşük (çoğu zaman engellenir) | $ (IP başına $0.20–0.40) | Düşük |
| Browser tabanlı scraping (kendi oturumu) | ✅ Orta-Yüksek | Ücretsiz | Düşük |
| Rate limiting + rastgele gecikmeler | ✅ Temel gereklilik | Ücretsiz | Düşük |
Uygulanabilir ipuçları:
- İstek gecikmeleri: İstekler arasında en az 2–5 saniye bekleyin. Scraperly, IP başına dakikada 5–10 istek civarında kalmayı ve 20–30 istekten sonra rotasyon yapmayı öneriyor.
- Oturum rotasyonu: User agent’ları ve browser fingerprint’lerini değiştirin. Tahmin edilebilir tarama desenleri hızlıca yakalanır.
- Datacenter proxy’lerden kaçının: Ucuzdurlar ama Craigslist’te çabuk bloklanırlar.
- Browser tabanlı scraping, orta hacimlerde proxy sorununu tamamen ortadan kaldırır. Thunderbit’in browser modu kendi Chrome oturumunuz içinde çalışır — proxy kurulumu yok, IP rotasyonu yok, ek maliyet yok. Birkaç yüz ilan çeken çoğu iş kullanıcısı için bu fazlasıyla yeterlidir.
Ve çoğu kişinin gözden kaçırdığı bakım tarafı da şu: Craigslist CSS yapısını değiştirdiğinde (ve bunu periyodik olarak yapar), CSS seçici tabanlı her scraper kırılır. Sayfayı inceleyip yeni seçicileri bulmanız, kodu güncellemeniz ve yeniden test etmeniz gerekir. Thunderbit gibi AI destekli araçlar bunu tamamen aşar — AI sayfa yapısını her seferinde yeniden okur, bu yüzden düzen değişiklikleri iş akışınızı bozmaz.
Kodlu vs. Kodsuz: Craigslist Scraping İçin İki Eksiksiz Yürüyüş
Bu yazının kitlesinin kabaca %50/%50 bölündüğünü biliyorum: veriyi isteyen teknik olmayan iş kullanıcıları ve çalışan kod görmek isteyen başlangıç-orta seviye geliştiriciler. Bu yüzden iki yolu da yan yana verdim.
Kodsuz: Thunderbit ile Craigslist Nasıl Scrape Edilir? (Adım Adım)
- Chrome Web Store üzerinden Thunderbit Chrome Extension’ı kurun.
- Bir Craigslist ilan sayfasına gidin — örneğin şehrinizdeki daireler (
https://yourcity.craigslist.org/search/apa). - “One Click Extract” butonuna tıklayın — Thunderbit’in AI’sı sayfayı okur, yapısını çözer, kategoriye uygun sütunları belirler ve yapılandırılmış tabloyu tek geçişte oluşturur. Konut için Title, Price, Sqft, Bedrooms, Location, Date Posted, Link görürsünüz. İsterseniz sonradan herhangi bir sütunu değiştirebilirsiniz.
- Sayfalamayı yönetin — sayfalar arasında geçiş yapın ya da Thunderbit’in bunu yönetmesine izin verin.
- Her bir ilanı ziyaret edip detay sayfası alanlarıyla zenginleştirmek için “Scrape Subpages” özelliğini kullanın: tam açıklama, tüm görseller, gömülü iletişim bilgileri.
- Google Sheets, Excel, Airtable, Notion veya CSV’ye — ücretsiz — aktarın.
Tüm süreç, sonuç sayfası başına yaklaşık 2 dakika sürer. CSS seçici yok, proxy yok, kod yok.
Kod Yolu: Python + Playwright ile Craigslist Nasıl Scrape Edilir?
Playwright, 2026’da geliştirici forumlarında Craigslist scraping için en çok önerilen kütüphanedir. Aşağıda, bir Craigslist konut sonuç sayfasını scrape eden, başlık/fiyat/link çıkaran, sayfalama yapan ve sonuç veren çalışan bir Python örneği var.
Yaklaşım şu: önce JSON-LD yapılandırılmış veriyi deneyin (Craigslist bazı sayfalarda ItemList şemasını gömer), sonra DOM seçicilerine dönün. Sayfalama s=120 ile yapılır.
import asyncio, json
from urllib.parse import urlparse, parse_qs, urlencode, urlunparse
from playwright.async_api import async_playwright

def next_page_url(url, step=120):
    p = urlparse(url)
    qs = parse_qs(p.query)
    offset = int(qs.get("s", ["0"])[0]) + step
    qs["s"] = [str(offset)]
    return urlunparse((p.scheme, p.netloc, p.path, "", urlencode(qs, doseq=True), ""))

async def scrape_page(page, url):
    await page.goto(url, wait_until="domcontentloaded")
    await page.wait_for_timeout(1500)
    data = []
    # Önce JSON-LD'yi dene
    for raw in await page.locator('script[type="application/ld+json"]').all_text_contents():
        try:
            obj = json.loads(raw)
        except Exception:
            continue
        if isinstance(obj, dict) and obj.get("@type") == "ItemList":
            for item in obj.get("itemListElement", []):
                thing = item.get("item", {})
                data.append({
                    "title": thing.get("name"),
                    "price": thing.get("offers", {}).get("price"),
                    "link": thing.get("url"),
                })
            if data:
                return data
    # Yedek: DOM seçicileri
    cards = page.locator("div.cl-search-result, li.cl-static-search-result")
    count = await cards.count()
    for i in range(count):
        card = cards.nth(i)
        title = await card.locator("a.posting-title, a.titlestring").first.text_content()
        link = await card.locator("a.posting-title, a.titlestring").first.get_attribute("href")
        price = (await card.locator(".price, .result-price").first.text_content()
                 if await card.locator(".price, .result-price").count() else None)
        data.append({"title": (title or "").strip(), "price": (price or "").strip(), "link": link})
    return data

async def main():
    start_url = "https://newyork.craigslist.org/search/apa?query=studio"
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True)
        page = await browser.new_page()
        url = start_url
        all_rows = []
        for _ in range(3):  # 3 sayfa çek
            rows = await scrape_page(page, url)
            if not rows:
                break
            all_rows.extend(rows)
            url = next_page_url(url)
        await browser.close()
        for row in all_rows[:10]:
            print(row)

asyncio.run(main())
Bu scriptin dışında ihtiyaç duyacaklarınız: Playwright kurulumu (pip install playwright && playwright install), yüksek hacimli çalışmalar için proxy ayarı ve rate limit’e takılırsanız manuel CAPTCHA yönetimi. Takas şu: tam kontrol, ama tam sorumluluk.
Ücretsiz vs. Ücretli: Her Craigslist Scraper İçin Dürüst Maliyet Tablosu
Bu konuya araştırma yaparken keşke elimde olsaydı dediğim tablo bu. Web scraping’de “ücretsiz” kelimesi biraz yanıltıcı olabilir.
| Araç | Tamamen Ücretsiz mi? | Ücretsiz Katman Sınırları | Başlangıç Ücreti | Gizli Maliyetler |
|---|---|---|---|---|
| Thunderbit | Ücretsiz katman (6 sayfa) | Ayda 6 sayfa; ücretsiz deneme = 10 sayfa | Daha yüksek hacimler için ücretli planlar | Yok — dışa aktarma ücretsiz |
| Scrapy | ✅ Açık kaynak | Sınırsız | $0 | Proxy maliyetleri, hosting, bakım |
| BeautifulSoup | ✅ Açık kaynak | Sınırsız | $0 | Proxy maliyetleri, hosting, bakım |
| Playwright | ✅ Açık kaynak | Sınırsız | $0 | Proxy maliyetleri, hosting, bakım |
| Selenium | ✅ Açık kaynak | Sınırsız | $0 | Proxy maliyetleri, hosting, bakım |
| ParseHub | Ücretsiz katman | 5 proje | ~$189/ay | Ücretsiz planda sınırlı zamanlanmış çalıştırma |
| Apify | Ücretsiz katman | Ayda $5 kredi | ~$49/ay | Compute bazlı fiyat hızla artabilir |
| Phantombuster | Ücretsiz katman | 5 slot, ayda 2 saat, 10 satır dışa aktarma | ~$56/ay (yıllık) | Slot bazlı fiyatlandırma |
| Bright Data | Sadece deneme | 1K istek / 1 hafta | ~$500+/ay | Proxy maliyeti ayrıca gelir |
| Oxylabs | Sadece deneme | 2K sonuç / 1GB | ~$75+/ay (Unblocker) | Kurumsal fiyatlandırma |
Açık kaynak araçlardaki “ücretsiz” ibaresine önemli bir yıldız koymak gerekir: Scrapy, Playwright, Selenium ve BeautifulSoup’u kurmak para tutmaz; ama bunları Craigslist’te ölçekli çalıştırmak, kurulum için saatlerce geliştirici emeği, residential proxy’ler için aylık $50–500+ ve Craigslist HTML’i değiştikçe sürekli bakım demektir. Thunderbit’in AI’sı sayfayı her seferinde yeniden okur (sıfır bakım), dışa aktarma ücretsizdir ve browser tabanlı scraping orta hacimlerde proxy maliyetini ortadan kaldırır. Teknik olmayan kullanıcılar için bu gerçekten büyük bir avantajdır.
Aslında Neleri Çekebilirsiniz: Kategoriye Göre Craigslist Veri Alanları
Craigslist kategorilerinin veri yapıları birbirinden tamamen farklıdır. Bir konut ilanı ile bir iş ilanı aynı görünmez. İşte her ana bölümden gerçekçi olarak çekebileceğiniz alanlar:
| Craigslist Kategorisi | Çekilebilir Alanlar | İletişim Bilgisi Var mı? |
|---|---|---|
| Konut / Daireler | Başlık, Fiyat, Metrekare, Oda sayısı, Banyo sayısı, Lokasyon, Tarih, Görseller, Açıklama, Harita bağlantısı, Uygunluk, Evcil hayvan politikası, Çamaşırhane/Otopark | ⚠️ Bazen (anonimleştirilmiş e-posta yönlendirmesi) |
| Satılık | Başlık, Fiyat, Durum, Lokasyon, Tarih, Görseller, Açıklama, Marka/Model/Yıl (değişken) | ⚠️ Bazen |
| İş İlanları | Başlık, Şirket, Ücret, Lokasyon, İş türü, Deneyim seviyesi, Tarih, Açıklama | Nadiren (yalnızca başvuru bağlantısı) |
| Hizmetler | Başlık, Lokasyon, Açıklama, Görseller | ⚠️ Bazen |
| Gigs | Başlık, Ücret, Lokasyon, Tarih, Açıklama | ⚠️ Bazen |
Birkaç önemli not:
- İletişim bilgisi: Craigslist, doğrudan e-posta scraping’i önlemek için özellikle anonimleştirilmiş e-posta yönlendirmesi kullanır. “Email çıkarır” diyen araçlar çoğu zaman ilan sahibinin gerçek e-postasını değil, yönlendirme adresini (
reply+randomstring@craigslist.org) alır. - Detay sayfası alanları — tam açıklama, tüm görseller ve gömülü iletişim bilgileri — yalnızca her bir ilana tek tek girdiğinizde görünür; arama sonuç sayfasında değil.
- Thunderbit’in “One Click Extract” özelliği, mevcut sayfada hangi alanların bulunduğunu otomatik algılar ve doğru sütun yapısını önerir. Konut çeken kullanıcıya sqft/bedrooms sütunları, iş çeken kullanıcıya compensation/job-type sütunları sunulur — manuel ayar gerekmez. Ardından gelen subpage scraping özelliği, detay sayfasındaki alanları almak için her ilanı ziyaret eder.
Yasal Gerçeklik Kontrolü: Craigslist TOS, 3Taps Davası ve Bilmeniz Gerekenler
Avukat değilim; bu yasal tavsiye değildir. Ama kullanıcıların bu konuda endişe ettiğini biliyorum ve net bir cevap vermek gerekir.
Temel emsal: Craigslist v. 3Taps (2013) davasında Craigslist, bir ihtar sonrası ilanları scrape edip yeniden yayınlayan 3Taps’e karşı ihtiyati tedbir kazandı. 3Taps’ın IP bloklarını proxy sunucularla aştığı iddia edildi ve mahkeme, blok sonrası erişimi potansiyel olarak “yetkisiz” saydı. EFF, davanın 2015’te uzlaşmayla sonuçlandığını belirtti.
Craigslist Kullanım Şartları, siteyle etkileşimde bulunmak için “robots, spiders, scripts, scrapers, crawlers veya bunların herhangi bir otomatik ya da manuel eşdeğerini” kullanmayı açıkça yasaklıyor. Hatta 24 saat içinde ilk 1.000 sayfa görüntülemeden sonra ihlaller için sayfa başına 0,25 $ sabit tazminat belirliyorlar.
Pratik rehber:
- ✅ Kamuya açık ilan verisini pazar araştırması veya kişisel kullanım için scrape edin
- ✅ robots.txt ve rate limit’e uyun
- ⚠️ Çekilen ilanları toplu şekilde yeniden yayınlamayın
- ⚠️ Çekilen iletişim bilgilerini istenmeyen pazarlama için kullanmayın
- ❌ Engellendikten sonra teknik erişim kısıtlarını aşmayın
Buradaki fark önemli: herkesin erişebildiği veriyi kendi analiziniz için toplamak ile onu topluca yeniden yayınlamak ya da spam için e-posta toplamak aynı şey değildir. Yine de Craigslist’in geçmişte şart ihlalinden IP bloklamaya ve oradan da hukuki sürece kadar gittiğini unutmayın.
Sizin İçin En İyi Craigslist Scraper Hangisi?
10 aracın hepsini test edip değerlendirdikten sonra, senaryoya göre önerim şöyle:
- Teknik olmayan, Craigslist verisine hızlıca ihtiyaç duyan iş kullanıcısı → Thunderbit. Kodsuz, AI destekli alan algılama, sıfır bakım, ücretsiz dışa aktarma. “Bu veriye ihtiyacım var” noktasından “tablomda hazır” noktasına en hızlı yol.
- Her gün tüm bölgelerde binlerce ilan çeken kurumsal ekip → Bright Data. Craigslist’e özel scraper, dev proxy altyapısı, otomatik CAPTCHA çözümü, özel destek.
- Yönetilen API/proxy altyapısı isteyen geliştirici ekip → proxy-first iş akışları için Oxylabs, actor pazaryeri esnekliği için Apify.
- Tam kontrol ve özelleştirme isteyen geliştirici → Scrapy + Playwright. Açık kaynak, maksimum esneklik; ama proxy ve bakım işini siz üstlenirsiniz.
- Bütçesi sınırlı ama orta düzey ihtiyacı olan kullanıcı → Apify ücretsiz katmanı ($5/ay kredi) veya ParseHub ücretsiz katmanı (5 proje).
- Zaten çok platformlu lead gen araçları kullanan satış ekibi → Phantombuster. Craigslist’i mevcut akışınıza ekleyin.
- Tek seferlik çekim yapan Python başlangıç seviyesindeki kişi → BeautifulSoup + requests. Az kod, az kurulum, az kapasite.
Teknik olmayan çoğu iş kullanıcısı için Thunderbit; kullanım kolaylığı, doğruluk ve maliyet arasında en iyi dengeyi sunuyor. Geliştiriciler için en güçlü kombinasyon Scrapy + Playwright. Kurumsal ölçekte ise Bright Data’yı geçmek zor.
AI destekli Craigslist scraping’in gerçekte nasıl göründüğünü görmek isterseniz, Thunderbit’i deneyin — ücretsiz katman kendi kullanım senaryonuzda test etmek için yeterli. Web scraping tekniklerinde daha derine inmek isterseniz Google Sheets’e nasıl scrape edilir, en iyi otomatik web scraping araçları ve engellenmeden web scraping rehberlerimize göz atın. Adım adım video anlatımlar için YouTube kanalımızı da inceleyebilirsiniz.
Keyifli scraping’ler — veriniz her zaman temiz, yapılandırılmış ve kullanıma hazır olsun.
SSS
Craigslist ilanlarını scrape etmek yasal mı?
Craigslist’in Kullanım Şartları otomatik scraping’i açıkça yasaklar ve Craigslist v. 3Taps davası başlıca yasal emsaldir. Kamuya açık ilan verisini kişisel veya analitik kullanım için scrape etmek, topluca yeniden yayınlama veya spam’den genellikle farklı değerlendirilir; ancak rate limit’lere ve site kurallarına her zaman uymalısınız — bu yasal tavsiye değildir.
Craigslist'i kod yazmadan scrape edebilir miyim?
Evet. Thunderbit, ParseHub ve Apify gibi araçlar Craigslist verisi çıkarmak için kodsuz veya düşük kodlu seçenekler sunar. Thunderbit’in AI destekli alan algılama özelliği işi özellikle kolaylaştırır — sadece “One Click Extract” ve ardından “Scrape” deyin.
En iyi ücretsiz Craigslist scraper hangisi?
Geliştiriciler için Scrapy veya BeautifulSoup tamamen ücretsiz ve açık kaynaklıdır (ama proxy ve bakım maliyetleri eklenir). Kod yazmayanlar için Thunderbit’in ücretsiz katmanı (ayda 6 sayfa) en iyi başlangıç noktasıdır; ParseHub’ın ücretsiz katmanı (5 proje) da başka bir seçenektir.
Craigslist'te engellenmeden nasıl scrape ederim?
Rate limiting kullanın (istekler arasında en az 2–5 saniye gecikme), user-agent’ları değiştirin, datacenter proxy’lerden kaçının (Craigslist’te residential veya ISP proxy’ler çok daha iyi çalışır) ve tahmin edilebilir tarama desenleri oluşturmayın. Orta hacimlerde, Thunderbit gibi browser tabanlı araçlar kendi Chrome oturumunuz içinde çalışarak proxy sorununu tamamen atlatır.
Tüm Craigslist bölgelerini tek seferde scrape edebilir miyim?
Scrapy veya Playwright gibi geliştirici araçlarıyla tüm 416 ABD/bölge URL’si arasında programatik döngü kurabilirsiniz. Bright Data ve Oxylabs gibi kurumsal araçlarda çok bölgeli scraping zaten yerleşik gelir. Thunderbit ile her bölgesel siteyi açıp aynı iş akışıyla scrape edebilirsiniz — AI her sayfaya otomatik uyum sağlar.
Craigslist scraping için Thunderbit'i deneyin Get Started Free
Daha Fazla Bilgi



