ตัวดึงข้อมูลโซเชียลมีเดียสำหรับข้อมูลสาธารณะข้ามแพลตฟอร์ม













เก็บข้อมูลโซเชียลสาธารณะได้ โดยไม่ต้องสร้างเวิร์กโฟลว์ใหม่ทุกครั้ง
ให้ AI จัดการเลย์เอาต์ที่เปลี่ยนไป ประมวลผลรายการ URL จำนวนมาก และเปิดหน้าที่ลิงก์ไปเมื่อจำเป็นต้องใช้รายละเอียดลึกขึ้น
เก็บข้อมูลต่อได้ แม้เลย์เอาต์หน้าจะเปลี่ยน
Thunderbit อ่านป้ายกำกับและเนื้อหาที่มองเห็นได้ แทนที่จะพึ่งพาเฉพาะตัวเลือกแบบตายตัว เมื่อโปรไฟล์สาธารณะหรือโพสต์เปลี่ยนรูปแบบ เวิร์กโฟลว์ก็ต้องซ่อมแซมน้อยลง
ประมวลผล URL ของโปรไฟล์และโพสต์เป็นชุด
วางหน้าสาธารณะที่ต้องการวิจัย แล้วประมวลผลพร้อมกัน ชื่อผู้ใช้ แคปชัน วันที่ และการมีส่วนร่วมที่มองเห็นได้จะถูกจัดออกมาเป็นแถว พร้อมสำหรับตรวจทานหรือส่งออก
ดึงรายละเอียดจากหน้าที่ลิงก์มาไว้ในตารางเดียว
เมื่อหน้ารายการเป็นเพียงจุดเริ่มต้น การดึงข้อมูลจากหน้ารองสามารถเปิดโปรไฟล์หรือโพสต์ที่เข้าถึงได้ แล้วเพิ่มรายละเอียดที่มองเห็นได้ตามที่คุณต้องการเป็นคอลัมน์ใหม่
เลิกสร้างตัวดึงข้อมูลโซเชียลแยกตามแพลตฟอร์มทีละตัว
เครื่องมือแบบดั้งเดิมจะฝังเลย์เอาต์ของแต่ละหน้าแยกกัน แต่ Thunderbit ใช้เวิร์กโฟลว์ AI เดียว และอ่านป้ายกำกับที่มองเห็นได้ของแต่ละแพลตฟอร์ม
ชุดตัวดึงข้อมูลเฉพาะแพลตฟอร์มหลายตัว
แต่ละแหล่งข้อมูลต้องตั้งค่าใหม่เพิ่มอีกครั้งเอเจนต์เดียวสำหรับหน้าสาธารณะที่คุณเลือก
Thunderbit ปรับตามฟิลด์ที่คุณต้องการ30 ฟิลด์ที่มีประโยชน์สำหรับการวิจัยโซเชียลสาธารณะ
ความพร้อมใช้งานและชื่อของเมตริกอาจต่างกันไปตามแพลตฟอร์ม ให้ระบุแพลตฟอร์มต้นทางและประเภทหน้าไว้ข้างค่าที่เก็บทุกครั้ง
- ชื่อแพลตฟอร์ม
- ประเภทหน้าต้นทาง
- URL ต้นทาง
- รหัสโปรไฟล์
- ชื่อผู้ใช้โปรไฟล์
- ชื่อที่แสดงของโปรไฟล์
- URL โปรไฟล์
- URL รูปโปรไฟล์
- ประวัติย่อโปรไฟล์
- URL เว็บไซต์ของโปรไฟล์
- สถานะการยืนยันโปรไฟล์
- จำนวนผู้ติดตาม
- จำนวนบัญชีที่ติดตาม
- จำนวนผู้ติดตามช่อง
- รหัสโพสต์
- URL โพสต์
- ข้อความหรือคำบรรยายโพสต์
- วันที่เผยแพร่โพสต์
- ประเภทโพสต์
- ประเภทสื่อ
- URL สื่อหลัก
- รายการแฮชแท็ก
- บัญชีที่ถูกกล่าวถึง
- จำนวนไลก์ของโพสต์
- จำนวนคอมเมนต์ของโพสต์
- จำนวนแชร์ของโพสต์
- จำนวนการดูของโพสต์
- รหัสคอมเมนต์
- ข้อความคอมเมนต์
- ชื่อผู้ใช้ของผู้เขียนคอมเมนต์
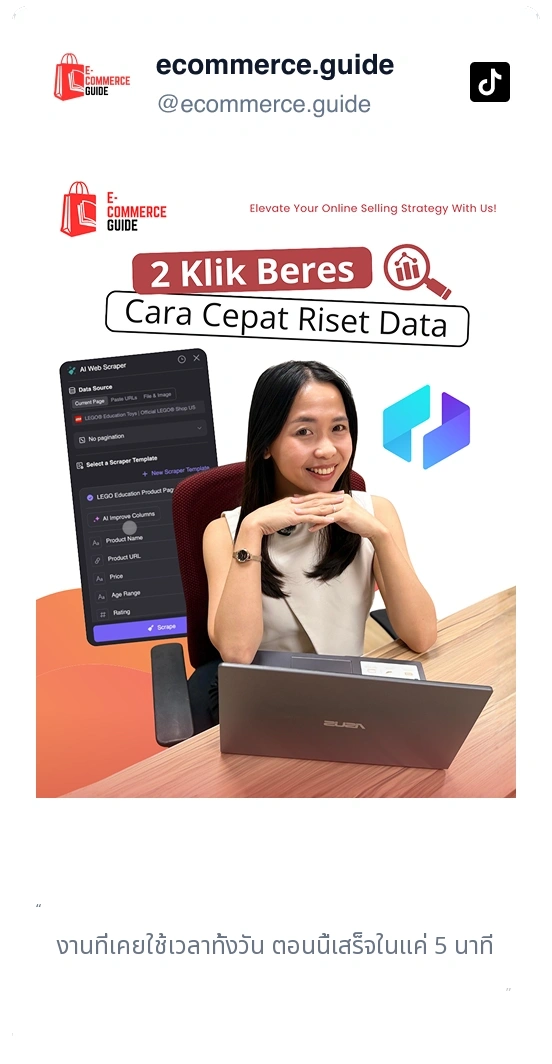
Hear how teams use one scraper across the web
Thunderbit users share how they collect public data from changing pages without maintaining a separate tool for every source.

คำถามสำหรับการสร้างชุดข้อมูลโซเชียลมีเดียที่อธิบายเหตุผลได้
ขอบเขต ความหมายของเมตริก การเข้าถึงแบบสาธารณะ และการเลือกสคีมาข้ามแพลตฟอร์ม
Switch to a platform-specific scraper when precision matters
Use dedicated TikTok comments, Telegram channel, Patreon membership, YouTube, Instagram, or X pages when the task depends on platform-only entities, fields, or interaction patterns.
เครื่องมือดึงข้อมูล Reddit แบบง่าย
ดึงโพสต์ Reddit ชื่อผู้เขียน ยอดโหวต และเนื้อหาเธรดได้ใน 2 คลิก — ไม่ต้องเขียนโค้ด ส่งออกไป Excel, Google Sheets หรือ Notion ได้ทันที เพื่อจับเทรนด์ ติดตามคอมมูนิตี้ และเปลี่ยนข้อมูล Reddit ให้เป็นอินไซต์ที่นำไปใช้ได้จริง
เรียนรู้เพิ่มเติม ->
Twitch scraper
ดึงชื่อสตรีมเมอร์ จำนวนผู้ชม และหมวดหมู่ไลฟ์สดจาก Twitch ได้ใน 2 คลิก — ไม่ต้องเขียนโค้ดหรือเซ็ตอัปอะไรให้ยุ่งยาก ติดตั้งส่วนขยายบนเบราว์เซอร์ได้ภายในไม่กี่วินาที แล้วส่งออกข้อมูลไปยัง Excel, Google Sheets หรือ Notion ได้ทันที
เรียนรู้เพิ่มเติม ->
Xiaohongshu scraper
ดึงข้อมูลโน้ตจาก Xiaohongshu — ทั้งชื่อเรื่อง เนื้อหา จำนวนไลก์ และข้อมูลผู้เขียน — แล้วส่งออกไปยัง Google Sheets, Excel หรือ Notion ได้ใน 2 คลิก ไม่ต้องเขียนโค้ด ไม่ต้องคัดลอกวาง: Thunderbit อ่านหน้าเว็บและจัดโครงสร้างข้อมูลให้คุณ
เรียนรู้เพิ่มเติม ->
Douyin scraper ฟรี
ดึงข้อมูลวิดีโอจาก Douyin — รวมถึงยอดไลก์ ยอดแชร์ และคำอธิบาย — ได้ใน 2 คลิก ส่งออกตรงไปยัง Excel, Google Sheets หรือ Notion แล้วให้ AI จัดการที่เหลือให้
เรียนรู้เพิ่มเติม ->
WhatsApp Scraper
The Thunderbit WhatsApp Scraper enables you to extract data from WhatsApp chats and group information directly from the web interface. Use AI-powered field suggestions to quickly gather messages, timestamps, sender names, group names, member counts, and more for analysis or record-keeping. Ideal for marketers, researchers, businesses, and individuals seeking structured WhatsApp data.
เรียนรู้เพิ่มเติม ->
9GAG Scraper | เครื่องมือดึงข้อมูลคอนเทนต์จาก 9GAG
Thunderbit 9GAG Scraper ใช้ระบบ AI ในการแนะนำฟิลด์ข้อมูลโดยอัตโนมัติ ช่วยให้คุณดึงข้อมูลจากโพสต์ยอดนิยมและมีมบน 9GAG ได้อย่างง่ายดาย รวบรวมหัวข้อโพสต์ รูปภาพ วิดีโอ จำนวนการกดถูกใจ และความคิดเห็นได้อย่างรวดเร็ว เหมาะสำหรับการวิเคราะห์เทรนด์โซเชียลมีเดีย การสร้างคอนเทนต์ หรือการเก็บข้อมูลวิจัยตลาด ช่วยให้คุณได้ข้อมูลที่จัดระเบียบพร้อมใช้งานทันที
เรียนรู้เพิ่มเติม ->พร้อมเร่งพลังการดึงข้อมูลของคุณหรือยัง?
เข้าร่วมกับมืออาชีพกว่า 200,000+ คนที่ใช้ Thunderbit เพื่อทำเวิร์กโฟลว์การดึงข้อมูลเว็บให้อัตโนมัติ
ทดลองใช้ฟรีพร้อมเครดิตไม่จำกัดสำหรับ 8 หน้าเว็บ



