
พิมพ์คำว่า "Thunderbit vs Oxylabs" ลงใน Google แล้วคุณอาจจะหวังให้เจอเทียบชัด ๆ แบบ Coke ปะทะ Pepsi แต่เรื่องนี้ไม่ได้ง่ายขนาดนั้น เพราะฝั่งหนึ่งคือเครื่องมือบนเบราว์เซอร์ที่คลิกแทนคุณได้ในไม่กี่วินาที ส่วนอีกฝั่งคือเครือข่ายพร็อกซีที่มี footprint ของ IP ใหญ่มากจนผู้ให้บริการโทรคมนาคมหลายรายยังต้องมองตาโต ถึงอย่างนั้น คนก็ยังค้นสองชื่อนี้คู่กันอยู่เรื่อย ๆ เพราะทั้งคู่พยายามตอบคำถามเดียวกัน: จะดึงข้อมูลจากเว็บออกมายังไง โดยไม่ต้องเสียเวลาเป็นอาทิตย์กับงานนี้
ผมใช้เวลาพอสมควรกับเส้นทางที่สลับไปมาระหว่างโลกของ "สร้างโครงสร้างพื้นฐาน" กับโลกของ "เอาข้อมูลมาให้ได้ก่อน" — เริ่มจาก Automation Anywhere ต่อด้วย Jet.com และตอนนี้มาดูแล Thunderbit อยู่ ผมเลยเข้าใจดีว่าทำไมหลายคนถึงสับสนกับตัวเลือกนี้ มันคล้ายเอาบริษัทขนย้ายมาเทียบกับกล่องสำหรับย้ายของ — ทั้งคู่ช่วยให้ของคุณจากจุด A ไปจุด B ได้เหมือนกัน แต่แบบหนึ่งคือบริการ อีกแบบคือสินค้าที่คุณเอาไปสร้างกระบวนการของตัวเอง งั้นมาแยกให้ชัดกันดีกว่าว่าคุณควรใช้ตัวไหน เพราะเชื่อเถอะว่ามันไม่ได้คลุมเครืออย่างที่หน้าเว็บการตลาดทำให้ดู
คำตอบสั้น ๆ
ถ้าเอาคำตอบสั้น ๆ ก่อนลงลึก: Thunderbit คือเว็บสแครปแบบ agentic ที่ไม่ต้องเขียนโค้ด — แค่เปิดหน้าเว็บ กด One Click Extract แล้วเครื่องมือจะช่วยเดาฟิลด์และดึงข้อมูลที่เป็นโครงสร้างให้ พร้อม Web App, Open API, MCP Server และ CLI สำหรับคนที่อยากต่อยอดลึกขึ้น ส่วน Oxylabs คือโครงสร้างพื้นฐานสำหรับการสแครประดับองค์กร — มีเครือข่ายพร็อกซี, Web Scraper API และผลิตภัณฑ์ Web Unblocker ที่ทำมาสำหรับทีมวิศวกรที่กำลังประกอบ data pipeline ของตัวเองในสเกลใหญ่
ไม่มีตัวไหน "ดีกว่า" แบบฟันธงลอย ๆ ทั้งหมดขึ้นอยู่กับว่าคุณกำลังแก้ปัญหาให้ใคร — ผู้ใช้สายธุรกิจที่ต้องการสเปรดชีตภายในวันศุกร์ หรือ data engineer ที่ต้องดูแล pipeline ให้เดินต่อเนื่องได้กับคำขอนับล้านครั้งต่อเดือน
มองแบบเร็ว ๆ
ก่อนจะเจาะทีละฟีเจอร์ ลองดูว่า 2 เครื่องมือนี้ต่างกันตรงไหน:
| มิติ | Thunderbit | Oxylabs |
|---|---|---|
| ผู้ใช้หลัก | ฝ่ายขาย, ops, ทีมวิจัย, ทีมที่ไม่ใช่สายเทคนิค และนักพัฒนาผ่าน API/MCP | Data engineer, ทีม backend, องค์กร |
| การเริ่มใช้งาน | ติดตั้งส่วนขยายเบราว์เซอร์ แล้วเปิดหน้าเว็บ | สมัครใช้งาน, สร้าง API credentials, เขียน logic สำหรับส่งคำขอ |
| ชั้นการดึงข้อมูล | แบบ agentic — AI อ่านหน้าเว็บและอนุมานฟิลด์เอง | กำหนดโดยนักพัฒนา — คุณเป็นคน parse และจัดโครงสร้างผลลัพธ์เอง |
| การรับมือ anti-bot/การ render | จัดการให้อัตโนมัติบนหน้าที่รองรับและได้รับอนุญาต | จัดการผ่าน Web Unblocker หรือการตั้งค่าระดับพร็อกซี |
| รูปแบบผลลัพธ์ | ตาราง/แถว, ส่งออกไป Sheets, Airtable, Notion | HTML ดิบ หรือ JSON ที่มีโครงสร้างสำหรับ target ที่รองรับ |
| โมเดลการสเกล | คิดตามเครดิต, เน้นตามงาน | คิดตามแบนด์วิดท์ (GB) และปริมาณคำขอ |
| การดูแลรักษา | ต่ำ — logic การดึงข้อมูลปรับตามหน้าเว็บให้ | ต่อเนื่อง — คุณต้องดูแล retry, rotation, การ parse เอง |
| การกำกับดูแล | หน้าที่ได้รับอนุญาตและใช้งานได้อย่างสอดคล้อง; ผู้ใช้ต้องดูแล compliance เอง | หลักการเดียวกัน — ลูกค้าต้องรับผิดชอบการใช้งานที่ถูกต้องตามกฎหมายและได้รับอนุญาต |
Thunderbit คืออะไร?
Thunderbit คือสิ่งที่ผมจะเรียกว่า agentic web scraper — คำว่า "agentic" สำคัญมาก เพราะหัวใจของมันคือคุณไม่ต้องมานั่งเขียน selector หรือออกแบบ schema เองทีละขั้น แค่เปิดหน้าเว็บที่คุณมีสิทธิ์เข้าถึง กด One Click Extract แล้ว agent จะตรวจจับ อ่าน และวิเคราะห์หน้าเว็บด้วยตัวเอง มันจะเสนอฟิลด์ที่เหมาะกับหน้านั้น ๆ จากนั้นปุ่ม Run Now จะปรากฏขึ้น — แต่ตรงนี้หลายคนมักพลาด: คุณไม่จำเป็นต้องกดมันด้วยซ้ำ ถ้าไม่ทำอะไรเลย การดึงข้อมูลก็จะเริ่มทำงานเอง
เวิร์กโฟลว์แบบนี้ต่างจากแนวทางหลายขั้นตอนที่เครื่องมือสแครปยุคแรก ๆ เคยใช้ และรีวิวเก่า ๆ อาจยังอธิบายไว้ เราออกแบบใหม่ให้เหลือแค่การกระทำสำคัญเพียงครั้งเดียว เพราะพูดตรง ๆ คือไม่มีใครอยากทำพิธีกรรม 5 ขั้นตอนแค่เพื่อเอาตารางราคาออกจากหน้าเว็บ

นอกจากการดึงข้อมูลแบบคลิกเดียวแล้ว คุณยังปรับแต่งผลลัพธ์ด้วยภาษาธรรมดาได้ เช่น "แสดงเฉพาะรายการใน 30 วันที่ผ่านมา" เติมข้อมูลจากหน้าย่อยเมื่อโครงสร้างเว็บไซต์รองรับ และส่งออกไป Google Sheets, Airtable หรือ Notion ได้ทันที และถ้าคุณเป็นนักพัฒนาที่อยากข้ามเบราว์เซอร์ไปเลย ก็มี Thunderbit Open API สำหรับใช้งานแบบโปรแกรม, Thunderbit MCP Server สำหรับเชื่อมการดึงข้อมูลเข้าไปใน Claude, Cursor หรือโฮสต์ AI agent อื่น ๆ และแพ็กเกจ Thunderbit CLI and Skills สำหรับเวิร์กโฟลว์แบบ terminal หรือ coding agent ทั้งหมดนี้ใช้ความฉลาดในการดึงข้อมูลชุดเดียวกัน ต่างกันแค่ว่าคุณจะเปิดประตูบานไหนให้มันทำงาน
ถ้าอยากเข้าใจภาพรวมของหมวดนี้ให้ลึกขึ้น ผมแนะนำให้อ่านบทความของเราเรื่อง AI web scraping และ web scraping without coding ซึ่งลงรายละเอียดเชิงกลไกมากกว่าที่ผมจะใส่ได้ในบทความนี้
Oxylabs คืออะไร?
Oxylabs เป็นอีกโลกหนึ่งเลย และพูดแฟร์ ๆ คือพวกเขาก็ไม่ได้พยายามเป็นคู่แข่ง Thunderbit ในความหมายแบบ "คลิกแล้วดึง" เท่าไร หน้าราคาในปัจจุบันของพวกเขาแสดงผลิตภัณฑ์หลายตัวแยกกัน ได้แก่ Web Scraper API, Web Unblocker และกลุ่มเครือข่ายพร็อกซี (residential, mobile, datacenter, ISP)
Web Scraper API คือผลิตภัณฑ์ที่ใกล้เคียงกับคำว่า "ตัวสแครป" มากที่สุด — เริ่มที่ $49/เดือน รองรับการ render JavaScript และส่งกลับ JSON ที่ผ่านการ parse หรือมีโครงสร้างแล้วสำหรับ target บางประเภท เช่น search engine, เว็บอีคอมเมิร์ซ และแพลตฟอร์มท่องเที่ยว ส่วน Web Unblocker เป็นเหมือนชั้นการเข้าถึงมากกว่า: มันจัดการ browser fingerprint, cookies, การเลือกพร็อกซี และ retry ให้อัตโนมัติ ถูกออกแบบมาเพื่อฝ่าด่านระบบ anti-bot ที่แข็งแรงบนเว็บที่ป้องกันไว้แน่น — แต่สิ่งที่คุณได้กลับมาคือ response ของหน้าเว็บ ไม่ใช่ตารางที่เรียบร้อย คุณยังต้องเป็นคนเขียน parser เอง
จากนั้นก็มีผลิตภัณฑ์พร็อกซีดิบ ๆ ซึ่งตรงตัวมาก: คือ pool ของ IP แบบ residential, mobile หรือ datacenter ที่คุณเช่าเป็น GB และสมมติว่าคุณมี browser automation, parsing และ storage pipeline ของตัวเองอยู่แล้ว นี่คือ infrastructure ในความหมายที่แท้จริง — คุณไม่ได้ซื้อผลลัพธ์สำเร็จรูป แต่ซื้อระบบท่อหลังบ้าน
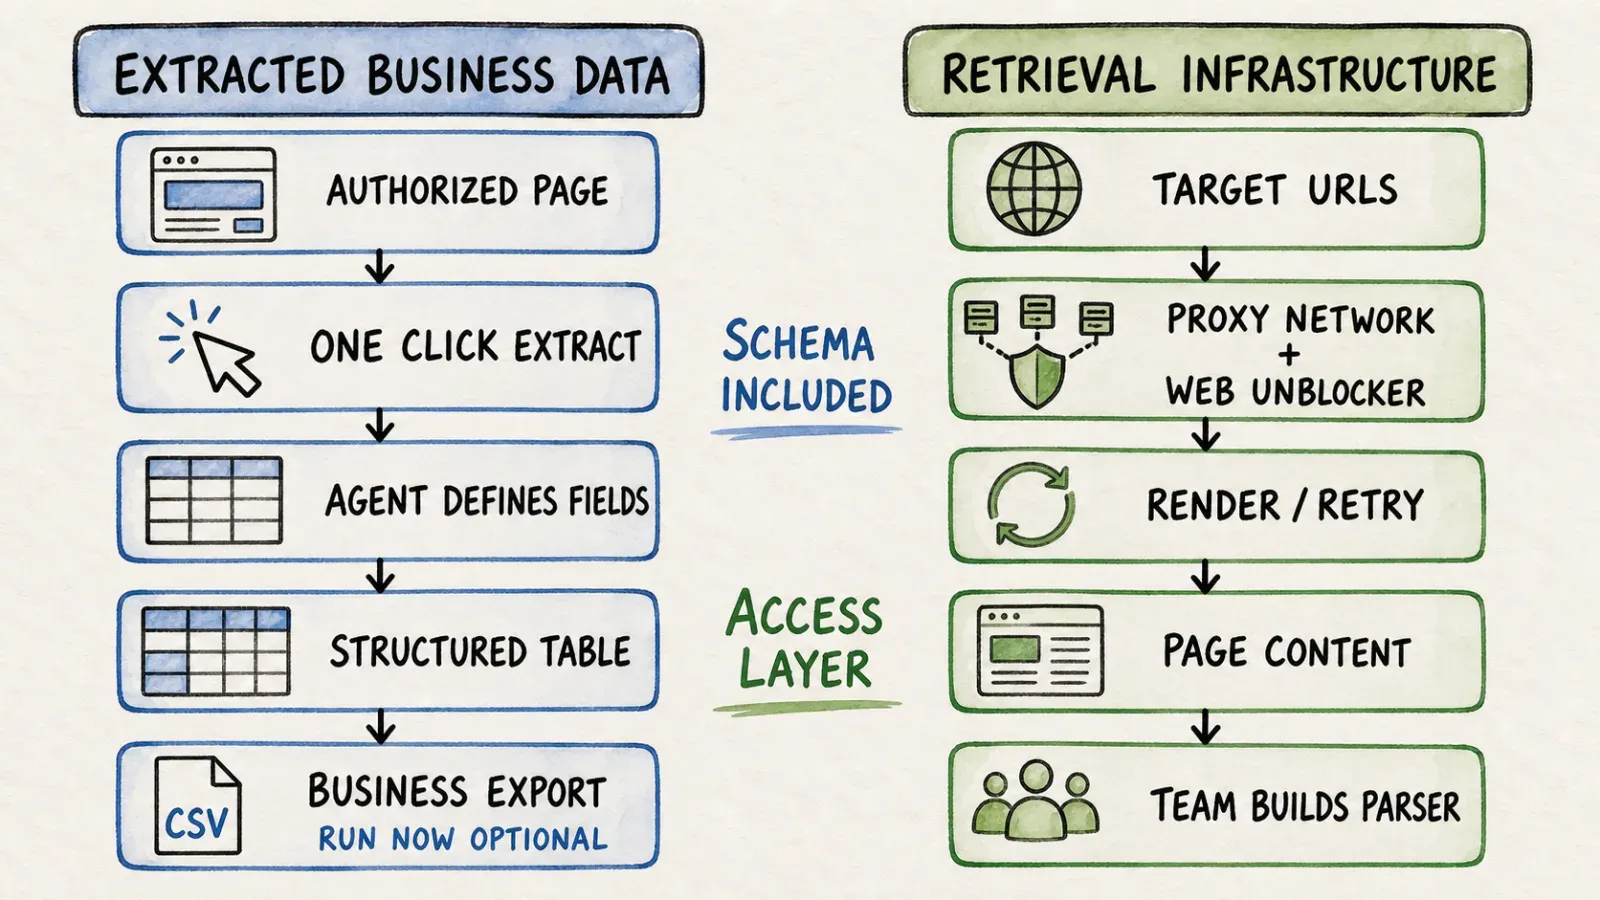
ความต่างหลัก: ข้อมูลธุรกิจที่ดึงออกมาได้ vs โครงสร้างพื้นฐานสำหรับการดึงข้อมูล
ใครเป็นคนกำหนด schema และฟิลด์?
กับ Thunderbit agent จะดูหน้าเว็บแล้วเสนอฟิลด์มาให้ เช่น ชื่อสินค้า ราคา คะแนน หรือข้อมูลที่มีอยู่จริงในหน้า จากนั้นคุณค่อยปรับด้วยภาษาธรรมดา ส่วนกับ Oxylabs ถ้าคุณไม่ได้ใช้ parser เฉพาะ target ใน Web Scraper API คุณจะต้องกำหนด schema เอง นี่ไม่ใช่การว่าทาง Oxylabs แต่เป็นการแบ่งบทบาทที่ต่างกันโดยพื้นฐาน เครื่องมือหนึ่งสมมติว่าคุณไม่อยากคิดเรื่อง schema เลย อีกเครื่องมือหนึ่งสมมติว่าคุณมีความเห็นชัดเจนเกี่ยวกับมัน และมีเวลาเชิงวิศวกรรมพอที่จะบังคับให้มันเป็นไปตามนั้น
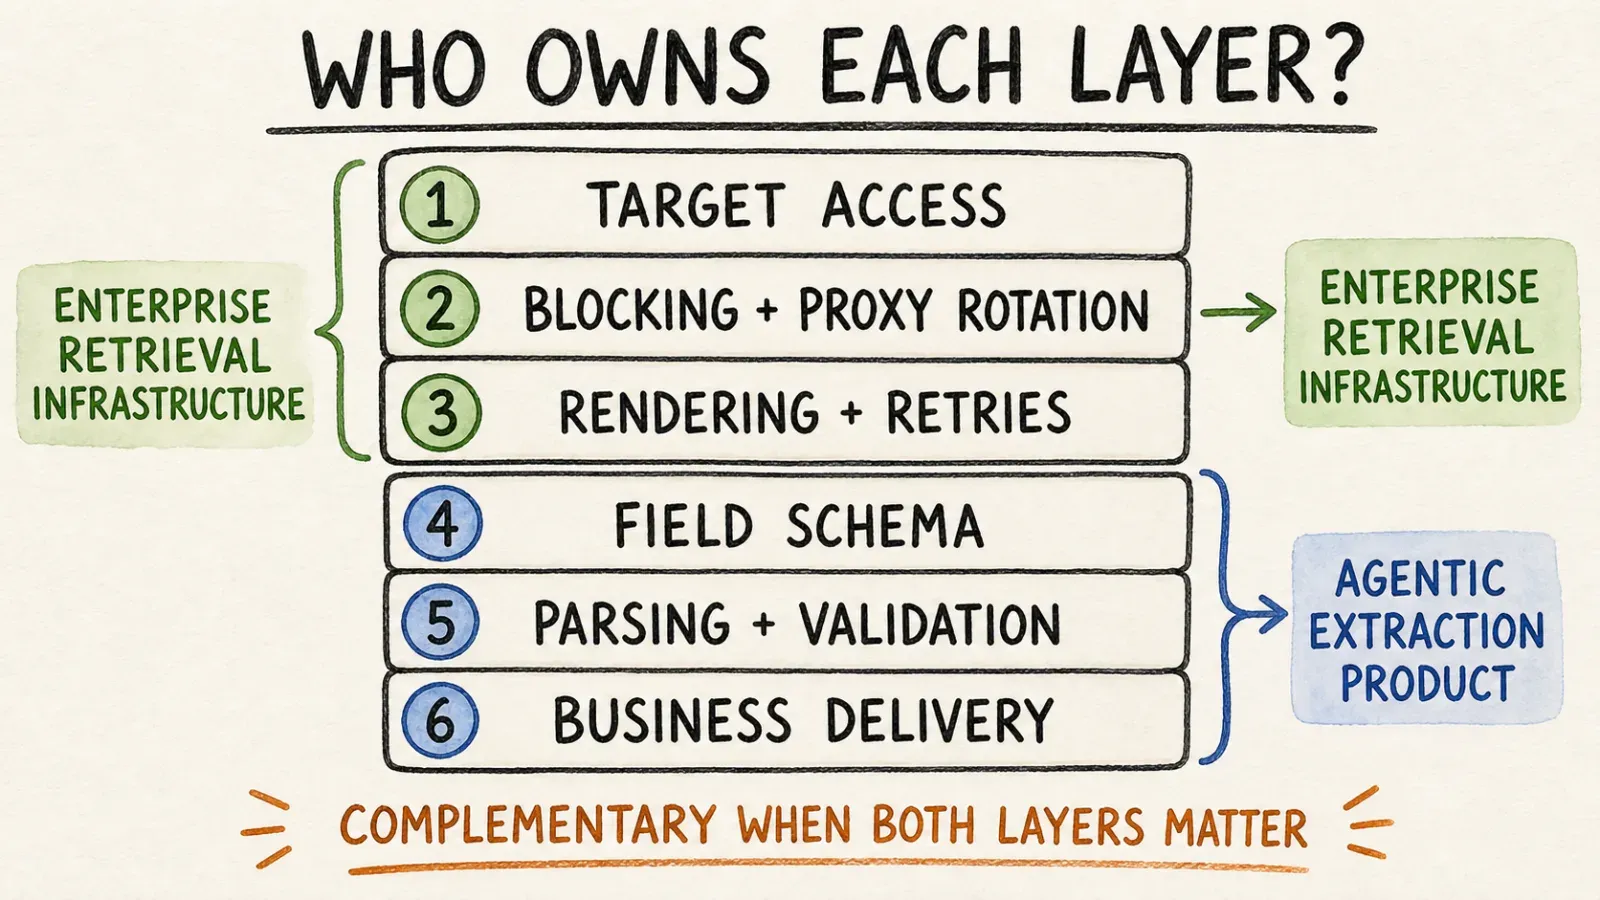
ใครจัดการ blocking, rendering และ proxy rotation?
Thunderbit จัดการ rendering และการเข้าถึงให้อัตโนมัติบนหน้าที่รองรับและได้รับอนุญาตเป็นส่วนหนึ่งของ flow การดึงข้อมูล — ไม่ต้องตั้งค่าผลิตภัณฑ์พร็อกซีแยกต่างหาก ส่วน Oxylabs แยกเรื่องนี้ออกเป็นอีกชั้นโดยเฉพาะ: Web Unblocker ถูกสร้างขึ้นมาก็เพราะการฝ่าระบบ anti-bot ที่ซับซ้อนนั้นยากพอจนควรเป็นผลิตภัณฑ์หนึ่งต่างหาก พร้อมราคาของตัวเองและเอกสารของตัวเอง ถ้า target ของคุณบล็อกแรงมาก ชั้น unblocking เฉพาะทางนี้ก็เป็นจุดแข็งจริงของ Oxylabs — เพราะถูกสร้างโดยคนที่คิดเรื่อง fingerprinting และ session management ตลอดทั้งวัน
ใครเป็นเจ้าของ monitoring และ parsing ในส่วนปลายทาง?
ตรงนี้แหละที่ความต่างระหว่าง "infrastructure" กับ "ผลลัพธ์สำเร็จรูป" ชัดที่สุด กับ Oxylabs เมื่อคุณได้ response กลับมา — ไม่ว่าจะเป็น HTML ดิบจาก Web Unblocker หรือ JSON ที่มีโครงสร้างจาก target ที่รองรับใน Web Scraper API — คุณหรือทีมของคุณต้องรับผิดชอบทุกอย่างต่อจากนั้น: validation, storage, scheduling, error handling, และ alert เมื่ออะไรพังตอนตีสอง ส่วน Thunderbit ภาระด้าน monitoring เบากว่ามาก เพราะขั้นตอนการดึงข้อมูลกับการจัดโครงสร้างเกิดพร้อมกัน และการส่งออกก็ไปยังเครื่องมือที่ทีมใช้อยู่แล้วได้เลย
เวิร์กโฟลว์แบบเทียบกันตรง ๆ
ตัวเลขไม่โกหก งั้นเรามานับขั้นตอนกันจริง ๆ แทนที่จะบอกลอย ๆ ว่าอันไหน "ง่ายกว่า"
งานดึงหน้าเว็บครั้งเดียวให้เป็นตาราง:
| ขั้นตอน | Thunderbit | Oxylabs |
|---|---|---|
| 1 | ติดตั้ง Thunderbit Chrome Extension แล้วเปิดหน้าที่ต้องการ | สมัครใช้งาน, สร้าง API credentials |
| 2 | กด One Click Extract | ตั้งค่า request payload (target, render, geolocation params) |
| 3 | Agent วิเคราะห์หน้าเว็บและเสนอฟิลด์ | ส่ง request, จัดการพารามิเตอร์ proxy/rendering |
| 4 | ปุ่ม Run Now ปรากฏขึ้น — เป็นตัวเลือกเสริม เพราะการดึงข้อมูลเริ่มเองได้อยู่แล้ว | parse response, สร้าง logic สำหรับ retry และ rotation เอง |
| 5 | ส่งออกไป Sheets/Airtable/Notion | เก็บ, ตรวจสอบ, และจัดโครงสร้างผลลัพธ์เอง |
สำหรับผู้ใช้สายธุรกิจที่แค่ต้องการตารางราคาคู่แข่งหรือรายชื่อ leads นั่นแทบจะเป็นงานคลิกเดียวด้วย Thunderbit เทียบกับงานพัฒนาเล็ก ๆ งานหนึ่งบน Oxylabs นี่ไม่ใช่การตำหนิ Oxylabs — เพราะพวกเขาไม่เคยถูกสร้างมาเพื่อข้ามขั้นวิศวกรรมอยู่แล้ว แต่ถูกสร้างมาเพื่อให้วิศวกรมีฐานที่เชื่อถือได้สำหรับต่อยอด
ระบบ crawling / data acquisition ที่ต้องทำซ้ำในสเกลใหญ่: พอเป็นกรณีนี้สมการจะกลับด้าน ถ้าคุณดึงหน้าเว็บนับล้านต่อเดือน ครอบคลุมหลายภูมิภาค และต้องรักษา SLA ที่เข้มงวด ความลึกของพร็อกซีและโครงสร้างซัพพอร์ตระดับองค์กรของ Oxylabs จะเริ่มสำคัญกว่า convenience แบบคลิกเดียว นี่คือสนามถนัดของพวกเขาจริง ๆ
การเชื่อมต่อกับ AI agent ผ่าน API หรือ MCP: ถ้าคุณกำลังต่อการดึงข้อมูลเข้ากับ workflow ของ Claude หรือ Cursor คุณอาจเลือกใช้ Thunderbit MCP Server สำหรับ structured extraction ที่ agent เป็นคนเรียก หรือใช้ Scraper API ของ Oxylabs ถ้าสิ่งที่ agent ต้องการจริง ๆ คือการเข้าถึงข้อมูลดิบ/การปลดบล็อก มากกว่าผลลัพธ์ที่จัดโครงสร้างเสร็จแล้ว ทั้งสองแบบใช้ได้ ขึ้นอยู่กับว่า agent ต้องทำอะไรกับข้อมูลหลังจากได้มันมา
ใครเหมาะกับอะไร
ผมชอบพูดเป็น persona มากกว่าพูดกว้าง ๆ ว่า "ใครควรใช้" เพราะคำพูดกว้าง ๆ นี่แหละคือที่หน้าเว็บการตลาดชอบซ่อนตัว
| Persona | ตัวเลือกที่เหมาะกว่า | เพราะอะไร |
|---|---|---|
| ฝ่ายขาย/มาร์เก็ตติ้ง ops, ผู้ใช้ธุรกิจที่ไม่เขียนโค้ด | Thunderbit | ดึงข้อมูลแบบจิ้มแล้วใช้ได้, ส่งออกตรงไป Sheets/Airtable/Notion, แทบไม่ต้องดูแลรักษา |
| Data engineer ที่สร้าง scraping pipeline ขนาดใหญ่ | Oxylabs | พร็อกซีพูลขนาดใหญ่, โครงสร้างพื้นฐานเฉพาะทาง, สเกลตามแบนด์วิดท์ |
| นักพัฒนาที่สร้าง workflow ของ AI agent | ได้ทั้งคู่ ขึ้นอยู่กับงาน | Thunderbit Open API/MCP สำหรับ structured extraction; Oxylabs Scraper API สำหรับการเข้าถึง/ปลดบล็อกแบบดิบ |
| องค์กรที่ต้องการความหลากหลายของ IP จำนวนมาก | Oxylabs | footprint ของ residential proxy คือจุดแข็งหลัก |
ถ้าจะสรุปให้เหลือประโยคเดียว: Thunderbit ตอบคำถามว่า "ฉันจะเอาข้อมูลที่ใช้งานได้ออกมาเดี๋ยวนี้ได้ยังไง" ส่วน Oxylabs ตอบคำถามว่า "ฉันจะสร้างระบบที่ดึงข้อมูลได้ต่อเนื่องไปเรื่อย ๆ ได้ยังไง"
ความแม่นยำ, การรับมือ anti-bot และการดูแลรักษา
ไม่มีเครื่องมือไหนวิเศษ และถ้าผมบอกว่าใช่ก็คงไม่จริง Thunderbit ใช้ agentic extraction ได้ดีบนหน้าที่รองรับและได้รับอนุญาต ซึ่งเป็นเงื่อนไขสำคัญ ไม่ใช่แค่เชิงการตลาด มันไม่ได้แปลว่าจะฝ่าทุก CAPTCHA, login wall หรือระบบป้องกัน automation ได้ทุกกรณีบนอินเทอร์เน็ต ส่วน Web Unblocker ของ Oxylabs ถูกออกแบบมาโดยเฉพาะเพื่อฝ่าบาง target ที่ยากพวกนั้น ด้วยการจัดการ fingerprint และ session อัตโนมัติ ซึ่งเป็นความเชี่ยวชาญที่สมควรให้เครดิตจริง ๆ
แต่จุดที่ช่องว่างกว้างขึ้นคือเรื่องการดูแลรักษา Thunderbit ปรับการตีความฟิลด์ตามการเปลี่ยนแปลงของหน้าเว็บได้ จึงลดงานคอยเฝ้าระวังที่สแครปเปอร์แบบดั้งเดิมมักต้องทำ ส่วน Oxylabs โยนภาระนี้กลับมาให้คุณ — retry, rotation logic, การอัปเดต parser เมื่อเว็บไซต์เป้าหมายเปลี่ยน HTML นี่คือราคาที่ต้องจ่ายเมื่อคุณเลือกถือ infrastructure เอง: ควบคุมได้มากขึ้น แต่ก็รับผิดชอบมากขึ้นเช่นกัน
สิ่งหนึ่งที่ทั้งสองบริษัทควรเห็นตรงกัน และควรเห็นตรงกันจริง ๆ คือ: เก็บเฉพาะข้อมูลที่คุณมีสิทธิ์เข้าถึง และเคารพเงื่อนไขการใช้งานของเว็บไซต์เป้าหมายรวมถึงกฎหมายที่เกี่ยวข้อง ไม่ว่า agent AI หรือเครือข่ายพร็อกซีก็ไม่ได้ทำให้การสแครปที่ไม่ได้รับอนุญาตกลายเป็นการสแครปที่ได้รับอนุญาต
ราคาและต้นทุนรวม
ตรงนี้แหละที่บทความเปรียบเทียบหลายชิ้นมักขี้เกียจ — เอาแค่ตัวเลขจากหน้าราคาใส่ลงไปแล้วจบ ทั้งที่จริงควรลองวางสถานการณ์ให้เห็นภาพ
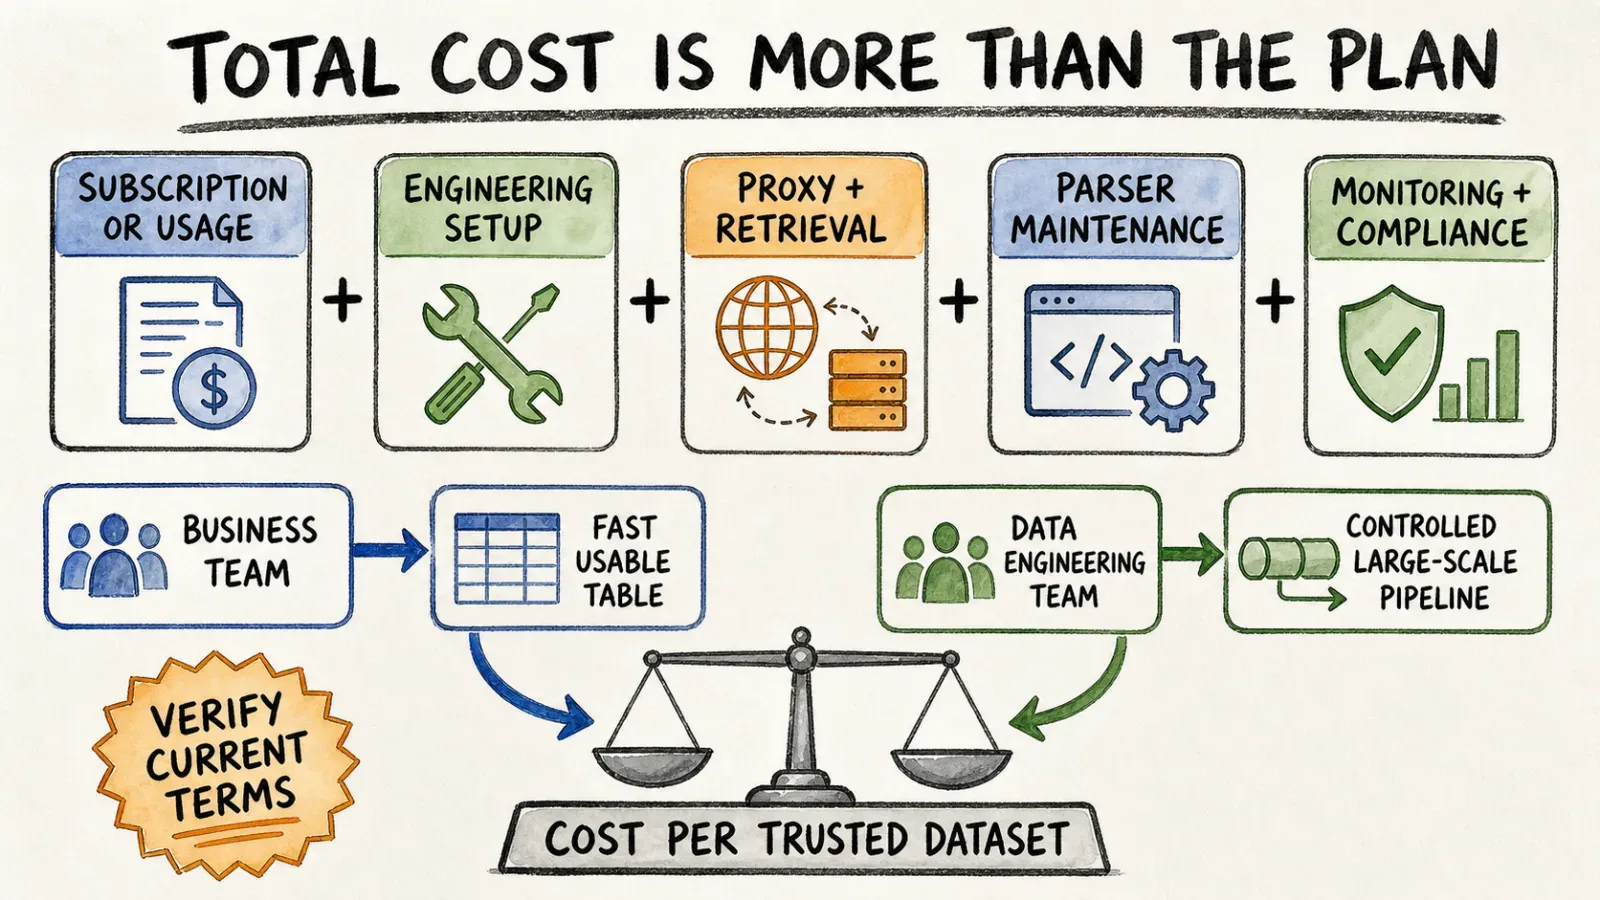
สมมติว่าคุณต้องเก็บรายการสินค้า 5,000 รายการต่อเดือนจากหน้าหมวดหมู่อีคอมเมิร์ซ และอัปเดตทุกสัปดาห์ ถ้าใช้ Web Scraper API ของ Oxylabs ที่เริ่มราว $49/เดือน คุณจะจ่ายตามผลลัพธ์และจำนวน request และถ้าต้องการชั้นการเข้าถึงที่ยากขึ้น ระดับของ Web Unblocker เริ่มตั้งแต่แผน Micro ที่ $75/เดือนสำหรับ 8GB ไปจนถึงแผน Advanced ที่ $660/เดือนสำหรับ 88GB (เป็นราคาปกติก่อนคูปองชั่วคราวใด ๆ) แต่ประเด็นคือการใช้ GB ไม่ได้สเกลแบบคาดเดาได้เสมอไป — หน้าเว็บที่ใช้ JavaScript หนักอาจกินแบนด์วิดท์เร็วกว่าเว็บ static แบบเบา ๆ และ เอกสารการ billing ของ Oxylabs เอง ก็ระบุว่าทั้ง traffic ขาเข้าและขาออกนับรวมในบิล และแม้แต่บาง response แบบ 4xx ก็อาจถูกคิดเงินได้
ในทางกลับกัน Thunderbit ใช้โมเดลแบบเครดิตที่ผูกกับงาน extraction แทนที่จะคิดจากแบนด์วิดท์ดิบ ๆ — ดังนั้นงานดึง 5,000 แถวก็จะมีค่าใช้จ่ายใกล้เคียงกับงาน 5,000 แถว ไม่ว่าหน้าเว็บนั้นจะหนัก JavaScript แค่ไหน นี่คือกรอบคิดที่ต่างกันจริง ๆ: แบบหนึ่งคิดเหมือนค่าน้ำค่าไฟ อีกแบบคิดเหมือนค่าสมาชิกรายเดือนของบริการ
ขอพูดสิ่งที่ชัดเจนแบบที่บทความเปรียบเทียบที่ซื่อสัตย์ควรพูด: หน้าราคาเปลี่ยนตลอด คูปองมีเข้า ๆ ออก ๆ และชื่อแพ็กเกจก็มีการปรับใหม่ เช็ก ราคาปัจจุบันของ Thunderbit และหน้าราคาของ Oxylabs โดยตรงก่อนวางงบ และอย่าลืมนับเวลาวิศวกรของคุณเข้าไปด้วย — rate ต่อ GB ที่ดู "ถูก" อาจไม่ได้ถูกจริง ถ้าต้องใช้ developer สองวันต่อเดือนเพื่อคอยให้ pipeline ยังทำงานได้
รีวิวบอกอะไรบ้างจริง ๆ
ผมพยายามไม่โบกธงของทีมตัวเองตรงนี้ เพราะมันไม่ช่วยคนที่กำลังหาข้อมูลจริง ๆ มากนัก เว็บไซต์รีวิวอย่าง G2 มักให้คะแนน Oxylabs สูงในด้านการดูแลลูกค้าแบบ dedicated และความเสถียรระดับองค์กร — ซึ่งก็สอดคล้องกับชนิดของลูกค้าที่บริษัทขาย infrastructure ให้ทีมวิศวกรที่ต้องรักษา SLA อยู่ตลอด ถ้าธุรกิจของคุณพึ่งพา scraping pipeline ที่ห้ามล่ม การมีทีมซัพพอร์ตที่ตอบไวมีมูลค่าจริง
ในอีกด้านหนึ่ง สัญญาณเรื่องความง่ายในการใช้งานและความคุ้มค่าในเวลาที่ได้ผลลัพธ์ มักจะเทไปทางเครื่องมือที่สร้างรอบ templates และ task-based extraction มากกว่าการตั้งค่า API ดิบ ๆ — ซึ่งก็คือสนามของ Thunderbit นั่นเอง คนละผลิตภัณฑ์ คนละเกณฑ์รีวิว และจริง ๆ แล้วทั้งสองอย่างสามารถเป็นจริงได้พร้อมกันโดยไม่ขัดแย้งกัน
ใครควรเลือก Thunderbit?
เลือก Thunderbit ถ้าคุณอยู่ในทีมฝ่ายขาย ops, ทีมวิจัย หรือมาร์เก็ตติ้ง และต้องการดึงข้อมูลแบบมีโครงสร้างจากหน้าเว็บโดยไม่ต้องรอคิวงานวิศวกรรม อีกทั้งยังเหมาะกับนักพัฒนาที่อยากให้ AI agent เป็นคนเรียกการดึงข้อมูล โดยไม่ต้องสร้าง proxy stack และ parser stack ของตัวเองตั้งแต่ศูนย์ — คุณยังได้ Open API, MCP Server และ CLI ตามต้องการ โดยไม่ต้องทิ้งตัวเลือกคลิกเดียวบนเบราว์เซอร์สำหรับงานด่วน ถ้าอยากเทียบกับเครื่องมืออื่นในหมวดนี้ บทสรุป best AI web scrapers ของเราก็เป็นจุดเริ่มต้นที่ดี
ใครควรเลือก Oxylabs?
เลือก Oxylabs ถ้าคุณเป็นทีมวิศวกรรมหรือทีมข้อมูลที่ทำงานดึงข้อมูลขนาดใหญ่ บน target ที่มีการป้องกัน และใช้ใน production จริง — งานที่ต้องการ geotargeting, การควบคุม session และ pool พร็อกซีที่ลึกพอจะรับมือกับ rate limiting ที่โหด ๆ ได้ ถ่องค์กรของคุณมี orchestration, parsing และ storage layer อยู่แล้ว และแค่ต้องการการเข้าถึงในปริมาณมากที่เชื่อถือได้ Oxylabs ก็ถูกสร้างมาสำหรับงานแบบนั้นพอดี
ใช้ร่วมกันได้ไหม?
ในทางทฤษฎีก็ได้ — องค์กรอาจใช้ Oxylabs สำหรับการเข้าถึงดิบและการปลดบล็อกในชั้น infrastructure ขณะที่แต่ละทีมใช้เครื่องมืออย่าง Thunderbit สำหรับการดึงข้อมูลแบบเร็วและมีโครงสร้างบนแหล่งข้อมูลที่ได้รับอนุญาต อย่างไรก็ตาม ผมขอระวังตรงนี้หน่อย: เท่าที่ทราบ ผมไม่เห็นว่าทั้งสองผลิตภัณฑ์มี integration อย่างเป็นทางการต่อกัน และไม่อยากพูดเกินจริงว่าเป็นพาร์ตเนอร์กันทั้งที่ไม่ได้เป็น ลองมองมันไม่ใช่ "สองผลิตภัณฑ์นี้เสียบกันได้" แต่เป็น "สองผลิตภัณฑ์นี้อยู่คนละชั้นแต่สามารถอยู่ร่วมกันได้ใน data stack ขององค์กร" จะตรงไปตรงมามากกว่า
บทสรุป
ถ้าเป้าหมายของคุณคือเส้นทางที่สั้นที่สุดจาก "หน้าเว็บ" ไปสู่ "สเปรดชีตที่ใช้ได้จริง" Thunderbit ถูกออกแบบรอบการคลิกตั้งใจเพียงครั้งเดียวที่ One Click Extract; agent จะวิเคราะห์หน้าเว็บและงานจะเริ่มทำงานอัตโนมัติ โดยที่ Run Now เป็นตัวเลือกเสริม แนวทาง Web Scraping Without Coding แบบนี้ทำให้ทีมที่ไม่ถนัดเทคนิคเข้าถึงได้ง่าย ถ้าเป้าหมายของคุณคือการเดินระบบ scraping ที่ทนทาน ปริมาณสูง และทีมวิศวกรของคุณควบคุมได้ทั้งหมด Oxylabs ก็ให้วัตถุดิบสำหรับสร้างระบบนั้น — ทั้งความลึกของพร็อกซี, การปลดบล็อก และการซัพพอร์ตระดับองค์กรที่มารองรับ
ผมไม่คิดว่าจะมีผู้ชนะที่ชนะขาดในทุกสถานการณ์ และถ้าบทความไหนบอกว่ามี ก็น่าจะกำลังพยายามขายอะไรบางอย่างให้คุณอยู่ เลือกตามคนที่จะเป็นผู้ใช้งานเครื่องมือนั้นในชีวิตจริง — ผู้ใช้ธุรกิจที่ต้องการผลลัพธ์ หรือวิศวกรที่ต้องการ infrastructure
คำถามที่พบบ่อย
Oxylabs เป็น no-code แบบ Thunderbit ไหม? ไม่ค่อยใช่ Oxylabs' Web Scraper API และ Web Unblocker เป็นผลิตภัณฑ์สำหรับนักพัฒนา — คุณส่ง API request และต้องจัดการผลลัพธ์เอง ไม่มีประสบการณ์แบบเบราว์เซอร์ที่คลิกแล้วดึงได้เทียบกับเวิร์กโฟลว์คลิกเดียวของ Thunderbit
Thunderbit มี API และ MCP สำหรับนักพัฒนาไหม? มี นอกจากส่วนขยายเบราว์เซอร์แล้ว Thunderbit ยังมี Open API สำหรับใช้งานแบบโปรแกรม, MCP Server สำหรับโฮสต์ AI agent อย่าง Claude และ Cursor และ CLI สำหรับเวิร์กโฟลว์บน terminal
ตัวไหนรับมือ target ที่มี anti-bot หนัก ๆ ได้ดีกว่า? Web Unblocker ของ Oxylabs ถูกสร้างมาเพื่อ target ที่ยากและมีการป้องกันแน่นโดยเฉพาะ พร้อมการจัดการ fingerprint และ session อัตโนมัติ ส่วน Thunderbit จัดการ rendering และการเข้าถึงบนหน้าที่รองรับและได้รับอนุญาตเป็นส่วนหนึ่งของ flow การดึงข้อมูล แต่ไม่ได้ทำการตลาดว่าเป็นเครื่องมือหลบ anti-bot โดยเฉพาะ
ตัวไหนใช้ง่ายกว่าสำหรับผู้ใช้ธุรกิจที่ไม่ใช่สายเทคนิค? Thunderbit ชัดเจนกว่ามาก คุณไม่ต้องตั้งค่า API ออกแบบ schema หรือเขียน parser — แค่คลิก ให้ agent เสนอฟิลด์ แล้วส่งออกผลลัพธ์ไป Sheets, Airtable หรือ Notion
ควรเทียบราคาของ Thunderbit กับ Oxylabs ยังไง? อย่าเทียบตัวเลขดอลลาร์ตรง ๆ เพราะโมเดลมันต่างกัน Oxylabs คิดค่าบริการหลักจากแบนด์วิดท์ (GB) และปริมาณ request ซึ่งผันตามความซับซ้อนของหน้าเว็บและการ render JavaScript ส่วน Thunderbit ใช้เครดิตที่ผูกกับงาน extraction ทำให้คาดการณ์ต้นทุนต่อ job ได้ง่ายกว่า เช็กตัวเลขล่าสุดบน หน้าราคา Thunderbit และหน้าราคาของ Oxylabs ก่อนวางงบเสมอ




