
พิมพ์คำว่า "datacenter proxy API" ลงใน Google แล้วคุณจะเจอบทความเป็นสิบ ๆ ชิ้นที่อธิบายว่า datacenter proxy คืออะไร — เร็ว, ราคาต่อ GB ถูก, ตรวจจับได้ง่าย — ซึ่งคุณน่าจะเคยอ่านย่อหน้านี้จากบล็อกของผู้ให้บริการพร็อกซีมาแล้วไม่ต่ำกว่าห้ารอบ สิ่งที่แทบไม่มีใครอธิบายจริง ๆ คือฝั่ง API: คุณจะโปรวิชัน หมุนเวียน และมอนิเตอร์พร็อกซีพวกนี้แบบอัตโนมัติได้อย่างไร แทนที่จะต้องคลิกหลังบ้านเหมือนยังอยู่ปี 2015
นั่นแหละคือประเด็นหลักของบทความนี้ ผมไล่ดูเอกสารสำหรับนักพัฒนาจริงของ Bright Data, Oxylabs และ IPRoyal โดยตรง (ไม่ใช่หน้าการตลาด — แต่เป็น API reference docs) เพื่อหาว่า "datacenter proxy API" ให้คุณควบคุมอะไรได้จริง ผู้ให้บริการแต่ละเจ้าออกแบบไม่เหมือนกันตรงไหน และภาษาที่อุตสาหกรรมใช้ร่วมกันนั้นเริ่มพังตรงไหน บอกก่อนเลยว่าไม่มีมาตรฐานกลางในเรื่องนี้ ผู้ให้บริการแต่ละรายสร้างระบบของตัวเองขึ้นมา และถ้าคิดว่าเหมือนกันหมด คุณก็มีสิทธิ์นั่งแก้ 403 อยู่สามชั่วโมงก่อนจะรู้ตัวว่ากำลังแตะผิดเลเยอร์ตั้งแต่แรก
Datacenter Proxy API คืออะไรกันแน่?
Datacenter proxy API คืออินเทอร์เฟซแบบโปรแกรม — โดยมากเป็น REST และบางครั้งมี SDK ครอบไว้อีกชั้น — ที่ให้คุณจัดการทรัพยากรของ datacenter proxy ผ่านโค้ดแทนการเข้าแดชบอร์ด เช่น การโปรวิชัน IP, ตั้งค่าการหมุน IP, เพิ่ม allowlist และดึงสถิติการใช้งาน
รายละเอียดเชิงเทคนิคที่บทความอธิบายส่วนใหญ่ข้ามไปคือ datacenter proxy API จริง ๆ ทำงานอยู่บนสองเลเยอร์ที่แยกจากกัน และการเอามาปนกันนี่แหละคือจุดเริ่มของปัญหาอินทิเกรชันส่วนใหญ่
Control plane คือชั้นจัดการบัญชี มันตอบคำถามอย่าง "บัญชีนี้มีทรัพยากรพร็อกซีอะไรบ้าง", "เพิ่มหรือเปลี่ยน subnet ได้ไหม" และ "ตอนนี้ใช้แบนด์วิดท์ไปเท่าไรแล้ว" ส่วนนี้แหละคือ API-driven ของจริง — คิดถึง POST /zone หรือ GET /whitelist
Data plane คือชั้นทราฟฟิกจริง — hostname, port และวิธี auth ที่ scraper หรือ bot ของคุณต่อเข้าไปเพื่อส่ง request ผ่านพร็อกซี นี่มักเป็นแค่ proxy URL พร้อม credentials มากกว่าจะเป็น REST call ที่ยิงทุกครั้งที่มี request
ให้นึกภาพโรงแรม: control plane คือระบบหน้าเคาน์เตอร์ที่ผู้จัดการใช้เพิ่มห้อง ตั้งราคา และดูรายงานการเข้าพัก ส่วน data plane คือกุญแจห้องจริงที่ให้แขกเปิดประตู คุณอัตโนมัติฝั่งเคาน์เตอร์ได้โดยไม่ต้องแตะล็อก และทำกลับกันก็ได้ — แต่ถ้าคิดว่าสองอย่างนี้คือระบบเดียวกัน คุณจะงงมากเวลาที่ "API call" ของคุณไม่ได้ทำให้ทราฟฟิกของ scraper เปลี่ยนเส้นทางเลย
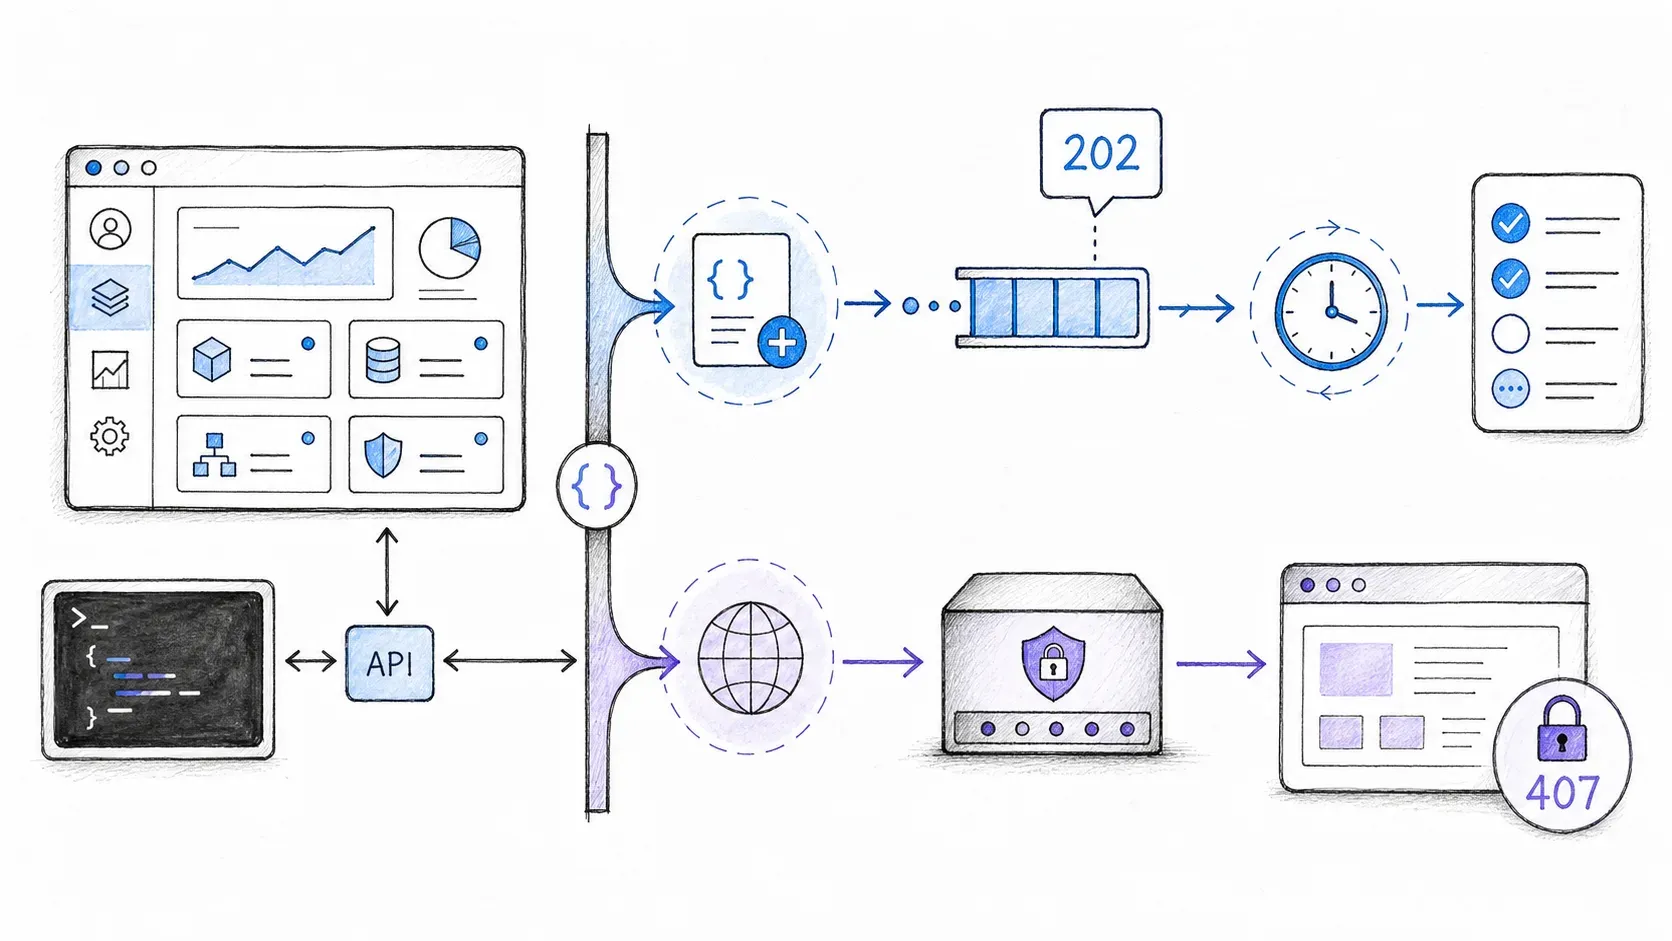
Datacenter proxy API ไม่ใช่ โปรโตคอลสากลแบบเดียวกันหมด ไม่มี endpoint /proxies หรือพารามิเตอร์ proxy_type แบบกลางที่ใช้ได้กับ Bright Data, Oxylabs และ IPRoyal ทุกเจ้า แต่ละเจ้ามี resource ของตัวเอง, auth scheme ของตัวเอง และแพ็กเกจผลิตภัณฑ์ของตัวเอง บทความที่ยกตัวอย่างโค้ดแบบกลาง ๆ แล้วทำเหมือนใช้ได้ทุกที่ กำลังพยายามทำให้เรื่องง่ายเกินจริง
Datacenter vs. Residential vs. ISP Proxies: ทบทวนสั้น ๆ
ก่อนจะลงลึกฝั่ง API มาทบทวนกันก่อนว่าจริง ๆ แล้วคุณกำลังจัดการอะไรอยู่
| ประเภทพร็อกซี | แหล่งที่มาของ IP | โครงสร้างราคาทั่วไป (ตัวอย่างจากผู้ให้บริการปี 2026) | กรณีใช้งานหลัก |
|---|---|---|---|
| Datacenter | ASN ของผู้ให้บริการคลาวด์/โฮสติ้ง | Bright Data แบบจ่ายตามการใช้งานราว $0.60/GB, แพ็กทราฟฟิกแชร์ของ Oxylabs ราว $0.59/GB และ IP แบบ dedicated ราว $2.25/IP | ค้นหาข้อมูลปริมาณมาก, ติดตามราคา, งานเก็บข้อมูลแบบไม่อ่อนไหวในสเกลใหญ่ |
| ISP (Static Residential) | ASN ฝั่งที่อยู่อาศัยแต่โฮสต์บนโครงสร้างพื้นฐาน | ราคาคล้าย residential แต่เสถียรแบบ datacenter มากกว่า | Sticky session บนเว็บไซต์ที่มีการป้องกันระดับปานกลาง |
| Residential | อุปกรณ์ผู้ใช้จริงผ่านเครือข่าย P2P | โดยทั่วไปแพงที่สุดต่อ GB เมื่อเทียบผู้ให้บริการรายใหญ่ | เป้าหมายที่มีมูลค่าสูง หรือถูกป้องกันเข้มงวด |
สังเกตคำว่า "vendor examples" — ตัวเลขพวกนี้เป็นราคาที่รายงานเองและเป็นข้อมูลตามช่วงเวลา ไม่ใช่ค่าเฉลี่ยของตลาด Bright Data, Oxylabs, IPRoyal และ Decodo ตั้งราคาต่างกันตามปริมาณ ความเป็นเอกสิทธิ์ และระยะสัญญาอยู่แล้ว ดังนั้นการเทียบตัวเลขหน้าปกของแต่ละเจ้าโดยไม่ดูหน่วยให้ตรงกัน (ต่อ IP vs ต่อ GB vs ตามระยะเวลา) มีโอกาสสูงมากที่จะพาคุณตัดสินใจซื้อผิด
แล้วคุณจัดการอะไรได้บ้างผ่าน Datacenter Proxy API? แยกดูเป็นฟีเจอร์
นี่คือส่วนที่บทความ "datacenter proxy คืออะไร" ส่วนใหญ่ไม่ค่อยลงรายละเอียด ผมเลยจะไล่ดูจากเอกสารจริงว่าผู้ให้บริการเปิดอะไรให้ใช้บ้าง — ไม่ใช่สิ่งที่ทูโทเรียลทั่วไปเดาว่าน่าจะมี
ผมดึงข้อมูลนี้จาก reference docs ของ 3 ผู้ให้บริการ ณ เดือนสิงหาคม 2026:
Bright Data's Account Management API มี operation สำหรับเพิ่ม zone, จัดการ allow/deny list, จัดการ static IP, แสดง zone ที่ใช้งานอยู่และที่มีให้ใช้, ดึงสถิติ bandwidth แบบราย zone และข้าม zone, ตรวจสอบ balance และดู zone ที่รอการเปลี่ยนแทนที่ ตัวอย่างเช่น allowlist endpoint เป็น GET ตรงไปตรงมาที่ใช้ Bearer token ในการยืนยันตัวตน ส่วนการสร้าง zone นั้น เอกสารของ Bright Data ระบุชัดว่ามีโอกาสเกิดค่าใช้จ่ายและต้องมีบทบาทบัญชีที่ถูกต้อง — นี่ไม่ใช่ endpoint แบบ "ลองเล่นดูได้เลย"
Oxylabs แยกประสบการณ์ออกเป็นสองแบบที่ต่างกันมาก Enterprise Dedicated Datacenter Proxy API รองรับการเพิ่มหรือเปลี่ยน proxy subnet, ตรวจสถานะของการเปลี่ยนแปลง และดู IP ที่ออฟไลน์อยู่ตอนนี้ — แต่ฟีเจอร์นี้อยู่ในระดับ Enterprise ไม่ใช่ว่าทุกบัญชีจะได้ใช้ ขณะที่ลูกค้าแบบ self-service จะได้แดชบอร์ดพร้อม export เป็น JSON/CSV และ gateway แบบเสถียร (ddc.oxylabs.io) ที่พอร์ตถูกแมปกับพร็อกซีที่ได้รับมอบหมาย สองผลิตภัณฑ์ที่ต่างกันมาก แต่ในบทความเปรียบเทียบมักถูกเหมารวมว่าเป็น "Oxylabs API"
IPRoyal surface ฝั่ง datacenter ที่เราดูเป็น API สำหรับ reseller บน host เฉพาะ ใช้ header X-Access-Token แทน Bearer auth ครอบคลุม products, orders, balance, การเปลี่ยน credentials และ proxy availability — แต่ endpoint สำหรับ availability ต้องเปิดใช้โดยแอดมิน และตามเอกสารของเขา ต้องมียอดใช้จ่ายสะสมถึง $10,000 ก่อนด้วย อีกเรื่องที่ควรระวังคือ IPRoyal ยกเลิก legacy API ไปตั้งแต่กันยายน 2025 ดังนั้นโค้ดตัวอย่างที่เก่ากว่านั้นมักใช้ไม่ได้แล้ว
| การทำงาน | Bright Data (Account Mgmt API) | Oxylabs (Enterprise Dedicated DC) | IPRoyal (Reseller API) |
|---|---|---|---|
| โปรวิชัน IP/subnet | มีเอกสารรองรับ (เพิ่ม zone) | มีเอกสารรองรับ (เพิ่ม/เปลี่ยน subnet) | มีเอกสารรองรับ (orders) |
| Allowlist | มีเอกสารรองรับ (/zone/whitelist) | ไม่พบในแหล่งสาธารณะที่ตรวจสอบ | มีเอกสารรองรับ (ผลิตภัณฑ์ residential มี whitelist API แยกต่างหาก) |
| การหมุน IP / ตั้ง session | จัดการผ่าน zone config ไม่ใช่พารามิเตอร์ต่อ request | ไม่อยู่ใน surface ของ API ชุดนี้ | ไม่พบในแหล่งสาธารณะที่ตรวจสอบ |
| สถิติการใช้งาน / bandwidth | มีเอกสารรองรับ (ราย zone และข้าม zone) | ไม่พบในแหล่งสาธารณะที่ตรวจสอบ | มีเอกสารรองรับ (balance) |
| Billing / เปลี่ยนแพ็กเกจ | มีบางส่วน (balance, cost totals) | จัดการผ่านแดชบอร์ด | มีเอกสารรองรับ (orders, balance) |
ข้อสรุปคือ อย่าเชื่อเมทริกซ์แบบ yes/no ทั่วไปสำหรับ proxy API เพราะแต่ละช่องขึ้นอยู่กับผู้ให้บริการ, ระดับผลิตภัณฑ์ และประเภทบัญชี ถ้าบทความเปรียบเทียบไหนโชว์เช็กลิสต์สวย ๆ แบบใช้ได้ทุกเจ้า ให้ถามกลับไปว่าเขาทดสอบระดับผลิตภัณฑ์ไหนกันแน่
ตัวอย่างโค้ด: คุยกับ Proxy API (และ Proxy Gateway)
ในชุดผลลัพธ์ SERP 13 รายการที่ผมวิเคราะห์ ไม่มีหน้าไหนโชว์โค้ด API เลย งั้นมาดูว่าทั้งสองเลเยอร์หน้าตาเป็นอย่างไรในทางปฏิบัติ ตัวอย่างต่อไปนี้เป็นเพียงภาพประกอบ — ก่อนรันอะไรกับบัญชีที่เสียเงิน ให้เช็ก docs ล่าสุดของผู้ให้บริการก่อนเสมอ
การเรียก control plane (อ่าน allowlist, ใช้ Bearer auth):
curl -X GET "https://api.brightdata.com/zone/whitelist" \
  -H "Authorization: Bearer $BRIGHTDATA_API_KEY"
การเรียก data plane (ส่งทราฟฟิกผ่าน datacenter proxy โดยใส่ credentials ใน proxy URL):
import requests

proxy_url = f"http://{username}:{password}@dc-gateway.example.com:8000"
proxies = {"http": proxy_url, "https": proxy_url}

response = requests.get("https://target-site.example.com", proxies=proxies, timeout=15)
print(response.status_code)
การ polling งาน async ของ control plane (Node.js เช่นหลังสั่งเปลี่ยน subnet):
const axios = require("axios");

async function pollJob(jobId) {
  const res = await axios.get(`https://api.provider.example.com/jobs/${jobId}`, {
    headers: { Authorization: `Bearer ${process.env.PROVIDER_API_KEY}` },
  });
  return res.data.status; // เช่น "processing" หรือ "done"
}
ตัวอย่างสุดท้ายสำคัญกว่าที่เห็น ถ้าอ้างอิงตาม RFC 9110 การตอบกลับ 202 Accepted ตั้งใจให้ยังไม่ฟันธง — เซิร์ฟเวอร์รับคำขอของคุณแล้ว แต่การทำงานยังไม่เสร็จ ดังนั้นถ้าการสั่งเปลี่ยน subnet ของคุณได้ 202 ให้ถือว่าเป็นสถานะ "รอดำเนินการ" ไม่ใช่ "สำเร็จ" และต้อง poll endpoint สถานะก่อนจะเอา IP ใหม่ไปรันทราฟฟิก
กลยุทธ์ Waterfall: แผน fallback แบบมีขอบเขตและอิงนโยบาย
นโยบาย fallback ช่วยลดต้นทุนและเพิ่มความทนทานได้ แต่ไม่มีลำดับชั้นกลางแบบสากลที่ปลอดภัยสำหรับทุกเป้าหมายหรือทุก request ให้นิยามเฉพาะเส้นทางที่ workload นี้ได้รับอนุญาต แยกความล้มเหลวตามเลเยอร์ และอนุญาตให้ retry เฉพาะเมื่อ method HTTP หรือ operation ของแอปปลอดภัยหรือ idempotent เท่านั้น
นโยบายที่พอปกป้องตัวเองได้มีลักษณะประมาณนี้:
- Route A — เส้นทางหลักที่อนุมัติแล้ว: ใช้ผู้ให้บริการ/ผลิตภัณฑ์ที่เลือกไว้สำหรับ target และข้อกำหนด session นั้น ๆ
- Route B — เส้นทางทางเลือกที่อนุมัติแล้ว: ลองใช้เฉพาะเมื่อเหตุผลของความล้มเหลวด้านเครือข่ายหรือผู้ให้บริการรองรับการเปลี่ยนเส้นทาง
- ไม่ escalate อัตโนมัติ: การได้ 403, CAPTCHA หรือ 429 ไม่ได้แปลว่าอนุญาตให้ย้ายไป residential product ทันที
- Fail closed: ถ้าเส้นทางที่อนุมัติหมดแล้ว ให้หยุด ไม่ใช่ส่งทราฟฟิกออกตรง ๆ หรือส่งผ่าน pool ที่ไม่ได้รับอนุญาตแบบเงียบ ๆ
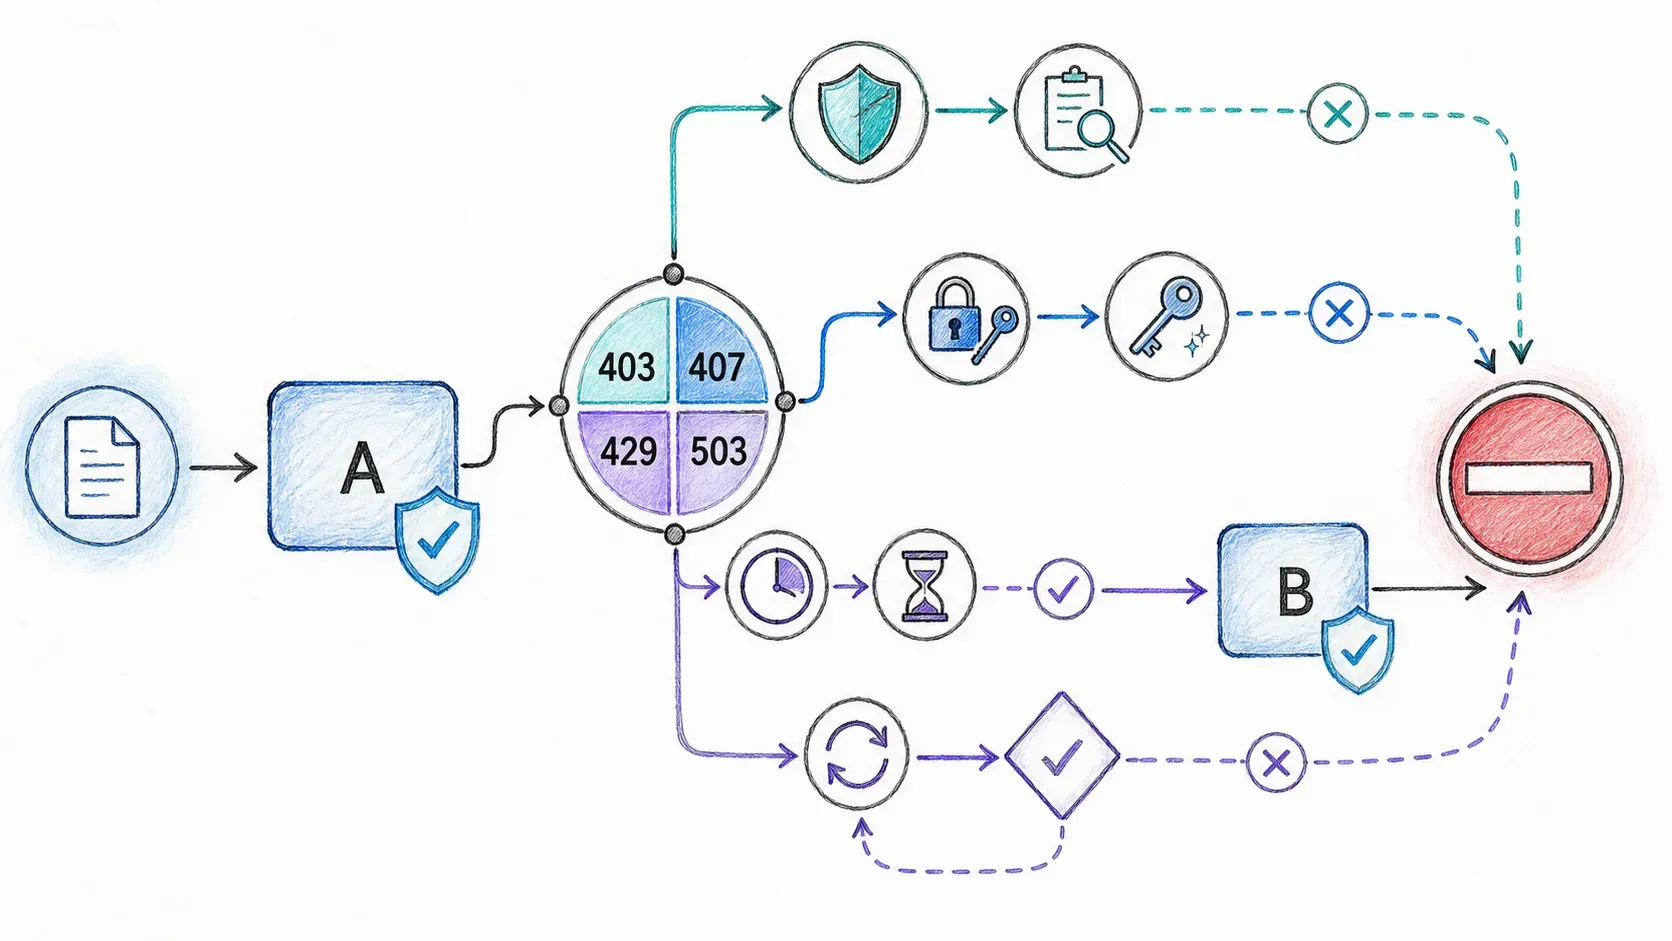
ควรเก็บ target, route, method, session policy, status class, จำนวนครั้งที่ลอง, bytes และ cost ไว้ด้วย ให้การวัดผลและสิทธิ์ของ target เป็นตัวกำหนดการ routing ในอนาคต แทนที่จะคิดไปเองว่า datacenter, ISP และ residential เป็นบันไดลำดับเดียวกัน
ผมอยากชี้เรื่องสำคัญตรงนี้ เพราะตอนหาข้อมูลผมพยายามหาเลข success-rate แบบชัด ๆ มาใส่ตารางสวย ๆ (datacenter X%, ISP Y%, residential Z%) แต่หา benchmark ที่ทำซ้ำได้และเทียบกันได้จริงสักชุดเดียวไม่ได้เลย ตัวเลขแนว "40-60% เทียบกับ 90-98%" ที่ลอยอยู่ตามฟอรัม ส่วนใหญ่ย้อนกลับไปที่คำโฆษณาของผู้ให้บริการรายใดรายหนึ่งบนชุดเป้าหมายที่ไม่ระบุชัด Cloudflare เองใน bot-score documentation อธิบายว่าระบบให้คะแนนจาก heuristic, machine learning ที่อิงคุณลักษณะ request, พฤติกรรม session และ JavaScript detection — IP reputation เป็นแค่หนึ่งในหลายอินพุต ไม่ใช่ทั้งหมด success rate ที่จริงสำหรับ target หนึ่งในวันหนึ่ง จึงแทบไม่บอกอะไรกับ target อื่นในเดือนถัดไป
ดังนั้นแทนที่จะทำตารางปลอม ให้สร้างของคุณเอง — ราย target และ log อัตโนมัติ:
| สัญญาณที่พบ | ความหมายจริง | การกระทำที่เหมาะสม |
|---|---|---|
Target 403 | เซิร์ฟเวอร์ต้นทางเข้าใจคำขอแต่ปฏิเสธ | บันทึก target + บริบท อย่าฟันธงว่า IP "ตาย" |
Proxy 407 | ต้องยืนยันตัวตนกับ proxy gateway | แก้ credentials — retry ที่ target ไม่ช่วย |
429 (target หรือ control API) | โดน rate limit อาจมี Retry-After | ทำตามเวลาที่กำหนด แล้ว retry ภายในงบ |
503 | อาจเป็นภาระงานชั่วคราวสูง | Retry อย่างระมัดระวัง อย่าเพิ่งตัดเส้นทางทิ้งทันที |
| CAPTCHA/challenge | เฉพาะแอป ไม่ใช่ HTTP code มาตรฐาน | ตรวจความสอดคล้องของ request ทั้งชุดก่อนค่อยพิจารณา escalate |
การขยับไป residential proxies ทันทีเมื่อเจอ 403 เป็นนิสัยที่พบบ่อยแต่ค่อนข้างลวก 403 บอกว่า origin ปฏิเสธคำขอ — ไม่ได้แปลโดยอัตโนมัติว่า "เส้นทางนี้โดนเผาแล้ว" หรือ "ต้องใช้ residential IP เดี๋ยวนี้" ให้ตีความแต่ละ status code ตามความหมายจริง ไม่ใช่ใช้เป็นปุ่มกด "ลอง tier ถัดไป"
ทำไมการหมุน IP อย่างเดียวอาจไม่พอ
การเปลี่ยน IP ไม่ได้ทำให้ส่วนอื่นของ request หรือ session กลมกลืนขึ้นมาทันที Cloudflare bot-score documentation ปัจจุบันบอกว่าระบบสามารถใช้ fingerprint เชิง heuristic, features และ headers ของ request, browser signals, JavaScript detections, machine learning, ข้อมูลความผิดปกติ และลักษณะของ session ได้ นั่นสนับสนุนการวินิจฉัยแบบหลายสัญญาณ ไม่ใช่การบอกว่ามีเทคโนโลยี fingerprint ตัวเดียวที่อธิบายได้ทุกความล้มเหลว
| กลุ่มสัญญาณ | การเปลี่ยน route อาจกระทบอะไร | สิ่งที่มันพิสูจน์ไม่ได้ด้วยตัวเอง |
|---|---|---|
| IP หรือ ASN reputation | ต้นทางเครือข่าย | headers, browser signals หรือสถานะ session สอดคล้องกันหรือไม่ |
| Request headers และ browser signals | ไม่ได้เปลี่ยนอะไรให้อัตโนมัติ | เป้าหมายจะยอมรับ route ใหม่หรือไม่ |
| ความสอดคล้องและพฤติกรรมของ session | ไม่ได้เปลี่ยนอะไรให้อัตโนมัติ | 403 พิสูจน์ได้ไหมว่า route ใช้ไม่ได้ |
| JavaScript detections | ไม่ได้เปลี่ยนอะไรให้อัตโนมัติ | อัตราความสำเร็จที่พกพาไปใช้กับทุกที่ได้ |
ถ้า route ใหม่ยังล้มเหลว ให้ตรวจเส้นทาง request ที่ได้รับอนุญาตทั้งหมด: นโยบายของ target, การยืนยันตัวตนของพร็อกซี, headers, โหมดการ render, สถานะ session, อัตราการยิง request และ output ของแอป หลักฐานที่มีไม่ได้ชี้ว่ามีสาเหตุหลักเพียงหนึ่งเดียว และก็ไม่ได้เปิดทางให้ escalate ไป residential แบบอัตโนมัติ
วิธีประเมิน API ของผู้ให้บริการพร็อกซี: เกณฑ์สำหรับนักพัฒนา
บทความเปรียบเทียบส่วนใหญ่จัดอันดับผู้ให้บริการพร็อกซีจากขนาด IP pool และราคาต่อ GB แต่แทบไม่มีใครประเมินประสบการณ์ของนักพัฒนาจริง ๆ — ซึ่งนี่แหละคือสิ่งที่ตัดสินว่าคุณกำลังดูแล pipeline อัตโนมัติที่เรียบร้อย หรือกำลังปะเทป retry logic ตอนตีสอง
| เกณฑ์ | สิ่งที่ควรตรวจ | ทำไมมันสำคัญ |
|---|---|---|
| สถาปัตยกรรม API | มี REST endpoints ไหม? มี SDK ไหม? มี OpenAPI spec หรือเปล่า? | ส่งผลต่อความเร็วในการอินทิเกรตและการดูแลระยะยาว |
| วิธีการยืนยันตัวตน | Bearer token vs. X-Access-Token vs. proxy user:pass | มีผลต่อวิธีป้องกัน credentials ใน CI/CD |
| การจัดการงานแบบ async | API ส่ง job ID กลับมาหรือไม่เวลาเปลี่ยน subnet? | สำคัญมากกับ automation ฝั่ง provisioning — ดูความหมายของ 202 ข้างต้น |
| Rate limit / concurrency | มีเอกสารเรื่อง request/sec และจำนวน connection พร้อมกันไหม | คอขวดของระบบที่รันในสเกลจริง |
| รายงานการใช้งาน | มี endpoint ดู bandwidth/balance แบบ real-time ไหม | ช่วยกันบิลพุ่งแบบไม่รู้ตัว |
| การสลับ pool แบบรวมศูนย์ | ใช้ API ชุดเดียวกับ DC, ISP และ residential ได้ไหม | ทำให้การสร้าง waterfall pipeline ง่ายขึ้นมาก |
| คุณภาพเอกสาร | เอกสารมีเวอร์ชัน, taxonomy ของ error และ changelog ไหม | ช่วยให้แก้ปัญหาเร็วขึ้นเมื่ออะไรพัง |
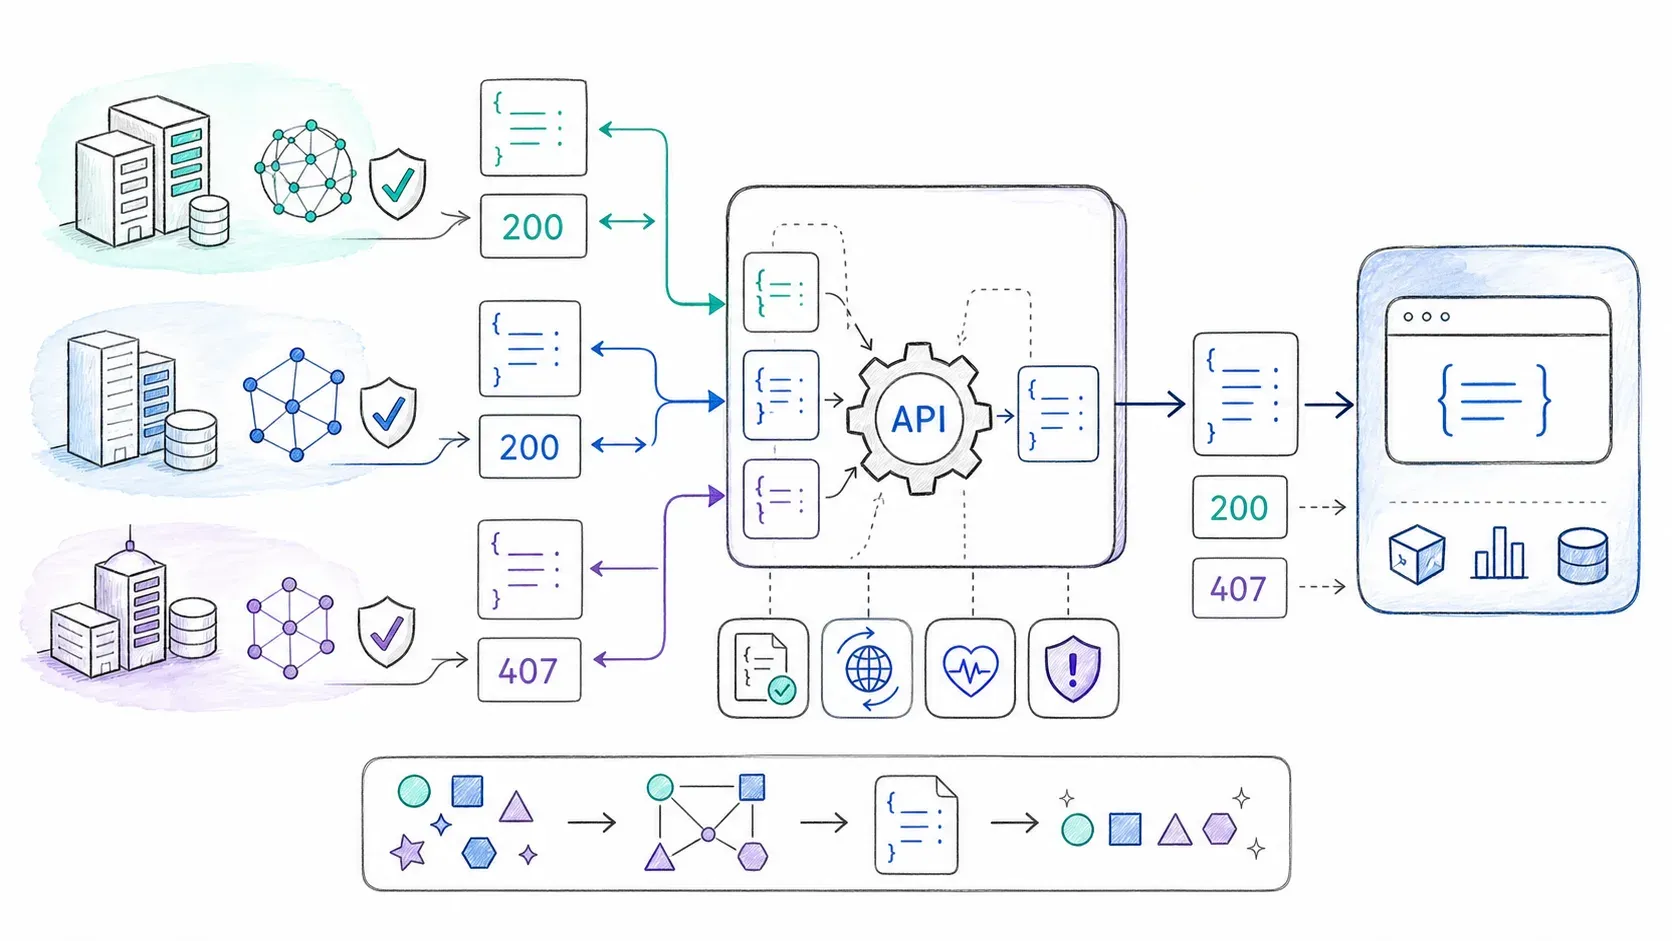
แถว "การสลับ pool แบบรวมศูนย์" สำคัญกว่าที่ดู เฟรมเวิร์กที่นักพัฒนามักบ่นกันบ่อยคืออยากรวมทุกอย่างไว้กับผู้ให้บริการเจ้าเดียว "ด้วยเหตุผลด้านการเงิน" — บิลง่ายขึ้น มีซัพพอร์ตเจ้าเดียว และมีชุด credentials เดียวให้หมุน ถ้าผู้ให้บริการบังคับให้คุณต้องอินทิเกรต API แยกกันสำหรับ datacenter กับ residential คุณกำลังจ่ายภาษีอินทิเกรชันเพิ่มจากค่าพร็อกซีไปอีกชั้นหนึ่ง
ถ้าจะใช้เกณฑ์นี้แบบตรงไปตรงมา: surface ฝั่ง account management ของ Bright Data ครอบคลุมกว้าง แต่การสร้าง zone มีความเสี่ยงด้าน billing จริงถ้าสคริปต์ไม่ระวัง Oxylabs enterprise datacenter API เหมาะกับการอัตโนมัติระดับ subnet แต่ถูกจำกัดอยู่ใน tier เฉพาะ — ส่วน self-service product เป็นประสบการณ์อีกแบบที่ง่ายกว่ามาก IPRoyal reseller API มีขอบเขตแคบกว่าและจำกัดบางฟีเจอร์ตาม threshold ของยอดใช้จ่าย ไม่มีเจ้าไหนที่ "ดีที่สุด" แบบวัตถุประสงค์ล้วน ๆ — ขึ้นอยู่กับว่าคุณกำลังซื้อ tier ไหนอยู่จริง
วิธีตั้งค่าและจัดการ Datacenter Proxy ผ่าน API แบบทีละขั้น
Step 1 — รับ credentials และยืนยัน tier ของคุณ สมัครบัญชี สร้าง API key หรือ proxy user:pass และที่สำคัญสุด ให้แน่ใจว่าคุณอยู่ใน product tier ไหน ฟีเจอร์ที่ระบุว่าเป็น "Enterprise" มักไม่มีในแพ็ก self-service
Step 2 — โปรวิชัน pool ของคุณ ใช้ control-plane API เพื่อเพิ่ม zone, subnet หรือ order แล้วแต่ศัพท์ของผู้ให้บริการ มองการทำขั้นตอนนี้เป็น action ที่ต้องตรวจทานได้ ไม่ใช่สคริปต์ยิงทิ้งอย่างเดียว — พิมพ์แผนก่อน apply เสมอ
Step 3 — ตั้งค่าการหมุน IP และ session โดยมากจะทำที่ระดับ gateway/data-plane (พารามิเตอร์ session ใน proxy URL หรือการแมปพอร์ต) ไม่ใช่ผ่าน API แยกอีกชุด
Step 4 — เชื่อมเข้ากับโค้ด scraping ของคุณ ส่ง request ผ่าน gateway โดยใช้วิธี auth ที่เอกสารระบุ — ดูว่าเป็น proxy URL ที่ฝัง credentials ไว้ หรือเป็น scheme แบบ header
Step 5 — มอนิเตอร์การใช้งานแบบโปรแกรม ตั้ง schedule ให้ poll endpoint ของ bandwidth/balance และแจ้งเตือนเมื่อมี spike แปลก ๆ อย่ารอให้บิลรายเดือนมาบอกว่าสคริปต์ใดสคริปต์หนึ่งวิ่งหลุด
Step 6 — เพิ่ม logic แบบ waterfall เข้าไป เมื่อทุกอย่างพื้นฐานทำงานแล้ว ให้เพิ่มตารางจำแนกความล้มเหลวจากก่อนหน้านี้ และใช้ log ของคุณเป็นตัวกำหนดว่า target ไหนควรใช้ tier ไหนในระยะยาว
ถ้าการดูแล control plane ของพร็อกซีไม่ใช่งานของคุณ: AI Scraping APIs
ทั้งหมดข้างต้นสมมติว่างานจริงของคุณคือการรันโครงสร้างพื้นฐานพร็อกซี แต่สำหรับหลายทีม งานจริงไม่ใช่แบบนั้น งานของพวกเขาคือเอาเว็บเพจหนึ่งหน้าแปลงเป็นข้อมูลเชิงโครงสร้าง — ส่วนเลเยอร์พร็อกซีเป็นแค่อุปสรรคที่ขวางระหว่างพวกเขากับ JSON ที่จะเอาไปลงฐานข้อมูลได้
ถ้านี่คือสถานการณ์ของคุณ AI-powered scraping API สามารถรับภาระปัญหาการจัดการพร็อกซีทั้งหมดไปเลย แทนที่จะโยนมาให้คุณทำเอง นี่ไม่ใช่ทางลัด แต่เป็นการแลกเปลี่ยนที่สมเหตุสมผล: คุณยอมเสียการควบคุม routing แบบละเอียด เพื่อไม่ต้องดูแล control plane, data plane, logic การหมุน IP และการจัดการ fingerprint เอง
ตรงนี้แหละที่ Thunderbit เข้ามามีบทบาท — ไม่ใช่ในฐานะผู้ให้บริการพร็อกซี แต่เป็นชั้นที่อยู่เหนือมัน Thunderbit Open API เปิด 2 endpoint ที่สำคัญตรงนี้: POST /distill ซึ่งแปลงหน้าเว็บที่ได้รับอนุญาตให้เป็น Markdown สะอาด ๆ (1 credit ต่อครั้ง) และ POST /extract ซึ่งคืนข้อมูลเชิงโครงสร้างตาม schema ที่จับคู่ไว้ (20 credits ต่อครั้ง) ผู้เรียกส่ง URL ที่ได้รับอนุญาตและ output ที่ต้องการไปยัง endpoint ที่เอกสารระบุไว้ แทนที่จะต้องบริหาร proxy gateway เอง โหมดการ render และความล้มเหลวเชิงโครงสร้างยังอยู่ภายใต้สัญญาบริการปัจจุบันและขีดจำกัดที่เอกสารระบุไว้
สำหรับทีมที่สร้าง AI agent มากกว่าสคริปต์ Thunderbit ยังมี MCP server มาด้วย ดังนั้นเครื่องมืออย่าง Claude หรือ Cursor จะเรียก thunderbit_distill หรือ thunderbit_extract ระหว่างทำงานได้ โดย agent ไม่ต้องไปแตะการตั้งค่าพร็อกซีเลย และสำหรับคนที่ทำงานในเทอร์มินัลเป็นหลัก Thunderbit CLI ช่วยให้คุณสั่ง thunderbit extract <url> --schema <file> จากสคริปต์หรือ cron job ได้โดยตรง พร้อมใช้ schema ซ้ำข้ามการรันแบบ batch
ขอย้ำข้อจำกัดให้ชัด: สิ่งนี้ใช้ได้กับการดึงข้อมูลสาธารณะที่ได้รับอนุญาตเท่านั้น ถ้า use case จริงของคุณคือ ad verification, การทดสอบโปรโตคอลเฉพาะทาง หรืออะไรก็ตามที่ต้องการการควบคุมพร็อกซีระดับเครือข่ายดิบ ๆ จริง ๆ datacenter proxy API ยังเป็นเครื่องมือที่ถูกต้อง — ไม่มี AI scraping API ตัวไหนแทนการครองเส้นลวดนี้ได้
| แนวทาง | สิ่งที่คุณต้องดูแล | การรับมือ anti-bot | เหมาะกับ |
|---|---|---|---|
| Datacenter Proxy API + custom scraper | พร็อกซี, การหมุน, fingerprint, parsing | คุณต้องสร้างเอง | ต้องการควบคุมละเอียด, งานเครือข่ายที่ไม่ใช่การสแครป |
| General scraping API (เช่น ScrapingBee, Scrapfly) | การเรียก API และการจัดการ output | แตกต่างกันตามสัญญาบริการของผู้ให้บริการ | งานสแครประดับกลางโดยไม่ต้องถือโครงสร้างพื้นฐานเองทั้งหมด |
| AI Scraping API (เช่น Thunderbit) | URL, output ที่ต้องการ และการตรวจสอบผลลัพธ์ | ผู้ให้บริการจัดการภายใต้ขีดจำกัดที่ระบุไว้ | ทีมที่ต้องการข้อมูลเชิงโครงสร้าง ไม่ใช่โครงสร้างพื้นฐานพร็อกซี |
ถ้าอยากดูภาพกว้างขึ้นว่า AI-based extraction เทียบกับการเขียน scraper เองเป็นอย่างไร ผมแนะนำให้ไปอ่าน web scraping คืออะไรจริง ๆ และ AI web scraping ต่างจากสคริปต์แบบดั้งเดิมอย่างไร — ทั้งสองบทความลงลึกเรื่อง landscape ของเครื่องมือมากกว่าที่บทความนี้มีพื้นที่ และถ้าอยากเห็นเวอร์ชัน no-code ของ workflow ทั้งหมดนี้ Thunderbit Chrome Extension และ วิดีโอสอนบน YouTube ก็น่าสนใจ
เคล็ดลับเชิงปฏิบัติสำหรับการจัดการ Datacenter Proxies ผ่าน API
นิสัยบางอย่างที่แยกระหว่าง pipeline ที่นิ่ง กับ pipeline ที่พังง่าย:
- ทำ allowlisting ให้เป็นอัตโนมัติใน CI/CD แทนที่จะเข้าแดชบอร์ดแก้เองทุกครั้งที่สร้าง environment ใหม่
- บันทึกการใช้ proxy tier แยกตาม target site ไม่ใช่แค่รวมภาพรวม — นี่แหละที่ทำให้กลยุทธ์ waterfall ค่อย ๆ ปรับตัวได้จริง
- มอง 403/429/503 เป็นสัญญาณคนละแบบ ไม่ใช่ปุ่มกด "หมุนพร็อกซี"
- แยก plan ออกจาก apply สำหรับ mutation ที่มีต้นทุน — พิมพ์สิ่งที่จะทำก่อนลงมือทำ
- poll usage endpoints เป็นรอบ ๆ แทนที่จะไปเจอ overage ตอนบิลมาถึง
- ใช้นโยบาย approved route เฉพาะ target — การได้ 403 หรือ challenge เพียงอย่างเดียวไม่ใช่หลักฐานว่าแพ็กพร็อกซีที่แพงกว่าจำเป็น
เรื่องกฎหมายและจริยธรรมแบบสั้น ๆ
บริการพร็อกซีคือโครงสร้างพื้นฐาน; เวิร์กโฟลว์การเก็บข้อมูลจะได้รับอนุญาตหรือไม่ ขึ้นอยู่กับเขตอำนาจศาล, ข้อมูลที่เกี่ยวข้อง, ข้อกำหนดของ target, นโยบายการใช้งานที่ยอมรับได้ของผู้ให้บริการ และการอนุญาตของผู้ใช้ บทความนี้ให้คำแนะนำเชิงเทคนิค ไม่ใช่คำปรึกษากฎหมาย ควรลดการใช้ข้อมูลส่วนบุคคลให้น้อยที่สุด บันทึกวัตถุประสงค์ทางธุรกิจและอำนาจในการเข้าถึง และปรึกษาผู้เชี่ยวชาญเมื่อเกี่ยวข้องกับประเด็นด้านความเป็นส่วนตัว สัญญา หรือข้อมูลที่มีการกำกับดูแล
ประเด็นสำคัญ
- Datacenter proxy API มีสองเลเยอร์ — control plane (จัดการบัญชี) และ data plane (เส้นทางทราฟฟิก) — และการเอาสองส่วนนี้มาปนกันคือสาเหตุหลักของความสับสนในการอินทิเกรต
- ไม่มีมาตรฐาน proxy API แบบสากล Bright Data, Oxylabs และ IPRoyal ต่างเปิด resource, auth scheme และข้อจำกัดตาม product tier ไม่เหมือนกัน
- การทำ fallback routing มีประโยชน์ก็ต่อเมื่อมีนโยบายที่ได้รับอนุญาตและเฉพาะ target ช่วยจำแนกความล้มเหลว และอนุญาตให้ retry แบบปลอดภัยหรือ idempotent; ไม่มี status code ไหนที่ให้เหตุผลพอสำหรับการ escalate ไป residential แบบอัตโนมัติ
- การหมุน IP อย่างเดียวไม่พอจะยืนยันความสำเร็จได้ เอกสาร Cloudflare ปัจจุบันชี้ว่าทั้ง request, browser, JavaScript และ session signals ล้วนมีผล
- ถ้าเป้าหมายจริงของคุณคือข้อมูลเชิงโครงสร้าง ไม่ใช่โครงสร้างพื้นฐานพร็อกซี AI scraping API อย่าง Thunderbit สามารถยกเลิกภาระของ proxy layer ไปได้ทั้งหมด
คำถามที่พบบ่อย
Datacenter proxy API คืออะไร? คืออินเทอร์เฟซแบบโปรแกรม — โดยมากเป็น REST — สำหรับจัดการทรัพยากร datacenter proxy ผ่านโค้ดแทนการใช้แดชบอร์ด มักครอบคลุม control plane (การโปรวิชัน, allowlist, สถิติการใช้งาน) ซึ่งแยกจาก data plane (gateway จริงที่ใช้ส่งทราฟฟิก)
จะจัดการ datacenter proxy ผ่าน datacenter proxy API ได้อย่างไร? รับ API credentials จากผู้ให้บริการ ยืนยัน product tier ของคุณให้ชัด (ฟีเจอร์ต่างกันมากระหว่างแพ็ก self-service กับ enterprise) โปรวิชัน proxy pool ผ่าน control-plane endpoints แล้วค่อยนำ credentials ของ gateway ไปใช้ในโค้ด scraping สำหรับ routing ทราฟฟิกจริง
Datacenter proxy API ต่างจาก scraping API ยังไง? Proxy API ให้การเข้าถึงเครือข่ายแบบดิบ — คุณยังต้องสร้างและดูแล scraper, logic การหมุน IP และการรับมือ anti-bot เอง ส่วน scraping API (โดยเฉพาะแบบ AI-native อย่าง Thunderbit) จะมีสัญญาบริการแบบ managed fetching, rendering และ extraction และส่งผลลัพธ์ที่ต้องการกลับมาโดยไม่ต้องให้คุณดูแล proxy control plane
Datacenter proxy ตรวจจับได้ง่ายไหม? ตรวจจับได้ผ่านสัญญาณจากเครือข่าย, request, browser, JavaScript และ session ไม่มีตัวเลข success rate แบบเดียวที่เชื่อถือได้และใช้ได้ทุกเว็บ เอกสาร Cloudflare bot-score documentation ปัจจุบันเป็นตัวอย่างหนึ่งของการให้คะแนนแบบหลายสัญญาณ
เมื่อไรควรใช้ residential proxies แทน datacenter proxies? ใช้ก็ต่อเมื่อการประเมินที่ได้รับอนุญาตและเฉพาะ target แสดงว่าผลิตภัณฑ์ residential ที่เลือกเหมาะกับ workload และนโยบายมากกว่าเส้นทางปัจจุบัน วิเคราะห์ 403, 407, 429, 503, ความสอดคล้องของ session และพฤติกรรมของ request แยกกัน อย่ามองสถานะใดสถานะหนึ่งเป็นสัญญาณให้ escalate อัตโนมัติ



