
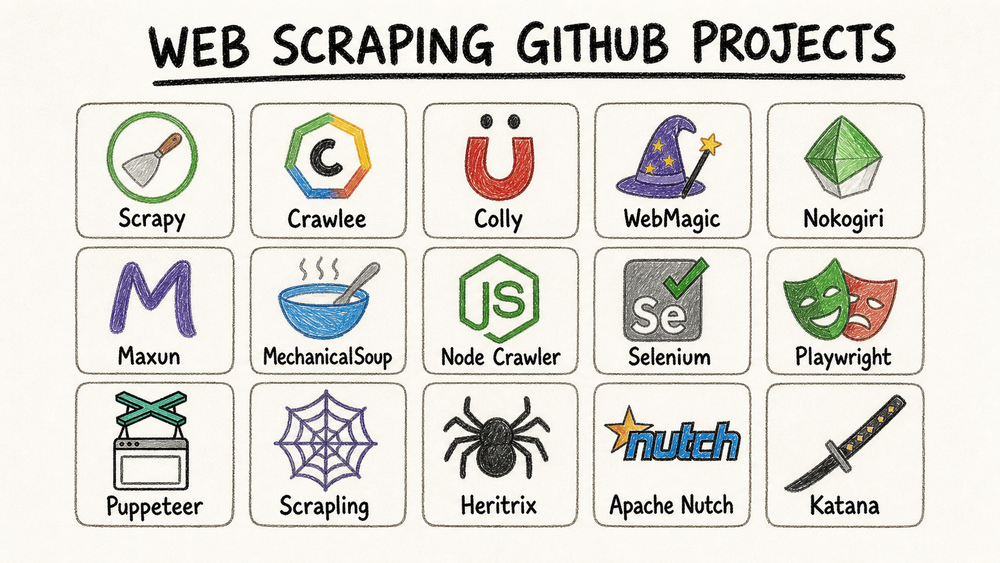
เว็บในปี 2026 ยังเต็มไปด้วยข้อมูลมีค่า แต่ทีมส่วนใหญ่ไม่ได้ต้องการแค่ “ตัวขูดข้อมูล” แบบกว้าง ๆ พวกเขาต้องการคำตอบที่ใช้งานได้จริงสำหรับหนึ่งในสามคำถามนี้มากกว่า: โปรเจกต์โอเพนซอร์สตัวไหนยังคุ้มค่าที่จะสร้างต่อ สแตกแบบไหนรับมือเว็บยุคใหม่ที่พึ่งพา JavaScript หนัก ๆ ได้ และคนที่ไม่ใช่นักพัฒนาควรข้าม GitHub ไปใช้เวิร์กโฟลว์แบบ no-code เลยหรือไม่
การอัปเดตครั้งนี้จึงออกแบบตามเส้นทางการตัดสินใจดังกล่าว ผมตรวจสอบหน้า repo บน GitHub สาธารณะ จำนวนดาว และกิจกรรมใน commit feed อีกครั้งเมื่อวันที่ 6 สิงหาคม 2026 แล้วนำโปรเจกต์ด้านล่างมาเปรียบเทียบกันในมิติของความยากในการเริ่มต้น การรองรับ JavaScript สัญญาณการดูแลรักษา ความสะดวกในการส่งออกข้อมูล และความเหมาะกับผู้ใช้งานแต่ละกลุ่ม
คำตอบแบบสั้น
- เลือก Scrapy ถ้าคุณต้องการเฟรมเวิร์ก Python สำหรับ crawl ข้อมูลแบบมีโครงสร้างและทำงานระดับใหญ่ที่成熟ที่สุด
- เลือก Crawlee ถ้าทีมของคุณใช้ JavaScript หรือ TypeScript และอยากได้สแตกเดียวที่รองรับทั้งการ scrape แบบ HTTP และแบบใช้เบราว์เซอร์
- เลือก Playwright หรือ Puppeteer ถ้าเว็บเป้าหมายใช้ JavaScript หนัก และสิ่งที่ต้องการจริง ๆ คือการควบคุมเบราว์เซอร์เต็มรูปแบบ
- เลือก Maxun ถ้าคุณอยากได้เลเยอร์ no-code แบบโอเพนซอร์ส มองเห็นการทำงานได้ชัด และโฮสต์เองได้ แทนที่จะเขียนโค้ด scrape จากศูนย์
- เลือก Heritrix, Apache Nutch หรือ Katana เฉพาะกรณีที่งานของคุณเป็นสายเฉพาะทาง เช่น การเก็บเว็บเพื่อทำ archive การ crawl แบบกระจาย หรือการสำรวจเชิงความปลอดภัย
- เลือก Thunderbit ถ้าคุณไม่ได้ตั้งใจจะสร้างบน GitHub เลย แต่อยากได้ข้อมูลลง Sheets, Airtable, Notion, CSV หรือ JSON ให้เร็วที่สุด
ลองใช้ตัวดึงข้อมูลแบบ No-Code ก่อนตัดสินใจใช้สแตกโค้ด
เปรียบเทียบแบบเร็ว ๆ
ดาวบน GitHub และสัญญาณ commit ล่าสุดด้านล่างนี้ตรวจสอบจากหน้า repo สาธารณะและ commit feed ณ วันที่ 6 สิงหาคม 2026
| โปรเจกต์ | ภาษา / โมเดล | ความยากในการตั้งค่า | รองรับ JS | เหมาะที่สุดกับ | ดาวบน GitHub | สัญญาณ commit ล่าสุด |
|---|---|---|---|---|---|---|
| Scrapy | เฟรมเวิร์ก Python | ปานกลาง | ไม่มีการเรนเดอร์ JS แบบ native | สไปเดอร์ขนาดใหญ่, ecommerce, ข่าว | 63.7k | 6 สิงหาคม 2026 |
| Crawlee | เฟรมเวิร์ก Node.js / TypeScript | ปานกลาง | มี | ทั้งการ scrape แบบ static และ dynamic ในสแตกเดียว | 25.2k | 6 สิงหาคม 2026 |
| Maxun | แพลตฟอร์ม no-code แบบโอเพนซอร์ส | ตั้งค่าการ deploy ปานกลาง, ใช้งานง่ายสำหรับผู้ใช้ | มี | ผู้ใช้งานธุรกิจที่ยังต้องการควบคุมแบบโอเพนซอร์ส | 17.1k | 5 สิงหาคม 2026 |
| MechanicalSoup | ไลบรารี Python | ง่าย | ไม่มี | ฟอร์ม, เซสชัน และเว็บ static แบบเรียบง่าย | 4.9k | 4 สิงหาคม 2026 |
| Node Crawler | Crawler สำหรับ Node.js | ปานกลาง | ไม่มี | crawl static แบบเร็วและรวมฟีดข้อมูล | 6.8k | 18 มิถุนายน 2026 |
| Heritrix | Crawler Java สำหรับ archive | ขั้นสูง | ไม่มี | การเก็บเว็บเพื่อทำ archive และการเก็บข้อมูลระดับโดเมน | 3.3k | 5 สิงหาคม 2026 |
| Apache Nutch | Crawler Java แบบกระจาย | ขั้นสูง | ไม่มี | การ crawl สไตล์ search engine และงานข้อมูลขนาดใหญ่ | 3.3k | 5 สิงหาคม 2026 |
| Selenium | ระบบอัตโนมัติเบราว์เซอร์หลายภาษา | ปานกลาง | มี | โฟลว์ที่ต้องโต้ตอบเยอะและต้องการพฤติกรรมเบราว์เซอร์จริง | 34.3k | 6 สิงหาคม 2026 |
| Playwright | ระบบอัตโนมัติเบราว์เซอร์หลายภาษา | ปานกลาง | มี | เว็บสมัยใหม่ที่ dynamic และต้องการสคริปต์ที่แข็งแรง | 94.1k | 6 สิงหาคม 2026 |
| Puppeteer | ระบบอัตโนมัติเบราว์เซอร์สำหรับ Node.js | ปานกลาง | มี | งานอัตโนมัติและ scrape ที่เน้น Chrome เป็นหลัก | 95.4k | 6 สิงหาคม 2026 |
| Scrapling | ชุดเครื่องมือ stealth scraping สำหรับ Python | ปานกลาง | มี | การ scrape ผ่านเบราว์เซอร์ที่เสี่ยงต่อการถูกบล็อก | 72.8k | 30 กรกฎาคม 2026 |
| Katana | Crawler / CLI บน Go | ปานกลาง | โหมด headless แบบเลือกใช้ได้ | งานสำรวจความปลอดภัยและค้นหา URL | 17.3k | 5 สิงหาคม 2026 |
| Colly | เฟรมเวิร์ก Go | ปานกลาง | ไม่มี | การ scrape แบบ static ที่ต้องการประสิทธิภาพสูง | 25.4k | 18 มิถุนายน 2026 |
| WebMagic | เฟรมเวิร์ก Java | ปานกลาง | ไม่มีการเรนเดอร์ JS แบบ native | ไปป์ไลน์ scrape สำหรับ Java ทั่วไป | 11.7k | 20 ธันวาคม 2025 |
| Nokogiri | ตัว parser สำหรับ Ruby | ง่าย | ไม่มี | แอป Ruby และเวิร์กโฟลว์ parsing แบบกำหนดเอง | 6.3k | 3 สิงหาคม 2026 |
| Thunderbit | ส่วนขยาย Chrome แบบ AI no-code | ใช้ได้ทันที | มี | ทีมที่ไม่ใช่สายเทคนิค แต่ต้องการข้อมูลที่ใช้งานได้เร็ว | N/A | ผลิตภัณฑ์ที่ดูแลต่อเนื่องและอัปเดตตลอด |
ก่อนเลือกโปรเจกต์บน GitHub ลองถามตัวเองก่อนว่าคุณอยากทำเวิร์กโฟลว์แบบโค้ดจริงไหม
Thunderbit ไม่ใช่โปรเจกต์บน GitHub และนั่นแหละคือเหตุผลว่าทำไมมันถึงควรอยู่ในคู่มือการตัดสินใจนี้ คนจำนวนมากที่ค้นหา “best web scraping GitHub projects” จริง ๆ แล้วไม่ได้อยากดูแลสแตก crawler เอง พวกเขาแค่อยากได้ข้อมูลที่มีโครงสร้างจากเว็บที่เปิดอยู่ตรงหน้าในวันนี้
Thunderbit คือทางออกที่สั้นที่สุดจากการวิจัยเครื่องมือ scrape แบบโค้ด ไปสู่การใช้งานจริงระดับธุรกิจ:
- เหมาะที่สุดสำหรับ: การหาลูกค้าเป้าหมาย งานติดตามข้อมูล ecommerce การรวบรวมข้อมูลอสังหาริมทรัพย์ การวิจัยเพื่อการสรรหาบุคลากร และงานปฏิบัติการที่ทำผ่านเบราว์เซอร์เป็นหลัก
- จุดเด่น: มี AI ช่วยแนะนำฟิลด์ รองรับการเติมข้อมูลจากหน้าย่อย จัดการหน้า dynamic ได้ และส่งออกไปยัง Sheets, Airtable, Notion, CSV และ JSON ได้โดยไม่ต้องเขียน logic สำหรับ scrape
- ข้อควรระวัง: ถ้างานของคุณคือแพลตฟอร์ม crawl ภายในองค์กรแบบระยะยาวที่มีโครงสร้างพื้นฐานเฉพาะตัว เฟรมเวิร์กโอเพนซอร์สยังให้คุณควบคุมได้มากกว่า
ถ้าคุณอยากเห็นเส้นทางแบบ no-code ก่อนตัดสินใจว่าจะใช้ GitHub เป็นฐานหรือไม่ วิดีโอแนะนำ Thunderbit เวอร์ชันปัจจุบันนี้คือวิธีเช็กความจริงที่เร็วที่สุด:
ลอง Thunderbit AI Web Scraper ฟรี
ผมประเมินโปรเจกต์ GitHub สำหรับ scraping เหล่านี้อย่างไร
โปรเจกต์ scraping บน GitHub ไม่ได้เทียบกันแบบตรง ๆ เสมอไป บางตัวเป็นเฟรมเวิร์กเต็มรูปแบบ บางตัวเป็นไลบรารีควบคุมเบราว์เซอร์ บางตัวเป็น parser และบางตัวก็เป็น crawler เฉพาะทางสำหรับงาน archive หรือทีมความปลอดภัย
เพื่อให้รายการนี้ใช้งานได้จริง ผมจึงคัดเฉพาะโปรเจกต์ที่ผ่านเกณฑ์ 4 ข้อนี้:
- ยังสะท้อนความเป็นจริงของตลาดอยู่
ดาวเยอะอย่างเดียวไม่พอ แต่ถ้ามีผู้ใช้ต่ำและดูแลรักษาน้อยก็มักไม่ใช่สัญญาณที่ดี - ยังมีการเคลื่อนไหวของโปรเจกต์ให้เห็น
สำหรับการอัปเดตครั้งนี้ ผมตรวจเช็กกิจกรรมใน commit feed แบบสาธารณะอีกครั้งเมื่อ 6 สิงหาคม 2026 แทนที่จะเชื่อข้อมูลสรุปเก่า ๆ - แก้ปัญหา scraping ได้จริง
ผมตัด repo ที่ดูดีแต่เฉพาะทางเกินไปและไม่ค่อยเข้ากับงานธุรกิจหรือการวิจัยในชีวิตจริง - แตกต่างกันพอที่จะใช้ตัดสินใจได้
เป้าหมายไม่ใช่การโยนรายชื่อ repo 50 ตัวใส่คุณ แต่คือช่วยให้เลือกได้ระหว่างเฟรมเวิร์ก สแตกเบราว์เซอร์ เครื่องมือ no-code แบบโอเพนซอร์ส และ crawler เฉพาะทาง
มิติที่ใช้เทียบกันก็เป็นชุดเดียวกับที่มักชี้ชะตาความสำเร็จหรือความล้มเหลวในงานจริง:
- ความยากในการตั้งค่า: ผู้ใช้ใหม่เริ่ม scrape ได้เร็วแค่ไหน
- รองรับ JavaScript: เครื่องมือรับมือเว็บที่เรนเดอร์ฝั่งไคลเอนต์ได้หรือไม่
- สุขภาพของโปรเจกต์: repo ยังดูมีชีวิตและน่าเชื่อถืออยู่ไหม
- การจัดการข้อมูล: ผลลัพธ์ที่ได้เป็นข้อมูลมีโครงสร้างหรือยังต้องไปจัดต่อเอง
- ความเหมาะกับผู้ใช้: เครื่องมือนั้นเหมาะกับมือใหม่ วิศวกรข้อมูล ทีมความปลอดภัย หรือผู้ใช้งานที่ไม่ถนัดเทคนิคจริงหรือไม่
ความยากในการตั้งค่า: เริ่มได้เร็วแค่ไหน?
การจัดระดับความยากแบบนี้ยังใช้ได้ แต่ในปี 2026 ควรคิดให้เรียบง่ายขึ้น:
- ใช้ได้ทันที: Thunderbit สำหรับผู้ใช้งานธุรกิจ; MechanicalSoup หรือ Nokogiri สำหรับสคริปต์โค้ดเบา ๆ
- ปานกลาง: Scrapy, Crawlee, Maxun, Selenium, Playwright, Puppeteer, Colly, Katana, Scrapling, WebMagic และ Node Crawler ล้วนต้องเขียนโค้ด ใช้ CLI หรือทำงานด้าน deployment บ้าง
- ขั้นสูง: Heritrix และ Apache Nutch เหมาะก็ต่อเมื่อคุณต้องการ archive หรือ crawl แบบกระจายที่ใช้ Java จริง ๆ
Maxun ควรพูดถึงเป็นพิเศษตรงนี้ เพราะมันอยู่กึ่งกลางระหว่างสองฝั่ง ตัวแพลตฟอร์มเองต้องมีการ deploy แต่ประสบการณ์ของผู้ใช้ปลายทางนั้นง่ายกว่าการใช้ Scrapy หรือ Playwright โดยตรงมาก
การรองรับคอนเทนต์แบบ Dynamic: โปรเจกต์ไหนรับมือเว็บยุคใหม่ได้?
เว็บสมัยนี้เต็มไปด้วย React, Vue, infinite scroll, การเรียก API เบื้องหลัง และโฟลว์ที่ต้องล็อกอินเยอะ ๆ เส้นแบ่งสำคัญจึงคือ “ได้ HTML” กับ “ได้ข้อมูลที่ต้องการจริง ๆ”
โปรเจกต์ในลิสต์นี้แบ่งได้เป็น 3 กลุ่ม:
- ควบคุมเบราว์เซอร์เต็มรูปแบบ: Selenium, Playwright และ Puppeteer รัน JavaScript ได้ครบ และยังเป็นตัวเลือกที่เชื่อถือได้ที่สุดสำหรับเว็บที่ต้องโต้ตอบเยอะ
- แบบไฮบริดหรือมี wrapper รองรับ: Crawlee สลับได้ระหว่างการ crawl แบบ HTTP เบา ๆ กับการ scrape ที่ใช้เบราว์เซอร์ Scrapling เติมเครื่องมือแนว stealth สำหรับเป้าหมายที่ยากกว่า ส่วน Maxun ใช้แนวทางที่อาศัยเบราว์เซอร์อยู่เบื้องหลังผ่านอินเทอร์เฟซแบบภาพ
- โดยค่าเริ่มต้นรองรับแค่ HTML static: Scrapy, MechanicalSoup, Node Crawler, Colly, WebMagic, Nokogiri, Heritrix และ Apache Nutch ไม่ได้แก้ปัญหาการเรนเดอร์เว็บสมัยใหม่ได้ด้วยตัวเอง
ถ้าคำถามใหญ่ของคุณคือ “สแตกนี้จะรับมือหน้าเว็บที่ใช้ JavaScript หนัก ๆ ได้ไหม โดยที่ผมไม่ต้องเขียนทุกขั้นตอนของเบราว์เซอร์เอง?” วิดีโอสอน Playwright สำหรับ scrape เวอร์ชันปัจจุบันนี้เป็นจุดเช็กความจริงตรงกลางหน้าที่ดีที่สุด:
สุขภาพของโปรเจกต์: repo ไหนยังน่าเชื่อถือในปี 2026?
เวอร์ชันบทความปี 2025 พึ่งจำนวนดาวและโน้ตอัปเดตเก่า ๆ มากเกินไป ซึ่งตอนนี้ไม่พอแล้ว ผมจึงตรวจทั้งจำนวนดาวปัจจุบันและสัญญาณ commit ล่าสุดอีกครั้งเมื่อ 6 สิงหาคม 2026
ภาพรวมที่ดูแข็งแรงเป็นแบบนี้:
- ยัง active ชัดเจน: Scrapy, Crawlee, Maxun, MechanicalSoup, Heritrix, Apache Nutch, Selenium, Playwright, Puppeteer, Scrapling, Katana และ Nokogiri ล้วนมี commit สาธารณะในช่วง 2 สัปดาห์ก่อนวันตรวจสอบ
- ยังใช้งานได้ แต่เคลื่อนไหวช้ากว่า: Colly และ Node Crawler มี commit ล่าสุดวันที่ 18 มิถุนายน 2026 ทั้งคู่ ยังดูใช้ได้ แต่จะอัปเดตเป็นช่วง ๆ มากกว่ารายสัปดาห์เหมือน Playwright หรือ Crawlee
- ควรระวังมากขึ้น: WebMagic คือช่องว่างที่ชัดที่สุดในลิสต์นี้ สัญญาณ commit สาธารณะล่าสุดที่ผมพบคือ 20 ธันวาคม 2025 ดังนั้นผมจะมองว่าโปรเจกต์นี้ “เสถียร” มากกว่าจะมองว่า “กำลังพัฒนาอย่างต่อเนื่อง”
สิ่งนี้สำคัญ เพราะรูปแบบการดูแลรักษาควรมีผลต่อ shortlist ของคุณ:
- ถ้าคุณต้องการค่าเริ่มต้นที่ปลอดภัยสำหรับงานวิศวกรรมใหม่ ให้เอนเอียงไปทาง repo ที่ active ชัดเจนกว่า
- ถ้าเครื่องมือเรียบง่ายและ use case แคบ การเคลื่อนไหวช้าก็ยังรับได้
- ถ้าโปรเจกต์เป็นสายเฉพาะทาง ให้ดูความเหมาะกับงานก่อน ไม่ใช่ดูแค่ว่ามี release ทุกสัปดาห์หรือไม่
15 โปรเจกต์ Web Scraping บน GitHub ที่ดีที่สุดในปี 2026
เฟรมเวิร์กสำหรับงาน scrape ขนาดใหญ่หรือใช้งานทั่วไป
1. Scrapy
Scrapy ยังเป็นคำตอบเริ่มต้นของสาย Python เมื่อโจทย์ใหญ่เกินกว่าจะใช้สคริปต์สั้น ๆ ถ้าคุณต้องการ spiders, pipelines, middleware, throttling, retries และ ecosystem ที่โตเต็มที่ มันยังเป็นตัวเลือกโอเพนซอร์สที่ปลอดภัยที่สุดในลิสต์นี้
- การตั้งค่า: ปานกลาง
- เหมาะที่สุดสำหรับ: แคตตาล็อก ecommerce, การ scrape ไดเรกทอรี, การ crawl ข่าว และระบบ scrape ภายในองค์กรที่ใช้งานระยะยาว
- รองรับ JS: ไม่มีการเรนเดอร์ native; ถ้าต้องใช้ให้จับคู่กับ Playwright หรือ Selenium
- เหตุผลที่ควรเลือก: สถาปัตยกรรม成熟, เอกสารแข็งแรง และเป็นหนึ่งในตัวเลือกที่สมดุลระหว่างพลังกับชุมชนที่ดีที่สุด
- ข้อควรระวัง: ถ้าคุณไม่เคยทำงานกับ crawler framework มาก่อน เส้นโค้งการเรียนรู้จะค่อนข้างจริงจัง
ถ้าคุณอยากประเมินก่อนว่าทาง Scrapy เหมาะกับคุณไหม วิดีโอสอนสำหรับมือใหม่เวอร์ชันนี้ยังมีประโยชน์มาก:
2. Crawlee
Crawlee กลายเป็นตัวเลือกเฟรมเวิร์กที่น่าสนใจที่สุดสำหรับ JavaScript หรือ TypeScript เมื่อคุณต้องการโปรเจกต์เดียวที่ครอบคลุมได้ทั้งการ crawl แบบเบาและการ scrape ที่ใช้เบราว์เซอร์เป็นฐาน ความสามารถในการสลับระหว่างโหมด HTTP-first กับโฟลว์ที่ขับเคลื่อนด้วย Playwright หรือ Puppeteer คือจุดแข็งจริง ๆ
- การตั้งค่า: ปานกลาง
- เหมาะที่สุดสำหรับ: ทีม JS และ TS, เป้าหมายทั้ง static และ dynamic, และเครื่องมือภายในที่เน้น automation
- รองรับ JS: ใช่
- เหตุผลที่ควรเลือก: โมเดลรันไทม์ยืดหยุ่น ตัวช่วยกันบล็อกดี และประสบการณ์ด้านเบราว์เซอร์ใช้ง่ายกว่า stack เก่าที่ทำได้แค่ crawl
- ข้อควรระวัง: เหมาะที่สุดเมื่อทีมของคุณคุ้นเคยกับ Node.js อยู่แล้ว
3. Colly
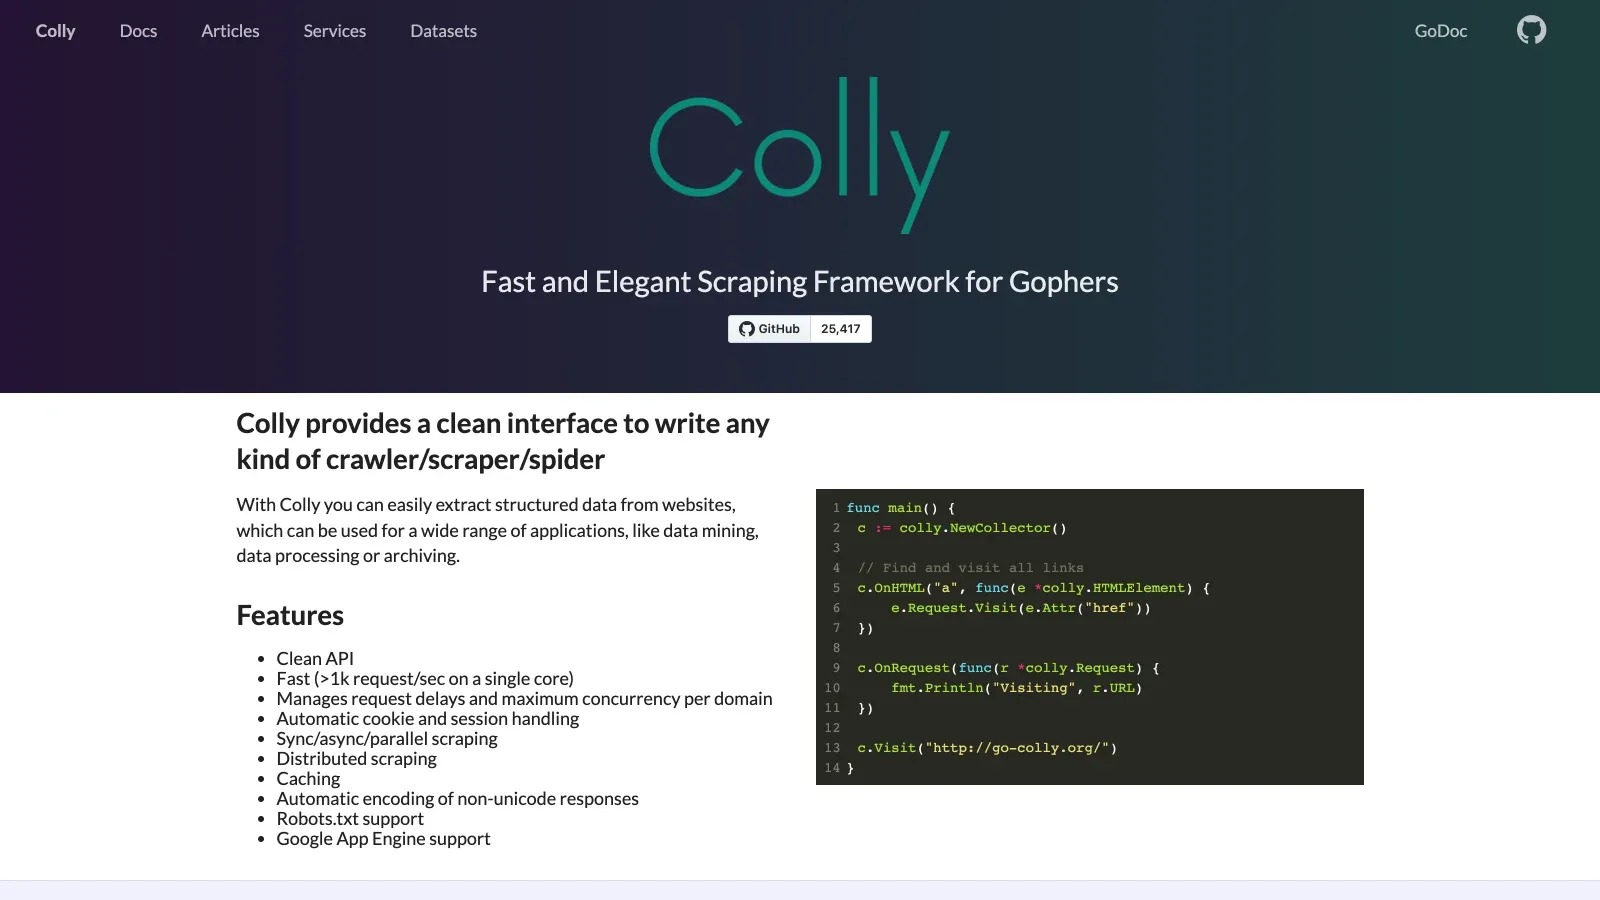
Colly ยังเป็นหนึ่งในตัวเลือก Go ที่เร็วและสะอาดที่สุดสำหรับทีมที่ไม่ต้องการการเรนเดอร์ผ่านเบราว์เซอร์โดยค่าเริ่มต้น มันเร็ว เรียบ และใช้งานได้จริงเมื่อคอขวดอยู่ที่ปริมาณงาน ไม่ใช่ความซับซ้อนของอินเทอร์เฟซ
- การตั้งค่า: ปานกลาง
- เหมาะที่สุดสำหรับ: นักพัฒนา Go ที่สร้าง crawler แบบ static ความเร็วสูง
- รองรับ JS: ไม่มีการเรนเดอร์ native
- เหตุผลที่ควรเลือก: ควบคุม concurrency ได้ดี จำกัดอัตราได้ และ API ใช้งานลื่นสำหรับงานที่มี throughput สูง
- ข้อควรระวัง: ไม่ใช่ตัวเลือกที่เหมาะถ้าการควบคุมเบราว์เซอร์คือความต้องการหลัก
4. WebMagic
WebMagic ยังเป็นตัวแทนฝั่ง Java สำหรับทีมที่ชอบโมเดลแบบ Scrapy แต่ต้องการอยู่ใน ecosystem ของ JVM ต่อไป มันยังสมเหตุสมผลสำหรับองค์กรสาย Java แม้ภาพรวมความนิยมจะน้อยกว่า Python หรือ Node
- การตั้งค่า: ปานกลาง
- เหมาะที่สุดสำหรับ: ไปป์ไลน์ scrape ที่ใช้ Java
- รองรับ JS: ไม่มีการเรนเดอร์ native
- เหตุผลที่ควรเลือก: มี scheduler, pipeline และโครงสร้างเฟรมเวิร์กที่เข้าใจง่าย
- ข้อควรระวัง: ecosystem เงียบกว่าตัวเลือกใหญ่ฝั่ง Python และ Node และสัญญาณ commit ล่าสุดที่ผมพบคือ 20 ธันวาคม 2025 ดังนั้นควรมองว่าเป็นเครื่องมือที่เสถียรมากกว่ากำลังพัฒนาอย่างคึกคัก
5. Nokogiri
Nokogiri ไม่ใช่ crawler framework มันคือ parser ที่นักพัฒนา Ruby ยังหยิบมาใช้เมื่ออยากจัดการ HTML หรือ XML อย่างสะอาดภายในสคริปต์หรือ flow ของแอปพลิเคชันที่เขียนเอง
- การตั้งค่า: ง่าย
- เหมาะที่สุดสำหรับ: แอป Ruby และ Rails ที่ต้อง parsing มากกว่าการมี crawler framework เต็มรูปแบบ
- รองรับ JS: ไม่มี
- เหตุผลที่ควรเลือก: เร็ว เสถียร และมีแนวทางการใช้งานที่ปลอดภัยเป็นค่าเริ่มต้น
- ข้อควรระวัง: คุณยังต้องเตรียมชั้น HTTP, session หรือเบราว์เซอร์เอง
โปรเจกต์สาย static ขนาดเบาและเหมาะกับผู้เริ่มต้น
6. Maxun
Maxun คือคำตอบแบบโอเพนซอร์สสำหรับคนที่ชอบแนวคิด no-code scraping แต่ยังอยากได้การโฮสต์เองและการควบคุมระดับ GitHub มันเข้าถึงง่ายกว่าการใช้เฟรมเวิร์กดิบ ๆ มากสำหรับคนที่ไม่ใช่นักพัฒนา แต่ก็ยังเป็นโปรเจกต์โอเพนซอร์สจริง ไม่ใช่ SaaS ปิด
- การตั้งค่า: การ deploy ปานกลาง แต่หลังติดตั้งแล้วใช้งานง่ายสำหรับผู้ใช้ปลายทาง
- เหมาะที่สุดสำหรับ: ทีมที่อยากได้ UI แบบภาพพร้อมการควบคุมแบบโอเพนซอร์ส
- รองรับ JS: ใช่
- เหตุผลที่ควรเลือก: เลือกข้อมูลแบบคลิก ๆ ได้ โฟลว์หลายขั้นตอน และเข้าถึงง่ายกว่าการเขียนโค้ดจากศูนย์
- ข้อควรระวัง: ขั้นตอน deployment ยังหนักกว่า browser extension ที่ดูแลให้ครบ
7. MechanicalSoup
MechanicalSoup ยังควรมีที่ในลิสต์ เพราะไม่ใช่ทุกงาน scrape ที่ต้องใช้ headless browser ถ้าปัญหาจริงคือการจัดการ session, การ submit ฟอร์ม หรือการเดิน flow แบบ static หลังล็อกอิน มันยังเล็กและเข้าใจง่ายมาก
- การตั้งค่า: ง่าย
- เหมาะที่สุดสำหรับ: ฟอร์มง่าย ๆ, หน้า static ที่ต้องล็อกอิน, และสคริปต์ Python อัตโนมัติแบบรวดเร็ว
- รองรับ JS: ไม่มี
- เหตุผลที่ควรเลือก: ใช้งานลื่น โค้ดอ่านง่าย และเป็นจุดเริ่มต้นที่ดีสำหรับผู้ใช้ Python
- ข้อควรระวัง: ถ้าเจอเว็บที่ใช้ JS หนัก ๆ มันจะหมดประโยชน์เร็ว
8. Node Crawler
Node Crawler ยังพอมีที่ยืนถ้าเป้าหมายของคุณเป็น HTML static และคุณสนใจเรื่อง concurrency, queueing และการ parsing แบบ Cheerio เป็นหลัก ผมคงไม่เลือกมันสำหรับโปรเจกต์ browser-heavy ใหม่ ๆ แต่สำหรับการเก็บข้อมูลแนว feed และ static site ก็ยังใช้งานได้ดี
- การตั้งค่า: ปานกลาง
- เหมาะที่สุดสำหรับ: การ crawl และรวมข้อมูล static แบบความเร็วสูง
- รองรับ JS: ไม่มี
- เหตุผลที่ควรเลือก: ควบคุม concurrency ได้ดี และมี workflow parsing ที่คล้าย jQuery ซึ่งคนคุ้นเคยได้ไม่ยาก
- ข้อควรระวัง: สัญญาณ commit ล่าสุดที่ผมหาได้คือ 18 มิถุนายน 2026 และช่วงระหว่างอัปเดตค่อนข้างห่าง จึงไม่ใช่จุดเริ่มต้นที่ผมจะเลือกสำหรับสแตก dynamic ระยะยาวตัวใหม่
โปรเจกต์สำหรับเว็บ dynamic และการควบคุมเบราว์เซอร์
9. Selenium
Selenium อายุมากกว่า Playwright แต่ก็ยังสำคัญเมื่อพฤติกรรมของเบราว์เซอร์จริงและความแม่นยำในการโต้ตอบสำคัญกว่าความสวยงามของ API มันยังมีความเกี่ยวข้องมาก โดยเฉพาะในงานที่ scrape ทับซ้อนกับ QA, การทำ automation แบบ regression หรือเว็บที่ต้องการพฤติกรรมเบราว์เซอร์แบบตรงตัวมาก ๆ
- การตั้งค่า: ปานกลาง
- เหมาะที่สุดสำหรับ: โฟลว์ที่ต้องโต้ตอบเยอะ, automation เบราว์เซอร์รุ่นเก่า, และทีมที่ใช้ Selenium สำหรับ testing อยู่แล้ว
- รองรับ JS: ใช่
- เหตุผลที่ควรเลือก: รองรับเบราว์เซอร์หลากหลาย ecosystem ใหญ่ และมีความ成熟มานาน
- ข้อควรระวัง: สแตก automation รุ่นใหม่มักจะรู้สึกสะอาดและเร็วกว่าเมื่อต้องเริ่มโปรเจกต์ scraping ใหม่
10. Playwright
Playwright คือคำแนะนำหลักของผมสำหรับทีมพัฒนาที่ต้อง scrape หน้า dynamic ในยุคนี้ การรองรับหลายเบราว์เซอร์ พฤติกรรมการรอที่แข็งแรง และ API ที่สะอาด ทำให้มันเป็นโปรเจกต์ automation เบราว์เซอร์ในลิสต์นี้ที่แนะนำได้ง่ายที่สุดในภาพรวม
- การตั้งค่า: ปานกลาง
- เหมาะที่สุดสำหรับ: เว็บแอปสมัยใหม่, โฟลว์ที่ต้องล็อกอิน และเป้าหมายที่ใช้ JavaScript หนัก
- รองรับ JS: ใช่
- เหตุผลที่ควรเลือก: ควบคุมข้ามเบราว์เซอร์ได้ดี primitive สำหรับ automation แข็งแรง และยังดูแลรักษาอย่างต่อเนื่อง
- ข้อควรระวัง: คุณยังต้องรับผิดชอบ selectors, โครงสร้างพื้นฐานของเบราว์เซอร์, retries และคุณภาพของ output เอง
11. Puppeteer
Puppeteer ยังเป็นคลาสสิกสำหรับ Chrome-first ถ้าทีมของคุณอยู่บน Node.js อยู่แล้วและส่วนใหญ่ทำงานกับ Chromium-compatible workflows มันยังเป็นตัวเลือกที่ใช้งานจริงและเข้าใจกันดี
- การตั้งค่า: ปานกลาง
- เหมาะที่สุดสำหรับ: automation ที่เน้น Chrome, screenshots, PDFs และการดึงข้อมูลแบบ dynamic
- รองรับ JS: ใช่
- เหตุผลที่ควรเลือก: ควบคุมเบราว์เซอร์ได้ละเอียด และมีตัวอย่างจากชุมชนจำนวนมาก
- ข้อควรระวัง: ถ้าคุณต้องการการรองรับเบราว์เซอร์ที่กว้างกว่า หรืออยากได้ภาพรวม cross-browser ที่ทันสมัยกว่า Playwright กลายเป็นตัวเลือกค่าเริ่มต้นที่ดีกว่า
12. Scrapling
Scrapling คือผู้เล่นที่เฉพาะทางที่สุดในกลุ่มนี้ มันเหมาะกับคนที่รู้แล้วว่าปัญหาไม่ได้มีแค่การเรนเดอร์ผ่านเบราว์เซอร์ แต่ยังต้องมี stealth, การรับรู้ proxy และท่าทีต่อ anti-bot ที่แข็งแรงกว่าเดิมด้วย
- การตั้งค่า: ปานกลาง
- เหมาะที่สุดสำหรับ: stealth scraping, เป้าหมายที่ไวต่อ anti-bot และงาน dynamic site ฝั่ง Python
- รองรับ JS: ใช่
- เหตุผลที่ควรเลือก: กำลังพัฒนาอย่างต่อเนื่องและโฟกัสกับแรงเสียดทานของงาน scrape ที่เฟรมเวิร์กง่าย ๆ มักมองข้าม
- ข้อควรระวัง: เกินความจำเป็นสำหรับเว็บ static ธรรมดา และไม่เป็นมิตรกับมือใหม่เท่า MechanicalSoup หรือ Scrapy
Crawler เฉพาะทางสำหรับงานวิจัย ความปลอดภัย และโครงสร้างพื้นฐาน
13. Heritrix
Heritrix ไม่ใช่ตัว scrape สำหรับเปรียบเทียบสินค้า แต่มันคือ crawler เพื่อการเก็บถาวรที่สร้างมาสำหรับสถาบันที่ใส่ใจการอนุรักษ์ทั้งเว็บและการเก็บข้อมูลที่สอดคล้องกับมาตรฐาน
- การตั้งค่า: ขั้นสูง
- เหมาะที่สุดสำหรับ: archive, ห้องสมุด และเวิร์กโฟลว์การอนุรักษ์ข้อมูลขนาดใหญ่
- รองรับ JS: ไม่มี
- เหตุผลที่ควรเลือก: สืบทอดจาก Internet Archive และมีเวิร์กโฟลว์การเก็บถาวรที่เน้น WARC
- ข้อควรระวัง: ไม่เหมาะกับงาน scrape รายการสินค้า หรือราคาที่เจาะจง
14. Apache Nutch
Apache Nutch ยังมีเหตุผลให้ใช้อยู่สำหรับทีมที่คิดแบบ distributed crawling, indexing หรือการเก็บข้อมูลสไตล์ search engine มากกว่างาน scrape ธุรกิจแบบครั้งคราว
- การตั้งค่า: ขั้นสูง
- เหมาะที่สุดสำหรับ: distributed crawling, ชุดข้อมูลเพื่อการวิจัย และการเก็บข้อมูลแบบ search-engine-style
- รองรับ JS: ไม่มี
- เหตุผลที่ควรเลือก: มีโมเดล plugin และคุ้นเคยกับองค์กรสาย Apache
- ข้อควรระวัง: หนักเกินไปมากสำหรับงานที่เริ่มจากสเปรดชีตหรือเบราว์เซอร์เป็นหลัก
15. Katana
Katana ควรอยู่ในลิสต์นี้เพราะการ crawl เพื่อความปลอดภัยเป็น use case ของมันเอง ถ้างานคือการสำรวจระบบ, ค้นหา endpoint หรืออยากเห็นโครงสร้างของเป้าหมายอย่างรวดเร็ว Katana เหมาะกว่าการใช้เฟรมเวิร์ก scrape ทั่วไปมาก
- การตั้งค่า: ปานกลาง
- เหมาะที่สุดสำหรับ: การสำรวจความปลอดภัย, การค้นหา link และการทำ inventory ของ URL
- รองรับ JS: ใช้โหมด headless ได้แบบเลือกเปิด
- เหตุผลที่ควรเลือก: เร็ว ควบคุม concurrency ได้ดี และมีโมเดล crawl ที่โฟกัสด้านความปลอดภัย
- ข้อควรระวัง: ไม่ได้ออกแบบมาเพื่อเป็นสแตกสำหรับดึงข้อมูลธุรกิจแบบขัดเกลาเรียบร้อย
รายการแนะนำแบบสรุปตามประเภททีม
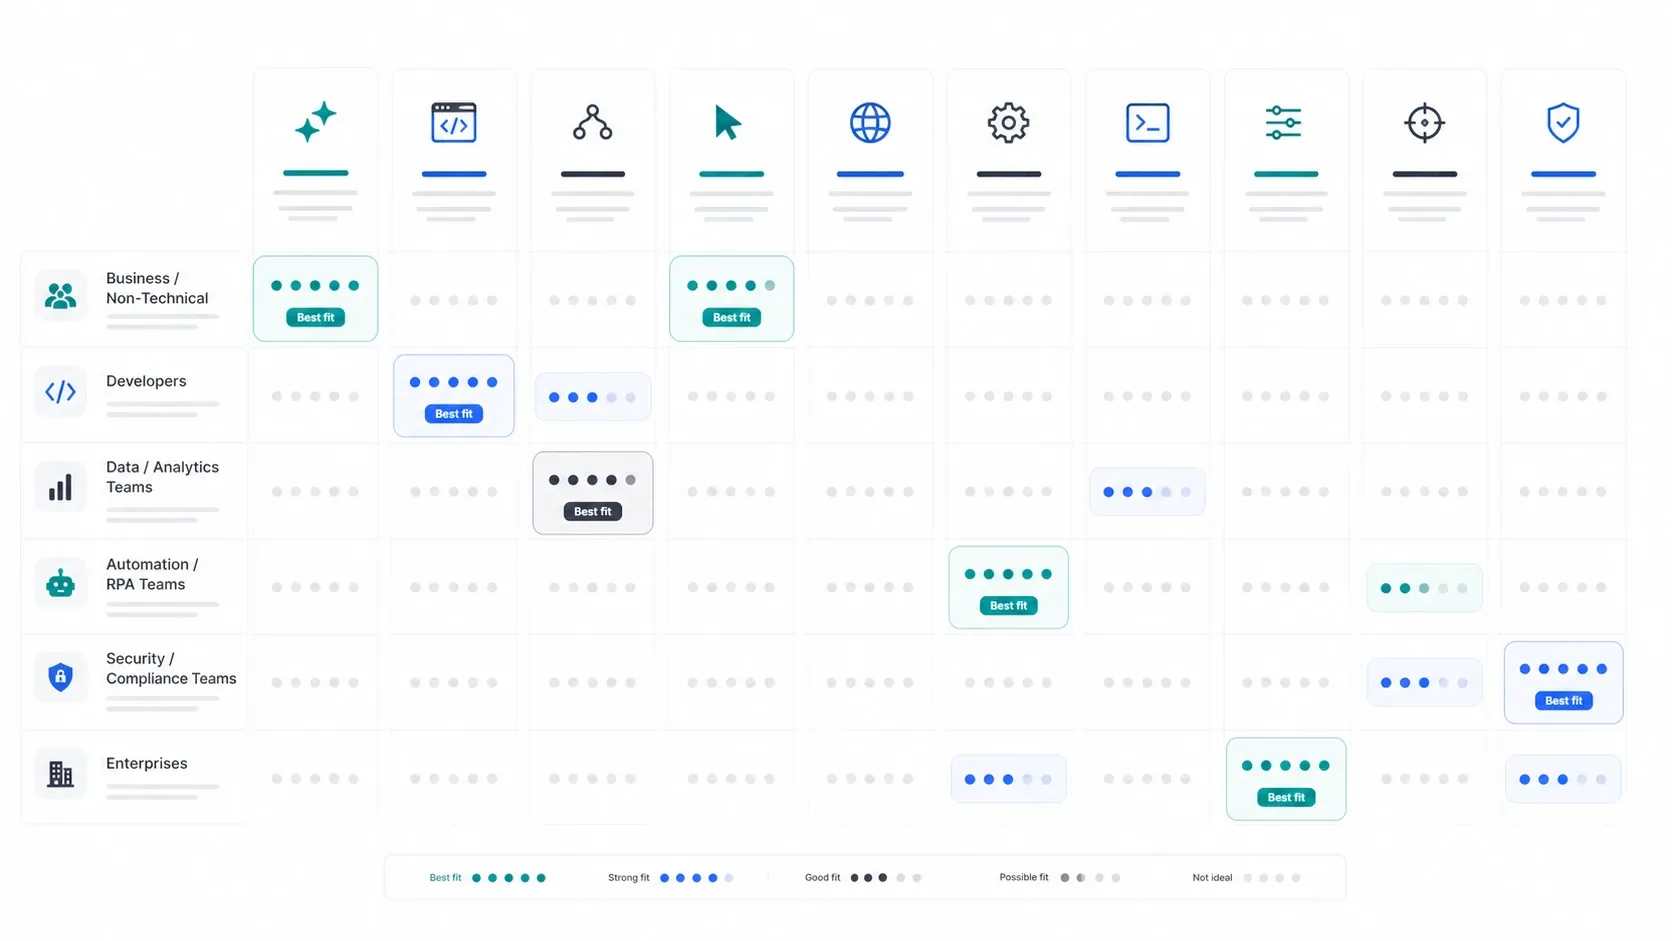
- นักพัฒนา Python: เริ่มที่ Scrapy สำหรับเฟรมเวิร์ก, MechanicalSoup สำหรับ flow static ขนาดเล็ก และ Scrapling ถ้าโจทย์มี stealth หรือ anti-bot อยู่แล้ว
- ทีม JavaScript หรือ TypeScript: เริ่มที่ Crawlee สำหรับเฟรมเวิร์ก, Playwright สำหรับ automation เบราว์เซอร์ และ Puppeteer ถ้า workflow ที่เน้น Chrome เพียงพอ
- ทีม Go: ใช้ Colly สำหรับการ scrape และ Katana สำหรับการ crawl เชิงความปลอดภัยที่เน้นการค้นหา
- ทีม Java: ใช้ WebMagic สำหรับการ crawl ทั่วไป, Heritrix สำหรับการเก็บถาวร และ Apache Nutch สำหรับ distributed crawling สไตล์ search
- ผู้ใช้งานที่ไม่ถนัดเทคนิค: ใช้ Maxun ถ้าคุณต้องการโฮสต์เองแบบโอเพนซอร์ส หรือ Thunderbit ถ้าคุณต้องการเวิร์กโฟลว์ no-code แบบดูแลให้ครบและได้ผลลัพธ์ใช้งานได้เร็วกว่า
แล้วคนส่วนใหญ่ควรเริ่มที่โปรเจกต์ไหนจริง ๆ?
คำตอบที่เป็นรูปธรรมที่สุดคือ:
- ถ้าคุณอยาก สร้างและเป็นเจ้าของ scraper เอง ให้เริ่มที่ Scrapy หรือ Crawlee
- ถ้าคุณต้องการ ควบคุมเบราว์เซอร์จริง ให้เริ่มที่ Playwright
- ถ้าคุณต้องการ เลเยอร์ no-code แบบภาพที่เป็นโอเพนซอร์ส ให้เริ่มที่ Maxun
- ถ้าคุณต้องการ archive หรือ crawl เชิงความปลอดภัยแบบเฉพาะทาง ให้เลือก Heritrix, Nutch หรือ Katana เฉพาะเมื่อ use case ของคุณบังคับให้ต้องใช้จริง ๆ
- ถ้าคุณอยาก ข้ามโค้ดและเอาข้อมูลเลยตอนนี้ อย่าฝืนเริ่มจาก GitHub ให้ใช้ Thunderbit
สรุปท้ายบทความ
GitHub project สำหรับ web scraping ที่ดีที่สุดในปี 2026 ไม่ได้ขึ้นกับจำนวนดาวล้วน ๆ แต่อยู่ที่ว่าคุณยอมรับภาระส่วนไหนไว้กับทีมของคุณ Scrapy ยังเป็นค่าเริ่มต้นที่ปลอดภัยที่สุดสำหรับ Python Crawlee เป็นตัวเลือกเฟรมเวิร์ก JavaScript สมัยใหม่ที่ดีที่สุด Playwright เป็นค่าเริ่มต้นที่แข็งแรงที่สุดสำหรับการควบคุมเบราว์เซอร์ Maxun คือทาง no-code แบบโอเพนซอร์สที่น่าสนใจที่สุด ส่วน Heritrix, Apache Nutch และ Katana เป็นเครื่องมือเฉพาะทางที่เก่งมากเมื่อโจทย์ของคุณเป็นสายเฉพาะจริง ๆ
สิ่งสำคัญคืออย่าสับสนระหว่าง “ทรงพลังที่สุด” กับ “เหมาะที่สุด” ถ้าทีมของคุณต้องการแค่ข้อมูลสะอาด ๆ ในสเปรดชีต GitHub อาจไม่ใช่จุดเริ่มต้นที่ถูกต้องตั้งแต่แรก
ตัดภาระการดูแลระบบออก แล้วเริ่ม scrape ได้เร็วขึ้น Get Started Free



