
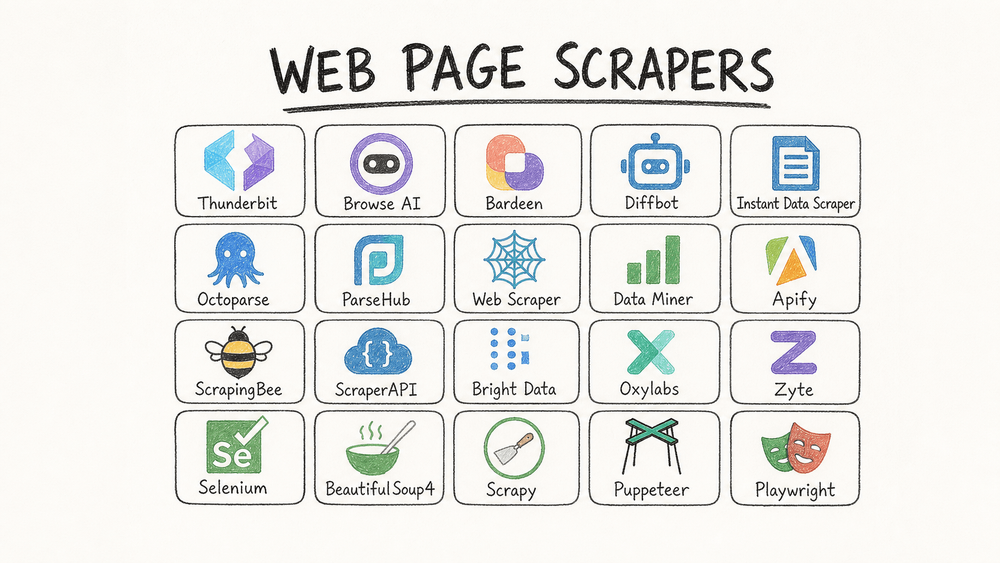
ถ้าคุณกำลังประเมินเครื่องมือเว็บสแครปปิ้งในปี 2026 คุณคงไม่ได้อยากอ่านบทเรียนปรัชญา สิ่งที่คุณต้องการคือรายชื่อที่เชื่อถือได้ วิธีคัดแยกเครื่องมือที่เหมาะกับผู้ใช้ธุรกิจออกจากสแต็กที่เน้นวิศวกรรมให้เร็วที่สุด และหลักฐานจริงพอจะช่วยไม่ให้ซื้อผิด นั่นแหละคือเป้าหมายของบทความนี้
คำตอบสั้น ๆ ก่อน
ถ้าคุณต้องการแค่แนวทางเลือก ใช้แบบนี้ได้เลย:
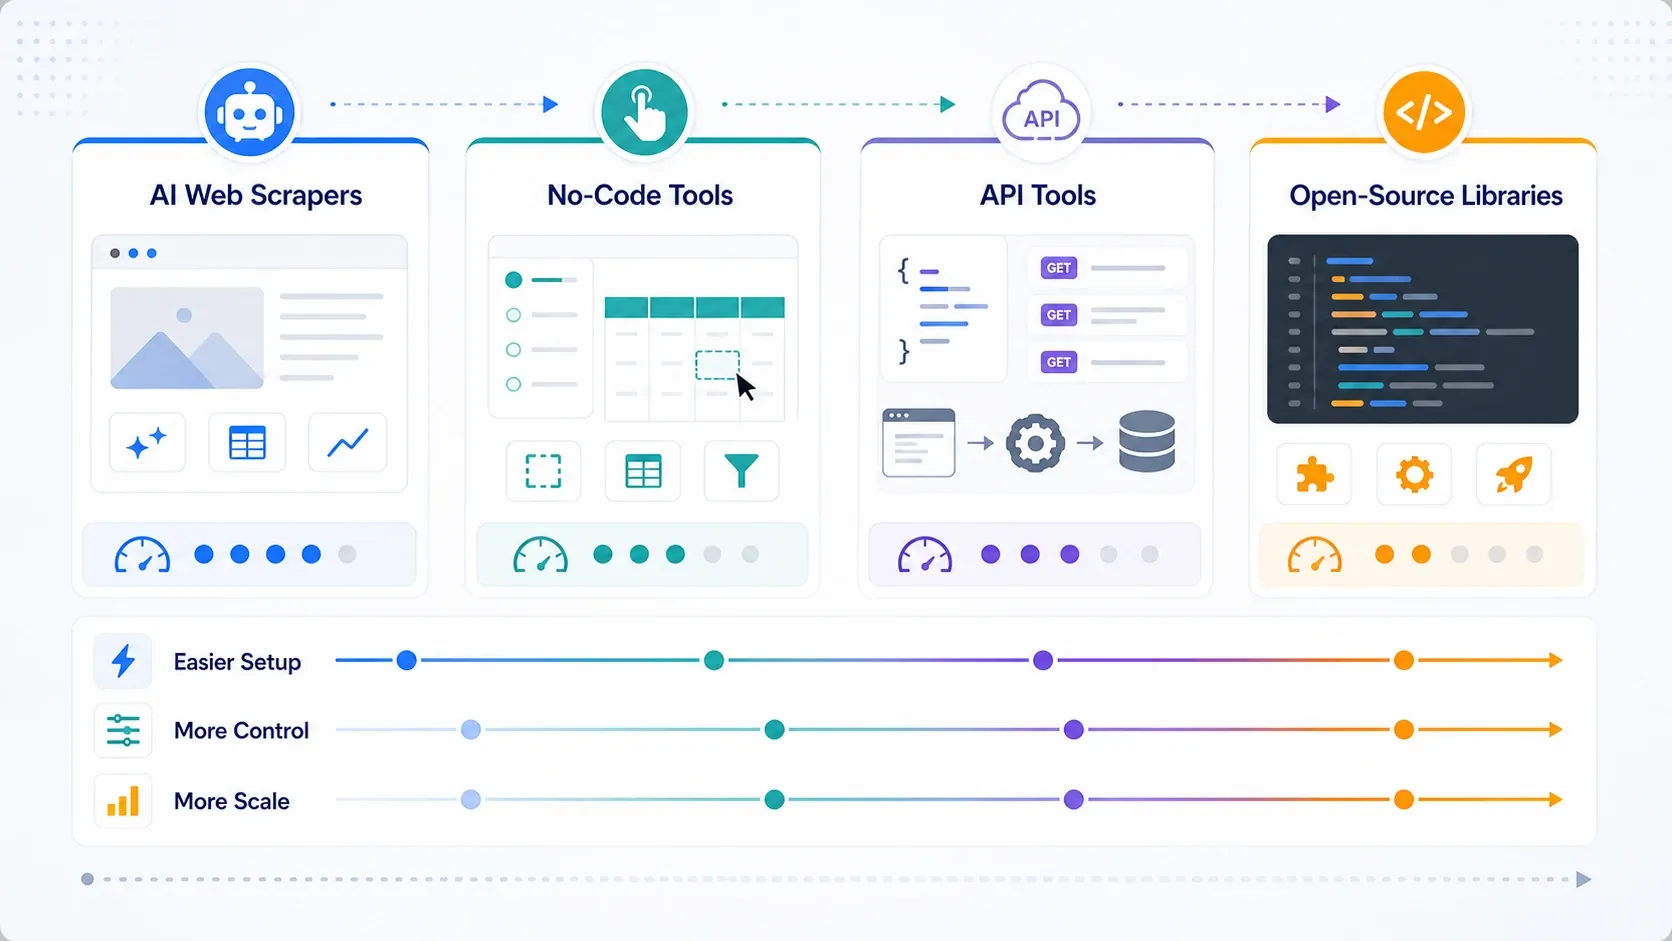
- เลือก AI web scraper ถ้าคุณอยากแปลงเว็บเป็นสเปรดชีตให้เร็วที่สุด โดยแทบไม่ต้องตั้งค่าอะไร
- เลือก no-code scraper ถ้าคุณต้องการควบคุมงานมากขึ้น ตั้งเวลาได้ หรือรันบนคลาวด์โดยไม่ต้องเขียนโค้ด
- เลือก API platform ถ้าทีมของคุณต้องการการเรนเดอร์หน้าเว็บ, การหมุนพร็อกซี, การจัดการ anti-bot หรือการเชื่อมเข้ากับผลิตภัณฑ์ภายใน
- เลือก open-source library ถ้าคุณอยากคุมทุกอย่างเอง และพร้อมรับผิดชอบเรื่องการดูแล, selectors, โครงสร้างพื้นฐาน และความล้มเหลว
บทความนี้รวบรวมเครื่องมือทั้ง 20 ตัวไว้ครบ แต่ตรรกะการแนะนำจะตั้งใจทำให้เข้าใจง่าย: เริ่มจากเครื่องมือที่เบาที่สุดซึ่งยังจัดการงานของคุณได้อย่างเสถียร แล้วค่อยขยับไปยังสแต็กล่างลงไปเมื่อเรื่องการดูแล, การถูกบล็อก หรือสเกล บีบให้ต้องทำ
ตารางเปรียบเทียบแบบเร็ว: เครื่องมือเว็บสแครปปิ้งที่ดีที่สุดในปี 2026
ราคาที่แสดงด้านล่างตรวจสอบจากหน้าผลิตภัณฑ์หรือหน้าราคาอย่างเป็นทางการในเดือนสิงหาคม 2026 หากผู้ให้บริการใช้การคิดค่าบริการตามการใช้งานจริงหรือเสนอราคาสำหรับองค์กรแบบกำหนดเอง ฉันจะอธิบายรูปแบบราคาแทนการทำเหมือนว่ามีป้ายราคามาตรฐานที่ใช้ได้กับทุกคน
| เครื่องมือ | ประเภท | เหมาะที่สุดสำหรับ | เหตุผลที่ติดลิสต์ปี 2026 | รูปแบบราคา (ตรวจสอบเมื่อ พ.ค. 2026) |
|---|---|---|---|---|
| Thunderbit | AI Web Scraper | งานขาย, ops, อีคอมเมิร์ซ, อสังหา | ทางลัดที่เร็วที่สุดสำหรับคนไม่เขียนโค้ด; แนะนำฟิลด์ด้วย AI, ดึงข้อมูลจากซับเพจ, ส่งออกได้, เวิร์กโฟลว์ทั้งบนเบราว์เซอร์และคลาวด์ | ฟรีแพลน, แพ็กเกจเสียเงิน, ราคาสำหรับธุรกิจแบบกำหนดเอง |
| Browse AI | AI Web Scraper | ผู้ใช้ธุรกิจที่ต้องการเฝ้าติดตามเว็บไซต์ | หุ่นยนต์แบบ no-code ที่แข็งแรง, การมอนิเตอร์ และผลลัพธ์สไตล์สเปรดชีต/API | ฟรีแพลน, แพ็กเกจเสียเงิน, แพ็กเกจพรีเมียมแบบจัดการให้ |
| Bardeen | AI Automation + Scraping | Revenue ops และเวิร์กโฟลว์บนเบราว์เซอร์ | เหมาะกว่าเมื่อการสแครปเป็นเพียงหนึ่งขั้นตอนในระบบอัตโนมัติที่ใหญ่กว่า | ฟรีแพลนและแพ็กเกจเสียเงิน |
| Diffbot | AI Extraction Platform | องค์กรและทีมข้อมูล | เหมาะที่สุดเมื่อคุณต้องการ AI extraction ควบคู่กับเวิร์กโฟลว์ข้อมูลแบบมีโครงสร้างในสเกลใหญ่ | ราคาสไตล์องค์กร |
| Instant Data Scraper | Lightweight Browser Scraper | ผู้ใช้ทั่วไปและการดึงตารางแบบเร็ว | ยังเป็นหนึ่งในวิธีที่ง่ายที่สุดในการดึงรายการหรือ ตารางที่มองเห็นได้ออกเป็น CSV แบบรวดเร็ว | ฟรี |
| Octoparse | No-Code Scraper | นักวิเคราะห์และทีม ops ที่มีงานประจำขนาดใหญ่ | ตัวสร้างงานแบบ visual ที่成熟แล้ว พร้อมดึงข้อมูลบนคลาวด์, กันบล็อก และเทมเพลต | ฟรีแพลน, เริ่มเสียเงินที่ $69/เดือน, องค์กรกำหนดเอง |
| ParseHub | Low-Code Scraper | นักวิเคราะห์ที่ต้องการตรรกะและการควบคุมบนเดสก์ท็อป | ตรรกะโปรเจกต์ยืดหยุ่นและการนำทางแบบซ้อนชั้น แม้จะเรียนยากกว่าเครื่องมือ AI-first รุ่นใหม่ | ฟรีแพลนและแพ็กเกจเสียเงิน |
| Web Scraper | No-Code Scraper | มือใหม่และงานคลาวด์เบา ๆ | จุดเริ่มต้นที่ดีถ้าคุณชอบการสแครปแบบ sitemap และตั้งค่าจากเบราว์เซอร์ก่อน | ส่วนขยายฟรี, แพ็กเกจคลาวด์เสียเงิน |
| Data Miner | Browser Scraper | นักวิจัยและทีม growth | ยังมีประโยชน์สำหรับการดึงข้อมูลแบบเร็วด้วย recipe ภายในเบราว์เซอร์ | ฟรีแพลนและแพ็กเกจเสียเงิน |
| Apify | API + Actor Platform | ทีมเทคนิคและทีมผสม | อีโคซิสเต็มของ Actors ที่ยอดเยี่ยม พร้อม runtime ของตัวเอง เมื่อคุณโตเกินส่วนขยายเบราว์เซอร์ | ฟรีแพลน, เริ่มที่ $29/เดือนบวกค่าการใช้งาน, แพ็กเกจสูงขึ้นตามสเกล |
| ScrapingBee | Scraping API | นักพัฒนาที่สแครปเว็บที่ใช้ JS หนัก | ตัวเลือกที่ดีเมื่อคุณต้องการการเรนเดอร์และการจัดการพร็อกซีโดยไม่ต้องสร้างเลเยอร์เบราว์เซอร์เอง | ทดลองใช้ฟรีและแพ็กเกจเสียเงิน |
| ScraperAPI | Scraping API | นักพัฒนาที่ต้องการสเกลคำขอให้เร็ว | API ที่ตรงไปตรงมา, เครดิตทดลอง, ผลิตภัณฑ์แบบมีโครงสร้าง และการย้ายภาระโครงสร้างพื้นฐานออกไปได้ง่ายขึ้น | ทดลอง 7 วันพร้อม 5,000 เครดิต, เริ่มเสียเงินที่ $49/เดือน |
| Bright Data | Enterprise API + Proxy Platform | งานปริมาณสูงและเน้น compliance | สแต็กเก็บข้อมูลที่ครอบคลุมที่สุด เมื่อการปลดบล็อก, พร็อกซี และการจัดหาข้อมูลแบบ managed สำคัญกว่าความง่าย | คิดตามการใช้งานและตามผลิตภัณฑ์ |
| Oxylabs | Enterprise API + Proxy Platform | ทีมที่ซื้อ scraping เป็นโครงสร้างพื้นฐาน | แข็งแรงสำหรับการเก็บข้อมูลสเกลใหญ่ โดยเฉพาะงานราคา, SEO และ research ตลาด | Web Scraper API เริ่มที่ $49/เดือน; ราคาพร็อกซีอื่น ๆ แตกต่างกัน |
| Zyte | API + Anti-Bot Stack | นักพัฒนาและทีมข้อมูล | เหมาะถ้าคุณต้องการ extraction แบบ API-first พร้อมบราว์เซอร์, rotation และ anti-detection ที่แข็งแรง | ทดลองพร้อมเครดิตฟรี $5, ผูกตามการใช้งาน |
| Selenium | Open-Source Browser Automation | ระบบอัตโนมัติสไตล์ QA และ flow ซับซ้อน | ยังมีประโยชน์เมื่อความแม่นยำของการโต้ตอบกับผู้ใช้สำคัญกว่าปริมาณงานสแครป | ฟรีและโอเพนซอร์ส |
| BeautifulSoup4 | Open-Source Parser | มือใหม่และงาน parse เบา ๆ | ดีที่สุดในบทบาทตัว parser สำหรับสแต็กง่าย ๆ ไม่ใช่แพลตฟอร์มสแครปครบวงจร | ฟรีและโอเพนซอร์ส |
| Scrapy | Open-Source Crawling Framework | ตัว crawler แบบกำหนดเองสำหรับงานโปรดักชัน | สมดุลดีที่สุดระหว่างพลังและความ成熟 ถ้าคุณอยากดูแล pipeline เอง | ฟรีและโอเพนซอร์ส |
| Puppeteer | Open-Source Browser Automation | การสแครปแบบ Node-first และเขียนสคริปต์บนเบราว์เซอร์ | เหมาะมากถ้าทีมของคุณคุ้นกับระบบนิเวศ Chrome/Node อยู่แล้ว | ฟรีและโอเพนซอร์ส |
| Playwright | Open-Source Browser Automation | การอัตโนมัติบนหลายเบราว์เซอร์แบบทันสมัย | มักเป็นตัวเลือกที่สะอาดที่สุดสำหรับ browser automation ยุคใหม่ พร้อมประสบการณ์นักพัฒนาที่ดี | ฟรีและโอเพนซอร์ส |
ฉันประเมินเครื่องมือเหล่านี้อย่างไร
ฉันใช้เกณฑ์ 4 ข้อ:
- ใช้เวลานานแค่ไหนกว่าจะสแครปสำเร็จครั้งแรก
ถ้าคนที่ไม่ใช่สายเทคนิคไม่สามารถดึงข้อมูลที่ใช้งานได้เร็วพอ นั่นคือเรื่องสำคัญ - ภาระการดูแลรักษา
ตั้งค่าได้เร็วก็ไม่มีความหมาย ถ้าเวิร์กโฟลว์พังทุกครั้งที่เว็บเปลี่ยน - ขีดจำกัดด้านสเกล
บางเครื่องมือเหมาะกับ 50 หน้า/สัปดาห์ แต่แย่มากสำหรับ 5 ล้านคำขอ/เดือน - ความเหมาะกับเวิร์กโฟลว์
เครื่องมือที่ดีที่สุดสำหรับทีม revenue ops แทบไม่ใช่ตัวเดียวกับที่ดีที่สุดสำหรับทีม data platform
ผลลัพธ์จึงไม่ใช่อันดับสากล แต่มันคือหน้าตัดสินใจสำหรับเลือก “ประเภท” ของเครื่องมือให้ถูกก่อน แล้วค่อยเลือกผลิตภัณฑ์ที่เหมาะที่สุดภายในประเภทนั้น
คุณต้องการเครื่องมือเว็บสแครปปิ้งแบบไหนกันแน่?
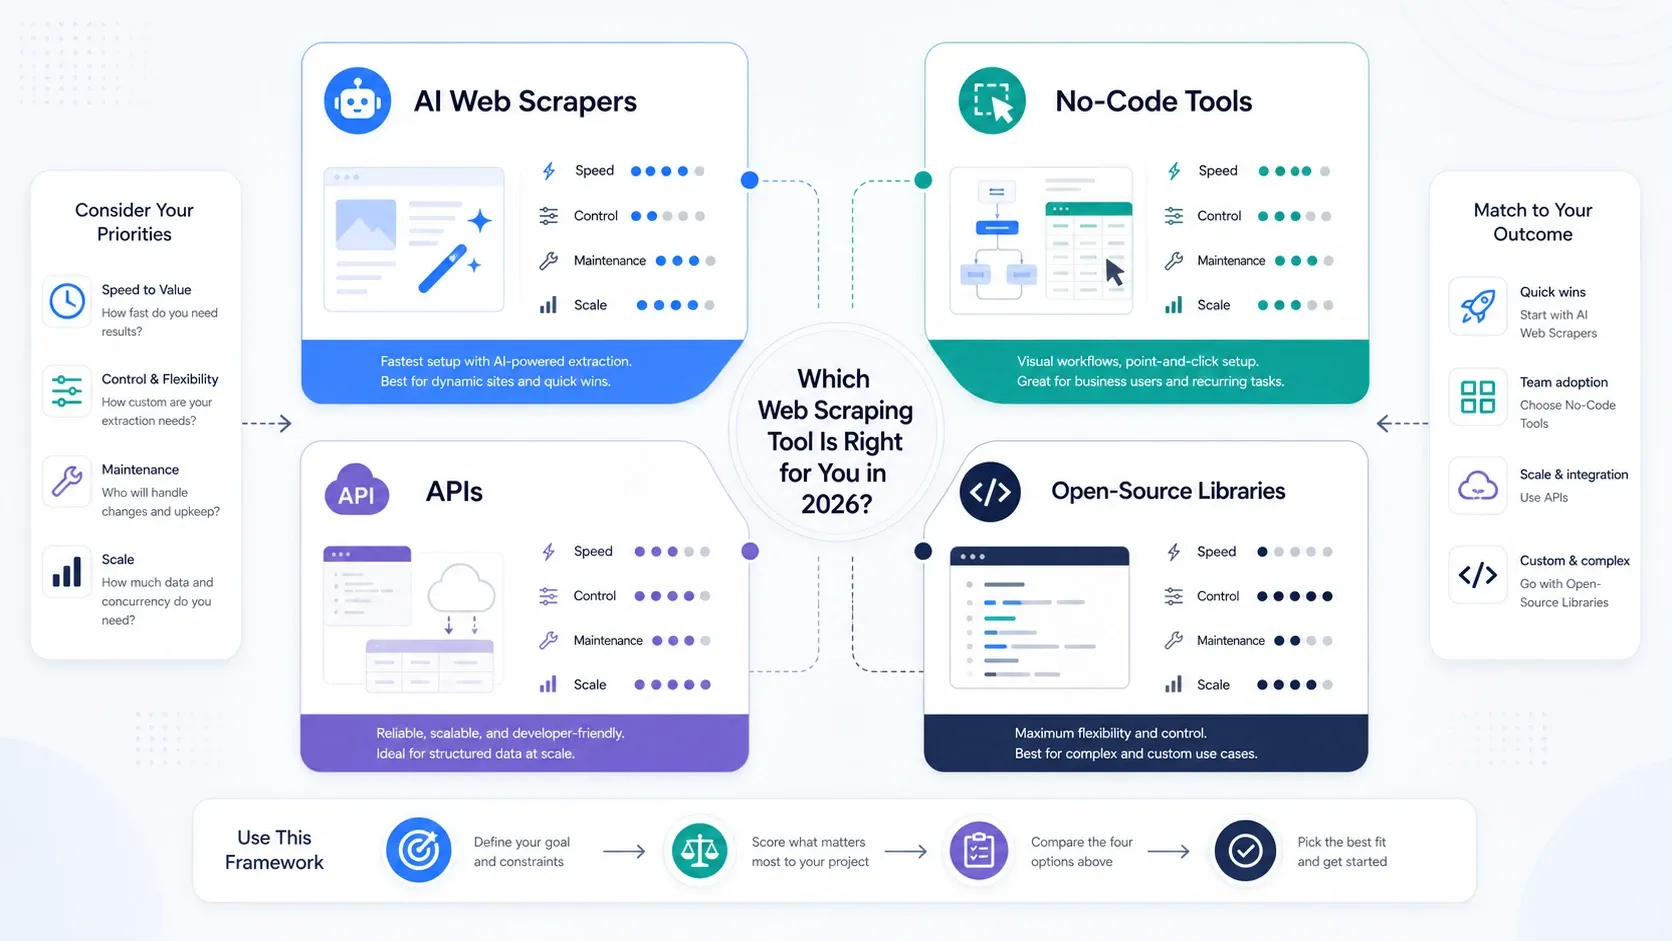
- เลือก AI web scrapers ถ้าเป้าหมายหลักของคุณคือความเร็วในการทำงาน
- เลือก no-code tools ถ้าคุณต้องการ pagination, scheduling และการควบคุมงานซ้ำ ๆ ให้ชัดเจนขึ้น
- เลือก APIs and scraping platforms ถ้าเรนเดอร์, rotation และความสามารถในการปลดบล็อกกลายเป็นคอขวด
- เลือก open-source libraries ถ้าทีมของคุณให้คุณค่ากับการควบคุมมากกว่าความสะดวก และสามารถดูแลสแต็กนี้เองได้
ถ้าทีมของคุณยังลังเลว่าควรให้ scraping อยู่ฝั่ง ops หรือ engineering ให้เริ่มจากเครื่องมือ AI หรือ no-code ก่อน คุณจะเรียนรู้ได้เร็วกว่าโดยการลงมือรันงานจริง มากกว่าพยายามออกแบบสแต็กให้สมบูรณ์ตั้งแต่ต้น
AI Web Scraper ที่ดีที่สุดสำหรับทีมธุรกิจ
นี่คือเครื่องมือที่ฉันจะเริ่มดูเป็นอันดับแรก ถ้าผลลัพธ์ที่ต้องการคือข้อมูลพร้อมใช้ในสเปรดชีต โดยใช้เวลาตั้งค่าน้อยที่สุดเท่าที่เป็นไปได้
1. Thunderbit
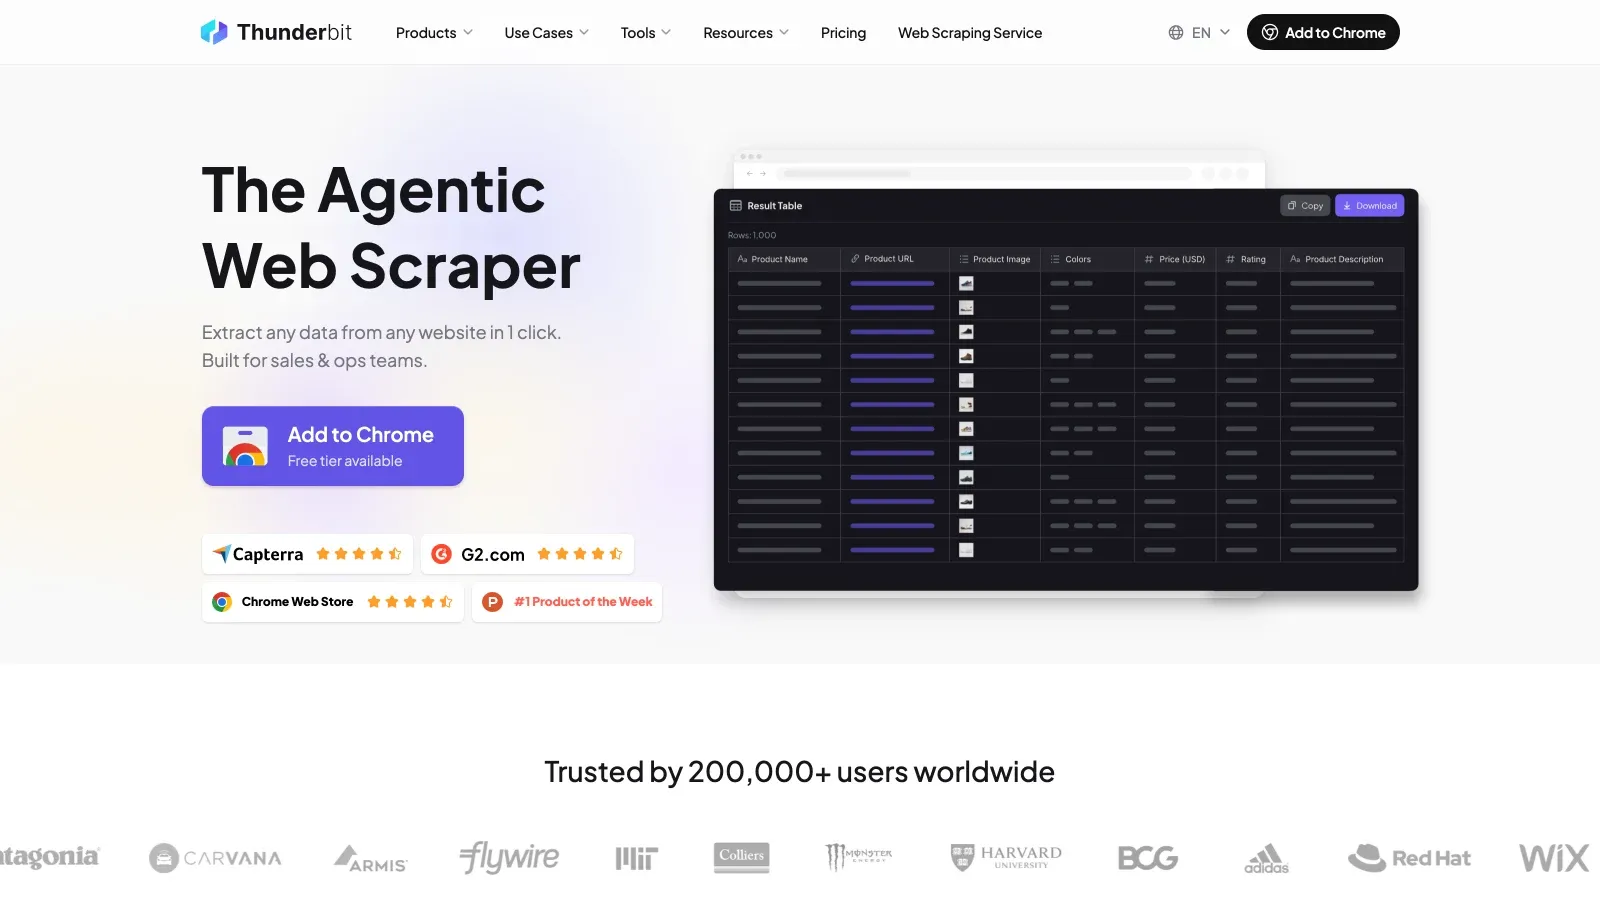
Thunderbit คือทางเลือกที่ง่ายที่สุดในลิสต์นี้ ถ้าทีมของคุณอยากดึงข้อมูลแบบมีโครงสร้างโดยไม่ต้องเรียน selectors, การเขียนสคริปต์บนเบราว์เซอร์ หรือโครงสร้างพื้นฐานสำหรับ scraping เวิร์กโฟลว์ของมันสร้างมาเพื่อการแนะนำฟิลด์ด้วย AI, การเสริมข้อมูลจากซับเพจ และการส่งออกตรงไปยังเครื่องมือที่คนทำงานธุรกิจใช้อยู่แล้ว
- เหมาะที่สุดสำหรับ: ทีมขาย, ops, อีคอมเมิร์ซ, อสังหา และทีมที่ต้องใช้งานผ่านเบราว์เซอร์เยอะ
- จุดเด่น: ลดเวลาเซ็ตอัปได้ดีกว่าเครื่องมืออื่นในลิสต์นี้สำหรับคนไม่เขียนโค้ด
- ข้อควรระวัง: ถ้าคุณต้องการตรรกะ crawler ที่ลึกมากหรือการควบคุมเชิงวิศวกรรมเฉพาะทางสูง สุดท้ายคุณอาจต้องขยับไปสแต็กล่างลงไป
- รูปแบบราคา: ฟรีแพลน, แพ็กเกจเสียเงินแบบ self-serve และราคาสำหรับธุรกิจ
ถ้าคุณอยากดูเวิร์กโฟลว์จริงที่เร็วที่สุดก่อนจะเปรียบเทียบเครื่องมืออื่น วิดีโอนี้คือจุดเริ่มที่คุ้มค่าที่สุด:
ลองใช้ Thunderbit บนหน้าเว็บจริง เปิดหน้าเว็บไหนก็ได้ ให้ AI อ่านข้อมูล แล้วส่งออกเป็นตารางที่มีโครงสร้างได้ในคลิกเดียว Get Started Free
2. Browse AI
Browse AI ยังเป็นตัวเลือกที่ดีสำหรับผู้ใช้ธุรกิจที่ต้องการตั้งค่าแบบคลิกแล้วใช้ได้ทันที พร้อมการเฝ้าติดตามแบบต่อเนื่อง โมเดล robot ของมันมีประโยชน์มากเป็นพิเศษเมื่อทั้งการสแครปและการตรวจจับการเปลี่ยนแปลงมีความสำคัญพอ ๆ กัน
- เหมาะที่สุดสำหรับ: เฝ้าดูหน้าราคา, หน้าแข่งขัน และการดึงรายการซ้ำ ๆ
- จุดเด่น: onboarding ลื่นไหล, robot สำเร็จรูป และเส้นทางที่ชัดจากเว็บไปสเปรดชีตหรือผลลัพธ์แบบ API
- ข้อควรระวัง: งานที่ซับซ้อนและปริมาณสูงอาจแพงหรือจัดการยากเร็วกว่าสแต็กแบบ API-first
- รูปแบบราคา: ฟรีแพลน, แพ็กเกจเสียเงิน, ระดับพรีเมียม/managed
3. Bardeen
Bardeen น่าสนใจที่สุดเมื่อการสแครปเป็นเพียงหนึ่งแอ็กชันในเวิร์กโฟลว์ automation บนเบราว์เซอร์ที่กว้างกว่า ถ้าคุณกำลังย้ายข้อมูลเข้า CRM, สเปรดชีต หรือเวิร์กโฟลว์ outbound มุม automation ของมันจะมีความหมายมากกว่าความลึกของการสแครปดิบ ๆ
- เหมาะที่สุดสำหรับ: revenue ops, workflow สำหรับลีด และงานอัตโนมัติที่ทำบนเบราว์เซอร์เป็นหลัก
- จุดเด่น: เรื่อง workflow automation แข็งแรงกว่าเครื่องมือ extraction ล้วน ๆ
- ข้อควรระวัง: ไม่ใช่ตัวที่ลงตัวที่สุดเมื่อการสแครปเองซับซ้อนและเป็นภารกิจสำคัญ
- รูปแบบราคา: ฟรีแพลนและแพ็กเกจเสียเงิน
4. Diffbot
Diffbot อยู่ตรงนี้สำหรับทีมที่ต้องการ AI extraction ในระดับองค์กร ไม่ใช่สำหรับคนที่มองหาทางที่ถูกที่สุดหรือเรียบง่ายที่สุด มันเหมาะกว่าเมื่อคุณให้ความสำคัญกับคุณภาพของข้อมูลเชิงโครงสร้างและการนำข้อมูลเข้าในสเกลใหญ่ มากกว่าการควบคุมลงมือเองแบบละเอียด
- เหมาะที่สุดสำหรับ: ทีมข้อมูลระดับองค์กร, content intelligence และโปรแกรม extraction ขนาดใหญ่
- จุดเด่น: การดึงข้อมูลสไตล์ computer vision และการเน้นผลลัพธ์แบบ structured อย่างชัดเจน
- ข้อควรระวัง: เกินความจำเป็นสำหรับทีมเล็ก และอาจหนักเกินไปถ้า use case ของคุณไม่ได้ซับซ้อนมาก
- รูปแบบราคา: แผนระดับองค์กรและการขายแบบกำหนดเอง
5. Instant Data Scraper
Instant Data Scraper ยังควรมีชื่ออยู่ในลิสต์ เพราะมีหลายสถานการณ์ที่คุณแค่ต้องการตาราง, ไดเรกทอรี หรือรายการที่มองเห็นอยู่ตอนนี้ มันไม่ใช่แพลตฟอร์ม แต่บ่อยครั้งมันก็เพียงพอแล้ว
- เหมาะที่สุดสำหรับ: การดึงข้อมูลครั้งเดียว, ลีดลิสต์แบบเร็ว, ไดเรกทอรีง่าย ๆ และตารางที่เห็นอยู่บนหน้าเว็บ
- จุดเด่น: ใช้งานแทบไม่มีแรงเสียดทานถ้าเจอหน้าที่เหมาะ
- ข้อควรระวัง: automation จำกัด, ดึงลึกได้ไม่มาก และไม่เหมาะกับเวิร์กโฟลว์ขั้นสูง
- รูปแบบราคา: ฟรี
เครื่องมือเว็บสแครปปิ้งแบบ No-Code ที่ดีที่สุดสำหรับงานซ้ำ ๆ
พองานไม่ได้เป็นแค่การสแครปเป็นครั้งคราว ตัวสร้างงานแบบ visual และการรันบนคลาวด์ก็เริ่มมีความสำคัญ
6. Octoparse
Octoparse ยังเป็นหนึ่งในแพลตฟอร์ม no-code ที่แข็งแรงที่สุด หากคุณต้องการรันบนคลาวด์, ครอบคลุมเทมเพลตจำนวนมาก และการจัดการงานที่ซับซ้อนกว่าส่วนขยายเบราว์เซอร์ทั่วไป
- เหมาะที่สุดสำหรับ: นักวิเคราะห์, ทีมราคา และทีม ops ที่รันงานเก็บข้อมูลเป็นประจำ
- จุดเด่น: ตัวสร้างงานที่成熟, การดึงข้อมูลบนคลาวด์, ฟีเจอร์กันบล็อก และอีโคซิสเต็มเทมเพลตขนาดใหญ่
- ข้อควรระวัง: มีพลังมากกว่าเครื่องมือบนเบราว์เซอร์แบบ AI-first แต่ก็แลกด้วยความซับซ้อนในการตั้งค่ามากขึ้น
- รูปแบบราคา: ฟรีแพลน, เริ่มที่ $69/เดือน, องค์กรแบบกำหนดเอง
7. ParseHub
ParseHub ยังสำคัญสำหรับคนที่อยากได้การควบคุมมากกว่า AI scraper แต่ไม่อยากเขียนโค้ดทั้งระบบ มันให้ผลตอบแทนกับคนที่มีความอดทน ไม่ใช่คนที่อยากได้ความเร็วทันที
- เหมาะที่สุดสำหรับ: นักวิเคราะห์และผู้ใช้สายเทคนิคที่รับมือกับ learning curve ที่ชันกว่าได้
- จุดเด่น: ตรรกะการนำทางยืดหยุ่น และคุมได้ดีกว่าเครื่องมือบนเบราว์เซอร์แบบเบา ๆ
- ข้อควรระวัง: ประสบการณ์ใช้งานดูหนักกว่าเครื่องมือรุ่นใหม่ โดยเฉพาะสำหรับทีมธุรกิจที่เคลื่อนที่เร็ว
- รูปแบบราคา: ฟรีแพลนและแพ็กเกจเสียเงิน
8. Web Scraper
Web Scraper ยังเป็นจุดเริ่มต้นที่เหมาะสม ถ้าคุณชอบโมเดล sitemap และอยากได้เครื่องมือที่เริ่มทำงานในเบราว์เซอร์ก่อน แล้วค่อยขยายไปสู่การตั้งเวลาบนคลาวด์ภายหลัง
- เหมาะที่สุดสำหรับ: มือใหม่, งานอดิเรก, และงานซ้ำ ๆ ขนาดเล็ก
- จุดเด่น: เวิร์กโฟลว์ sitemap เข้าใจง่าย และเริ่มใช้งานจากเบราว์เซอร์ได้ไม่ยาก
- ข้อควรระวัง: เริ่มจำกัดเมื่อคุณต้องการตรรกะการดึงข้อมูลที่ปรับตามสถานการณ์ได้มากขึ้น
- รูปแบบราคา: ส่วนขยายเบราว์เซอร์ฟรีและแพ็กเกจคลาวด์เสียเงิน
9. Data Miner
Data Miner ควรมองว่าเป็นเครื่องมือดึงข้อมูลแบบเร็ว มากกว่าจะเป็นแพลตฟอร์มสแครปเต็มรูปแบบ มันยังติดลิสต์เพราะการทำงานแบบ recipe มีประโยชน์มากสำหรับงานวิจัยและ prospecting หลายประเภท
- เหมาะที่สุดสำหรับ: นักวิจัย, ทีม growth และงานส่งออกข้อมูลจากเบราว์เซอร์แบบเร็ว
- จุดเด่น: โมเดล recipe, ใช้งานง่าย และ export จากเบราว์เซอร์สะดวก
- ข้อควรระวัง: ไม่ใช่เครื่องมือที่เหมาะกับการสแครประดับแพลตฟอร์มจริงจัง
- รูปแบบราคา: ฟรีแพลนและแพ็กเกจเสียเงิน
แพลตฟอร์ม API ที่ดีที่สุดเมื่อสเกลและการถูกบล็อกกลายเป็นปัญหาจริง
นี่คือเลเยอร์ที่ทีมวิศวกรรมจะเลิกถามว่า “จะสแครปหน้านี้ยังไง” แล้วหันไปถามว่า “จะทำให้เชื่อถือได้ในปริมาณมากได้ยังไง”
10. Apify
Apify เป็นแพลตฟอร์มที่ยืดหยุ่นที่สุดในกลุ่มนี้ ถ้าคุณต้องการทั้งมาร์เก็ตเพลสของ scraper ที่นำกลับมาใช้ซ้ำได้ และพื้นที่สำหรับรันโค้ดของตัวเอง มันเชื่อมโลก no-code discovery กับการทำงานของนักพัฒนาได้ดีกว่าคู่แข่งส่วนใหญ่
- เหมาะที่สุดสำหรับ: ทีมผสม, scraping ที่มีนักพัฒนาดูแล และเวิร์กโฟลว์ automation ที่นำกลับมาใช้ซ้ำได้
- จุดเด่น: อีโคซิสเต็มของ Actor และ runtime แบบ custom ทำให้มีขอบเขตการใช้งานกว้างผิดปกติ
- ข้อควรระวัง: พอคุณทำ custom จริง คุณก็กลับไปอยู่ในโลกวิศวกรรม และความง่ายก็ลดลง
- รูปแบบราคา: ฟรีแพลน, เริ่มที่ $29/เดือนบวกค่าการใช้งาน, แพ็กเกจใหญ่ขึ้นและองค์กร
11. ScrapingBee
ScrapingBee เป็นตัวเลือกที่ดีเมื่อความต้องการจริง ๆ ของคุณคือ “ช่วยคืนหน้าเว็บที่เรนเดอร์แล้วมาให้ฉัน และจัดการโครงสร้างพื้นฐานยุ่งยากแทน” มันเข้ากับเว็บไซต์ที่ใช้ JS หนักได้ดี
- เหมาะที่สุดสำหรับ: นักพัฒนาที่สแครปเว็บไดนามิก แต่ไม่อยากดูแล infra มาก
- จุดเด่น: API ที่เรียบง่ายสำหรับการเรนเดอร์, พร็อกซี และ browser automation
- ข้อควรระวัง: มันคือบริการโครงสร้างพื้นฐาน ดังนั้นคุณยังต้องดู parsing, retry logic และคุณภาพข้อมูลปลายทางเอง
- รูปแบบราคา: ทดลองใช้และแพ็กเกจเสียเงิน
12. ScraperAPI
ScraperAPI ยังเป็นหนึ่งในวิธีที่ง่ายที่สุดในการย้ายภาระเรื่องพร็อกซีและอัตราคำขอสำเร็จไปให้ผู้ให้บริการ เมื่อคุณต้องการขยายงานอย่างรวดเร็ว
- เหมาะที่สุดสำหรับ: นักพัฒนาที่ต้องการไต่จากต้นแบบไปสู่ปริมาณงานจริงแบบเร็ว
- จุดเด่น: API ตรงไปตรงมา, เครดิตทดลอง, ผลิตภัณฑ์ที่มีโครงสร้าง และระดับสเกลที่ชัดเจน
- ข้อควรระวัง: เหมือนผลิตภัณฑ์ API-first อื่น ๆ มันไม่ได้ทำให้คุณไม่ต้องคิดเรื่อง parsing และการตรวจสอบคุณภาพข้อมูล
- รูปแบบราคา: ทดลอง 7 วันพร้อม 5,000 เครดิต, เริ่มที่ $49/เดือน
13. Bright Data
Bright Data เป็นตัวหนักของกลุ่มเมื่อความสามารถในการปลดบล็อก, คลังพร็อกซี และการจัดหาข้อมูลแบบ managed สำคัญกว่าความเรียบง่ายของเครื่องมือ
- เหมาะที่สุดสำหรับ: โปรแกรมระดับองค์กร, การเก็บข้อมูลสเกลใหญ่ที่ต้องคำนึงถึง compliance และการจัดหาข้อมูลแบบจัดการให้
- จุดเด่น: ครอบคลุมทั้งพร็อกซี, scraper, browser และ dataset products
- ข้อควรระวัง: แพง และซื้อเกินความต้องการได้ง่ายถ้าเวิร์กโฟลว์หลักยังไม่ได้ซับซ้อนมาก
- รูปแบบราคา: คิดตามการใช้งานและตามผลิตภัณฑ์ใน API, พร็อกซี และบริการ managed
14. Oxylabs
Oxylabs ยังคงเป็นตัวเลือกที่แข็งแรงสำหรับทีมที่ซื้อ scraping ในฐานะโครงสร้างพื้นฐาน มากกว่าจะเป็นเครื่องมือบนเบราว์เซอร์ มันสำคัญเป็นพิเศษเมื่อความเสถียรและความพร้อมของกระบวนการจัดซื้อมีความหมาย
- เหมาะที่สุดสำหรับ: การเก็บข้อมูลระดับองค์กร, มอนิเตอร์ราคา, มอนิเตอร์ SEO และ market research
- จุดเด่น: เรื่องโครงสร้างพื้นฐานแข็งแรง, พร็อกซีแน่น และกระบวนการขายสู่ enterprise ชัดเจน
- ข้อควรระวัง: ไม่เหมาะถ้าทีมของคุณอยากได้เวิร์กโฟลว์แบบ self-serve สบาย ๆ
- รูปแบบราคา: Web Scraper API เริ่มที่ $49/เดือน; ผลิตภัณฑ์อื่น ๆ แตกต่างตามหน่วยและการใช้งาน
15. Zyte
Zyte ยังควรค่าแก่การพิจารณาอย่างจริงจังสำหรับทีมพัฒนาและทีมข้อมูลที่ต้องการ anti-detection, browser actions, การเรนเดอร์ JS และ IP rotation ภายใต้เรื่องเล่าแบบ API-first เดียวกัน
- เหมาะที่สุดสำหรับ: ทีมเทคนิคที่สร้างระบบ extraction ซ้ำได้
- จุดเด่น: browser actions, การเรนเดอร์ JS, IP rotation และแนวทาง anti-bot ในสแต็กเดียว
- ข้อควรระวัง: เหมาะกับทีมที่มีเจ้าของด้านวิศวกรรม มากกว่าผู้ใช้สายไม่เทคนิค
- รูปแบบราคา: ทดลองพร้อมเครดิตฟรี $5 และผูกตามการใช้งานรายเดือน
ลองเวิร์กโฟลว์ที่ง่ายกว่าก่อนจะสร้างระบบเกินจำเป็น ก่อนที่คุณจะลงไปผูกกับพร็อกซีและโค้ด ลองดูว่า AI scraper แบบคลิกเดียวพาไปได้ไกลแค่ไหน Get Started Free
ไลบรารีโอเพนซอร์สที่ดีที่สุดสำหรับนักพัฒนาที่ต้องการควบคุมทั้งหมดเอง
ถ้าคุณอยากดูแลสแต็ก scraper ตั้งแต่ต้นน้ำถึงปลายน้ำ เครื่องมือเหล่านี้คือบล็อกสร้างที่มีประโยชน์ที่สุดในปี 2026
16. Selenium
Selenium ยังมีประโยชน์เมื่อคุณต้องการความแม่นยำของการโต้ตอบสไตล์ QA, เวิร์กโฟลว์ automation บนเบราว์เซอร์แบบเก่า หรือการควบคุม user flow ที่ชัดเจนมาก
- เหมาะที่สุดสำหรับ: automation ที่มี interaction หนัก, งานที่ทับซ้อนกับ QA และเว็บไซต์ที่พฤติกรรมเบราว์เซอร์สำคัญกว่าปริมาณ crawl
- จุดเด่น: อีโคซิสเต็ม成熟และรองรับเบราว์เซอร์หลากหลาย
- ข้อควรระวัง: หนักและช้ากว่าเครื่องมือเบราว์เซอร์รุ่นใหม่สำหรับงานสแครปหลายแบบ
- รูปแบบราคา: ฟรีและโอเพนซอร์ส
17. BeautifulSoup4
BeautifulSoup ไม่ใช่แพลตฟอร์มสแครปครบวงจร แต่ยังเป็นหนึ่งในวิธีที่ง่ายที่สุดในการ parse HTML ที่เละ ๆ ในเวิร์กโฟลว์ขนาดเบา
- เหมาะที่สุดสำหรับ: มือใหม่, สคริปต์เร็ว ๆ และงานที่เริ่มจาก parser เป็นหลัก
- จุดเด่น: API เข้าใจง่ายและใช้ความคิดน้อย
- ข้อควรระวัง: ต้องใช้คู่กับ request, browser หรือ crawler tooling; ถ้าใช้ลำพังมันเป็นแค่ parser
- รูปแบบราคา: ฟรีและโอเพนซอร์ส
18. Scrapy
Scrapy ยังเป็นคำตอบที่ดีที่สุดเมื่อคุณต้องการ crawler framework จริง ๆ แทนที่จะเป็นสคริปต์ไม่กี่ไฟล์
- เหมาะที่สุดสำหรับ: ตัว crawler แบบกำหนดเองเพื่อโปรดักชัน และ data pipeline ที่องค์กรดูแลเอง
- จุดเด่น: ประสิทธิภาพสูง, pipeline, middleware และขยายต่อในระยะยาวได้ดี
- ข้อควรระวัง: มีภาระด้านวิศวกรรมจริง และเป้าหมายที่ใช้ JS หนักมักต้องมีเครื่องมือเสริม
- รูปแบบราคา: ฟรีและโอเพนซอร์ส
19. Puppeteer
Puppeteer ยังเหมาะมากสำหรับทีมที่ใช้ Node เป็นหลักและอยากควบคุม Chromium กับ browser scripting ได้โดยตรง
- เหมาะที่สุดสำหรับ: การสแครปด้วย Node, การจับภาพหน้าจอ และงานอัตโนมัติบนเบราว์เซอร์
- จุดเด่น: ควบคุมพฤติกรรม Chromium ได้ตรงและทรงพลัง
- ข้อควรระวัง: เรื่องเบราว์เซอร์แคบกว่า Playwright และกินทรัพยากรสูงเมื่อสเกลใหญ่
- รูปแบบราคา: ฟรีและโอเพนซอร์ส
20. Playwright
Playwright คือคำแนะนำเริ่มต้นของฉันสำหรับ browser automation สมัยใหม่ ถ้าทีมของคุณเขียนโค้ดและอยากได้ abstraction ที่ใหม่กว่า Selenium
- เหมาะที่สุดสำหรับ: browser automation ยุคใหม่, เว็บไซต์ที่ใช้ JS หนัก และทีมที่สนใจประสบการณ์นักพัฒนา
- จุดเด่น: โมเดลหลายเบราว์เซอร์ที่แข็งแรง, การรอโหลดที่เชื่อถือได้ และ API ที่สะอาด
- ข้อควรระวัง: คุณยังต้องดูแล infra ของเบราว์เซอร์, concurrency, selector drift และการตรวจสอบข้อมูลเอง
- รูปแบบราคา: ฟรีและโอเพนซอร์ส
รายชื่อแนะนำแบบย่อ แยกตามประเภททีม
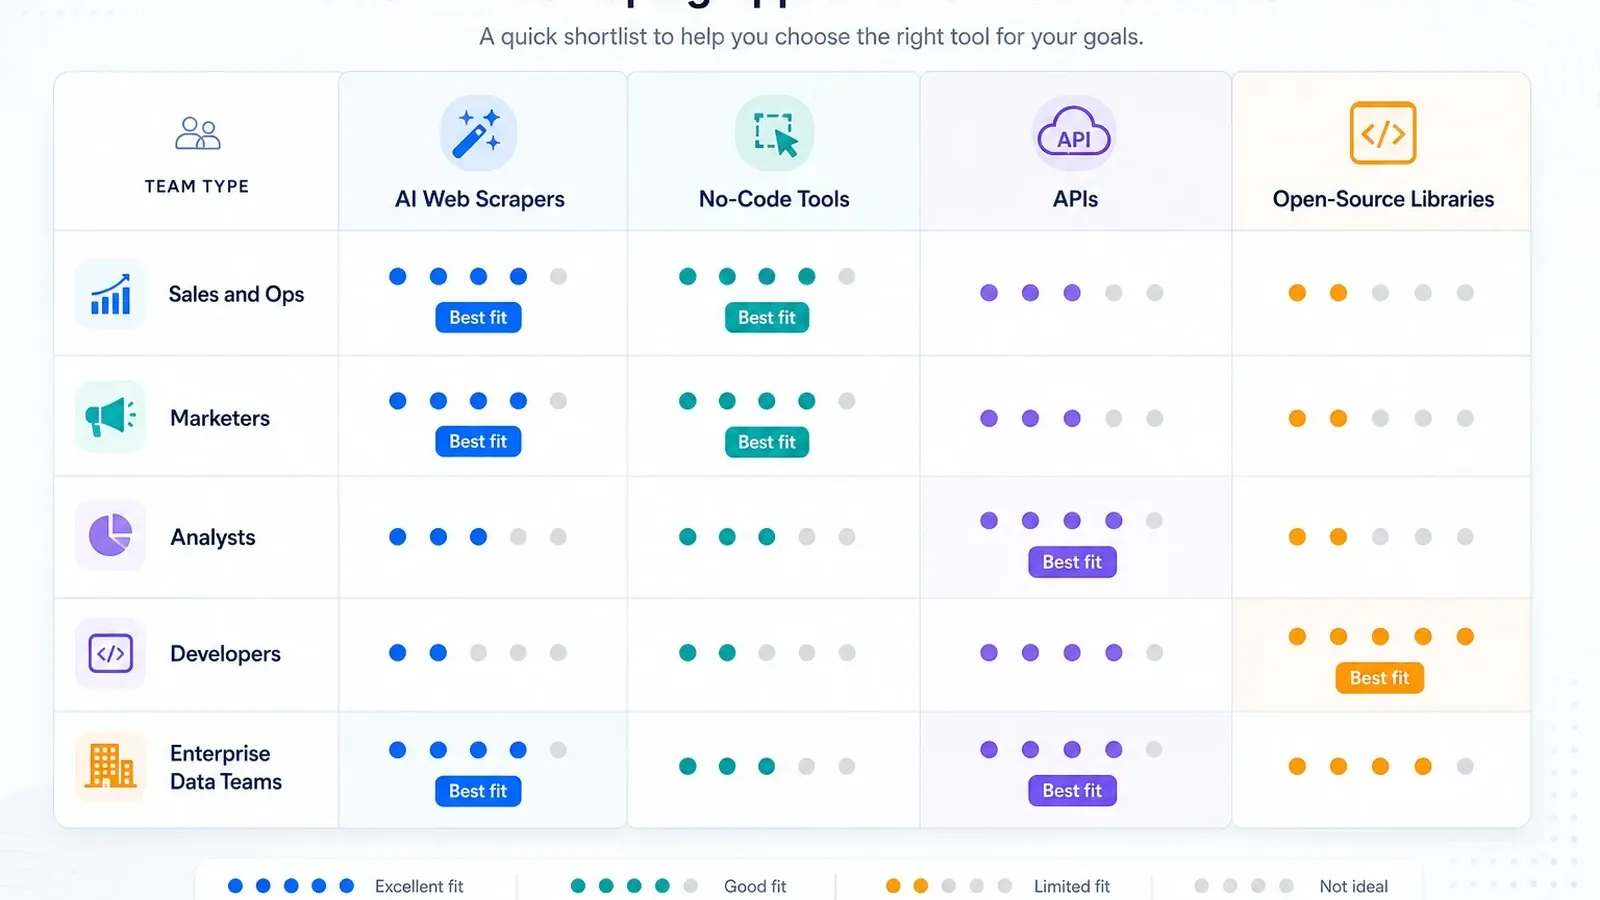
- ทีมขายและ ops: เริ่มจาก Thunderbit แล้วค่อยดู Browse AI ถ้าการมอนิเตอร์สำคัญกว่าการเสริมข้อมูลจากซับเพจ
- ทีมนักวิเคราะห์และวิจัย: Octoparse ก่อน ถ้างานซ้ำ ๆ ใหญ่เกินกว่าที่เครื่องมือบนเบราว์เซอร์จะรับมือได้อย่างสบาย
- ทีม GTM ที่พึ่งพา automation สูง: Bardeen ถ้าการสแครปเป็นเพียงหนึ่งขั้นตอนในเวิร์กโฟลว์ที่กว้างกว่า
- ทีมพัฒนาที่สร้างเครื่องมือภายใน: Apify, Zyte, ScraperAPI หรือ Playwright แล้วแต่คุณอยากถือครองสแต็กมากแค่ไหน
- โปรแกรมข้อมูลระดับองค์กร: Bright Data, Oxylabs, Diffbot และ Zyte คือบทสนทนาเรื่องโครงสร้างพื้นฐานที่จริงจัง
เมื่อไหร่ควรขยับลงสแต็ก
ใช้กฎนี้:
- อยู่กับ AI tools จนกว่าคุณจะชนข้อจำกัดเรื่องความทำซ้ำได้หรือกรณีขอบ ๆ
- ขยับไป no-code tools เมื่อ scheduling, pagination, anti-blocking หรือการรันบนคลาวด์สำคัญกว่าความง่ายแบบคลิกเดียว
- ขยับไป APIs เมื่ออัตราการปลดบล็อก, การเรนเดอร์ JS และ concurrency กลายเป็นคอขวดจริง
- ขยับไป open-source libraries เมื่อราคาของ abstraction จาก vendor สูงกว่าค่าการดูแลสแต็กทั้งหมดเอง
ทีมส่วนใหญ่มักขยับลงสแต็กเร็วเกินไป นั่นเป็นหนึ่งในความผิดพลาดที่ฉันเห็นบ่อยที่สุด
สรุปสุดท้าย
สำหรับทีมที่ไม่ใช่สายเทคนิคส่วนใหญ่ คำตอบที่ถูกในปี 2026 ไม่ใช่ “scraper ที่ทรงพลังที่สุด” แต่คือเครื่องมือที่ทำให้ข้อมูลแม่นยำไหลเข้าขั้นตอนงานถัดไปได้ โดยมีการดูแลน้อยที่สุด นั่นจึงเป็นเหตุผลที่เครื่องมือ AI-first ยังชนะสำหรับผู้ปฏิบัติงาน ขณะที่ API และสแต็กโอเพนซอร์สยังเหมาะกว่าสำหรับทีมเทคนิคที่มีความต้องการด้านสเกลชัดเจน
ถ้าคุณต้องการเส้นทางที่สั้นที่สุดจากหน้าเว็บไปสู่ผลลัพธ์แบบมีโครงสร้าง ให้เริ่มที่ Thunderbit ถ้าคุณรู้แล้วว่างานของคุณต้องใช้โครงสร้างพื้นฐานหนัก ให้ข้ามไปที่เลเยอร์ API และนักพัฒนาได้เลย แต่อย่าสับสนระหว่างความซับซ้อนกับความล้ำสมัย
เริ่มจากเครื่องมือที่เบาที่สุดซึ่งยังทำงานได้จริง Get Started Free
คำถามที่พบบ่อย
1. เครื่องมือเว็บสแครปปิ้งที่ดีที่สุดสำหรับผู้ใช้ที่ไม่ใช่สายเทคนิคในปี 2026 คืออะไร?
สำหรับผู้ใช้ที่ไม่ใช่สายเทคนิคส่วนใหญ่ เครื่องมือแบบ AI-first อย่าง Thunderbit และ Browse AI จะพาไปสู่ข้อมูลที่ใช้งานได้เร็วที่สุด เพราะลดงานเรื่อง selectors, ความยุ่งยากในการตั้งค่า และภาระการดูแล
2. ถ้าเว็บไซต์ของฉันใช้ JavaScript หนัก หรือบล็อกคำขออย่างเข้มงวด ควรเลือกอะไร?
ให้ขยับไปทาง ScrapingBee, ScraperAPI, Zyte, Bright Data, Oxylabs, Playwright หรือ Selenium ขึ้นอยู่กับว่าคุณต้องการบริการแบบ managed หรือควบคุมเชิงวิศวกรรมโดยตรง
3. เครื่องมือ no-code ยังมีความสำคัญอยู่ไหม ในเมื่อ AI web scraper ดีกว่าแล้ว?
มีอยู่แน่นอน เครื่องมือ no-code อย่าง Octoparse และ ParseHub ยังสำคัญเมื่อคุณต้องการการควบคุมตรรกะงาน, การรันบนคลาวด์ และการจัดการงานซ้ำอย่างชัดเจนกว่า
4. เครื่องมือไหนเหมาะกับทีมวิศวกรรมมากที่สุด?
Apify, Zyte, ScraperAPI, Scrapy, Playwright, Puppeteer และ Selenium เป็นตัวเลือกที่เป็นธรรมชาติที่สุดเมื่อฝั่งนักพัฒนาเป็นเจ้าของเวิร์กโฟลว์
5. จะคัดรายชื่ออย่างรวดเร็วแทนที่จะรีเสิร์ชยาว ๆ ได้อย่างไร?
ให้เลือก “ประเภทเครื่องมือ” ก่อน “ผู้ขาย” ตัดสินใจก่อนว่าคุณต้องการความง่ายแบบ AI, การคุมงานแบบ no-code, โครงสร้างพื้นฐานแบบ API หรือการเป็นเจ้าของแบบ open-source แล้วค่อยเทียบผลิตภัณฑ์ภายในเลเยอร์นั้น
อ่านต่อที่เกี่ยวข้อง




