
เว็บเต็มไปด้วยข้อมูลมหาศาล และในปี 2026 การแข่งขันเพื่อเปลี่ยนความวุ่นวายนั้นให้กลายเป็นคุณค่าทางธุรกิจยิ่งดุเดือดกว่าเดิม ผมได้เห็นทีมขาย ทีมอีคอมเมิร์ซ และทีมปฏิบัติการเปลี่ยนวิธีทำงานของตัวเองไปแบบแทบจะคนละเรื่อง ด้วยการอัตโนมัติงานที่เมื่อก่อนต้องเสียเวลาเป็นชั่วโมงไปกับการคัดลอกและวางซ้ำ ๆ ทุกวัน ถ้าคุณยังไม่ได้ใช้ซอฟต์แวร์ขูดข้อมูลเว็บ คุณไม่ได้แค่ตามหลังคู่แข่งเท่านั้น—คุณอาจยังติดอยู่ในนรกของสเปรดชีต ในขณะที่คู่แข่งของคุณกำลังจิบกาแฟแก้วที่สองกันไปแล้ว
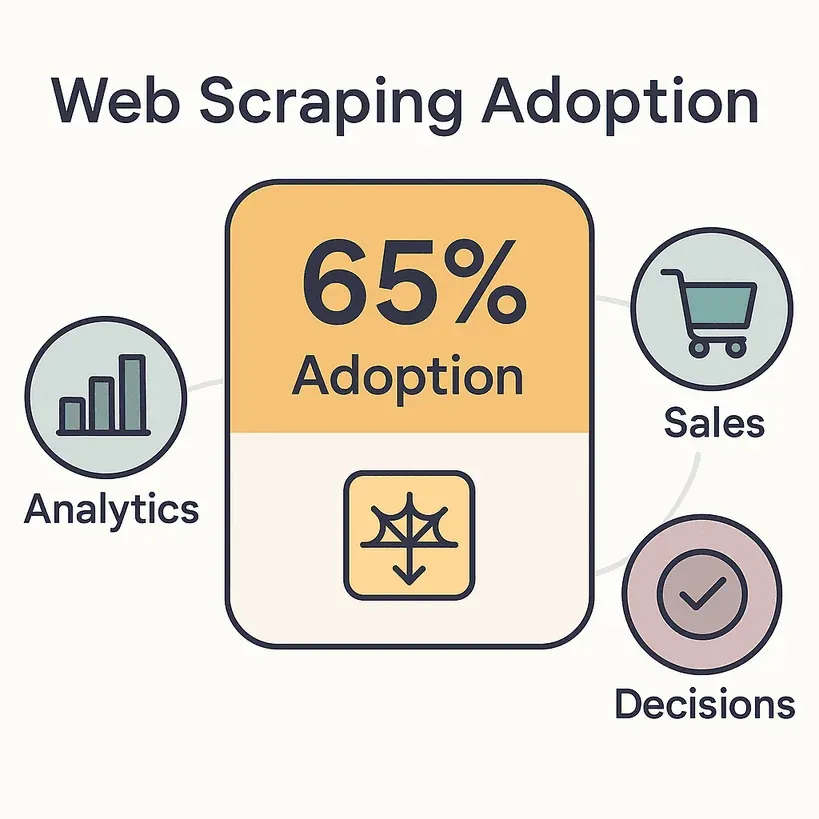
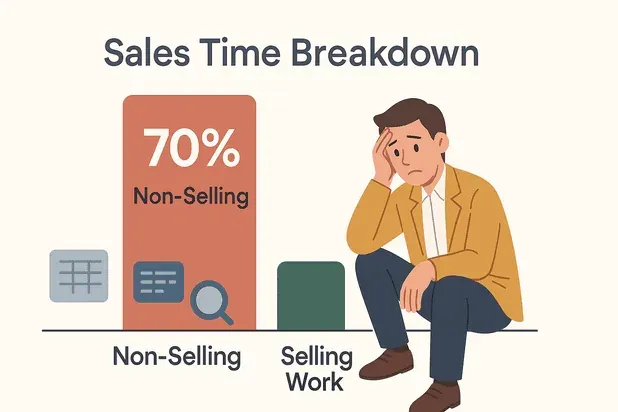
ความจริงก็คือ 65% ขององค์กรตอนนี้ใช้เครื่องมือขูดข้อมูลเว็บ เพื่อส่งต่อข้อมูลไปยังงานวิเคราะห์ งานขาย และการตัดสินใจทางธุรกิจ ตลาดการดึงข้อมูลจากเว็บทั่วโลกมีมูลค่าสูงถึง มากกว่า 1 พันล้านดอลลาร์ แล้ว และคาดว่าจะโตเป็นสองเท่าภายในปี 2030 ตัวแทนฝ่ายขายจำนวนมากต้องเสียเวลาส่วนใหญ่ของสัปดาห์ไปกับงานที่ไม่ใช่งานขาย เช่น การกรอกข้อมูลและการค้นคว้า นั่นคือเวลาจำนวนมากที่ควรเอาไปปิดดีลจริง ๆ หรืออย่างน้อยก็ใช้พักกินมื้อกลางวันแบบไม่ต้องรีบ
แล้วซอฟต์แวร์ขูดข้อมูลเว็บที่ดีที่สุดสำหรับปี 2026 คืออะไร? ผมได้ลงลึกสำรวจเครื่องมือ 5 อันดับแรกที่กำลังเปลี่ยนเกมให้กับทีมทุกขนาดและทุกระดับทักษะทางเทคนิค ไม่ว่าคุณจะเป็นคนไม่เขียนโค้ดที่อยากกดแล้วใช้งานได้เลย หรือเป็นนักพัฒนาที่ต้องการความยืดหยุ่นสูงสุด ที่นี่มีตัวเลือกที่เหมาะกับคุณแน่นอน
อะไรทำให้ซอฟต์แวร์ขูดข้อมูลเว็บ “ดีที่สุด”
Data Scraping คืออะไร และทำอย่างไรในปี 2025 Get Started Free
เอาตรง ๆ เลยนะ: เว็บสแครปเปอร์ไม่ได้ดีเหมือนกันทุกตัว ซอฟต์แวร์ขูดข้อมูลเว็บที่ดีที่สุดในปี 2026 ต้องโดดเด่นด้วยความสามารถในการดึงข้อมูลที่ เร็ว เสถียร และเข้าถึงได้สำหรับทุกคน ไม่ใช่แค่คนที่ฝันเป็นภาษา Python
นี่คือเกณฑ์สำคัญที่ผมใช้ดู และเป็นสิ่งที่ผู้ใช้สายธุรกิจให้ความสำคัญมากที่สุด:
- ใช้งานง่าย: ผู้ใช้ที่ไม่ใช่สายเทคนิคสามารถตั้งค่าการดึงข้อมูลได้ภายในไม่กี่นาทีหรือไม่? อินเทอร์เฟซแบบ no-code และ AI-driven เป็นสิ่งจำเป็นสำหรับหลายทีม
- ยืดหยุ่นกับแหล่งข้อมูล: รองรับหน้าเว็บ PDF รูปภาพ และคอนเทนต์แบบไดนามิกหรือไม่ เช่น infinite scroll หรือ AJAX? ยิ่งรองรับหลายแหล่ง ยิ่งดี
- อัตโนมัติและการตั้งเวลา: ตั้งงานดึงข้อมูลซ้ำ ๆ ได้ไหม จัดการ pagination ได้หรือไม่ และนำทางไปยังหน้าย่อยแบบอัตโนมัติได้หรือเปล่า? ระบบอัตโนมัติคือเส้นแบ่งระหว่าง “ตั้งครั้งเดียวแล้วปล่อย” กับ “ตั้งแล้วต้องคอยดูตลอด”
- การเชื่อมต่อและการส่งออก: ส่งออกตรงไปยัง Excel, Google Sheets, Notion, Airtable หรือผ่าน API ได้ไหม? ยิ่งต้องทำมือให้น้อย ทีมก็ยิ่งทำงานสบายขึ้น
- ทักษะเทคนิคที่ต้องใช้: เป็นแบบ no-code จริงหรือไม่ หรือยังต้องไปทบทวน regex กันอยู่? เครื่องมือที่ดีควรรองรับทั้งคนไม่เขียนโค้ดและผู้ใช้ระดับโปร
- รองรับการขยายตัว: ดึงข้อมูลจากหลายร้อยหรือหลายพันหน้าได้โดยไม่สะดุดหรือเปล่า?
- การซัพพอร์ตและคอมมูนิตี้: มีเอกสารที่ดี ทีมซัพพอร์ตตอบไว และฐานผู้ใช้งานที่ยัง active อยู่หรือไม่?
เกณฑ์เหล่านี้ไม่ใช่แค่ของที่มีแล้วก็ดี—แต่มันคือสิ่งที่แยกเครื่องมือที่ช่วยคุณประหยัดเวลาเป็นชั่วโมงออกจากเครื่องมือที่ทำให้คุณเสียเวลาเป็นวัน ๆ ในปี 2026 ที่ เกือบครึ่งหนึ่งของทราฟฟิกอินเทอร์เน็ตทั้งหมดมาจากบอท การมีสแครปเปอร์ที่เหมาะสมจึงกลายเป็นความได้เปรียบทางการแข่งขัน
เอาล่ะ มาดู 5 อันดับแรกกันเลย
5 อันดับซอฟต์แวร์ขูดข้อมูลเว็บที่ดีที่สุดในปี 2026
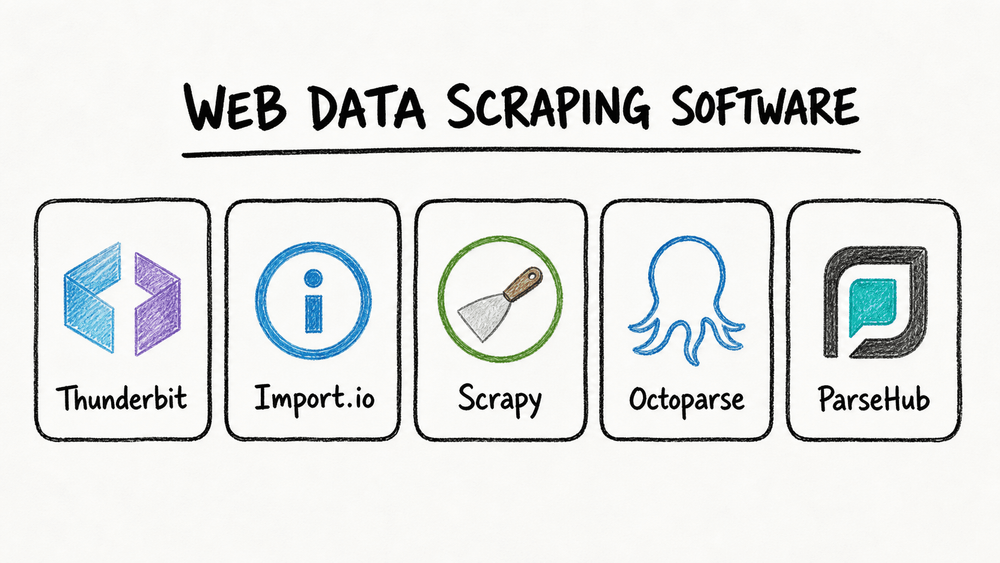
- Thunderbit สำหรับการขูดข้อมูลแบบ no-code ที่ขับเคลื่อนด้วย AI และรองรับหลายแหล่งข้อมูล
- Import.io สำหรับไปป์ไลน์ข้อมูลระดับองค์กรที่ผสานการทำงานได้ดี
- Scrapy สำหรับความยืดหยุ่นแบบโอเพนซอร์สที่ให้นักพัฒนาคุมได้เต็มที่
- Octoparse สำหรับการขูดข้อมูลแบบ no-code ผ่านหน้าตาเชิงภาพ พร้อมการตั้งเวลา
- ParseHub สำหรับการดึงข้อมูลแบบ point-and-click ที่ใช้งานง่าย
1. Thunderbit: ซอฟต์แวร์ขูดข้อมูลเว็บด้วย AI ที่ใช้งานง่ายที่สุด
ดึงข้อมูลจากทุกเว็บไซต์ด้วย AI Get Started Free
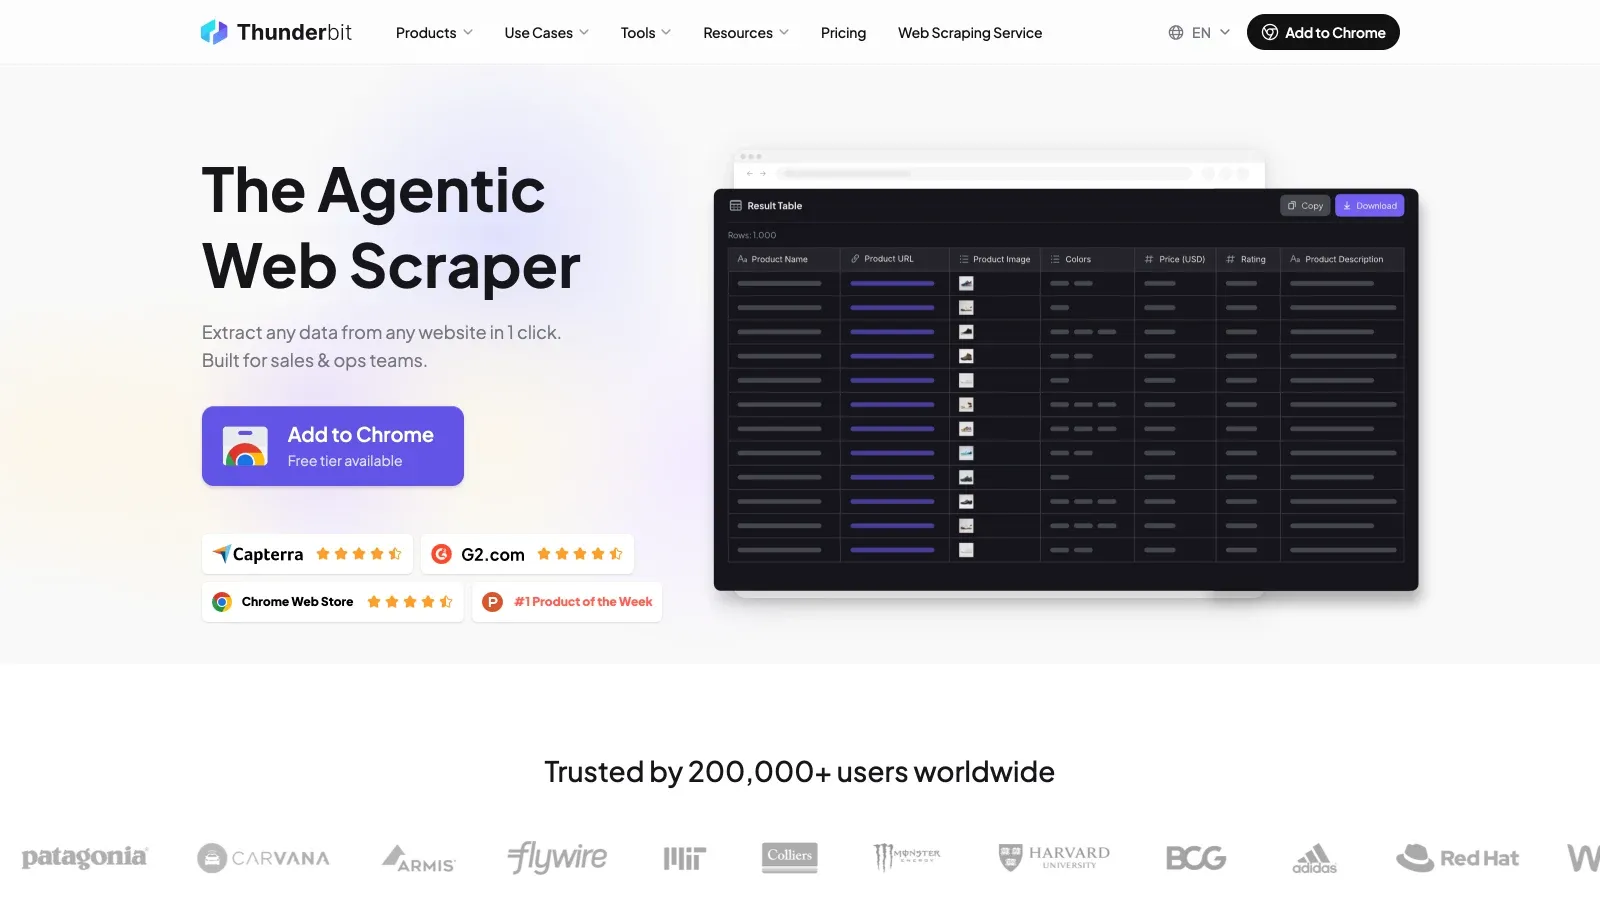
Thunderbit คือเครื่องมือที่ผมแนะนำเป็นอันดับแรกสำหรับใครก็ตามที่อยากขูดข้อมูลเว็บโดยไม่ต้องเขียนโค้ดแม้แต่บรรทัดเดียว และใช่ ผมอาจมีอคตินิดหน่อย—เพราะผมมีส่วนช่วยสร้างมันขึ้นมาเอง—but ขอให้ฟังก่อน: Thunderbit ถูกออกแบบมาสำหรับผู้ใช้สายธุรกิจที่ต้องการผลลัพธ์ ไม่ใช่ปวดหัว
อะไรทำให้ Thunderbit โดดเด่น?
- AI Suggest Fields: แค่กด “AI Suggest Fields” แล้ว AI ของ Thunderbit จะอ่านหน้าเว็บ แนะนำว่าควรดึงข้อมูลอะไร และตั้งค่าสแครปเปอร์ให้คุณทันที ไม่ต้องเลือก selector ไม่ต้องสร้างเทมเพลต ไม่ต้องดราม่า
- ขูดข้อมูลได้หลายแหล่ง: ไม่ได้มีแค่หน้าเว็บ แต่ยังรองรับ PDF และรูปภาพด้วย Thunderbit ดึงข้อความ ลิงก์ อีเมล เบอร์โทร และรูปภาพได้ในสองคลิก
- อัตโนมัติสำหรับหน้าย่อยและ pagination: ถ้าต้องดึงรายละเอียดจากทุกหน้าสินค้าหรือทุกโปรไฟล์ Thunderbit จะไล่ตามลิงก์ เก็บข้อมูลเพิ่ม แล้วรวมกลับมาเป็นตารางเดียว ยังรับมือ infinite scroll และ pagination ได้ดีมาก
- ขูดข้อมูลแบบ batch และตั้งเวลาได้: วางรายการ URL ตั้งงานให้รันซ้ำได้ แล้วปล่อยให้ Thunderbit จัดการงานหนักเอง ไม่ว่าจะเป็นการติดตามราคาทุกวันหรืออัปเดตลีดรายสัปดาห์
- ส่งออกได้ทันที: ส่งออกตรงไปยัง Excel, Google Sheets, Airtable, Notion, CSV หรือ JSON ได้ ไม่ต้องมานั่งคัดลอกวางซ้ำ ๆ อีก
- Custom AI Prompts: อยากจัดหมวดหมู่ แปลภาษา หรือใส่ป้ายกำกับให้ข้อมูลระหว่างดึงข้อมูล? แค่เพิ่มคำสั่งเฉพาะ แล้ว AI ของ Thunderbit จะจัดการให้
- Cloud หรือ Browser Mode: รันงานในคลาวด์เพื่อความเร็ว (ครั้งละ 50 หน้า) หรือรันแบบโลคัลสำหรับเว็บที่ต้องล็อกอิน
Thunderbit ได้รับความไว้วางใจจากผู้ใช้งานกว่า 200,000 คนทั่วโลก ตั้งแต่ทีมขาย ตัวแทนอสังหาริมทรัพย์ ไปจนถึงร้านอีคอมเมิร์ซขนาดเล็ก แพ็กเกจฟรีให้คุณขูดข้อมูลได้สูงสุด 6 หน้า/เดือน และจ่ายตามการใช้งานจริง—หนึ่งเครดิตต่อหนึ่งแถวผลลัพธ์
ทำไมผมถึงชอบมัน: Thunderbit เป็นเครื่องมือเดียวที่ผมเคยเห็นว่า ผู้ใช้ที่ไม่ถนัดเทคนิคสามารถเปลี่ยนจาก “ฉันต้องการข้อมูลนี้” ไปเป็น “นี่คือสเปรดชีตของฉัน” ได้ภายในไม่ถึงห้านาที อินเทอร์เฟซใช้งานสบายจริง ๆ (เราคิดมาเยอะมากกับเรื่องนี้) และ AI ยังปรับตัวตามการเปลี่ยนแปลงของเว็บไซต์ได้ ทำให้คุณไม่ต้องมานั่งแก้สแครปเปอร์ที่พังอยู่เรื่อย ๆ
เหมาะสำหรับ: ทีมขาย อีคอมเมิร์ซ งานปฏิบัติการ และทุกคนที่ต้องการการขูดข้อมูลแบบ no-code ด้วย AI ที่แทบไม่ต้องดูแล
ลองใช้ส่วนขยาย Chrome ของ Thunderbit
ดู Thunderbit Blog สำหรับคู่มือเพิ่มเติม
2. Import.io: การขูดข้อมูลเว็บและการเชื่อมต่อระดับองค์กร
Import.io คือแชมป์รุ่นเฮฟวี่เวตสำหรับองค์กรที่ต้องการข้อมูลเว็บในระดับใหญ่ และต้องการเชื่อมเข้ากับระบบธุรกิจโดยตรง
อะไรที่ทำให้ Import.io แตกต่าง?
- ไปป์ไลน์พร้อมใช้งานระดับองค์กร: Import.io ไม่ใช่แค่สแครปเปอร์ แต่เป็นแพลตฟอร์มผสานข้อมูลจากเว็บแบบครบวงจร คิดแบบ “data-as-a-service” ที่ส่งข้อมูลอย่างต่อเนื่องและอัตโนมัติ
- AI แบบ Self-Healing: ถ้าเว็บไซต์มีการเปลี่ยนแปลง AI ของ Import.io จะพยายามจับคู่ฟิลด์ใหม่ให้อัตโนมัติ ทำให้ไปป์ไลน์ของคุณไม่พังข้ามคืน
- ระบบอัตโนมัติที่แข็งแรง: ตั้งรันงานรายชั่วโมง รายวัน หรือกำหนดช่วงเวลาเองได้ พร้อมแจ้งเตือนเมื่อมีปัญหาหรือข้อมูลดูผิดปกติ
- เวิร์กโฟลว์แบบอินเทอร์แอ็กทีฟ: จัดการเว็บที่ต้องล็อกอิน มีฟอร์ม หรือมีขั้นตอนหลายสเต็ปได้ Import.io สามารถบันทึกและเล่นซ้ำลำดับขั้นตอนที่ซับซ้อนได้
- Compliance และ Governance: มีการตรวจจับ PII อัตโนมัติ การปกปิดข้อมูล และบันทึก audit log ซึ่งสำคัญมากสำหรับอุตสาหกรรมที่มีกฎระเบียบเข้มงวด
- API และการเชื่อมต่อ: ส่งข้อมูลตรงไปยัง Google Sheets, Excel, Tableau, Power BI, ฐานข้อมูล หรือแอปของคุณเองผ่าน API ได้
Import.io ได้รับความไว้วางใจจากแบรนด์อย่าง Unilever, Volvo และ RedHat มักถูกใช้กับกรณีอย่างการติดตามราคาจากเว็บไซต์อีคอมเมิร์ซนับพันแห่ง งาน market intelligence หรือป้อนข้อมูลเว็บล่าสุดเข้าโมเดล AI/ML
ราคา: Import.io เป็นโซลูชันระดับพรีเมียม โดยเริ่มราว ๆ $199/เดือนสำหรับแพ็กเกจแบบ self-service มีทดลองใช้ฟรี แต่ไม่มีแพ็กเกจฟรีระยะยาว ถ้าข้อมูลเว็บเป็นเรื่องสำคัญต่อธุรกิจจริง ๆ ผลตอบแทนก็คุ้ม
เหมาะสำหรับ: องค์กรและทีมที่ขับเคลื่อนด้วยข้อมูล ซึ่งต้องการความเสถียร การขยายตัว การปฏิบัติตามข้อกำหนด และการเชื่อมต่อเชิงลึก
3. Scrapy: เฟรมเวิร์กขูดข้อมูลเว็บแบบโอเพนซอร์สสำหรับนักพัฒนา
Scrapy คือขุมพลังโอเพนซอร์สสำหรับนักพัฒนาที่ต้องการความยืดหยุ่นและการควบคุมสูงสุด ถ้าคุณหรือทีมของคุณเขียน Python ได้ Scrapy ก็คือมีดสวิสอาร์มีของงานขูดข้อมูลเว็บ
ทำไมนักพัฒนาถึงชอบ Scrapy:
- ปรับแต่งได้เต็มที่: เขียนสไปเดอร์ (scripts) เพื่อ crawl, parse และประมวลผลข้อมูลได้ตามที่ต้องการ จัดการ multi-page flow ตรรกะเฉพาะทาง และการทำความสะอาดข้อมูลที่ซับซ้อนได้
- ทำงานแบบ asynchronous และเร็วมาก: สถาปัตยกรรมของ Scrapy ถูกสร้างมาเพื่อความเร็วและสเกล—ขูดได้หลายร้อยหน้า/นาที หรือเป็นล้านหน้าด้วย distributed crawler
- ขยายความสามารถได้ง่าย: มี ecosystem ของปลั๊กอินและ middleware จำนวนมากสำหรับ proxy, headless browser (Splash/Playwright) และการเชื่อมต่อกับระบบอื่น ๆ
- ฟรีและโอเพนซอร์ส: ไม่มีค่าลิขสิทธิ์ รันบนฮาร์ดแวร์หรือคลาวด์ของคุณเองได้ และขยายได้ตามต้องการ
- ซัพพอร์ตจากคอมมูนิตี้: มีดาวบน GitHub กว่า 55,000 ดวงและฐานผู้ใช้ขนาดใหญ่ ถ้าคุณเจอปัญหา โอกาสสูงว่ามีคนเคยแก้ไว้แล้ว
ข้อควรระวัง: Scrapy ต้องมีทักษะ Python และความคุ้นเคยกับ command line ไม่มี UI แบบ point-and-click—นี่คือพื้นที่ของโค้ดล้วน ๆ แต่สำหรับโปรเจกต์เฉพาะทาง ข้อมูลฝึก AI หรือการ crawl ขนาดใหญ่ ไม่มีอะไรเทียบได้
เหมาะสำหรับ: องค์กรที่มีนักพัฒนาในทีม ไปป์ไลน์ข้อมูลแบบกำหนดเอง หรือความต้องการขูดข้อมูลที่ซับซ้อนและขนาดใหญ่
4. Octoparse: การขูดข้อมูลเว็บแบบภาพที่ใช้งานง่าย
Octoparse เป็นตัวโปรดของคนไม่เขียนโค้ดที่ต้องการการขูดข้อมูลทรงพลัง แต่ใช้งานผ่านอินเทอร์เฟซแบบภาพและ point-and-click
ทำไม Octoparse ถึงได้รับความนิยม:
- ตัวสร้างเวิร์กโฟลว์แบบภาพ: คลิกองค์ประกอบต่าง ๆ ในเบราว์เซอร์ในตัว แล้ว Octoparse จะตรวจจับแพตเทิร์นอัตโนมัติ ไม่ต้องเขียนโค้ด แค่คลิกแล้วดึงข้อมูล
- จัดการคอนเทนต์แบบไดนามิกได้: ขูดข้อมูลจาก AJAX, infinite scroll และเว็บที่ต้องล็อกอินได้ จำลองการคลิก การเลื่อน และการส่งฟอร์มได้
- Cloud Scraping และการตั้งเวลา: รันงานบนคลาวด์ได้เร็วขึ้นและแบบขนาน พร้อมตั้งงานซ้ำเพื่อให้ได้ข้อมูลที่สดใหม่เสมอ
- เทมเพลตสำเร็จรูป: มีเทมเพลตกว่าร้อยแบบสำหรับเว็บยอดนิยม (Amazon, Twitter, Zillow ฯลฯ) ช่วยให้เริ่มขูดข้อมูลได้ทันที
- Export และ API: ดาวน์โหลดผลลัพธ์เป็น CSV, Excel, JSON หรือดึงข้อมูลผ่าน API ได้ เชื่อมต่อกับ Google Sheets หรือฐานข้อมูลได้
Octoparse มักถูกอธิบายว่า “ใช้งานง่ายมาก แม้แต่ผู้เริ่มต้น” แพ็กเกจฟรีมีข้อจำกัด แต่แพ็กเกจเสียเงิน (เริ่มราว $69/เดือน) จะปลดล็อกการรันบนคลาวด์ การตั้งเวลา และความเร็วที่มากขึ้น
เหมาะสำหรับ: ผู้ใช้ที่ไม่ใช่สายเทคนิค นักการตลาด นักวิจัย และทีมขนาดเล็กที่ต้องการเก็บข้อมูลอัตโนมัติเป็นประจำโดยไม่ต้องเขียนโค้ด
5. ParseHub: เครื่องมือดึงข้อมูลที่ใช้งานง่ายสำหรับงานประจำวัน
ParseHub ก็เป็นอีกหนึ่งตัวเลือก no-code ที่คนชอบ โดยเฉพาะธุรกิจขนาดเล็กและฟรีแลนซ์ที่อยากอัตโนมัติงานข้อมูลในชีวิตประจำวัน
จุดเด่นของ ParseHub:
- ง่ายแบบ point-and-click: เลือกข้อมูลโดยคลิกองค์ประกอบในมุมมองเบราว์เซอร์ สร้างเวิร์กโฟลว์แบบภาพได้ ไม่ต้องเขียนโค้ด
- รับมือเว็บ JS และเว็บไดนามิกได้: ขูดหน้าเว็บที่ใช้ JavaScript หนัก ๆ, infinite scroll และการนำทางหลายขั้นตอนได้
- รันได้ทั้งคลาวด์และโลคัล: รันงานบนคอมพิวเตอร์ของคุณหรือบนคลาวด์ ตั้งงานซ้ำได้ และเข้าถึงผลลัพธ์ผ่าน API (ในแพ็กเกจที่สูงขึ้น)
- ตัวเลือกการส่งออก: ดาวน์โหลดข้อมูลเป็น CSV, Excel หรือ JSON ได้ รวมถึงมี API สำหรับงานอัตโนมัติ
- รองรับหลายแพลตฟอร์ม: ใช้ได้ทั้ง Windows, Mac และ Linux
แพ็กเกจฟรีของ ParseHub มีข้อจำกัด (200 หน้า/รัน) แต่แพ็กเกจเสียเงิน (เริ่มราว $189/เดือน) จะปลดล็อกพลัง ความเร็ว และการเข้าถึง API มากขึ้น
เหมาะสำหรับ: ธุรกิจขนาดเล็ก ฟรีแลนซ์ และทีมที่มีความต้องการขูดข้อมูลไม่ซับซ้อนมาก ที่อยากได้เครื่องมือแบบภาพที่เชื่อถือได้
ตารางเปรียบเทียบ: ซอฟต์แวร์ขูดข้อมูลเว็บที่ดีที่สุดแบบดูเร็ว ๆ
| เครื่องมือ | ใช้งานง่ายแค่ไหน | แหล่งข้อมูล | ระบบอัตโนมัติและการตั้งเวลา | การเชื่อมต่อและการส่งออก | ทักษะเทคนิค | ราคา |
|---|---|---|---|---|---|---|
| Thunderbit | No-code, ขับเคลื่อนด้วย AI | เว็บ, PDF, รูปภาพ | หน้าย่อย, pagination, ตั้งเวลา, batch | Excel, Sheets, Notion, Airtable, CSV, JSON | ไม่มี | ฟรีเมียม (จ่ายตามแถว) |
| Import.io | UI แบบ point-and-click | เว็บ (static/dynamic, login) | self-healing, ตั้งเวลา, แจ้งเตือน | API, เครื่องมือ BI, Sheets, Excel, DB | ต่ำ–กลาง | $199+/เดือน |
| Scrapy | ต้องเขียนโค้ด | เว็บ, API, (JS ผ่านส่วนเสริม) | อัตโนมัติเต็มรูปแบบผ่านโค้ด | ได้ทุกแบบ (ผ่านโค้ด) | นักพัฒนา Python | ฟรี (โอเพนซอร์ส) |
| Octoparse | ภาพชัด ใช้งานง่ายแบบ no-code | เว็บ (dynamic, login) | ตั้งเวลาบนคลาวด์, เทมเพลต | CSV, Excel, JSON, API | ไม่มี | $69+/เดือน |
| ParseHub | ภาพชัด ใช้งานง่ายแบบ no-code | เว็บ (JS, dynamic) | รันคลาวด์/โลคัล, ตั้งเวลา | CSV, Excel, JSON, API | ไม่มี | $189+/เดือน |
วิธีเลือกซอฟต์แวร์ขูดข้อมูลเว็บที่เหมาะกับธุรกิจของคุณ
ยังไม่แน่ใจว่าเครื่องมือไหนเหมาะกับคุณ? นี่คือชีทสรุปแบบเร็วของผม:
- ผู้ใช้ที่ไม่ถนัดเทคนิค ต้องการผลลัพธ์เร็ว: เลือก Thunderbit หรือ Octoparse. Thunderbit เหนือชั้นสำหรับการขูดข้อมูลทันทีด้วย AI และรองรับหลายแหล่งข้อมูล (เว็บ, PDF, รูปภาพ) ส่วน Octoparse เหมาะมากสำหรับงานขูดข้อมูลแบบภาพและตั้งเวลา
- องค์กรที่ต้องการการเชื่อมต่อ การปฏิบัติตามข้อกำหนด และสเกลใหญ่: Import.io คือคำตอบที่ดีที่สุด สร้างมาเพื่อไปป์ไลน์ข้อมูลที่ต่อเนื่อง เสถียร และเชื่อมต่อเชิงลึก
- นักพัฒนา โปรเจกต์เฉพาะทาง หรือการ crawl ขนาดมหึมา: Scrapy คือทางเลือกที่ควรไป คุณต้องมีทักษะ Python แต่ได้ความยืดหยุ่นแบบไม่จำกัด
- ธุรกิจขนาดเล็ก ฟรีแลนซ์ หรือใช้งานทั่วไปในชีวิตประจำวัน: ParseHub เป็นตัวเลือกที่ดี ใช้งานง่ายแบบ point-and-click และทำงานอัตโนมัติระดับกลางได้
เคล็ดลับในการเลือกเครื่องมือที่เหมาะ:
- เลือกเครื่องมือให้ตรงกับทักษะของทีมและความต้องการด้านข้อมูล
- พิจารณาความซับซ้อนของเว็บไซต์ที่ต้องขูด เช่น คอนเทนต์แบบไดนามิกหรือเว็บที่ต้องล็อกอิน
- คิดล่วงหน้าว่าคุณจะใช้ข้อมูลอย่างไร—ต้องการส่งออกตรงไปยัง Sheets หรือเชื่อมกับ API แบบลึก ๆ?
- เริ่มจากทดลองใช้ฟรีหรือแพ็กเกจฟรีเมียมเพื่อทดสอบงานจริง
- อย่ามองข้ามคุณค่าของซัพพอร์ตและเอกสารที่ดี
สรุป: ปลดล็อกคุณค่าทางธุรกิจด้วยซอฟต์แวร์ขูดข้อมูลเว็บที่ดีที่สุด
ข้อมูลบนเว็บคือเชื้อเพลิงของการตัดสินใจทางธุรกิจที่ฉลาดขึ้นในปี 2026 ซอฟต์แวร์ขูดข้อมูลเว็บที่เหมาะสมช่วยคุณประหยัดเวลา ลดข้อผิดพลาด และทำให้ทีมของคุณได้เปรียบจริง ๆ ไม่ว่าคุณจะกำลังสร้างรายชื่อผู้มุ่งหวัง ติดตามคู่แข่ง หรือป้อนข้อมูลให้กับระบบวิเคราะห์ของคุณ
สรุปสั้น ๆ:
- Thunderbit คือสแครปเปอร์ no-code ที่ใช้งานง่ายที่สุดและขับเคลื่อนด้วย AI สำหรับผู้ใช้สายธุรกิจ
- Import.io คือโซลูชันระดับองค์กรสำหรับไปป์ไลน์ข้อมูลที่ต่อเนื่องและเชื่อมต่อครบวงจร
- Scrapy คือชุดเครื่องมือโอเพนซอร์สสำหรับนักพัฒนาที่ต้องการควบคุมทุกอย่างได้เอง
- Octoparse และ ParseHub ทำให้การขูดข้อมูลแบบภาพและ no-code เข้าถึงได้สำหรับทุกคน
เครื่องมือส่วนใหญ่มีทดลองใช้ฟรีหรือแพ็กเกจฟรีเมียม ดังนั้นลองเอาไปใช้งานจริงดูได้เลย อัตโนมัติงานน่าเบื่อ ปลดล็อกอินไซต์ใหม่ ๆ และปล่อยให้ทีมของคุณไปโฟกัสกับสิ่งที่สำคัญจริง ๆ
ขอให้สนุกกับการขูดข้อมูล—และขอให้ข้อมูลของคุณสดใหม่ มีโครงสร้างดี และพร้อมใช้งานเสมอ
คำถามที่พบบ่อย
1. ซอฟต์แวร์ขูดข้อมูลเว็บใช้ทำอะไร?
ซอฟต์แวร์ขูดข้อมูลเว็บช่วยอัตโนมัติขั้นตอนการดึงข้อมูลจากเว็บไซต์ PDF และรูปภาพ ใช้กับงานสร้างลีด การติดตามราคา งานวิจัยตลาด การรวบรวมคอนเทนต์ และอื่น ๆ
2. การขูดข้อมูลเว็บถูกกฎหมายไหม?
การขูดข้อมูลเว็บทำได้ถูกกฎหมายเมื่อเก็บข้อมูลที่เปิดเผยต่อสาธารณะ และเคารพเงื่อนไขการใช้งานของเว็บไซต์รวมถึงกฎหมายความเป็นส่วนตัว ควรตรวจนโยบายของเว็บและใช้ข้อมูลอย่างรับผิดชอบเสมอ
3. ต้องเขียนโค้ดได้ไหมถึงจะใช้ซอฟต์แวร์ขูดข้อมูลเว็บได้?
ไม่จำเป็นเสมอไป! เครื่องมืออย่าง Thunderbit, Octoparse และ ParseHub ถูกออกแบบมาสำหรับคนไม่เขียนโค้ด ส่วนโปรเจกต์ที่ซับซ้อนหรือทำแบบเฉพาะทาง อาจต้องใช้เครื่องมือของนักพัฒนาอย่าง Scrapy
4. ส่งออกข้อมูลที่ขูดได้ไป Excel หรือ Google Sheets ยังไง?
สแครปเปอร์สมัยใหม่ส่วนใหญ่ เช่น Thunderbit, Octoparse และ ParseHub มีการส่งออกไป Excel, Google Sheets, CSV ได้ในคลิกเดียว หรือเชื่อมต่อโดยตรงกับ Notion และ Airtable
5. ซอฟต์แวร์ขูดข้อมูลเว็บรับมือเว็บไดนามิกหรือเว็บที่ต้องล็อกอินได้ไหม?
ได้—เครื่องมือชั้นนำอย่าง Import.io, Octoparse และ ParseHub สามารถจัดการคอนเทนต์แบบไดนามิก (AJAX, infinite scroll) และเว็บที่ต้องล็อกอินได้ Thunderbit ก็รองรับการขูดข้อมูลจากหน้าเว็บไดนามิกและหน้าย่อยด้วย
ถ้าอยากเห็นว่าการขูดข้อมูลเว็บแบบสมัยใหม่หน้าตาเป็นอย่างไร? ดาวน์โหลดส่วนขยาย Chrome ของ Thunderbit หรือเข้าไปดู Thunderbit Blog เพื่ออ่านเคล็ดลับ บทสอน และการเจาะลึกโลกของการดึงข้อมูลด้วย AI
ลองใช้ AI Web Scraper Get Started Free




