
Trustpilot มีรีวิวที่ยังใช้งานอยู่กว่า 361 ล้านรายการ ครอบคลุมธุรกิจกว่า 1.27 ล้านแห่ง — แต่ตัวดึงข้อมูลส่วนใหญ่ที่เคยใช้กับข้อมูลชุดนี้พังไปตั้งแต่หลายเดือนก่อน ถ้าคุณลองดึงรีวิวเมื่อไม่นานมานี้ ก็น่าจะเคยเจอกำแพงล็อกอินหน้าที่ 10 อันเลื่องชื่อ และเห็นเครื่องมือของคุณตอบกลับมาแค่ error ว่าง ๆ
ช่วงไม่กี่สัปดาห์ที่ผ่านมา ผมใช้เวลาทดสอบ ค้นคว้า และเปรียบเทียบเครื่องมือที่ยังพอใช้ดึงข้อมูลรีวิวจาก Trustpilot ได้อย่างน่าเชื่อถือในปี 2026 สถานการณ์เปลี่ยนไปมาก: ระบบป้องกันบอทของ Trustpilot เข้มงวดขึ้น Frontend ที่ใช้ Next.js สร้างชื่อคลาสแบบเปลี่ยนตามการอัปเดตแต่ละครั้ง และที่สำคัญที่สุดคือ ตอนนี้การเข้าถึงแบบไม่ยืนยันตัวตนจะถูกตัดหลังจากดูรีวิวได้เพียง 10 หน้าเท่านั้น กระทู้ Reddit ช่วงปลายปี 2025 สะท้อนความหัวเสียได้ชัดเจนมากว่า “none of the actors on the store work.”
แล้วเครื่องมือไหนใช้ได้จริง? ผมประเมินทั้งหมด 5 ตัว โดยดูจากวิธีรับมือกำแพงล็อกอิน มาตรการกันบอท ภาระในการดูแล และความเหมาะสมกับทั้งนักการตลาดและนักพัฒนา
ทำไมการดึงรีวิว Trustpilot ถึงยากกว่าที่คิดในปี 2026
Trustpilot ไม่ใช่เว็บสแตติกธรรมดาที่ส่ง HTTP request แบบง่าย ๆ แล้วใช้ BeautifulSoup แยกข้อมูลออกมาได้ มันคือแพลตฟอร์มสมัยใหม่ที่เรนเดอร์แบบไดนามิกบน Next.js และระบบป้องกันก็แน่นขึ้นอย่างเห็นได้ชัดตลอดปีที่ผ่านมา
สิ่งที่คุณต้องเจอจริง ๆ คือ:
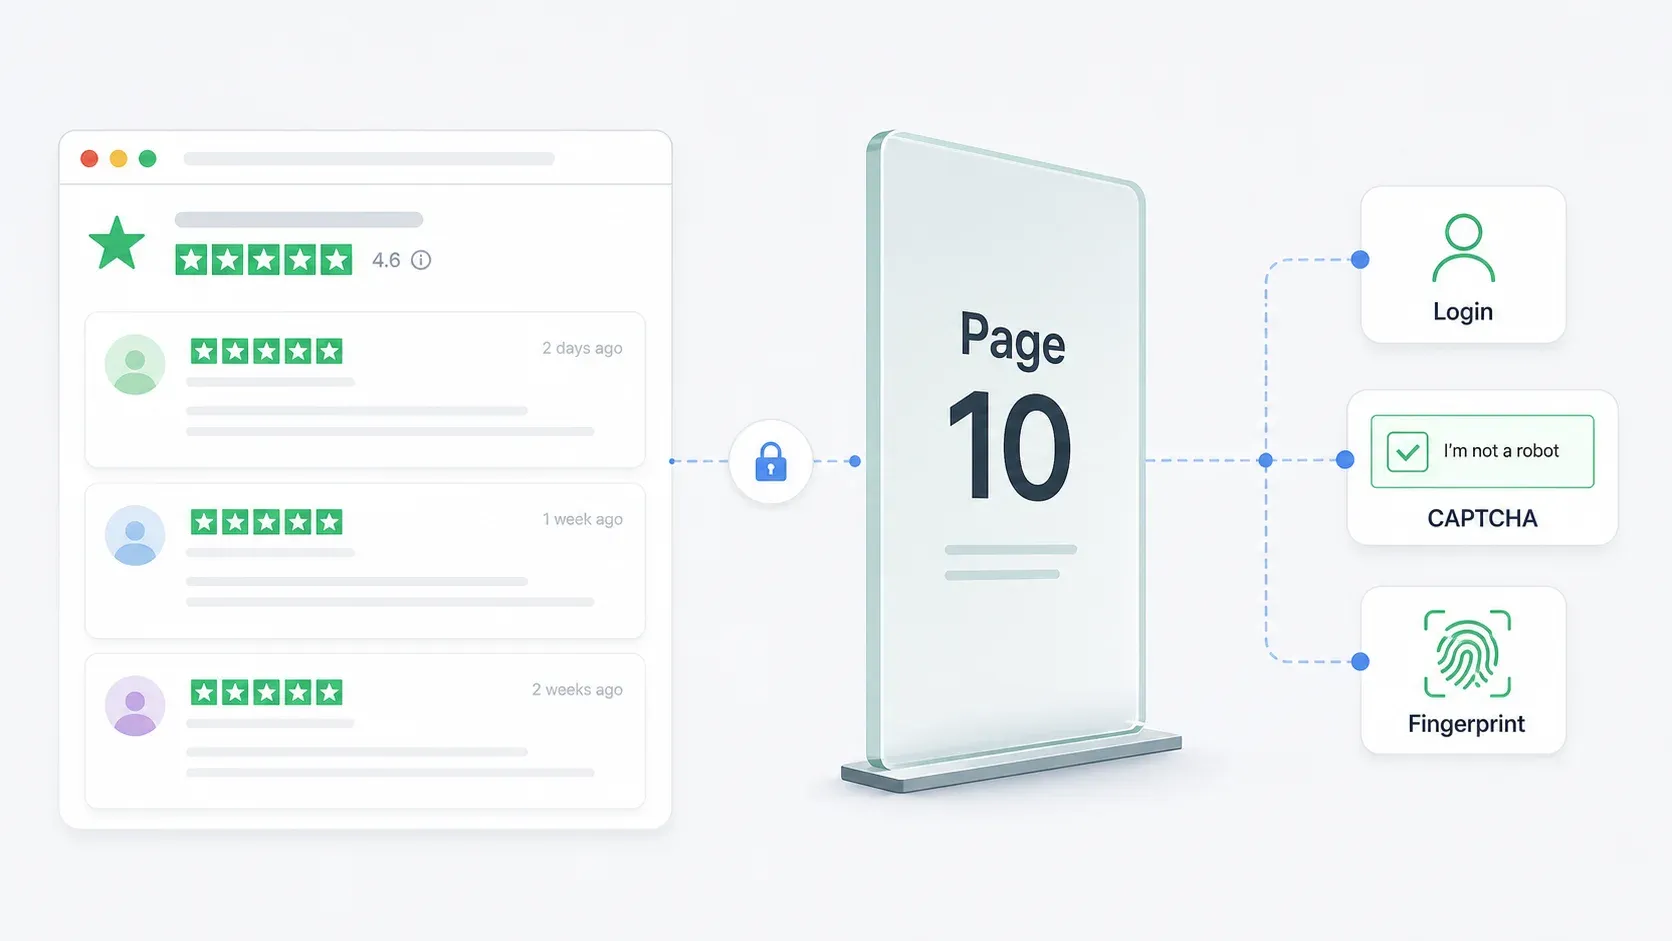
กำแพงล็อกอินหน้าที่ 10 นี่คือปัญหาใหญ่ที่สุดเพียงเรื่องเดียว คู่มือ Trustpilot ของ Web Scraper เองในเดือนมีนาคม 2026 ยืนยันว่า Trustpilot เปิดให้ดูรีวิวได้แค่ 10 หน้าแรกก่อนจะขึ้นหน้าล็อกอิน สำหรับธุรกิจที่มีรีวิว 2,000 รายการ (ประมาณ 100 หน้า ถ้าหน้าละ 20 รีวิว) คุณจะถูกตัดออกจากข้อมูลไปถึง 90% ถ้าไม่มีเซสชันที่ยืนยันตัวตนไว้
ระบบกันบอท Trustpilot ใช้ reCAPTCHA การบล็อกตามเซสชัน การกรองคำขอระดับ CDN และ browser fingerprinting หน้า About ของเขาระบุชัดว่าเว็บไซต์ “protected by reCAPTCHA” และมีการเก็บสัญญาณจากอุปกรณ์และการโต้ตอบของผู้ใช้
ชื่อคลาส CSS ที่เปลี่ยนตลอด เพราะ Trustpilot ใช้ Next.js ร่วมกับ CSS modules ชื่อคลาสอย่าง styles_reviewCardInner__EwDq2 ถูกสร้างตอน build และจะเปลี่ยนทุกครั้งที่ Trustpilot deploy อัปเดต บทแนะนำของ ScraperAPI เอง พึ่งพา selector แบบนี้แบบตรงตัว — หมายความว่าโค้ดใดก็ตามที่ทำตามบทแนะนำนี้จะพังทันทีที่ Trustpilot อัปเดต frontend รอบถัดไป
โครงสร้าง DOM ที่เปลี่ยนได้ นอกจากชื่อคลาสแล้ว ลำดับ HTML จริง ๆ ก็เปลี่ยนได้เช่นกัน องค์ประกอบถูกซ้อนต่างกัน มี wrapper ใหม่เพิ่มเข้ามา และคอมโพเนนต์ pagination ถูกจัดวางใหม่
เครื่องมือดึงข้อมูลที่พึ่งพา CSS selector — ไม่ว่าจะเป็น Apify Actors, เวิร์กโฟลว์ของ Octoparse หรือสคริปต์ Python ที่เขียนเอง — จึงเปราะบางมากเมื่อใช้กับ Trustpilot มันใช้ได้… จนกว่าจะใช้ไม่ได้ และคำว่า “จนกว่าจะใช้ไม่ได้” มักหมายถึงเป็นสัปดาห์ ไม่ใช่เป็นเดือน
สิ่งที่เรามองหาในเครื่องมือดึงรีวิว Trustpilot ที่ดีที่สุด
ผมไม่ได้ประเมินเครื่องมือเหล่านี้จากเกณฑ์กว้าง ๆ แบบ “ดึงหน้าเว็บได้ไหม” เพราะทุกตัวในลิสต์นี้ดึงข้อมูลจากหน้า HTML ธรรมดาได้อยู่แล้ว
คำถามจริงคือ: มันรับมือกับ Trustpilot โดยเฉพาะได้ไหม ในสภาพแวดล้อมปี 2026?
นี่คือสิ่งที่สำคัญที่สุด:
| เกณฑ์ | ทำไมจึงสำคัญกับ Trustpilot |
|---|---|
| รับมือกำแพงล็อกอิน (หน้า 10+) | ธุรกิจส่วนใหญ่มีรีวิวเกิน 200 รายการมาก กำแพง 10 หน้าแปลว่าคุณจะพลาดข้อมูลประวัติส่วนใหญ่ไป |
| แนวทางหลบ/รับมือบอท | reCAPTCHA การบล็อกเซสชัน และการกรองของ CDN จะหยุดตัวดึงข้อมูลที่ไม่ฉลาดได้ทันที |
| ความทนทานของ selector / ภาระการดูแล | คลาส CSS ที่สร้างอัตโนมัติทำให้เครื่องมือที่อาศัย selector พังบ่อย เครื่องมือมี self-heal ไหม? |
| รองรับ pagination | รีวิวอาจกินพื้นที่หลายร้อยหน้า การดึงแบบกดทีละหน้าไม่ใช่ทางเลือกที่ทำได้จริง |
| ต้องเขียนโค้ดหรือไม่ | นักการตลาดต้องการคลิกแล้วจบ แต่นักพัฒนาต้องการควบคุมได้เต็มที่ |
| ราคา / แพ็กเกจฟรี | ทีมที่คุมงบต้องรู้ชัดก่อนตัดสินใจ |
| ตัวเลือกการ export | ผู้ใช้ธุรกิจต้องการ Google Sheets, Airtable, Notion ไม่ใช่แค่ JSON ดิบ ๆ |
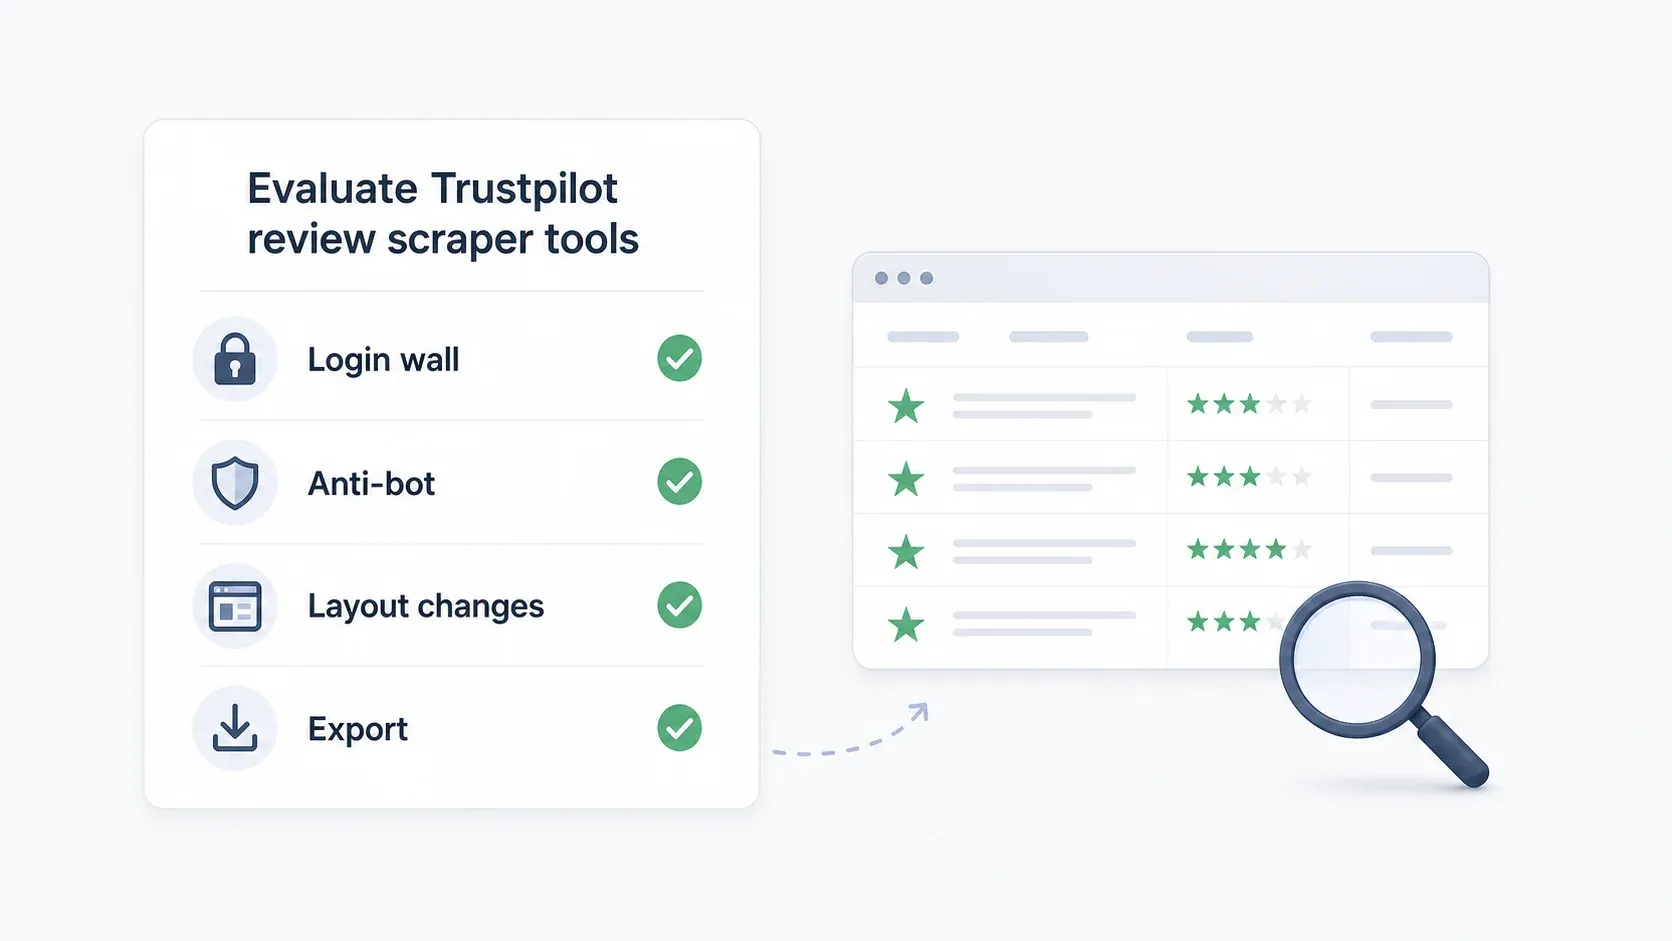
กำแพงล็อกอินคือจุดชี้ขาด
ถ้าเครื่องมือใดข้ามหน้า 10 ไม่ได้ — หรืออย่างน้อยไม่สามารถรองรับการเข้าถึงแบบยืนยันตัวตนได้อย่างชัดเจน — มันก็ไม่ใช่ Trustpilot scraper ที่ใช้งานได้จริงในปี 2026
ภาพรวมเครื่องมือดึงรีวิว Trustpilot ที่ดีที่สุด
ตารางเปรียบเทียบฉบับเต็ม:
| เครื่องมือ | ระดับทักษะ | รับมือกำแพงล็อกอิน | แนวทางกันบอท | Pagination | แพ็กเกจฟรี | ตัวเลือกการส่งออก |
|---|---|---|---|---|---|---|
| Thunderbit | ไม่ต้องเขียนโค้ด | โหมดเบราว์เซอร์ (ใช้ Chrome session ที่ล็อกอินอยู่ของคุณ) | AI แบบ semantic ปรับตามการเปลี่ยนเลย์เอาต์ | ตรวจจับอัตโนมัติ, หลายหน้า | ฟรี 6 หน้า/เดือน | Excel, Sheets, Airtable, Notion, CSV, JSON |
| Apify | Low-code | ขึ้นอยู่กับ Actor; บางตัวต้องตั้งค่า cookie สำหรับหน้าที่เกิน 10 | มี proxy rotation ในตัว, แล้วแต่ Actor | ปรับได้ตาม Actor | เครดิตแพลตฟอร์มฟรี $5/เดือน | JSON, CSV, Excel, XML, RSS |
| Octoparse | ไม่ต้องเขียนโค้ด (แบบภาพ) | ต้องตั้งค่า cookie/session เอง | IP rotation, residential proxies, CAPTCHA solving (แบบเสียเงิน) | เวิร์กโฟลว์แบบคลิก/เลื่อน | แผนฟรี + ทดลองพรีเมียม 14 วัน | CSV, Excel, JSON, HTML, XML, ฐานข้อมูล |
| Web Scraper | ไม่ต้องเขียนโค้ด (sitemap) | จำกัด — คู่มือของเขาเองระบุเพดาน 10 หน้า | Cloud + proxy ในแพ็กเกจเสียเงิน | ปรับได้; แนะนำให้ใช้ JS click | ส่วนขยาย Chrome ฟรี | CSV, XLSX |
| ScraperAPI | สำหรับนักพัฒนา (Python) | จัดการ session/cookie ในระดับโค้ด | residential proxies กว่า 40M+, JS rendering, จัดการ CAPTCHA | ทำด้วยโค้ด | ทดลอง 7 วัน, เครดิต API 5,000 | กำหนดเองโดยนักพัฒนา (CSV, JSON ฯลฯ) |
1. Thunderbit

Thunderbit คือส่วนขยาย Chrome ที่ขับเคลื่อนด้วย AI ออกแบบมาสำหรับทีมธุรกิจที่ต้องการข้อมูลแบบมีโครงสร้างจากเว็บไซต์โดยไม่ต้องเขียนโค้ด สำหรับ Trustpilot โดยเฉพาะ Thunderbit มี เทมเพลตดึงรีวิวโดยเฉพาะ ที่ดึงชื่อผู้รีวิว คะแนน ดาว ชื่อเรื่องรีวิว ข้อความรีวิว วันที่ และข้อความตอบกลับจากธุรกิจได้ในคลิกเดียว
ผมมีอคตินิดหน่อย — เพราะผมทำงานที่นี่ — แต่เหตุผลที่เราออกแบบ Thunderbit แบบนี้ มาจากปัญหาจริงของการดึง Trustpilot โดยตรง AI ของเราอ่านหน้าเว็บแบบ semantic แทนที่จะพึ่ง CSS selector เมื่อ Trustpilot เปลี่ยนชื่อคลาสหรือจัด DOM ใหม่ Thunderbit ยังปรับตัวได้ เพราะมันมองหา ความหมาย ขององค์ประกอบบนหน้า ไม่ใช่ที่อยู่ HTML เฉพาะจุด
ลองใช้ Thunderbit สำหรับดึงข้อมูล Trustpilot
Thunderbit รับมือกำแพงล็อกอินหน้าที่ 10 อย่างไร
นี่คือจุดที่โหมดเบราว์เซอร์สำคัญ Thunderbit ทำงานอยู่ภายใน Chrome ของคุณ — เบราว์เซอร์เดียวกับที่คุณล็อกอิน Trustpilot ไว้อยู่แล้ว เมื่อคุณสลับไปใช้โหมด browser scraping ส่วนขยายจะอ่านเฉพาะหน้าที่มองเห็นได้ในเซสชันที่ยืนยันตัวตนแล้ว ไม่ต้องเล่นกับ proxy แบบซับซ้อน ไม่ต้อง inject cookie ไม่ต้องมี Playwright session pool
เวิร์กโฟลว์จริง ๆ คือ: ล็อกอิน Trustpilot ใน Chrome ไปยังหน้ารวมรีวิวที่ต้องการ เปิดส่วนขยาย กดครั้งเดียว AI จะระบุฟิลด์รีวิวบนหน้าที่มีอยู่และดึงข้อมูลให้เอง ถ้าคุณต้องการข้อมูลคนละแบบ ก็แค่บอก AI ตามที่ต้องการได้เลย จากนั้น pagination จะดำเนินต่อให้อัตโนมัติ — Thunderbit จะไล่ผ่านทุกหน้าที่เบราว์เซอร์ของคุณเข้าถึงได้
ทำไม Thunderbit ถึงไม่พังเวลา Trustpilot เปลี่ยนแปลง
หน้า เทมเพลต Trustpilot ของเราอธิบายเรื่องนี้ไว้ชัดเจน: ตัวดึงข้อมูลแบบเดิมพังเมื่อเลย์เอาต์เปลี่ยนและต้องอัปเดต CSS selector แต่ Thunderbit ใช้ semantic AI ที่เข้าใจคอนเทนต์โดยไม่ต้องพึ่ง CSS เฉพาะเจาะจง รองรับเนื้อหาไดนามิก และจัดการ auto-pagination ได้
เทียบกับโค้ดในบทแนะนำของ ScraperAPI ที่ parse ด้วย class name อย่าง styles_reviewCardInner__EwDq2 นั่นคือ selector ที่จะพังเมื่อ Trustpilot deploy รอบถัดไป ในขณะที่ AI ของ Thunderbit จะถามว่า “ข้อความรีวิวอยู่ตรงไหนบนหน้านี้?” แทนที่จะถามว่า “div class นี้มีอะไรอยู่ข้างใน?”
ฟีเจอร์สำคัญสำหรับการดึงรีวิว Trustpilot
- ฟิลด์ที่ AI ตรวจจับอัตโนมัติ: ส่วนขยายจะจับฟิลด์รีวิวเองได้ (ชื่อ คะแนน วันที่ ชื่อเรื่อง ข้อความ ข้อความตอบกลับจากธุรกิจ) โดยไม่ต้องตั้งค่าเอง — หรือถ้าคุณอยากได้ชุดข้อมูลเฉพาะ ก็บอกได้เลย
- เวิร์กโฟลว์คลิกเดียว: คลิกครั้งเดียว → ได้ตารางสำเร็จรูป จบ
- โหมดเบราว์เซอร์สำหรับหน้าที่ต้องล็อกอิน: ใช้ภายใน Chrome session ที่คุณล็อกอินไว้ เพื่อเข้าถึงหน้า 10+
- Auto-pagination: จัดการชุดรีวิวหลายหน้าโดยไม่ต้องคอยสั่งเอง
- ดึงข้อมูลจากหน้ารอง: เข้าไปดูโปรไฟล์ผู้รีวิวรายบุคคลเพื่อเพิ่มข้อมูลได้
- ตั้งเวลาการดึงข้อมูล: ตั้งดึงรีวิวรายสัปดาห์หรือรายเดือนเพื่อเฝ้าระวังชื่อเสียงแบรนด์
- การ export: Google Sheets, Airtable, Notion, CSV, JSON — รวมอยู่ฟรีทั้งหมด
ราคา
- แพ็กเกจฟรี: 6 หน้า/เดือน ไม่ต้องใช้บัตรเครดิต
- ระบบเครดิต: 1 เครดิต = 1 แถวผลลัพธ์
- แพ็กเกจเสียเงิน: $15/เดือน หรือประมาณ $9/เดือนเมื่อชำระรายปี (หน้าราคา)
เหมาะสำหรับ: ทีมการตลาด ทีมปฏิบัติการ และผู้ใช้ธุรกิจที่ต้องการรีวิว Trustpilot โดยไม่ต้องแตะโค้ด — และไม่อยากดูแลสคริปต์ที่พังทุกไม่กี่สัปดาห์
2. Apify
Apify คือแพลตฟอร์มดึงข้อมูลบนคลาวด์ที่มี marketplace ของ “Actors” สำเร็จรูป — เทมเพลตการดึงข้อมูลที่ผู้ใช้รายอื่นและทีม Apify สร้างไว้ สำหรับ Trustpilot ใน store มี Actor หลายตัวจากคอมมูนิตี้ให้เลือกใช้ แต่ความเสถียรต่างกันไป
ข้อแลกเปลี่ยนของ Apify คือมันทรงพลังได้ แต่กระจัดกระจาย บาง Actor ใช้งานได้ บางตัวถูกเลิกดูแล บางตัวต้องใช้ cookie สำหรับหน้าที่เกิน 10 และคำบ่นใน Reddit ที่ว่า “none of the actors on the store work” ก็มีมูลจริง — มันสะท้อนว่า Trustpilot เปลี่ยนเร็วแค่ไหนจนตรรกะของ Actor แต่ละตัวพังได้ง่าย
Actors สำหรับ Trustpilot และข้อจำกัดที่พบบ่อย
Apify Store มี Trustpilot Actors หลายตัว อย่างน้อยหนึ่งตัว (โดยนักพัฒนาชื่อ “burbn”) ระบุชัดเจนว่าต้องใส่ cookie input สำหรับหน้าหลังหน้า 10 ตัวอื่น ๆ มีเรตติ้ง 0.0 มีผู้ใช้น้อยมาก หรือเพิ่งถูกแก้ไขไม่นานมานี้ — สัญญาณว่ามีการดูแลต่อเนื่องแต่ความน่าเชื่อถือยังแกว่ง
Actor ที่เลิกใช้ไปแล้วก็น่าสนใจเช่นกัน มี Actor เก่าตัวหนึ่งที่อ่าน JSON __NEXT_DATA__ ที่ฝังไว้ของ Trustpilot โดยตรง — เป็นวิธีที่ฉลาดและเร็วกว่าการ parse DOM แต่ก็ยังพังเมื่อ Trustpilot เปลี่ยนโครงสร้างข้อมูล
การรับมือกำแพงล็อกอินและบอท
- กำแพงล็อกอิน: ขึ้นอยู่กับ Actor ที่เลือก บางตัวรองรับการ inject cookie สำหรับหน้า 10+ แต่บางตัวไม่รองรับ
- กันบอท: แพลตฟอร์มของ Apify มี proxy rotation และโครงสร้างพื้นฐานที่คิดตาม compute unit มี residential proxies ให้ใช้ในราคา $8/GB บน Free/Starter
- การดูแล: เมื่อ Actor พัง คุณต้องรอผู้ดูแลแก้ไข เปลี่ยนไปใช้ Actor อื่น หรือจ้างสร้าง private Actor ใหม่
ราคา
- แพ็กเกจฟรี: เครดิตใช้งานล่วงหน้า $5/เดือน ไม่ต้องใช้บัตรเครดิต
- Starter: $9/เดือน + จ่ายตามการใช้งาน
- Scale: $99/เดือน + จ่ายตามการใช้งาน
- การ export: JSON, CSV, Excel, XML, RSS (ขึ้นอยู่กับ Actor)
เหมาะสำหรับ: ผู้ใช้ที่พอมีทักษะเทคนิค สามารถประเมิน Actor หลายตัว ตั้งค่า cookie และไล่แก้ปัญหาเวลาเกิดข้อผิดพลาด ไม่เหมาะกับทีมที่อยากได้แบบตั้งครั้งเดียวแล้วปล่อยยาว
3. Octoparse
Octoparse คือ scraper แบบไม่ต้องเขียนโค้ดบนเดสก์ท็อปที่มีตัวสร้างเวิร์กโฟลว์แบบภาพ จุดยืนของมันอยู่กึ่งกลางระหว่างความง่ายแบบคลิกครั้งเดียวของ Thunderbit กับการควบคุมเต็มรูปแบบของ ScraperAPI — คุณได้การตั้งค่าแบบ visual โดยไม่ต้องเขียนโค้ด แต่ก็ยังต้องสร้างและดูแลเวิร์กโฟลว์เอง
วิธีตั้งค่าการดึง Trustpilot ใน Octoparse
ขั้นตอนค่อนข้างตรงไปตรงมาแต่ต้องทำเอง:
- วาง URL หน้ารีวิวธุรกิจของ Trustpilot
- เลือกองค์ประกอบรีวิวแบบเห็นภาพ (ชื่อเรื่อง เนื้อหา คะแนน วันที่ ชื่อผู้รีวิว)
- ตั้งลูป pagination ด้วยปุ่มหน้าถัดไป
- กำหนดเวลารอ (แนะนำ 2-5 วินาทีเพื่อหลีกเลี่ยง reCAPTCHA)
- รันบนเครื่องสำหรับตัวอย่างขนาดเล็ก หรือรันบนคลาวด์สำหรับงานใหญ่
สำหรับคนที่คุ้นกับเครื่องมืออยู่แล้ว การตั้งค่าจะใช้เวลาประมาณ 10-15 นาที แต่จุดสำคัญคือ เพราะ Octoparse ใช้ visual selector ที่ผูกกับ DOM คุณจะต้องอัปเดตเวิร์กโฟลว์ทุกครั้งที่ Trustpilot เปลี่ยนโครงสร้างหน้า
การรับมือกำแพงล็อกอินและบอท
- กำแพงล็อกอิน: ต้องตั้งค่าการล็อกอิน/cookie/session เอง ไม่ได้จัดการอัตโนมัติ
- กันบอท: แพ็กเกจเสียเงิน มี IP rotation, residential proxies ($3/GB) และการแก้ CAPTCHA อัตโนมัติ ($1-1.5 ต่อพันครั้ง)
- การดูแล: ระดับปานกลาง คาดว่าต้องสร้างใหม่หรือปรับเวิร์กโฟลว์เมื่อ Trustpilot อัปเดต frontend
ราคา
- แผนฟรี: ฟรีตลอดไป, 10 tasks, 1 อุปกรณ์, ดึงข้อมูลแบบ local, ได้สูงสุด 50,000 แถว/เดือน
- Standard: $69/เดือน (ชำระรายปี)
- Professional: $149/เดือน
- ทดลองพรีเมียม 14 วัน: รวม cloud extraction, scheduling, API และเทมเพลต
- การ export: Excel, CSV, JSON, HTML, XML; ฐานข้อมูลและ Google Sheets ในระดับที่สูงขึ้น
เหมาะสำหรับ: ผู้ใช้ที่อยากควบคุมเวิร์กโฟลว์แบบภาพ ไม่ติดเรื่องเวลาเซ็ตอัป และรับได้กับการดูแลเมื่อหน้าเว็บเปลี่ยน เหมาะกับทีมที่ต้องการปรับแต่งมากกว่าการใช้เครื่องมือคลิกครั้งเดียว แต่ไม่อยากเขียน Python เอง
4. Web Scraper
Web Scraper คือส่วนขยาย Chrome และแพลตฟอร์มบนคลาวด์ที่ใช้แนวทางแบบ sitemap ในการดึงข้อมูล จุดแข็งสำหรับ Trustpilot คือมี เทมเพลตสำเร็จรูปสำหรับหน้า business ที่ดึงข้อมูลระดับบริษัทได้ เช่น ชื่อธุรกิจ หมวดหมู่ ที่อยู่ คะแนน จำนวนรีวิว TrustScore และ URL เว็บไซต์
สำหรับการดึงรีวิวโดยตรง มีข้อจำกัดที่ควรบอกไว้ชัดเจน
เทมเพลตสำเร็จรูป vs การตั้งค่าเอง
เทมเพลตใน marketplace ใช้ได้ดีสำหรับการค้นหาบริษัท — ดึงโปรไฟล์ธุรกิจในแต่ละหมวดของ Trustpilot ส่วนการดึงรีวิวแบบกำหนดเอง Sitemap Wizard ช่วยให้คุณสร้าง scraper แบบ visual ภายในส่วนขยาย Chrome ได้
คู่มือของ Web Scraper เองในเดือนมีนาคม 2026 แนะนำให้ใช้ JavaScript click pagination แทน pagination แบบอิง URL เพราะ Trustpilot อาจจัดเรียงคอนเทนต์ใหม่แบบไดนามิกระหว่างหน้า ทำให้ผลลัพธ์เลื่อนตำแหน่งได้
การรับมือกำแพงล็อกอินและบอท
ต้องพูดตรง ๆ: คู่มืออย่างเป็นทางการของ Web Scraper ระบุชัดว่า Trustpilot เปิดให้ดูรีวิวได้เพียง 10 หน้าแรกก่อนจะขึ้นหน้าล็อกอิน คู่มือนี้ยอมรับข้อจำกัดนี้แบบตรงไปตรงมา ไม่ได้เสนอทางลัดแก้ไข
- กำแพงล็อกอิน: รับมือได้จำกัด คู่มือของเขาระบุเพดาน 10 หน้าไว้ชัดเจน
- กันบอท: แพ็กเกจคลาวด์มี proxy support; คู่มือแนะนำให้หน่วงเวลา 2-5 วินาทีและลด concurrency
- Pagination: ตั้งค่าได้ แต่ในทางปฏิบัติจำกัดอยู่แค่ 10 หน้าแรกของรีวิวสำหรับการเข้าถึงแบบไม่ล็อกอิน
ราคา
- ส่วนขยาย Chrome ฟรี: ดึงข้อมูลบนเครื่อง ฟังก์ชันจำกัด
- Project: $50/เดือน (5,000 URL credits)
- Professional: $100/เดือน (20,000 URL credits)
- Scale: เริ่มที่ $200/เดือน (URL credits ไม่จำกัดภายใต้เงื่อนไข)
- ทดลองใช้ฟรี 7 วัน สำหรับแพ็กเกจคลาวด์แบบเสียเงิน
- การ export: CSV, XLSX
เหมาะสำหรับ: ผู้ใช้ที่ต้องการเทมเพลตพร้อมใช้สำหรับดึงโปรไฟล์บริษัทบน Trustpilot หรือคนที่ต้องการแค่รีวิวจาก 10 หน้าแรก ไม่เหมาะถ้าคุณต้องการประวัติรีวิวครบทั้งหมดของธุรกิจที่มีรีวิวเยอะ
5. ScraperAPI
ScraperAPI คือโครงสร้างพื้นฐานสำหรับการดึงข้อมูลที่ออกแบบมาสำหรับนักพัฒนา — ไม่ใช่เครื่องมือแบบคลิกแล้วใช้ แต่เป็น proxy/rendering layer ที่ช่วยจัดการมาตรการกันบอท ขณะที่คุณเป็นคนเขียนตรรกะการ parse เอง หน้าสินค้า Trustpilot solution ของเขาโฆษณาฟีเจอร์ JS rendering, CAPTCHA handling และ proxy กว่า 40M+
ถ้าคุณเป็นนักพัฒนา Python ที่อยากควบคุมตรรกะการดึงข้อมูลได้เต็มที่ ScraperAPI ก็ให้ท่อส่งน้ำไว้ครบ
แต่คุณก็ต้องดูแลทุกอย่างเองด้วย
สร้าง Trustpilot scraper แบบกำหนดเองด้วย ScraperAPI
บทแนะนำของ ScraperAPI ในเดือนมกราคม 2026 แสดงเวิร์กโฟลว์ Python + BeautifulSoup:
import requests
from bs4 import BeautifulSoup

payload = {
    "api_key": "YOUR_API_KEY",
    "url": "https://www.trustpilot.com/review/example.com",
    "render": "true",
    "keep_headers": "true",
}

html = requests.get("https://api.scraperapi.com", params=payload).text
soup = BeautifulSoup(html, "html.parser")
โค้ดที่ทำเสร็จในบทแนะนำตั้งค่า pages_to_scrape = 10 ซึ่งเป็นการยอมรับโดยปริยายว่าหน้า public มีเพดานอยู่เท่านี้ สำหรับหน้า 10+ นักพัฒนาต้องจัดการ session ที่ยืนยันตัวตน cookie และ token เอง
การรับมือกำแพงล็อกอินและบอท
- กำแพงล็อกอิน: ต้องจัดการ session/cookie ในระดับโค้ด ScraperAPI รับผิดชอบ proxy และ rendering ส่วนคุณต้องจัดการตรรกะการยืนยันตัวตนเอง
- กันบอท: มี residential proxy pool พร้อม IP rotation อัตโนมัติ, render แบบ JS ด้วย
render=true, และจัดการ CAPTCHA ผ่าน smart proxy rotation ใช้ได้ใน ทุกแพ็กเกจ - การดูแล: เมื่อ Trustpilot เปลี่ยนชื่อคลาส (ซึ่งเกิดขึ้นบ่อย) คุณต้องอัปเดตโค้ด parse เอง selector
styles_reviewCardInner__EwDq2ในบทแนะนำก็เหมือนตัวนับถอยหลังที่กำลังเดินอยู่แล้ว
ราคา
- ทดลอง 7 วัน: เครดิต API ฟรี 5,000 เครดิต ไม่ต้องใช้บัตรเครดิต
- Hobby: $49/เดือน (100,000 API credits)
- Startup: $149/เดือน (1,000,000 credits)
- Business: $299/เดือน (3,000,000 credits)
- การ export: แล้วแต่โค้ดของคุณจะสร้างออกมา โดยทั่วไปคือ CSV, JSON หรือเขียนลงฐานข้อมูล
เหมาะสำหรับ: นักพัฒนาที่ต้องการปรับแต่งได้เต็มที่ ดูแลสคริปต์ parse ของตัวเองได้ และต้องการควบคุม session management, pagination logic และโครงสร้างข้อมูลแบบโปรแกรมได้ ไม่เหมาะกับผู้ใช้ที่ไม่ถนัดเทคนิค
ทำไม Trustpilot scraper ถึงพังบ่อย และจะเลือกตัวที่ไม่พังง่ายได้อย่างไร
นี่คือปัจจัยที่ถูกมองข้ามมากที่สุดเวลาจะเลือก Trustpilot scraper คำถามไม่ใช่ “เครื่องมือนี้ใช้ได้วันนี้ไหม?” แต่คือ “มันจะยังใช้ได้อีกสามสัปดาห์ข้างหน้าหรือเปล่า?”
Scraper บน Trustpilot มักพังด้วย 4 เหตุผลหลัก:
-
คลาส CSS ที่สร้างอัตโนมัติเปลี่ยน Next.js CSS modules สร้างชื่อคลาสอย่าง
styles_reviewCardInner__EwDq2ซึ่งเปลี่ยนทุกครั้งที่ frontend ถูก deploy ตัวดึงข้อมูลที่ชี้ไปที่คลาสเหล่านี้จึงพัง -
โครงสร้าง DOM เปลี่ยน Trustpilot สามารถจัด HTML hierarchy ใหม่ได้ — ซ้อน review card ต่างออกไป เปลี่ยน wrapper element หรือย้าย metadata ไปอีกตำแหน่ง
-
สัญญาณกันบอทเปลี่ยน threshold ของ reCAPTCHA เปลี่ยนไป การหมุน session token เข้มขึ้น กฎการกรองของ CDN ถูกอัปเดต
-
การยืนยันตัวตน/เซสชันเปลี่ยน กำแพงล็อกอินหน้า 10 ถูกเพิ่มเข้ามา (หรือบังคับใช้อย่างเข้มขึ้น) ในช่วงปลายปี 2025 และข้อจำกัดการเข้าถึงใหม่อาจโผล่มาได้ทุกเมื่อ
ความแตกต่างเชิงสถาปัตยกรรมพื้นฐานคือระหว่างการดึงข้อมูลแบบ selector-based กับแบบ semantic:
-
เครื่องมือแบบ selector-based (Apify Actors, เวิร์กโฟลว์ Octoparse, สคริปต์ ScraperAPI, sitemap ของ Web Scraper) จะถามว่า: “หา element ที่อยู่ตาม path CSS นี้ให้หน่อย” พอ path เปลี่ยน มันก็ล้มเหลวแบบเงียบ ๆ หรือดึงข้อมูลว่างออกมา
-
เครื่องมือแบบ semantic/AI (Thunderbit) จะถามว่า: “หาข้อความรีวิว คะแนน และวันที่บนหน้านี้ให้หน่อย” AI จะตีความคอนเทนต์จากความหมาย ไม่ใช่จากที่อยู่ เลย์เอาต์เปลี่ยนก็ไม่พัง เพราะความหมายไม่ได้เปลี่ยน
คำแนะนำของผม:
- รับภาระการดูแลแทบไม่ได้เลย? → แบบ AI (Thunderbit)
- รับการดูแลได้บ้าง อยากได้อัตโนมัติบนคลาวด์? → Apify (เลือก Actor และเฝ้าดูการพัง)
- อยากควบคุมแบบ visual และรับการดูแลระดับกลาง? → Octoparse
- ต้องการแบบใช้เทมเพลต ขอบเขตจำกัด? → Web Scraper
- ต้องการควบคุมเต็มรูปแบบ ทำทุกอย่างเอง? → ScraperAPI
จะเอารีวิว Trustpilot ที่ดึงมาไปใช้อะไรต่อ
การดึงรีวิวเป็นแค่ขั้นแรก คำถามที่ผมเห็นในฟอรัมบ่อยมากคือ: “มีข้อมูลแล้ว แล้วต่อไปทำอะไร?”
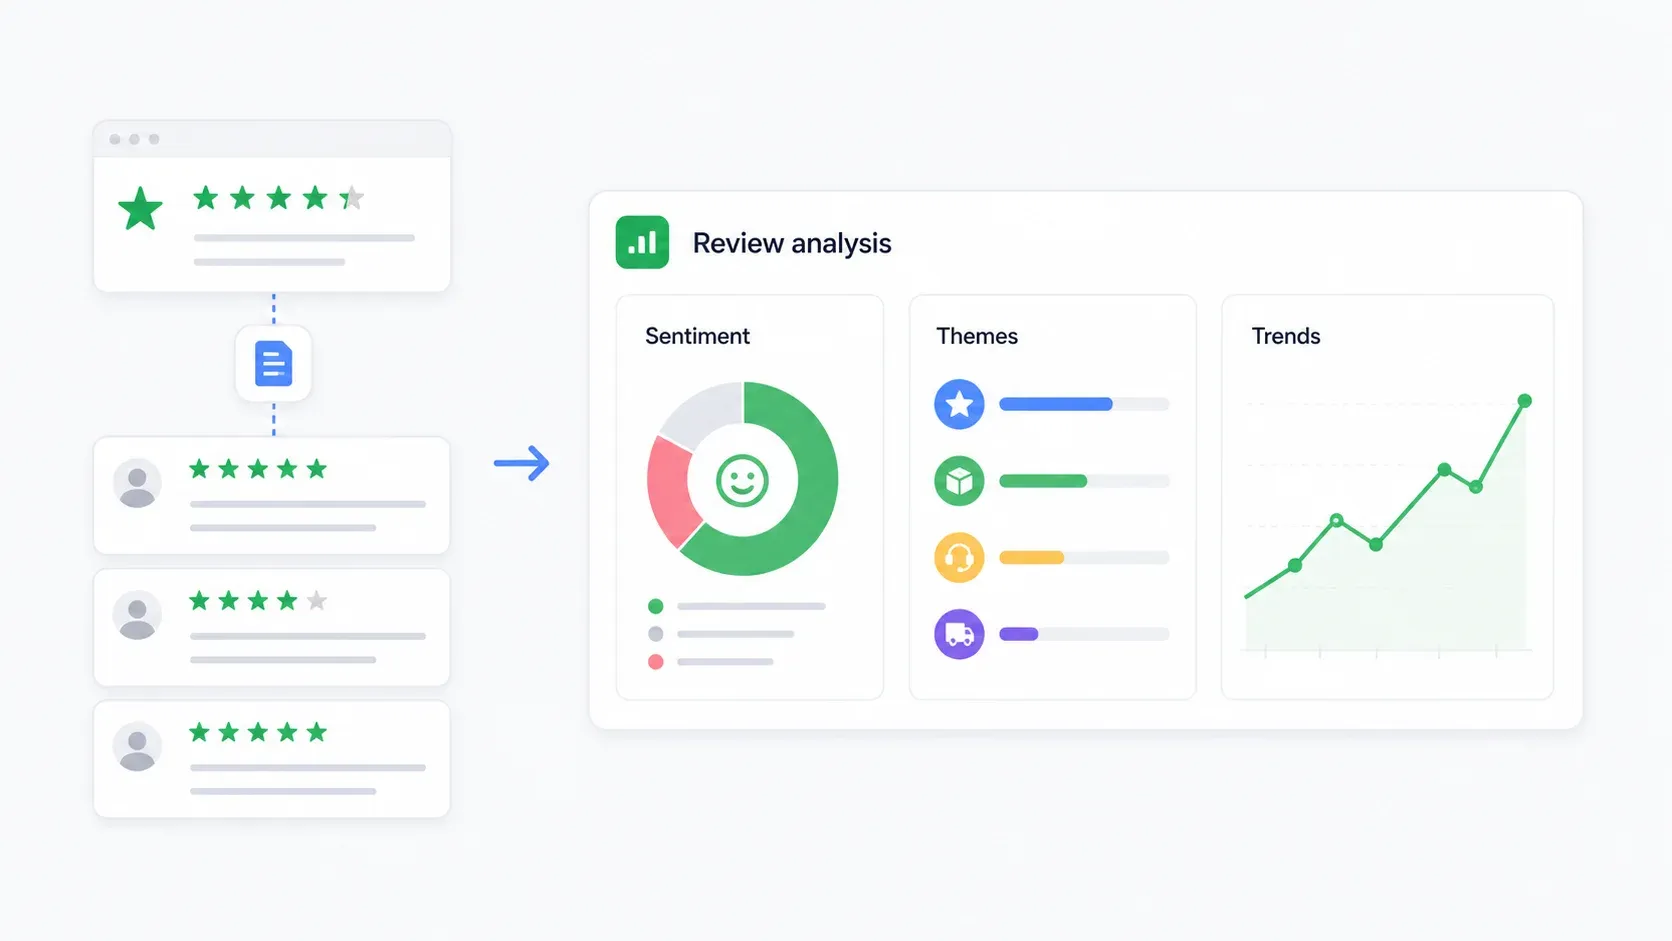
การวิเคราะห์ความรู้สึก
เวิร์กโฟลว์ที่ง่ายที่สุดคือ export รีวิวไป Google Sheets แล้วใช้เครื่องมือ AI (ChatGPT, Claude หรือฟังก์ชัน AI ใน Sheets) เพื่อจัดประเภทแต่ละรีวิวเป็นบวก กลาง หรือ ลบ เพิ่มคอลัมน์สำหรับหมวดปัญหา ความเร่งด่วน และลำดับความสำคัญของการแก้ไขที่แนะนำ
สำหรับชุดข้อมูลขนาดใหญ่ ให้อัปโหลด CSV เข้า ChatGPT แล้วขอให้สรุปว่า: “จัดหมวดรีวิวเหล่านี้ตาม sentiment และระบุ 5 ประเด็นร้องเรียนหลักพร้อมคำอ้างอิงตัวอย่าง”
การติดตามคู่แข่ง
ใช้การดึงแบบตั้งเวลาใน Thunderbit เพื่อดึงรีวิวคู่แข่งรายสัปดาห์หรือรายเดือน ติดตาม:
- แนวโน้มคะแนนเฉลี่ยเมื่อเวลาผ่านไป
- สัดส่วนของรีวิว 1 ดาวและ 2 ดาว
- การเปลี่ยนแปลงจำนวนรีวิว (เขาได้รีวิวมากขึ้นหรือน้อยลง?)
- ธีมข้อร้องเรียนที่พบบ่อยที่สุด
- อัตราและความเร็วในการตอบกลับของธุรกิจ
แดชบอร์ด Google Sheets แบบง่าย ๆ ที่ใช้ pivot table ตามคะแนนและวันที่ จะกลายเป็นฟีดข้อมูลเชิงแข่งขันที่อัปเดตอัตโนมัติ
การสกัดธีม
จัดกลุ่มรีวิวตามหมวดที่พบซ้ำ เช่น การจัดส่ง/การขนส่ง บริการลูกค้า การคืนเงิน คุณภาพสินค้า การเรียกเก็บเงิน ความสะดวกในการใช้แอป ราคา/ความคุ้มค่า และข้อกังวลเรื่องการฉ้อโกง ผลลัพธ์ควรเป็นตารางที่แสดง: ธีม จำนวนรีวิว คะแนนเฉลี่ย คำอ้างอิงตัวอย่าง และการดำเนินการที่ธุรกิจควรทำ
วิธีนี้มีประโยชน์กว่า word cloud เพราะมันบอกได้จริงว่าอะไรคือสิ่งที่ผลักให้ลูกค้าพอใจหรือไม่พอใจ
การวิเคราะห์หลายธุรกิจแบบจำนวนมาก
สำหรับงานวิจัยระดับหมวดหมู่ ให้ดึงรีวิวจากหลายธุรกิจในหมวดเดียวกันบน Trustpilot เปรียบเทียบจำนวนรีวิว คะแนน การกระจายของดาว และความถี่ของธีมในตลาดทั้งเซกเมนต์ Web Scraper เหมาะกับการค้นหาบริษัทจากรายการธุรกิจ ส่วน Thunderbit หรือ ScraperAPI จะจัดการการสุ่มตัวอย่างระดับรีวิวของแต่ละบริษัทได้
ประเด็นทางกฎหมายและจริยธรรมในการดึงข้อมูล Trustpilot
ผมไม่ใช่ทนาย และนี่ไม่ใช่คำแนะนำทางกฎหมาย แต่เรื่องการปฏิบัติตามกฎมีความสำคัญมากในกรณีนี้
ข้อกำหนดการใช้งานของ Trustpilot ระบุไว้ชัดเจน พวกเขาห้าม ผู้ใช้เข้าถึงหรือรวบรวมคอนเทนต์ “ด้วยวิธีอื่นใดนอกเหนือจากที่ Trustpilot กำหนดหรืออนุมัติเป็นพิเศษ” และระบุชัดถึง text mining, data mining และ web scraping โดยไม่มีอนุญาตอย่างชัดแจ้ง
ภาพความเสี่ยงโดยรวมเป็นแบบนี้:
- ความเสี่ยงต่ำกว่า: export รีวิวของบริษัทคุณเองเพื่อวิเคราะห์ภายใน โดยเฉพาะถ้าใช้เครื่องมือทางการหรือ API ของ Trustpilot
- ความเสี่ยงปานกลาง: ดึงข้อมูลหน้าสาธารณะของคู่แข่งในปริมาณต่ำเพื่อทำ market research ยังต้องอยู่ภายใต้ ToS และข้อกำหนดด้านความเป็นส่วนตัว
- ความเสี่ยงสูงกว่า: ดึงข้อมูลหน้าที่ต้องยืนยันตัวตนหลังหน้า 10 ข้ามการควบคุมทางเทคนิค นำข้อมูลผู้รีวิวไปเผยแพร่ต่อ หรือใช้รีวิวที่ดึงมาไปฝึกโมเดล AI
ข้อพิจารณาเรื่อง GDPR: ชื่อผู้รีวิว ลิงก์โปรไฟล์ ข้อความรีวิว และข้อมูลตำแหน่งที่ตั้งอาจถือเป็นข้อมูลส่วนบุคคลภายใต้กฎหมายความเป็นส่วนตัวของสหภาพยุโรป มาตรการป้องกันที่ทำได้จริง ได้แก่ เก็บเฉพาะฟิลด์ที่จำเป็น แฮชชื่อผู้รีวิวสำหรับ analytics ภายใน กำหนดระยะเวลาเก็บรักษาข้อมูล และไม่เผยแพร่ข้อความรีวิวดิบในวงกว้าง
ข้อมูลสาธารณะ vs ข้อมูลที่ต้องล็อกอิน: มีความแตกต่างทางกฎหมายและจริยธรรมที่สำคัญระหว่างการดึงข้อมูลจากหน้าที่ทุกคนมองเห็นได้ (10 หน้าแรกของรีวิว) กับการดึงข้อมูลหลังแนวกำแพงยืนยันตัวตน เครื่องมือที่ทำงานกับข้อมูลสาธารณะล้วน ๆ จึงมีความเสี่ยงด้าน compliance ต่ำกว่าตัวที่ต้องใช้ข้อมูลล็อกอิน
เรื่องนี้ควรเป็นส่วนหนึ่งของการเลือกเครื่องมือ Thunderbit ในโหมดเบราว์เซอร์ทำงานกับหน้าที่มองเห็นได้ใน session ของคุณเอง — ไม่ได้ข้ามการยืนยันตัวตนให้โดยอิสระ ส่วน ScraperAPI ให้ความยืดหยุ่นเต็มที่แก่ผู้พัฒนา แต่ก็มาพร้อมความรับผิดชอบเต็มรูปแบบเรื่องความถูกต้องของการจัดการ session
วิธีเลือก Trustpilot review scraper ให้เหมาะกับคุณ
กรอบการตัดสินใจตามลักษณะผู้ใช้:
- นักการตลาดที่ไม่ถนัดเทคนิคและอยากได้รีวิวโดยไม่ต้องเขียนโค้ด? → Thunderbit คลิกเดียว AI จัดการที่เหลือ ส่งออกไป Sheets/Notion/Airtable ได้
- ผู้ใช้ low-code ที่สบายกับการตั้งค่าและแก้บั๊ก? → Apify เลือก Actor ตั้ง cookie สำหรับหน้า 10+ แล้วคอยเฝ้าดูว่าอะไรพัง
- คนชอบสร้างแบบ visual ที่อยากควบคุมเวิร์กโฟลว์? → Octoparse ตั้งค่าแบบคลิกแล้วเลือก แต่เตรียมรับการดูแลเมื่อ Trustpilot เปลี่ยนหน้า
- ต้องการข้อมูลระดับบริษัท หรือแค่รีวิว 10 หน้าแรก? → Web Scraper มีเทมเพลตสำเร็จรูปที่แข็งแรงสำหรับโปรไฟล์ธุรกิจ
- นักพัฒนาที่อยากปรับแต่งได้เต็มที่? → ScraperAPI คุณดูแล logic การ parse, session management และ data pipeline เอง
ถ้าความสามารถในการดูแลรักษาเป็นเรื่องหลัก สเปกตรัมจะเรียงจาก Thunderbit (แทบไม่ต้องดูแล) ไปจนถึง ScraperAPI (คุณต้องดูแลทุกอย่าง) ด้านงบประมาณ ทุกเครื่องมือในลิสต์นี้มีจุดเริ่มต้นฟรี — ลองใช้ส่วนฟรีก่อนจะตัดสินใจจ่าย
สรุป
ข้อมูลรีวิวจาก Trustpilot มีคุณค่าอย่างแท้จริงสำหรับ competitive intelligence การเฝ้าระวังชื่อเสียงแบรนด์ และการเข้าใจลูกค้า
แต่ในปี 2026 การดึงข้อมูลนี้ให้เชื่อถือได้ ต้องใช้เครื่องมือที่รับมือกำแพงล็อกอินหน้า 10 ปรับตามการเปลี่ยน DOM ได้ และจัดการระบบป้องกันบอทได้โดยไม่ต้องมานั่งแก้เองตลอด
สำหรับผู้ใช้ธุรกิจส่วนใหญ่ Thunderbit คือทางที่ง่ายที่สุด — คลิกเดียว ตรวจจับฟิลด์ด้วย AI โหมดเบราว์เซอร์สำหรับหน้าที่ล็อกอินแล้ว และไม่ต้องดูแลอะไรเมื่อ Trustpilot เปลี่ยน frontend คุณสามารถลองใช้ฟรี ได้ 6 หน้า/เดือน โดยไม่ต้องใช้บัตรเครดิต
สำหรับนักพัฒนาที่ต้องการควบคุมเต็มที่ ScraperAPI คือโครงสร้างพื้นฐานที่ตอบโจทย์ ส่วนสำหรับคนที่อยู่กึ่งกลาง Apify, Octoparse และ Web Scraper ต่างก็มีจุดเด่นเฉพาะตัว หัวใจสำคัญคือเลือกเครื่องมือให้ตรงกับความถนัดทางเทคนิค ภาระในการดูแล และข้อกำหนดด้าน compliance ของคุณ
ถ้าคุณอยากดูว่า Thunderbit จัดการ Trustpilot โดยเฉพาะอย่างไร เรามีวิดีโอ walkthrough บน YouTube และถ้าอยากอ่านพื้นฐานเพิ่มเติมเกี่ยวกับการทำเว็บสแครปโดยไม่ต้องเขียนโค้ด หรือเว็บสแครปคืออะไรจริง ๆ คู่มือเหล่านั้นจะช่วยปูพื้นได้ดี
คำถามที่พบบ่อย
1. ดึงรีวิว Trustpilot เกินหน้า 10 ได้ไหม?
ได้ แต่ต้องใช้เส้นทางที่ยืนยันตัวตนแล้ว Trustpilot จะบล็อกการเข้าถึงแบบไม่ล็อกอินหลัง 10 หน้าแรก Thunderbit ในโหมดเบราว์เซอร์จะทำงานภายใน Chrome session ที่คุณล็อกอินอยู่ จึงเข้าถึงหน้าที่คุณมองเห็นได้ ScraperAPI ต้องจัดการ session/cookie ในระดับโค้ด Apify Actors ต้องตั้งค่า cookie ส่วน Octoparse ต้องตั้งค่าการล็อกอิน/cookie เอง และเอกสารของ Web Scraper เองก็ยอมรับข้อจำกัด 10 หน้าโดยไม่ได้ให้ทางแก้ในตัว
2. การดึงรีวิว Trustpilot ถูกกฎหมายไหม?
ข้อกำหนดการใช้งานของ Trustpilot ห้ามการเก็บข้อมูลอัตโนมัติโดยไม่ได้รับอนุญาตชัดแจ้ง ความเสี่ยงทางกฎหมายจะแตกต่างกันตามวิธีและกรณีใช้งาน: การดึงรีวิวสาธารณะของบริษัทตัวเองมีความเสี่ยงต่ำกว่าการข้ามกำแพงยืนยันตัวตนเพื่อดึงข้อมูลคู่แข่ง GDPR มีผลกับข้อมูลผู้รีวิวในสหภาพยุโรป นี่ไม่ใช่คำแนะนำทางกฎหมาย — หากเป็นโปรเจกต์ขนาดใหญ่หรือเชิงพาณิชย์ควรปรึกษาทนาย
3. คุณดึงข้อมูลอะไรจาก Trustpilot ได้บ้าง?
ฟิลด์ที่พบบ่อย ได้แก่: ชื่อผู้รีวิว คะแนนดาว ชื่อเรื่องรีวิว ข้อความรีวิว วันที่โพสต์ วันที่มีประสบการณ์ สถานะ verified purchase ตำแหน่งของผู้รีวิว ข้อความตอบกลับจากธุรกิจ ชื่อบริษัท TrustScore จำนวนรีวิวทั้งหมด การกระจายดาว และ URL ของรีวิว
4. Trustpilot scrapers พังบ่อยแค่ไหน?
เครื่องมือที่อาศัย selector (Apify Actors, เวิร์กโฟลว์ Octoparse, สคริปต์ Python ที่เขียนเอง) อาจพังได้ทุกครั้งที่ Trustpilot เปลี่ยน CSS class หรือโครงสร้าง DOM ซึ่งอาจเกิดขึ้นหลายครั้งต่อเดือน เครื่องมือ AI แบบ semantic อย่าง Thunderbit ปรับตัวอัตโนมัติ เพราะตีความความหมายของหน้า แทนที่จะชี้ไปที่ selector เฉพาะ อย่างไรก็ตาม ไม่มีเครื่องมือใดรอดพ้นจากการเปลี่ยนแปลงการควบคุมการเข้าถึงขนาดใหญ่อย่างกำแพงล็อกอินหน้า 10
5. ฉันจะดึงรีวิว Trustpilot ฟรีได้ไหม?
ทุกเครื่องมือในลิสต์นี้มีจุดเริ่มต้นฟรี: Thunderbit ให้ใช้ฟรี 6 หน้า/เดือน, ScraperAPI ให้เครดิตทดลอง 5,000 เครดิตใน 7 วัน, Web Scraper มีส่วนขยาย Chrome ฟรีสำหรับใช้งานบนเครื่อง, Octoparse มีแผนฟรีตลอดไป (10 tasks, 50,000 แถว/เดือน) และ Apify มีเครดิตฟรี $5/เดือน สำหรับการทดสอบขนาดเล็กหรือเก็บตัวอย่าง เครื่องมือเหล่านี้ใช้งานได้โดยไม่ต้องจ่ายเงิน
ลองใช้ Thunderbit สำหรับดึงรีวิว Trustpilot Get Started Free
อ่านเพิ่มเติม



