
Google ประมวลผลการค้นหามากกว่า 8.5 พันล้านครั้งต่อวัน—บางการประเมินบอกว่าอาจใกล้ 14 พันล้าน—และตัวเลขนี้ก็ยังไต่ขึ้นเรื่อย ๆ ข้อมูลการค้นหาเหล่านี้เป็นเหมืองทองสำหรับทีม SEO, ฝ่ายขายและปฏิบัติการ, นักวิเคราะห์อีคอมเมิร์ซ และตอนนี้ยังรวมถึง AI agents ที่ต้องการหลักฐานจากเว็บแบบเรียลไทม์ด้วย แล้วปัญหาคืออะไร? การเลือก SERP API ในปี 2026 ให้ความรู้สึกไม่ต่างจากเดินหลงอยู่ในเขาวงกตของหน้าราคา ระบบเครดิต และคำสัญญาลอย ๆ เรื่อง "structured JSON"
ในช่วงหลายสัปดาห์ที่ผ่านมา ผมได้ลงลึกกับผู้ให้บริการ SERP API ทั้ง 8 ราย—ทดสอบความเร็วในการตอบสนอง ปรับโครงสร้างราคาให้เป็นมาตรฐานเดียวกันท่ามกลางโมเดลบิลลิงที่ชวนงง และเช็กว่าแต่ละเจ้าดึงองค์ประกอบ SERP อะไรออกมาเป็นฟิลด์แบบมีโครงสร้างได้จริงบ้าง เป้าหมายคืออยากให้คุณได้เห็นการเปรียบเทียบแบบตรงไปตรงมาและเทียบกันได้จริง ซึ่งหาไม่ได้ง่ายจากบทความอื่น เราจะครอบคลุมทั้งความเร็ว ต้นทุนจริงเมื่อใช้งานระดับสเกล ความครอบคลุมในการ parse ความพร้อมสำหรับ AI agents และความเสถียรระดับ production ถ้าคุณเคยหงุดหงิดกับคำว่า "คุณกำลังเทียบหน้าราคา ไม่ใช่ค่าใช้จ่ายจริง" (เป็นคำพูดจริงจาก เธรด Reddit ที่ผมเจอ) บทความนี้เขียนมาเพื่อคุณ
ทำไมคุณถึงต้องใช้ SERP API ในปี 2026 (และทำไมการเลือกถึงยาก)
SERP API คือบริการที่โฮสต์ไว้ให้คุณส่งคำค้นไปยังเสิร์ชเอนจิน แล้วรับหน้าผลลัพธ์กลับมาในรูปแบบที่เครื่องอ่านได้—ส่วนใหญ่คือ JSON แทนที่จะต้องสร้างระบบหมุน proxy เอง จัดการ CAPTCHA เรนเดอร์เบราว์เซอร์ และเขียน parser เอง คุณก็แค่เรียก endpoint แล้วรับข้อมูลที่มีโครงสร้างกลับมา แนวคิดดูง่าย แต่ตลาดจริงซับซ้อนกว่านั้นมาก
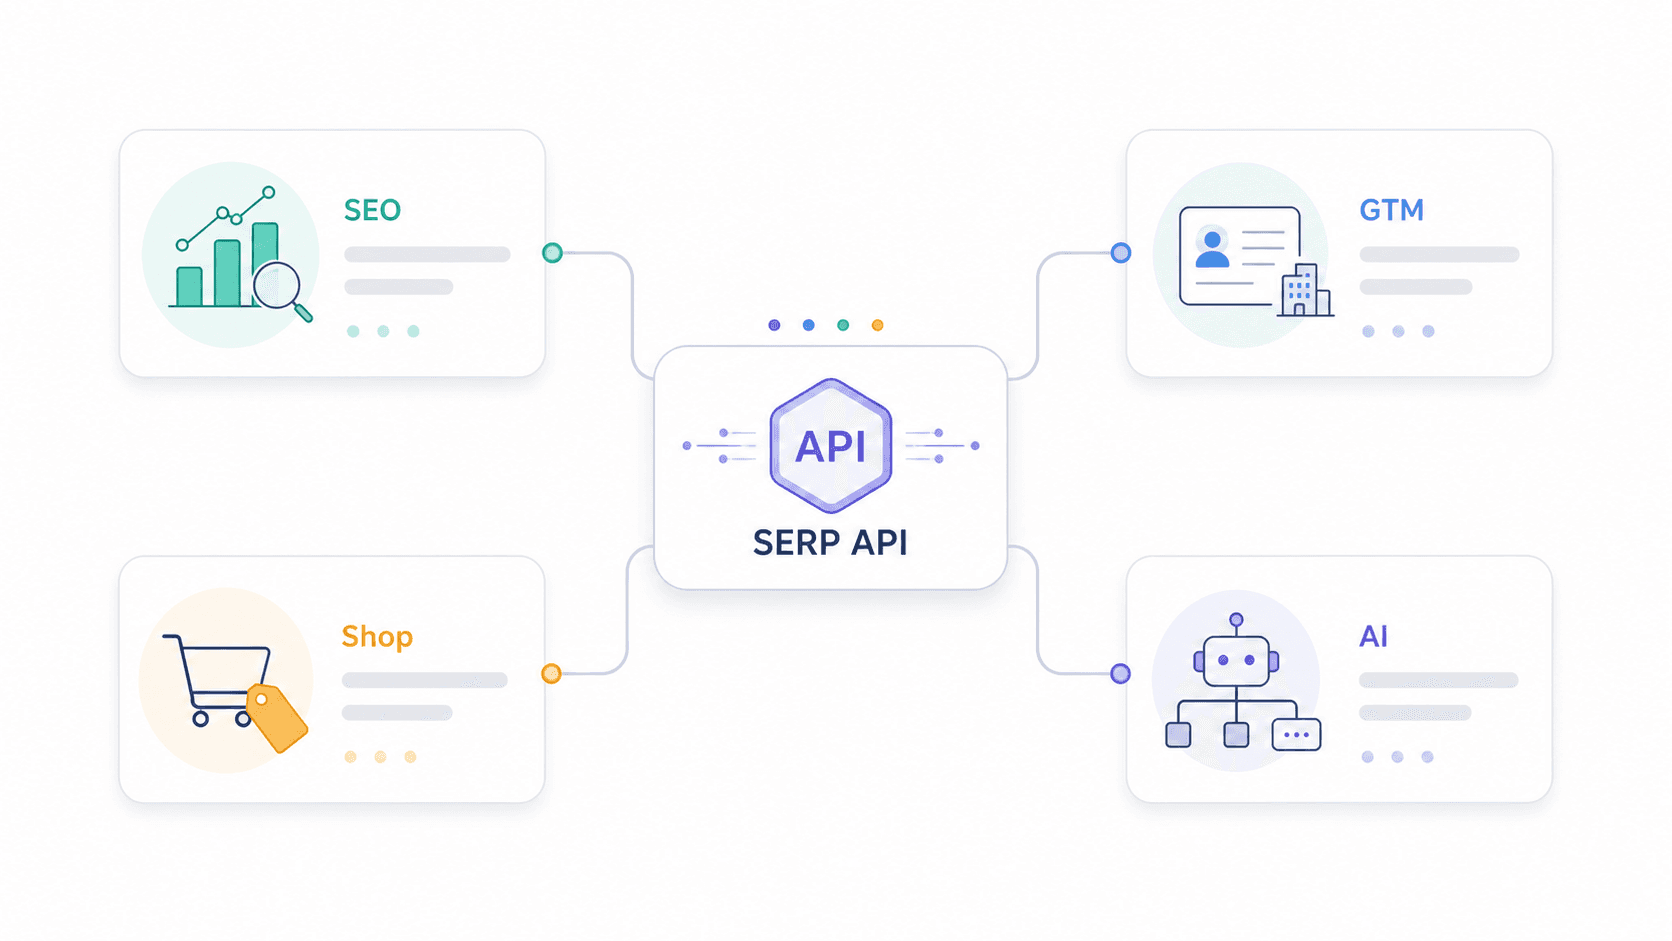
กรณีการใช้งานก็ไม่ได้จำกัดอยู่แค่การติดตามอันดับอีกต่อไป:
- ทีม SEO ต้องการอันดับการค้นหา เจ้าของ snippet คำถาม People Also Ask และความโดดเด่นของคู่แข่ง
- ทีมขายและ GTM ใช้ SERP เพื่อหา company หน้ารีวิว ไดเรกทอรี และสัญญาณการซื้อ
- ทีมอีคอมเมิร์ซ ติดตาม Google Shopping โฆษณาแบบเสียเงิน และราคาของคู่แข่ง
- นักพัฒนา AI ป้อนข้อมูล SERP เข้า LLM agents, RAG pipelines และเครื่องมือ workflow อย่าง n8n และ LangChain
ตลาด web scraping คาดว่าจะพุ่งแตะ 2.23 พันล้านดอลลาร์สหรัฐภายในปี 2031 ด้วยอัตราการเติบโตเฉลี่ยต่อปีราว 13.78% และ SERP API ก็เป็นส่วนสำคัญของตลาดนั้น
จุดที่น่าหงุดหงิดที่สุดคือ ผู้ให้บริการแทบทุกรายชอบบอกว่าให้ "structured JSON" แต่จริง ๆ แล้ว SERP element ที่ parse ได้—PAA, knowledge panel, local pack, shopping ads, featured snippets—กลับต่างกันเยอะมาก ส่วนราคาก็ยุ่งไม่แพ้กัน บางเจ้าคิดต่อการค้นหา บางเจ้าคิดต่อเครดิต บางเจ้าคิดต่อผลลัพธ์ และบางเจ้าคิดต่างกันตามระดับความเร็วหรือภูมิภาค มีผู้ใช้ Reddit คนหนึ่งสรุปไว้ดีมากว่า: "SerpApi คิดเงินตามการค้นหาที่สำเร็จ ScraperAPI ห่อทุกอย่างเป็นเครดิต ส่วน Serperdev ดูเหมือนถูกจนกว่าคุณจะเอาเครดิตไปเทียบกับงานจริงของคุณ"
บทความนี้จะปิดช่องว่างที่ผมหาไม่เจอจากที่ไหนเลย: ตาราง parsing ที่แสดงว่าแต่ละ API คืนอะไรได้จริง, ราคาแบบ normalized ที่ 1K/10K/100K queries, ความเหมาะกับ AI agents และข้อมูลความพร้อมใช้งานใน production
วิธีที่เราทดสอบ: เกณฑ์ในการเลือก SERP API ที่ดีที่สุด
ผมประเมินผู้ให้บริการแต่ละรายตาม 8 มิติที่สะท้อนสิ่งที่ผู้ใช้ระดับ production สนใจจริง ๆ บทความเปรียบเทียบของคู่แข่งส่วนใหญ่แตะเรื่องพวกนี้แค่ 2–3 ข้อแบบผิวเผิน ผมอยากได้ครบทั้ง 8 ข้อ พร้อมหลักฐาน
ความเร็วและเวลาตอบสนอง ผมอ้างอิง benchmark จากแหล่งภายนอก โดยเฉพาะ การเปรียบเทียบของ HasData และเอกสารของผู้ให้บริการ ความเร็วสำคัญมากเมื่อคุณกำลังทำแดชบอร์ดแบบเรียลไทม์ หรือ AI agents ที่ต้องเรียกเครื่องมือแล้วรอผลไม่ได้นาน 30 วินาที
ราคาที่ระดับสเกล (1K, 10K, 100K queries) ผมแปลงราคาของทุกเจ้าให้เป็นต้นทุนต่อ 1,000 การค้นหาที่สำเร็จ นี่คือวิธีเดียวที่จะเทียบโมเดลแบบเครดิต แบบสมัครสมาชิก และแบบจ่ายตามใช้ได้อย่างยุติธรรม
SERP features ที่ parse ได้ (มากกว่า organic results) ผมอ่านเอกสารและตัวอย่าง response เพื่อดูว่าแต่ละ API คืนองค์ประกอบ SERP อะไรเป็นฟิลด์โครงสร้างจริง ๆ ไม่ใช่แค่ HTML ดิบ
มี free tier และจ่ายตามใช้ได้ไหม การเริ่มต้นแบบไม่ผูกมัดสำคัญมาก ถ้าคุณยังลองงานจริงก่อนจ่ายเงินหลายร้อยดอลลาร์ไม่ได้ นั่นคือสัญญาณอันตราย
การเชื่อมต่อกับ AI และ automation ปี 2026 ทีมจำนวนมากต้องการ SERP API ที่ป้อนข้อมูลให้ AI agents มากกว่าแดชบอร์ด Schema ที่นิ่ง, output ที่สะอาด และการแปลงเป็น Markdown ล้วนสำคัญต่อการใช้งานกับ LLM แบบต่อเนื่อง
รองรับหลายเสิร์ชเอนจิน บทความส่วนใหญ่โฟกัสแค่ Google ผมจึงเช็กว่าผู้ให้บริการรายใดรองรับ Bing, Yandex, DuckDuckGo, Baidu และอื่น ๆ บ้าง
Rate limits และความพร้อมระดับ production ไม่มีบทความเปรียบเทียบไหนที่ไล่ดู rate limit, retry policy หรือ SLA อย่างเป็นระบบ แต่ทีมที่สเกลไปถึงหลักพันคำขอต่อวันจำเป็นต้องรู้เรื่องนี้
ความเป็นมิตรต่อนักพัฒนา คุณภาพเอกสาร ความพร้อมของ SDK และเวลาจนได้ผลลัพธ์แรก
1. Thunderbit
Thunderbit ใช้แนวทางที่ต่างจาก SERP API แบบดั้งเดิมโดยสิ้นเชิง แทนที่จะมี endpoint ตายตัวที่ parse องค์ประกอบ SERP ไว้ล่วงหน้า Thunderbit's Extract API ให้คุณกำหนด JSON Schema ของคุณเอง—and AI จะดึงฟิลด์ที่คุณระบุจากหน้าผลการค้นหาได้ตรงตามต้องการ ส่วน Distill API จะเปลี่ยน URL ใด ๆ ให้กลายเป็น Markdown ที่สะอาดและพร้อมใช้กับ LLM
นั่นหมายความว่า Thunderbit ใช้ได้กับ Google, Bing, Yandex, DuckDuckGo หรือเสิร์ชเอนจินอื่น ๆ—AI อ่านหน้าแบบสดใหม่ทุกครั้งแทนที่จะพึ่ง selectors ที่เขียนตายตัวไว้ SERP layout เปลี่ยนตลอด คุณจึงไม่ต้องรอให้ผู้ให้บริการมาอัปเดต parser
ฟีเจอร์เด่น
- Extract API: กำหนด JSON Schema แบบกำหนดเอง (organic results, PAA questions, local pack businesses, shopping products—อะไรก็ตามที่คุณต้องการ) แล้วรับฟิลด์เหล่านั้นกลับมาเป็นข้อมูลมีโครงสร้าง
- Distill API: แปลงหน้า SERP ใด ๆ ให้เป็น Markdown ที่สะอาด—เหมาะมากสำหรับ RAG pipelines และการสรุปด้วย LLM
- ออกแบบมาให้ใช้หลายเสิร์ชเอนจิน: ใช้ได้กับหน้า search ใด ๆ ที่เข้าถึงได้ ไม่ใช่แค่ Google
- ประมวลผลแบบ batch: จัดการหลาย URL พร้อมกันได้
- มีระบบกันบอทในตัว: รองรับการแก้ CAPTCHA, JS rendering และการหมุน proxy ในตัว
- Rate limit ตามแพ็กเกจ: Free (600 units แบบใช้ครั้งเดียว, 2 concurrent), Starter (60,000 units/เดือน, 30 concurrent), Pro (600,000 units/เดือน, 50 concurrent)
ราคา
โมเดลแบบเครดิต Distill ใช้ 1 เครดิตต่อหน้า ส่วน Extract ใช้ 20 เครดิตต่อหน้า มีเครดิตฟรีสำหรับทดสอบ หากคำนวณตามแพ็กเกจรายปี ต้นทุนส่วนเพิ่มของ Distill อาจต่ำได้ถึงประมาณ 0.80 ดอลลาร์สหรัฐต่อ 1K หน้า ขณะที่ Extract อยู่ราว 16 ดอลลาร์สหรัฐต่อ 1K หน้าเมื่อใช้งานเต็มประสิทธิภาพ จุดเด่นของ Extract คือคุณได้ schema ที่ระบบปลายทางต้องการพอดี—ไม่ต้องมานั่ง post-process ต่อ
ดูแพ็กเกจปัจจุบันได้ที่ Thunderbit Pricing
ลองใช้ Thunderbit สำหรับการดึง SERP ด้วย AI
เหมาะที่สุดสำหรับ
เวิร์กโฟลว์ของ AI agents, RAG pipelines, การดึงข้อมูลแบบหลายเสิร์ชเอนจิน, ทีมที่ต้องการ schema ยืดหยุ่นแทน output แบบตายตัว และคนที่เบื่อการรอให้ผู้ให้บริการเพิ่มการรองรับ SERP feature ใหม่ ๆ
2. SerpApi
SerpApi คือผู้เล่นรุ่นเก๋าในตลาดนี้—ให้บริการมาตั้งแต่ปี 2016 และมี endpoint เฉพาะสำหรับ Google ที่ครอบคลุมที่สุด รองรับ Google Search, Maps, Shopping, Scholar, News, Jobs, Trends, Images, Videos และอื่น ๆ
ฟีเจอร์เด่น
- มี endpoint แยกสำหรับผลิตภัณฑ์ของ Google หลายแบบ พร้อม geo-targeting ที่ mature มาก (ถึงระดับเมือง)
- parse PAA, knowledge panels, local pack, ads, shopping results, featured snippets, answer boxes และ related searches เป็นฟิลด์โครงสร้าง
- เอกสารและ client library หลายภาษาที่ดูแลดี
ราคา
ค้นหาได้ฟรี 250 ครั้งต่อเดือน แพ็กเกจ Starter: 25 ดอลลาร์สหรัฐ/เดือน สำหรับ 1,000 searches (เท่ากับ 25 ดอลลาร์ต่อ 1K) แพ็กเกจ Developer (ติดป้ายว่า 'Most popular'): 75 ดอลลาร์สหรัฐ/เดือน สำหรับ 5,000 searches (~15 ดอลลาร์ต่อ 1K) แพ็กเกจ Big Data: 275 ดอลลาร์สหรัฐ/เดือน สำหรับ 30,000 searches (~9.17 ดอลลาร์ต่อ 1K) ไม่มีตัวเลือก pay-as-you-go แบบง่าย ๆ—เป็นแพ็กเกจสมัครสมาชิกแบบ bucket
ความเร็วและความน่าเชื่อถือ
Benchmark ของ HasData ระบุเวลาตอบสนองเฉลี่ยราว 5.49 วินาที—ไม่ใช่เจ้าที่เร็วที่สุด แต่เสถียร SerpApi ระบุ SLA uptime 99.95% บนแพ็กเกจแบบชำระเงิน และข้อจำกัดคำขอพร้อมกันจะแตกต่างกันตามแพ็กเกจ
เหมาะที่สุดสำหรับ
ทีมที่ต้องการ coverage ของผลิตภัณฑ์ Google ที่กว้างที่สุด (Maps, Scholar, Shopping, Jobs) พร้อมความแม่นยำสูงและ schema ที่นิ่ง โปรเจกต์ระดับองค์กรที่มีงบสำหรับราคาพรีเมียม
3. Serper
Serper คือสายเร็วและคุมต้นทุน เป็นผู้เล่นหน้าใหม่ที่โฟกัสการ scrape Google SERP ให้เร็วในราคาที่แข่งขันได้มาก และได้รับความนิยมในชุมชน n8n และ LangChain สำหรับการเชื่อมต่อกับ AI agents
ฟีเจอร์เด่น
- output JSON ที่สะอาดสำหรับ Google Search, News, Scholar, Images, Shopping, Videos, Places, Patents และ Autocomplete
- ตั้งค่าง่ายมาก—เริ่มดึงผลลัพธ์ได้ภายในไม่ถึงนาที
- เรียบง่ายพอที่เฟรมเวิร์ก AI agents จะเชื่อมต่อได้แบบ native
ราคา
สมัครแล้วได้ 2,500 queries ฟรี ราคาเริ่มต้นราว 0.001 ดอลลาร์สหรัฐต่อ search และลดลงเหลือประมาณ 0.00075 ดอลลาร์ที่ปริมาณสูง รองรับการจ่ายตามใช้ ข้อควรระวังคือ การขอผลลัพธ์มากกว่า 10 รายการต่อ query อาจคิด 2 credits (ควรตรวจพฤติกรรมปัจจุบันในแดชบอร์ดของคุณ)
ความเร็วและความน่าเชื่อถือ
ติดอันดับต้น ๆ ในแง่ความเร็ว—HasData รายงานเฉลี่ยราว 2.87 วินาที ซัพพอร์ตมีแค่ทางอีเมล และทีมค่อนข้างไม่เปิดเผยตัวมากนัก ซึ่งทำให้บางคนลังเล เมื่อ concurrency สูงมาก รีวิวบางส่วนก็ชี้ประเด็นด้านความเสถียร อย่างไรก็ดี สำหรับงานส่วนใหญ่ถือว่าดีมาก
เหมาะที่สุดสำหรับ
โปรเจกต์ที่เน้นประหยัดงบ, สตาร์ทอัพ, การเชื่อมต่อกับ AI agents ที่ต้องการข้อมูล Google SERP ที่เร็วและถูก งาน rank tracking ปริมาณสูงที่ต้นทุนต่อ query เป็นข้อจำกัดหลัก
4. Scrapingdog
Scrapingdog อยู่ในตลาดมานานกว่า 5 ปี และมักโผล่มาเป็นตัวที่เร็วที่สุดใน benchmark จากแหล่งภายนอก HasData วัดได้ที่ เวลาตอบสนองเฉลี่ย ~1.25 วินาที พร้อมอัตราความสำเร็จ 100%
ฟีเจอร์เด่น
- Google SERP API คืน organic results, PAA, featured snippets, ads และ local results เป็น JSON แบบมีโครงสร้าง
- มีทั้งตัวเลือก raw HTML และ parsed JSON
- เอกสารหลายภาษา พร้อมตัวอย่างโค้ดสำหรับภาษาโปรแกรมส่วนใหญ่—เริ่มใช้ได้ในไม่กี่นาที ไม่ใช่หลายชั่วโมง
- ซัพพอร์ต 24/7
ราคา
200 เครดิตฟรีต่อเดือน แพ็กเกจเสียเงินเริ่มราว 40 ดอลลาร์สหรัฐ/เดือน ราคาต่อการเรียกเริ่มประมาณ 0.001 ดอลลาร์ และลดลงมากเมื่อใช้งานระดับสูง—บางการเปรียบเทียบระบุว่าต่ำได้ถึง 0.000058 ดอลลาร์ในระดับสูงสุด
ความเร็วและความน่าเชื่อถือ
ตัวเลขความเร็วถือว่าน่าประทับใจจริง ๆ ถ้า workflow ของคุณไวต่อ latency และคุณทำการดึง Google SERP แบบ fixed schema ในปริมาณสูง Scrapingdog เป็นตัวที่เอาชนะยากในแง่เวลาตอบสนองดิบ ๆ
เหมาะที่สุดสำหรับ
เครื่องมือ SEO และ rank tracker ปริมาณสูงที่ต้องการทั้ง latency ต่ำและต้นทุนต่ำ ทีมที่สร้างระบบ production ซึ่งทุกมิลลิวินาทีของ API response time มีความหมาย
5. DataForSEO
DataForSEO ไม่ใช่แค่ SERP API—แต่เป็นชุด API เต็มรูปแบบที่ออกแบบมาสำหรับบริษัทที่สร้างผลิตภัณฑ์ด้าน SEO รองรับ SERP, keywords, backlinks, business data, Google Ads, Trends และอื่น ๆ
ฟีเจอร์เด่น
- การ parse SERP feature ครอบคลุมมาก—organic, paid, local pack, knowledge graph, PAA, featured snippets, shopping, images, videos, top stories และอื่น ๆ
- มี 2 โหมด: Live (synchronous) สำหรับแดชบอร์ดเรียลไทม์ และ Standard (asynchronous) สำหรับ workflow แบบ batch ที่คุณส่งงานเข้าคิวแล้วค่อยดึงผลภายหลัง
- รองรับหลายเสิร์ชเอนจิน: Google, Bing, Yahoo, Baidu, Naver, Seznam และอื่น ๆ
ราคา
โมเดลจ่ายตามใช้ แต่ราคาจะแตกต่างกันตาม endpoint, engine, device, priority และ mode โดยทั่วไปราคา SERP มักอยู่ราว 0.0006–0.002 ดอลลาร์สหรัฐต่อ task สำหรับ Google organic ขึ้นอยู่กับ standard vs. live และการตั้ง priority เอกสารค่อนข้างหนา—ควรเผื่อเวลาใช้เครื่องคำนวณราคาดู DataForSEO Pricing
ความเร็วและความน่าเชื่อถือ
โหมด Standard แบบ async อาจช้ากว่า (~10 วินาที) เพราะงานถูกจัดคิว โหมด Live/ความเร็วสูงมีราคาสูงกว่า แต่เหมาะกับแดชบอร์ดแบบเรียลไทม์ มีประวัติการใช้งานยาวนาน เสถียร และมีซัพพอร์ตระดับองค์กร
เหมาะที่สุดสำหรับ
บริษัท SaaS ที่สร้างแพลตฟอร์ม SEO, แดชบอร์ด rank tracking และเครื่องมือวิจัยคีย์เวิร์ด ทีมที่สบายใจกับเอกสารซับซ้อนและโครงสร้างระดับองค์กร
6. Bright Data
Bright Data คือยักษ์ใหญ่ระดับองค์กร SERP API เป็นเพียงหนึ่งในหลายผลิตภัณฑ์ของเขา—proxy, datasets, Web Unlocker และเครื่องมือ scraping จุดขายคือสเกล ความเสถียร และโครงสร้างพื้นฐาน
ฟีเจอร์เด่น
- มี endpoint เฉพาะสำหรับ Google Maps, Shopping และ search ทั่วไป—พร้อมรองรับหลายเสิร์ชเอนจินผ่านโครงสร้าง proxy ที่ครอบคลุม Bing, Yahoo, Yandex และ DuckDuckGo
- อ้างว่าอัตราความสำเร็จ 100% ด้วยเทคโนโลยีปลดบล็อกในตัว
- จุดแข็งจริง ๆ ของ Bright Data คือ geo-targeting, concurrency และการปลดบล็อกในระดับองค์กร
ราคา
เน้นลูกค้าองค์กร ราคาสาธารณะแสดงทั้งแบบจ่ายตามใช้และแบบสมัครสมาชิก โดยหลายบทความเปรียบเทียบระบุว่ามี commitment เริ่มต้นราว 499 ดอลลาร์สหรัฐ/เดือน ต้นทุนต่อการเรียกเริ่มประมาณ 0.005 ดอลลาร์ แต่จะลดลงเมื่อใช้งานมากขึ้น Bright Data Pricing มี free tier ด้วย (5,000 credits/เดือน ไม่ต้องใช้บัตรเครดิต)
ความเร็วและความน่าเชื่อถือ
Benchmark มักอยู่ในช่วง 2 ถึง 5.58 วินาที เหตุผลที่ซื้อ Bright Data ไม่ใช่เพราะ latency เฉลี่ยต่ำที่สุด—แต่เป็น SLA ระดับองค์กร, ซัพพอร์ตเฉพาะทาง และ infrastructure ที่รับคำขอพร้อมกันระดับหลายล้านได้โดยไม่ตก เอกสาร rate limit แนะนำให้เพิ่มโหลดอย่างค่อยเป็นค่อยไป
เหมาะที่สุดสำหรับ
ทีมองค์กรที่เก็บ SERP หลายล้านรายการต่อเดือน องค์กรที่ต้องการ Google Maps / local business data ในระดับสเกล ทีมที่ใช้งานผลิตภัณฑ์ proxy ของ Bright Data อยู่แล้ว
7. ScraperAPI
ScraperAPI เป็น web scraping API แบบใช้งานทั่วไปที่มี structured Google SERP endpoints ด้วย เป็นตัวเลือกแบบ "หนึ่งเครื่องมือใช้ได้ทุกอย่าง" ที่ผสานง่าย และมี proxy pool มากกว่า 40M IP
ฟีเจอร์เด่น
- Structured data endpoints สำหรับ Google Search, Shopping, News และ Jobs
- ระบบ anti-blocking และ CAPTCHA solving ด้วย machine learning พร้อม JavaScript rendering โดยไม่มีค่าใช้จ่ายเพิ่ม
- รองรับ geotargeting สำหรับผลลัพธ์เฉพาะพื้นที่
ราคา
ทดลองใช้ฟรี 7 วันพร้อม 5,000 credits แพ็กเกจเสียเงินเริ่มราว 49 ดอลลาร์สหรัฐ/เดือน จุดที่ต้องระวังคือ SERP call อาจใช้เครดิตต่างจาก request scraping ปกติ ดังนั้นควรแปลงต้นทุนตามจำนวน SERP queries ที่สำเร็จจริงเสมอ ScraperAPI Pricing
ความเร็วและความน่าเชื่อถือ
พูดตรง ๆ คือ HasData รายงานเวลาตอบสนองเฉลี่ยราว 33.66 วินาทีสำหรับ SERP queries ซึ่งช้ากว่า SERP API เฉพาะทางมาก แม้อัตราความสำเร็จจะสูง (99.9%) แต่ latency ทำให้ไม่ค่อยเหมาะกับงานเรียลไทม์ เหมาะกับงาน batch มากกว่า
เหมาะที่สุดสำหรับ
ทีมที่ต้องการโซลูชัน web scraping แบบกว้างและมี SERP เป็นฟังก์ชันเสริม โปรเจกต์ที่ความเร็วไม่สำคัญเท่าความเสถียรและความง่ายในการเริ่มใช้ นักพัฒนาที่ใช้งาน ScraperAPI อยู่แล้วกับงาน scraping อื่น ๆ และต้องการรวมผู้ให้บริการให้เหลือน้อยลง
8. Apify
Apify ไม่ใช่ SERP API แท้ ๆ แต่เป็นแพลตฟอร์ม scraping และ automation ที่สร้างขึ้นรอบ ๆ "Actors"—สคริปต์นำกลับมาใช้ใหม่ได้สำหรับงานอย่าง Google Search scraping, Maps extraction และ workflow automation ลองคิดว่าเป็น marketplace ที่คุณเลือก (หรือสร้าง) ตัว scraper ที่ตรงกับความต้องการที่สุด
ฟีเจอร์เด่น
- มี marketplace ของ Google SERP actors สำเร็จรูปที่มี coverage ฟีเจอร์ต่างกันไป
- ปรับแต่งได้สูง—สร้าง workflow scraping แบบกำหนดเอง เชื่อม actors เข้าด้วยกัน และตั้งเวลา run ได้
- ส่งออกเป็น JSON และสามารถปรับ configuration เพื่อ parse SERP features เฉพาะได้
- เหมาะมากเมื่อจะรวม SERP extraction เข้ากับงาน scraping/automation อื่น ๆ
ราคา
มี free tier พร้อม platform credits รายเดือน (~5 ดอลลาร์สหรัฐ หรือประมาณ 1,400 results) แพ็กเกจเสียเงินเริ่มราว 29 ดอลลาร์สหรัฐ/เดือน ต้นทุนระดับ actor แตกต่างกัน—บางตัวคิดตามผลลัพธ์ บางตัวคิดตาม compute unit การเปรียบเทียบจากแหล่งภายนอกมักประเมิน Apify ที่ราว 0.003 ดอลลาร์ต่อ search ในสเกลเล็ก Apify Pricing
ความเร็วและความน่าเชื่อถือ
HasData รายงานเฉลี่ยราว 8.2 วินาที สถาปัตยกรรมแบบ actor เพิ่ม overhead เมื่อเทียบกับ SERP endpoint เฉพาะทาง เหมาะกับ workflow แบบตั้งเวลา/batch มากกว่าคำถามแบบเรียลไทม์
เหมาะที่สุดสำหรับ
ทีมที่ต้องการ workflow scraping + automation แบบกำหนดเองที่มากกว่าแค่ข้อมูล SERP โปรเจกต์ที่รวม SERP extraction กับงาน web scraping อื่น ๆ นักพัฒนาที่ต้องการความยืดหยุ่นสูงสุดเหนือ endpoint สำเร็จรูป
ตารางเปรียบเทียบ SERP Feature Parsing: แต่ละ API คืนอะไรได้จริง
นี่คือการเปรียบเทียบที่ผมหาไม่ได้จากที่ไหนเลย ทุกเจ้าบอกว่าให้ "structured JSON" แต่ SERP element ที่ถูก parse ออกมาเป็นฟิลด์หลักจริง ๆ กลับต่างกันมาก ผมตรวจเอกสารและตัวอย่าง response ของแต่ละเจ้า
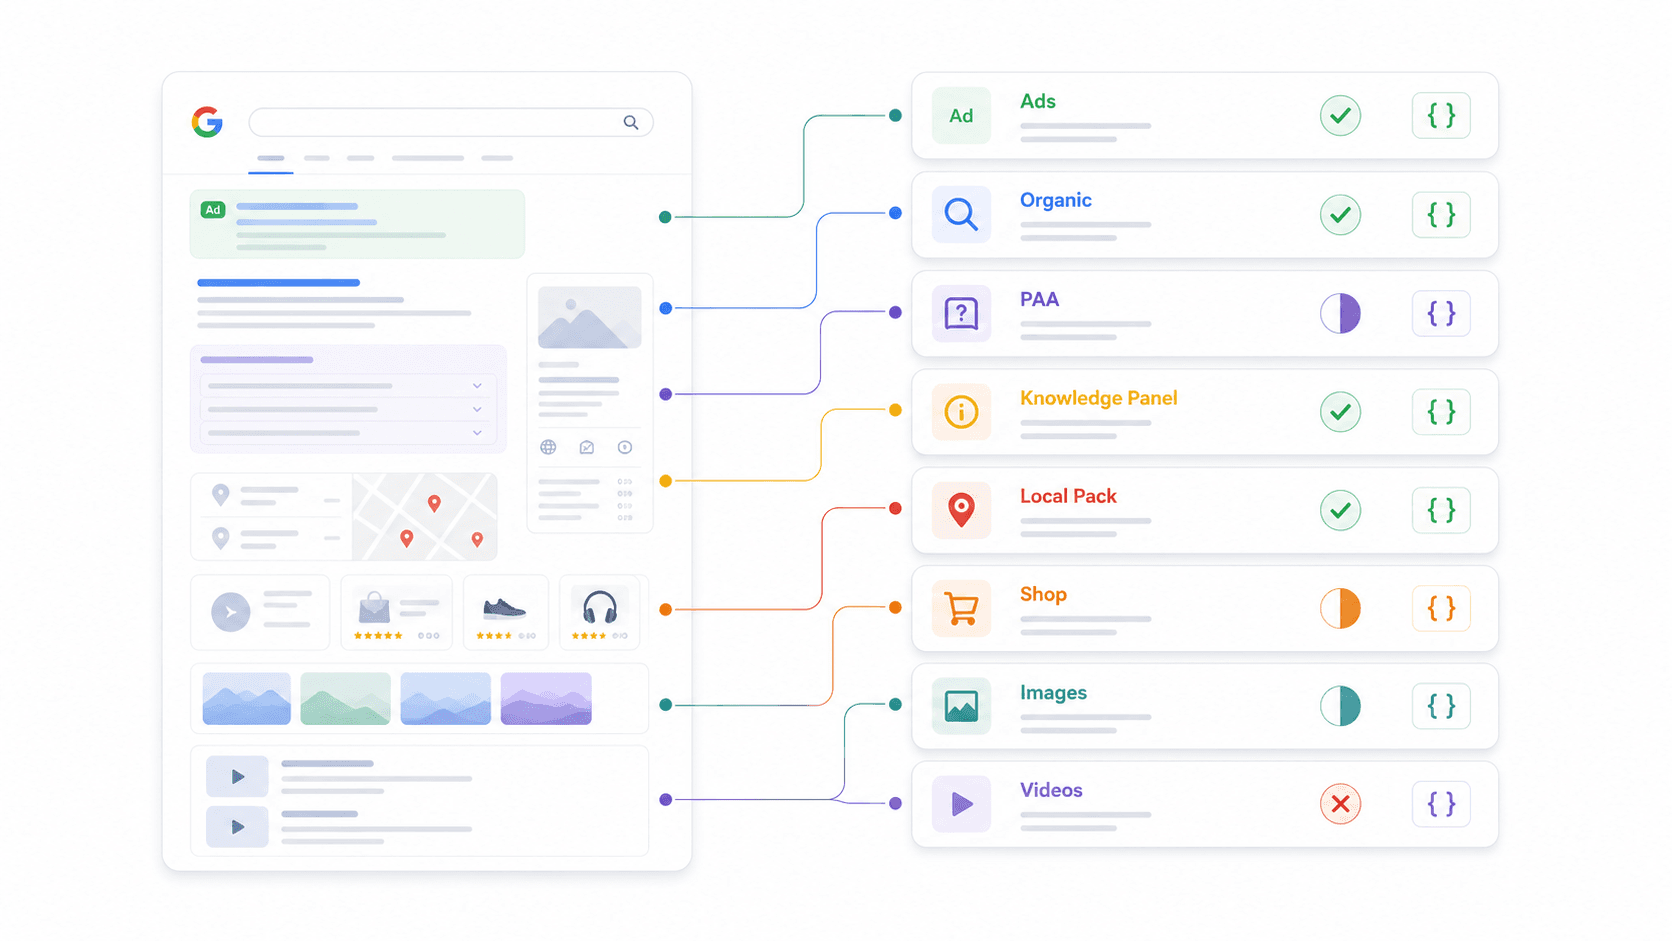
| SERP Feature | Thunderbit | SerpApi | Serper | Scrapingdog | DataForSEO | Bright Data | ScraperAPI | Apify |
|---|---|---|---|---|---|---|---|---|
| Organic Results | Custom Schema | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ขึ้นอยู่กับ Actor |
| People Also Ask | Custom Schema | ✅ | ✅ | ✅ | ✅ | รองรับบางส่วน | รองรับบางส่วน | ขึ้นอยู่กับ Actor |
| Knowledge Panel | Custom Schema | ✅ | รองรับบางส่วน | รองรับบางส่วน | ✅ | รองรับบางส่วน | รองรับบางส่วน | ขึ้นอยู่กับ Actor |
| Local Pack / Maps | Custom Schema | ✅ | ✅ | รองรับบางส่วน | ✅ | ✅ | รองรับบางส่วน | ขึ้นอยู่กับ Actor |
| Shopping Results | Custom Schema | ✅ | ✅ | รองรับบางส่วน | ✅ | ✅ | ✅ | ขึ้นอยู่กับ Actor |
| Featured Snippets | Custom Schema | ✅ | รองรับบางส่วน | ✅ | ✅ | รองรับบางส่วน | รองรับบางส่วน | ขึ้นอยู่กับ Actor |
| Ads (Top/Bottom) | Custom Schema | ✅ | รองรับบางส่วน | ✅ | ✅ | รองรับบางส่วน | รองรับบางส่วน | ขึ้นอยู่กับ Actor |
| Image Pack | Custom Schema | ✅ | ✅ | ✅ | ✅ | รองรับบางส่วน | รองรับบางส่วน | ขึ้นอยู่กับ Actor |
| Video Results | Custom Schema | ✅ | ✅ | รองรับบางส่วน | ✅ | รองรับบางส่วน | รองรับบางส่วน | ขึ้นอยู่กับ Actor |
Custom Schema ของ Thunderbit หมายถึงอะไร: แทนที่จะล็อกไว้ล่วงหน้าว่าจะ parse SERP feature ไหนบ้าง คุณกำหนด JSON Schema ของคุณเองเพื่อดึงฟิลด์ที่ต้องการแบบตรงจุด อยากได้คำถาม PAA พร้อมสรุปคำตอบและสัญญาณความตั้งใจเชิงพาณิชย์ใช่ไหม? แค่กำหนด schema แล้ว AI ก็ส่งให้คุณ นี่คือเหตุผลที่ Thunderbit ใช้ได้กับทุกเสิร์ชเอนจิน ไม่ใช่แค่ Google
ทำไมเรื่องนี้ถึงสำคัญต่อ workflow ของคุณ: ถ้าคุณต้องใช้ข้อมูล PAA สำหรับวางกลยุทธ์คอนเทนต์ คุณต้องเช็กให้ชัดว่าผู้ให้บริการ parse ได้จริงหรือไม่ ถ้าคุณติดตามโฆษณา shopping สำหรับอีคอมเมิร์ซ ก็ควรยืนยันว่ามี structured shopping fields จริง อย่าคิดว่า "structured JSON" เท่ากับครอบคลุมทุกอย่าง
ต้นทุนจริงเมื่อใช้งานในระดับสเกล: เปรียบเทียบราคา per query
ราคาที่แสดงบนเว็บไซต์ไม่ได้บอกภาพรวมทั้งหมด ผมจึงปรับทุกอย่างให้เป็นต้นทุนต่อ 1,000 queries ที่สำเร็จใน 3 ระดับปริมาณ
| Provider | Cost for 1K Queries | Cost for 10K Queries | Cost for 100K Queries | Pay-As-You-Go? | Free Tier |
|---|---|---|---|---|---|
| Thunderbit (Distill) | ~USD 0.80–3.20 | ~USD 8–32 | ~USD 80–320 | Credit-pack | เครดิตฟรี |
| Thunderbit (Extract) | ~USD 16–64 | ~USD 160–640 | ~USD 1,600–6,400 | Credit-pack | เครดิตฟรี |
| SerpApi | USD 25 (Starter) | ~USD 150 (Developer) | ~USD 917 (Big Data) | ไม่มี (สมัครสมาชิก) | 250/เดือน |
| Serper | ~USD 1 | ~USD 10 | ~USD 75–100 | ใช่ | 2,500 queries |
| Scrapingdog | ~USD 1 | ~USD 10 หรือต่ำกว่า | ต่ำกว่า USD 10 ได้มาก | แพ็กเกจ/เครดิต | 200 credits/เดือน |
| DataForSEO | ~USD 0.60–2 | ~USD 6–20 | ~USD 60–200 | ใช่ | Trial credits |
| Bright Data | ~USD 0.50–5+ | แล้วแต่ใบเสนอราคา | เหมาะที่สุดเมื่อใช้งานระดับองค์กร | ใช่/แพ็กเกจ | Free tier (5,000 credits/เดือน) |
| ScraperAPI | ขึ้นอยู่กับเครดิต | ขึ้นอยู่กับเครดิต | ขึ้นอยู่กับเครดิต | แพ็กเกจ/เครดิต | 5,000 trial credits |
| Apify | ~USD 3 (สเกลเล็ก) | ขึ้นอยู่กับ Actor | ขึ้นอยู่กับ Actor | Platform credits | เครดิตฟรีรายเดือน |
ต้นทุนแฝงที่ต้องระวัง:
- Serper อาจคิด 2 credits เมื่อขอผลลัพธ์มากกว่า 10 รายการต่อ query
- DataForSEO มีราคาต่างกันระหว่างโหมด standard และ live/high-priority
- ScraperAPI ใช้ตัวคูณเครดิตต่างกันระหว่าง SERP กับการ scraping ทั่วไป
- Bright Data มี commitment ขั้นต่ำสำหรับลูกค้าองค์กร
ความคุ้มค่าตามระดับใช้งาน:
- โปรเจกต์เสริม (50 ดอลลาร์สหรัฐ/เดือน): Serper หรือ Scrapingdog สำหรับ JSON ของ Google SERP แบบตายตัว
- ทีมที่กำลังโต (10K–50K queries/เดือน): Serper, Scrapingdog หรือ DataForSEO แล้วแต่ความลึกของ parsing
- องค์กร (100K+ queries/เดือน): DataForSEO, Bright Data หรือ SerpApi Big Data
- เน้น AI ก่อน: Thunderbit เพราะ schema ตรงกับความคาดหวังของ agent ฝั่งปลายทางโดยไม่ต้อง post-process
SERP API ที่ดีที่สุดสำหรับ AI Agents และ LLM Workflows ในปี 2026
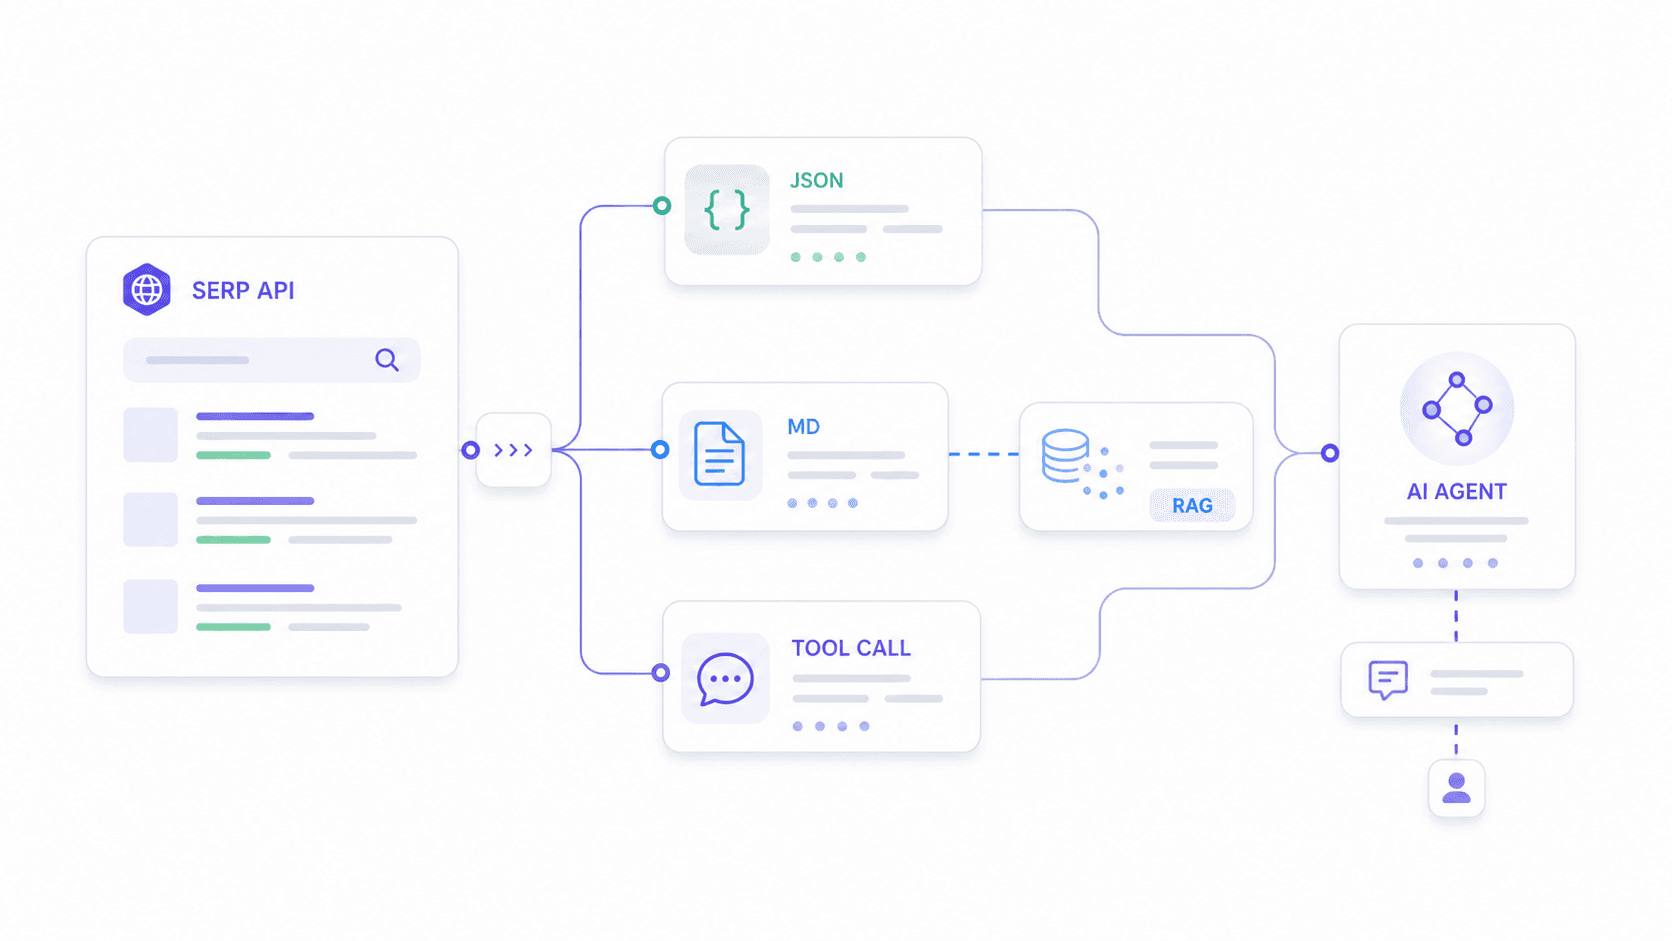
นี่คือ use case ที่แทบไม่มีใครอธิบายได้ดีพอ ผมเจออย่างน้อย 3 เธรด Reddit ที่ผู้ใช้เล่าว่าพยายามเชื่อม SERP API กับ workflow ของ n8n และ AI agents แล้วไปไม่รอด มีคนหนึ่งพูดตรง ๆ ว่า "ยังหาวิธีทำให้มันทำงานกับ AI agent ได้อย่างถูกต้องไม่ได้"
AI agents ต้องการของที่ต่างจากแดชบอร์ดติดตามอันดับ พวกมันต้องการ:
- JSON ที่ schema นิ่ง ซึ่งจะไม่ทำให้ logic การ parse พังเวลาผู้ให้บริการอัปเดตรูปแบบ output
- ฟิลด์ผลลัพธ์แบบกำหนดเอง ที่ตรงกับสิ่งที่โมเดลฝั่งปลายทางต้องการ ไม่ใช่ dump ทุกอย่างแบบกว้าง ๆ
- Markdown หรือ text ที่สะอาด สำหรับ RAG embedding pipelines
- latency ต่ำพอ สำหรับการเรียกใช้เครื่องมือแบบเรียลไทม์
ผู้ให้บริการแต่ละรายเข้ากับ AI agent stack อย่างไร
| Provider | AI Agent Fit | Why |
|---|---|---|
| Thunderbit | ดีเยี่ยม | JSON Schema แบบกำหนดเอง (Extract API) + Markdown สำหรับ RAG (Distill API) ยืดหยุ่นที่สุดสำหรับการดึงข้อมูลเฉพาะ agent |
| Serper | ดีมาก | JSON ที่เร็วและสะอาด เป็นที่นิยมในชุมชน n8n/LangChain ใช้งานง่ายและถูกสำหรับ search-tool call พื้นฐาน |
| SerpApi | ดี | schema นิ่ง เอกสารยอดเยี่ยม เหมาะเมื่อ agent ต้องใช้ Google verticals (Maps, Scholar, Shopping) |
| DataForSEO | ดี | เหมาะที่สุดเมื่อ agent เป็นส่วนหนึ่งของ data pipeline ด้าน SEO ที่ใหญ่กว่า |
| Scrapingdog | ดี | เร็วและถูก; schema นิ่งสำหรับ Google SERP |
| Bright Data | ดี | เก็บข้อมูลสดระดับองค์กรข้ามเอนจินและภูมิภาค |
| ScraperAPI | ปานกลาง | เหมาะเมื่อ agent ยังต้องการ web crawling ทั่วไปด้วย |
| Apify | ปานกลางถึงดี | ยืดหยุ่นแต่ช้ากว่า เหมาะกับ workflow แบบตั้งเวลาและ batch มากกว่า |
ตัวอย่างใช้งานจริงกับ Thunderbit: สมมติว่า AI agent ของคุณต้องวิเคราะห์ search intent สำหรับคำว่า "best CRM for real estate" คุณกำหนด schema ให้ดึง organic results (title, URL, snippet, position), คำถาม People Also Ask พร้อมสรุปคำตอบ และการจัดประเภท intent เชิงพาณิชย์ Thunderbit's Extract API จะคืนโครงสร้างนั้นมาให้ตรง ๆ—ไม่มากไม่น้อยเกินไป Agent ของคุณไม่ต้องเสีย token ไปกับการ parse ฟิลด์ที่ไม่เกี่ยวข้องหรือทำความสะอาด HTML ที่รกตา
สำหรับ RAG pipelines, Thunderbit's Distill API จะเปลี่ยนหน้า SERP ให้เป็น Markdown ที่สะอาด พร้อมนำไปฝัง embedding ได้ทันที SERP API เฉพาะทางส่วนใหญ่มักคืน JSON schema แบบตายตัว แต่แนวทางของ Thunderbit เปิดให้ developer ปรับ output ให้ตรงกับสิ่งที่โมเดลฝั่งปลายทางต้องการ
ตารางตัดสินใจตาม use case: ถ้าคุณต้องการ X ให้ใช้ Y
ผู้ใช้ในฟอรัมมักถามหา recommendation ที่ผูกกับ workflow จริงของตัวเอง ไม่ใช่คำตอบกว้าง ๆ แบบ "แล้วแต่กรณี" ดังนั้นผมจึงทำตารางนี้ขึ้นมา
| Use Case ของคุณ | ตัวเลือกที่ดีที่สุด | ตัวเลือกสำรอง | เหตุผล |
|---|---|---|---|
| ติดตามอันดับ SEO ปริมาณสูง | DataForSEO | Scrapingdog | endpoint ที่เกิดมาเพื่อ SEO, ราคาสำหรับงานจำนวนมาก, parsing ครอบคลุม |
| ข้อมูล Google Maps / ธุรกิจท้องถิ่น | SerpApi | Bright Data | endpoint Maps ที่ mature; Bright Data เหมาะกับ local scraping ระดับองค์กร |
| AI agent / automation บน n8n | Thunderbit | Serper | custom schema + Markdown สำหรับ RAG; Serper เร็วและถูกสำหรับคำสั่งง่าย ๆ |
| MVP แบบประหยัด / โปรเจกต์เสริม (<USD 50/เดือน) | Serper | Scrapingdog | free tier ใจดี, จ่ายตามใช้, ตั้งค่าง่าย |
| หลายเสิร์ชเอนจิน (Bing, Yandex, DuckDuckGo) | Thunderbit | DataForSEO | Thunderbit ใช้ AI extraction ได้กับทุกเสิร์ชเอนจิน; DataForSEO มี multi-engine endpoints |
| รวมรีวิว Google | SerpApi | DataForSEO | มี endpoint สำหรับ parsing รีวิวโดยเฉพาะ |
| อีคอมเมิร์ซ / ติดตามสินค้า | SerpApi | DataForSEO | ครอบคลุม Google Shopping และ structured fields ดีมาก |
| เวิร์กโฟลว์ scraping แบบกำหนดเอง | Apify | ScraperAPI | actor ปรับแต่งได้; ScraperAPI ง่ายสำหรับ scraping ทั่วไป + SERP |
คู่มือแบบสั้นตาม persona:
- ทีม SEO: เริ่มที่ DataForSEO ถ้ากำลังสร้างแดชบอร์ด; ใช้ SerpApi ถ้าความครอบคลุม vertical ของ Google และเอกสารสำคัญกว่าราคา
- ทีมขาย: ใช้ Thunderbit เมื่อ workflow ครอบคลุมทั้ง SERP, หน้าไดเรกทอรี และ enrichment; ใช้ Serper สำหรับคำค้นหาค้นหา lead แบบง่าย ๆ
- นักพัฒนาเครื่องมือ AI: Thunderbit สำหรับ custom schemas/RAG, Serper สำหรับ search ที่เร็วและถูก, SerpApi สำหรับ Google vertical ที่แข็งแรง
- ผู้ประกอบการเดี่ยว: เริ่มจาก free tier ของ Serper, Scrapingdog, SerpApi และ Thunderbit ลอง query แบบใกล้เคียงงานจริง 20 รายการก่อนตัดสินใจ
เปรียบเทียบ Rate Limits, ความน่าเชื่อถือ และความพร้อมระดับ Production
ผมอยากมีหัวข้อนี้ตั้งแต่ตอนแรกที่ประเมินผู้ให้บริการสำหรับงาน production ทีมที่สเกลไปถึงหลักพันคำขอต่อวันต้องมี rate limit ที่คาดเดาได้, automatic retries และการรับประกัน uptime—ซึ่งบทความเปรียบเทียบอื่นแทบไม่พูดถึงอย่างเป็นระบบ
| Provider | Rate Limit | Concurrent Requests | Retry on Failure | SLA / Uptime |
|---|---|---|---|---|
| Thunderbit Free | 600 units, ใช้ครั้งเดียว | 2 | มีในตัว (anti-bot, CAPTCHA) | — |
| Thunderbit Starter | 60,000 units/เดือน | 30 | มีในตัว | — |
| Thunderbit Pro | 600,000 units/เดือน | 50 | มีในตัว | — |
| SerpApi | ตามแพ็กเกจ (searches/hour) | ตามแพ็กเกจ | ผู้ให้บริการจัดการ proxy/CAPTCHA ให้ | SLA 99.95% |
| Serper | ตามบัญชี/แพ็กเกจ | ไม่ได้เผยแพร่อย่างกว้างขวาง | แนะนำให้ retry ฝั่ง client เอง | ไม่มี public SLA |
| Scrapingdog | ตามแพ็กเกจ | ตรวจสอบเงื่อนไขของแพ็กเกจ | จัดการ anti-blocking ให้ | ไม่ได้เผยแพร่เสมอไป |
| DataForSEO | มีเอกสารแยกตาม endpoint/mode | แตกต่างตาม mode | โหมด async รองรับ polling/retry | ซัพพอร์ตระดับองค์กร |
| Bright Data | มีเอกสาร แนะนำให้ ramp ทีละน้อย | ระดับองค์กร | มีระบบปลดบล็อกในตัว | SLA ระดับองค์กร |
| ScraperAPI | concurrency ตามแพ็กเกจ | ขึ้นอยู่กับเครดิต | จัดการ retries/proxies ให้ | มีตัวเลือกซัพพอร์ตแบบชำระเงิน |
| Apify | ขึ้นกับ Actor/memory/compute | ข้อจำกัดของแพลตฟอร์ม | ตั้งค่าระดับ Actor ได้ | ความน่าเชื่อถือของแพลตฟอร์ม |
เช็กลิสต์ก่อนใช้งานจริง:
- ถามให้ชัดว่าผู้ให้บริการคิดเงินกับ request ที่ล้มเหลวหรือถูกบล็อกหรือไม่
- ยืนยัน concurrency, requests per minute และพฤติกรรมตอน burst ให้ชัด
- ตรวจสอบว่า geotargeting, mobile vs. desktop และ JS rendering มีผลต่อการใช้เครดิตหรือไม่
- เซฟตัวอย่าง JSON response สำหรับ 20–50 query จริง และเปรียบเทียบชื่อฟิลด์ข้ามวันเพื่อเช็กว่า schema นิ่งแค่ไหน
- เพิ่ม client-side retries และ timeout budget หาก SERP data สำคัญต่อธุรกิจอย่างยิ่ง
สรุปภาพรวม: เปรียบเทียบ SERP API ทั้ง 8 ราย
| Provider | Avg Speed | Cost per 1K | Free Tier | Parsing Coverage | AI Fit | Multi-Engine | Verdict |
|---|---|---|---|---|---|---|---|
| Thunderbit | ปานกลาง (AI extraction) | ต่ำ (Distill) ถึงพรีเมียม (Extract) | มี | กำหนดเอง (ทุกฟีเจอร์) | ดีเยี่ยม | ดีเยี่ยม | ดีที่สุดสำหรับการดึง SERP แบบ AI-native และ RAG |
| SerpApi | ~5.5 วินาที | พรีเมียม | 250/เดือน | ดีเยี่ยม (ตายตัว) | ดี | ครอบคลุม Google verticals | ครอบคลุม Google ที่ mature ที่สุด |
| Serper | ~2–3 วินาที | ต่ำมาก | 2,500 queries | ดี | ดีมาก | ส่วนใหญ่เป็น Google | API ที่เร็วและถูกที่สุดสำหรับ AI/MVP |
| Scrapingdog | ~1.25 วินาที | ต่ำมากเมื่อใช้งานระดับสเกล | 200 credits/เดือน | ดี | ดี | ต้องตรวจสอบเอนจิน | คุ้มค่าที่สุดด้านความเร็ว/ราคา |
| DataForSEO | ปานกลาง–ช้า (standard) | ต่ำ–ปานกลาง | Trial credits | ดีเยี่ยม | ดี | ดีเยี่ยม | โครงสร้างพื้นฐานที่ดีที่สุดสำหรับแพลตฟอร์ม SEO |
| Bright Data | ~2–5.5 วินาที | ระดับองค์กร | Free tier (5,000/เดือน) | ดี (ขึ้นกับผลิตภัณฑ์) | ดี | ดีเยี่ยม | การเก็บข้อมูลระดับองค์กรที่ดีที่สุด |
| ScraperAPI | ~33 วินาที | ขึ้นอยู่กับเครดิต | 5,000 trial | ปานกลาง | ปานกลาง | endpoint ของ Google | เหมาะถ้า SERP เป็นเพียงส่วนหนึ่งของการ scraping ที่ใหญ่กว่า |
| Apify | ~8 วินาที | ขึ้นอยู่กับ Actor | เครดิตฟรีรายเดือน | ขึ้นอยู่กับ Actor | ปานกลาง–ดี | ขึ้นอยู่กับ Actor | ดีที่สุดสำหรับ workflow automation แบบกำหนดเอง |
Thunderbit เข้ากับ workflow SERP ของคุณอย่างไร
ขออธิบายเพิ่มอีกนิดว่าทำไมทีมของเราถึงสร้าง API ของ Thunderbit ในรูปแบบนี้ โมเดล SERP API แบบดั้งเดิม—endpoint ตายตัว, ฟิลด์ output ที่กำหนดไว้ล่วงหน้า, ใช้ได้แค่ Google—ก็โอเคสำหรับการติดตามอันดับแบบตรงไปตรงมา แต่พอคุณต้องการอะไรที่ต่างออกไปนิดเดียว (เช่นคำตอบ PAA พร้อม sentiment, ผล local pack พร้อมจำนวนรีวิว, หรือข้อมูล shopping ที่ต้องจัดรูปแบบตาม schema ของฐานข้อมูลเฉพาะ) คุณจะติดอยู่กับการ post-process หรือไม่ก็ต้องเปลี่ยนผู้ให้บริการ
Extract API ของ Thunderbit พลิกโมเดลนั้น คุณบอกสิ่งที่ต้องการผ่าน JSON Schema แล้ว AI จะหาวิธีดึงข้อมูลจากหน้า search ที่คุณชี้ไปให้เอง วันนี้เป็น Google พรุ่งนี้เป็น Bing สัปดาห์หน้าจะเป็น search engine เฉพาะทางก็ยังใช้ API เดิม แนวทางเดิม
Distill API แก้ปัญหาอีกแบบหนึ่ง: การแปลงหน้า SERP ที่รกให้เป็น Markdown ที่สะอาด ซึ่ง LLM จะอ่านได้จริงโดยไม่สะดุดกับ HTML ที่กองเกลื่อน, element นำทาง และ tracking script ถ้าคุณกำลังสร้าง RAG pipeline ที่ต้องใช้หลักฐานจากการค้นหาใหม่ ๆ นี่คือเส้นทางที่เร็วที่สุดจาก "live SERP" ไปสู่ "embedded content"
ทั้งสอง endpoint มี anti-bot handling, CAPTCHA solving และ JS rendering มาให้พร้อม คุณไม่ต้องจ่ายเพิ่มสำหรับส่วนนี้—มันรวมอยู่ในต้นทุนเครดิตแล้ว
ลองใช้ Thunderbit Chrome Extension
ลองใช้ด้วยตัวเอง: Thunderbit Chrome Extension สำหรับการดึงข้อมูลผ่านเบราว์เซอร์ หรือเรียก API ตรง ๆ สำหรับงานแบบ programmatic และ ช่อง YouTube ของเรามีวิดีโอสอนใช้งาน หากคุณอยากเห็นการทำงานจริงก่อนเขียนโค้ด
หมายเหตุเรื่องความถูกต้องตามกฎหมาย
เรื่องนี้ถูกถามทุกครั้งใน FAQ ดังนั้นขอสรุปสั้น ๆ ว่า: ความถูกต้องของการ scrape SERP ขึ้นอยู่กับข้อเท็จจริงและเขตอำนาจศาล คดี hiQ v. LinkedIn ระบุว่าการ scrape ข้อมูลที่เข้าถึงได้สาธารณะไม่ได้แปลว่าจะเป็นอาชญากรรมคอมพิวเตอร์เสมอไป แต่ก็ไม่ได้เป็นการอนุญาตแบบเหมารวม Google เคย ฟ้อง SerpApi เรื่องการ scrape SERP ซึ่งสะท้อนแรงกดดันทางการค้าเกี่ยวกับการเข้าถึงข้อมูลนี้อย่างชัดเจน
คำแนะนำเชิงปฏิบัติ: ใช้ API ของผู้ให้บริการตามเงื่อนไขของเขา หลีกเลี่ยงการเก็บข้อมูลส่วนบุคคลถ้าไม่จำเป็น และถามผู้ให้บริการว่าพวกเขาจัดการเรื่อง compliance อย่างไร อย่าคิดว่า SERP scraping ปลอดความเสี่ยง
บทสรุป
ไม่มีผู้ให้บริการรายใดชนะทุกด้าน—ตัวเลือกที่ถูกต้องขึ้นอยู่กับ use case งบประมาณ และสแต็กเทคโนโลยีของคุณ หลังจากปรับราคาให้เทียบกันได้ ทดสอบความเร็ว ทำแผนที่ความครอบคลุมของการ parsing และประเมินความพร้อมสำหรับ AI agents แล้ว นี่คือกรอบตัดสินใจของผม:
- ต้องการความยืดหยุ่น + พร้อมสำหรับ AI agents? → Thunderbit
- ต้องการครอบคลุมผลิตภัณฑ์ Google ให้กว้างที่สุด? → SerpApi
- ต้องการความเร็ว + ต้นทุนต่ำสุด? → Serper หรือ Scrapingdog
- กำลังสร้างแพลตฟอร์ม SEO? → DataForSEO
- ระดับองค์กรและต้องมี SLA? → Bright Data หรือ DataForSEO
- ต้องการ scraping ทั่วไป + SERP เป็นครั้งคราว? → ScraperAPI หรือ Apify
เริ่มจาก free tier ก่อน รัน 20–50 query จริงที่ใกล้เคียง workload ของ production เปรียบเทียบ JSON response ดูต้นทุนจริงหลังหักเครดิตและตัวคูณต่าง ๆ แล้วค่อยตัดสินใจ
ตลาดนี้เปลี่ยนราคาอยู่บ่อย—การเปรียบเทียบนี้อ้างอิงจากหน้าสาธารณะปัจจุบันในเดือนพฤษภาคม 2026 หากคุณมาอ่านภายหลังเป็นเดือน ๆ ควรตรวจสอบใหม่ก่อนซื้อ
หากต้องการอ่านเพิ่มเติมเกี่ยวกับแนวทาง AI web scraping และการเปรียบเทียบกับวิธีแบบดั้งเดิม เราเขียนไว้ละเอียดมาก และถ้าคุณกำลังประเมิน web scraping without coding Thunderbit Chrome extension ก็ช่วยงานด้านนั้นได้เช่นกัน
คำถามที่พบบ่อย
1. SERP API คืออะไร และใครควรใช้?
SERP API คือบริการที่ส่งคำค้นไปยังเสิร์ชเอนจินอย่าง Google, Bing หรือ Yandex แล้วคืนผลลัพธ์กลับมาในรูปข้อมูลที่มีโครงสร้าง (ส่วนใหญ่คือ JSON) ผู้เชี่ยวชาญ SEO ใช้ติดตามอันดับ ทีมขายใช้ค้นหา lead ทีมอีคอมเมิร์ซใช้ติดตามราคา และนักพัฒนา AI ใช้ป้อนข้อมูลค้นหาแบบสดให้ agents และ RAG pipelines
2. การ scrape ผลการค้นหา Google 1,000 รายการผ่าน API มีราคาเท่าไหร่?
แตกต่างกันมาก—ตั้งแต่ประมาณ 0.60 ดอลลาร์สหรัฐต่อ 1K (DataForSEO ใน tier มาตรฐาน) ไปจนถึงประมาณ 25 ดอลลาร์ต่อ 1K (SerpApi Starter plan) ส่วนลดสำหรับการใช้งานระดับสูงแตกต่างกันมากในแต่ละเจ้า ควรเปรียบเทียบในรูปต้นทุนต่อ 1,000 queries ที่สำเร็จจริง แทนการดูราคาแค่ตัวเลขหน้าบ้าน
3. ใช้ SERP API กับ AI agents อย่าง LangChain หรือ n8n ได้ไหม?
ได้ Serper ได้รับความนิยมในชุมชน n8n สำหรับคำสั่งค้นหาง่าย ๆ Thunderbit เด่นที่สุดเมื่อ agent ของคุณต้องใช้ custom JSON schemas หรือ Markdown สำหรับ RAG ส่วน SerpApi เหมาะกับ agent ที่ต้องการข้อมูล Google vertical ที่เสถียร (Maps, Scholar, Shopping)
4. SERP API เจ้าไหนมี free tier ที่ดีที่สุดสำหรับการทดสอบ?
Serper ให้ 2,500 queries ฟรีตอนสมัคร ถือว่าใจดีที่สุดในแง่ปริมาณล้วน ๆ SerpApi ให้ 250 ต่อเดือน Scrapingdog ให้ 200 credits/เดือน ScraperAPI ให้ 5,000 trial credits (7 วัน) และ Thunderbit มีเครดิตฟรีสำหรับการทดลองสร้างต้นแบบ Apify มีเครดิตฟรีรายเดือนมูลค่าประมาณ 5 ดอลลาร์
5. ควรเช็กว่า provider parse SERP features อะไรได้บ้างก่อนซื้อ?
อย่าคิดว่า "structured JSON" จะครอบคลุมทุกอย่าง ควรตรวจสอบว่า API คืนฟิลด์แบบมีโครงสร้างสำหรับ: People Also Ask, Knowledge Panel, Local Pack/Maps, Shopping results, Featured Snippets, Ads (บนและล่าง), Image Pack และ Video Results หรือไม่ ใช้ตาราง parsing ในบทความนี้เป็นเช็กลิสต์เริ่มต้น และลองด้วย query จริงก่อนสมัครแพ็กเกจ
ลองใช้ Thunderbit สำหรับ AI Web Scraping Get Started Free
อ่านเพิ่มเติม



