
Varje vecka får jag någon variant av samma meddelande från en Thunderbit-användare: "Hej, jag hittade en annan scraper som heter Ultimate Web Scraper — hur står den sig mot er?" Rimlig fråga, och en jag faktiskt gillar att besvara, eftersom de flesta verktygsjämförelser på nätet är rätt usla.
Jag letade efter en ärlig sida-för-sida-jämförelse mellan Thunderbit och Ultimate Web Scraper och hittade... ingenting. Noll av de topprankade artiklarna för exakt den här sökningen nämner ens Ultimate Web Scraper vid namn — man får generiska listor med "de 5 bästa scrapers" eller recensioner av ett enskilt verktyg, men ingen har faktiskt ställt de här två bredvid varandra. Så jag gjorde jobbet själv, gick igenom de aktuella officiella dokumenten och prissidorna för båda, och satte ihop den head-to-head som borde ha funnits redan. En snabb brasklapp innan vi börjar: jag är med och driver Thunderbit, så ta min analys med en nypa salt, men jag har försökt hämta varje uppgift om Ultimate Web Scraper från deras egna officiella sidor i stället för att gissa utifrån namnet.
Snabb dom
Om du vill gå från "här är en webbsida" till "här är ett rent kalkylblad" på absolut kortast möjliga tid, så känns Thunderbits agentiska, ett-klicks-metod snabbare eftersom det helt enkelt krävs mindre konfiguration. Om du främst kör lokala jobb, är prismedveten på årsbasis och gillar att ha namngivna verktyg för specifika uppgifter (e-postsökare, telefonsökare, Google Maps-extraktor, Shopify-extraktor), är Ultimate Web Scrapers verktygslådemodell och obegränsade lokala extraktion på betalplaner svåra att bortse från.
Ingen av dem vinner på allt. Det är det ärliga svaret, och ärligt talat är det också ett mer intressant svar än en fejkad "Verktyg A krossar Verktyg B"-rubrik.
Vad är Thunderbit och Ultimate Web Scraper?
Thunderbit i korthet
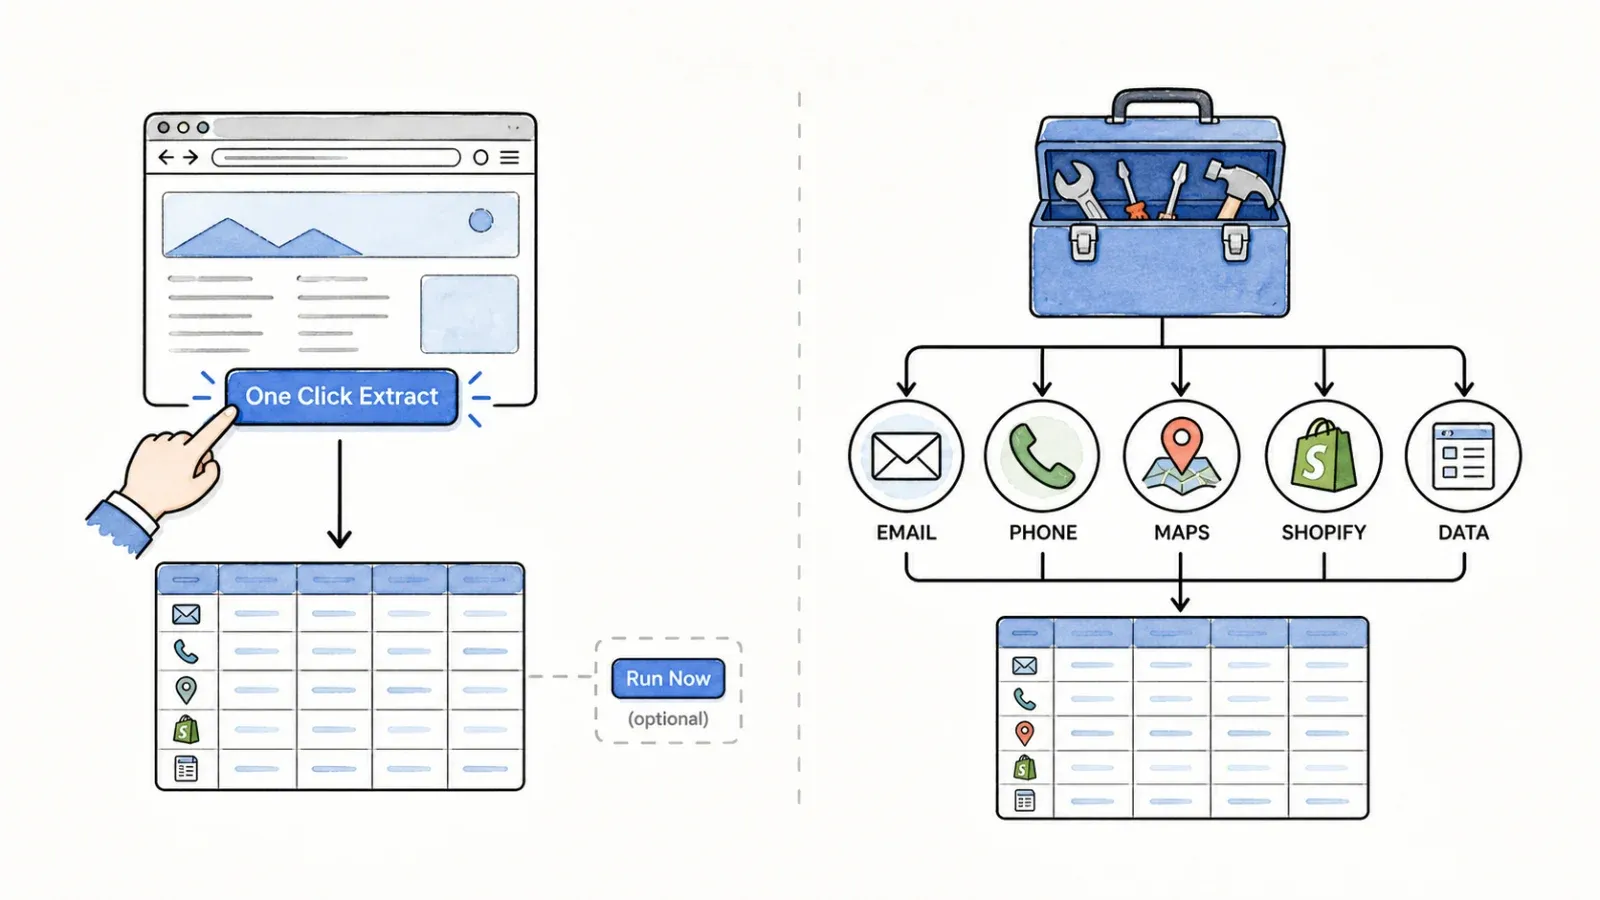
Thunderbit är det jag skulle kalla en agentisk webbscraper — med extra fokus på just den agentiska delen. Standardflödet i Thunderbit Chrome Extension kräver ett enda klick: One Click Extract. Därefter läser agenten sidan, listar ut vilka fält som sannolikt är relevanta (priser, namn, e-postadresser, vad sidan nu tydligt erbjuder) och föreslår dem. Run Now visas som en knapp, men är valfri i praktiken — jobbet startar automatiskt om du inte gör något. Du kan gå in och finjustera fält eller lägga till instruktioner på vanlig engelska om du vill ha mer kontroll, men du behöver varken bygga ett schema eller skriva en enda selector för att få en användbar tabell.

Utöver tillägget finns Thunderbit också som en Web App, ett Open API för utvecklare, en MCP Server för AI-agentflöden och ett CLI för terminalbaserad automation. Schemaläggning, subpage enrichment (att hämta en lista och sedan följa varje rads länk för att samla in mer detaljdata) samt export till Excel, Google Sheets, Airtable och Notion kompletterar bilden. Mitt team byggde det specifikt för att folk som bara vill ha "de här datan i ett kalkylblad, jag vill inte lära mig ett verktyg" faktiskt ska komma dit på några minuter.
Ultimate Web Scraper i korthet
Ultimate Web Scraper är en kommersiell produkt från Happy Panda Tech FZ-LLC, tillgänglig på ultimatewebscraper.com. Värt att flagga direkt: det här är en omprofilering av en produkt som tidigare hette PandaExtract, och den har inget samband med CubicleSofts PHP-verktyg med ett liknande namn — jag nämner det eftersom jag själv nästan hamnade i fel rabbithole under researchen.
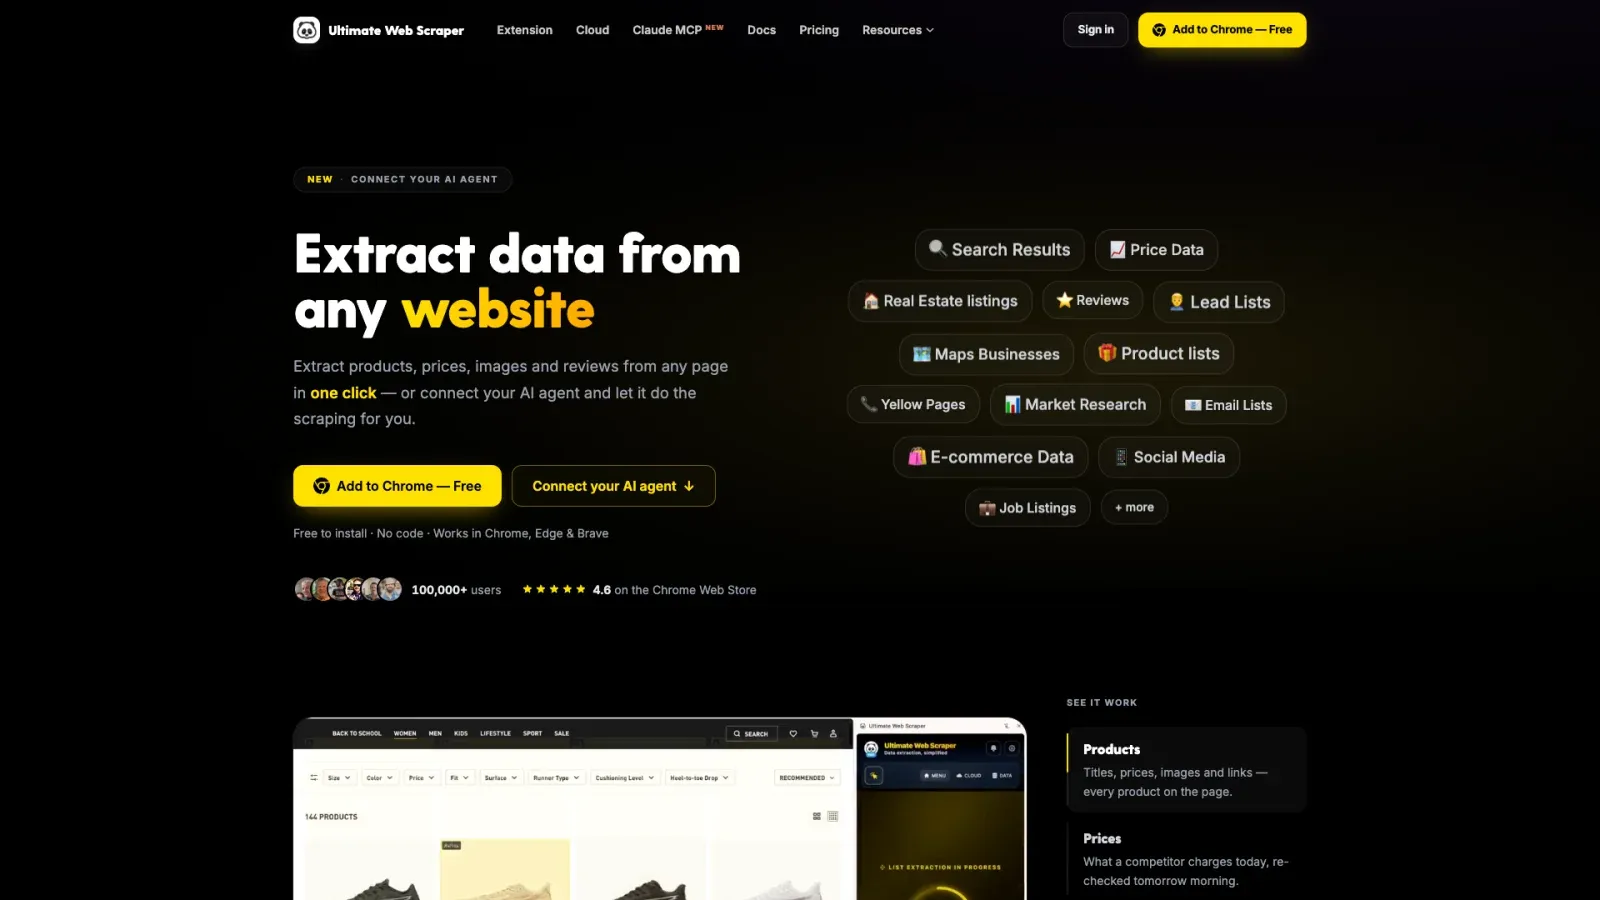
Den nuvarande versionen, enligt dess Chrome Web Store-listning, identifierar automatiskt listor, tabeller och kataloger på en sida och erbjuder ett-klicksextraktion därifrån. Där den verkligen särskiljer sig är i samlingen av dedikerade extraktorer — separata verktyg för e-postadresser, telefonnummer, sociala länkar, bilder, sidtext, Google Maps-listningar och Shopify-butiker. Den stöder obegränsad lokal extraktion (med din egen auktoriserade, inloggade webbläsarsession) på betalplaner, plus en nyare molnplattform med schemaläggning och proxy-stöd. Det är en mogen produkt i verktygslådestil, inte en avskalad scraper.
Jämförelse sida vid sida
Här är tabellen jag önskar hade funnits innan jag började den här researchen. Några celler är märkta "enligt officiell dokumentation" eftersom Ultimate Web Scrapers egen dokumentation är den enda trovärdiga källan till dess funktioner — jag drar inte slutsatser utifrån produktnamnet.
| Kriterium | Thunderbit | Ultimate Web Scraper |
|---|---|---|
| Standarduppsättning | Ett klick (One Click Extract), agenten upptäcker fält, Run Now är valfritt | Ett klick för automatisk identifiering av listor/tabeller; separata namngivna extraktorer för specialuppgifter |
| Paginering/oändlig scroll | Stöds på kompatibla sidor | Automatisk, enligt officiell dokumentation |
| Detaljsidor/batch-flöden | Subpage enrichment (sammanfogning av lista till detalj) | Page Extractor för batchsidor, enligt officiell dokumentation |
| Inloggade sessioner | Stöds på auktoriserade, kompatibla sidor | Lokal extraktion med auktoriserad inloggad session |
| Molnkörning | Tillgängligt via Web App/API | Molnwebbläsare, lanseras 2026 |
| Schemaläggning | Stöds där planen/gränssnittet tillåter | 11 förinställda scheman, enligt credits-dokumentationen |
| Proxyer | Inte primär positionering | ISP-/residential-proxyer med landsval |
| Exporter | Excel, Google Sheets, Airtable, Notion, nedladdningar | CSV, Excel, Google Sheets, betald JSON |
| API/MCP | Open API + MCP Server | MCP + Claude-integration |
| Ideal användare | Icke-tekniska affärsanvändare, AI-agentbyggare | Lokaltunga användare, specialiserade extraktionsbehov |
Lägg märke till att jag inte använde en vägg av gröna bockar. Den stilen döljer de verkliga avvägningarna, och det finns gott om sådana som faktiskt är värda att läsa om.
Den avgörande skillnaden i arbetsflöde: en agentisk handling kontra en verktygslåda med extraktorer
Thunderbits One Click Extract-flöde
Det här är egentligen kärnan i jämförelsen, och det är också det som jag tycker de flesta recensioner hoppar över eftersom det är svårare att beskriva än en funktionslista. I Thunderbit landar du på en sida, klickar på One Click Extract, och agenten gör läsningen åt dig. Den tittar på struktur, upprepade mönster, rubriker och kontextledtrådar för att lista ut hur en "rad" data bör se ut på just den här sidan — oavsett om det handlar om produktlistningar, bostadsannonser eller en kontaktkatalog. Det finns ingen rullgardinsmeny med extraktortyper att välja först. Du behöver inte avgöra "det här är ett e-postjobb" eller "det här är ett Maps-jobb" — agenten tittar bara på vad som faktiskt finns på sidan och arbetar utifrån det.
Hur Ultimate Web Scraper organiserar jobbet
Ultimate har ett mer strukturerat, verktygslådebaserat upplägg. Dess automatiska identifiering av listor/tabeller hanterar standardfallet, men om du vet att du specifikt vill ha e-post, telefonnummer, sociala profiler, bilder, Google Maps-listningar eller Shopify-produktdata, finns en dedikerad extraktor byggd exakt för den uppgiften. Jag vill inte beskriva det som "selector-tungt friktion" — det är verkligen inte så primitivt, och för en användare som redan vet att de behöver till exempel en massuttagning av e-post från 10 000 webbplatser, är ett ändamålsbyggt verktyg sannolikt effektivare än att vänta på att en generell agent ska tolka avsikten. Avvägningen är att du väljer mellan namngivna verktyg i stället för att låta ett system avgöra åt dig, vilket ger ett litet extra steg av "vilken extraktor behöver jag här?" som Thunderbits flöde helt hoppar över.
Listor, paginering och berikning av detaljsidor
Båda verktygen hanterar det vanliga fallet "scrapa en lista, följ pagineringen, hämta fler rader" — det är i princip grundkrav för alla moderna scrapers numera. Det blir mer intressant först efter listan.
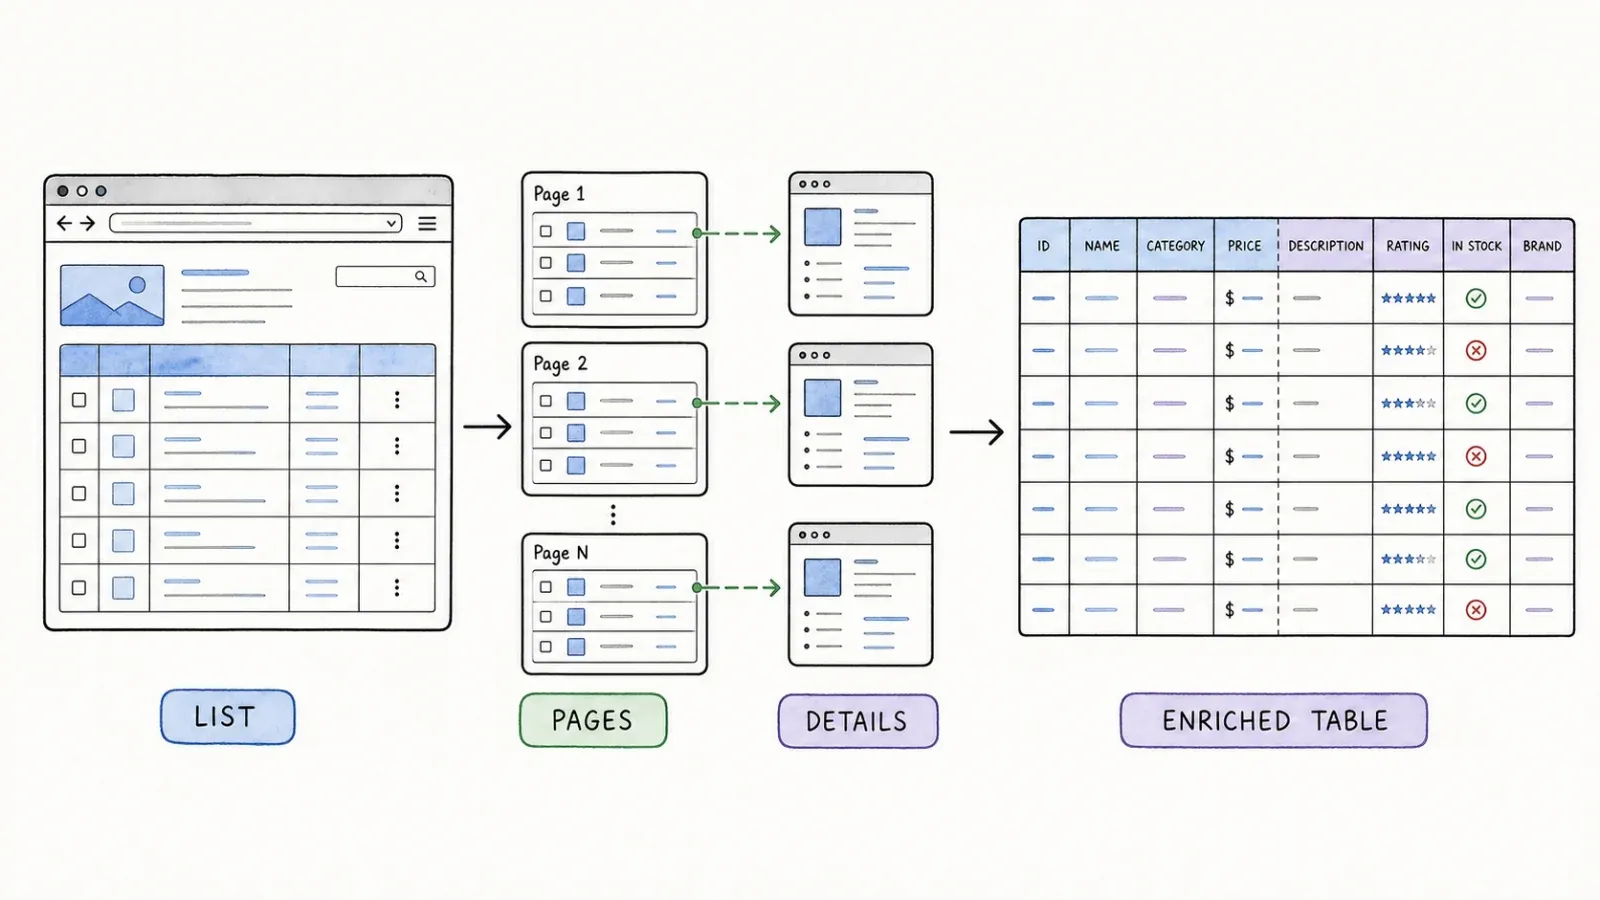
Thunderbits subpage enrichment låter dig ta en lista med objekt (t.ex. företagsnamn med länkar) och automatiskt besöka varje länkad sida för att hämta extra fält — ett telefonnummer, en adress, ett antal recensioner — och sedan slå ihop allt tillbaka till den ursprungliga raden. Det är ett enda sammanhängande arbetsflöde: lista plus detalj, och ut kommer ett rent kalkylblad.
Ultimate Web Scraper's Page Extractor hanterar också batchsidor, med publicerade gränser som är bra att känna till: enligt dokumentationen maxar ett enskilt Page Extractor-jobb runt 2 000 sidor, e-post-/socialskanning toppar runt 10 000 webbplatser per jobb, och Google Maps-extraktion maxar runt 2 000 listningar per körning. Det här är officiella planbegränsningar, inte uppmätt faktisk genomströmning, och jag skulle se dem som riktlinjer för planering snarare än garantier. Inget av företagen hävdar universell kompatibilitet med varje webbplatslayout — sidor byggda med tung klientrendering eller ovanliga DOM-strukturer kan få vilken scraper som helst att snubbla, oavsett om den är agentisk eller regelbaserad.
Webbläsarsessioner, molnkörningar, proxyer och schemaläggning
Lokalt kontra moln är där ekonomin och mentala modellen börjar skilja sig en hel del.
Ultimate Web Scrapers lokala läge körs direkt i din egen auktoriserade, inloggade webbläsarsession — vilket betyder att om du redan är inloggad på en webbplats kan tillägget arbeta med den sessionen direkt, och på betalplaner är den lokala extraktionen obegränsad. Deras molnplattform, som blev publik 2026, lägger till molnwebbläsare, 11 schemaläggningsförinställningar (allt från var tionde minut till en gång i månaden), ISP- och residential-proxyer med landsinriktning samt viss automatiserad upplåsning för vissa utmaningar. Det är en genuint robust molnstapel för en produkt som började som ett webbläsartillägg.
Thunderbit skiljer också mellan körning i webbläsaren och i molnet — du kan köra extraktion direkt i din webbläsare mot en sida du har behörighet att se, eller låta molnkörning ta över för schemalagda och större jobb där planen tillåter det. Jag vill vara tydlig med en sak här, eftersom jag ser alldeles för många scraper-leverantörer överdriva detta: inget av verktygen garanterar framgång mot alla anti-bot-system eller CAPTCHA-lösningar där ute. Cloudflare-utmaningar, aggressiv rate limiting och inloggningsväggar hanteras från webbplats till webbplats, på bästa möjliga sätt, i båda verktygen. Om någon säger att deras scraper aldrig blockeras, så ljuger de antingen eller så har de inte skrapat tillräckligt många webbplatser ännu.
Utskrifter och automationsytor
Att få ut datan är där båda verktygen faktiskt ser ganska lika ut på pappret, även om abstraktionerna bakom skiljer sig.
Thunderbit exporterar direkt till Excel, Google Sheets, Airtable och Notion, utöver vanliga nedladdningar, och för utvecklare finns Open API plus MCP Server för att koppla in extraktion i AI-agentflöden i verktyg som Claude eller Cursor. Ultimate Web Scraper erbjuder exporter till CSV, Excel och Google Sheets, med JSON bakom betalplaner, plus webhook-leverans och sin egen MCP-integration som låter en AI-agent starta scrapingjobb, granska sitemaps och fråga rena tabeller. Båda företagen ser tydligt vart det här är på väg — AI-agenter kommer att initiera många fler scrapingjobb framöver, inte bara människor som klickar på knappar — och båda har byggt för det. Skillnaden är att Ultimate's MCP-yta exponerar familjen av namngivna extraktorer som separata anropbara verktyg, medan Thunderbits MCP-yta exponerar en flexibel extraktionsgrund som en agent kan rikta mot nästan vilken sida som helst.
Prissättning: lokal ekonomi kontra molnekonomi
Här skulle jag råda vilken vän som helst som väljer mellan dessa två att sakta ner och faktiskt räkna på sin egen volym, eftersom listpriset ensamt är missvisande.
Per min research den 2026-08-13 är Ultimate Web Scrapers prissättning årsdebiterad endast: Pro för 60 USD/år med 10 000 molnkrediter per år, Pro+ för 99 USD/år med 100 000 krediter och Team för 249 USD/år med 200 000 krediter över sex platser. Krediter rullar inte över månad för månad (det är årliga pooler), och — det här är den viktiga delen — alla betalda nivåer låser upp obegränsad lokal extraktion. Så om din arbetsbörda mest är "scrapa saker på min egen dator, i min egen webbläsarsession", så är 60 USD/år för obegränsade lokala jobb verkligen billigt. Molnkrediterna blir egentligen först relevanta när du schemalägger återkommande jobb eller behöver molnwebbläsare som kör utan att din laptop är öppen.
Thunderbit använder en kreditbaserad modell med en gratisnivå och betalda månads-/årsplaner — kolla de aktuella siffrorna direkt på Thunderbits prissida i stället för att lita på några siffror jag skulle kunna nämna här, eftersom prissidor ändras och jag hellre skickar dig till källan än att du går på gamla siffror jag skrivit ner.
Här är nyansen som spelar roll: en "kredit" i Ultimate's molnplattform motsvarar en sida, medan Thunderbits kredit-enhet fungerar annorlunda beroende på yta och jobbtyp. Det här är inte äpplen mot äpplen, så motstå frestelsen att bara dela dollar med krediter och kalla det klart. Om du modellerar kostnad vid 1 000 eller 10 000 sidor i månaden är den ärliga övningen att kolla båda aktuella prissidorna, mata in din faktiska förväntade mix av lokala kontra moln-/schemalagda jobb och räkna därifrån — jag föredrar att säga åt dig att göra den uträkningen själv med live-siffror än att ge dig en tabell som ändå är föråldrad när du läser den.
Spridning, aktivitet och vad bevisen faktiskt säger
Siffror är lockande att luta sig mot, så jag vill vara tydlig med vad de faktiskt bevisar.
Enligt Chrome Web Store-snapshoten jag hämtade den 2026-08-13 visar Ultimate Web Scraper 100 000 användare, betyget 4,6 av 5 från 234 omdömen, featured-status, version 3.2 och en uppdatering daterad 2026-08-11. Thunderbits snapshot visar 200 000 användare, betyget 4,2 av 5 från 193 omdömen och en uppdatering daterad 2026-07-28.
Jag ska vara rak: de här siffrorna berättar något om installationsantal och hur nyligen någon släppte en uppdatering. De berättar inte vilket verktyg som extraherar data mer exakt, hanterar just din webbplats bättre eller överlever en CAPTCHA-vägg. Jag letade efter ett oberoende, kontrollerat benchmark som jämför de två direkt i hastighet, noggrannhet eller framgång mot blockering — det finns inte ännu, åtminstone inte vad jag kunde hitta. Den som påstår något annat kör sannolikt sina egna marknadsföringssiffror.
Vilket verktyg ska du välja?
I stället för ett luddigt "det beror på" kommer här en faktisk scenariouppdelning baserad på hur folk brukar använda vart och ett av verktygen.
| Din situation | Bättre val |
|---|---|
| Icke-teknisk marknadsförare eller grundare som vill ha ett kalkylblad snabbt, utan uppsättning | Thunderbit |
| Mest lokal scraping, tajt årsbudget | Ultimate Web Scraper |
| Behöver lista + detaljsidor sammanslagna i en ren tabell | Thunderbit |
| Behöver dedikerad extraktion av e-post/telefon/sociala medier/Maps/Shopify | Ultimate Web Scraper |
| Bygger en AI-agent som behöver en flexibel scraping-primitive via MCP | Thunderbit |
| Vill ha en AI-agent som anropar namngivna extraktorverktyg (Maps, Shopify osv.) | Ultimate Web Scraper |
| Behöver schemalagda molnjobb med proxy-/landsinriktning direkt ur lådan | Ultimate Web Scraper |
| Vill ha programmatisk åtkomst via ett generellt Open API för backendflöden | Thunderbit |
Min ärliga rekommendation, och jag skulle säga samma sak även om jag inte jobbade på Thunderbit: installera båda på dina egna auktoriserade sidor och kör dem mot de faktiska webbplatser du bryr dig om. Ett fem minuter långt test på din riktiga data säger mer än vilken jämförelseartikel som helst, även den här.
Ansvarsfull användning och begränsningar
Inget av verktygen är en magisk nyckel till varje webbplats på internet, och jag skulle göra dig en otjänst om jag antydde något annat. Båda kräver att du extraherar från sidor du har behörighet att komma åt — att respektera inloggningsväggar, webbplatsens användarvillkor och tillämplig dataskyddslagstiftning är ditt ansvar, inte mjukvarans. Extraktion bakom inloggning fungerar bara smidigt på webbplatser där din session och tillägget beter sig förutsägbart tillsammans, och hårt skyddade eller ovanligt strukturerade webbplatser kan sakta ner eller blockera båda verktygen. Det här är inte juridisk rådgivning, bara en påminnelse om att "kan jag tekniskt sett scrapa detta" och "bör jag" är två olika frågor som är värda att ställa varje gång.
Slutlig bedömning
När jag jämförde de här två sida vid sida var det som slog mig mest att de angriper samma problem från var sitt håll. Thunderbit satsar på att ta bort beslut — ett klick, agenten räknar ut resten, och subpage enrichment syr ihop detaljdata igen. Ultimate Web Scraper satsar på att ge dig fler explicita verktyg och riktigt låg årskostnad för lokalt arbete. Beroende på vem som frågar lönar sig båda satsningarna. Om du mest undrar vilket verktyg som sparar flest klick per jobb, vinner Thunderbits agentiska flöde just den tävlingen. Om du mest undrar vilket som sparar mest pengar vid tung lokal användning, är Ultimate's prismodell faktiskt konkurrenskraftig. Jag skulle också tipsa om våra egna genomgångar av AI-webbscraping och de bästa AI-webbscraperna om du vill ha mer kontext om vart hela kategorin är på väg innan du bestämmer dig för något av verktygen.
Vanliga frågor
Är Ultimate Web Scraper samma sak som CubicleSoft PHP-verktyget? Nej. Ultimate Web Scraper är ett kommersiellt Chrome-tillägg och en molnplattform från Happy Panda Tech FZ-LLC, tidigare profilerad som PandaExtract. Det delar varken kod eller ägarskap med det orelaterade open source-projektet CubicleSoft PHP med liknande namn, så blanda inte ihop dem när du söker dokumentation.
Vilket är enklast för en icke-teknisk användare? Thunderbit är byggt specifikt för att ta bort inställningssteg — klicka på One Click Extract och agenten föreslår fält automatiskt, utan selectors. Ultimate Web Scraper är också no-code i sin automatiska identifiering av listor/tabeller, men valet mellan flera dedikerade extraktorer (e-post, telefon, Maps, Shopify osv.) lägger till ett litet beslutsteg som en förstagångsanvändare behöver lära sig.
Kräver Ultimate Web Scraper CSS-selectors? Inte för dess automatiska list-/tabellidentifiering eller dess namngivna extraktorer — de är byggda för ett-klicksflöde, enligt egen dokumentation. Det är en annan uppsättningsfilosofi än rent selector-baserade verktyg, även om den är mer verktygslådsorienterad än Thunderbits enda agentiska handling.
Kan båda verktygen fungera med inloggade sidor? Båda stöder extraktion från auktoriserade, inloggade webbläsarsessioner på kompatibla sidor. Ingen av dem garanterar framgång på varje sida bakom inloggning, särskilt inte de med aggressivt anti-bot-skydd, så testa mot din specifika målsida innan du förlitar dig på dem i produktion.
Vilken produkt är billigast för lokal respektive molnbaserad scraping? För tunga lokala arbetslaster är Ultimate Web Scrapers Pro-plan för 60 USD/år med obegränsad lokal extraktion svårslagen prismässigt. För moln-, schemalagda eller programmatisk-flöden är jämförelsen rättvisare om du kollar aktuella livepriser på både Thunderbits prissida och Ultimate's prissida, eftersom kreditenheterna inte är direkt utbytbara mellan dem.
Bevisar Chrome Store-betyg vilket scraperverktyg som är mest exakt? Nej. Butiksbetyg och installationsantal, som Ultimate's 4,6/5 från 234 omdömen eller Thunderbits 4,2/5 från 193 omdömen, speglar användarnas upplevelse och spridning, inte uppmätt extraktionsnoggrannhet. Det finns i nuläget inget oberoende, kontrollerat benchmark som jämför de två direkt, så det enda tillförlitliga testet är att köra båda mot dina egna riktiga sidor.



