
Sök på "Thunderbit vs Oxylabs" i Google och du väntar dig nog en snygg jämförelsetabell, ungefär som Coca-Cola mot Pepsi. Så enkelt är det inte. Det ena är ett webbläsarverktyg som klickar sig igenom en sida åt dig på några sekunder. Det andra är ett proxynätverk med en IP-täckning som de flesta telekombolag skulle avundas. Ändå söker folk ofta på just den här kombinationen, eftersom båda försöker svara på samma grundfråga: hur får jag ut data från webben utan att offra en hel arbetsvecka på det?
Jag har ägnat en stor del av min karriär åt att röra mig mellan världen där man "bygger infrastrukturen" och världen där man tänker "ge mig bara datan" — först på Automation Anywhere, sedan på Jet.com, och nu när jag leder Thunderbit. Så jag förstår varför valet kan kännas förvirrande. Det är lite som att jämföra en flyttfirma med ett gäng flyttkartonger — båda hjälper dig få saker från punkt A till punkt B, men den ena är en tjänst och den andra är en produkt du använder för att bygga din egen process. Låt oss reda ut vad du faktiskt behöver, för jag lovar att det inte är så dimmigt som marknadsföringssidorna får det att verka.
Snabbt svar
Om du vill ha den korta versionen innan vi går ner i detaljerna: Thunderbit är en agentisk, kodfri webbskrapare — du öppnar en sida, klickar på One Click Extract, och verktyget räknar ut fälten och hämtar strukturerad data, med Web App, Open API, MCP Server och CLI för dig som vill gå djupare. Oxylabs är enterprise-infrastruktur för scraping — proxynätverk, en Web Scraper API och en Web Unblocker-produkt byggd för utvecklingsteam som sätter ihop sina egna datapipelines i stor skala.
Ingen av dem är "bättre" i absoluta termer. Allt beror på vems jobb du försöker lösa — affärsanvändaren som behöver ett kalkylblad senast på fredag, eller dataingenjören som ansvarar för att hålla en scraping-pipeline igång över en miljon förfrågningar i månaden.
Översikt
Så här skulle jag placera produkterna innan vi dyker in i enskilda funktioner:
| Dimension | Thunderbit | Oxylabs |
|---|---|---|
| Huvudanvändare | Sälj, drift, research, icke-tekniska team, samt utvecklare via API/MCP | Dataingenjörer, backend-team, företag |
| Setup | Installera webbläsartillägg, öppna en sida | Skapa konto, generera API-uppgifter, skriva anropslogik |
| Extraktionslager | Agentiskt — AI läser sidan och tolkar fälten | Utvecklarstyrt — du analyserar och strukturerar svaret |
| Anti-bot/rendering | Hanteras automatiskt på stödda, auktoriserade sidor | Hanteras via Web Unblocker eller konfigurering av proxy-lagret |
| Output | Tabell/rader, export till Sheets, Airtable, Notion | Rå HTML eller strukturerad JSON för stödda mål |
| Skalningsmodell | Kreditbaserad, uppgiftsorienterad | Bandbredds- (GB) och volymbaserad |
| Underhåll | Lågt — extraktionslogiken anpassar sig efter sidan | Löpande — du äger retry-logik, rotation och parser-underhåll |
| Styrning | Auktoriserade, kompatibla sidor; användardriven efterlevnad | Detsamma — laglig, auktoriserad användning är kundens ansvar |
Vad är Thunderbit?
Thunderbit är det jag skulle kalla en agentisk webbskrapare — betoningen ligger på "agentisk", eftersom poängen är att du inte själv ska behöva skriva selektorer eller bygga ett schema för hand. Du öppnar en sida du har rätt att använda, klickar på One Click Extract, och agenten upptäcker, läser och analyserar sidan på egen hand. Den föreslår fält som passar just den sidan, och sedan dyker Run Now upp — men här är det många missar: du behöver inte ens klicka på den. Om du inte gör något startar extraktionen av sig själv.
Det är ett tydligt annorlunda arbetssätt jämfört med de flerstegsflöden som vissa tidiga scrapingverktyg använde och som äldre recensioner fortfarande kan beskriva. Vi byggde om det kring en enda avsiktlig handling, eftersom ärligt talat vill ingen gå igenom fem steg bara för att hämta en tabell med priser från en sida.

Utöver engångsextraktionen kan du förfina resultaten på vanlig svenska/engelska med egna instruktioner ("visa bara listningar från de senaste 30 dagarna"), berika undersidor där sajten stöder det och exportera direkt till Google Sheets, Airtable eller Notion. Och om du är utvecklare och vill hoppa över webbläsaren helt finns Thunderbit Open API för programmatisk åtkomst, Thunderbit MCP Server för att koppla extraktion till Claude, Cursor eller andra AI-agentvärdar, samt paketet Thunderbit CLI and Skills för terminalbaserade eller kodagent-drivna arbetsflöden. Det är samma underliggande extraktionsintelligens, bara exponerad via den väg som passar jobbet bäst.
Om du vill ha en bredare bild av hur den här kategorin fungerar i stort skulle jag rekommendera våra genomgångar av AI web scraping och web scraping utan kod — båda går djupare i mekaniken än vad jag har plats för här.
Vad är Oxylabs?
Oxylabs är en helt annan typ av produkt, och rättvist nog försöker de egentligen inte vara en Thunderbit-konkurrent i betydelsen "klicka och extrahera". Deras nuvarande prissida listar flera olika produkter: Web Scraper API, Web Unblocker och en familj av proxynätverk (residential, mobile, datacenter, ISP).
Web Scraper API är det närmaste en "scrapingprodukt" — den börjar på 49 USD/månad, hanterar JavaScript-rendering och returnerar analyserad eller strukturerad JSON för stödda måltyper som sökmotorer, e-handelssajter och reseplattformar. Web Unblocker är mer ett åtkomstlager: det hanterar webbläsarfingeravtryck, cookies, val av proxy och retries automatiskt, och är byggt för att ta sig igenom tuffa anti-bot-skydd på skyddade mål — men du får tillbaka sidans respons, inte en färdig tabell. Du står fortfarande för parsningen.
Sedan finns de rena proxyprodukterna, som är precis vad de låter som: pooler av residential-, mobile- eller datacenter-IP:er som du hyr per gigabyte, och som förutsätter att du redan har byggt din egen automation i webbläsaren, parsning och lagringspipeline. Det här är infrastruktur i ordets egentliga bemärkelse — du köper inte ett färdigt resultat, du köper rören i systemet.
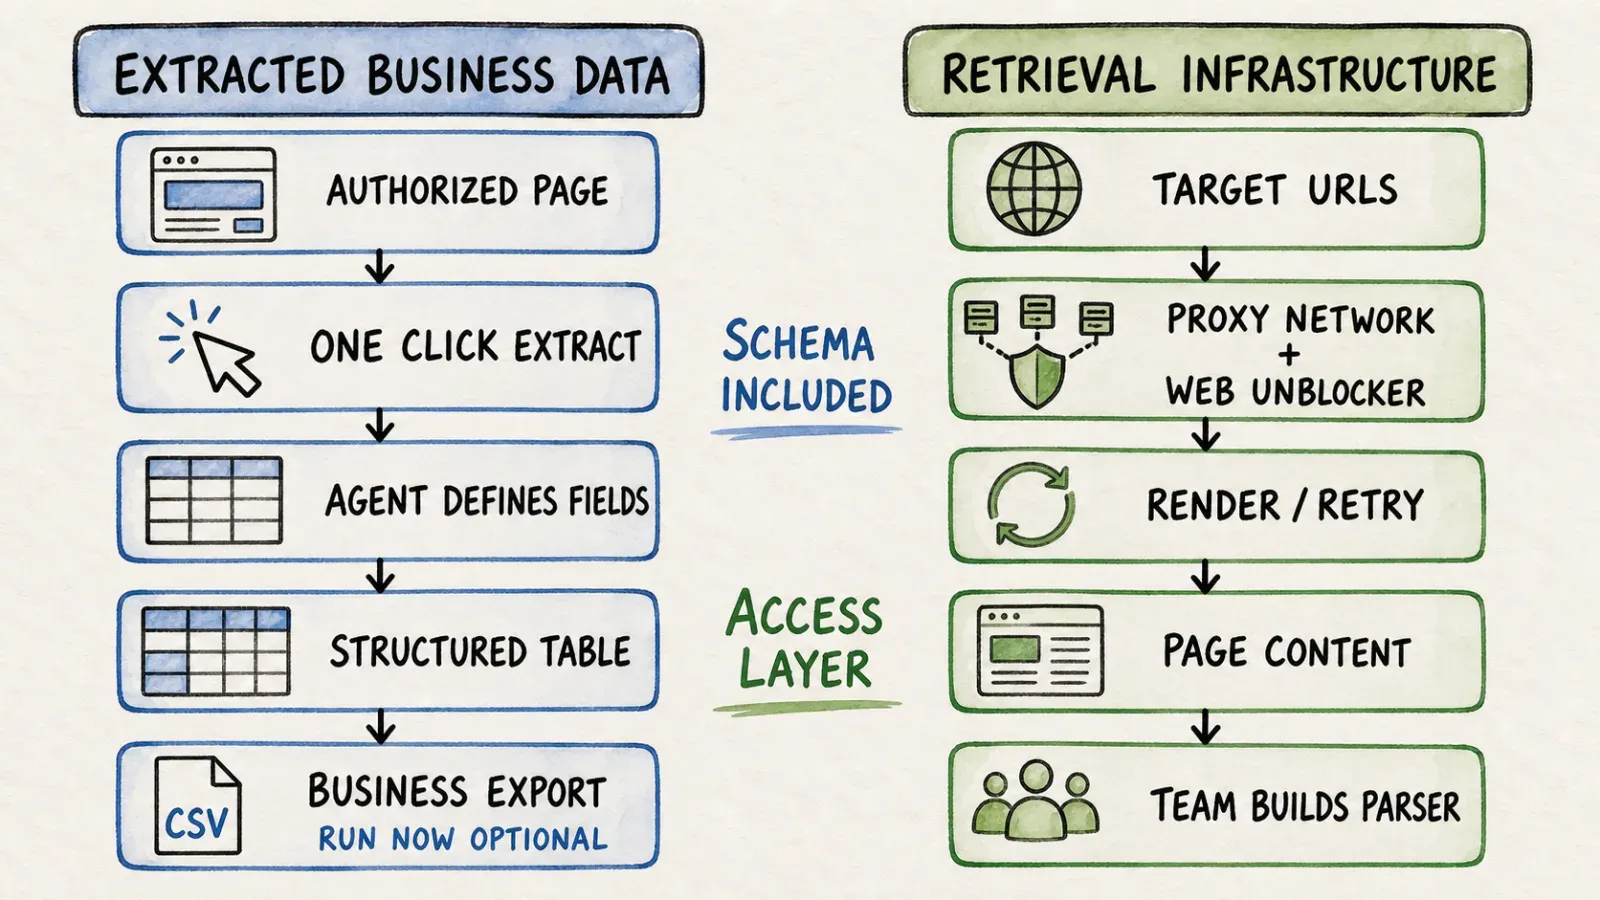
Den viktigaste skillnaden: extraherad affärsdata vs återhämtningsinfrastruktur
Vem definierar schema och fält?
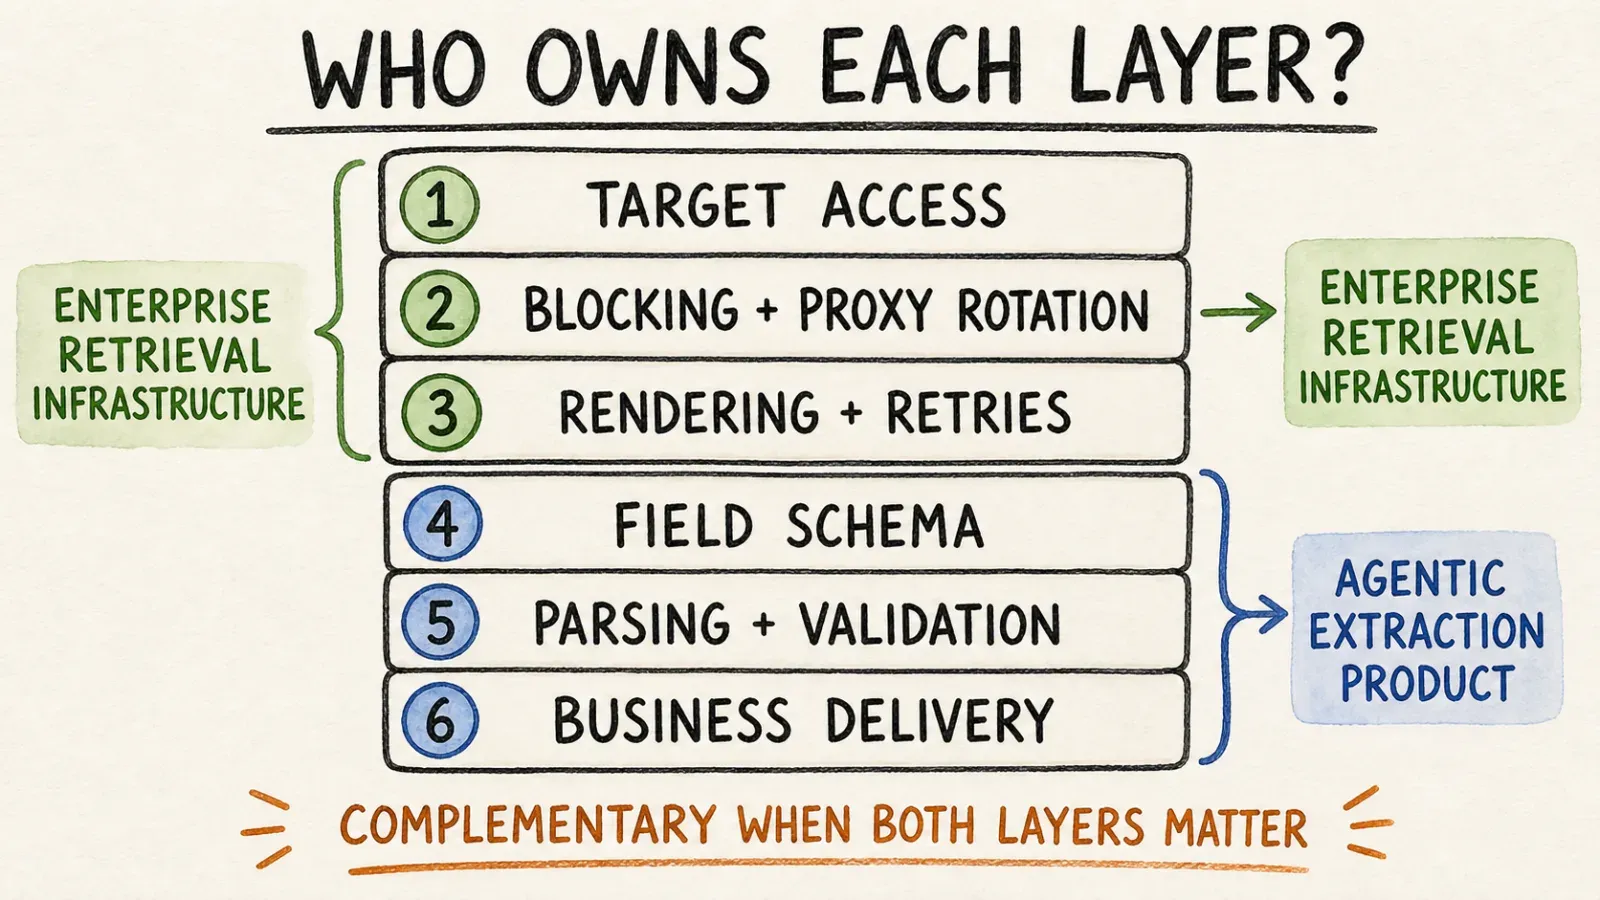
Med Thunderbit tittar agenten på sidan och föreslår fälten — produktnamn, priser, betyg, vad som nu faktiskt finns på sidan — och du justerar därifrån med vanliga instruktioner. Med Oxylabs definierar du själv schemat, om du inte använder en målspecifik parser i Web Scraper API. Det är inte ett minus för Oxylabs; det är bara en helt annan arbetsfördelning. Det ena verktyget utgår från att du inte vill tänka på schema alls. Det andra utgår från att du har åsikter om det och tid att genomdriva dem tekniskt.
Vem hanterar blockering, rendering och proxyrotation?
Thunderbit hanterar rendering och åtkomst automatiskt på stödda, auktoriserade sidor som en del av extraktionsflödet — det finns ingen separat proxyprodukt att konfigurera. Oxylabs delar upp detta i ett eget lager: Web Unblocker finns just för att det är svårt nog att ta sig förbi avancerade anti-botsystem för att förtjäna en egen produkt, med egen prissättning och egen dokumentation. Om dina målsajter är särskilt aggressiva med blockering är det här lagret en verklig styrka hos Oxylabs — det är byggt av människor som tänker på fingerprinting och sessionshantering hela dagarna.
Vem äger övervakning och efterföljande parsning?
Det är här skillnaden mellan "infrastruktur" och "färdig output" verkligen blir tydlig. Med Oxylabs äger du eller ditt team allt nedströms när du fått ett svar — oavsett om det är rå HTML från Web Unblocker eller strukturerad JSON från ett stödt mål i Web Scraper API: validering, lagring, schemaläggning, felhantering och larm när något går sönder klockan 02:00. Med Thunderbit är den bördan mycket lättare eftersom extraheringen och struktureringen sker samtidigt, och exporterna går direkt till de verktyg teamet redan använder.
Arbetsflöde sida vid sida
Siffror ljuger inte, så låt oss faktiskt räkna stegen i stället för att bara säga att något är "enklare".
Engångsjobb: sida till tabell:
| Steg | Thunderbit | Oxylabs |
|---|---|---|
| 1 | Installera Thunderbit Chrome Extension, öppna målsidan | Skapa konto, generera API-uppgifter |
| 2 | Klicka på One Click Extract | Konfigurera request-payload (mål, render, geolokalisering) |
| 3 | Agenten analyserar sidan och föreslår fält | Skicka requesten, hantera proxy- och renderparametrar |
| 4 | Run Now visas — valfritt, extraktionen startar ändå automatiskt | Parsa svaret, bygg retry- och rotationslogik |
| 5 | Exportera till Sheets/Airtable/Notion | Lagra, validera och strukturera outputen själv |
För en affärsanvändare som bara behöver en tabell med konkurrentpriser eller en lista med leads är det ungefär ett klickjobb med Thunderbit jämfört med ett mindre utvecklingsprojekt med Oxylabs. Det är inte en kritik mot Oxylabs — de var aldrig byggda för att hoppa över ingenjörsstegen. De är byggda för att ge ingenjörer en stabil grund att bygga vidare på.
Stort återkommande crawling-/datainsamlingssystem: här vänder kalkylen. Om du hämtar miljontals sidor per månad över dussintals geografier med hårda SLA-krav blir Oxylabs proxydjup och enterprise-support mycket viktigare än bekvämligheten med ett klick. Det här är verkligen deras hemmaplan.
AI-agentintegration via API eller MCP: om du kopplar extraktion till ett Claude- eller Cursor-flöde skulle du antingen välja Thunderbits MCP Server för strukturerad extraktion som agenten anropar, eller Oxylabs Scraper API om det din agent faktiskt behöver är rå åtkomst/avblockering snarare än ett färdigt strukturerat resultat. Båda är rimliga val, beroende på vad agenten ska göra med datan när den väl har den.
Vem behöver egentligen vad?
Jag gillar personor bättre än vaga texter om "vem det här är för", eftersom vag prosa är där marknadsföringssidor gömmer sig.
| Persona | Bättre val | Varför |
|---|---|---|
| Sälj-/marknadsops, affärsanvändare utan kod | Thunderbit | Pek-och-klick-extraktion, direkt export till Sheets/Airtable/Notion, inget att underhålla |
| Dataingenjör som bygger en scraping-pipeline i stor skala | Oxylabs | Djupa proxy-pooler, dedikerad infrastruktur, bandbreddsbaserad skalning |
| Utvecklare som bygger ett AI-agentflöde | Båda, beroende på jobbet | Thunderbits Open API/MCP för strukturerad extraktion; Oxylabs Scraper API för rå åtkomst/avblockering |
| Företag som behöver massiv IP-diversitet | Oxylabs | Residential-proxytäckning är deras kärnstyrka |
Om jag skulle koka ner det till en mening: Thunderbit svarar på "hur får jag användbar data just nu", och Oxylabs svarar på "hur bygger jag ett system som fortsätter få data för alltid."
Noggrannhet, anti-bot-hantering och underhåll
Inget av verktygen är magiskt, och det vore oärligt att påstå något annat. Thunderbits agentiska extraktion fungerar bra på kompatibla, auktoriserade sidor som den är byggd för — men det är en viktig begränsning, inte en parentes i marknadsföringen. Det är ingen garanti mot varje CAPTCHA, inloggningsvägg eller anti-automationsförsvar på internet. Oxylabs Web Unblocker är specifikt konstruerad för att ta sig igenom vissa av de svårare målen med automatisk hantering av fingerprint och sessioner, och det är en verklig specialisering som förtjänar respekt.
Det är dock i underhållsfrågan som gapet blir större. Thunderbits tolkning av fält anpassar sig när sidor förändras, vilket minskar den handpåläggning traditionella skrapare ofta kräver. Oxylabs lägger det ansvaret på dig — retries, rotationslogik, parseruppdateringar när en målsajt bygger om sin HTML. Det är kompromissen med att äga infrastrukturen själv: mer kontroll, mer ansvar.
En sak som båda företagen skulle (och bör) hålla med om: samla bara in det du har rätt att komma åt, och respektera målsajtens villkor och tillämplig lag. Varken en AI-agent eller ett proxynätverk gör otillåten scraping till tillåten scraping.
Prissättning och total kostnad
Här tycker jag att många jämförelseartiklar blir slarviga — de kopierar bara siffror från en prissida och är klara där. Låt oss faktiskt sätta ett scenario på det.
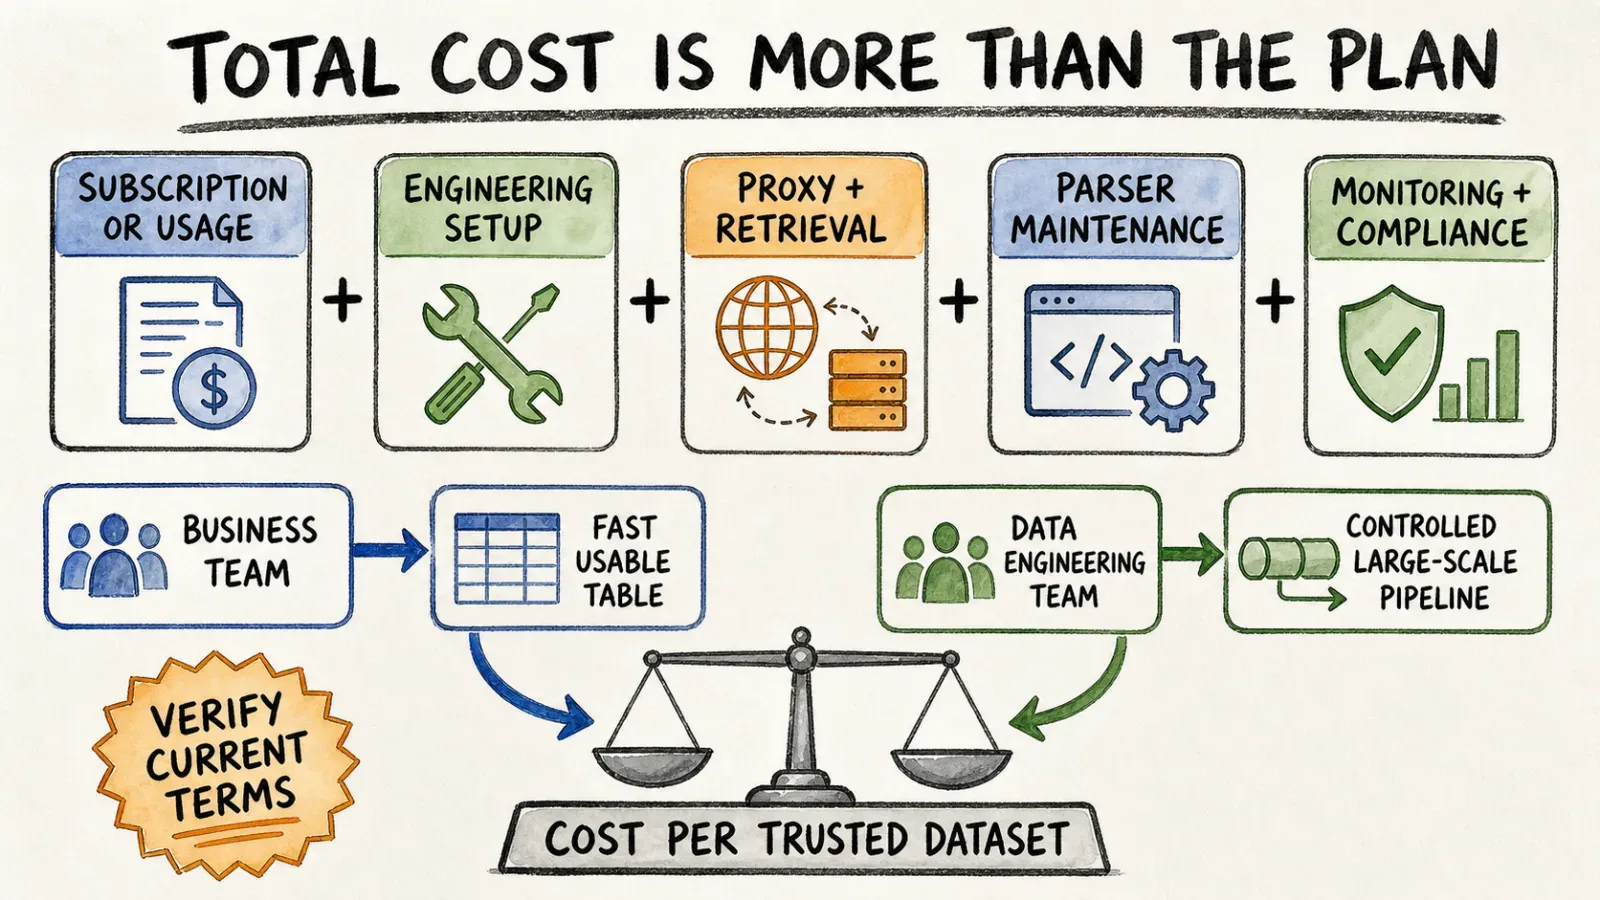
Säg att du behöver samla in 5 000 produktlistningar i månaden från en kategorisida inom e-handel, uppdaterad veckovis. Med Oxylabs Web Scraper API, som börjar runt 49 USD/månad, betalar du utifrån resultat och förfrågningar, och om du behöver det tuffare åtkomstlagret ligger Web Unblocker från Micro-planen på 75 USD/månad för 8 GB upp till Advanced på 660 USD/månad för 88 GB (ordinarie pris, före eventuell tillfällig rabattkod). Haken är att GB-användning inte skalar helt förutsägbart — en sida med tung JavaScript-rendering kan äta bandbredd snabbare än en lätt statisk sida, och Oxylabs egen faktureringsdokumentation säger att både request- och response-trafik räknas mot fakturan, och att även vissa 4xx-svar kan vara avgiftsbelagda.
Thunderbit använder i stället en kreditbaserad modell kopplad till extraktionsuppgifter snarare än rå bandbredd — så ett jobb med 5 000 rader kostar ungefär vad ett jobb med 5 000 rader kostar, oavsett hur tungt sidan råkar vara på JavaScript. Det är en verkligt annan mental modell: den ena mäts som en elräkning, den andra som en tjänsteprenumeration.
Jag säger det självklara som alla ärliga jämförelser borde säga: prissidor ändras hela tiden, rabatter kommer och går, och planernas namn byts runt. Kolla Thunderbits aktuella prissättning och Oxylabs prissida direkt innan du budgeterar något, och räkna med din egen utvecklingstid också — ett "billigt" GB-pris är inte billigt om det krävs två utvecklardagar i månaden för att hålla pipelinen igång.
Vad recensionerna faktiskt säger
Jag försöker att inte bara vifta med mitt eget teams flagga här, eftersom det inte hjälper någon som gör seriös research. Recensionssajter som G2 visar ofta att Oxylabs får starka betyg för dedikerad kontosupport och tillförlitlighet i enterprise-miljö — vilket stämmer väl med den kundrelation man kan förvänta sig av ett företag som säljer infrastruktur till utvecklingsteam med SLA:er på spel. Om ditt företag är beroende av att en scraping-pipeline aldrig går ner är ett supportteam som svarar snabbt värt riktiga pengar.
Å andra sidan tenderar signalerna kring användarvänlighet och tid-till-värde att tala för verktyg som bygger på mallar och uppgiftsbaserad extraktion snarare än ren API-konfiguration — vilket är Thunderbits område. Olika produkter, olika granskningskriterier, och ärligt talat kan båda sakerna vara sanna samtidigt utan att motsäga varandra.
Vem bör välja Thunderbit?
Välj Thunderbit om du arbetar inom sälj, drift, research eller marknadsföring och behöver strukturerad data från en webbsida utan att vänta på ett utvecklingssprint. Det är också ett bra val för utvecklare som vill ha AI-agentstyrd extraktion utan att själva bygga en proxy- och parsingstack från grunden — du får Open API, MCP Server och CLI vid behov, utan att förlora det snabba webbläsaralternativet för manuella jobb. Om du vill se hur detta står sig mot andra verktyg i kategorin är vår genomgång av de bästa AI-webbskraparna en bra nästa läsning.
Vem bör välja Oxylabs?
Välj Oxylabs om du är ett teknik- eller datateam som kör stora, skyddade och produktionskritiska insamlingsjobb — sådana där du behöver geografisk styrning, sessionskontroll och en proxy-pool som är tillräckligt djup för att klara aggressiv rate limiting. Om din organisation redan äger orkestrering, parsning och lagring och bara behöver stabil åtkomst i stor volym, är Oxylabs infrastruktur byggd exakt för det jobbet.
Kan de användas tillsammans?
I teorin, ja — ett enterprise skulle kunna använda Oxylabs för rå åtkomst och avblockering på infrastrukturnivå, medan enskilda team använder ett verktyg som Thunderbit för snabb, strukturerad extraktion ovanpå auktoriserade datakällor. Jag vill dock vara försiktig här: jag känner inte till någon officiell integration mellan produkterna, och jag vill inte överdriva ett partnerskap som inte finns. Tänk mindre "de här två produkterna kopplas direkt ihop" och mer "de här två produkterna kan samexistera på olika nivåer i ett företags datastack" — vilket är en betydligt ärligare beskrivning.
Slutsats
Om ditt mål är den kortaste vägen från "webbsida" till "användbart kalkylblad" är Thunderbit byggt kring ett avsiktligt klick på One Click Extract; agenten analyserar sidan och jobbet körs automatiskt, medan Run Now är valfritt. Den här Web Scraping Without Coding-metoden gör det tillgängligt även för icke-tekniska team. Om ditt mål i stället är att driva en robust scrapingverksamhet med hög volym som ditt utvecklingsteam fullt ut äger och kontrollerar, ger Oxylabs dig råmaterialet för att bygga det — proxydjup, avblockering och enterprise-supporten som backar upp allt.
Jag tycker inte att det finns någon universell vinnare här, och alla artiklar som påstår det försöker sannolikt sälja något. Välj utifrån vem som ska använda verktyget i vardagen — en affärsanvändare som vill ha resultat, eller en ingenjör som vill ha infrastruktur.
FAQ
Är Oxylabs kodfritt som Thunderbit? Inte riktigt. Oxylabs Web Scraper API och Web Unblocker är produkter för utvecklare — du skickar API-anrop och hanterar svaret själv. Det finns ingen webbläsarbaserad klick-och-extrahera-upplevelse som kan jämföras med Thunderbits ettklicksflöde.
Ingår API och MCP för utvecklare i Thunderbit? Ja. Utöver webbläsartillägget erbjuder Thunderbit ett Open API för programmatisk åtkomst, en MCP Server för AI-agentvärdar som Claude och Cursor, samt en CLI för terminalbaserade arbetsflöden.
Vilket verktyg klarar anti-bot-tunga mål bäst? Oxylabs Web Unblocker är byggt specifikt för svåra, skyddade mål med automatisk hantering av fingerprint och sessioner. Thunderbit hanterar rendering och åtkomst på kompatibla, auktoriserade sidor som en del av sitt extraktionsflöde, men marknadsförs inte som ett dedikerat anti-bot-bypassverktyg.
Vilket är enklast för icke-tekniska affärsanvändare? Thunderbit, med stor marginal. Det finns ingen API-konfiguration, inget schema att designa och ingen parser att skriva — du klickar, agenten föreslår fält, och resultatet exporteras till Sheets, Airtable eller Notion.
Hur bör jag jämföra Thunderbits prissättning med Oxylabs prissättning? Jämför inte bara prisetiketter direkt — modellerna är olika. Oxylabs fakturerar främst per bandbredd (GB) och förfrågningsvolym, vilket varierar med sidans komplexitet och JavaScript-rendering. Thunderbit använder krediter kopplade till extraktionsuppgifter, vilket ger mer förutsägbar kostnad per jobb. Kolla alltid aktuella siffror på Thunderbits prissida och Oxylabs prissida innan du budgeterar.




