
Sammanfattning
Den föregående rapporten ställde en policyfråga: hur många av världens mest besökta webbplatser talar om för AI-sökrobotar vad de får och inte får göra?
Den här uppföljningen ställer den operativa frågan bakom den: hur tillförlitlig är robots.txt som den infrastruktur som nu förväntas bära den policyn?
Svaret är obekvämt. robots.txt fungerar fortfarande eftersom den är publik, billig, maskinläsbar och redan förstås av crawlare. Men den förväntas också göra långt mer än den var byggd för. År 2026 kan samma textfil innehålla crawlkontroller för SEO, sitemap-index, äldre sökmotortillägg, AI-träningsavståenden, policyvokabulär från Cloudflare, upphovsrättsreservationer och juridiskt språk inför framtida tvister.
Det är konfigurationsskuld.
Datamängden bakom rapporten är samma Tranco Top 10 000-crawl som användes i den ursprungliga studien om AI-crawlare. Av de 10 000 domänerna returnerade 6 638 en läsbar robots.txt; ytterligare 610 returnerade 404, vilket enligt protokollet behandlas som implicit tillåtelse. Det ger 7 248 analyserbara sajter för beslut om botåtkomst och 6 638 konkreta filer för analys av konfigurationskomplexitet.
Sex resultat sticker ut:
-
De flesta
robots.txt-filer är små, men den högra svansen är extremt komplex. Medianfilen är bara 834 byte och 31 rader. Men 1 005 filer är minst 5 KB, 273 är minst 20 KB och 28 är minst 100 KB. Den största filen i urvalet är 248 KB. -
Hundratals toppwebbplatser kör filer som liknar produktionskonfiguration mer än policyanteckningar. Medianfilen har 9
Disallow-direktiv. Men 707 sajter har minst 100Disallow-regler, 13 har minst 1 000, 240 anger minst 50 user-agents och 110 anger minst 100 user-agents. -
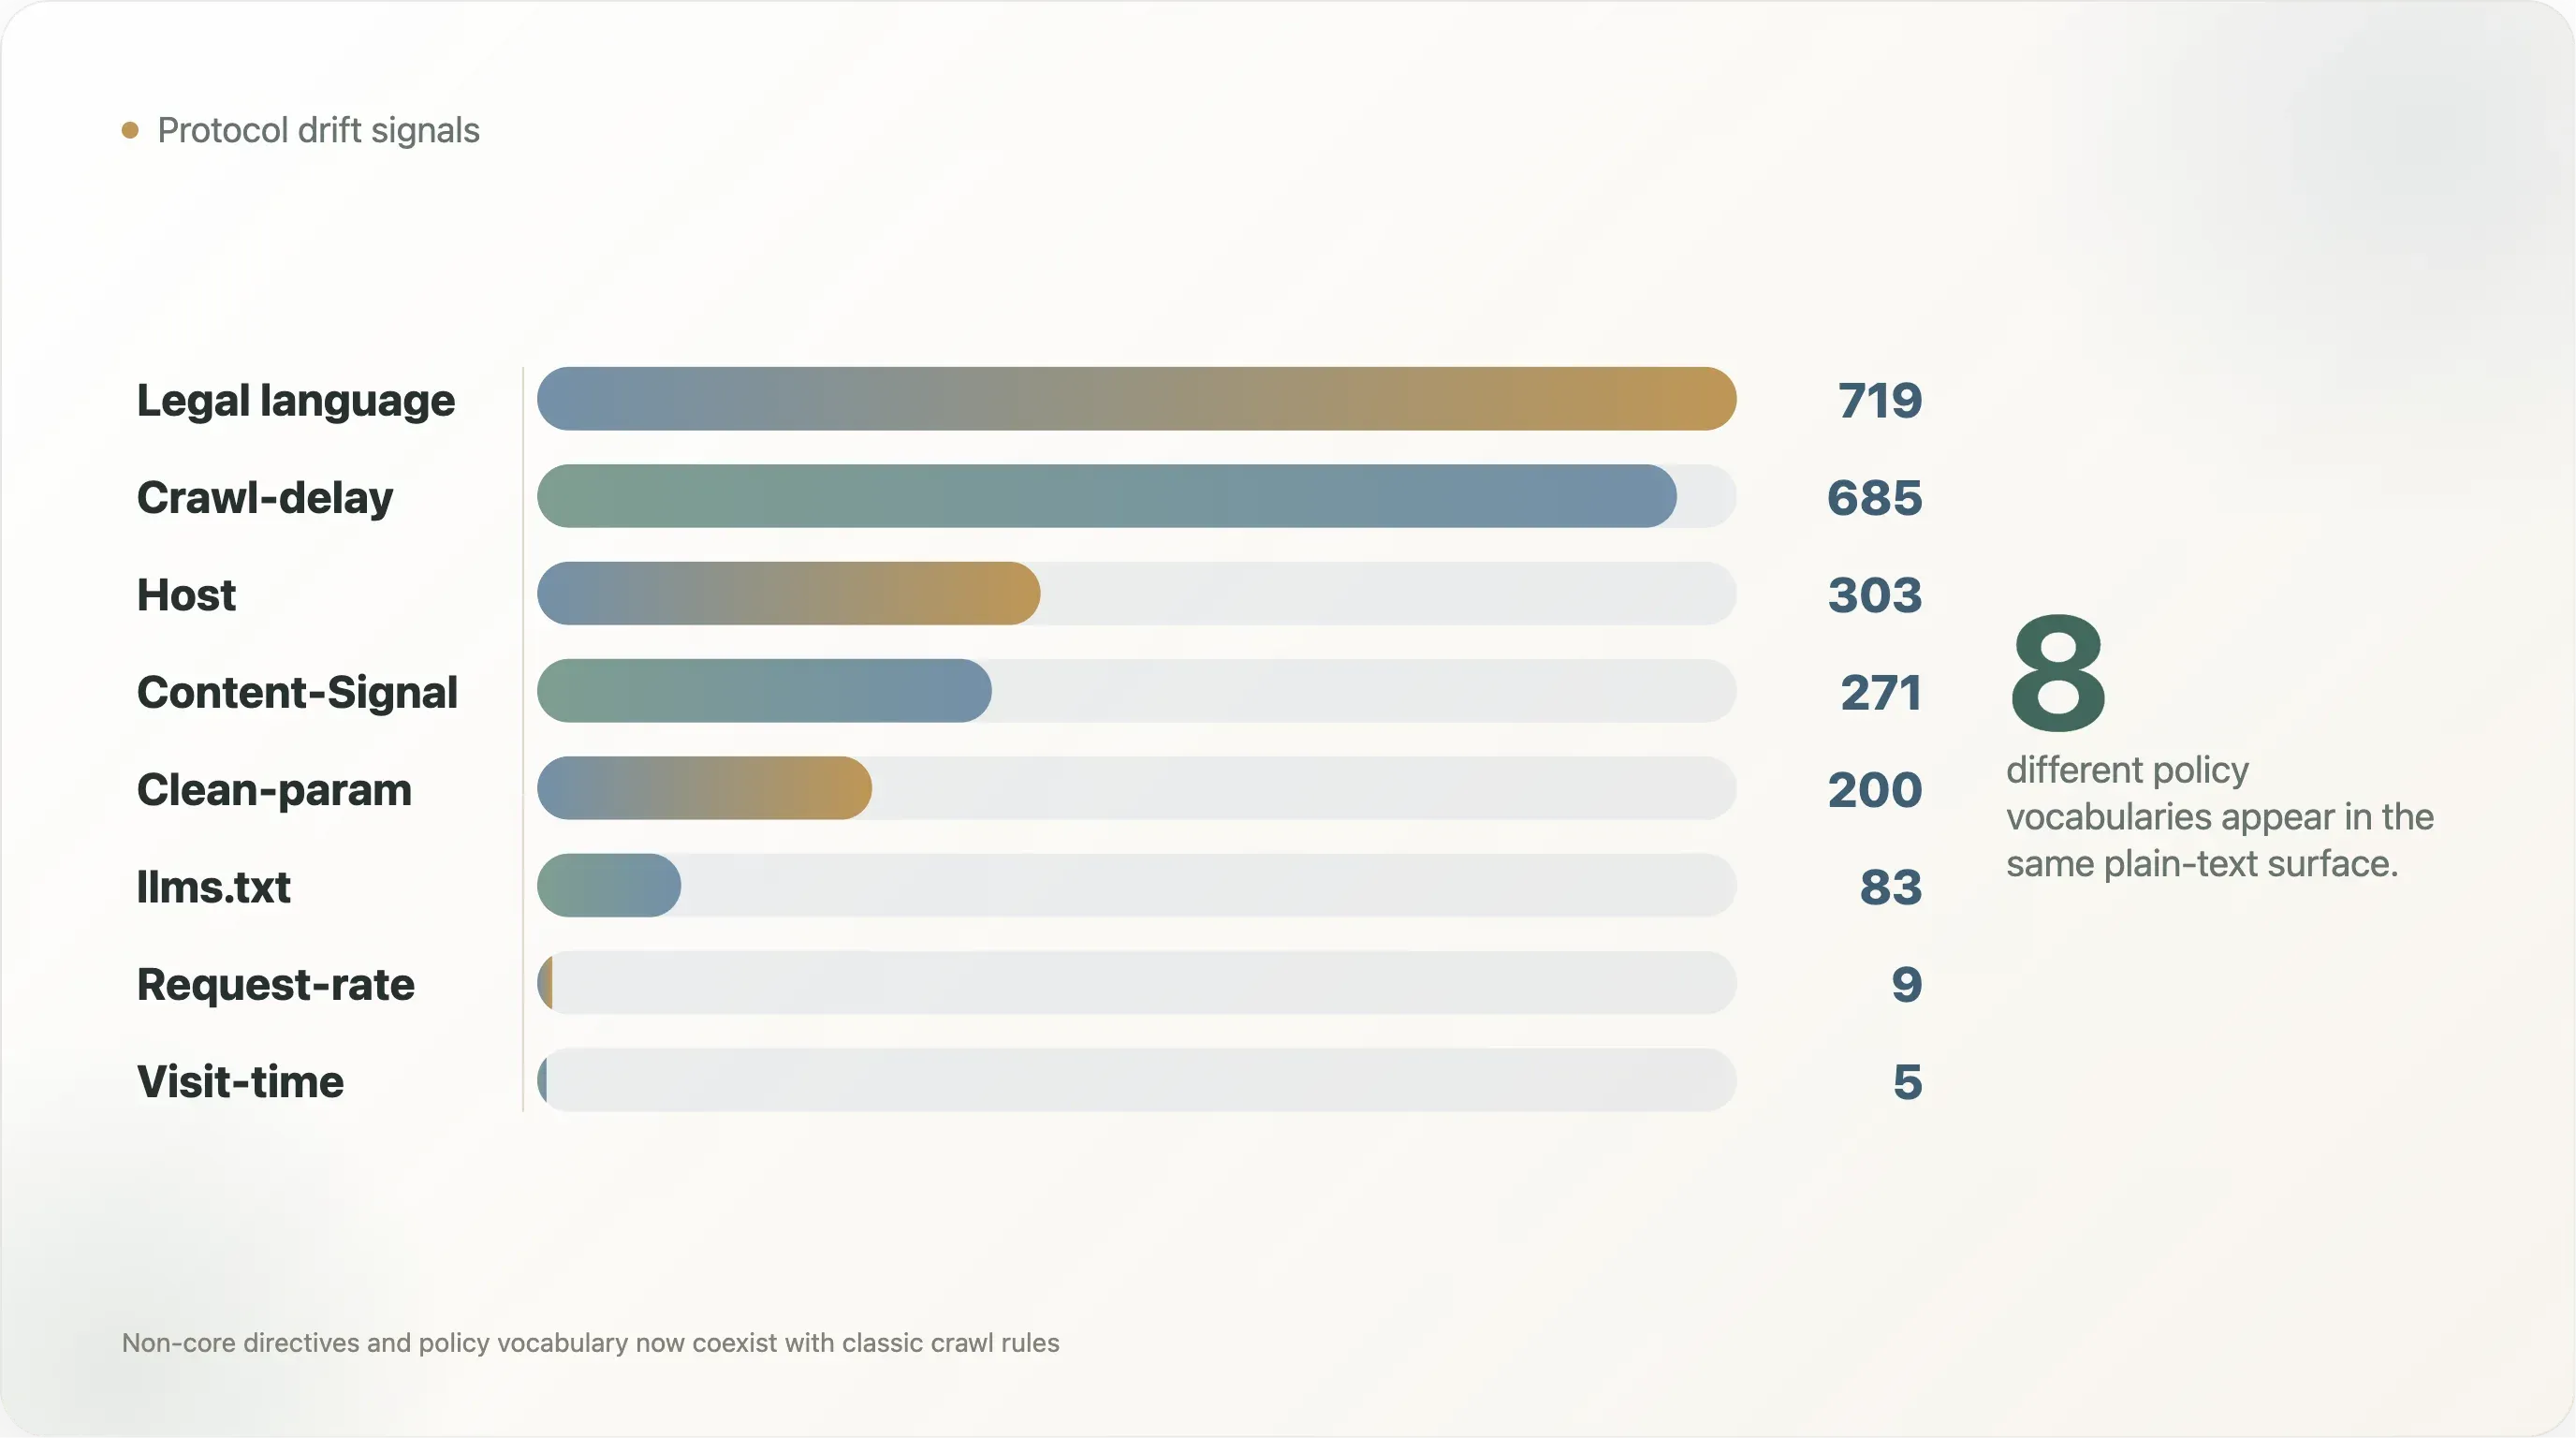
Protokollglidning är inte teoretisk. Bland de 6 638 läsbara filerna innehåller 685
Crawl-delay, 303 innehållerHost, 200 innehållerClean-param, 9 innehållerRequest-rate, 5 innehållerVisit-timeoch 271 innehåller Cloudflare-liknandeContent-Signal-språk. Det är inte allt delar av samma rena standard. Det är ackumulerad crawlerfolklore. -
Googlebot behandlas som en särskild medborgare. 562 analyserbara domäner blockerar minst en traditionell sökrobot. I 404 av dessa fall tillåts Googlebot medan minst en annan sökrobot blockeras. Diskriminering av AI-crawlare uppstod inte i ett neutralt ekosystem;
robots.txtkodade redan in en hierarki mellan sökmotorer. -
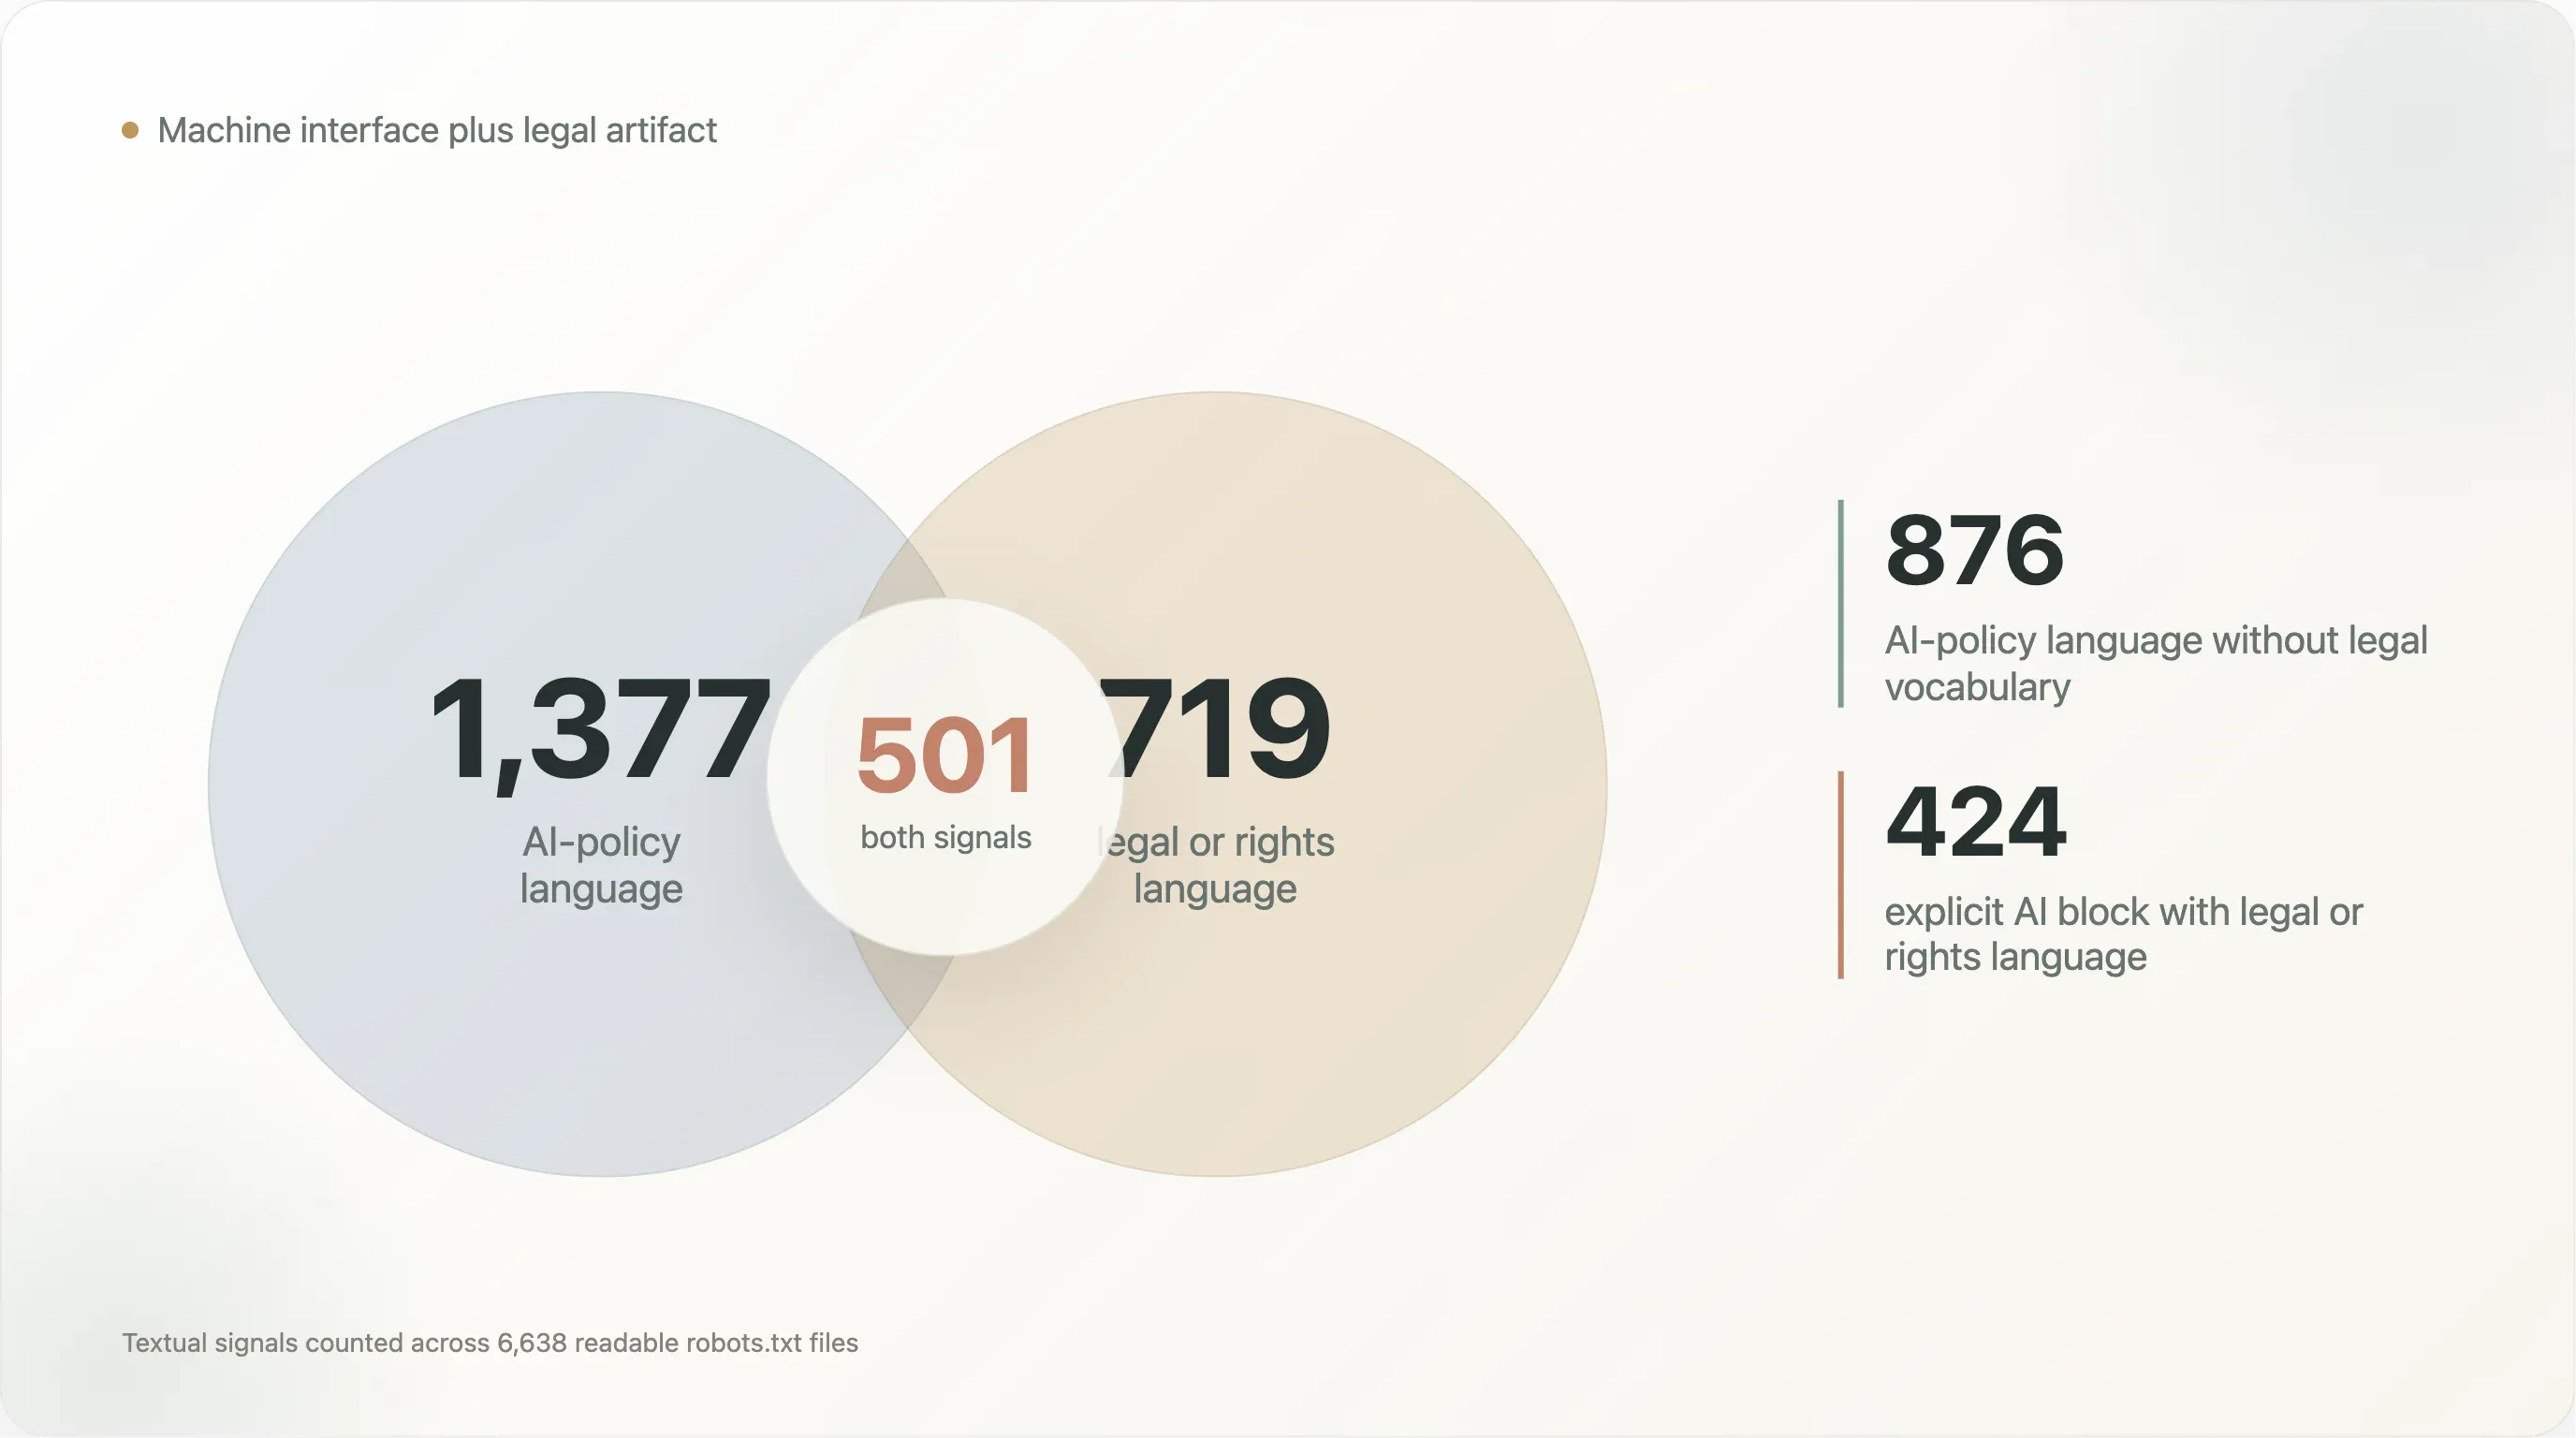
AI-policyn gör skulden mer synlig. 1 377 läsbara filer innehåller AI-policy-språk; 719 innehåller upphovsrätts-, villkors-, licens- eller tillståndsspråk; och 501 innehåller båda. Filen har blivit både maskinellt gränssnitt och juridiskt artefakt. Det är användbart, men skört.
-
De mest riskfyllda filerna är inte alltid de mest anti-AI-filerna. E-handel, resor, sociala plattformar, finans, akademi och nyheter producerar komplexa filer av olika skäl: kontroll av crawlbudget, äldre sökvägar, användargenererat innehåll, rättighetsreservationer och botspecifika undantag. AI-regler läggs nu ovanpå en redan rörig grund.
Huvudslutsatsen: robots.txt är fortfarande webben mest betydelsefulla offentliga yta för crawlerpolicy, men den är en svag grund för AI-styrning med höga insatser om inte ekosystemet standardiserar crawleridentitet, vokabulär för AI-användning och möjligheten att granska policyn.
Metod
Den här rapporten återanvänder datamängden från Thunderbits ursprungliga analys av AI-crawlerpolicy på domänerna i Tranco Top 10 000.
Inmatningsmaterialet var:
tranco_top10k.csv— den ursprungliga domänlistan för Tranco Top 10K.out/fetch_meta.csv— hämtningsstatus, byteantal, schema, omdirigeringsutfall och felmetadata.out/sites.csv— domän, rank, kategori, språk och status förrobots.txt.out/site_meta.csv— en analytisk rad per sajt, inklusive mallklass, flaggor för AI-blockering, filstorlek och sammanfattningsfält för botpolicy.out/bot_status.csv— en rad per domän och crawler, inklusive om boten blockeras och om en specifik regel finns.raw_robots/— cachaderobots.txt-innehåll för de 6 638 sajter som returnerade status200.
För den här uppföljningen granskades varje läsbar robots.txt-fil efter:
- filstorlek och antal rader;
- aktiva rader som inte är kommentarer;
- antal direktiv för
User-agent,Disallow,AllowochSitemap; - äldre eller icke-kärndirektiv som
Crawl-delay,Host,Clean-param,Request-rateochVisit-time; - AI-era-vokabulär inklusive
Content-Signal,llms.txt, AI, LLM, machine learning, TDM och2019/790; - juridisk vokabulär som upphovsrätt, användarvillkor, licens, tillstånd och språk om rättighetsreservation;
- behandling av sökrobotar för Googlebot, Bingbot, DuckDuckBot, Slurp, Baiduspider och YandexBot.
Rapporten definierar också en enkel konfigurationsskulds-poäng för prioritering. Den kombinerar filstorlek, antal user-agents, antal Disallow, antal Allow, antal icke-standarddirektiv samt blandningen av AI-policy- och juridiskt språk. Poängen är inte tänkt som ett universellt mått på korrekthet. Den är ett sätt att identifiera filer som sannolikt blir svåra att underhålla, granska eller resonera kring.
Alla härledda tabeller och diagram ingår i leveransmappen.
Resultat 1: Medianfilen är enkel; svansen är det inte
Den typiska robots.txt-filen på webben är fortfarande liten.
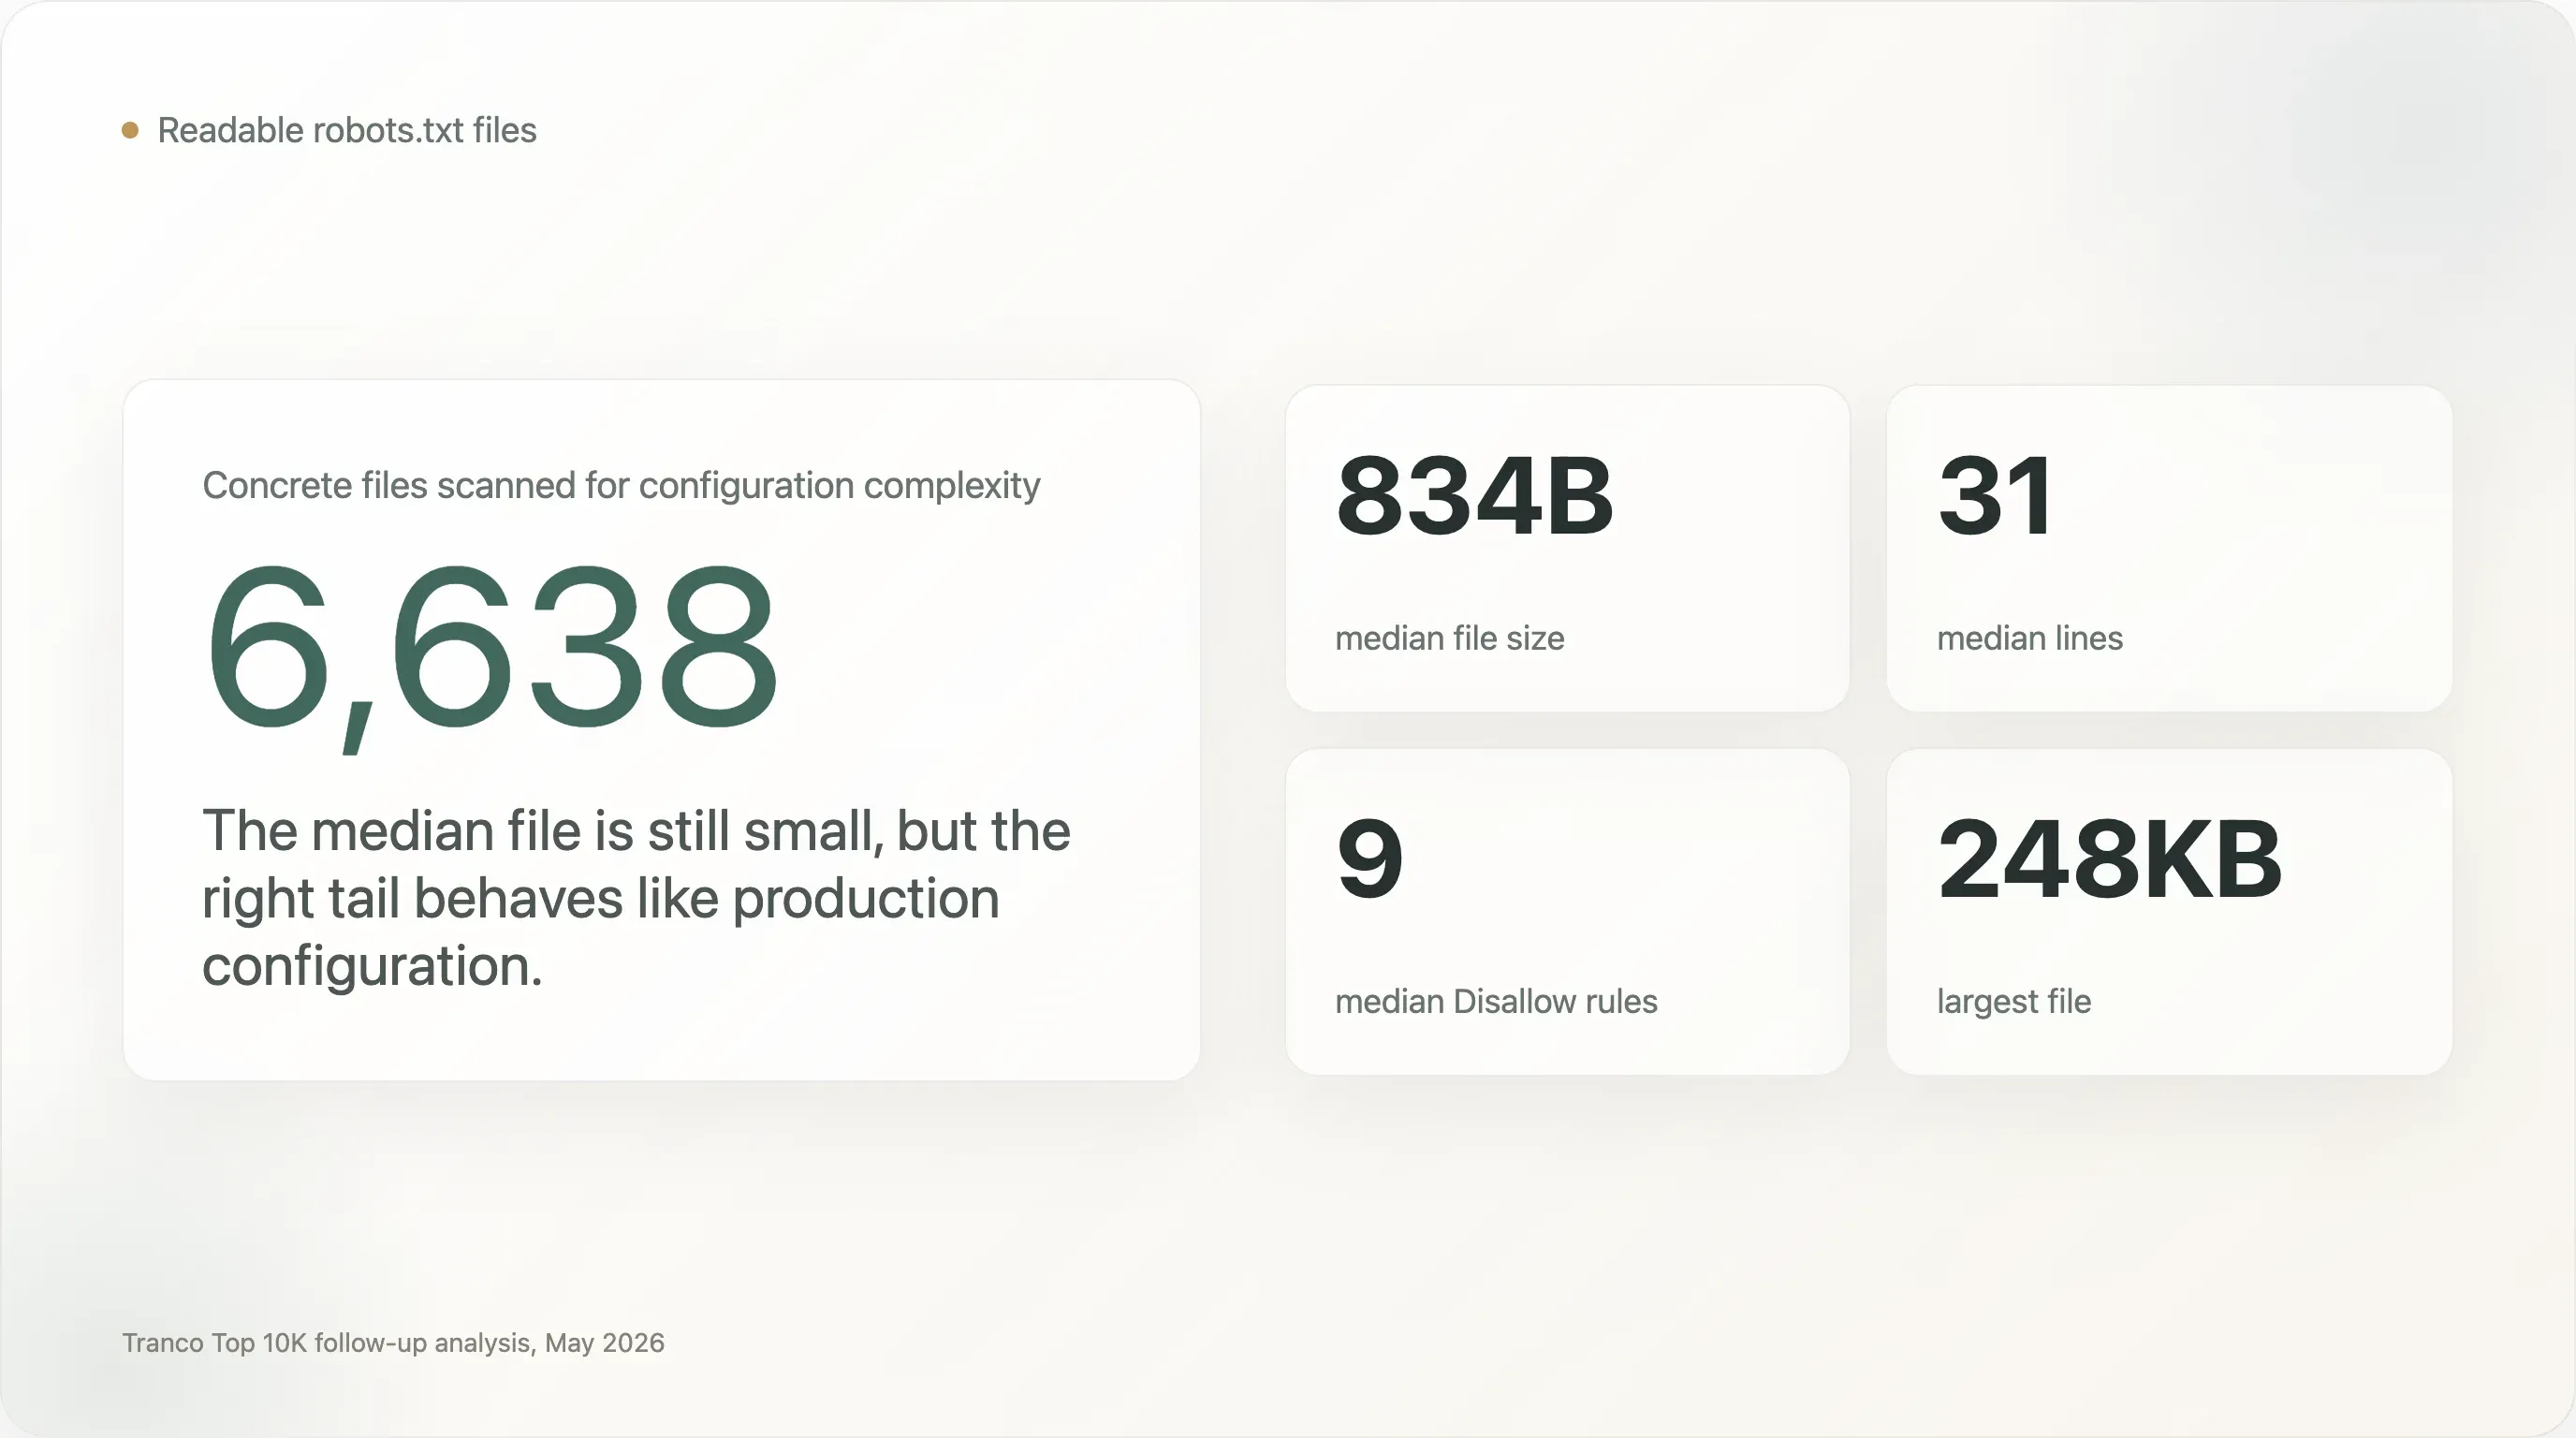
Bland de 6 638 läsbara filerna:
| Mått | Median | P90 | P95 | P99 | Max |
|---|---|---|---|---|---|
| Filstorlek | 834 byte | 6,7 KB | 15,8 KB | 76,0 KB | 248,3 KB |
| Rader | 31 | 238 | 332 | 1 008 | 4 998 |
| Aktiva rader | 23 | 198 | 282 | 837 | 4 998 |
User-agent-direktiv | 1 | 21 | 39 | 137 | 823 |
Disallow-direktiv | 9 | 103 | 176 | 422 | 4 997 |
Allow-direktiv | 1 | 17 | 33 | 69 | 890 |
Den här fördelningen spelar roll eftersom robots.txt ofta beskrivs som om den vore en kort deklaration:
User-agent: *
Disallow: /private/
Den mentala modellen stämmer inte för en betydande minoritet av webben med hög trafik.
I den här datamängden:
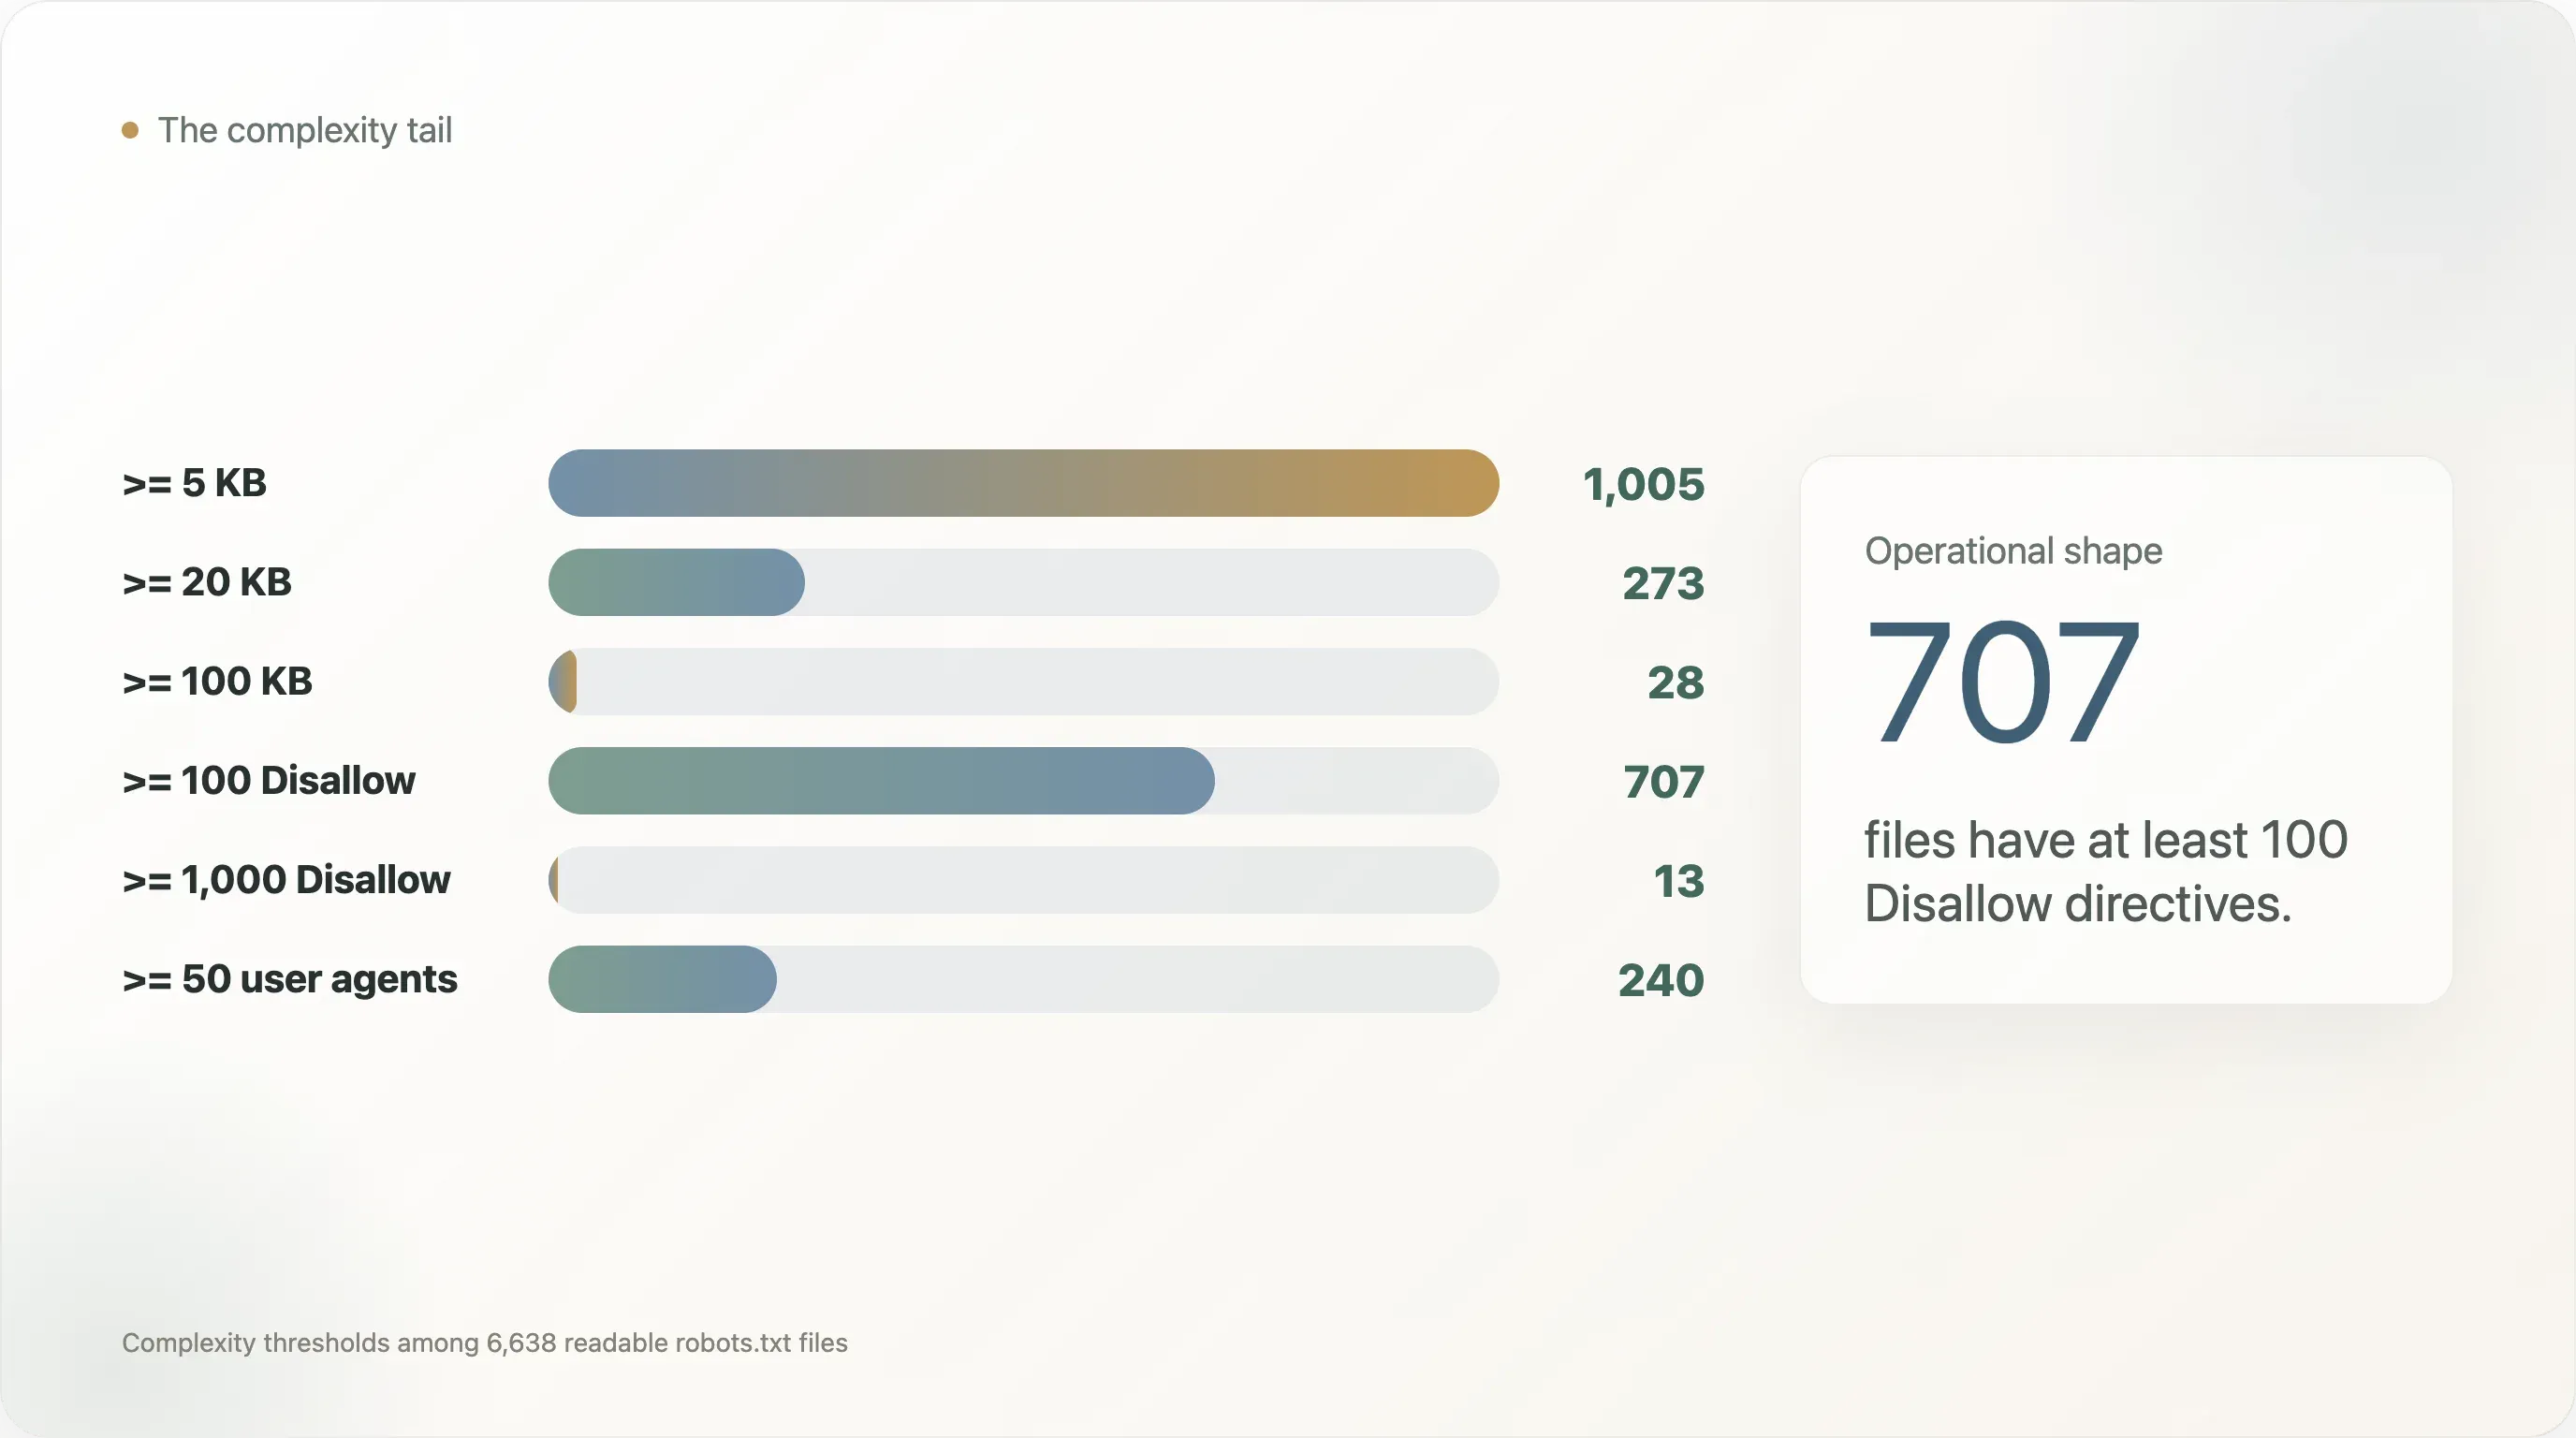
| Komplexitetströskel | Sajter |
|---|---|
robots.txt större än eller lika med 5 KB | 1 005 |
| Större än eller lika med 20 KB | 273 |
| Större än eller lika med 100 KB | 28 |
Minst 50 User-agent-direktiv | 240 |
Minst 100 User-agent-direktiv | 110 |
Minst 100 Disallow-direktiv | 707 |
Minst 1 000 Disallow-direktiv | 13 |
Minst 100 Allow-direktiv | 40 |
De största och mest komplexa filerna är inte akademiska kuriositeter. De tillhör verkliga, vältrafikerade tjänster:
| Domän | Rank | Kategori | Byte | User-agent | Disallow | Allow |
|---|---|---|---|---|---|---|
linkedin.com | 17 | socialt | 114 341 | 76 | 4 184 | 281 |
runescape.com | 5 226 | okänd | 113 393 | 1 | 4 997 | 0 |
academia.edu | 832 | akademi | 57 384 | 63 | 2 044 | 227 |
etsy.com | 286 | e-handel | 51 320 | 3 | 1 621 | 120 |
thepaper.cn | 9 395 | nyheter | 56 867 | 1 | 1 496 | 0 |
opentable.com | 4 137 | okänd | 70 494 | 32 | 1 683 | 176 |
alfabank.ru | 2 625 | finans | 73 158 | 2 | 1 566 | 133 |
Dessa filer ligger närmare produktionsrutningstabeller än policyfloskler. De kodar år av produktlanseringar, äldre sökvägar, blockerade parametermönster, crawlerundantag, SEO-experiment, CDN-beslut och nu AI-crawlerregler.
Svansen handlar inte bara om AI. Av de 273 filer som är 20 KB eller större innehåller 131 AI-policyspråk och 142 gör det inte. Av de 707 filer som har minst 100 Disallow-direktiv innehåller bara 207 AI-policyspråk. Med andra ord skapade inte AI problemet med stora filer. Den kom efter år av vanlig webbd drift som redan hade fyllt filen med sökvägsregler, sitemap-referenser och crawlerundantag.
Det spelar roll eftersom underhållbarhet beror på form, inte bara avsikt. En liten fil med en tydlig AI-blockering kan vara enkel att granska. En 70 KB stor e-handels- eller resefil kan vara svår att granska även om den inte säger något om AI. Risken är inte att varje stor fil är fel. Risken är att den faktiska policyn blir för svår för de ansvariga att verifiera.
Den operativa risken är enkel: när robots.txt växer blir det svårare för en utgivare, plattformsingenjör, jurist eller SEO-ansvarig att svara på den grundläggande frågan: vad tillåter den här filen egentligen?
Den frågan är inte längre trivial. Enligt RFC-liknande parsering kan en crawler matcha en mer specifik user-agent-grupp i stället för User-agent: *; längre sökvägsmatchningar kan överskugga kortare; direktiven Allow och Disallow samspelar genom företräde; och generella blockera-allt-regler kan av misstag fånga nya crawlare som inte fanns när filen skrevs.
För en fil på 30 rader kan en människa resonera kring det. För en fil på 4 000 rader med dussintals namngivna bottar borde ingen behöva göra det.
Resultat 2: robots.txt bär på mer än crawlregler
Debatten om AI-crawlare gjorde robots.txt politiskt synlig, men den underliggande filen hade redan börjat samla på sig orelaterade uppgifter.
En modern robots.txt för en toppsajt kan innehålla:
- kontroller av crawler-sökvägar;
- upptäckt av sitemaps;
- sökmotor-specifika tillägg;
- antydningar om crawlhastighet;
- antydningar om kanonisk host;
- antydningar om rensning av URL-parametrar;
- policyvokabulär injicerad av CDN;
- text om upphovsrättsreservation;
- avståenden från AI-träning;
- juridiska kommentarer som människor kan läsa.
Datamängden visar detta lager-på-lager tydligt.
| Signal | Filer | Andel av läsbara filer |
|---|---|---|
Crawl-delay | 685 | 10,3% |
Host | 303 | 4,6% |
Clean-param | 200 | 3,0% |
Content-Signal | 271 | 4,1% |
Request-rate | 9 | 0,1% |
Visit-time | 5 | 0,1% |
omnämnande av llms.txt | 83 | 1,3% |
| Upphovsrätt, villkor, licens- eller tillståndsspråk | 719 | 10,8% |
| AI-policyspråk | 1 377 | 20,7% |
Vissa av dessa direktiv känns igen av specifika crawlare. Vissa är äldre konventioner. Vissa är leverantörsspecifika. Vissa är egentligen inte crawlerdirektiv alls, utan juridiskt eller produktrelaterat språk inbäddat i kommentarer.
Det är så protokollglidning ser ut.
Crawl-delay är ett bra exempel. Det är bekant för många sajtägare, men stödet är ojämnt bland stora crawlare. Host och Clean-param har historiskt förknippats med Yandex-beteende. Content-Signal ingår i Cloudflares policyvokabulär för AI-eran. llms.txt är ett föreslaget angränsande upptäcktsformat, inte en universellt respekterad standard. Ändå förekommer allt detta i samma typ av fil, ofta bredvid klassiska User-agent- och Disallow-regler.
Siffrorna visar också hur gamla och nya konventioner nu samexisterar. Crawl-delay förekommer i 685 filer, mer än dubbelt så många som de 271 filer som har Content-Signal. Host förekommer i 303 filer och Clean-param i 200, vilket huvudsakligen speglar äldre sökmotortraditioner. Trots mycket diskussion i AI-sökningskretsar nämns llms.txt i bara 83 läsbara filer. Webben håller inte på att enas kring ett vokabulär. Den staplar vokabulär.
Problemet är inte att något enskilt tillägg är fel. Problemet är att filen har blivit en oversionsstyrd behållare för flera överlappande styrsystem.
Det skapar tre sorters skuld:
- Semantisk skuld. Olika crawlare kan tolka samma fil olika.
- Ägarskuld. SEO-, juridik-, infrastruktur-, säkerhets- och produktteam kan alla ha skäl att redigera filen, men inget enskilt team äger kanske hela policyn.
- Revisionsskuld. En sajt kan publicera en policy som ser avsiktlig ut, medan bara en parser kan avgöra dess faktiska beteende.
AI gör detta viktigare eftersom insatserna har ändrats. När ett äldre tips om crawlhastighet ignoreras kan resultatet bli extra trafik. När ett avstående från AI-träning är tvetydigt kan resultatet bli bevis i en upphovsrätts- eller licenstvist.
Resultat 3: Filen har blivit både maskinellt gränssnitt och juridiskt artefakt
Den ursprungliga rapporten om AI-crawlare visade att 17,0 % av de analyserbara sajterna hade skrivit uttryckliga AI-specifika regler. Den här uppföljningen tittar på den textmässiga bördan som dessa policyer lägger till.
Bland de 6 638 läsbara robots.txt-filerna:
- 1 377 innehåller AI-policyspråk;
- 719 innehåller upphovsrätts-, villkors-, licens-, rättighets- eller tillståndsspråk;
- 271 innehåller
Content-Signal; - 83 nämner
llms.txt.
Överlappningen är där historien blir mer intressant:
| Textmönster | Filer |
|---|---|
| AI-policyspråk och juridiskt/rättighetsrelaterat språk | 501 |
| AI-policyspråk utan juridiskt/rättighetsrelaterat språk | 876 |
| Juridiskt/rättighetsrelaterat språk utan AI-policyspråk | 218 |
Content-Signal med juridiskt/rättighetsrelaterat språk | 242 |
| Uttrycklig AI-blockering med juridiskt/rättighetsrelaterat språk | 424 |
Det här är en ny sorts fil.
En traditionell robots.txt-fil riktar sig till crawlare. En robots.txt med juridisk förord är riktad till minst fyra målgrupper samtidigt:
- crawleroperatörer, som behöver maskinläsbara direktiv;
- sök- och AI-leverantörer, som behöver policiesignaler;
- jurister, som vill ha uttrycklig rättighetsreservation;
- framtida revisorer, domstolar eller journalister, som kan läsa kommentarerna som bevis på avsikt.
Den flermålgruppsdesignen förklarar varför vissa filer nu låter som policydokument. Men den försvagar också den rena uppdelningen mellan vad en crawler kan tolka och vad en mänsklig jurist vill deklarera.
De 876 filer med AI-policyspråk men utan juridisk vokabulär är mestadels maskinpolicyfiler: botnamn, Disallow-block och mallspråk. De 501 filer med både AI- och juridiskt språk är något annat. De försöker vara både crawlerinstruktioner och rättighetsreservationer på samma gång. De 218 filer med juridiskt språk men ingen AI-vokabulär visar att detta mönster inte började med LLM:er; robots.txt användes redan som plats för att ange villkor, gränser för tillstånd och rättighetsanspråk.
Till exempel kan en kommentar säga att machine learning är förbjudet, medan själva direktivblocket bara blockerar en delmängd av kända user-agents. En sajt kan hävda rättigheter globalt men bara nämna några få crawlare. En CDN-mall kan injicera AI-relaterad vokabulär i en fil vars operatör aldrig själv skrev det juridiska språket. En sajt kan skriva en bred User-agent: *-regel som oavsiktligt blockerar framtida crawlare.
Ur styrningsperspektiv har robots.txt blivit attraktiv just för att den är publik och maskinläsbar. Men ju mer policy den bär, desto mer spelar dess begränsningar roll:
- Det finns inget autentiseringslager som visar att en specifik policy granskades av rättighetsinnehavaren i stället för att ärvas från infrastrukturen.
- Det finns ingen inbyggd versionshistorik.
- Det finns inget strukturerat fält för avsedd användning, som träning, hämtning, sökindexering, sammanfattning, cachelagring eller modellevaluering.
- Det finns inget universellt register över AI-crawleridentiteter.
- Det finns ingen verkställighetsmekanism.
Det gör inte filen värdelös. Det gör den skör.
Den bättre tolkningen är att robots.txt håller på att bli ett notislager: en offentlig, inspekterbar deklaration av preferenser och avsikt. Den är inte i sig ett komplett rättighetshanteringssystem.
Resultat 4: Sök var redan ojämlik innan AI kom
Ett av de starkaste resultaten i den ursprungliga rapporten var att många publicister skiljer mellan AI-träningscrawlare och sökcrawlare. De blockerar CCBot, GPTBot eller Google-Extended men behåller synlighet i Google-sökning.
Den här uppföljningen lägger till en annan poäng: traditionella sökcrawlare behandlas inte heller lika.
Vi kontrollerade sex sökcrawlare:
- Googlebot;
- Bingbot;
- DuckDuckBot;
- Slurp;
- Baiduspider;
- YandexBot.
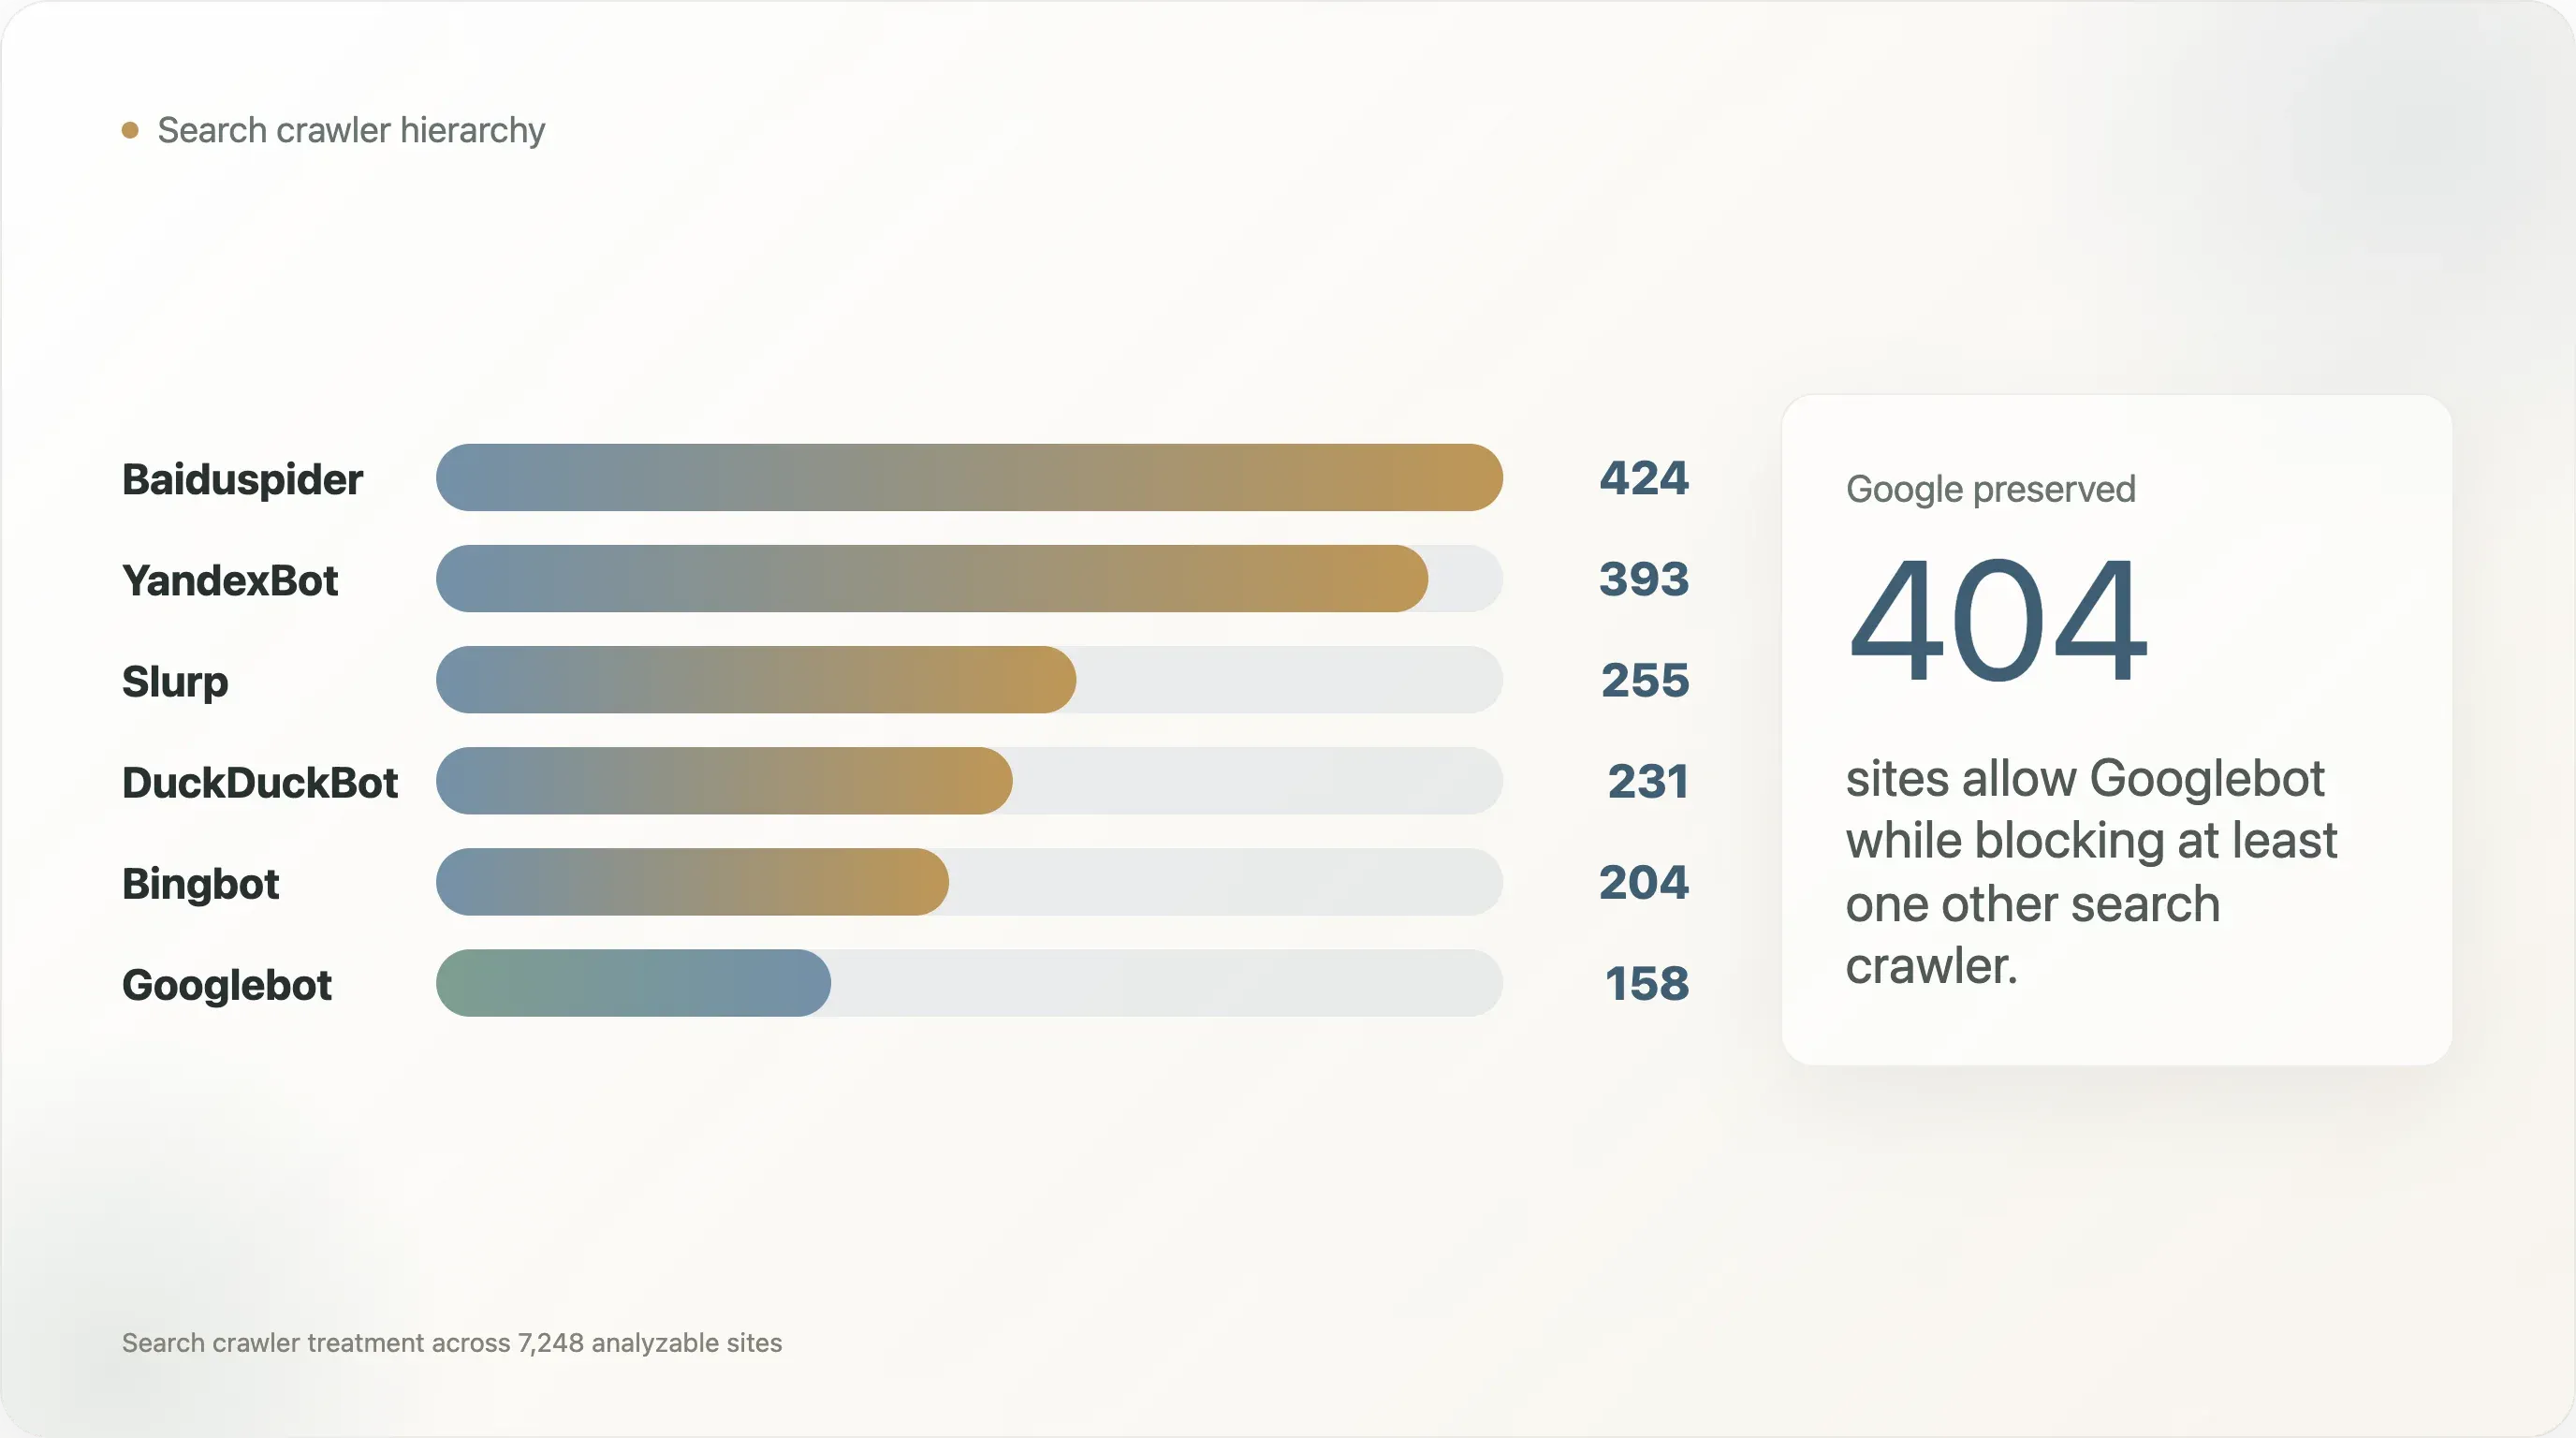
Bland de 7 248 analyserbara sajterna:
| Behandling av sökrobotar | Sajter |
|---|---|
| Blockerar minst en sökrobot | 562 |
| Tillåter Googlebot men blockerar minst en annan sökrobot | 404 |
| Blockerar alla sex granskade sökrobotar | 152 |
Antalet blockerade bottar är inte jämnt fördelat:
| Sökrobot | Sajter som blockerar den |
|---|---|
| Baiduspider | 424 |
| YandexBot | 393 |
| Slurp | 255 |
| DuckDuckBot | 231 |
| Bingbot | 204 |
| Googlebot | 158 |
Googlebot är den minst blockerade roboten i detta urval. Baiduspider och YandexBot blockeras betydligt oftare, och i de flesta av dessa fall är Googlebot fortfarande tillåten. Bland de 404 sajter som tillåter Googlebot samtidigt som de blockerar minst en annan sökrobot blockerar 269 Baiduspider och 240 blockerar YandexBot.
Exemplen är välkända:
| Domän | Blockerade sökrobotar medan Googlebot tillåts |
|---|---|
facebook.com | Baiduspider, YandexBot |
apple.com | Baiduspider |
twitter.com | DuckDuckBot, Slurp, Baiduspider, YandexBot |
netflix.com | DuckDuckBot, Slurp |
x.com | DuckDuckBot, Slurp, Baiduspider, YandexBot |
tiktok.com | Baiduspider |
baidu.com | Bingbot, DuckDuckBot, Slurp, YandexBot |
washingtonpost.com | YandexBot |
wsj.com | YandexBot |
bilibili.com | DuckDuckBot, Slurp, YandexBot |
temu.com | Slurp |
t-mobile.com | Baiduspider, YandexBot |
Detta spelar roll för AI-debatten eftersom det visar att robots.txt inte var ett neutralt protokoll för universell åtkomst ens innan LLM-crawlare dök upp. Den offentliga webben hade redan en hierarki:
- Googlebot bevaras ofta eftersom Google-söktrafik är för värdefull för att riskeras.
- Regionala eller konkurrerande crawlare är lättare att blockera.
- Vissa sajter behandlar sökrobotåtkomst som ett beslut per marknad eller leverantör.
AI-crawlare kom in i ett ekosystem där differentierad åtkomst redan var normalt.
Det gör policyförskjutningen lättare att förstå. En publicist som skriver "blockera Google-Extended, tillåt Googlebot" uppfinner inte en ny form av diskriminering. Den tillämpar ett gammalt mönster på en ny typ av crawler: bevara distribution, begränsa extraktion.
Den olösta frågan är om detta gamla mönster skalar. Med sök fanns bara ett fåtal ekonomiskt viktiga crawlare. Med AI är crawleridentiteten fragmenterad mellan modellleverantörer, hämtningsbottar, datamäklare, akademiska crawlare, syntetiska webbläsaragenter och hämtningsverktyg på infrastruktur-nivå. Antalet namngivna user agents kommer att fortsätta växa om inte ekosystemet konsolideras kring färre, syftesbaserade signaler.
Så byggs konfigurationsskuld på.
Resultat 5: Komplexitet varierar mellan sektorer, men inte på samma sätt som AI-blockeringsgrader gör
Den ursprungliga rapporten visade ett stort sektorspann i AI-blockering: nyheter blockerar i hög grad; telekom, myndigheter och SaaS blockerar i låg grad.
Konfigurationskomplexitet skär webben annorlunda.
Bland utvalda kategorier med tillräckligt många läsbara robots.txt-filer för meningsfull jämförelse:
| Kategori | n | Median byte | P90 byte | Median Disallow | P90 Disallow | Median User-agent | P90 User-agent |
|---|---|---|---|---|---|---|---|
| e-handel | 215 | 1 738 | 10 388 | 37 | 164 | 3 | 49 |
| resor | 63 | 2 074 | 27 368 | 41 | 779 | 5 | 34 |
| nyheter | 647 | 1 534 | 7 039 | 19 | 114 | 6 | 68 |
| finans | 121 | 1 002 | 8 337 | 17 | 132 | 2 | 23 |
| akademi | 253 | 839 | 3 959 | 14 | 75 | 1 | 11 |
| myndigheter | 151 | 1 227 | 3 263 | 13 | 46 | 1 | 4 |
| SaaS | 368 | 485 | 12 606 | 4 | 56 | 1 | 10 |
| utvecklarverktyg | 119 | 273 | 9 255 | 3 | 58 | 1 | 10 |
P90 Disallow by category chart here<<<<<<<<<<<<<<<<<<<<<<<<<
Nyheter är politiskt komplext eftersom det skriver uttryckliga AI-regler och juridisk text. Men e-handel och resor är operativt komplexa eftersom de har stora kataloger, facetterad navigering, sökresultatsidor, filter, kontovägar och parametriserade URL:er.
Den skillnaden är viktig.
Resor är det tydligaste exemplet. Det har bara 63 läsbara filer i denna kategoriblandning, men dess P90 robots.txt är 27,4 KB och dess P90 antal Disallow är 779, långt över nyheter. Det betyder inte att resesajter har en mer utvecklad AI-policy. Det betyder att resesajter har fler ytor som crawleroperatörer av misstag kan slösa budget på: datumsökningar, tillgänglighetssidor, sidnumrerade recensioner, bokningsflöden, filterkombinationer och lokaliserade lagervägar.
SaaS är motsatsen till den typen av överraskning. Medianfilen är bara 485 byte, men P90-filen hoppar till 12,6 KB. De flesta SaaS-sajter är öppna och lätta; en mindre andel bär långa filer för sökvägskontroll, ofta eftersom dokumentation, inloggningsytor, appvägar och marknadssidor ligger under samma domän.
Nyheter ligger mitt i operativt men nära toppen politiskt. Dess P90 antal User-agent är 68, högre än e-handel, resor, finans, akademi, myndigheter, SaaS och utvecklarverktyg i den här tabellen. Det är ett tecken på botspecifik policy, inte bara sökvägshygien.
En utgivares robots.txt kan vara komplex på grund av rättighetspolicy. En marknadsplats fil kan vara komplex på grund av hantering av crawlbudget. En universitets fil kan vara komplex eftersom tusentals äldre sökvägar har ackumulerats under en domän. En social plattforms fil kan vara komplex eftersom den måste exponera vissa ytor och dölja andra i enorm skala.
AI-policy läggs ovanpå allt detta. Den ersätter inte de redan existerande skälen till att en fil är komplex.
Det hjälper till att förklara varför AI-era-governance för robots.txt inte kan lösas med en universell blocklista. De underliggande filerna har olika jobb:
- e-handelssajter hanterar duplicerade sökvägar och lager-/sortimentsytor;
- resesajter hanterar listningar, kalendrar, recensioner och dynamiska söksidor;
- nyhetssajter hanterar upphovsrätt, arkiv och licenshållning;
- SaaS- och utvecklarverktygssajter vill ofta ha AI-synlighet;
- myndigheter behöver ofta offentlig åtkomst men kan ändå ha känsliga system som ska uteslutas;
- sociala plattformar hanterar användargenererat innehåll, profilsidor och frågor om missbruksskydd.
Samma AI-crawlerregel betyder olika saker i varje miljö.
Resultat 6: Ett index för konfigurationsskuld identifierar granskningsrisk, inte moraliskt misslyckande
Den här analysen skapade en enkel konfigurationsskulds-poäng för att identifiera robots.txt-filer som sannolikt är svåra att granska.
Poängen väger in:
- filstorlek;
- antal
User-agent-direktiv; - antal
Disallow-direktiv; - antal
Allow-direktiv; - antal icke-kärndirektiv;
- förekomst av AI-policyspråk;
- blandning av uttrycklig AI-blockering och juridiskt eller upphovsrättsligt språk.
Detta är inte en korrekthetspoäng. En fil med hög komplexitet kan vara helt avsiktlig. En fil med låg komplexitet kan ändå vara fel. Poängen är prioritering: om en fil är stor, policytung, botspecifik och full av undantag förtjänar den strängare granskningsdisciplin.
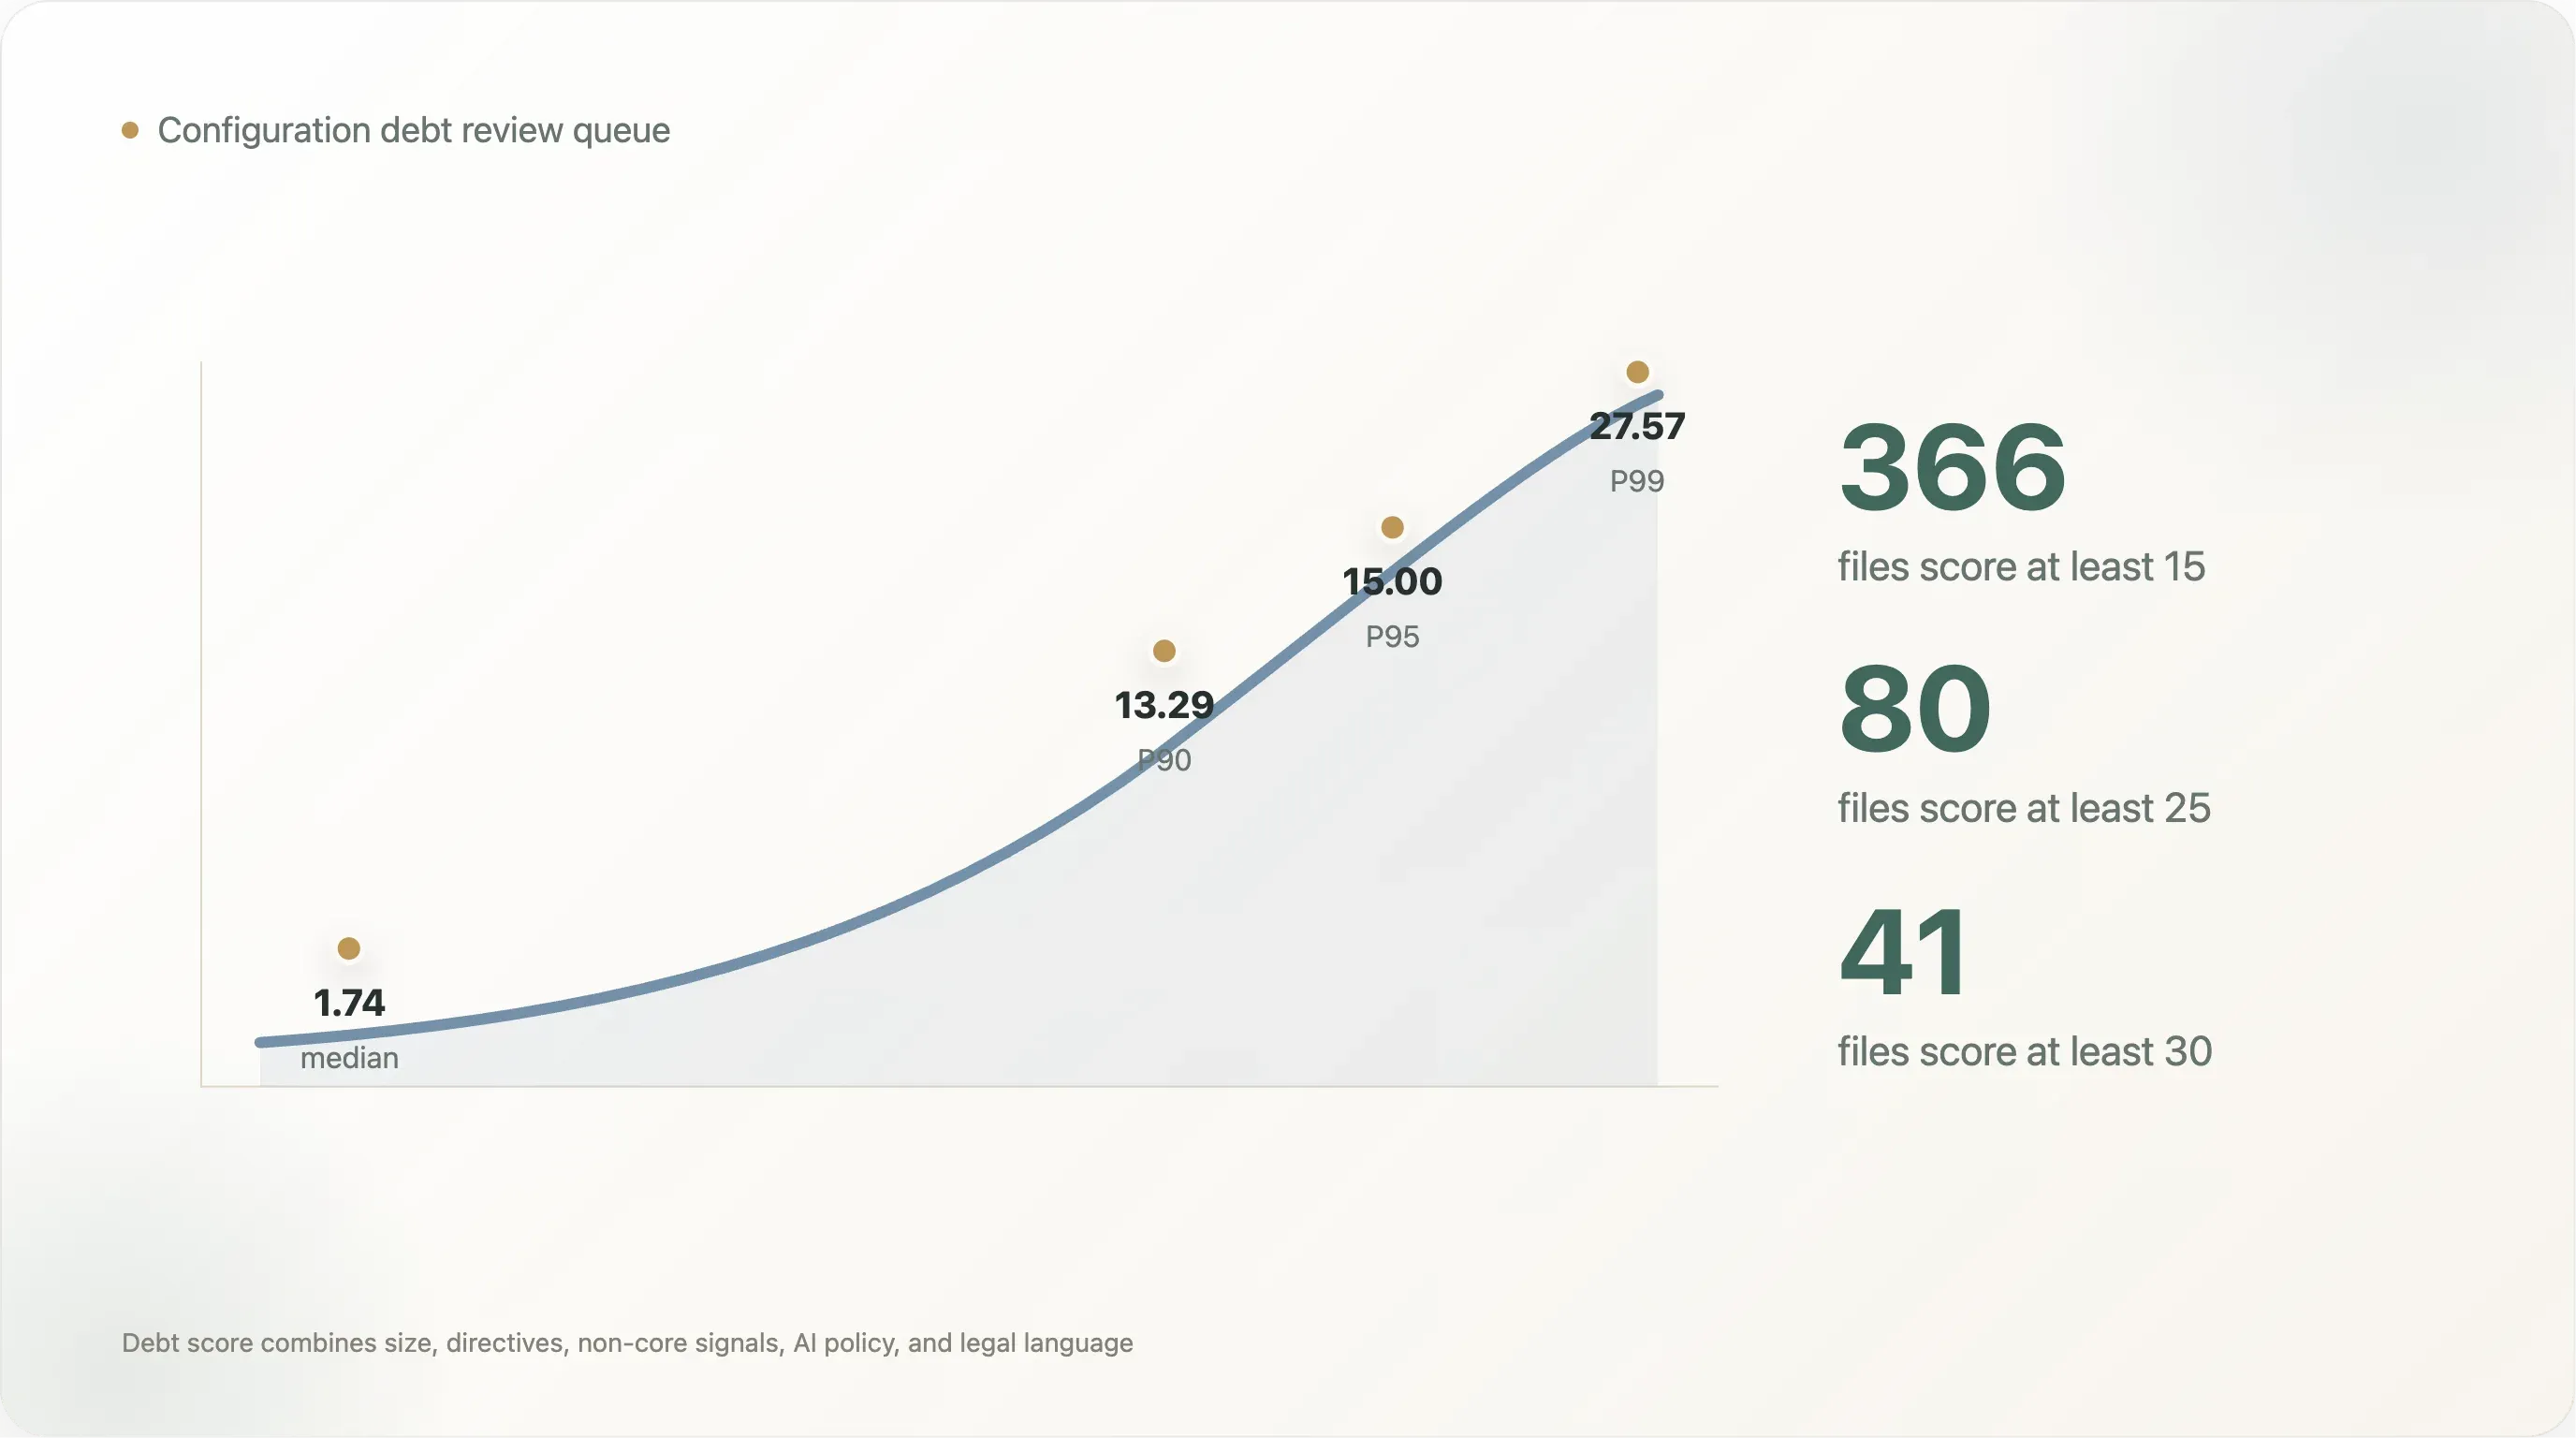
Poängfördelningen är brant. Medianfilen som kan läsas får 1,74. P90-poängen är 13,29, P95 är 15,00 och P99 är 27,57. Bara 366 filer får minst 15, 80 får minst 25 och 41 får minst 30. Det är den praktiska granskningskön: inte varje sajt behöver ett styrningsprojekt, men den övre svansen gör det.
Kategorivyn visar också varför en enda etikett för ”AI-blockerare” blir för platt:
| Kategori | Medianpoäng | P90-poäng |
|---|---|---|
| resor | 4,92 | 28,94 |
| sök | 2,97 | 24,23 |
| socialt | 2,25 | 15,00 |
| nyheter | 4,91 | 14,92 |
| finans | 1,67 | 12,61 |
| SaaS | 0,98 | 11,85 |
| e-handel | 3,88 | 10,87 |
| myndigheter | 1,57 | 6,38 |
Resor och sök har de högsta P90-poängen eftersom en minoritet av filerna blir mycket stora och regeltyngda. Nyheter har en av de högsta medianpoängen eftersom policyspråk och botspecifik behandling är vanligare i hela kategorin. E-handel har ett högt medianantal Disallow, men dess P90-skulds-poäng är lägre än resor eftersom komplexiteten är mer koncentrerad till sökvägsregler än till blandade policy-/juridiksignaler.
De högst poängsatta filerna i den här datamängden inkluderar:
| Domän | Varför den får högt värde |
|---|---|
linkedin.com | Mycket stor fil, tusentals sökvägsregler, många namngivna user agents, uttryckligt AI-policyspråk |
lnkd.in | Samma policyyta som LinkedIns kortlänksinfrastruktur |
fragrantica.com | Hundratals namngivna user-agent-block plus AI-policyspråk |
sovcombank.ru | Hundratals user-agent-block och juridiskt/policyrelaterat språk |
academia.edu | Stor matris av allow/disallow och uttrycklig AI-blockeringspolicy |
opentable.com | Stor uppsättning sökvägsregler, många sitemap-direktiv, AI-relaterad policyyta |
etsy.com | Stor fil för kontroll av e-handelssökvägar med mer än 1 600 Disallow-regler |
runescape.com | Nästan 5 000 Disallow-direktiv under en user-agent-grupp |
Dessa filer ska inte förlöjligas för att vara komplexa. Komplexitet speglar ofta verkliga affärsbehov. Men de visar varför robots.txt-policy förtjänar samma tekniska disciplin som annan produktionskonfiguration:
- ägarskap ska vara tydligt;
- ändringar ska granskas;
- genererade avsnitt ska märkas;
- juridiska kommentarer bör separeras från maskindirektiv där det är möjligt;
- testfall bör säkerställa förväntad botåtkomst för kritiska crawlare;
- versionshistorik bör bevaras;
- gamla botnamn bör fasas ut eller dokumenteras;
- AI-träning, AI-hämtning, sökindexering och arkivering bör behandlas som separata ändamål.
Den sista punkten är den viktigaste. Den nuvarande grammatiken utgår från user-agent: den ber sajtägare att namnge bottar. Behovet i AI-eran är syftesbaserat: det ber sajtägare att ange vilka användningar som är tillåtna.
Det är inte samma sak.
Den skillnaden är varför längre blocklistor inte kommer att åldras väl. En utgivare kan lägga till GPTBot, ClaudeBot, CCBot, Google-Extended, Bytespider, Applebot-Extended och PerplexityBot i dag, men nästa crawlernamn, hämtningsagent eller datamäklare kan dyka upp i morgon. En syftesbaserad policy skulle låta sajten säga ”sökindexering ja, AI-träning nej, användarinitierad hämtning kanske” utan att förvandla robots.txt till en adressbok över bottar.
Vad detta betyder för AI-styrning
Den offentliga debatten ramar ofta in robots.txt som antingen meningsfull eller föråldrad. Data pekar på ett mer praktiskt svar:
robots.txt är meningsfull, men överlastad.
Den är meningsfull eftersom stora sajter använder den, crawlare kan tolka den och policyval är synliga för forskare, journalister, leverantörer och domstolar. Den ursprungliga rapporten fann att 17,0 % av de analyserbara toppsajterna hade avsiktliga AI-specifika regler. Det är inte symboliskt brus.
Den är överlastad eftersom filen nu måste uttrycka mer än botåtkomst:
- ”Träna inte på detta innehåll.”
- ”Du får använda detta innehåll för sökindexering.”
- ”Du får använda detta innehåll för live-hämtning.”
- ”Du får inte skapa cachade datamängder.”
- ”Denna juridiska reservation gäller enligt EU:s lag om text- och datautvinning.”
- ”Den här CDN-hanterade sajten skickar
Content-Signal: ai-train=no.” - ”Den här sajten vill ha Googlebot men inte YandexBot.”
- ”Den här sajten har 1 000 äldre URL-sökvägar som inte bör crawlas.”
Grammatiken var inte designad för så många uppgifter.
Tre förändringar skulle minska skulden:
-
Crawleridentitet behöver ett register. Sajtägare ska inte behöva underhålla en ständigt växande lista med
GPTBot,ClaudeBot,anthropic-ai,CCBot,Google-Extended,Applebot-Extended,Bytespider,OAI-SearchBot,ChatGPT-Useroch många fler. Utan ett register kommer policyn alltid att släpa efter crawlerbeteendet. -
AI-användning behöver strukturerad vokabulär. Träning, hämtning, indexering, sammanfattning, återförsäljning av datamängder, modellevaluering och användarinitierad surfning är olika användningar. Att uttrycka dem genom leverantörsspecifika user-agent-namn är skört.
-
Policy behöver kunna granskas. Webben behöver ett sätt att skilja handskrivna rättighetsreservationer från ärvda CDN-standarder, genererade CMS-mallar, gamla legacregler och oavsiktliga blockera-allt-regler. Skillnaden spelar roll för förtroende och för rättstvister.
Inget av detta betyder att robots.txt ska ersättas över en natt. Den bättre vägen är lager-på-lager: behåll robots.txt som upptäckts- och kompatibilitetsyta, men standardisera angränsande maskinläsbar policy för AI-specifika användningar.
llms.txt är ett försök, men användningen i den här datamängden är fortfarande liten: bara 83 läsbara filer nämner det. Content-Signal är mer synligt eftersom Cloudflare kan distribuera det via infrastruktur, och alla de 271 Content-Signal-filerna i denna genomgång matchade också AI-policyspråk. Ändå är distribution inte samma sak som konsensus. En hållbar lösning behöver sannolikt den tråkiga standardiseringsmaskinen: tydliga fält, tydlig semantik, crawleråtaganden och offentliga testsviter.
Slutsats
Striden om AI-crawlare har gjort robots.txt till ett styrningsartefakt. Det är både nyttigt och riskabelt.
Nyttigt, eftersom filen är offentlig. Forskare kan granska den. Utgivare kan ändra den. Crawlare kan respektera den. Domstolar kan läsa den. Infrastrukturleverantörer kan distribuera den i stor skala.
Riskabelt, eftersom den bär för mycket.
Medianfilen robots.txt i Tranco Top 10K är fortfarande liten nog att förstå. Men den högtrafikerade webbens långsvans består av stora, gamla, lager-på-lager-byggda, leverantörsspecifika och juridiskt laddade filer. Hundratals sajter underhåller nu robots.txt-konfigurationer som bättre förstås som produktionspolitiska system än som enkla crawlerhintar.
Den centrala lärdomen är inte att robots.txt har misslyckats. Det är att webben har gett den en upphöjd roll utan att omstrukturera den.
Om AI-åtkomstpolicy ska bero på offentliga, maskinläsbara deklarationer är nästa steg inte ännu en längre blocklista. Det är bättre policyinfrastruktur: syftesbaserade tillstånd, stabil crawleridentitet, granskningsbara mallar och revisionsspår.
Tills dess kommer webben offentliga AI-styrningslager att fortsätta vila på en textfil som aldrig var tänkt att bära så här mycket vikt.
Anteckningar om reproducerbarhet
Leveransmappen innehåller:
source_data/analysis.json— ursprungliga aggregerade mätvärden.source_data/site_meta.csv— ursprunglig analytisk tabell per sajt.source_data/bot_status.csv— ursprunglig tabell över policy per domän och bot.source_data/fetch_meta.csv— ursprunglig metadata för hämtning.source_data/sites.csv— ursprunglig tabell över domän/kategori/status.derived_data/robots_complexity_by_site.csv— komplexitetsmått per sajt som genererats för denna rapport.derived_data/search_bot_treatment.csv— matris för behandling av sökrobotar.derived_data/category_complexity_summary.csv— sammanfattning av komplexitet på kategorinivå.derived_data/top_config_debt_sites.csv— toppsajter enligt prioriteringspoängen som beskrivs ovan.derived_data/summary_metrics.json— alla huvudmått som citeras i rapporten.
Ladda ner alla skript och datamängder
Rättelser i metodiken, problem i datamängden och uppföljande analyser är välkomna på support@thunderbit.com. Den här rapporten publiceras oberoende av Thunderbits eventuella kommersiella position; vi bygger en AI-driven webbskrapare, och vi har ett strukturellt intresse av att robots.txt fortsätter vara ett meningsfullt, maskinläsbart kontrakt på den öppna webben. Data i den här rapporten står för sig själv. — Thunderbits forskningsteam, maj 2026.
Testa Thunderbit för AI-webbskrapning Get Started Free



