De flesta köper residential proxies och blir ändå blockerade inom en vecka. IP:t var okej. Allt annat var fel.
Jag har ägnat mycket tid i proxyforum, i leverantörernas dashboards och i scraping-pipelines. Mönstret går igen: någon tecknar ett residential proxy-abonnemang, skickar iväg förfrågningar och blir stoppad nästan direkt. Man skyller på leverantören, byter till en annan — och får samma resultat. Problemet är nästan aldrig bara "dåliga IP-adresser". Det är allt runt omkring IP:t. Marknaden för residential proxies uppskattas nu till över 1,47 miljarder USD (2024) och väntas växa till 7,5 miljarder USD till 2035. Samtidigt visar Proxyways forskning från 2026 att över 50 nya proxyaktörer etablerades bara under 2025. Med så mycket brus är det lätt att känna sig överväldigad. Den här guiden går igenom helheten: hur du väljer leverantör, förstår prissättning, kommer igång praktiskt och — viktigast av allt — vilka lager av skydd som faktiskt håller dig under radarn.
Vad är residential proxies och varför spelar de roll?
En residential proxy skickar din trafik via en IP-adress från en vanlig internetleverantör för konsumenter — samma typ av IP som din router hemma använder. När en webbplats ser din förfrågan ser det ut som om den kommer från en vanlig person som surfar hemifrån, inte från ett serverrack i Virginia.
Så funkar det: en proxy-leverantör får tillgång till dessa IP-adresser via riktiga hushållsenheter — ofta genom opt-in-appar eller SDK:er där användare delar oanvänd bandbredd mot någon form av ersättning. Din begäran går från din dator till leverantörens gateway, vidare ut genom en av dessa residential IP:er, träffar målsidan och svaret kommer tillbaka samma väg.
Målgruppen är bred: alla som behöver smälta in i normal internettrafik. Säljteam som samlar in företagskataloger. Ecommerce-team som bevakar konkurrenters priser. Marknadsföringsteam som verifierar annonsplaceringar i specifika städer. Målet är alltid detsamma: se ut som en vanlig konsument, inte en bot.
En sak är viktig att förstå direkt: all insamling av residential IP:er är inte lika bra. Vissa leverantörer använder transparenta opt-in-program. Andra lutar sig mot inbäddade SDK:er, vilseledande samtycke eller värre. Googles Threat Intelligence Group slog i januari 2026 sönder det man trodde var ett av världens största residential proxy-botnät, och FBI publicerade samma år en varning om residential proxies om kriminellt missbruk av dessa nätverk. Etisk sourcing är inte bara en trevlig bonus — den påverkar drifttid, juridisk risk och om IP-adresserna redan är ”brända” innan du ens använder dem.
Varför residential proxies är viktiga: verkliga användningsfall för sälj-, ecommerce- och operations-team
Residential proxies är inte någon specialgrej för hackare — det är ett praktiskt verktyg för affärsteam som behöver korrekt, platsberoende webbinformation eller hantera flera konton utan att trigga korrelationslarm. Här är några exempel från riktiga arbetsflöden:
| Användningsfall | Varför residential proxies hjälper | Vem gynnas |
|---|---|---|
| Leadgenerering och kontaktinsamling | Kataloger och lokala listningar begränsar eller lokaliserar resultat efter IP. Residential IP:er låter dig se vad en lokal prospekt ser. | Sälj, BDR-team |
| Pris- och SKU-bevakning inom ecommerce | E-handelsplatser visar regionspecifika priser, lagerstatus och MAP-signaler. Residential IP:er efterliknar riktiga köpare. | Ecommerce-ops, prisanalytiker |
| Annonsverifiering och lokal SEO | För att verifiera annonsplaceringar eller lokala sökresultat måste du se exakt det en användare i den staden ser. | Marknadsföring, SEO-team |
| Hantering av flera konton | Stabil residential- eller ISP-session minskar risken för oavsiktliga IP-korrelationsflaggor över marknadsplats- eller sociala konton. | Kontohanterare (med hänsyn till ToS) |
| Marknadsanalys och konkurrensbevakning | Åtkomst till geobegränsat innehåll, granskning av lokaliserade konkurrenter eller storskalig insamling av offentlig data. | Strategi-, research-team |
Proxyways rapport från 2026 bekräftar att ecommerce fortfarande är det mest populära användningsområdet för proxies, samtidigt som AI-driven dataåtkomst växer snabbt. Webshares dokumentation om annonsverifiering visar hur proxies låter annonsörer efterlikna användares platser för att kontrollera leverans och upptäcka bedrägerier.
En viktig notis om hantering av flera konton: många plattformar förbjuder uttryckligen samordnade konton eller att dölja identitet. Om du hanterar legitima regionala konton måste du följa plattformens regler. Proxies gör inte förbjudet beteende okej.
Residential proxies jämfört med datacenter, mobile och VPN: förstå skillnaderna
Residential proxies är inte alltid rätt verktyg. De kostar mer och är långsammare än datacenter proxies, så det sparar både tid och pengar att förstå kompromisserna innan du köper.
| Proxytyp | IP-källa | Risk för upptäckt | Typisk kostnad (2026) | Bäst för |
|---|---|---|---|---|
| Residential | Konsument-ISP, P2P/SDK-pooler | Lägre på skyddade sajter | 3–15 USD/GB | Ecommerce-bevakning, geo-kontroller, offentlig scraping |
| Datacenter | Moln- och hostingleverantörer | Högre på skyddade sajter | Från ca 0,5 USD/IP | Hög volym, låg risk, intern testning |
| Mobile | Mobilnät (carrier-grade NAT) | Mycket låg | Högre än residential | App-testning, mobilspecifikt innehåll, hårda mål |
| VPN | Centraliserade VPN-servrar | Hög för automation (kända IP-intervall) | Låg månadskostnad för konsument | Integritet, manuell surfning, enkel regionsväxling |
Grundregeln är enkel: om målsidan aktivt blockerar datacentertrafik och du behöver framstå som en riktig användare på en viss plats, är residential proxies rätt val. Är hastighet och pris viktigare än att smälta in? Då räcker datacenter proxies gott. Mobile proxies är en sista utväg för extremt hårda mål, och VPN handlar om integritet — inte skala.
Så väljer du en leverantör av residential proxies: det som faktiskt spelar roll
De flesta ”topp 10 proxy”-artiklar rankar leverantörer efter funktioner som ingen faktiskt bryr sig om. Forumanvändare säger något annat — de bryr sig om IP-färskhet, om man kan testa innan man binder sig, hur exakt geo-targetingen är och om IP:erna verkligen är residential.
Förtroendefrågan är verklig: vissa leverantörer paketerar om datacenter-IP:er som residential. Innan du lägger pengar, verifiera poolens sammansättning med verktyg som PixelScan, BrowserLeaks eller IPinfo.
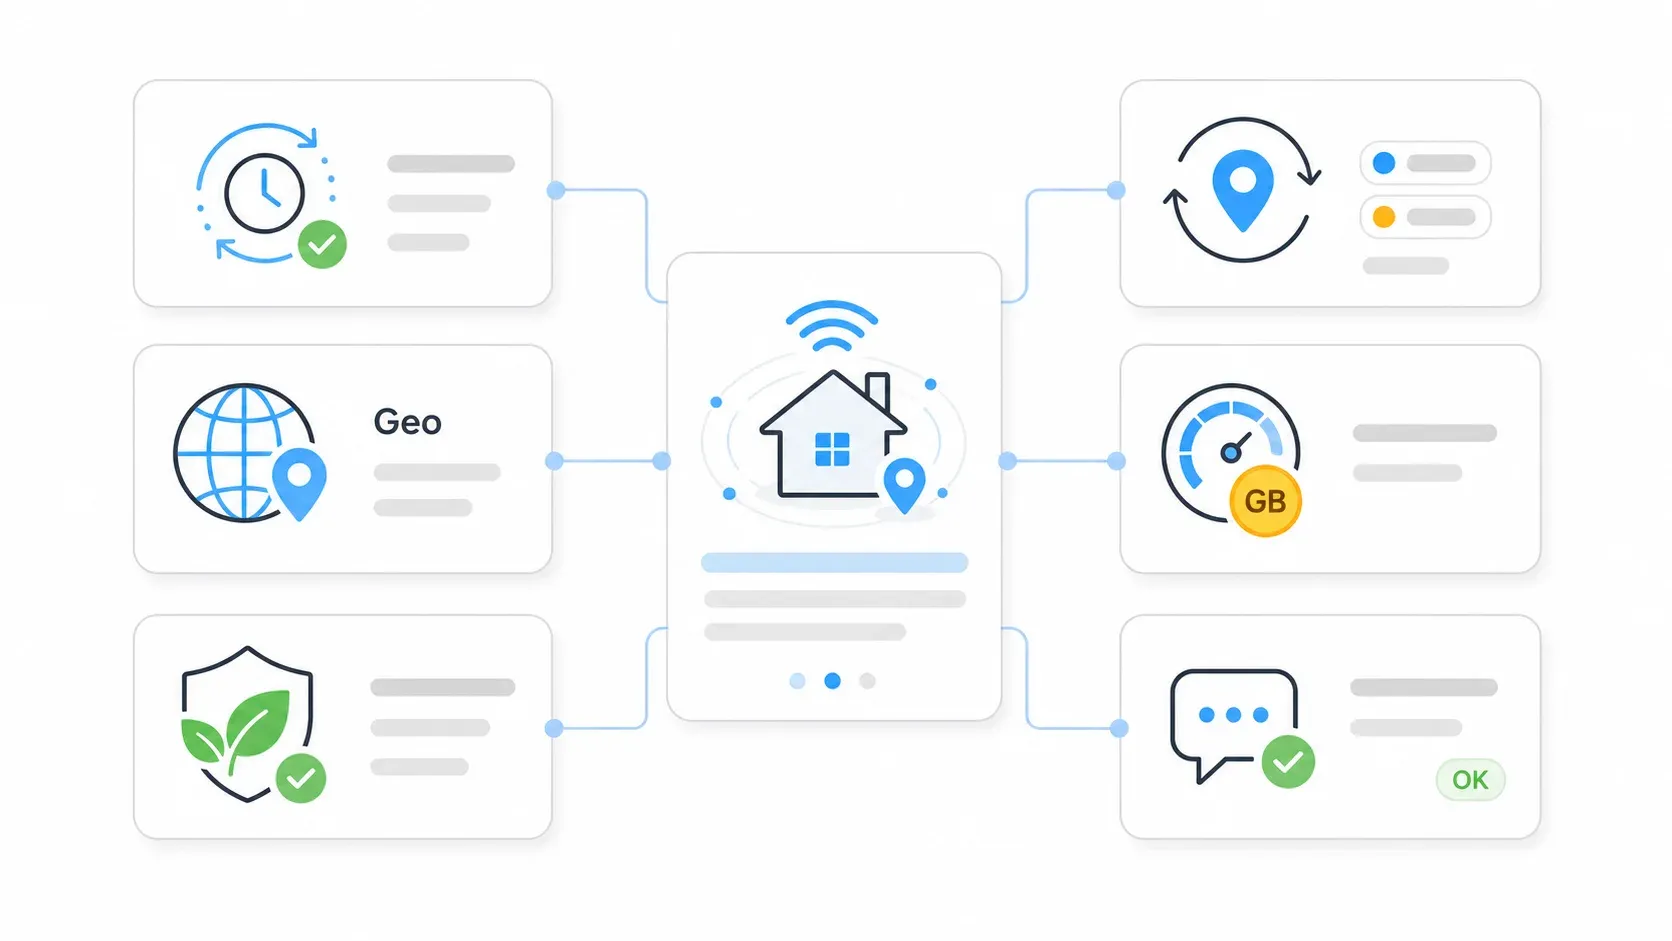
Här är utvärderingsramverket som faktiskt spelar roll:
| Kriterium | Varför det spelar roll | Så verifierar du |
|---|---|---|
| IP-poolens storlek och färskhet | Överanvända IP-adresser flaggas snabbt. Stora annonserade pooler kan innehålla inaktiva eller dubbla IP:er. | Kör ett mindre pilottest; logga unika IP:er, ASN-diversitet, dubblettfrekvens och blockfrekvens. Proxyways studie av verklig poolstorlek jämför faktiskt mot annonserat. |
| Subnet- och ASN-diversitet | För många IP:er från samma ASN ser onaturligt ut. | Kontrollera IP:er med IPinfo, MaxMind eller BrowserLeaks. |
| Noggrannhet i geo-targeting | Nivån ”land” räcker inte för lokal SEO eller annonsverifiering. Du behöver stad- eller postnummernivå. | Testa land, region, stad och postnummer innan du köper ett abonnemang. Jämför vad målsidan faktiskt visar. |
| Etisk IP-sourcing | Otydlig sourcing skapar juridisk, säkerhetsmässig och driftmässig risk. | Leta efter samtyckesformuleringar, transparensrapporter, KYC-/missbruksregler och opt-out-möjligheter. |
| Flexibilitet i sessionskontroll | Olika uppgifter kräver roterande eller stickiga sessioner. | Bekräfta att båda sessionstyperna finns; testa begränsningar i sessionstid. |
| Support och dokumentationskvalitet | Nybörjare fastnar ofta i auth, portar och sessionssyntax. | Läs snabbstartsguiden och ställ en supportfråga innan du köper. Mät svarstiden. |
| Faktureringsmodell | Per GB, per IP, per request och PAYG förändrar den verkliga kostnaden kraftigt. | Estimera bandbredd med realistiska sidstorlekar och retries innan du väljer plan. |
Som referens är här aktuella påståenden om leverantörernas poolstorlek (betrakta dem som marknadsföring, inte granskade siffror):
- Bright Data: påstår 400M+ månatliga residential IP:er i 195 länder
- Oxylabs: påstår 175M+ residential IP:er
- Decodo (Smartproxy): påstår 115M+ IP:er med city-/postnummer-targeting
- NetNut: påstår 85M+ residential IP:er i 195+ länder
Så fungerar prissättning för residential proxies: per GB, per IP, per request och PAYG
Det är här de flesta artiklar faller platt: de listar priser men förklarar aldrig hur faktureringsmodellerna fungerar, så du kan inte uppskatta din verkliga kostnad.
| Modell | Så fungerar det | Bäst för | Tänk på |
|---|---|---|---|
| Per GB | Du betalar för överförd bandbredd | Tung scraping, mediaspäckade sidor | Kostnaderna skjuter i höjden med bilder, JS och retries |
| Per IP / per port | Fast avgift per IP-adress | Statisk residential / ISP-proxy, kontohantering | Begränsade rotationsmöjligheter |
| Per request | Fast pris per API-anrop | Scraping-API:er | Blir dyrt vid mycket hög volym |
| PAYG | Ingen bindning, betala efter användning | Testning, oförutsägbar volym | Högre enhetspris |
| Månadsabonnemang | Kvot av GB eller IP:er per månad | Förutsägbar användning i hög volym | Outnyttjad kvot = bortkastade pengar |
Ett konkret kostnadsexempel
Säg att du ska scrapa 10 000 produktsidor som i snitt är 500 KB styck. Det blir ungefär 5 GB bandbredd innan retries, bilder, scripts eller browser-overhead. Med 6 USD/GB blir grundkostnaden för proxyn cirka 35 USD. Men vid verklig scraping i webbläsare — där JavaScript, typsnitt, tracking-pixlar och retries staplas på varandra — kan faktisk bandbredd vara 3–5 gånger högre. Din uppskattning på 35 USD kan i praktiken bli 100–175 USD.
Aktuella prissignaler
| Leverantör | Offentligt pris för residential | Källa |
|---|---|---|
| Bright Data | Från ca 5,88 USD/GB (PAYG-kampanj ca 4 USD/GB) | Bright Data-prissättning |
| Oxylabs | 5 GB för 6 USD/GB, 20 GB för 5 USD/GB, 125 GB för 4 USD/GB | Oxylabs prissättning |
| Decodo | 3 GB för 3,75 USD/GB, 10 GB för 3,50 USD/GB, 25 GB för 3,25 USD/GB | Decodo prissättning |
| SOAX | 25 GB för 3,60 USD/GB, 50 GB för 3,40 USD/GB, 800 GB för 2 USD/GB | SOAX prissättning |
Dolda kostnader som ingen nämner
- Misslyckade förfrågningar förbrukar fortfarande bandbredd. En CAPTCHA-sida eller block-sida är fortfarande data du betalar för.
- DNS-uppslag och SSL-handshake lägger till cirka 1–3 KB per request. I stor skala blir det mycket.
- Webbläsar-rendering laddar ner bilder, typsnitt, scripts och tracking-pixlar du troligen inte behöver.
- Minsta insättningar och utgående krediter kan göra lågvolymplaner dyrare än rubriken antyder.
- Retries och uppvärmningstrafik för inloggning, paginering och sessionsstart är inte gratis.
Sticky vs. roterande residential proxy-sessioner: ett beslutsstöd
Det vanligaste konfigurationsfelet jag ser: man använder roterande sessioner för uppgifter som kräver kontinuitet, eller sticky sessioner för uppgifter som kräver spridning.
| Faktor | Roterande sessioner | Sticky (statiska) sessioner |
|---|---|---|
| Bäst för | Oberoende förfrågningar: SERP-kontroller, prisuttag, bred övervakning | Sessionsberoende uppgifter: inloggning, checkout, paginering, kundvagnsflöden |
| IP-livslängd | Ny IP per request (eller kort intervall) | Samma IP i 10–60 minuter (beroende på leverantör) |
| Risk för upptäckt | Kan se stökigt ut om beteendet inte är sammanhängande | Kan samla rate limits om det överanvänds |
| Bandbreddskostnad | Fler retries möjliga om målsidan reagerar på rotation | Färre sessionsuppvärmningar, men blockerade sticky IP:er slösar tid |
Decodos dokumentation bekräftar att roterande sessioner kan byta IP vid varje ny request, medan sticky sessioner kan hålla samma IP i upp till 60 minuter.
Tumregel: Om uppgiften måste komma ihåg dig mellan requests (inloggning, kundvagn, paginering), använd sticky. Om varje request är fristående (SERP-kontroller, prisuttag), använd roterande.
I praktiken använder de flesta scraping-flöden roterande sessioner. Kontohantering och checkout-flöden behöver sticky. Många leverantörer erbjuder båda i samma plan — kontrollera det innan du köper.
Så sätter du upp residential proxies: steg-för-steg
Nästan ingen artikel på nätet går faktiskt igenom proxysetup steg för steg. Jag har konfigurerat proxies hos flera leverantörer, och processen är mer lik än olika — så här är den faktiska genomgången.
- Svårighetsgrad: Nybörjare
- Tidsåtgång: Cirka 15 minuter till första lyckade request
- Du behöver: Ett residential proxy-konto, en terminal eller webbläsare, och en mål-URL att testa
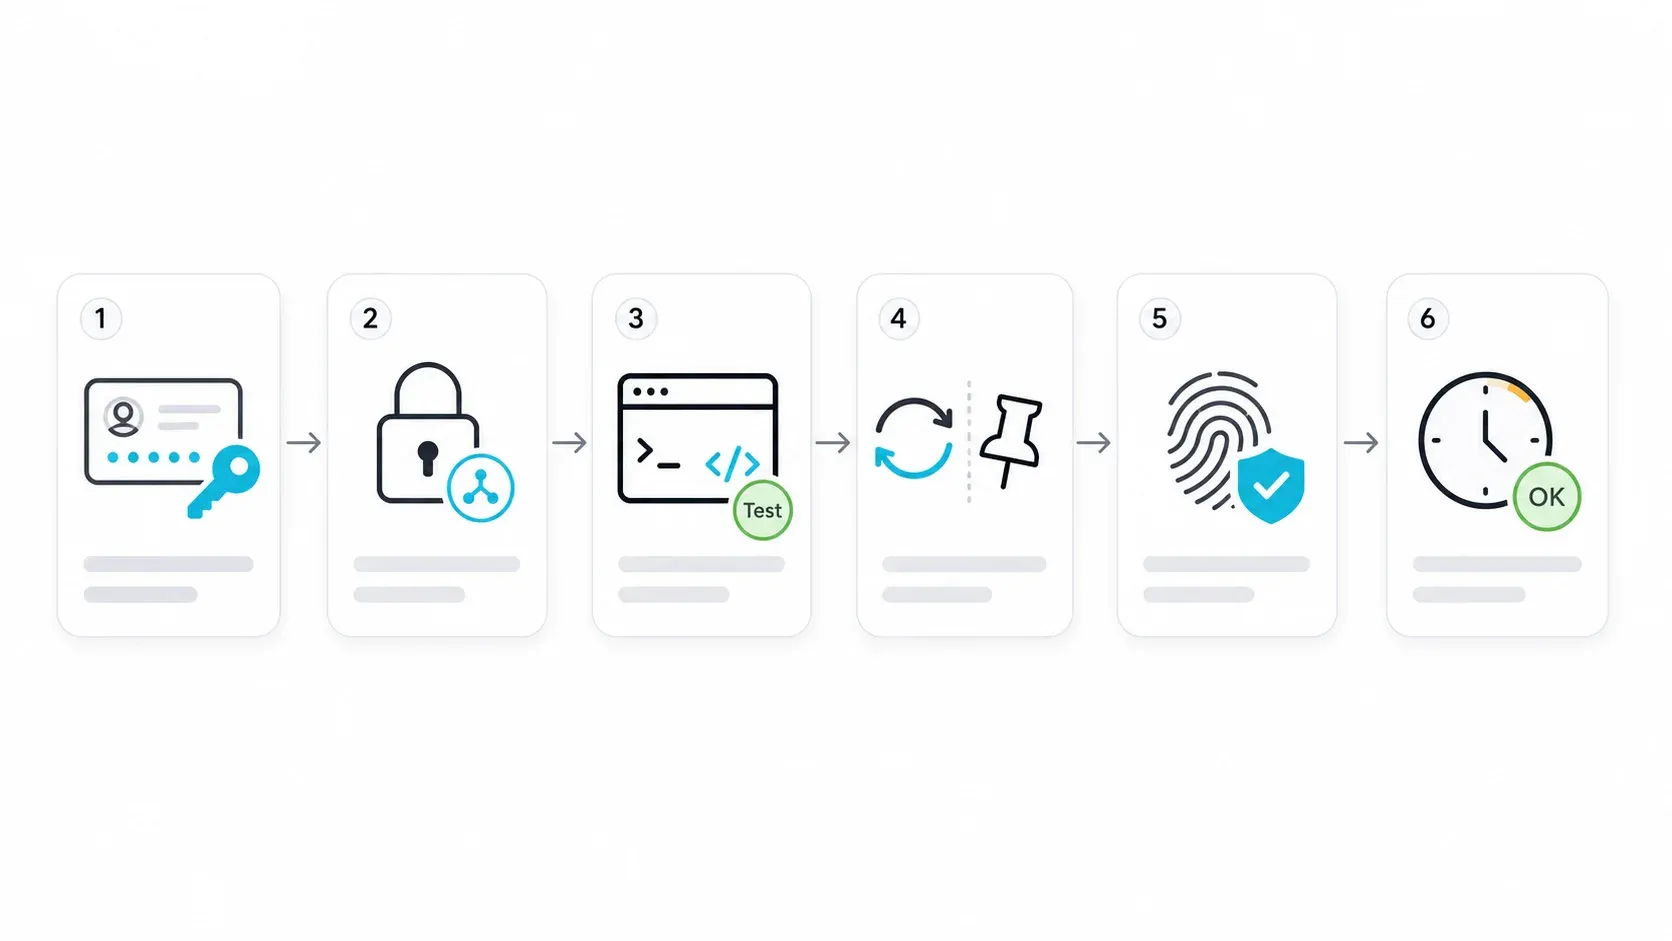
Steg 1: Skapa konto och hämta proxy-uppgifter
Registrera dig hos den leverantör du valt. Gå till dashboarden och hitta proxyendpointen (hostname), port, användarnamn och lösenord. Vissa leverantörer ger också en API-token eller en syntax för land/stad som du lägger till i användarnamnet.
Du borde se något i stil med:
- Host:
gate.provider.com - Port:
8000 - Username:
user-country-us-city-newyork - Password:
yourpassword123
[screenshot: provider dashboard showing proxy credentials and endpoint details]
Steg 2: Välj autentiseringsmetod
| Metod | Bäst för | Avvägning |
|---|---|---|
| Användarnamn:lösenord | Script, webbläsare, teamverktyg | Enkelt, men uppgifterna måste lagras säkert |
| IP-whitelisting | Servrar eller fasta kontors-IP:er | Renare auth, men fungerar dåligt om IP:n ändras |
| API-token | Hanterade API:er och dashboard-flöden | Bra för automation, måste skyddas som en nyckel |
De flesta nybörjare bör börja med användarnamn:lösenord. Det fungerar överallt och kräver ingen serverkonfiguration.
Steg 3: Välj protokoll — HTTP, HTTPS eller SOCKS5
| Protokoll | Bäst för | Krypterat? | Hastighet |
|---|---|---|---|
| HTTP | Enkel scraping, surfning | Nej (proxyhoppet är okrypterat) | Snabb |
| HTTPS | Inloggningssessioner, känslig data | Ja (trafiken till destinationen är HTTPS) | Snabb |
| SOCKS5 | Multi-account, annan trafik än HTTP | Beror på destination | Snabbare i vissa fall |
För de flesta webb-scrapingscenarier är HTTPS standard. SOCKS5 är användbart för anti-detect-webbläsare eller andra protokoll än HTTP. HTTP fungerar bra för snabba tester mot mindre känsliga mål.
Steg 4: Testa din första request med curl
Den officiella curl-dokumentationen bekräftar att proxyuppgifter kan skickas med -U eller --proxy-user.
curl -x http://gate.provider.com:8000 \
  -U "user-country-us:yourpassword123" \
  https://ipinfo.io/json
Du bör få ett JSON-svar som visar en amerikansk residential IP, ett ISP-namn (inte ett hostingbolag) och rätt stad om du specificerat en.
Om du får timeout eller autentiseringsfel: kontrollera uppgifterna, bekräfta porten och se till att kontot är aktivt och påfyllt.
Steg 5: Testa med Python requests
Requests-bibliotekets dokumentation stödjer proxy-URL:er i proxies-dicten.
import requests

proxy = "http://user-country-us:yourpassword123@gate.provider.com:8000"
proxies = {
    "http": proxy,
    "https": proxy,
}

response = requests.get("https://ipinfo.io/json", proxies=proxies, timeout=30)
print(response.json())
Utdata ska visa en residential IP med namnet på en konsument-ISP. Om du ser ett datacenter-ASN (som Amazon, Google eller DigitalOcean) levererar leverantören kanske inte riktiga residential IP:er — och det är en varningssignal.
Steg 6: Testa med Playwright (för webbläsarbaserad scraping)
Playwrights Python-dokumentation stödjer HTTP(S)- och SOCKS-proxies globalt eller per browser-context.
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(proxy={
        "server": "http://gate.provider.com:8000",
        "username": "user-country-us",
        "password": "yourpassword123",
    })
    page = browser.new_page()
    page.goto("https://ipinfo.io/json")
    print(page.text_content("body"))
    browser.close()
Steg 7: Konfigurera rotation och sessionsregler
I leverantörens dashboard ställer du in roterande eller sticky sessioner utifrån ditt användningsfall (se beslutsstödet ovan). För roterande är standard oftast en ny IP per request. För sticky lägger du vanligtvis till ett session-ID i användarnamnet — något i stil med user-country-us-session-abc123 — och leverantören håller den IP:n under den valda perioden.
Steg 8: Verifiera med flera verktyg
Lita inte på en enda IP-kontroll. Använd flera:
- ipinfo.io: ASN, företag, geolokalisering, integritetsflaggor
- BrowserLeaks: Browser-, WebRTC-, canvas- och IP-läckagetester
- PixelScan: Kontroller av proxy/fingerprint-konsistens
- whatismyipaddress.com: Snabb kontroll av synlig IP och plats
Bekräfta både den synliga IP:n och det faktiska innehållet från målsidan. En proxy kan passera en IP-kontroll men ändå bli blockerad eller få annat innehåll från målsidan.
Så undviker du att bli bannad: varför residential proxies inte ensamma räcker mot moderna anti-bot-system
Att ha en residential IP är nödvändigt men inte tillräckligt — och det här är något de flesta proxyguider hoppar över helt. Moderna anti-bot-system tittar på flera lager samtidigt.
Detektionslagren bortom IP-adressen
TLS/JA3-fingerprinting: När din klient initierar en HTTPS-anslutning avslöjar handskakningen ett fingeravtryck av hur klienten kommunicerar. Cloudflares dokumentation förklarar att JA3/JA4-fingeravtryck identifierar TLS-klienter utifrån deras anslutningsmönster. Salesforces ursprungliga JA3-inlägg går djupare: JA3 fingeravtrycker klienten, JA3S serverns svar. Om du påstår att du är Chrome via din User-Agent men ditt TLS-fingeravtryck säger ”Python requests”, blir du avslöjad.
Konsistens i HTTP-headern: User-Agent, Accept-Language, sec-ch-ua, encoding och headerordning måste passa ihop. En request som säger att den är Chrome på macOS men skickar Linux-liknande headers ser misstänkt ut.
Browser fingerprinting: Canvas, WebGL, typsnitt, skärmstorlek, tidszon, WebRTC och automationsflaggor (som navigator.webdriver) kan identifiera headless-webbläsare eller onaturliga miljöer. DataDomes forskning beskriver hur dessa signaler används i kombination.
Beteendeanalys: Timing mellan requests, scrollning, musrörelser, navigationsdjup och sessionshistorik. Att träffa 100 sidor per sekund från en ”hemmaanvändar”-IP ser inte ut som en hemmaanvändare.
JavaScript-exekvering: Många sajter förväntar sig att scripts körs, cookies sätts och utmaningsflöden slutförs. En rå HTTP-request som aldrig kör JS faller på dessa sajter.
Checklista mot bannlysning
Det här är vad jag faktiskt verifierar innan jag kör något proxybaserat arbetsflöde:
- ✅ Residential IP från en kvalitetsleverantör (verifierad med PixelScan/IPinfo)
- ✅ Konsistent, realistisk User-Agent-header
- ✅ TLS-fingerprint som matchar den påstådda webbläsaren (påstå inte Chrome medan du skickar en Python-fingerprint)
- ✅ Matchande tidszon, språk och Accept-Language för proxyns geografiska plats
- ✅ Realistisk request-timing (2–10 sekunder mellan sidor, inte 50 ms)
- ✅ Stöd för JavaScript-rendering när målsidan kräver det
- ✅ Hantering av cookies och sessioner (behåll cookies inom en session)
- ✅ Undvik honeypot-fällor (dolda länkar, osynliga formulärfält)
- ✅ Respektera
robots.txtoch sajtens villkor där det är relevant
Bright Datas egen dokumentation om anti-blockering varnar uttryckligen för att "residential proxies alone" är en missuppfattning — moderna system kontrollerar TLS-fingerprints, browser fingerprints och beteendemönster tillsammans med IP-rykte.
Vanliga misstag som får användare av residential proxies bannade
- Att bombardera sidor för snabbt. Även med roterande IP:er ser 100 requests/sekund från samma providersubnät automatiserat ut.
- Inkonsistenta headers mellan requests. Byta User-Agent mitt i en session eller skicka headers som inte matchar den påstådda webbläsaren.
- Ignorera
robots.txtpå sajter som övervakar den. Vissa sajter använder efterlevnad avrobots.txtsom signal. - Använda samma sticky IP för länge. En residential IP som surfar samma sajt i fyra timmar i sträck är ovanligt.
- Scraping medan du är inloggad på ett personligt konto. Om kontot flaggas förlorar du kontot — inte bara sessionen.
- Aldrig rendera JavaScript. Många e-handels- och sociala sajter visar tomma skal till klienter som inte kör JS.
Hoppa över proxy-stacken: så hanterar Thunderbit web scraping utan att du behöver administrera proxies
En ärlig fråga som är värd att ställa innan du bygger upp en proxy-stack: vill du egentligen ha residential proxies, eller vill du ha datan?
För många av användningsfallen ovan — prisbevakning, lead scraping, konkurrensanalys — är målet inte ”skicka trafik via en residential IP”. Det är ”få strukturerad data från webbsidorna till ett kalkylblad”. Residential proxy är bara en del av en större stack: proxies + headless browser + fingerprint-spoofing + retry-logik + CAPTCHA-hantering + HTML-parsing + schema-normalisering. Det är mycket som ska fungera tillsammans.
På Thunderbit byggde vi Open API och CLI för att hantera hela kedjan i ett enda anrop. POST /extract tar en URL och ett schema, renderar JavaScript, hanterar anti-bot-skydd, sköter proxyrotation internt, löser CAPTCHAs och returnerar strukturerad JSON som matchar ditt schema. Inga proxyuppgifter, ingen Puppeteer-konfiguration, ingen fingerprint-hantering.
För utvecklare: API och CLI
POST /openapi/v1/distill— Returnerar ren, LLM-anpassad Markdown från vilken sida som helstPOST /openapi/v1/extract— Returnerar strukturerad JSON som matchar ditt schema- CLI:
npx @thunderbit/thunderbit-cli extract <url> --schema <json>— körs från terminal, scripts eller CI - Batchbearbetning för upp till 100 URL:er per jobb
- MCP-server för AI-agenter (Claude, Cursor) som behöver webdata mitt i ett arbetsmoment
CLI-dokumentationen stödjer distill, extract, suggest-fields och batch-flöden från terminalen.
För icke-tekniska team: Chrome-tillägg
För sälj- och operations-team som inte kodar erbjuder Thunderbit Chrome Extension scraping i två klick med AI Suggest Fields. Klicka på tillägget, låt det föreslå kolumner, kör scraping och exportera till Excel, Google Sheets, Airtable eller Notion. Ingen proxysetup krävs.
När du ska använda residential proxies kontra Thunderbit
| Scenario | Residential proxies | Thunderbit |
|---|---|---|
| Web scraping → strukturerad data | Bra om du redan har en komplett scraper-stack | Stark lösning: extrahering, rendering, anti-bot och strukturerad output i ett anrop |
| Hantering av flera konton | Behövs för rå IP-/sessionskontroll | Inte rätt verktyg |
| Annonsverifiering | Behövs för platsbaserad surfning | Delvis passande endast om resultatet ska vara strukturerad data |
| Geo-begränsad surfning | Bra för manuell platskontroll | Passar när målet är att extrahera data från den lokaliserade sidan |
| Scraping för icke-tekniska team | Kräver proxy- och verktygskonfiguration | Stark lösning via Chrome-tillägg och direkt export |
Jag tänker inte låtsas att Thunderbit ersätter residential proxies i alla scenarier. Att hantera 50 Amazon-säljkonto eller verifiera annonsplaceringar i 30 städer? Då behöver du direkt proxyåtkomst. Men om slutmålet är ”få in den här datan i ett kalkylblad” kan en egen proxy-stack vara överarbete du inte behöver. Thunderbits gratisnivå låter dig testa utan att binda dig.
För mer om hur AI-driven scraping funkar under huven, se våra inlägg om AI web scraping och web scraping utan kod.
Tips och vanliga fallgropar
Börja smått. Köp inte ett 100 GB-abonnemang innan du testat med PAYG eller en gratis provperiod. Kör en pilot mot dina faktiska målsajter och mät lyckandefrekvens, hastighet och geo-noggrannhet.
Följ upp framgångsfrekvensen, inte bara IP:t. 95 % lyckande låter bra tills du inser att de 5 % misslyckandena alltid är på de sidor du bryr dig mest om. Följ blockfrekvens per målsajt, inte bara totalt.
Rotera User-Agents realistiskt. Välj 3–5 aktuella webbläsarsträngar och håll dig till dem. En lista med 500 slumpmässiga User-Agents hjälper faktiskt mindre — konsekvens är viktigare än variation.
Budgetera för retries. I verkligheten blir bandbreddsförbrukningen enligt min erfarenhet ofta 2–5 gånger högre än den naiva beräkningen utifrån sidstorlek.
Kontrollera leverantörens IP-sourcing. Om leverantören inte kan förklara var IP:erna kommer ifrån är det en varningssignal. FBI:s varning och Googles IPIDEA-insats påminner om att oetisk sourcing innebär verklig risk.
Ignorera inte sessionsstrategin. Att använda roterande sessioner i ett inloggningsflöde kommer att brytas varje gång. Att använda sticky sessioner för bred prisövervakning slösar pengar och ökar upptäcktsrisken.
Testa geo-noggrannheten separat. Leverantörens dashboard säger ”New York”. Målsidan kanske ser ”Newark” eller ”någonstans i New Jersey”. Verifiera med flera geolokalisationsdatabaser och genom att kontrollera vad målsidan faktiskt levererar.
Viktiga lärdomar
- Residential proxies skickar trafiken via konsument-ISP-IP:er, vilket får dina förfrågningar att se ut som vanlig hemanvändning. De är rätt val när målsidor aktivt blockerar datacentertrafik.
- Valet av leverantör är viktigare än poolens storlek. Utvärdera IP-färskhet, subnet-diversitet, geo-noggrannhet, etisk sourcing, sessionsflexibilitet och faktureringsmodell — inte bara det stora IP-talet i rubriken.
- Prismodellerna skiljer sig kraftigt. Per GB, per IP, per request och PAYG har olika kostnadsprofiler. Uppskatta verklig bandbredd, inklusive retries och rendering, innan du binder dig.
- Sticky kontra roterande är ett konfigurationsval, inte en smakfråga. Matcha sessionstyp med uppgiften: sticky för kontinuitet, roterande för spridning.
- En residential IP är bara ett lager av flera. TLS-fingerprints, header-konsistens, browser fingerprints, request-timing och JavaScript-rendering spelar alla roll. Missar du något av detta blir du bannad oavsett IP-kvalitet.
- För web scraping specifikt bör du fundera på om du alls behöver proxies. Verktyg som Thunderbits API och Chrome-tillägg hanterar hela anti-detekteringskedjan internt och levererar strukturerad data utan proxyhantering. För scraping inom ecommerce, sälj och leadgenerering kan det spara mycket tid på både setup och underhåll.
Redo att testa? Thunderbit erbjuder en gratisnivå för scraping, och du kan använda utvärderingschecklistan ovan för att välja en residential proxy med större trygghet om direkt IP-åtkomst är det du behöver.
FAQ
1. Är residential proxies lagliga att använda?
Ja, proxys i sig är lagliga i de flesta jurisdiktioner. Lagligheten beror på vad du gör med dem: att följa webbplatsens användarvillkor, dataskyddslagar (GDPR, CCPA) och att inte ägna dig åt bedrägeri eller otillåten åtkomst. Hur leverantören får tag på IP:erna spelar också roll — proxies byggda på botnät eller utan användarsamtycke innebär juridisk risk för köparen, inte bara för leverantören.
2. Vad är skillnaden mellan residential proxies och ISP-proxies (statiska residential proxies)?
ISP-proxies använder datacenterhostade IP:er som är registrerade hos konsument-ISP:er. De är snabbare och stabilare än P2P-baserade residential proxies, men poolerna är mindre och IP:erna kan bli lättare att fingerprinta över tid. De är en bra mellanväg för arbetsflöden där du behöver en stabil IP som ser residential ut, utan variationen från P2P-pooler.
3. Hur mycket kostar residential proxies 2026?
Typiska priser per GB ligger ungefär mellan 2 USD/GB (enterprise-planer med hög volym) och över 7 USD/GB (små PAYG-planer). AI Multiple uppskattar spannet till 3–15 USD/GB beroende på leverantör och volym. Den verkliga kostnaden beror på faktureringsmodell, bandbreddsförbrukning (inklusive retries och rendering) och om du använder PAYG eller ett abonnemang där kvoten inte nyttjas fullt ut.
4. Kan jag använda residential proxies gratis?
Vissa leverantörer erbjuder gratisnivåer eller testperioder med begränsad bandbredd eller IP-tillgång. De är användbara för testning men har oftast mindre pooler, lägre hastighet och IP:er som kan vara hårt använda redan från början. För alla produktionsflöden ska du räkna med att betala. Gratisnivån är till för validering, inte volym.
5. Hur många residential proxy-IP:er behöver jag?
Det beror på volym och rotationsstrategi. För bred scraping med roterande sessioner behöver du inte förvälja IP:er — leverantörens pool hanterar rotationen. För sticky sessioner (kontohantering, inloggningsflöden) behöver du en stabil IP per samtidig session. En grov tumregel: om du hanterar 10 konton samtidigt behöver du 10 sticky IP:er. Om du scrapar 10 000 sidor med roterande sessioner är poolstorleken viktigare än exakt antal IP:er — leta efter leverantörer med stora, färska pooler i din målregion. Läs mer



