
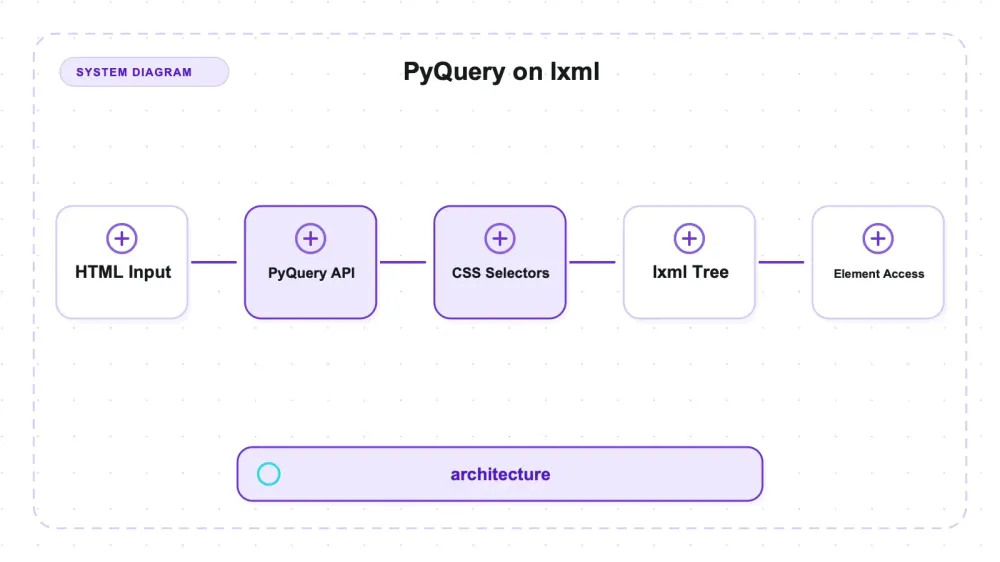
PyQuery lägger ett jQuery-liknande API ovanpå lxml. Över fem sidstorlekar, från 1 KB till 10 MB, låg alla fem medianvärden under rå lxml:s, inklusive en skillnad på 1,5 % vid den största storleken. benchmarken visar inte att wrappern är snabbare; den hittade ingen skillnad som var tillräckligt stor för att påverka valet i det här selector-och-läs-scenariot.
Den låg också inom några få procent från selectolax från 10 KB och uppåt i de visade medianerna. Utan en fördefinierad gräns för ekvivalens är det ett nära resultat, inte oavgjort i statistisk mening.
Vad PyQuery är
PyQuery är ett Python-bibliotek som ger dig jQuery:s selector- och chain-baserade API ovanpå ett lxml-dokumentträd. Testad version: 2.1.0, BSD-licens, 2 380 GitHub-stjärnor, 59 öppna ärenden, senaste push 2026-07-27.
Officiell referens: PyQuery documentation.
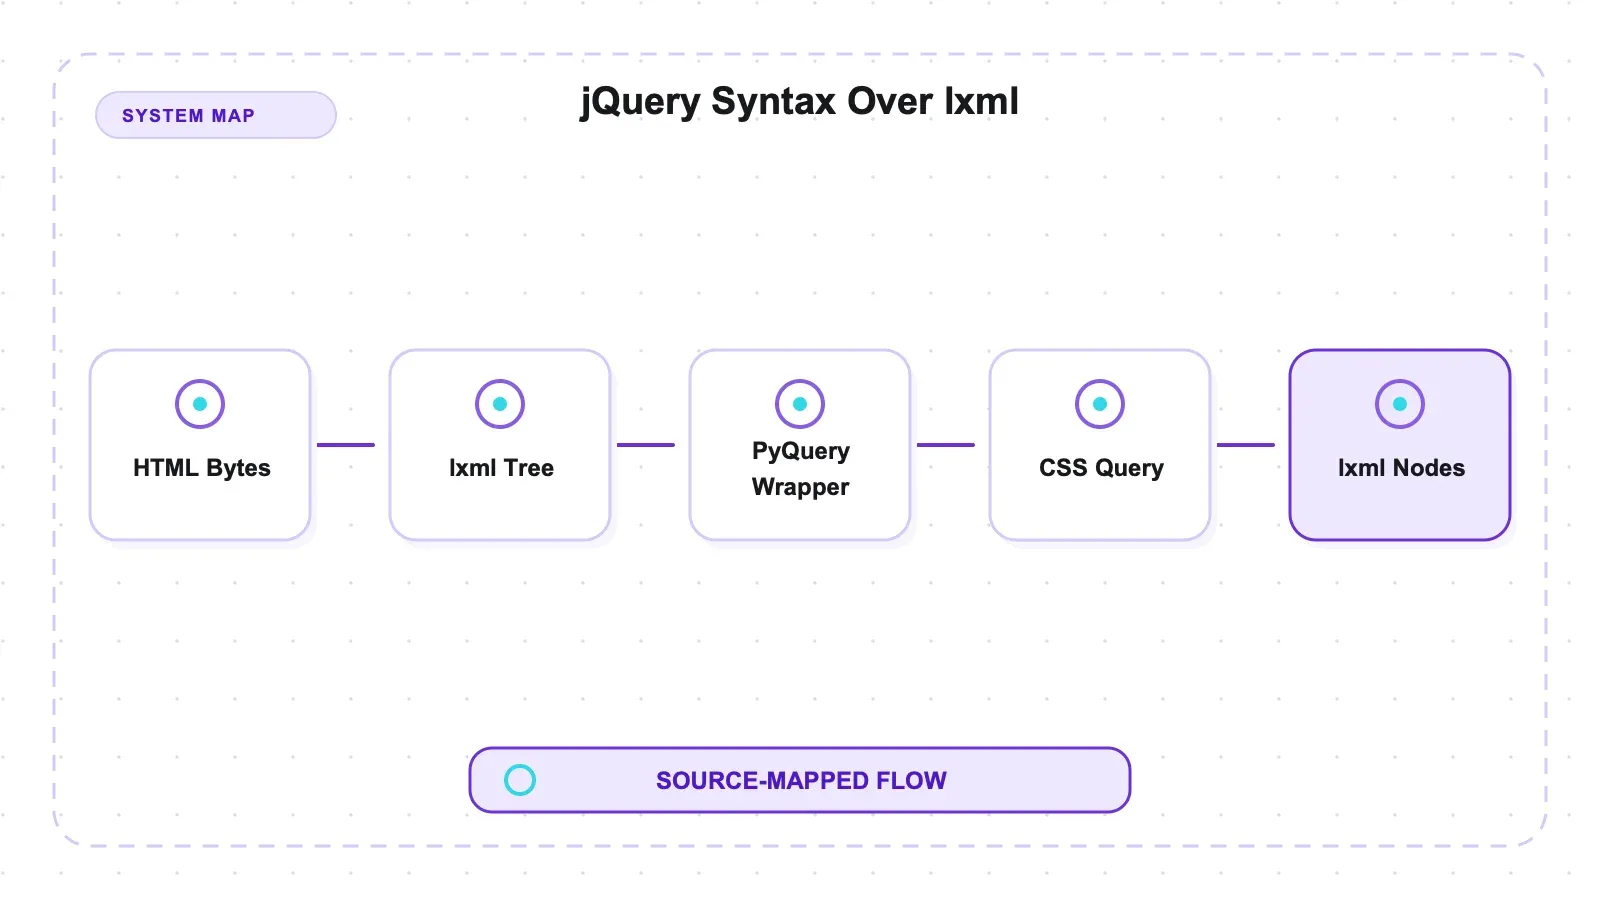
from pyquery import PyQuery as pq
d = pq(html)
titles = [e.text_content() for e in d("h3.title")]
hrefs = [e.get("href") for e in d("a")]
Objekten som returneras är lxml-element, så allt du redan kan göra med lxml fungerar fortfarande. Det är själva poängen i designen: PyQuery är ett lager för bättre ergonomi, inte en parser. pip install pyquery drar in 3 paket — lxml, cssselect och PyQuery självt — och 20,1 MiB, nästan allt från lxml:s kompilerade tillägg.
Om du har använt cheerio i Node är det här samma typ av API-idé i Python. De två selectors som testades här fungerade i båda; testet visar däremot inte full språklig överensstämmelse mellan cssselect och cheerio.
Mätningen
Det här forskningsunderlaget hade redan en parser-benchmark med en egenskap som de flesta tester saknar: en parity-gate som hashar extraherat innehåll — sorterade titlar plus sorterade hrefs — mot en referensparser, så att ett bibliotek inte kan fuska sig till en snabb tid genom att hoppa över arbete. Fem sidstorlekar, 50 iterationer, tre oberoende körningar.
Att lägga till PyQuery krävde två saker.
Köra om referensen. selectolax kördes igen i samma process. Dess innehållshash reproducerades på 5 av 5 storlekar och dess p50 landade mellan 0,989× och 1,079× jämfört med den publicerade siffran — alltså samma maskin och samma testmiljö.
Köra lxml i samma process också. Den publicerade benchmarken loggar maskinen och Python-versionen men inte biblioteksversioner, så dess lxml-rad kan ha kommit från en annan lxml-version än den som PyQuery omsluter här. Att jämföra över det gapet hade jämfört två lxml-versioner och kallat det wrapper-skatt. Att köra lxml sida vid sida tar bort den frågan — båda är lxml 6.1.1 i den här venv:n.
| Sidstorlek | selectolax | PyQuery | lxml | PyQuery vs lxml |
|---|---|---|---|---|
| 1 KB | 0.0286 ms | 0.0456 ms | 0.0508 ms | 0.90× |
| 10 KB | 0.1725 ms | 0.1728 ms | 0.1802 ms | 0.96× |
| 100 KB | 1.4855 ms | 1.4093 ms | 1.4145 ms | 1.00× |
| 1 MB | 14.97 ms | 14.96 ms | 15.03 ms | 1.00× |
| 10 MB | 158.10 ms | 162.86 ms | 165.25 ms | 0.99× |
p50 i millisekunder, median av tre körningar, allt i samma process. parser-bench.json. Alla tre innehållshashar matchade referensen vid varje storlek.
Wrapper-skatt som inte finns där
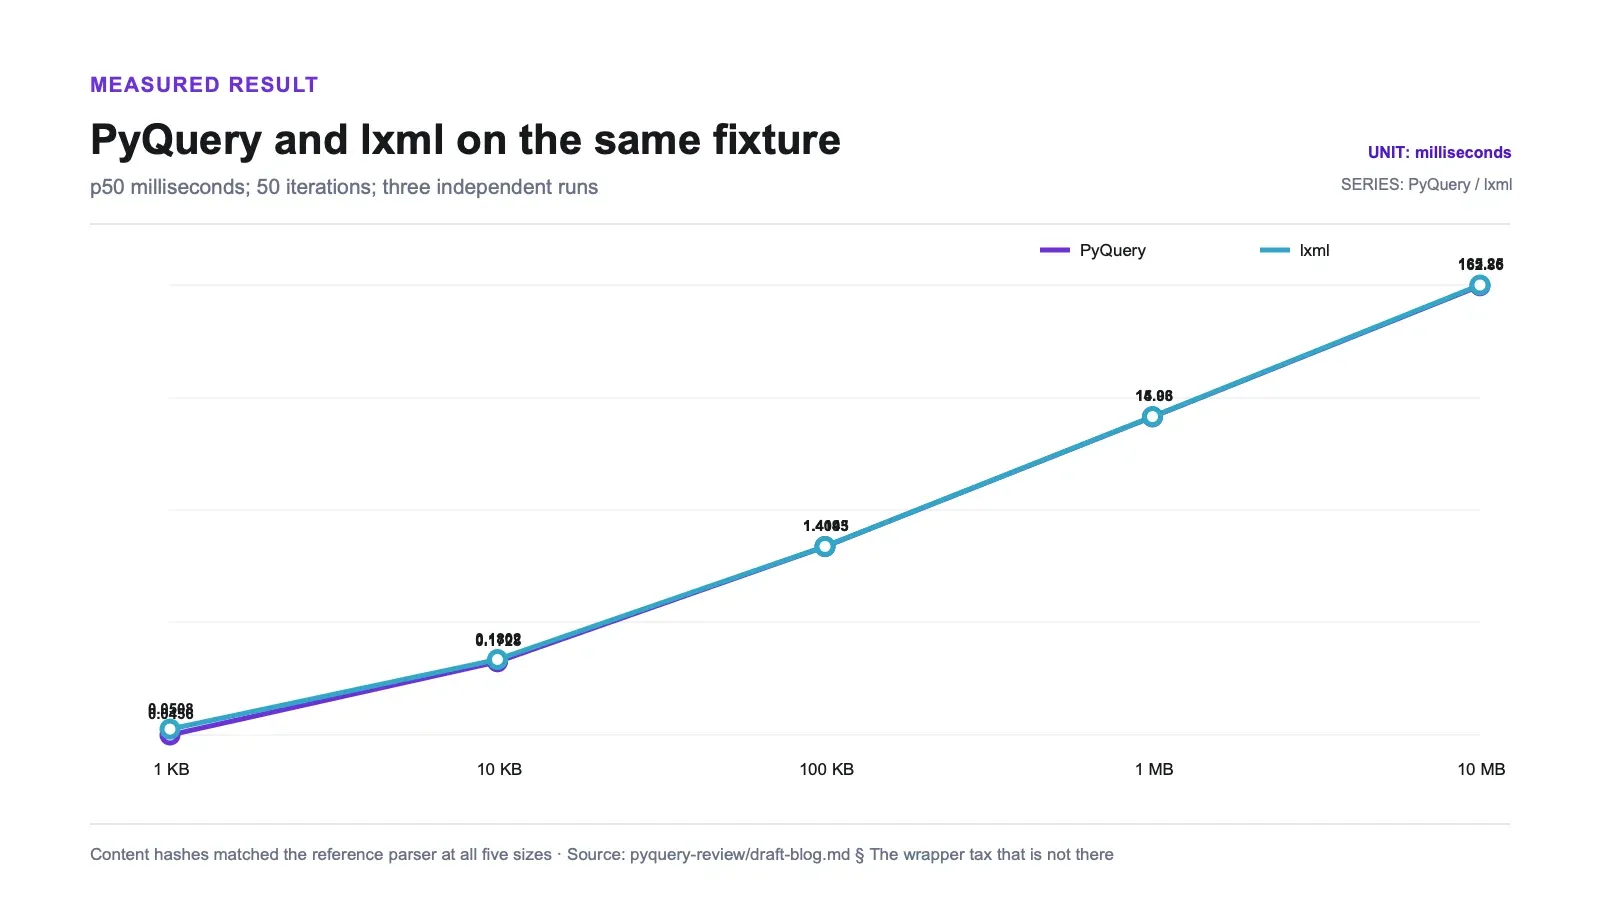
PyQuery låg på eller under rå lxml vid varje visad median. Det är inte bevis för att en wrapper gör parsning snabbare. Tre körningsmedianer och ingen fördefinierad ekvivalensmarginal räcker bara för den snävare slutsatsen att just detta testfall inte visade något beslutspåverkande selector-overhead.
Vid 10 MB var PyQuery:s tre körningar 162.86, 163.17 och 161.13 ms; lxml:s var 169.46, 165.25 och 164.18. Spannen ligger nära men överlappar inte. Vid 1 MB skiljer medianerna 0,5 %. De här små körningarna stödjer ett praktiskt omdöme, inte ett statistiskt ekvivalenspåstående.
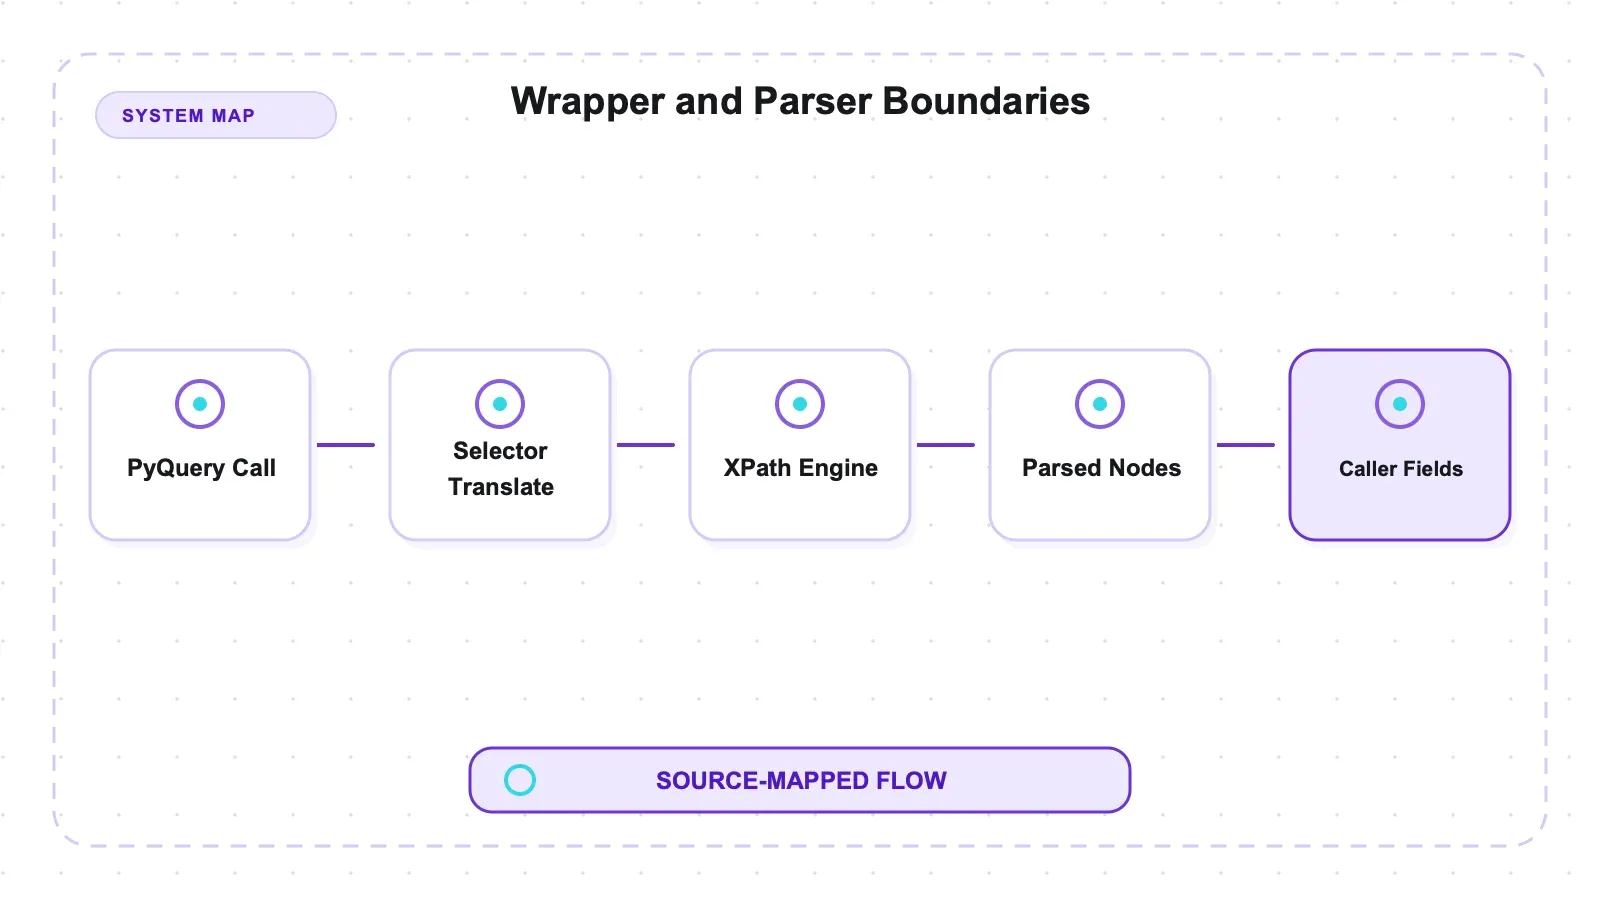
Mekanismen är enkel nog: pq(html) bygger ett lxml-träd en gång, d("h3.title") kompilerar CSS-selectorn via cssselect på samma sätt som tree.cssselect() gör, och elementen som skickas tillbaka är lxml-element. Det finns mycket lite PyQuery-arbete i just den här uppmätta heta vägen. Traversering, manipulation, upprepade frågor, import och minne ligger utanför påståendet om selector-tid.
Nära resultat från 10 KB och uppåt
Det mer användbara resultatet är den första kolumnen.
Från 10 KB och uppåt var spannet mellan snabbast och långsammast median bland selectolax, lxml och PyQuery 4,5 % vid 10 KB, 5,4 % vid 100 KB, 0,5 % vid 1 MB, och 4,5 % vid 10 MB. Den här körningen var inte ett ekvivalenstest; den praktiska slutsatsen är att de här skillnaderna sannolikt inte skulle ändra de flesta parser-val för just den här arbetslasten.
selectolax är faktiskt snabbare vid 1 KB — 0.0286 ms mot 0.0456 och 0.0508 — men den raden går inte att använda. Mellan de tre parserna är spannet vid den storleken 77,6 %, och selectolax egna tre körningar låg mellan 0.0267 och 0.0404 ms. Vid 28 mikrosekunder dominerar timern och schemaläggaren. Jag skulle inte rangordna något där.
För den här selector-och-läs-arbetslasten bör du välja mellan dessa tre utifrån API och uppmätta beroendefakta, inte utifrån en antagen hastighetshierarki. PyQuery visade ingen beslutspåverkande nackdel mot lxml. selectolax använder en annan parser-stack, men den här artikeln mätte inte dess installerade fotavtryck, wheel-täckning eller byggkrav på samma sätt.
Som jämförelse satte den publicerade benchmarken två fler Python-alternativ på samma 10 MB-fixtur, och det är där skillnaderna verkligen syns:
| Parser (10 MB) | p50 |
|---|---|
| selectolax (lexbor) | 159.93 ms |
| lxml | 172.93 ms |
| parsel | 231.85 ms |
| selectolax (modest) | 247.95 ms |
| BeautifulSoup + lxml | 2,261.56 ms |
| BeautifulSoup + html.parser | 2,788.75 ms |
Publicerade siffror från bench_parse.json.
De historiska benchmark-raderna placerar BeautifulSoup mer än en magnitud över de snabbare parser-medianerna i det här testfallet. De raderna kördes inte om med den aktuella PyQuery/lxml-kombinationen i samma process, så de är användbar kontext snarare än en kontrollerad multiplikator för huvudslutsatsen.
Cheerios sparade rad var 2 927.89 ms (2927.8857 i parser-bench.json) med matchande hashar av extraherat innehåll. Det resultatet mellan olika runtime-miljöer påverkas också av Node, paketversioner och de historiska körkontrollerna; det bör inte läsas som en isolerad multiplikator för bibliotekshastighet.
Installationsrealitet
| Bibliotek | Paket | Disk | Licens | Stjärnor | Senaste push |
|---|---|---|---|---|---|
| PyQuery | 3 | 20.1 MiB | BSD | 2,380 | 2026-07-27 |
| cheerio (Node) | 22 (npm) | 9.0 MiB | MIT | 30,449 | 2026-08-11 |
Officiell referens: PyQuery on PyPI.
Tre paket är ett snyggt beroendefotavtryck, och två av dem — lxml och cssselect — är sådant som många Python-projekt för scraping redan har. I så fall är PyQuery:s marginella kostnad bara några tiotal kilobyte.
De 20,1 MiB är lxml:s kompilerade tillägg, inte PyQuery:s. Det är samma runt 20 MiB du betalar för att använda lxml direkt.
Paketet har BSD-licens. Vid den daterade ögonblicksbilden hade det 59 öppna ärenden och en push tre veckor före testet; de observationerna räcker i sig inte för att bedöma underhållskvalitet eller framtida kompatibilitet.
Minne, och vad trasig HTML gör med det
Två saker som varje review i den här omgången listade som otestade är nu uppmätta.
Den bredare stress-test-konteksten finns i ten-library memory and malformed-HTML comparison.
Topp-RSS-minne, via /usr/bin/time -l, en färsk process per cell — importgolvet är det biblioteket kostar när det laddas och ligger stilla, toppvärdena inkluderar dokumentet.
| Bibliotek | Runtime | Importgolv | 226 KB topp | 10 MB topp |
|---|---|---|---|---|
| html2text | python3.14 | 18.7 | 19.9 | 71.2 |
| pyquery | python3.14 | 30.3 | 33.9 | 172.5 |
| resiliparse | python3.14 | 20.5 | 25.1 | 225.1 |
| markdownify | python3.14 | 23.9 | 28.9 | 278.5 |
| goose3 | python3.14 | 44.1 | 52.4 | 398.5 |
| cheerio | node22 | 66.8 | 76.5 | 398.5 |
| justext | python3.14 | 30.3 | 36.6 | 431.2 |
| newspaper4k | python3.14 | 52.6 | 61.8 | 668.5 |
| trafilatura | python3.14 | 52.5 | 64.8 | 927.1 |
| turndown | node22 | 47.8 | 68.4 | 2947.1 |
memory-results.json. Python- och Node-baslinjer går inte att jämföra direkt med varandra; tolkningen påverkas av själva interpreter:n i båda fallen.
PyQuery är lättare än resiliparse på det stora dokumentet — 172.5 MiB mot 225.1 — trots ett högre importgolv. lxml:s träd är kompakt, och det mesta av PyQuery:s 30.3 MiB-golv beror på att lxml laddas snarare än på något PyQuery gör.
Trasig HTML. Tolv dokument som vardera förstörde exakt en sak — oavslutade taggar, felinbäddade inline-element, oquotade attribut med mellanslag, ensamma avslut, ingen <html> alls, dubblettattribut, ett dokument avklippt mitt i en tagg, trasiga entities, en oavslutad <script>, en missvisande charset-deklaration, en kommentar som innehåller markup, och 600 nivåer av nästning — plus två välformade kontroller i matchande storlekar, eftersom ”den returnerade inget” bara säger något om trasighet om biblioteket inte också är tyst på ett rent dokument av samma storlek.
pyquery kastade fel på 0 av 14 och returnerade inget på 1, och återhämtade 10/22 sentinelvärden över de trasiga fixturerna (malformed-results.json). En fixtur räknas inte i den siffran: enligt HTML5 är allt efter en oavslutad <script> script-innehåll, så att tappa det där är korrekt och att återställa det vore avvikelsen. Utan de direkta alternativen och deras sentinel-resultat bredvid blir 10/22 en robusthetsobservation snarare än en ranking för biblioteksval.
För- och nackdelar
Till fördel. jQuery-syntax, bekant för alla som skrivit front-end-JavaScript eller använt cheerio. Inget beslutspåverkande selector-overhead syntes mot rå lxml i det här testfallet. Bara 3 paket, och 2 av dem har du sannolikt redan i ditt träd. Det returnerar lxml-element, så lxml-tekniker fungerar fortsatt. BSD. Innehållshasharna matchade referensen vid alla fem storlekar.
Mot det. 20.1 MiB, på grund av lxml. 2 380 stjärnor betyder en mycket mindre community än cheerios 30 449 — färre exempel när något blir märkligt. Det är ett bekvämlighetslager, så allt som lxml inte kan göra kan det heller inte göra. Och om du hoppades att jQuery-API:t köper prestanda gör det inte det: det köper ergonomi, och det är parsern under som gör arbetet.
Vem bör använda det, och vem bör låta bli
Använd PyQuery när du eller ditt team föredrar jQuery-liknande selectors i Python. Den uppmätta konstruktionen, två selektioner och läsningar visade ingen beslutspåverkande nackdel mot lxml; andra PyQuery-operationer mättes inte.
Använd lxml direkt om du föredrar XPath eller vill ha ett paket färre. Den här körningen gav ingen selector-hastighetsorsak att välja mellan dem.
Utvärdera selectolax om dess parser-API och beroendestack passar ditt projekt. 1 KB-raden är uttryckligen inte rankad, och den här artikeln ger inget stöd för påståendet om ”minst beroenden”.
I Node är cheerio den närmaste API-motsvarigheten. De sparade cross-runtime-raderna var långsammare här, men skillnader i runtime och historiska körningar gör att man inte kan dra en ren slutsats om just biblioteket.
Var ett managed API passar
PyQuery parsar HTML som du redan har. Det hämtar inte, renderar inte JavaScript och hanterar inte anti-bot-lager — inget parserbibliotek i den här jämförelsen gör det, och på många riktiga mål är det den svårare halvan.
Författaranteckning: Thunderbit är vårt managed-alternativ för inhämtning/rendering från URL och extraktion. Det jämfördes inte mot PyQuery här. Den relevanta gränsen är om du redan har HTML och vill köra lokala selectors, eller om du vill att sidinhämtning och extraktion ska hanteras som en tjänst.
Den ärliga formuleringen: om du har HTML och kan dina selectors är PyQuery gratis och behagligt. Om selectors hela tiden går sönder, eller om du hämtar i stor skala, är det ett annat köp.
För det bredare landskapet täcker vår web scraping API roundup hostade alternativ och open-source scraper pillar de självhostade. Om det parsade resultatet ska in i en modell är converting HTML to Markdown in Python platsen där fidelity går förlorad.
Testa Thunderbit för extrahering av webdata
Borde du använda PyQuery?
Ja, om du vill ha jQuery-liknande syntax i Python och den uppmätta selector-/läsbanan motsvarar din arbetslast.
Benchmarken fann inget beslutspåverkande selector-overhead mot lxml, samtidigt som innehållshash-pariteten bibehölls. Den visade inte heller att biblioteket som helhet är kostnadsfritt.
Över fem storlekar låg de tre Python-parser-medianerna tillräckligt nära varandra för att API-passform sannolikt ska vara viktigare för just den här uppgiften. Definiera en ekvivalensmarginal och kör om exakt samma alternativ innan du gör om den här bedömningen till en bredare parser-ranking.
Testa Thunderbit för extrahering av webdata Get Started Free
Vanliga frågor
Saktar PyQuery ner lxml?
Inget beslutspåverkande selector-overhead syntes i den här körningen. Över fem sidstorlekar landade medianerna på eller under rå lxml, och båda använde lxml 6.1.1 i samma process. Vid 10 MB överlappade inte de nära spannen: PyQuery 161.13–163.17 ms och lxml 164.18–169.46 ms. pq(html) bygger ett lxml-träd, och de testade selectors kompileras via cssselect.
Är selectolax snabbare än PyQuery? Dess median vid 1 KB var lägre, men den raden är inte rankad eftersom variation dominerar på mikrosekundnivå. Från 10 KB och uppåt var median-spannen 0,5 %–5,4 %. Det är nära för den här arbetslasten, inte bevis på ekvivalens eller överlappande intervall i alla fall.
Varför köra om lxml i stället för att citera den publicerade siffran? För att den publicerade benchmarken loggar maskinen och Python-versionen men inte biblioteksversioner. Dess lxml-rad kan ha kommit från en annan lxml än den som PyQuery omsluter idag, och ett versionsgap hade kunnat se ut som en wrapper-skatt som inte finns där. Att köra båda i samma process på lxml 6.1.1 tar bort oklarheten.
Hur står det sig mot cheerio? Samma övergripande API-idé, annat ekosystem. De två selectors som testades här fungerade i båda och innehållshasharna matchade vid alla fem storlekar; det betyder inte full kompatibilitet för alla selectors. Cheerio:s sparade tider var långsammare, men skillnader i runtime och historiska körningskontroller gör att man inte kan påstå en isolerad multiplikator för biblioteket.
Vad testades inte här? Minne mättes som peak RSS för endast import, ett dokument på 226 KB och ett dokument på 10 MB. Trasig HTML testades med 12 skadade dokument plus två matchade kontroller. Fortfarande otestat är PyQuery:s prestanda för manipulation och traversering, cache för upprepade frågor, URL-hämtning, samtidighet och verkliga arbetslaster från levande sajter. 1 KB-tidningen förblir inte rankad.




