
I et annoteret fixture-set med fokus på artikler levererede newspaper4k output på samtlige 22 fixtures, hentede 98,65 % af de scorede artikel-enheder og tog ingen af de markerede boilerplate-tokens med. De tre egenskaber gør den til en stærk kandidat ud fra testens prioriteringer; de udpeger ikke nogen universel vinder.
Ingen andre i dette set kombinerede netop de tre observerede resultater. Mozilla Readability hentede hver scoret indholdsenhed, men tog mere markeret boilerplate med; goose3 tog ingen markeret boilerplate med, men returnerede tomme strenge to gange. Andre beslutningsregler kan sagtens vælge et andet bibliotek.
En fetch-default fortjener særlig opmærksomhed, før du sætter det i drift.
Vad newspaper4k är
newspaper4k er en vedligeholdt fork af newspaper3k, som igen var Python 3-opfølgeren til det oprindelige newspaper. Det slægtskab betyder noget, når du leder efter hjælp, fordi det meste, du finder online, henviser til forgængeren, og en del af API’et er flyttet.
Officiel reference: newspaper4k:s officielle repository.
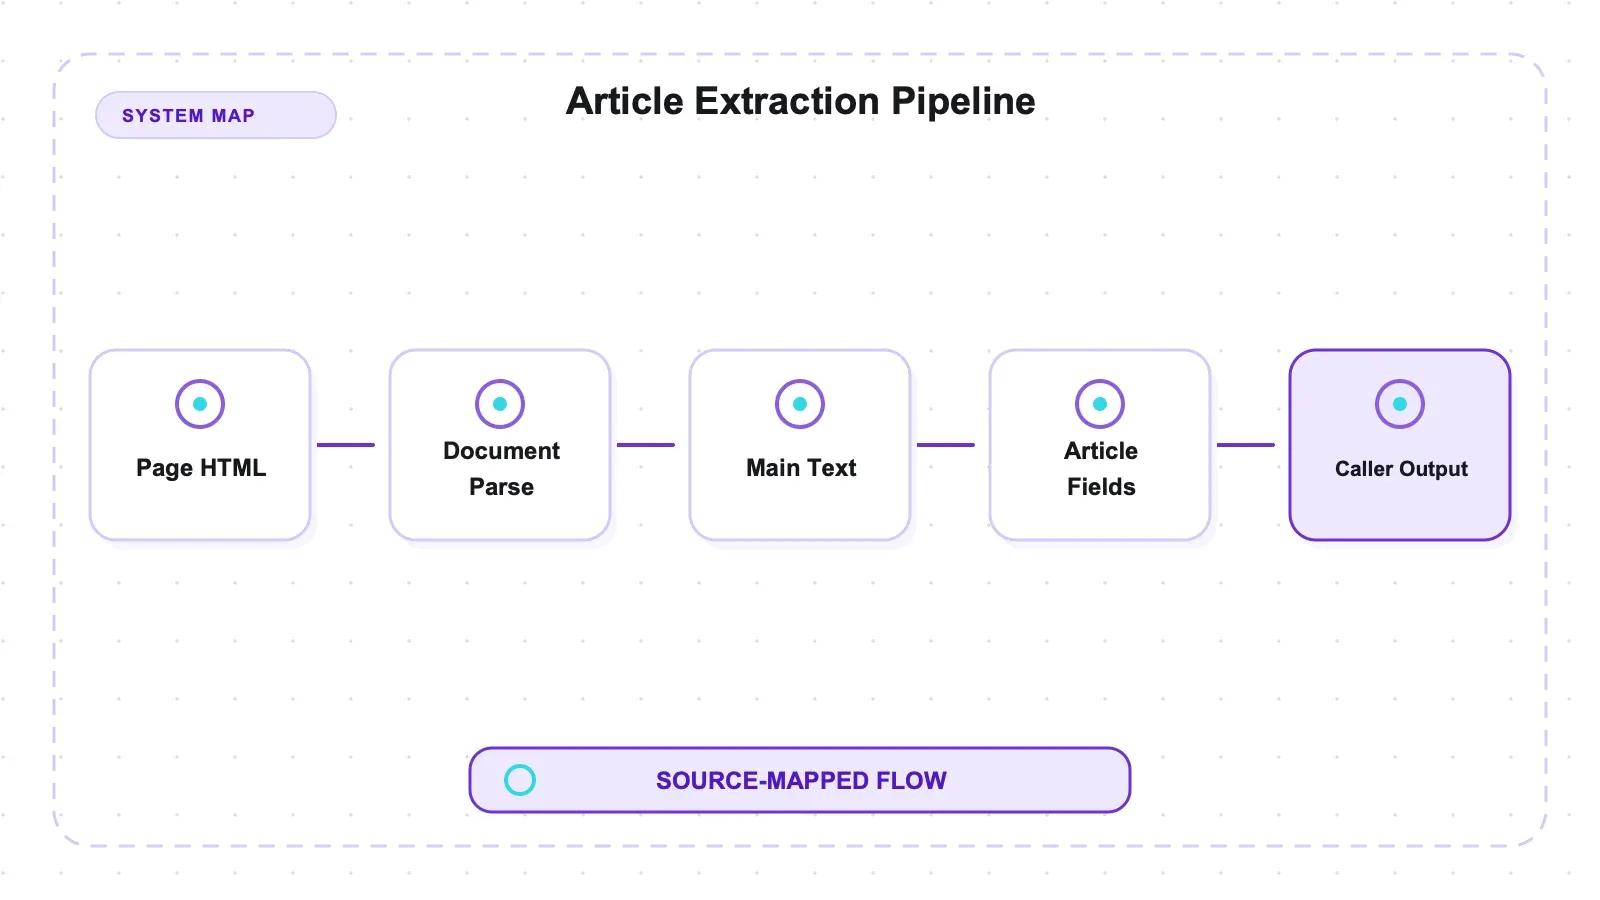
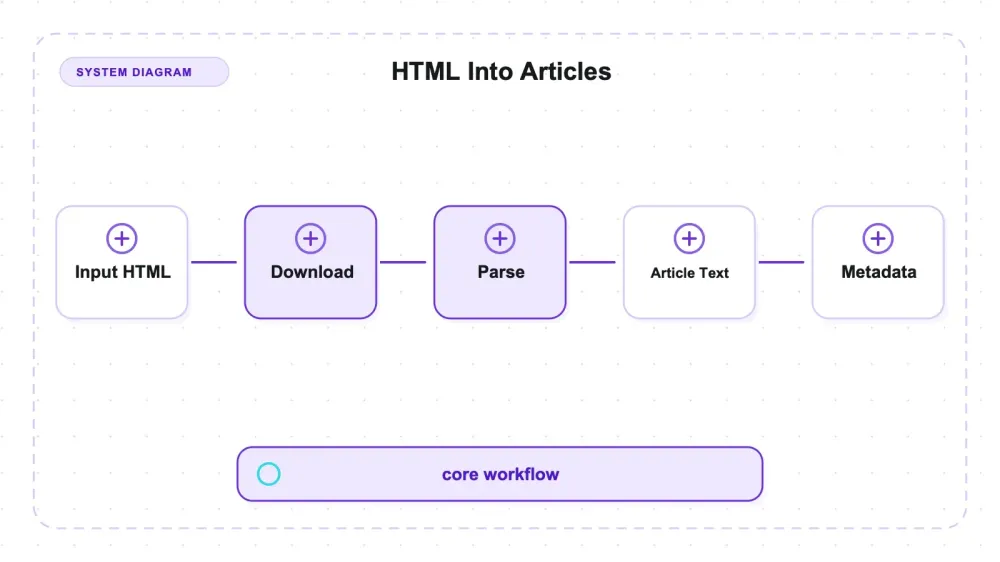
Den mest almindelige måde at bruge biblioteket forkert på er for eksempel at forsøge med set_html(). Den metode findes ikke. HTML sendes ind via download():
from newspaper import Article
a = Article(url="https://example.com/story")
a.download(input_html=html)     # ikke set_html()
a.parse()
text = a.text
Jeg lavede selv den fejl i første omgang og gav biblioteket 0 ud af 22 fixtures, før jeg tjekkede, om fejlen faktisk var min. Det var den.
Det, du får tilbage, er ikke bare tekst. Article-objektet eksponerer felter som text, title, authors, publish_date, top_image, images, movies, meta_description, meta_lang, tags og article_html. keywords og summary kræver den valgfrie NLP-installation og corpus-opsætningen, som beskrives længere nede. Feltsættet blev inventeret, men metadata-præcisionen blev ikke vurderet.
Testet version: 0.9.6, MIT, 1 135 GitHub-stjerner, med en repository-push dateret 2026-07-31. Den daterede aktivitet er et øjebliksbillede, ikke en fuld vurdering af vedligeholdelsesstatusen. Python 3.14.2.
Resultatet
| Bibliotek | Artikeldækning (alle 22) | Boilerplate-lækage | Præcision for indholdstokens | Forurenende tokens | Gav output |
|---|---|---|---|---|---|
| Readability | 1.0000 | 0.2353 | 0.9109 | 35 | 22/22 |
| trafilatura | 0.9865 | 0.0588 | 0.9411 | 4 | 22/22 |
| newspaper4k | 0.9865 | 0.0000 | 0.9452 | 0 | 22/22 |
| resiliparse | 0.9054 | 0.0588 | 0.9381 | 7 | 22/22 |
| jusText | 0.8378 | 0.4706 | 0.8760 | 74 | 19/22 |
| goose3 | 0.8243 | 0.0000 | 1.0000 | 0 | 20/22 |
sixway-scores.json. Hver enhed i hver fixture har et unikt sentineltoken, så "hentet" og "lækket" betyder præcis delstrengsmedlemskab snarere end en lighedsscore. Recall gælder alle 22 fixtures; lækage og præcision gælder de 11, der indeholder både artikel og boilerplate.
Tre kolonner er værd at holde adskilt.
Det svarede på hver side. goose3 og jusText gjorde det ikke — henholdsvis 20 og 19 ud af 22. Det betyder mere, end det først ser ud, fordi præcision og F1 i sådan en tabel betinges af, at der faktisk bliver produceret output: et bibliotek, der returnerer en tom streng, bidrager ikke til nogen side af brøken, så det er gratis at lade være. goose3’s præcision på 1.0000 blev regnet på 10 ud af 11 fixtures; newspaper4k’s 0.9452 på 11 ud af 11. Det er ikke helt den samme måling.
Det lækkede ingenting. Fixtures indeholder med vilje adversarial boilerplate — neutralt klassede promo-blokke, der ligger som søskende til artiklen, kommentarfelter med uskyldige klassnavne, annonceblokke der ikke siger "ad". Readabilitys søskende-append-heuristik slugte flere af dem; newspaper4k tog ingen.
Det missede én enhed ud af 74, og den missede enhed deles af andre.
Missene ligger i fixturet uden løbende prosa — en side bygget af tabeller, kodeblokke, korte punkter og en billedtekst i stedet for afsnit — og enheden, der faldt fra, er billedteksten. Den er ikke alene der:
| Bibliotek | Recall på siden uden løbende prosa | Enheder der faldt fra |
|---|---|---|
| Readability | 1.000 | — |
| jusText | 1.000 | — |
| trafilatura | 0.875 | billedteksten |
| resiliparse | 0.875 | billedteksten |
| newspaper4k | 0.875 | billedteksten |
| goose3 | 0.250 | begge tabeller, kodeblokken, begge korte punkter, billedteksten |
Tre biblioteker mister den samme billedtekst og ingen anden enhed, hvilket lyder mindre som tre separate bugs og mere som en fælles arv af antagelser om, hvad en billedtekst er værd. Hvis dit indhold er dokumentation, opskrifter eller noget, hvor billedteksten bærer information, som afsnittet ikke gør, bør du teste det først, før du beslutter dig — Readability og jusText beholdt den begge.
Samme fixture er også dér, hvor goose3 falder helt fra hinanden og mister tre fjerdedele af siden, så "ikke-prosaindhold" er en dimension, hvor de seks skiller sig betydeligt mere ad, end hovedtabellen antyder.
Når det gælder hastighed, var newspaper4k’s medianekstraktion over 22 fixtures 2,69 ms, langsomst af de seks, med et værste tilfælde på 199,81 ms. Sammenlignet med resiliparse’s median på 0,06 ms er det en 45× forskel i denne kontrollerede kørsel. Medianen kan være lille i et workflow med enkelte sider, men gennemstrømning og hale-latens under belastning blev ikke testet. Koldimport måles separat nedenfor.
Den standard jeg ville ændre på linje ét
Officiel reference: newspaper4k-dokumentationen.
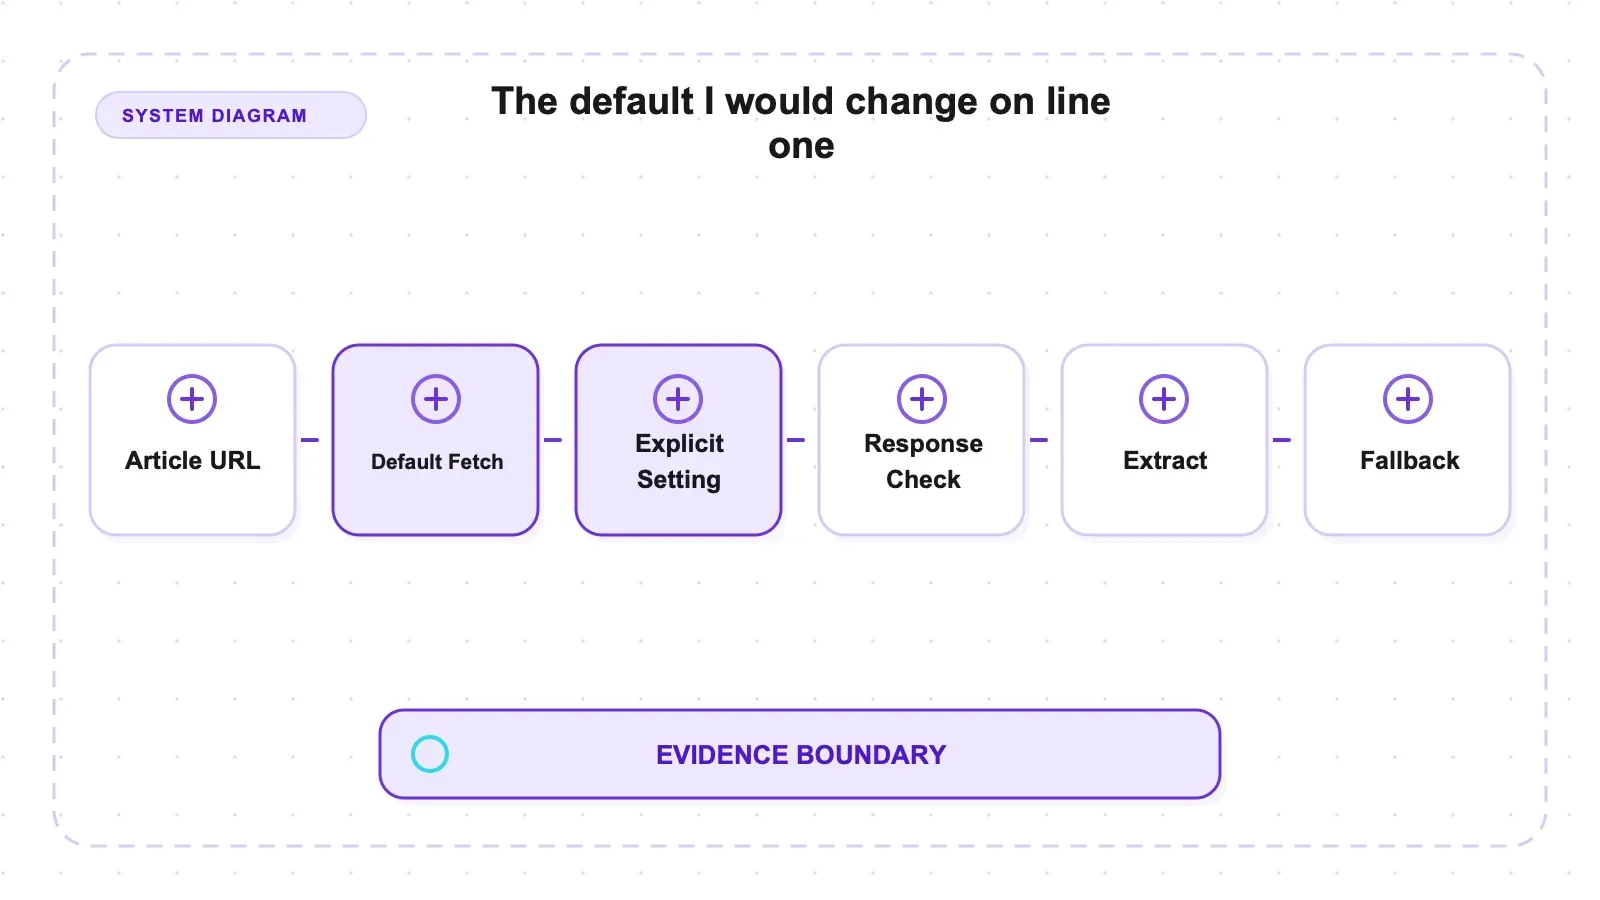
Hvis man læser det medfølgende Configuration-objekt, finder man 22 indstillinger. En af dem er denne:
_honor_robotstxt = False
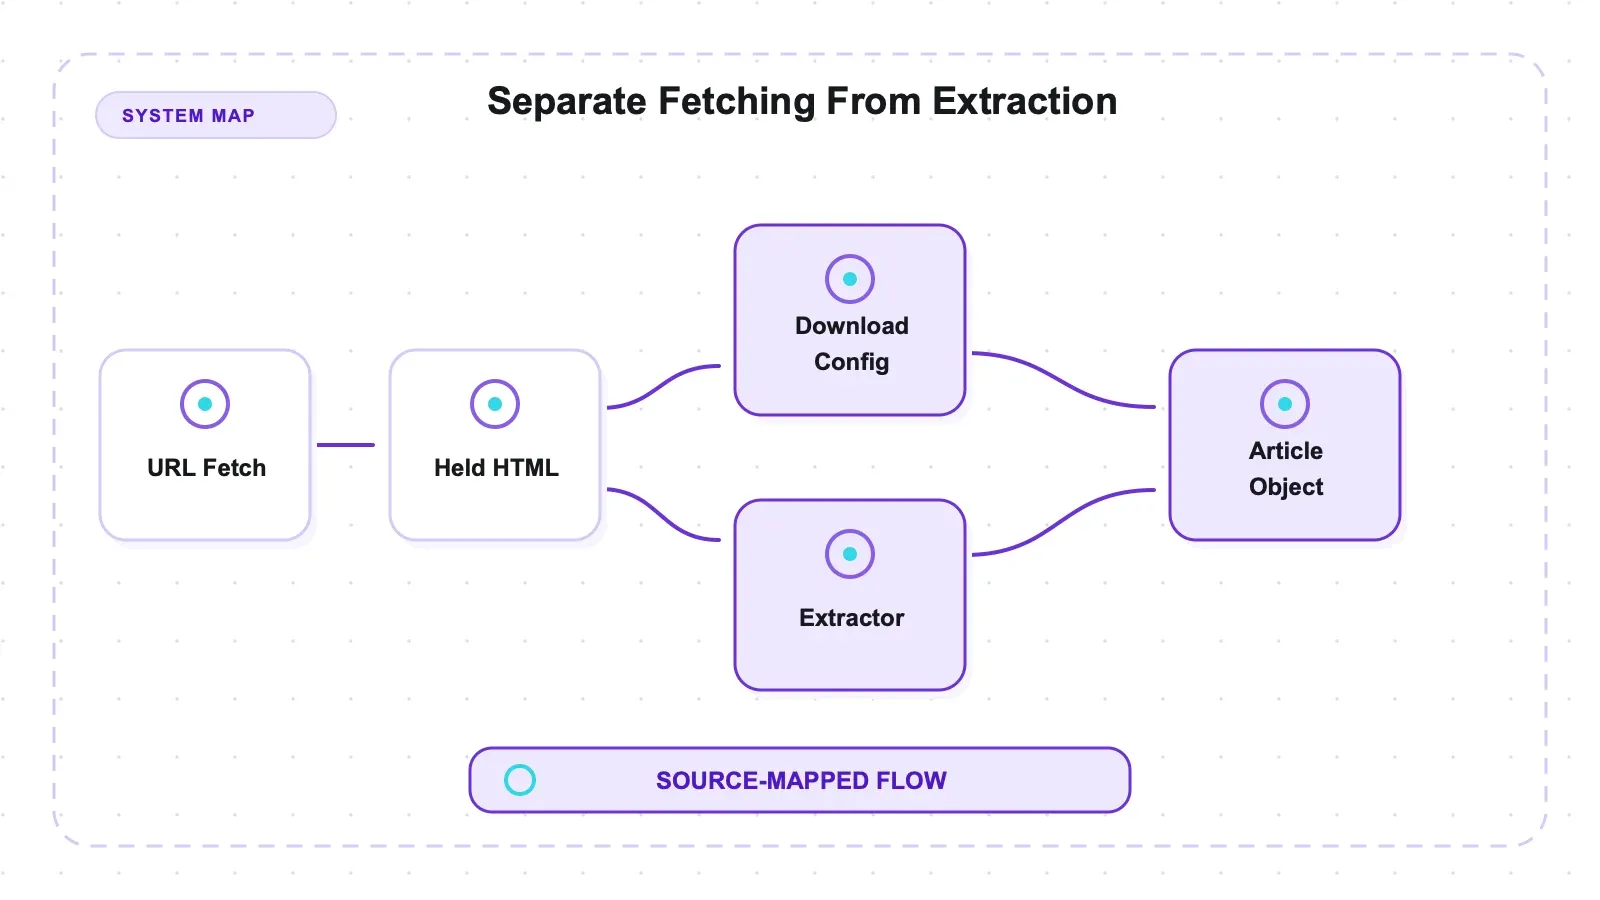
newspaper4k respekterer ikke robots.txt, medmindre du beder det om det. Hvis du lader det hente — Article(url).download() uden input_html — så henter det det, du peger det mod, uanset hvad sitets robots-fil siger.
Det er et teknisk forsvarligt standardvalg for et bibliotek, hvis primære brug er at tolke HTML, du allerede har, og et uforsvarligt valg at opdage i produktion efter at du har peget det mod tusind URL’er. Sæt honor_robotstxt=True i din Configuration, eller send input_html og håndtér hentningen selv, hvilket jeg gjorde gennem hele testen.
To mere er værd at kende:
number_threads = 10. Standardniveauet for parallelisme i dets hjælpefunktioner til flere artikler er ti. Samtidighed er ikke det samme som requests pr. sekund, men det kan skabe en burst af samtidige kald, hvis du ikke sætter eksplicitte grænser per værtsnavn og planlægning.
fetch_images = True. Billedhentning er slået til som standard, hvilket rejser et spørgsmål om offline-brug. Med socket.connect blokeret fuldførte den testede newspaper4k 0.9.6-sti — download(input_html=…) efterfulgt af parse() på et enkelt HTML-inputobjekt —, returnerede 1 292 tegn og forsøgte ingen netværksforbindelser. Det understøtter netop den sti, ikke hver konfiguration, plugin, indholdstype eller fremtidig version.
Resten er rimeligt: min_word_count 300, min_sent_count 7, max_text 100 000, http_success_only True, memorize_articles True, follow_meta_refresh False, allow_binary_content False.
Installationsvirkeligheden
pip install newspaper4k henter 22 pakker og 47,5 MiB på omkring seks sekunder. Koldimport i en ny subprocess: 2,812 s — langsomst i sammenligningen.
| Bibliotek | Pakker | site-packages | Koldimport | Ekstraktion p50 |
|---|---|---|---|---|
| resiliparse | 5 | 21.0 MiB | 0.015 s | 0.06 ms |
| jusText | 3 | 22.4 MiB | 0.777 s | 0.56 ms |
| goose3 | 16 | 44.3 MiB | 2.181 s | 1.85 ms |
| newspaper4k | 22 | 47.5 MiB | 2.812 s | 2.69 ms |
| trafilatura | 17 | 69.9 MiB | 1.584 s | 0.51 ms |
install-and-import.json. Hvert bibliotek i en egen tom virtualenv, så intet arver en søskendeparts afhængigheder.
2,812 sekunder til import er 187 gange resiliparse’s 15 millisekunder. I en langlivet worker betaler du det én gang og så er det ligegyldigt. I en serverless-funktion betaler du det ved hver cold start, og så er newspaper4k det forkerte valg, uanset hvor god ekstraktionen er.
En lille kant ved installationen. Importen skriver en advarsel:
UserWarning: nltk is not installed. Some NLP features will be unavailable. Install it with: pip install 'newspaper4k[nlp]'
Intet i denne test havde brug for de funktioner, og ekstraktionen fungerede fint uden dem, men grundinstallationen er ikke den komplette installation, og newspaper4k[nlp] trækker et klart tungere afhængighedstræ plus corpus-downloads ind. Regn kun med det, hvis du vil have nøgleord og opsummeringer.
Hukommelse, og hvad ødelagt HTML gør ved den
To ting, som hver anmeldelse i denne runde markerede som utestede, er nu målt.
Den bredere stresstest-kontekst findes i sammenligningen af hukommelse og fejlbehæftet HTML for ti biblioteker.
Topresidenthukommelse, via /usr/bin/time -l, en frisk proces per celle — importgulvet er det, biblioteket koster, når det er indlæst og tomt, toppene inkluderer dokumentet.
| Bibliotek | Runtime | Importgulv (MiB) | HTML på 226 KB top (MiB) | HTML på 10 MB top (MiB) |
|---|---|---|---|---|
| html2text | python3.14 | 18.7 | 19.9 | 71.2 |
| pyquery | python3.14 | 30.3 | 33.9 | 172.5 |
| resiliparse | python3.14 | 20.5 | 25.1 | 225.1 |
| markdownify | python3.14 | 23.9 | 28.9 | 278.5 |
| goose3 | python3.14 | 44.1 | 52.4 | 398.5 |
| cheerio | node22 | 66.8 | 76.5 | 398.5 |
| justext | python3.14 | 30.3 | 36.6 | 431.2 |
| newspaper4k | python3.14 | 52.6 | 61.8 | 668.5 |
| trafilatura | python3.14 | 52.5 | 64.8 | 927.1 |
| turndown | node22 | 47.8 | 68.4 | 2947.1 |
memory-results.json. Python- og Node-baselines kan ikke sammenlignes direkte med hinanden; interpreter ligger inde i begge.
newspaper4k’s gulv er 52,6 MiB og dets top ved 10 MB er 668,5 MiB — næstyngst blandt Python-bibliotekerne. Intet af det er et problem for almindelige sider; begge dele betyder noget, hvis du batcher store dokumenter i en worker med hukommelsesgrænse.
Fejlbehæftet HTML. Tolv dokumenter, som hver bryder præcis én ting — uafsluttede tags, forkert indlejrede inline-elementer, uquoted attributter med mellemrum, ensomme afslutninger, ingen <html> overhovedet, dobbelte attributter, et dokument afskåret midt i et tag, ødelagte enheder, en uafsluttet <script>, en falsk charset-deklaration, en kommentar med markup og 600 niveauer af indlejring — plus to velformede kontroller i matchede størrelser, fordi "den returnerede intet" kun siger noget om fejl, hvis biblioteket heller ikke er tavst på et rent dokument af samme størrelse.
Kontrollerne og de ødelagte tilfælde skiller sig tydeligt ad i råresultaterne:
| Gruppe | Dokumenter | Udløste fejl | Tomt output | Hentede scorede sentineler |
|---|---|---|---|---|
| Velformede matchede kontroller | 2 | 0 | 0 | bruges ikke i den ødelagte score |
| Fejlbehæftede fixtures | 12 | 0 | 10 | 5/33, eksklusive tilfældet med uafsluttet <script> |
De to kontroller producerede henholdsvis 70 og 1 351 tegn, mens ti af tolv ødelagte inputs gav en tom streng. Det gør tavsheden til noget, der kan tilskrives netop fejlbehæftelsen i denne fixture-design og ikke bare kort input. Scoreren kontrollerer sentinel-tegn for overskrift, afsnit og link på tværs af de elleve kvalificerede ødelagte dokumenter. Fixturet med den uafsluttede <script> udelades, fordi efterfølgende markup ifølge HTML5-parsing stadig er scriptindhold. Se malformed-results.json. Det er en væsentlig genopretningsbegrænsning at tage med i valget, ikke bare et "udløste ingen fejl"-resultat.
Fordele og ulemper
Til dens fordel. Ingen markerede boilerplate-tokens i denne sammenligning, output på alle 22 kontrollerede artikel-fixtures og 0,9865 i scoret artikeldækning. Den eksponerer artikeltekst plus metadatafelter, selvom metadata-præcisionen ikke blev testet. Den testede held-HTML-sti lavede ingen netværksforsøg med socket.connect blokeret. Repositoryet havde en nyligt dateret push ved kontrollen; bredere vedligeholdelsesstatus blev ikke vurderet.
Imod den. Tungeste koldimport i sættet på 2,812 s og 22 pakker / 47,5 MiB målt site-packages. honor_robotstxt er False som standard, og hjælpefunktioner til flere artikler bruger ti tråde som standard. Grundinstallationen advarer om manglende NLTK, så nøgleord og opsummeringer kræver en tungere valgfri installation. Vigtigst af alt: ti ud af tolv fejlbehæftede fixtures returnerede tomt output, selv om begge velformede kontroller producerede tekst.
Hvem bør bruge det, og hvem bør lade være
Overvej newspaper4k når din prioriteringsrækkefølge er: producer ikke-tom tekst på det kontrollerede artikelorienterede korpus, minimer markeret boilerplate i netop det korpus og accepter en langsommere koldimport. Under den eksplicitte regel vandt det her fixture-sammenligningen. En anden regel kan vælge Readability for maksimal bevaret indholdsmængde eller resiliparse for starttid og medianhastighed ved ekstraktion.
Spring det over eller test det grundigt når cold start dominerer, når 47,5 MiB målt site-packages er væsentligt, eller når genopretning fra fejlbehæftet HTML er vigtig. Resiliparse importerede 187 gange hurtigere her, men matchede ikke trafilatura på alle kvalitetskolonner: trafilatura havde højere artikeldækning, mens deres lækage- og præcisionsprofiler også skilte sig ad. newspaper4k er artikelorienteret; produktlister og dashboards blev ikke testet, så der påstås intet om deres adfærd.
Uanset hvad du gør, så sæt honor_robotstxt, hvis du lader det hente. Det er ikke en præstationsnote.
Var en håndteret API-løsning passer
newspaper4k kan tolke HTML, som anmodes leveret af brugeren, og har også fetch-veje. En håndteret ekstraktionstjeneste lægger indsamling, rendering og planlægning bag en leverandørgrænse i stedet. Vi bygger Thunderbit, men den blev ikke kørt mod dette fixture-set, så denne anmeldelse understøtter ingen sammenligning af kvalitet, rendering, anti-bot, latenstid eller pris. For gemt artikel-HTML handler evidensen her kun om newspaper4k; ikke-artikelmål kræver deres egen evaluering.
For de samme fixtures på tværs af alle seks ekstraktorer, se sammenligningen af seks biblioteker til ekstraktion.
For det hostede felt er vores gennemgang af web scraping-API’er det bredere billede; for selvhostede alternativer, open source-scraper-guiden. Hvis teksten skal ind i en model, dækker at konvertere HTML til Markdown i Python, hvor troværdigheden går tabt.
Test Thunderbit til webdataudtræk
Bør du bruge newspaper4k?
Se newspaper4k som en stærk kandidat til udtræk af artikeltekst, når HTML allerede er tilgængelig, og kør derefter en reel sammenligning på dit eget korpus, før du tager det i brug. Det kontrollerede set støtter høj scoret artikeldækning, ingen markeret boilerplate og ikke-tomt output på alle 22 artikelorienterede fixtures. Det siger intet om virkelige sider eller metadata-præcision, og ti ud af tolv fejlbehæftede fixtures returnerede tomt output.
Hvis du bruger fetch-vejen, så gennemgå honor_robotstxt=False, parallelisme med ti tråde og grænser per værtsnavn helt eksplicit. Hvis cold start eller afhængighedsfodaftryk betyder noget, så mål den lokale import på 2,812 sekunder og observationen om 47,5 MiB site-packages i dit eget driftsmiljø i stedet for at betragte dem som universelle containeromkostninger.
Test Thunderbit til webdataudtræk Get Started Free
Vanliga frågor
Hvorfor virker set_html() ikke?
Fordi den ikke findes i newspaper4k. HTML sendes ind via download(input_html=html), og derefter parse(). Søgeresultater kan vise eksempler fra newspaper3k, hvilket gør det her til en let fejl; jeg lavede selv den fejl i første kørsel og rettede testharnessen før scoringen.
Respekterer newspaper4k robots.txt?
Ikke som standard. honor_robotstxt leveres som False. Sæt det til True i din Configuration, hvis du lader biblioteket hente, eller send input_html og hent selv. Arbejde med flere artikler bruger også ti tråde som standard. Det er valgt samtidighed, ikke en fast request-hastighed; sæt tydelige grænser per værtsnavn ved hentning.
Gør parse() netværkskald?
I newspaper4k 0.9.6 gjorde stien download(input_html=…) plus parse(), som blev testet, ingen forbindelsesforsøg for en hold-HTML-indgang, mens socket.connect var blokeret. Det betyder ikke, at alle parserkonfigurationer, plugins, indholdstyper eller fremtidige versioner er netværksfri.
Hvad betyder NLTK-advarslen ved import?
Grundinstallationen indeholder ikke NLTK, så nøgleordsudtræk og opsummeringer er ikke tilgængelige, og biblioteket siger det ved import. Selve ekstraktionen påvirkes ikke — alt, der blev målt her, kørte på grundinstallationen. pip install 'newspaper4k[nlp]' tilføjer dem sammen med et tungere afhængighedstræ og corpus-downloads.
Hvad blev ikke testet i denne anmeldelse? Virkelige websider — det her er kontrollerede fixtures med mærkede enheder. Metadatafelter blev inventeret, men ikke scoret for titel-, forfatter-, dato- eller billedpræcision. Flersproget ekstraktion, NLP-tilføjelser, multitrådet kildehentning og gennemstrømning under belastning blev heller ikke testet. Processens top-hukommelse blev målt på en HTML-input på 226 KB og en på 10 MB, ikke under samtidighed eller vedvarende belastning.




