
På de fyra HTML-fixtures som delades med markitdown producerade markdownify samma antal utskrivna Markdown-tabellrader enligt vår räknare — 36 mot 36 — och återskapade alla 16 kontrollerade innehållssträngar. Dess 21 062 token långa output var nominellt lägst, även om de tre första konverterarna låg inom 1,3 % från varandra. Det installerar på 1,8 MiB, har MIT-licens och hade 2 235 GitHub-stjärnor vid snapshoten.
Det är det minst omtalade biblioteket i den här kategorin och, utifrån de här siffrorna, det jag själv skulle välja först.
Vad markdownify är
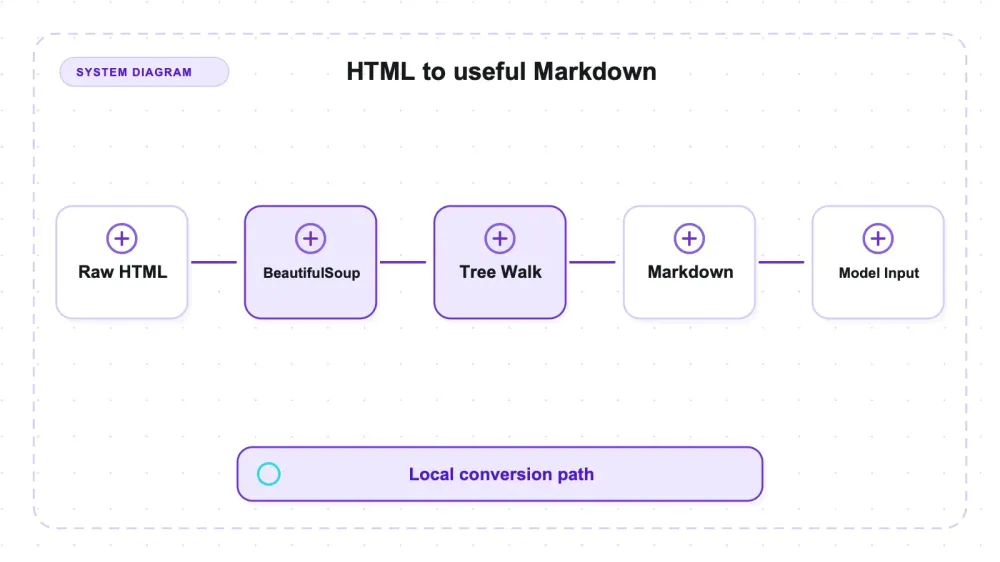
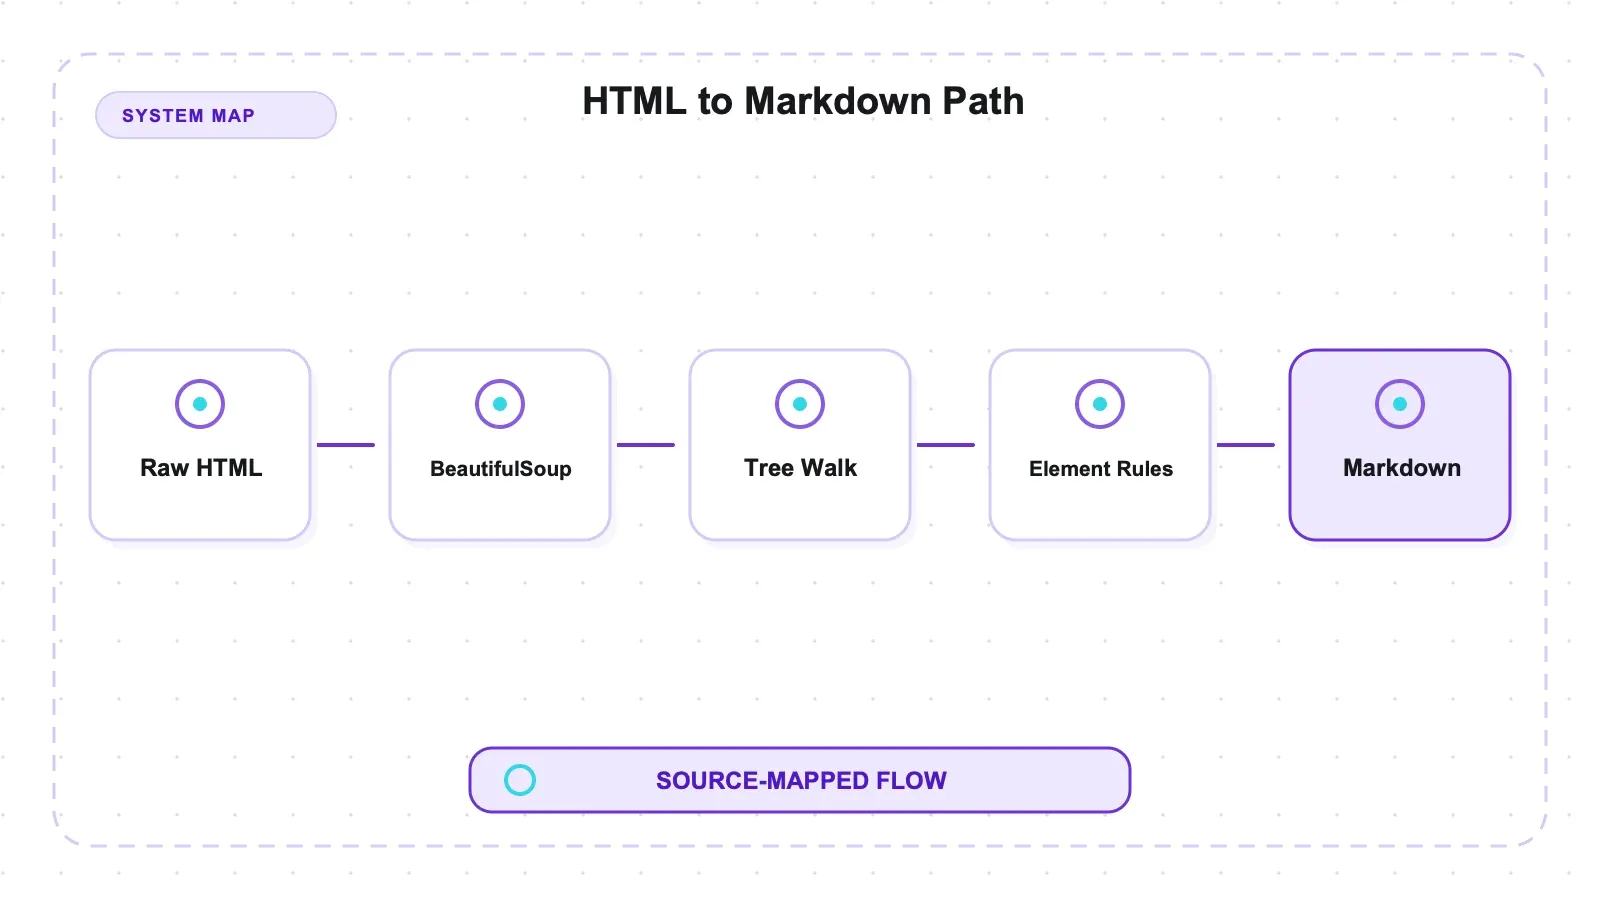
markdownify är en Python-konverterare från HTML till Markdown byggd ovanpå BeautifulSoup. Det är hela arkitekturen: parsa med BeautifulSoup, gå igenom trädet, skriv ut Markdown. Testad version: 1.2.3, MIT, 2 235 stjärnor, 42 öppna ärenden, senaste släpp 2026-06-30 — aktivt underhållet, 44 releaser.
Officiell referens: python-markdownifys officiella repository.
API:t är en funktion:
from markdownify import markdownify
md = markdownify(html)
Det finns en klassvariant (MarkdownConverter) om du vill styra hur enskilda element hanteras, och en bra uppsättning inställningar — rubrikstil, punkttecken, identifiering av kodspråk, borttagning av element. Men det är enkelraden som är standardfallet, och den fungerar.
pip install markdownify drar in 5 paket och 1,8 MiB, och kallimporterar på 0,046 s — snabbast av de tre konverterare jag testade mot. Beroendeträdet består av BeautifulSoup och dess vanliga följeslagare, som många Python-projekt redan har, så den extra kostnaden är ofta nära noll.
Mätningen
Jag körde det på de fyra HTML-fixtures som ett annat paket i den här basen redan hade använt för markitdown, med det paketets förregistrerade probesträngar — 16 exakta brödtextsträngar som kontrollerades för att se om de överlevde, plus kontroller för sidans grundläggande chrome. En femte fixture, Nothing but tables, är ett separat diagnosfall med mycket tabeller och ingår inte i den fyra-fixture-aggregatet nedan.
| Konverterare | Brödtextprober | Outputtecken | Token (o200k) | Markdown-tabellrader | Länkar |
|---|---|---|---|---|---|
| markdownify | 16/16 | 76 868 | 21 062 | 36 | 599 |
| html2text | 16/16 | 76 452 | 21 176 | 32 | 545 |
| markitdown | 16/16 | 76 995 | 21 336 | 36 | 598 |
| turndown | 16/16 | 95 188 | 26 236 | 0 | 611 |
fourway-scores.json. Fyra fixtures, token räknade med o200k_base, tabellrader räknade med samma regel över alla fyra — inklusive en omräkning av markitdowns sparade output, som matchade dess publicerade siffra exakt.
Tre saker sticker ut.
Det går jämt upp med markitdown i antal utskrivna tabellrader. 36 rader vardera på de fyra delade fixturesen, räknat med samma heuristik. Det bevisar inte cell-för-cell-ekvivalens; det betyder att båda outputterna exponerade samma antal igenkännbara Markdown-tabellrader för den här räknaren.
Det har lägst tokenantal. 21 062, marginellt under html2texts 21 176 och markitdowns 21 336, och 19,7 % under turndowns 26 236. De tre första ligger inom 1,3 % av varandra, vilket jag skulle kalla ett oavgjort läge snarare än en seger; den verkliga skillnaden är mot turndown.
Varje innehållsprobe överlevde. Alla 16. Det gjorde de också för de andra tre — innehållsöverlevnad är inte där de här biblioteken skiljer sig åt.
Tabellen den hanterar rätt
Hockeystatistik-fixturen är där konverterarna skiljs åt. markdownify:
| Team Name | Year | Wins | Losses | OT Losses | Win % | ... |
| --- | --- | --- | --- | --- | --- | --- |
| Boston Bruins | 1990 | 44 | 24 |  | 0.55 | ... |
Standard-GFM med inledande och avslutande pipes, en separatorrad och — notera den tomma cellen mellan 24 och 0.55 — den skriver ut den tomma cellen i stället för att hoppa över den. Det låter trivialt, men är det inte: en konverterare som tappar tomma celler flyttar alla efterföljande värden till fel kolumn, och outputen ser ändå ut som en giltig tabell.
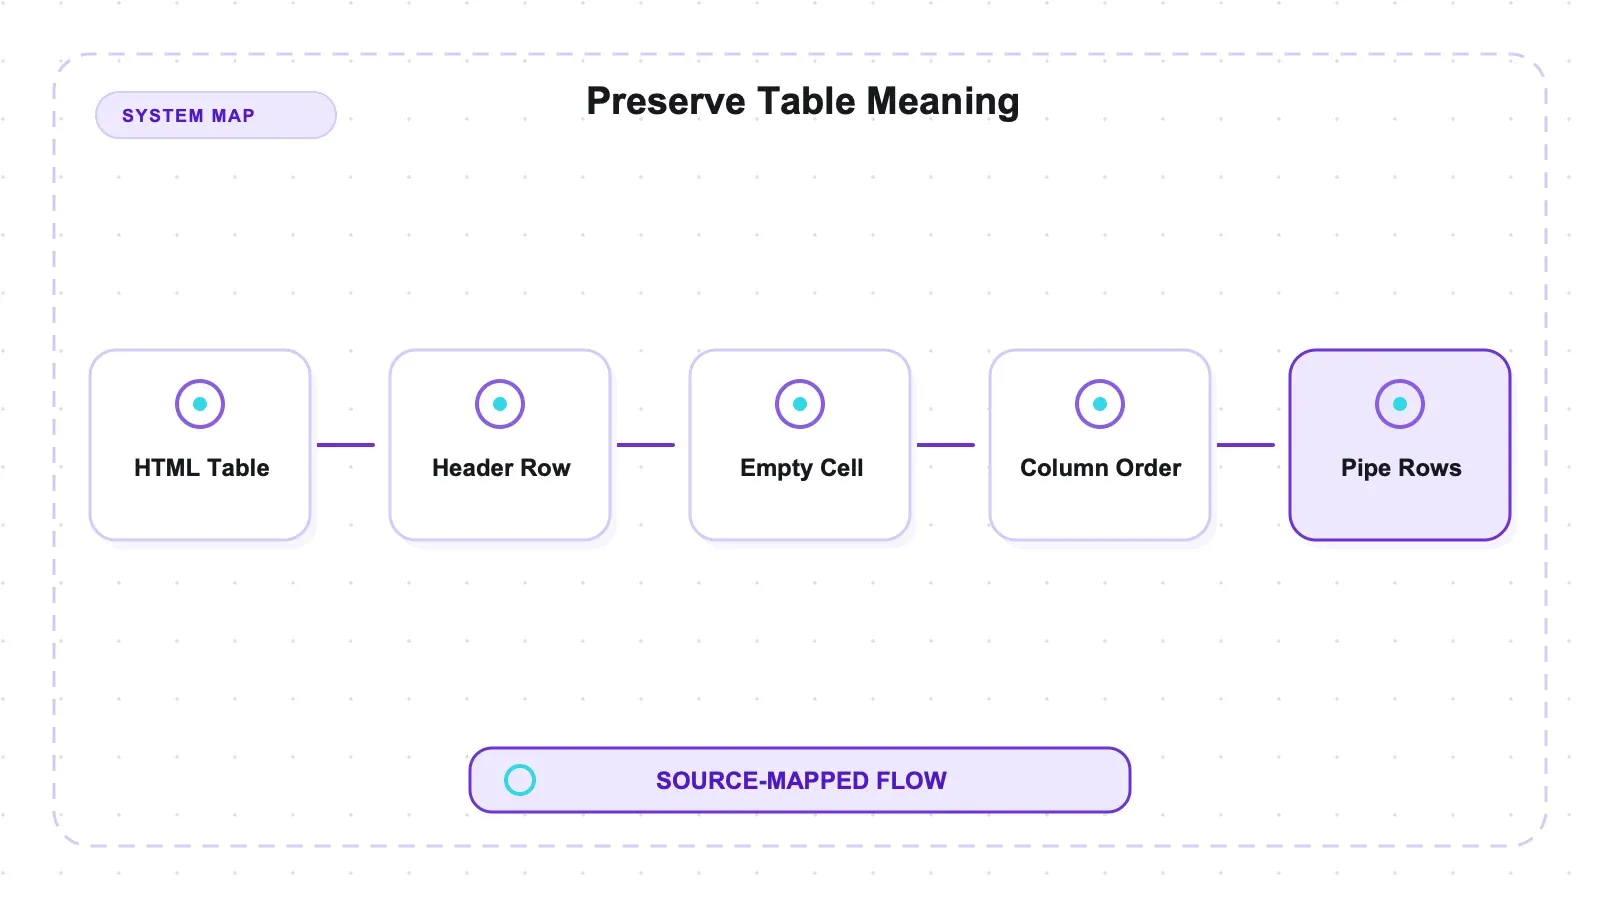
turndown på samma input gör om varje värde till ett eget stycke utan någon kolumnstruktur alls. html2text skapar en korrekt tabell i en annan stil, utan de yttre pipesen.
Om Markdownen ska vidare till en modell är det pipesen och den bevarade tomma cellen som gör att den kan svara "hur många matcher förlorade Boston" i stället för att gissa.
Två saker den tar bort som turndown inte gör
Tabellprecisionen är den synliga skillnaden. Den här är större, och ingen pratar om den.
markdownify tar bort innehåll i <script> och <style>. turndown gör inte det. Räknat via markörer som bara förekommer i de elementen har markdownifys output över fixturesen noll scriptmarkörer och noll stylemarkörer; turndowns har 10 och 84. På Wikipedia-fixturen är det skillnaden mellan 59 561 tecken och 74 939 — och åtta rader med MediaWikis inbyggda JavaScript-konfiguration och CSS står för 14 644 tecken, alltså 95 % av hela gapet (script-style-stripping.json).
För allt som ska matas till en modell är det här den dyraste delen i hela jämförelsen: ett JavaScript-konfigurationsblock kostar token men innehåller ingen användbar information alls. markdownify tar bort det utan att bli ombedd. html2text gör det också.
Per fixture är markdownify och html2text helt överens där tabellen är enkel och skiljer sig där den inte är det:
| Fixture | markdownify | html2text |
|---|---|---|
| Hockey statistics | 27 rader | 27 rader |
| Wikipedia | 9 rader | 5 rader |
| Nothing but tables (separat diagnos) | 62 rader | 59 rader |
markdownify skriver ut fler igenkända rader i båda diagnosjämförelserna. På Wikipedia håller det särskilt fast vid nio rader där html2text håller fem enligt den här räknaren. Det är en bra signal att granska representativa nästlade och oregelbundna tabeller innan du väljer, inte ett bevis på att varje utskriven cell är semantiskt korrekt.
Installation och licens, jämfört med alternativen
| Bibliotek | Paket | Disk | Kallimport | Licens | Stjärnor | Senaste release |
|---|---|---|---|---|---|---|
| markdownify | 5 | 1,8 MiB | 0,046 s | MIT | 2 235 | 2026-06-30 |
| html2text | 1 | 0,2 MiB | 0,077 s | GPL-3.0-or-later | 2 168 | 2025-04-15 |
| turndown | 3 (npm) | 8,8 MiB | 0,056 s | MIT | 11 386 | 2026-04-03 |
Officiell referens: markdownify på PyPI.
install-and-import.json och metadata-snapshot.json. Varje bibliotek installerades i en egen tom miljö.
html2text är nio gånger mindre på disk, och det är GPL-3.0-or-later. För en distribuerad produkt bör detta ses som en avstämningspunkt för den som äger licensfrågan; artikeln är inte juridisk rådgivning. markdownify är MIT, vilket generellt är mer tillåtande, men det hör fortfarande hemma i den vanliga compliance-granskningen.
De 1,8 MiB är också något teoretiska om ditt projekt redan använder BeautifulSoup, vilket många Python-scrapingprojekt gör — i så fall är markdownify nära gratis.
markdownifys releasetakt är den friskaste av de tre: 44 releaser och en push sex veckor före testet, jämfört med html2texts senaste release i april 2025.
Vad en enda Python-rad faktiskt ger dig
Hela biblioteket är markdownify(html), och det är värt att vara tydlig med vad det anropet bestämmer åt dig, eftersom tre av de besluten är just de som den här jämförelsen hängde på.
Det parsar med BeautifulSoup, tar bort <script> och <style> utan att du behöver be om det, och skriver ut tabeller i GFM-stil med yttre pipes och bevarade tomma celler. Bara parserns släktträd garanterar inte hur trasig input hanteras, så den frågan mäts separat nedan.
Inget av detta är inställningar du själv sätter. Det är standardbeteendet, och i en kategori där turndowns standard behåller JavaScript och html2texts standard radbryter hårt vid 78 tecken är ett bibliotek vars out-of-the-box-beteende inte behöver rättas till värt något i sig.
Inställningar finns när du vill ha dem — heading_style, bullets, code_language, strip och convert för tillåt- och blocklistor av element, samt MarkdownConverter för överlagring per element. Allt som mättes här använde inga av dem.
Minne och vad trasig HTML gör med det
Det bredare stresstest-sammanhanget finns i jämförelsen av minne och felaktig HTML för tio bibliotek.
Två saker som varje granskning i den här omgången listade som otestade, är nu uppmätta.
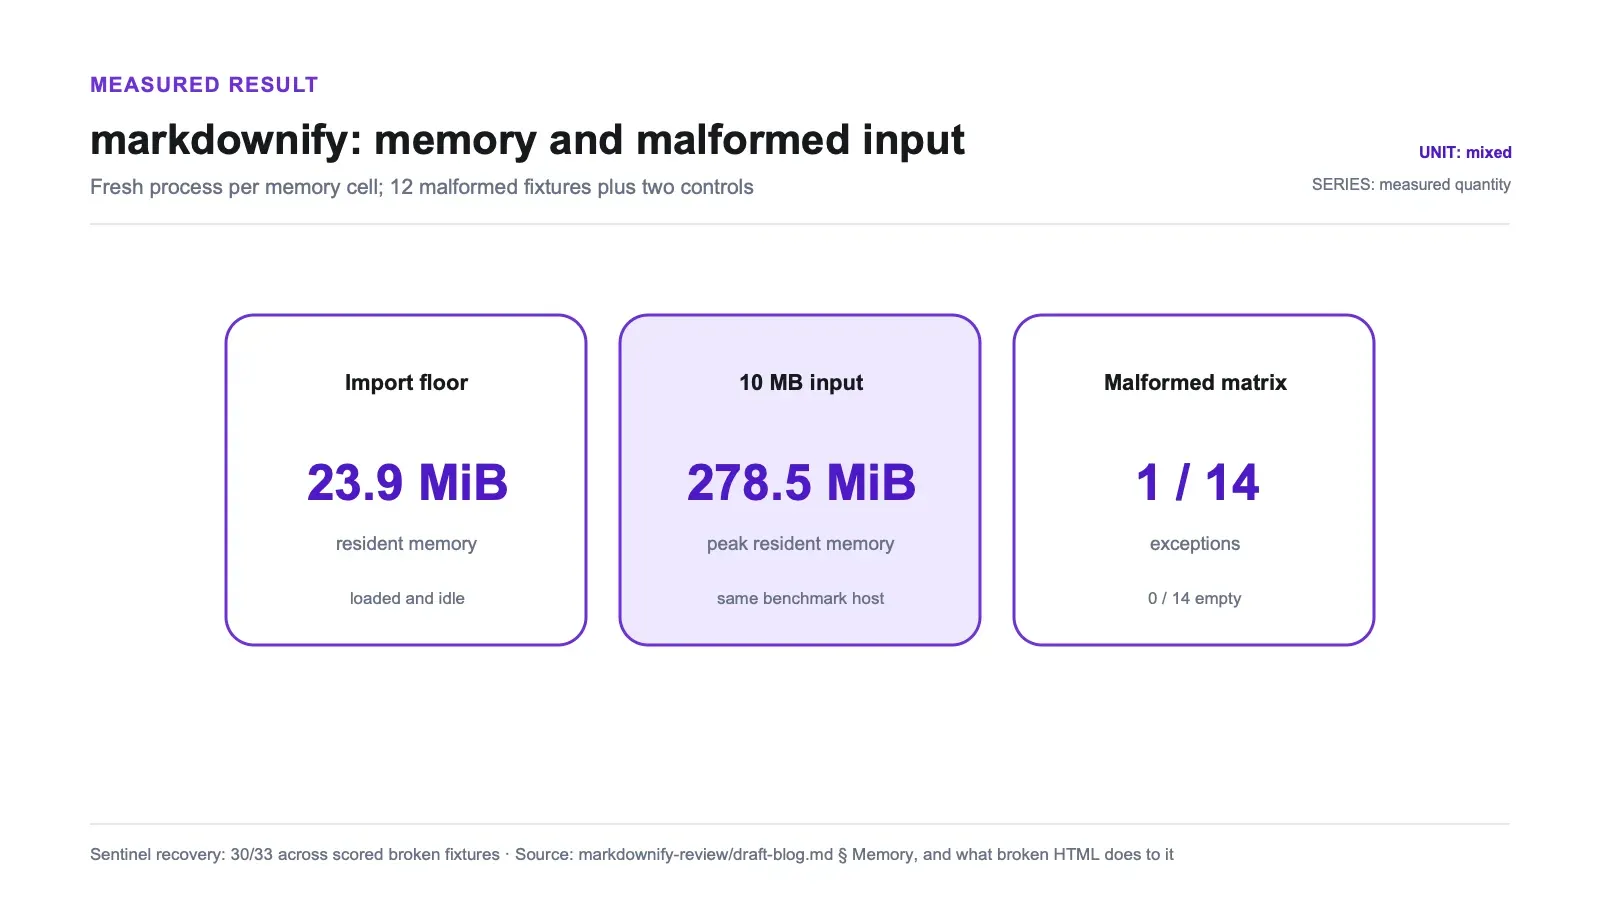
Maximalt resident minne, via /usr/bin/time -l, en ny process per cell — importgolvet är vad biblioteket kostar när det är laddat men overksamt, topparna inkluderar dokumentet.
| Bibliotek | Runtime | Importgolv | 226 KB topp | 10 MB topp |
|---|---|---|---|---|
| html2text | python3.14 | 18,7 | 19,9 | 71,2 |
| pyquery | python3.14 | 30,3 | 33,9 | 172,5 |
| resiliparse | python3.14 | 20,5 | 25,1 | 225,1 |
| markdownify | python3.14 | 23,9 | 28,9 | 278,5 |
| goose3 | python3.14 | 44,1 | 52,4 | 398,5 |
| cheerio | node22 | 66,8 | 76,5 | 398,5 |
| justext | python3.14 | 30,3 | 36,6 | 431,2 |
| newspaper4k | python3.14 | 52,6 | 61,8 | 668,5 |
| trafilatura | python3.14 | 52,5 | 64,8 | 927,1 |
| turndown | node22 | 47,8 | 68,4 | 2947,1 |
memory-results.json. Python- och Node-baslinjer är inte jämförbara med varandra; tolken ingår i båda.
markdownify hamnar i mitten: ett importgolv på 23,9 MiB och 278,5 MiB på ett 10 MB-dokument. Det är 3,9 gånger html2texts topp och ungefär en tiondel av turndowns, vilket är priset för att bygga på BeautifulSoup.
Trasig HTML. Tolv dokument där exakt en sak är trasig — oavslutade taggar, felnästlade inline-element, attribut utan citattecken med mellanslag, stray closers, ingen <html> alls, dubbla attribut, ett dokument avklippt mitt i en tagg, trasiga entiteter, ett oavslutat <script>, en felaktig charset-deklaration, en kommentar som innehåller markup och 600 nivåer av nästling — plus två välformade kontroller i matchande storlekar, eftersom "den returnerade inget" bara säger något om trasighet om biblioteket inte också är tyst på ett rent dokument av samma storlek.
markdownify kastade på 1 av 14 och returnerade ingenting på 0, samt återfick 30/33 kontrollsträngar i de trasiga fixturesen (malformed-results.json). En fixture är undantagen från den siffran: enligt HTML5 är allt efter ett oavslutat <script> faktiskt scriptinnehåll, så att förlora det där är korrekt och att återfå det är avvikelsen.
För- och nackdelar
Talar för det. Tabellprecision i nivå med markitdown, räknat med samma regel. Lägst tokenantal av de fyra. MIT. 1,8 MiB, och nära noll extra kostnad om BeautifulSoup redan finns i trädet. Snabbaste kallimporten på 0,046 s. Aktivt släppt. Bevarar tomma tabellceller. Per-element-anpassning via MarkdownConverter. Den enkla enkelraden är rätt val.
Talar emot det. Bygger på BeautifulSoup, så det blir nio gånger diskstorleken jämfört med html2text om du inte redan har det. 2 235 stjärnor betyder en mindre community än turndowns — färre färdiga exempel när du stöter på något ovanligt. Bara Python, alltså ingen hjälp i en Node-stack. Och 42 öppna ärenden.
Vem bör använda det, och vem bör inte
Börja med markdownify för en Python-arbetslast som liknar de här fixturesen. Det matchar markitdowns antal utskrivna rader under den här räknaren, ligger i det lägsta tokenklustret och är MIT-licensierat. Om du redan är beroende av BeautifulSoup kan den extra installationsytan vara liten; verifiera det faktiska beroendetillskottet i din miljö.
Överväg html2text i stället om beroendebudgeten räknas i hundratals kilobyte och dess outputformat fungerar för dina sidor. Granska GPL-3.0-or-later med den som äger licensfrågan innan distribution.
Överväg markitdown i stället om du redan konverterar PDF:er eller Office-dokument. Deras HTML-resultat hade samma antal utskrivna rader här, men bredare precision visades inte vara ekvivalent.
Hoppa över det i Node, där turndown är det naturliga svaret — med turndown-plugin-gfm installerat bredvid, eftersom turndowns kärna inte producerar några tabeller alls.
Var en hanterad API-lösning passar in
markdownify konverterar HTML som du redan har. Den hämtar inte, renderar inte JavaScript och hanterar inte något anti-bot-lager — inget av de fyra konverterarna gör det, och på många riktiga mål är det den svårare halvan av jobbet.
För samma fixtures över alla fem konverterare, se femvägsjämförelsen av HTML till Markdown.
Vår egen utvecklarstack på Thunderbit löser det uppströms arbetet: POST /distill hämtar en URL och returnerar Markdown, medan POST /extract returnerar schemaformad JSON. Båda finns via MCP-server och CLI; prissättning finns på Thunderbits prissida. De hostade endpointsen benchmarkades inte mot de här lokala konverterarna, så detta är en kategoriskillnad, inte en prestandajämförelse.
Det ärliga sättet att se det: om du redan har HTML och vill ha Markdown är markdownify gratis och gör jobbet lika bra som något annat här. Om du hämtar sidor, eller vill ha rader i stället för text, är det ett annat köp.
För det bredare fältet täcker vår översikt över webbskrapnings-API:er hostade alternativ och öppen källkod-pelaren för scrapers de egenhostade. Konvertera HTML till Markdown i Python är den praktiska genomgången.
Testa Thunderbit för webbdatauttag
Borde du använda markdownify?
För Python är det en stark kandidat när din input liknar de här fixturesen; testa det på dina egna tabeller och trasiga sidor innan du gör det till standard.
Det går jämt upp med markitdown i antal utskrivna tabellrader, ligger i det lägsta tokenklustret, importerar snabbast i den här körningen och är MIT-licensierat. Samtidigt använder det mer minne än html2text, är bara för Python och kastade på en trasig-fixture. Disk och licens är dessutom viktiga urvalsfaktorer, inte de enda argumenten.
Det som slår mig är stjärnantalet. turndown har fem gånger mer uppmärksamhet och konverterar, direkt ur lådan, inga av de tabeller som markdownify hanterar korrekt. Populariteten i den här kategorin följer alltså inte uppmätt beteende, vilket är en stor del av varför den här jämförelsen var värd att göra.
Testa Thunderbit för webbdatauttag Get Started Free
Vanliga frågor
Är markdownify verkligen lika bra som markitdown för HTML? På de här fyra fixturesen skrev de ut 36 igenkända Markdown-tabellrader vardera, återfick alla 16 kontrollerade strängar och producerade output inom 0,2 % i teckenmängd. Det är inte ett test på cellnivå eller renderingsekvivalens. markitdown hanterar dessutom PDF- och Office-format, så den här jämförelsen handlar bara om de uppmätta HTML-resultaten.
Behöver det BeautifulSoup? Ja — det är dess parser, och det står för större delen av de 1,8 MiB. Om ditt projekt redan använder BeautifulSoup är markdownifys marginalkostnad liten. Om inte, och disk verkligen spelar roll, är html2text 0,2 MiB med ett paket, men då med GPL-3.0-or-later-licens.
Hur hanterar det tomma tabellceller? Det skriver ut dem. I fixturen med luckor i datan behåller outputen den tomma cellen på rätt plats, så alla efterföljande värden stannar i rätt kolumn. En konverterare som hoppar över tomma celler producerar en tabell som fortfarande ser giltig ut men där varje värde har flyttats ett steg åt vänster, vilket är det sämre felet eftersom inget avslöjar det.
Ska jag använda funktionen eller klassen?
markdownify()-funktionen för standardfallet. MarkdownConverter när du behöver styra hur ett specifikt element konverteras — allt som mättes här använde den vanliga funktionen med standardinställningar.
Vad testades inte här? Fyra delade fixtures plus en tabell-only-diagnos är inte ett representativt corpus. Den separata trasighets-sviten täckte 12 namngivna feltyper och två kontroller, men inte alla former av trasig HTML. Nästlade listor, definitionslistor, fotnoter, matematik, Markdown-till-HTML-roundtrips, cellnivå-ekvivalens i tabeller och konfigurationsvarianter jämfördes inte heller. Konverteringshastighet jämfördes inte heller.




