
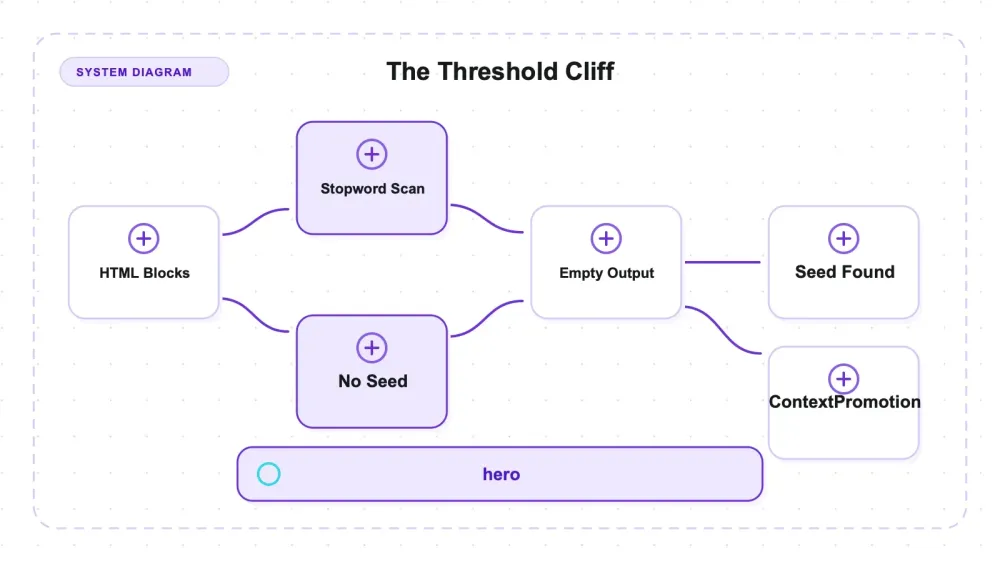
I ett dokument där det längsta stycket är 151 tecken ger jusText med standardinställningar noll tecken tillbaka. Inte ens en halv extraktion — bara en tom sträng. Sänker man ett tröskelvärde så att exakt ett stycke passerar det, får samma dokument 832 tecken. Sänker man det ännu mer blir resultatet fortfarande 832.
I den här fixture-miljön beter sig verktyget mer som en skarp kant än som en mjuk lutning. Om standardvärdet ligger på fel sida avgörs det av styckenas längd och mängden boilerplate i mål-korpuset.
Vad jusText är, och varför lexikal densitet spelar roll
Jämfört med de andra extraktorerna i det här fixture-setet är jusText ovanligt starkt beroende av språk-specifik stopword-densitet. Ett block med hög andel funktionsord — the, and, of, was — är mer sannolikt löptext. Den lexikala signalen är dock inte hela klassificeraren: styckelängd, länk-densitet, HTML-baserade blockgränser, avstånd till rubriker, närliggande klasser och ett kontextkänsligt steg påverkar också utfallet.
Officiell referens: jusTexts officiella repository.
Eftersom klassificeraren använder en språklista med stopord levereras jusText med 100 stycken. Den tydliga språk-specifika lexikala ytan är dess största skillnad i den här jämförelsen, även om stöd för flera språk inte testades.
Testad version: 3.0.2, BSD 2-Clause, 822 GitHub-stjärnor. Python 3.14.2.
Klippkanten, mätt
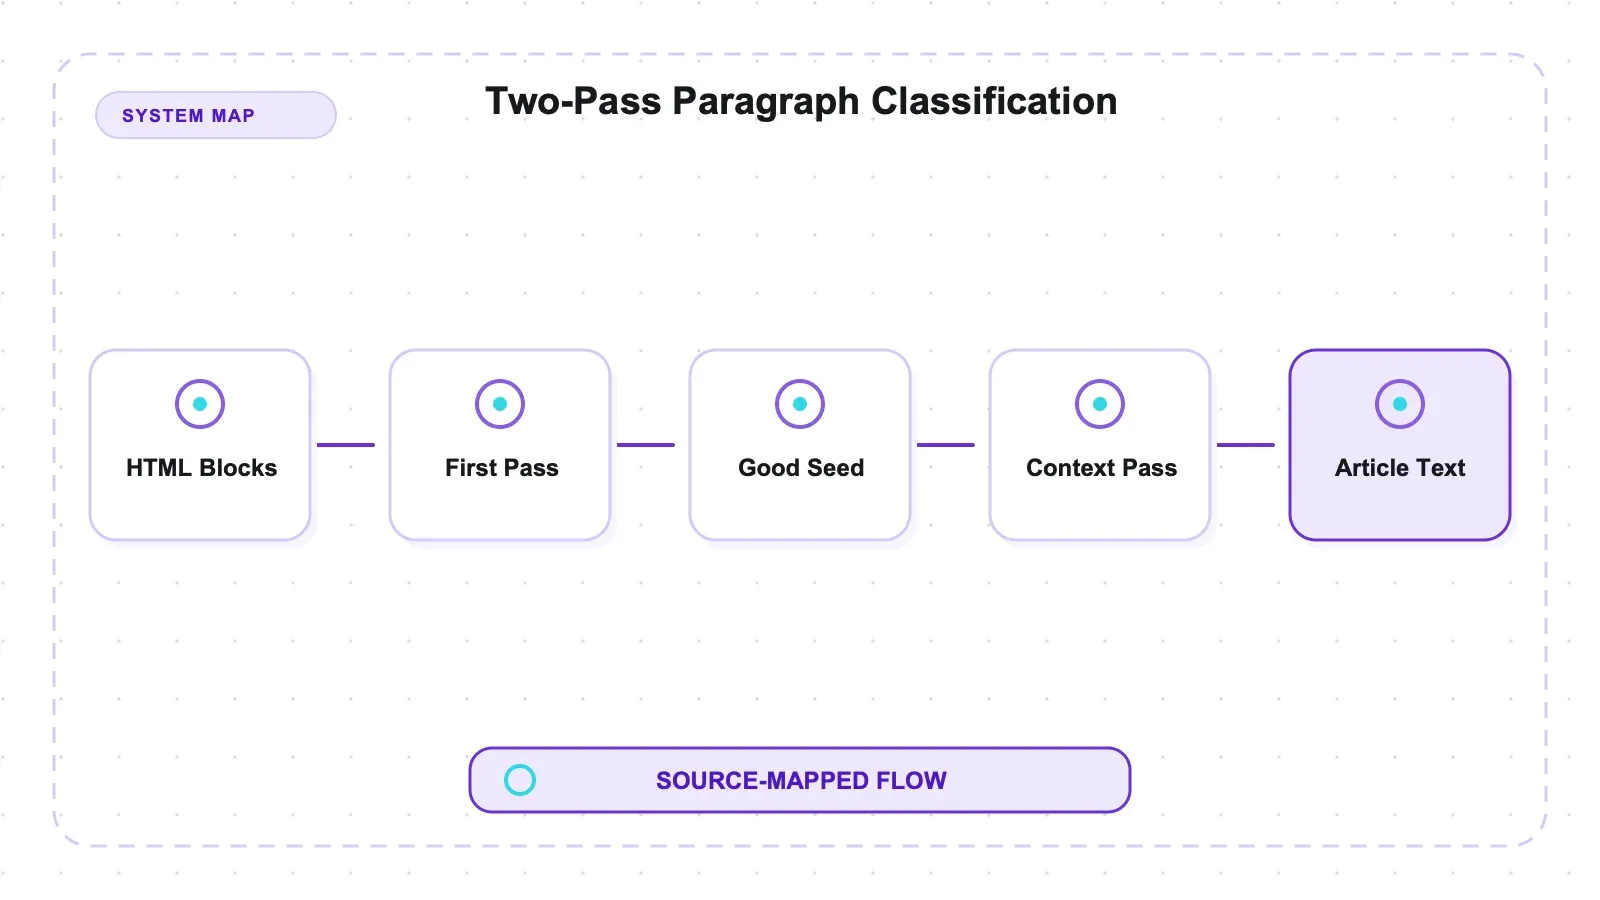
jusTexts klassificerare körs i två steg. I det första, utan kontext, får varje stycke klassningen good, bad, short eller neargood. I det andra, kontextkänsliga steget, kan neargood uppgraderas till good — men bara när det ligger intill ett block som redan är good. Ett stycke blir dessutom good på egen hand endast om det överstiger length_high, som som standard är 200 tecken.
I ett dokument där inget stycke passerar 200 finns ingen startpunkt för uppgraderingarna, och alla neargood-block faller tillbaka till boilerplate. Hela sidan kommer tillbaka tom.
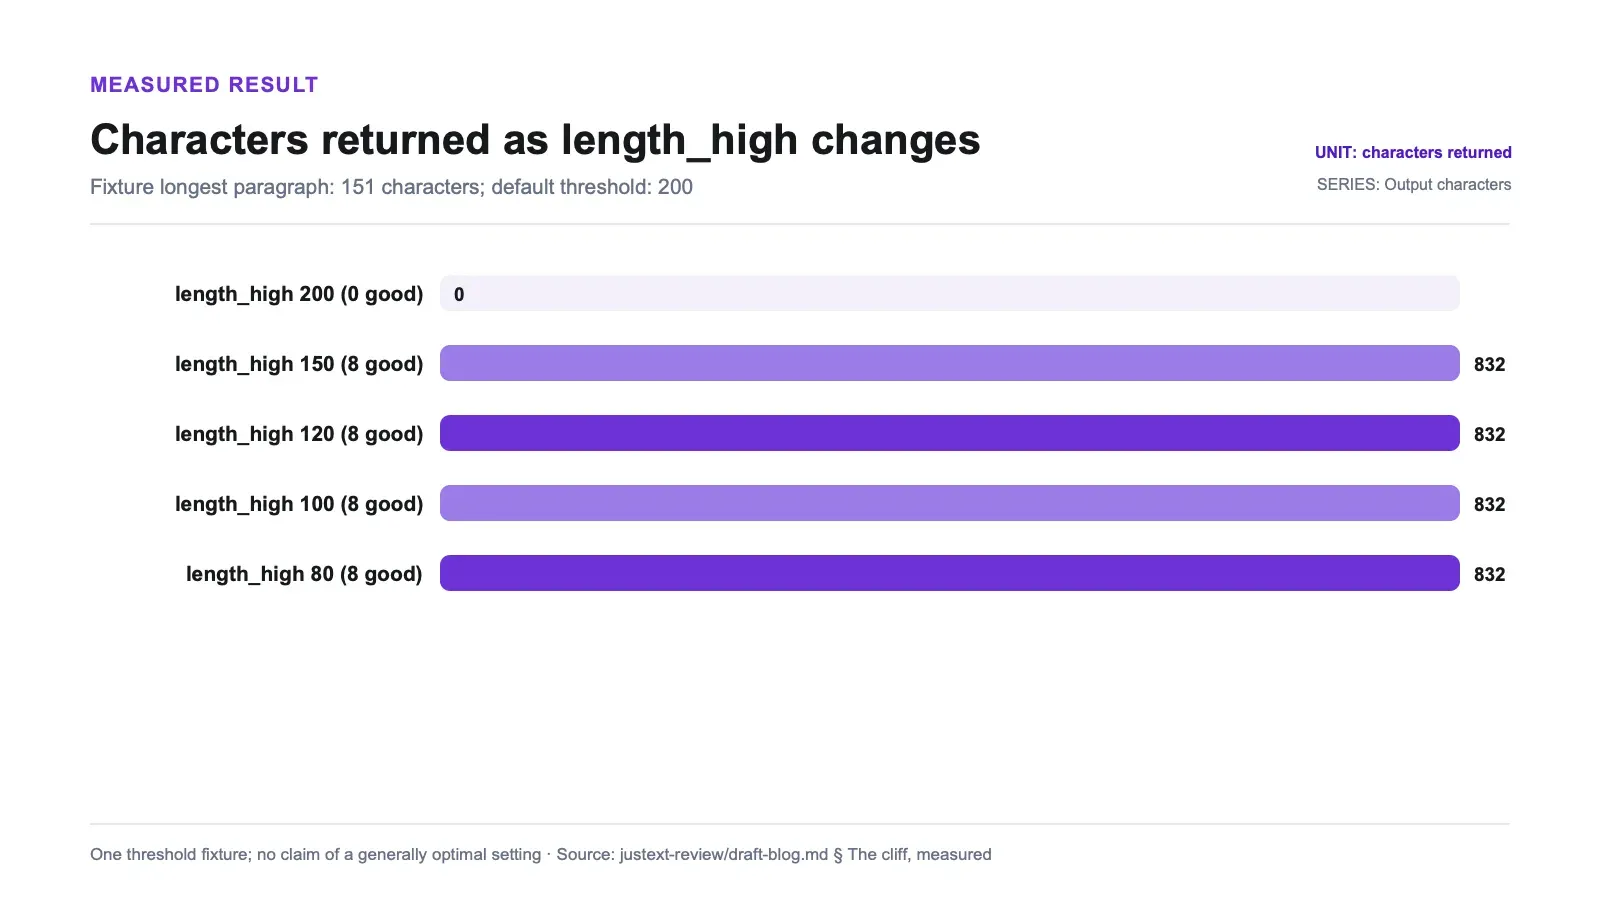
Jag testade tröskeln på en fixture där det längsta stycket är 151 tecken:
length_high | Stycken klassade som good | Tecken som returneras |
|---|---|---|
| 200 (standard) | 0 | 0 |
| 150 | 8 | 832 |
| 120 | 8 | 832 |
| 100 | 8 | 832 |
| 80 | 8 | 832 |
justext-length-threshold.json.
I den här tröskel-fixturen räckte det att ett stycke passerade gränsen för att alla åtta målstycken skulle börja komma ut, och att sänka tröskeln ytterligare gav inget mer. Mönstret stämmer med att kontext-steget uppgraderar lämpliga neargood-grannar runt ett befintligt good-block; det betyder inte att alla grannar uppgraderas var som helst.
Innan jag skyllde växlingen på length_high testade jag length_low över fyra värden i kombination med max_link_density över två: åtta kombinationer, alla gav noll. Att ändra någon av de två inställningarna återställde inte output i den här fixturen.
Över hela setet med 22 fixtures håller mönstret: 2 av 22 gav output vid length_high=200, 9 av 22 vid 150, 15 av 22 vid 120.
Två saker som detta inte säger. Det säger inte att jusText extraherar dåligt — på en verklig naturlig språk-sida med standardinställningar gav den 1 190 tecken ren artikeltext, eftersom ett riktigt nyhetsstycke klarar 200 tecken direkt. Och det säger inte att standardvärdet är fel; det säger att standardvärdet utgår från långa stycken, och du bör avgöra om ditt korpus verkligen ser ut så innan du kör något.
Den andra sidan av det här fixture-setet: högre läckage med standardvärden
I detta märkta fixture-set, med standardinställningar, har jusText den högsta uppmätta boilerplate-läckan.
| Bibliotek | Artikelåtervinning (alla 22) | Boilerplate-läckage | Precision för innehållstokens | Förorenande tokens |
|---|---|---|---|---|
| Readability | 1.0000 | 0.2353 | 0.9109 | 35 |
| trafilatura | 0.9865 | 0.0588 | 0.9411 | 4 |
| newspaper4k | 0.9865 | 0.0000 | 0.9452 | 0 |
| resiliparse | 0.9054 | 0.0588 | 0.9381 | 7 |
| jusText | 0.8378 | 0.4706 | 0.8760 | 74 |
| goose3 | 0.8243 | 0.0000 | 1.0000 | 0 |
sixway-scores.json. Ett fixture-set, en scorer, och varje enhet är märkt med en unik sentinel så att återhämtningen blir exakt substring-matchning.
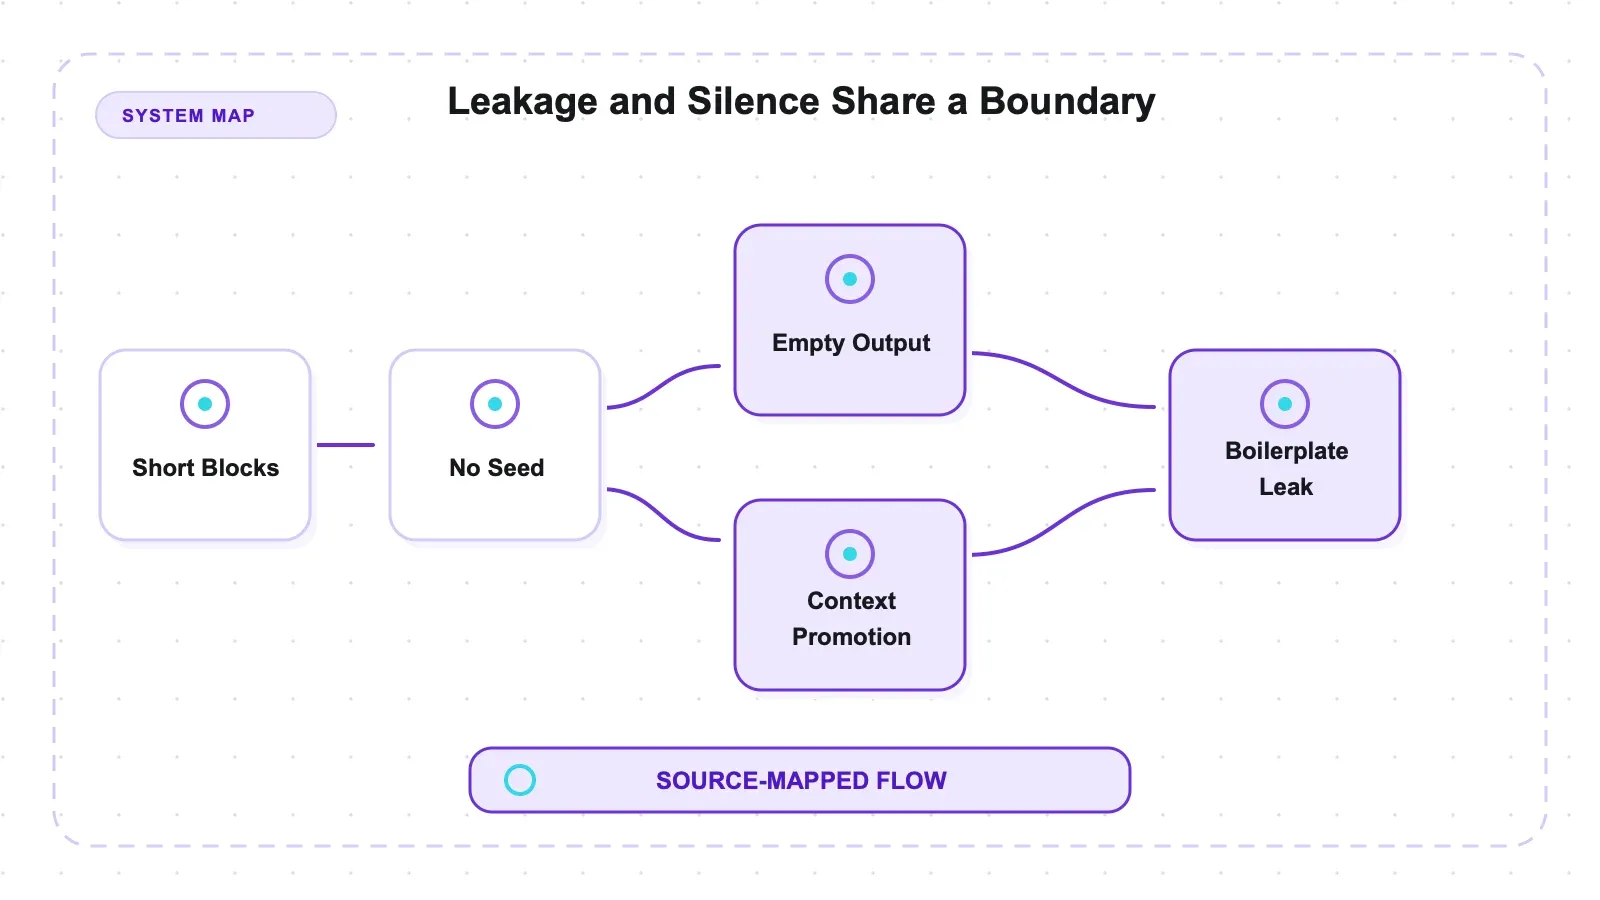
47 % boilerplate-läckage och 74 förorenande tokens — dubbelt så hög läckagenivå som Readability och mer än dubbelt så mycket förorening i det här märkta syntetiska setet. Detta är ett diagnostiskt resultat med standardvärden, inte en stabil produktövergripande ranking.
Det observerade läckaget stämmer med samma kontextsteg som spelar in i klippkanten. Lämpliga neargood-block kan uppgraderas när reglerna för omgivande blockklasser och avstånd tillåter det; en prosa-liknande promo eller kommentar bredvid artikeltext kan därför passera gränsen. Fixture-resultatet visar vilka märkta block som läckte, medan den förenklade mekanismen fortfarande är villkorad av jusTexts exakta kontextregler.
Dess återvinning är 0.8378, tredje sämst, och hela förlusten sitter i tröskeln: den hämtade inget från en enstaka artikel på 129 tecken, inget från en sida med tio korta stycken och inget från det nästan tomma dokumentet.
Inventeringen av språklistor med stopord
Nittionio andra stoplistor.
justext.get_stoplists() returnerar 100 språk. Klassificeraren är språkparameteriserad från början, inte genom översättning av en engelsk heuristik, och att byta språk är en enda parameter:
import justext
paragraphs = justext.justext(html, justext.get_stoplist("Czech"))
text = "\n".join(p.text for p in paragraphs if not p.is_boilerplate)
trafilatura och goose3 har också språkrelaterat beteende, men i den här granskningen poängsattes ingen extraktor mot icke-engelsk ground truth. jusTexts 100 medföljande stoplistor gör den till en tydlig kandidat för flerspråkig utvärdering; inventeringen i sig bevisar inte extraktionskvalitet på de språken och säger heller inte att konkurrenterna täcker dem sämre.
API:t består av två funktioner och nio justerbara konstanter — length_low 70, length_high 200, stopwords_low 0.30, stopwords_high 0.32, max_link_density 0.20, max_heading_distance 200, plus hantering av teckenkodning. Smått, tydligt och fullt dokumenterat i signaturen.
Installation och hastighet
pip install justext hämtar 3 paket — minst i jämförelsen — och 22.4 MiB, på under två sekunder.
Officiell referens: jusText på PyPI.
| Bibliotek | Paket | site-packages | Kall import | Extraktion p50 |
|---|---|---|---|---|
| resiliparse | 5 | 21.0 MiB | 0.015 s | 0.06 ms |
| jusText | 3 | 22.4 MiB | 0.777 s | 0.56 ms |
| goose3 | 16 | 44.3 MiB | 2.181 s | 1.85 ms |
| newspaper4k | 22 | 47.5 MiB | 2.812 s | 2.69 ms |
| trafilatura | 17 | 69.9 MiB | 1.584 s | 0.51 ms |
install-and-import.json. Varje bibliotek i en egen tom virtualenv.
Tre paket och 22.4 MiB är ett litet beroende i den här jämförelsen, och 0.56 ms median för extraktion ligger nära trafilaturas 0.51 i det här testet. Mätningen av miljön delar inte upp paketstorleken efter filtyp, så den kan inte säga hur mycket av diskutrymmet som kommer från stoplistorna.
Underhållsfrågan, försiktigt besvarad
De daterade underhållsmått som används här är den senaste pushen till repositoryt och den senaste PyPI-versionen, båda 2025-02-25. Det var sjutton månader före testningen. Totalt åtta releaser, 91 forks, 9 öppna issues, inte arkiverat.
PyPI-klassificerarna anger Python-stöd upp till 3.9. Jag körde det på 3.14.2 och det installerades, importerades på 0.777 s och extraherade på 19 av 22 fixtures utan ett enda undantag.
Så metadata ligger fem Python-versioner efter verkligheten, och verkligheten är att det fungerar. Det är den viktiga skillnaden: ett tyst repository är en signal om support, inte automatiskt om funktion. För ett bibliotek vars hela algoritm är en publicerad metod från 2011 plus en uppsättning ordlistor är ”färdigt” ett rimligt läge — det finns inte mycket kvar att ändra, och stoplistor slits inte på samma sätt som en workaround mot bot-skydd gör.
Vad ett tyst repo däremot betyder: om du stöter på en bugg får du fixa den själv eller forka. Det ska vägas mot nio öppna issues, vilket inte ser ut som ett bibliotek som drunknar i olösta problem.
Minne, och vad trasig HTML gör med det
Två driftfrågor mäts separat här.
Det bredare stresstestet finns i jämförelsen av minne och trasig HTML för tio bibliotek.
Toppresidentminne, via /usr/bin/time -l, en ny process per cell — importgolvet är vad biblioteket kostar när det är laddat och idle, topparna inkluderar dokumentet.
| Bibliotek | Runtime | Importgolv | 226 KB topp | 10 MB topp |
|---|---|---|---|---|
| html2text | python3.14 | 18.7 | 19.9 | 71.2 |
| pyquery | python3.14 | 30.3 | 33.9 | 172.5 |
| resiliparse | python3.14 | 20.5 | 25.1 | 225.1 |
| markdownify | python3.14 | 23.9 | 28.9 | 278.5 |
| goose3 | python3.14 | 44.1 | 52.4 | 398.5 |
| cheerio | node22 | 66.8 | 76.5 | 398.5 |
| justext | python3.14 | 30.3 | 36.6 | 431.2 |
| newspaper4k | python3.14 | 52.6 | 61.8 | 668.5 |
| trafilatura | python3.14 | 52.5 | 64.8 | 927.1 |
| turndown | node22 | 47.8 | 68.4 | 2947.1 |
memory-results.json. Python- och Node-baslinjer går inte att jämföra direkt med varandra; tolken ingår i båda.
jusTexts golv är 30.3 MiB och dess topp på den här 10 MB-fixturen är 431.2 MiB, ungefär 14.2 gånger importgolvet och 43.1 gånger indata-storleken i absolut RSS. En fixture och en process räcker inte för att fastställa någon allmän skalningskurva; Python- och Node-baslinjerna förblir också icke-jämförbara.
Trasig HTML. Tolv dokument där exakt en sak går sönder — oavslutade taggar, felnästade inline-element, attribut utan citationstecken med mellanslag, lösa avslutare, ingen <html> alls, duplicerade attribut, ett dokument avklippt mitt i en tagg, dåliga entities, en oavslutad <script>, en ljugande charset-deklaration, en kommentar som innehåller markup och 600 nivåer av nästling — plus två välformade kontroller i matchande storlek, eftersom ”den gav inget tillbaka” bara säger något om trasighet om biblioteket inte också är tyst på ett rent dokument av samma storlek.
justext kastade undantag på 0 av 14 och returnerade inget på 13, och återhämtade 0/33 märkta sentinels över de trasiga fixtures (malformed-results.json). Den välformade korta kontrollen gav också 0 tecken; den välformade långa kontrollen var det enda icke-tomma resultatet med 1 333 tecken. De tolv trasiga fixtures förblev alla tomma, och fallet med oavslutad <script> undantas från scoring av sentinel-överlevnad. Den här batchen visar alltså parser-tålighet — inget undantag — men kan inte tillskriva tystnaden till trasig HTML snarare än den redan uppmätta storlekströskeln.
För- och nackdelar
Fördelar. 100 språk-stoplistor, och en klassificerare som faktiskt bygger på dem i stället för att översättas till dem. Minst antal beroenden i jämförelsen med 3 paket. 0.56 ms medianextraktion. Nio dokumenterade, tydliga tuning-konstanter. BSD 2-Clause. Kör rent på Python 3.14 trots klassificerare som stannar vid 3.9.
Nackdelar. Högst boilerplate-läckage i det här syntetiska testet med standardvärden: 47 %, och 74 förorenande tokens. Fixturen med korta stycken gav en tom sträng när inget stycke passerade length_high. Återvinningen var 0.8378 i det här setet. Den senaste registrerade pushen och releasen låg sjutton månader före testningen, så ägarskapet av underhåll måste vägas in.
Vem bör använda det, och vem bör låta bli
Utvärdera jusText för flerspråkiga korpusar eftersom den språk-specifika stoplist-ytan är tydlig och bred. Det här testet inventerade 100 stoplistor men mätte inte kvalitet på flera språk. Det är också en kandidat när ett beroende på tre paket och tydlig kontroll över trösklar passar i driftsättningen.
Hoppa över det om du matar en modell per token, där 74 förorenande tokens jämfört med goose3:s och newspaper4k:s noll är en direkt kostnad. Hoppa över det för sidor med korta stycken — produkttexter, listningar, changelogs, FAQ-poster — om du inte medvetet har satt length_high. Och hoppa över det om du behöver ett aktivt underhållet beroende av compliance- eller upphandlingsskäl, vilket är en verklig begränsning även när koden fungerar.
Om du använder det ändå, justera length_high mot ett märkt valideringsurval i stället för att kopiera standardvärdet eller en percentilregel. Testa rimliga trösklar och mät både artikelåtervinning och boilerplate-precision; att sänka gränsen kan fånga kort prosa men också lyfta oönskade grannblock.
Var en hanterad API-lösning passar in
jusText arbetar på HTML som du redan har, precis som allt annat i den här jämförelsen. Inget av dessa bibliotek hämtar en sida, renderar JavaScript eller hanterar ett anti-bot-lager.
För samma fixtures över alla sex extraktorer, se sex-biblioteksjämförelsen för extraktion.
En hostad tjänst för hämtning/rendering/extraktion, inklusive vår egen Thunderbit, täcker ett annat ansvarsskikt. Thunderbit benchmarkades inte här. Skillnaden är klassificering av tillhandahållen HTML-prosa kontra en tjänst som hämtar och bearbetar en URL; den här artikeln ger ingen kvalitetsjämförelse på samma mått.
Den ärliga bilden: jusTexts flerspråkiga stoplistor är en verklig och gratis kapacitet. Om ditt problem är att hämta sidor på många språk snarare än att klassificera prosa i dem, är det ett annat inköp.
För det bredare området täcker vår sammanställning av webbskrapnings-API:er hostade alternativ och översikten över open source-scrapers täcker självhostade. Om utdata ska in i en modell är att konvertera HTML till Markdown i Python platsen där mest precision går förlorad.
Prova Thunderbit för webbdataextraktion
Bör du använda jusText?
Det är en kandidat om korpusen är flerspråkig eller om dess fördelning av stycklängder gynnas av tydlig tröskeljustering. Validera båda egenskaperna innan driftsättning.
De 100 medföljande stoplistorna är en verklig designdetalj, men flerspråkig träffsäkerhet testades inte. Tröskelklippan går att justera; om ett lägre värde är acceptabelt beror på återvinning och boilerplate-precision mätt på ett märkt urval.
I det här engelska syntetiska setet med standardvärden läckte newspaper4k noll märkta boilerplate-enheter och återvann 0.9865 av artikel-enheterna. Det gör det till en kandidat i jämförelsen för den här arbetsbelastningen, inte en universell ersättningsrekommendation.
Prova Thunderbit för webbdataextraktion Get Started Free
Vanliga frågor
Varför returnerar jusText en tom sträng i stället för en partiell extraktion?
Klassificeraren har två steg. Ett stycke får klassen good på egen hand bara om det ligger över length_high (standard 200 tecken); i det andra steget uppgraderas grannblock som är neargood. Utan något stycke över tröskeln finns inget frö, så alla kandidater faller tillbaka till boilerplate och resultatet blir tomt. Det är all-or-nothing enligt konstruktionen, inte ett misslyckande att hitta ett delresultat.
Är jusText övergivet? Den senaste pushen till repositoryt och den senaste PyPI-versionen var båda 2025-02-25 — sjutton månader före testningen — och PyPI-klassificerarna stannar vid Python 3.9. Men det installerades och kördes på Python 3.14.2 utan undantag, och 9 öppna issues är inte någon stor backlogg. Läs datumen som underhållsrisk snarare än bevis på trasigt beteende; den praktiska risken är att du själv kan behöva fixa buggar.
Varför läcker det mer boilerplate än Readability? I det här fixture-setet korsade närliggande block som liknade prosa utdata-gränsen under standardreglerna för kontext. Uppgradering är villkorad av blockklass, avstånd och kontext, inte automatisk för varje granne. Det uppmätta resultatet blev 47 % boilerplate-läckage och 74 förorenande tokens med standardvärden.
Hur använder jag det för ett annat språk?
justext.justext(html, justext.get_stoplist("German")). get_stoplists() returnerar alla 100 tillgängliga. Stoplistan är den språk-specifika lexikala indata till en klassificerare som också använder styckelängd, länk-densitet, HTML-baserad segmentering, avstånd till rubriker och kontexten kring närliggande block. Det byter språkinput; det validerar inte i sig tysk extraktionskvalitet.
Vad testades inte här?
Verkliga sidor, alls — det här är kontrollerade fixtures med märkta enheter. Den flerspråkiga förmågan, som är bibliotekets stora säljpunkt, inventerades till 100 stoplistor men poängsattes inte på icke-engelsk text. Kodningskanter, trots att jusText exponerar parametrarna encoding, default_encoding och enc_errors. Och max_heading_distance samt de två stopword-ratio-trösklarna lämnades på standardvärden genom hela testet.




