
Skriv den skyddskod som alla använder:
try:
    r = requests.get(url, timeout=0.5)
except requests.exceptions.Timeout:
    retry()
Peka den mot en server som skickar statusraden och headers direkt och sedan låser sig innan body kommer. Läsningen går på timeout. Skyddet triggas inte. Undantaget som kommer ut är ConnectionError, och ConnectionError är inte en underklass till Timeout.
Samma typ av stopp mot httpx ger ReadTimeout, som är en TimeoutException, och det fångar motsvarande skyddskod.
Jag började leta efter hur httpx skiljer sig från requests på sätt som ställer till det för web scraping, och tänkte att jag skulle skriva om async. Det visade sig vara det minst intressanta på listan.
Vad jag testade och hur
Åtta kontroller mot en lokal testserver, eftersom en klient som själv säger vad den gjorde inte är bevis för vad den faktiskt gjorde. Servern räknar TCP-anslutningar — ökar med ett för varje accepterat socket, innan någon request line ens tolkas — och sökvägar som faktiskt hämtats. Återanvändning av anslutningar och redirect-hantering är båda påståenden om trafiken på nätet, och det är där de kan verifieras.
httpx 0.28.1 med http2-extrat, requests 2.34.2, Python 3.14.2, macOS arm64. Båda kördes i samma nyinstallerade virtualenv så att ingen av dem ärvde något från den andra. Rådata: httpx-probes.json.
Sex förutsägelser lades in i testharnessen innan första körningen och låg kvar efteråt. Tre stämde, två var fel, en var rätt för det jag tänkte på men missade det som faktiskt spelade roll. prediction-scorecard.json innehåller bokföringen.
Standardinställningar som ändrar beteende under dig
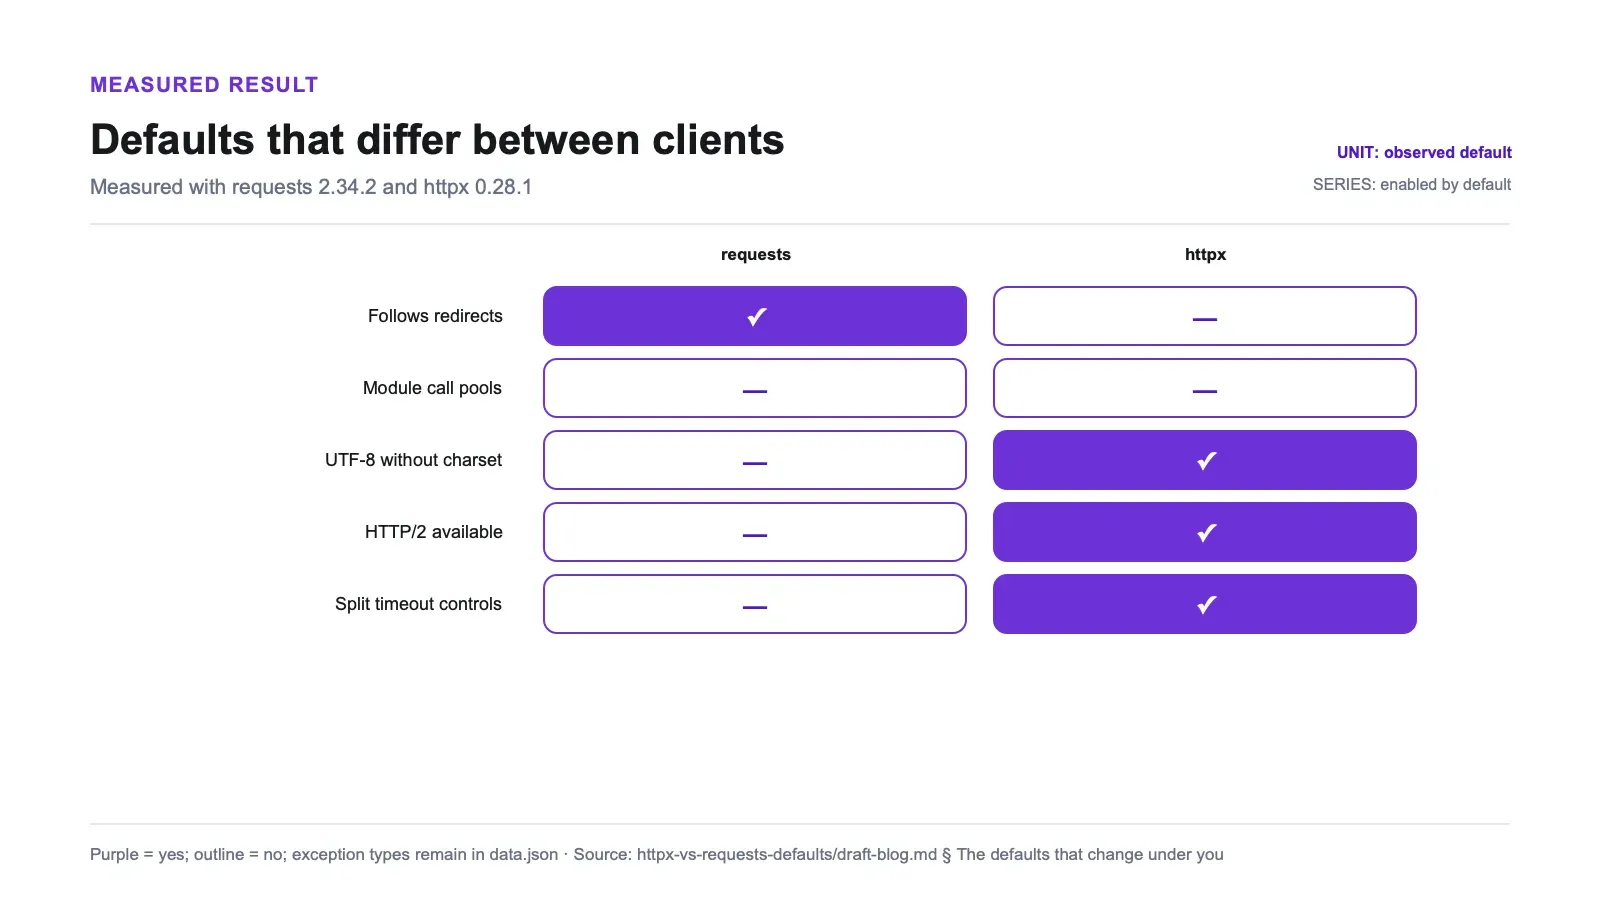
| Beteende | requests 2.34.2 | httpx 0.28.1 |
|---|---|---|
| Följer redirects som standard | ja | nej |
| Funktionsanrop på modulnivå återanvänder anslutningar | nej | nej |
| Stopp innan headers | ReadTimeout | ReadTimeout |
| Stopp mitt i body | ConnectionError | ReadTimeout |
| Ingen charset angiven | ISO-8859-1 | utf-8 |
| HTTP/2 | inte tillgängligt | valbart, fungerar |
| Separata timeoutar för connect/read/write/pool | nej | ja |
Redirects, återanvändning av sockets, undantagsresultat, avkodning och protokollförhandling observerades i testkörningar. Formen på timeout-API:t och att requests saknar en HTTP/2-flagga är observationer om API-funktioner. httpx-probes.json.
Tre av de här raderna kommer att ändra vad din kod gör den dag du byter, utan att säga till.
Redirects: avstängda som standard, och servern bevisar det
En redirect-kedja med fyra hopp som slutar på /ok:
| Klient | Servern såg | Returstatus |
|---|---|---|
| requests | 5 requests | 200 |
| httpx | 1 request | 302 |
httpx, follow_redirects=True | 5 requests | 200 |
Femman är fyra hopp plus målet. Min förutsägelse sa fyra, vilket var huvudräkning jag inte kontrollerade; riktningen i påståendet var det viktiga, och räknandet rättas här i stället för att smygas in i texten.
Det här är dokumenterat beteende i httpx och ett fullt rimligt designval — en redirect är något anroparen kanske vill veta om. Men det är också det vanligaste sättet en migration går sönder utan att något kastas. Din kod får en 302, response.text är tom, din parser hittar inga rader, och loggarna säger 200 OK… fast egentligen står det 302, och ingen tittade på statuskoden eftersom det aldrig behövdes med requests.
Timeout-fyndet, som är det jag hade bakvänt
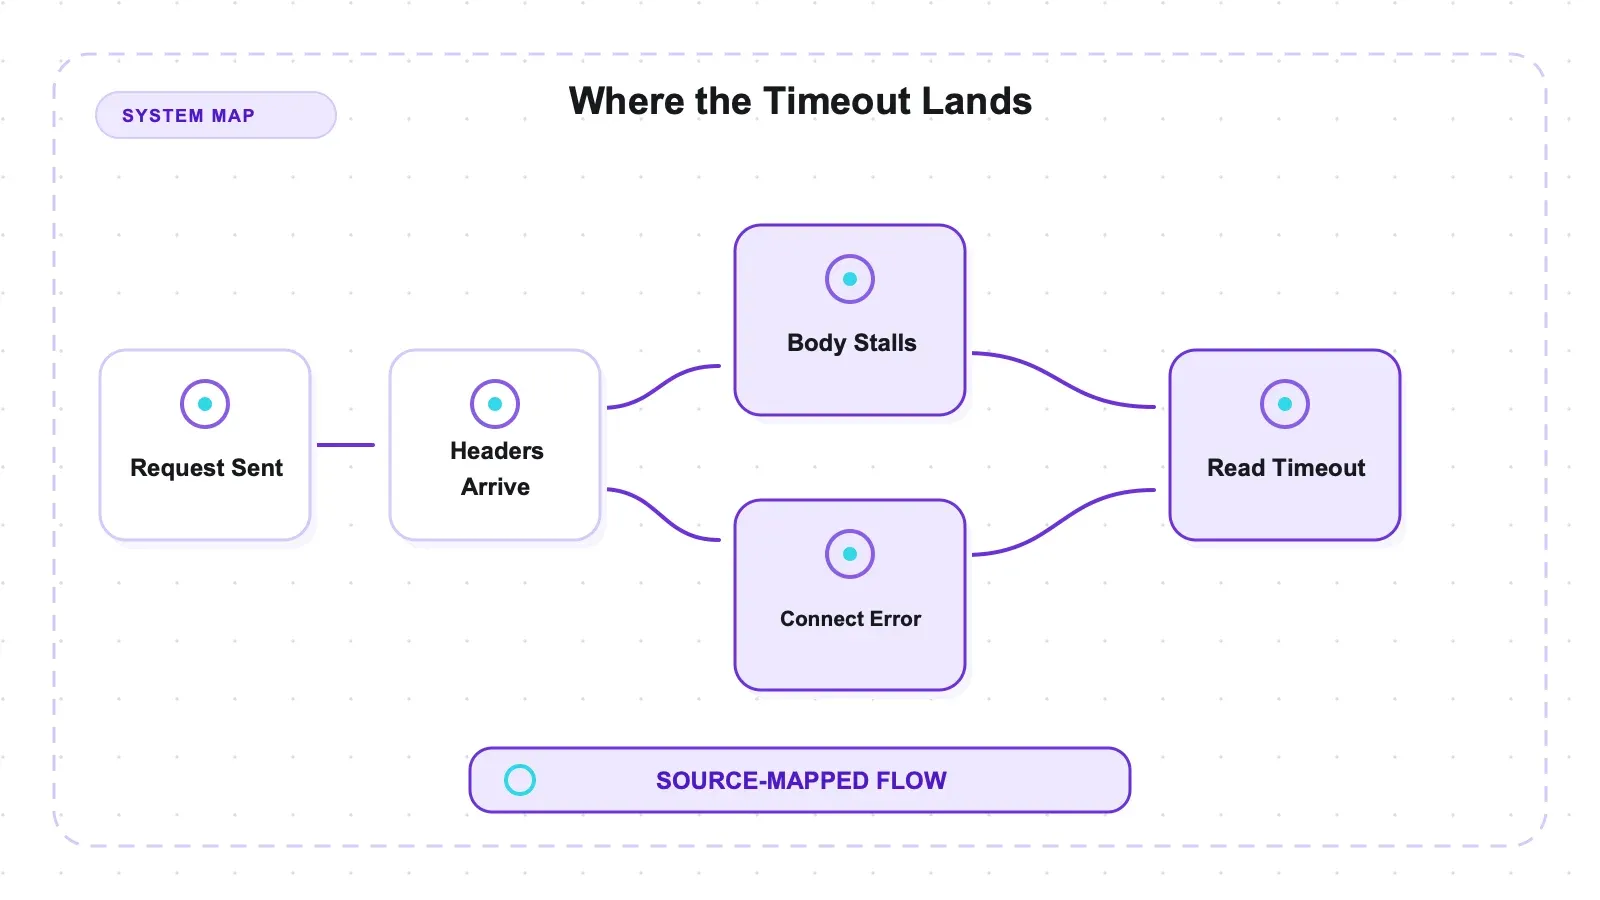
Jag förutsåg att httpx skulle namnge den fas som misslyckades och att requests skulle slå ihop båda i en klass. Det är tvärtom.
Officiell referens: Requests timeout documentation.
Officiell referens: HTTPX timeout documentation.
| Stopp | requests | httpx |
|---|---|---|
| Före statusraden | ReadTimeout | ReadTimeout |
| Mitt i body, efter att headers skickats | ConnectionError | ReadTimeout |
httpx ger samma, korrekta namn till båda. requests skiljer dem åt — och delar upp dem över just den gräns som retry-kod brukar byggas mot.
Konsekvensen är inte en slutsats från klasshierarkin. Jag körde skyddskoden:
| Stopp | except requests.exceptions.Timeout | except httpx.TimeoutException |
|---|---|---|
| Före statusraden | fångas | fångas |
| Mitt i body | glider förbi som ConnectionError | fångas |
timeout-retry-guard.json. requests.exceptions.ConnectionError är inte en underklass till requests.exceptions.Timeout; httpx.ReadTimeout är en underklass till httpx.TimeoutException.
Meddelandet från requests säger Read timed out. inne i en ConnectionError. Biblioteket vet vad som hände. Det berättar bara inte det för typsystemet, och det är typsystemet som din except-sats frågar.
Det uppmätta fallet är specifikt: headers kommer fram, och sedan upphör body-att ta emot data tillräckligt länge för att read timeout ska passeras. En respons som fortsätter leverera chunkar inom timeoutfönstret, inklusive en avsiktlig ström, kan bete sig annorlunda och testades inte här.
Connection pooling: klient-API:t är hela skillnaden
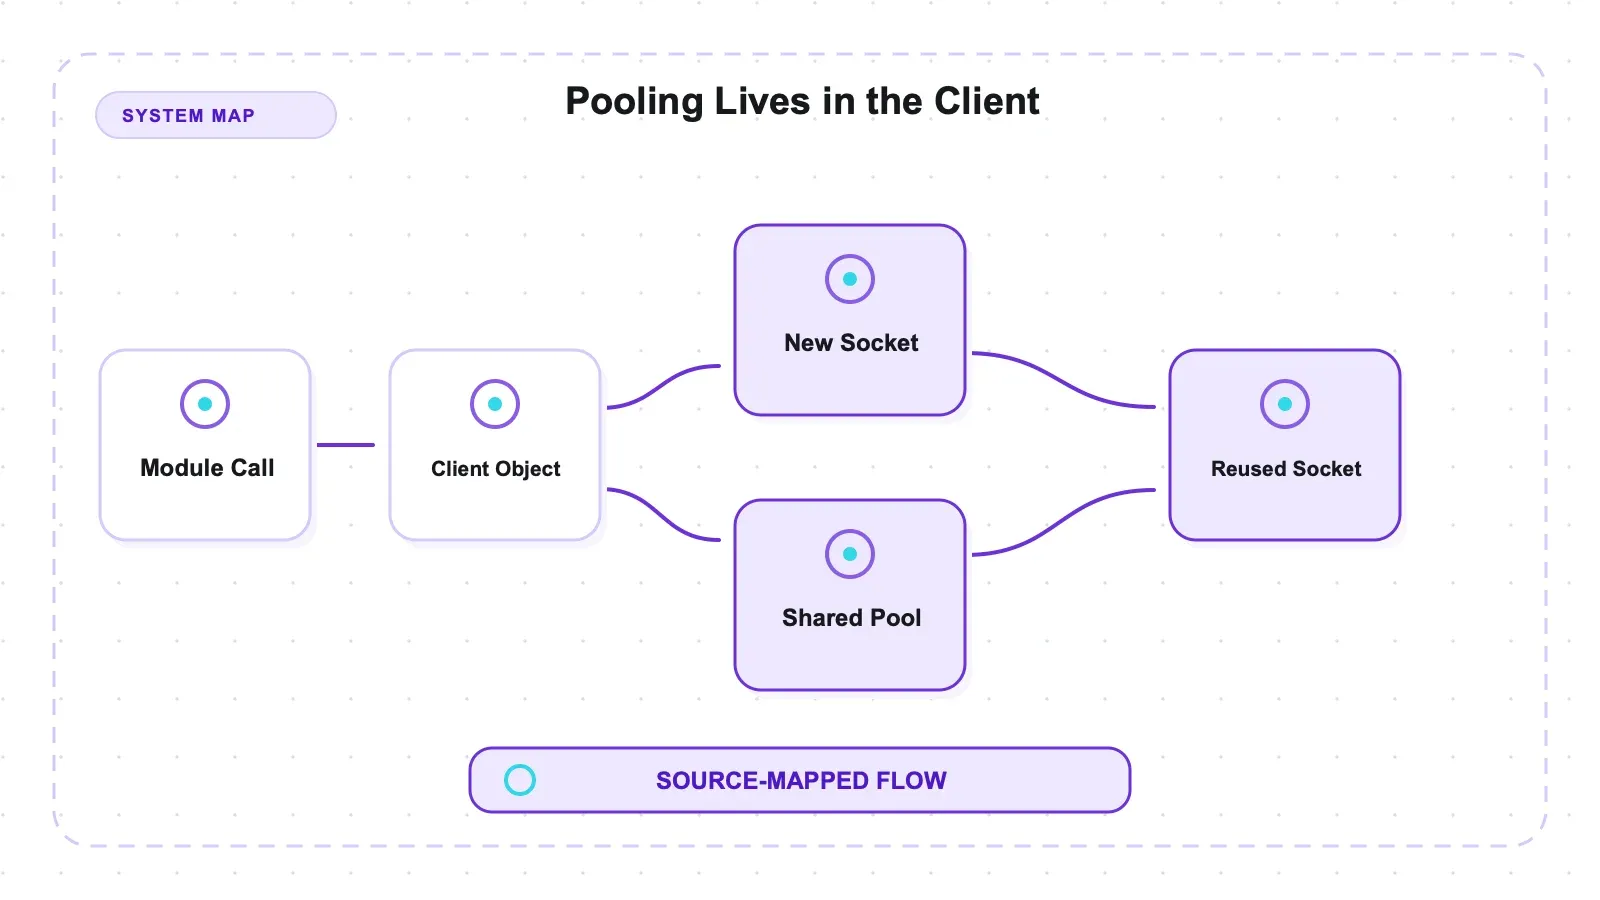
Tio GET-anrop, fyra sätt, sockets räknade på serversidan:
| Sätt | Öppnade sockets |
|---|---|
httpx.get() × 10 | 10 |
requests.get() × 10 | 10 |
httpx.Client() | 1 |
requests.Session() | 1 |
Samma resultat, och värt att säga eftersom det är den vanligaste föreställningen om just det här paret — att httpx poolar och requests inte gör det. Ingen av dem poolar på modulnivå. Båda poolar via sitt klientobjekt. Om du idag kör requests.get() i en loop, så ändrar httpx.get() i en loop ingenting i din socket-churn.
HTTP/2 är explicit och kräver extrat
Mot en publik HTTP/2-endpoint som loggades i testartefakten:
Officiell referens: RFC 9113: HTTP/2.
| Klient | Förhandlat protokoll |
|---|---|
httpx.Client(http2=True) | HTTP/2 |
httpx.Client(http2=False) | HTTP/1.1 |
| requests | HTTP/1.1, ingen flagga finns |
Du behöver httpx[http2]-extrat. Jag antog att ett vanligt pip install httpx skulle ge en klient som tyst förhandlar 1.1, och kollade upp det innan jag skrev ner det:
ImportError: Using http2=True, but the 'h2' package is not installed.
Make sure to install httpx using `pip install httpx[http2]`.
Det kastas vid skapandet av Client, innan en enda request skickas, och meddelandet talar om hur det fixas. Det är den bra versionen av det här felet, och jag hade det bakvänt (http2-extra-missing.json).
Den här kontrollen visar att protokollförhandlingen lyckas mot just den endpointen. Den visar inte någon vinst i scraping-hastighet; inget matchande HTTP/1.1-arbetslaster testades.
Sekventiell kontra samtidig throughput mot testservern
Tjugo requests mot en endpoint som sover i 0,3 s:
| Läge | Väggklocktid | Sockets |
|---|---|---|
Synkront, en Client | 6.138 s | 1 |
Asynkront, en AsyncClient | 0.357 s | 20 |
Den samtidiga körningen blev klar på 0,357 sekunder jämfört med 6,138 sekunder för den sekventiella körningen. Den öppnade också tjugo anslutningar medan den synkrona klienten återanvände en, så experimentet ändrar exekveringsmodell och faktisk samtidighet snarare än att isolera bibliotekets råa hastighet.
Det är den ärliga tolkningen av siffran. Det är en mätning av samtidighet mot en medvetet långsam endpoint, inte en mätning av httpx. Vilken klient som helst med fungerande async-stöd hamnar i samma härad, och mot en snabb endpoint krymper gapet.
Charset-fallet jag inte tänkte förutsäga
Jag förutsåg att ett svar där headern ljuger — charset=iso-8859-1 på utf-8-bytes — skulle ge samma mojibake i båda. Det gör det. Båda returnerar Café Ubersetzung â naïve résumé där källan säger Café Ubersetzung — naïve résumé.
Fallet jag inte förutsåg är det som faktiskt spelar roll:
| Svar | requests avkodar | httpx avkodar |
|---|---|---|
charset=utf-8, utf-8-bytes | korrekt | korrekt |
charset=iso-8859-1, utf-8-bytes | mojibake | mojibake |
| ingen charset alls | mojibake | korrekt |
requests faller tillbaka till ISO-8859-1 när headern inte säger något, medan httpx använder utf-8 som standard. I testfallet utan charset gav klienterna därför olika avkodad text via .text; konsumenter som använder response.content behåller samma ursprungliga bytes.
Minne, eftersom det är billigt att mäta
Peak RSS, /usr/bin/time -l, en ny process per cell:
| Cell | requests | httpx |
|---|---|---|
| Endast import | 36.0 MiB | 30.6 MiB |
| Import plus en GET | 35.8 MiB | 40.7 MiB |
Det här är ögonblicksbilder från en enstaka process, och att requests en-GET-värde ligger lite under import-only-värdet visar bara att mätbrus finns. De säger inget säkert om riktningen; det skulle krävas flera sampel och intervall.
Vad det här betyder när du väljer
Hittar du buggar i befintlig requests-kod? Granska antaganden om redirects, hanterare som bara fångar requests.exceptions.Timeout men tror att de täcker ett stopp mitt i body, och .text-användare som får svar utan charset.
Migrerar du mekaniskt till httpx? Byt undantagsnamnrymder till httpx.TimeoutException eller de snävare fas-klasserna, bestäm om follow_redirects ska aktiveras och testa om avkodningsantaganden igen. Den befintliga requests-hanteraren missar redan det visade fallet med stopp mitt i body; migrationen skapar inte just den buggen.
Bygger du något nytt som hämtar många URL:er? httpx är ett bra alternativ när du behöver AsyncClient och separata timeoutar för connect, read, write och pool. De faserna talar om var väntan skedde — anslutningsskapande, framsteg i response-body, uppladdning av request eller lokal pool-anskaffning — inte varför en fjärrserver betedde sig så.
Bygger du något litet och synkront? requests fungerar fint och finns överallt. Skälet att byta är inte fart.
Oavsett vad du väljer, använd klientobjektet i stället för funktionen på modulnivå. Det är den enda förändringen på den här listan som är en tydlig vinst i båda biblioteken.
Var en managed API-lösning passar in
Allt ovan handlar om fetch-lagret, och fetch-lagret är den enkla delen. Inget av det renderar JavaScript, inget hanterar en anti-bot-utmaning, och inget förvandlar HTML till de rader du egentligen ville ha.
Författarnotis: Thunderbit är vårt managed-alternativ för rendering och extrahering direkt från URL. Det testades inte i det här HTTP-klientharneset. Se den kategorin bara när sidinhämtning eller strukturerad extrahering — inte HTTP-klientsemantik — är problemet du försöker ta bort.
Om du hämtar vanliga sidor och parser dem själv, är båda klienterna fortfarande relevanta. En managed tjänst är ett separat build-vs-buy-beslut, inte ett argument för valet mellan de här biblioteken.
För en bredare överblick täcker vår web scraping API roundup de hostade alternativen och open-source scraper pillar de self-hostade.
Testa Thunderbit för extrahering av webdata
Slutsats
För ett nytt Python-fetchlager som behöver async-samtidighet, fas-specifika timeoutar och en utf-8-fallback är httpx mitt förstaval under de förutsättningar som testats här. Requests är fortfarande fullt gångbart för mogen synkron kod där migrationsrisk väger tyngre än de fördelarna. Proxyer, retry-policyer, TLS-fingerprinting, streaming, uppladdningar och verklig nätverksvariation testades inte, så det här är ingen universell ranking av scraping-klienter.
Skälet att vara försiktig är redirect-standardbeteendet, och det är en verklig risk just för att det är ett bra designbeslut. Explicit är bättre än implicit ända tills det implicita var bärande i kod du redan skickat i produktion.
Den förregistrerade scorecarden slutade med tre rätta förutsägelser, två fel och en ofullständig. Den användbara korrigeringen var undantagsklassen för stopp mitt i body; resten av beslutet bör komma från observerat beteende snarare än från berättelsen i scorecarden.
Testa Thunderbit för extrahering av webdata Get Started Free
Vanliga frågor
Följer httpx verkligen inte redirects?
Inte som standard, nej. Servern räknade ett enda request för en kedja med fyra hopp, och svaret kom tillbaka som en 302. Skicka follow_redirects=True per anrop, eller sätt det en gång på Client. Det här är dokumenterat och avsiktligt; det är ändå det som sannolikt går sönder tyst vid en migration, eftersom felet blir en tom parsering i stället för ett undantag.
Räcker verkligen inte except requests.exceptions.Timeout?
Inte för en server som stannar efter att headers skickats. Det fallet ger ConnectionError, som inte är en underklass till Timeout, så skyddet missar det — visat direkt, inte härlett. Fånga requests.exceptions.RequestException om du vill täcka båda, men acceptera att du då också fångar sådant som inte är timeoutar.
Är httpx snabbare än requests? Inte på något meningsfullt sätt för ett request i taget — det är inte vad det är till för. 17,2× i det här testet är en mätning av tjugo samtidiga requests mot en endpoint som sover i 0,3 s, alltså en mätning av samtidighet. Om din arbetslast är sekventiell, räkna inte med någon fartvinst och välj utifrån standardbeteendena i stället.
Behöver jag http2-extrat?
Bara om du vill ha HTTP/2 — och om du sätter http2=True utan det, kastar httpx ImportError när du skapar Client, med ett meddelande som säger att du ska installera httpx[http2]. Ingen tyst nedgradering att oroa sig för. Jag förväntade mig en sådan och kollade i stället för att skriva ned den.
Vad testades inte här? Proxy-beteende, vilket spelar stor roll för web scraping och behöver ett eget testupplägg. Retries — httpx levererar ingen retry-logik och requests får sin från urllib3, så en rättvis jämförelse är egentligen en jämförelse mellan två retry-bibliotek. TLS-fingerprinting, som är den axel anti-bot-system faktiskt tittar på och som inget av biblioteken adresserar. Streaming och filuppladdningar. Och allt här är en maskin, en Python-version och localhost för sex av de åtta kontrollerna — latenssiffror från en testserver mäter designen, inte ditt nätverk.




