
html2text installeras som ett paket och tar 0,2 MiB i anspråk — nio gånger mindre än det närmaste Python-alternativet och fyrtio gånger mindre än Node-alternativet. Det klarade alla fyra sidor i konverteringssviten och behöll alla 16 registrerade brödtext-prober. Dessa prober kontrollerar om utvalda brödtextsträngar överlever; de bedömer inte hierarki, listnästling, länkdestinationer, upprepat innehåll eller fullständig tabelltrohet.
Det är dessutom licensierat under GPL-3.0-or-later, vilket är den egenskap i den här jämförelsen som inte syns i några benchmarkresultat och som kan diskvalificera ett bibliotek helt.
Vad html2text är
html2text är ett Python-bibliotek som gör om HTML till Markdown-liknande ren text. Släktskapet går tillbaka till Aaron Swartz ursprungliga version, och den nu underhållna linjen ligger på 2025.4.15 — en datumversion från april 2025, med 2 168 GitHub-stjärnor, 95 öppna ärenden och senaste push i oktober 2025.
Officiell referens: html2text:s officiella repo.
import html2text
h = html2text.HTML2Text()
h.body_width = 0          # se nedan; standardvärdet kan överraska dig
md = h.handle(html)
pip install html2text hämtar 1 paket och 0,2 MiB, med kallimport på 0,077 s. Inga beroenden. I en containerimage eller en Lambda-layer är det en tydlig skillnad jämfört med markdownify:s 1,8 MiB och turndowns 8,8 MiB.
Standardvärdet som ändrar varje siffra
body_width har standardvärdet 78. html2text radbryter alltså varje utgående rad vid 78 tecken om du inte stänger av det.
Det är ett rimligt standardval för ett bibliotek vars ursprungliga uppgift var att skapa läsbar ren text för terminaler och e-post. Det är däremot fel standard för allt som ska matas till en modell eller jämförelse med diff, där insatta radbrytningar förändrar tokenisering, delar upp långa länkar över flera rader och gör utdata jämförelsevis meningslös.
Jag satte body_width = 0 för allt nedan, och jag markerar det öppet i stället för att gömma det: med radbrytning på skulle varje tecken- och tokenantal i den här artikeln vara annorlunda. Om du själv benchmarkar konverterare är det här inställningen som i tysthet gör dina siffror svåra att jämföra.
Mätningen
Jag körde html2text på en namngiven konverteringssvit med fyra sidor, samma som användes i markitdown-jämförelsen, med förregistrerade probe-strängar — utvalda brödtextsträngar som måste överleva och boilerplate-strängar vars närvaro visar att sidans chrome följde med. Samma fyra filer, samma prober, samma poängsättning för alla fyra konverterare. Probe-överlevnad mäter att registrerade strängar finns med, inte att strukturen är korrekt; tabell- och länkkolumnerna finns separat just därför.
| Konverterare | Brödtextprober | Utdata-tecken | Token (o200k) | Markdown-tabellrader | Länkar |
|---|---|---|---|---|---|
| html2text | 16/16 | 76 452 | 21 176 | 32 | 545 |
| markdownify | 16/16 | 76 868 | 21 062 | 36 | 599 |
| markitdown | 16/16 | 76 995 | 21 336 | 36 | 598 |
| turndown | 16/16 | 95 188 | 26 236 | 0 | 611 |
fourway-scores.json. Fyra fixture-filer, token räknade med o200k_base.
Minst utdata av de fyra med 76 452 tecken, och i praktiken lika på token med markdownify och markitdown — 21 176 mot 21 062 och 21 336, en spridning på 1,3 % som jag inte skulle kalla en verklig skillnad.
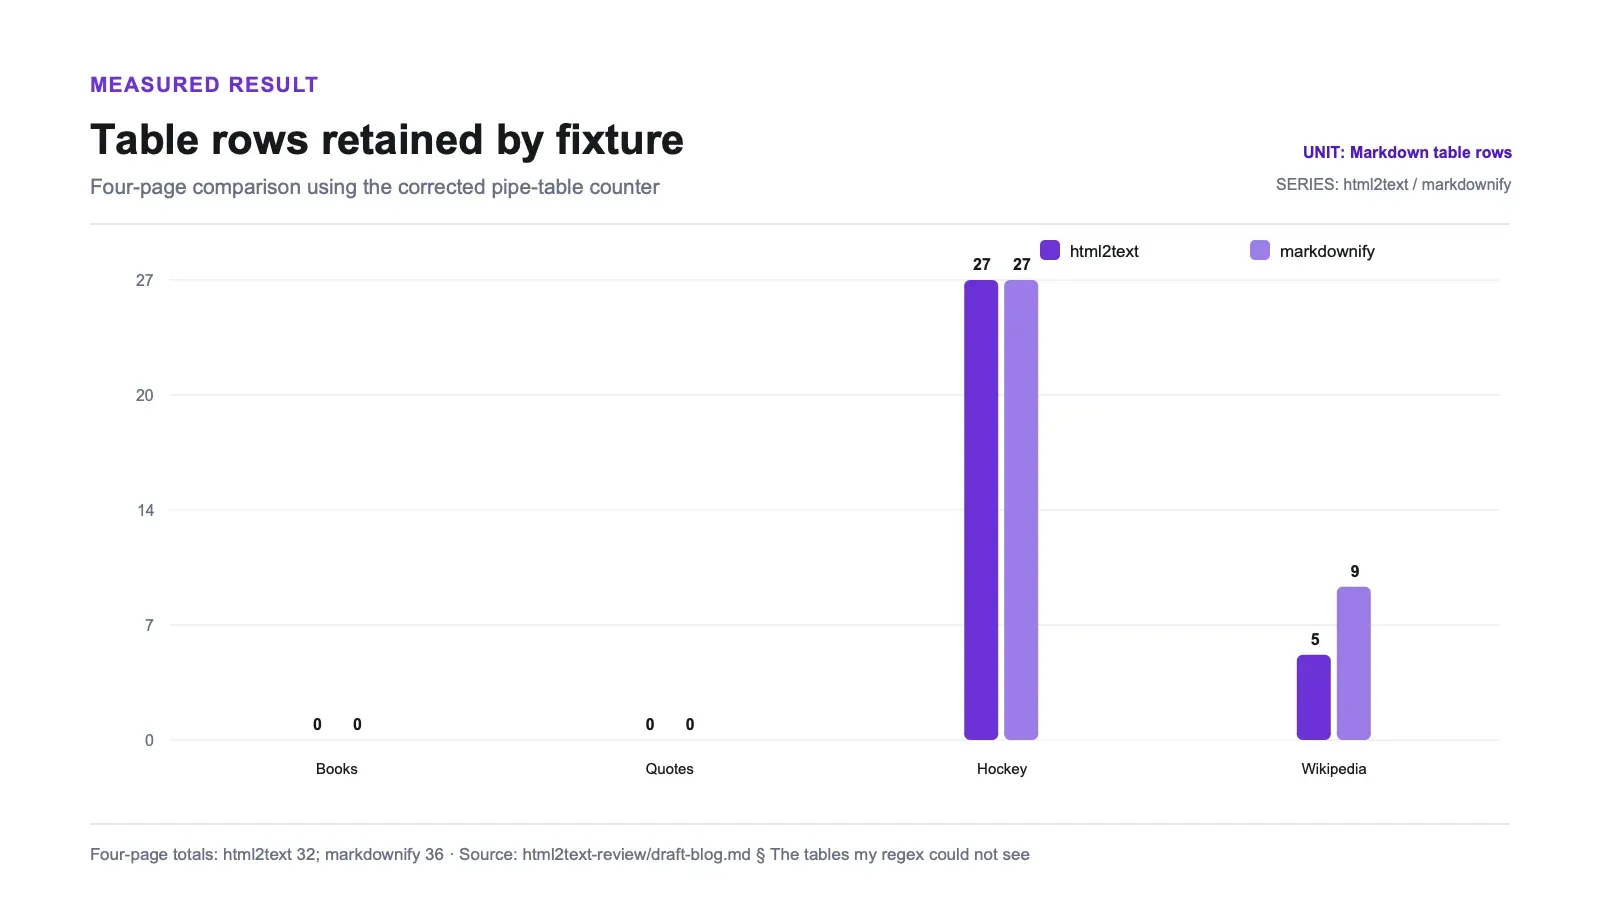
32 tabellrader mot markdownify:s och markitdown:s 36 i fyrasidessviten. Skillnaden på fyra rader uppstår i den oregelbundna Wikipedia-fixturen, inte i den yttre pipe-formatering som beskrivs längre ner.
Färst länkar, 545, mot 598 till 611 för de andra. Värt att kontrollera mot dina egna sidor om länkbevaring är viktigt — det är den kolumn där html2text tydligt ligger under gruppen i stället för inom den.
Tabellerna som min regex inte såg
Det här är värt att berätta, eftersom jag nästan publicerade fel slutsats om det.
Min första räknare för tabellrader krävde inledande och avslutande pipes — ^\|.*\|$. Med den regeln fick html2text 1 tabellrad över fem filer: fyrasidessviten plus en separat syntetisk fixture med komplex tabell. Den räknaren mätte en Markdown-variant, inte tabeller.
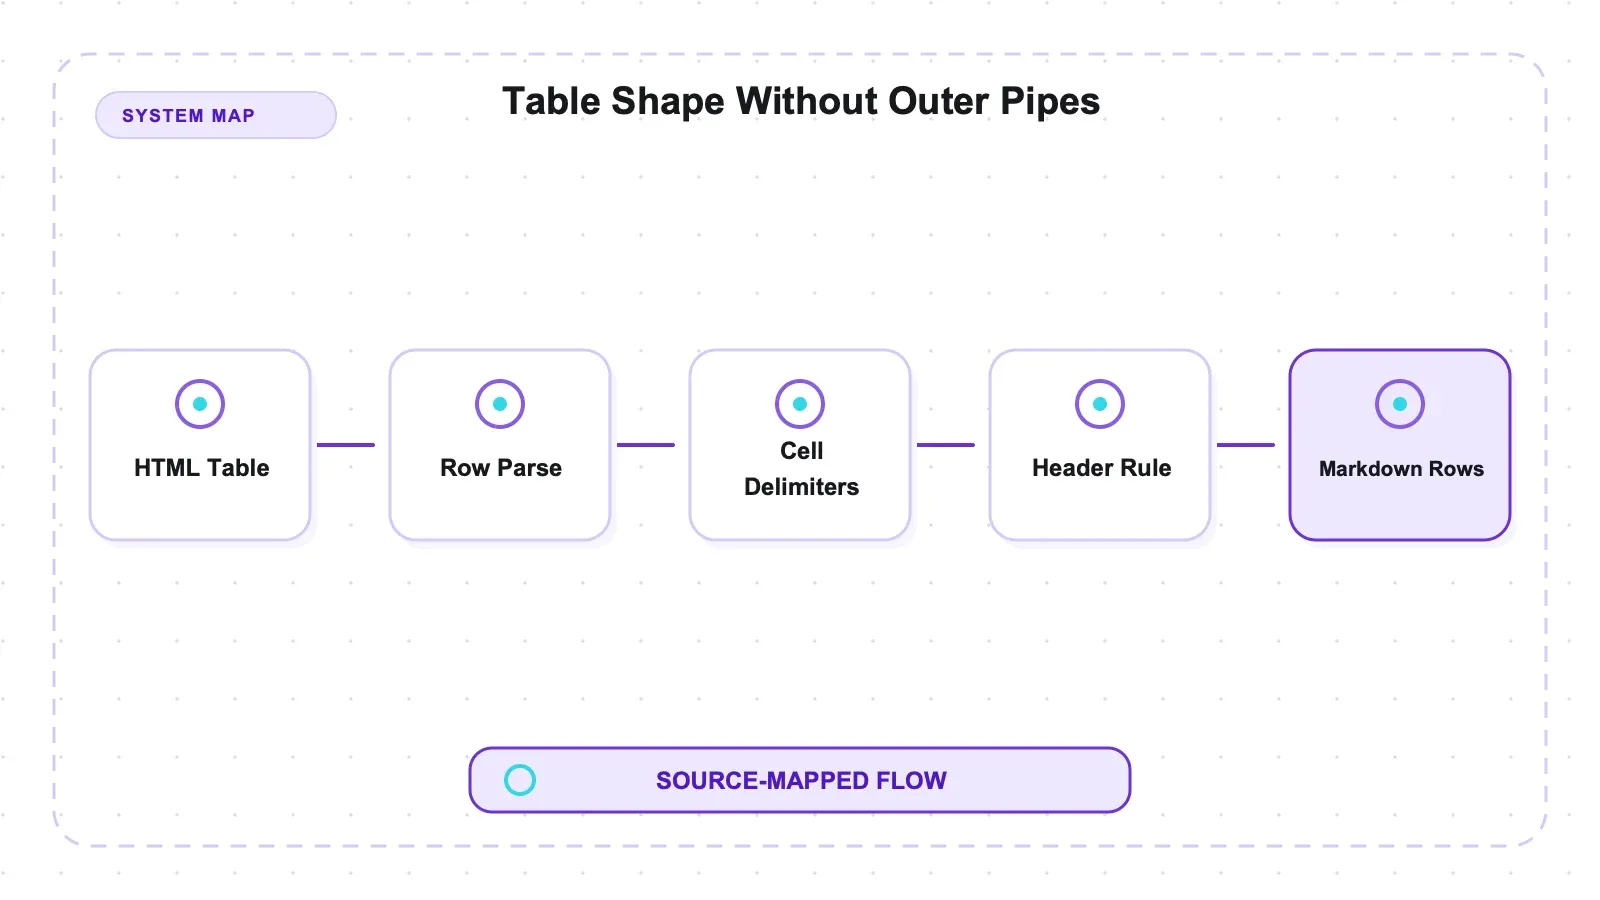
Det gör den. Den skriver dem så här:
Team Name  |  Year  |  Wins  |  Losses  |  Win %
---|---|---|---|---
Boston Bruins  |  1990  |  44  |  24  |  0.55
Inga yttre pipes. Det är konventionell pipe-table-syntax, men testharnessen validerade inte detta mot olika Markdown-renderare. Den blir osynlig för en regex som förväntar sig outer-pipe-stil. När jag skrev om räknaren så att den letade efter en följd av rader med pipes och en separatorrad inuti, gick html2text från 1 rad till 32 i fyrasidessviten och 91 över alla fem filer.
Slutsatsen är alltså inte att html2text saknar tabeller. Det är att två av de här fyra konverterarna skriver yttre pipes och en gör det inte, vilket spelar roll om du efterbearbetar Markdown med egna mönsteruttryck. Det är bra att veta, och det hade jag missat helt om jag hade litat på mitt första tal.
Vad den tar bort, och var den tappar rader
Två fynd som drar åt olika håll.
Den tar bort <script> och <style>. Mätt med markörer som bara förekommer i de elementen innehåller html2text:s utdata över fixture-filerna noll script-markörer och noll style-markörer. turndown innehåller 10 och 84 — i Wikipedia-fixturen ger åtta rader inbäddad JavaScript-konfiguration i MediaWiki och CSS värda 14 644 tecken (script-style-stripping.json). För modellbunden utdata var detta den största observerade källan till onödig text i den fixturen. Ingen nedströms kostnadsmodell mättes.
Den tappar tabellrader på den svåra sidan. Fyrasidessviten går ihop så här:
| Fixture | html2text | markdownify |
|---|---|---|
| Books to Scrape | 0 rader | 0 rader |
| Quotes to Scrape | 0 rader | 0 rader |
| Hockey statistics | 27 rader | 27 rader |
| Wikipedia | 5 rader | 9 rader |
| Totalt för fyra sidor | 32 rader | 36 rader |
Den separata syntetiska fixture-filen med komplex tabell lägger till 59 html2text-rader och 62 markdownify-rader, vilket ger totalsumman 91 respektive 98 över fem filer. Den ingår inte i rubrikjämförelsen för de fyra sidorna. På den rena hockeytabellen är de överens. På Wikipedia, där tabellerna är nästlade och oregelbundna, ger html2text fem rader där markdownify ger nio.
Mönstret är alltså: enkla tabeller, identiskt; knepiga tabeller, html2text behåller mindre. Om dina sidor har den typen av tabeller som Wikipedia har, testa det innan du bestämmer dig. Om de har den typ som en statistik-sida har, är de två utbytbara på den här punkten.
Licensen
| Bibliotek | Licens | Paket | Disk |
|---|---|---|---|
| html2text | GPL-3.0-or-later | 1 | 0,2 MiB |
| markdownify | MIT | 5 | 1,8 MiB |
| turndown | MIT | 3 (npm) | 8,8 MiB |
Officiell referens: html2text på PyPI.
Bekräftat på tre ställen: PyPI-metadata, GitHub-repot och det installerade paketets egen METADATA-fil, där det står License-Expression: GPL-3.0-or-later.
Vad det betyder beror på hur mjukvaran integreras, överförs och distribueras. Intern användning eller nätverksanvändning är i regel ett annat GPL-scenario än att leverera mjukvara som innehåller paketet eller kombineras med det, men den här artikeln är ingen juridisk analys. Team som distribuerar mjukvara bör låta jurist granska den exakta integrations- och distributionsmodellen.
Det besvärliga är korrelationen. Biblioteket med minsta fotavtryck, det du skulle välja just för att hålla en distribuerbar artefakt liten, är det som har licensen som mest begränsar distributionen. Båda alternativen är MIT-licensierade.
Jag är inte jurist och detta är inte rådgivning — bara fakta, med källa, eftersom det är den egenskap som sannolikt spelar störst roll och minst sannolikt syns i en jämförelsetabell.
Underhåll
Senaste release 2025.4.15, senaste repo-push i oktober 2025 — ungefär tio månader före testet, med 41 releaser bakom sig. requires_python >= 3.9, och det installerades och kördes utan problem på Python 3.14.2.
Det är tystare än markdownify (senaste release sex veckor före testet) och turndown (fyra månader), och betydligt mer aktivt än ingenting. För ett bibliotek som konverterar HTML till text — ett problem som inte förändras särskilt mycket — känns ett glapp på tio månader mer som stabilitet än övergiven kod. Nittiofem öppna ärenden är den större varningssignalen, och värda att skumma igenom efter sådant som liknar ditt användningsfall innan du bestämmer dig.
Minne, och vad trasig HTML gör med det
Här mäts två driftfrågor separat.
Den bredare stress-test-kontexten finns i jämförelsen av tio biblioteks minne och felaktig HTML.
Maximalt resident minne, via /usr/bin/time -l, en färsk process per cell — importgolvet är vad biblioteket kostar när det är inläst men tomt, topparna inkluderar dokumentet.
| Bibliotek | Körmiljö | Importgolv | Topp 226 KB | Topp 10 MB |
|---|---|---|---|---|
| html2text | python3.14 | 18,7 | 19,9 | 71,2 |
| pyquery | python3.14 | 30,3 | 33,9 | 172,5 |
| resiliparse | python3.14 | 20,5 | 25,1 | 225,1 |
| markdownify | python3.14 | 23,9 | 28,9 | 278,5 |
| goose3 | python3.14 | 44,1 | 52,4 | 398,5 |
| cheerio | node22 | 66,8 | 76,5 | 398,5 |
| justext | python3.14 | 30,3 | 36,6 | 431,2 |
| newspaper4k | python3.14 | 52,6 | 61,8 | 668,5 |
| trafilatura | python3.14 | 52,5 | 64,8 | 927,1 |
| turndown | node22 | 47,8 | 68,4 | 2947,1 |
memory-results.json. Python- och Node-baslinjer är inte jämförbara med varandra; tolken finns i båda.
html2text är det lättaste alternativet här på båda mätta axlarna. Dess importgolv på 18,7 MiB och topp på 71,2 MiB på 10 MB-fixturen ger ett inkrementellt RSS på 52,5 MiB: (71,2 - 18,7) / 10 = 5,25× fixture-storleken. Jämför det med de absoluta och inkrementella raderna i tabellen, och ha förbehållet om Python/Node-baslinjer i åtanke.
Trasig HTML. Tolv dokument där exakt en sak går sönder i varje — oavslutade taggar, felnästade inline-element, attribut utan citationstecken med mellanslag, lösa avslut, ingen <html> alls, dubbla attribut, ett dokument avkortat mitt i en tagg, felaktiga entiteter, en oavslutad <script>, en vilseledande charset-deklaration, en kommentar med markup och 600 nivåer av nästling — plus två välformade kontroller i matchade storlekar, eftersom "den returnerade inget" bara säger något om felaktighet om biblioteket inte också är tyst på ett rent dokument av samma storlek.
html2text kastade fel på 0 av 14 och returnerade inget på 0, och återställde 33/33 markörer i de trasiga fixture-filerna (malformed-results.json). En fixture räknas inte med i den siffran: enligt HTML5 är allt efter en oavslutad <script>-tagg scriptinnehåll, så att förlora det där är korrekt och att återställa det vore avvikelsen.
För- och nackdelar
Fördelar. Ett paket, 0,2 MiB, inga beroenden — klart minst i jämförelsen. Minst utdata av de fyra och i praktiken lika på token med markdownify och markitdown. Skapar igenkännbar pipe-table-syntax. Kör på Python 3.14. Lång och stabil historik.
Nackdelar. GPL-3.0-or-later, vilket alternativen inte har. body_width=78 som standard, vilket radbryter utdata hårt och ändrar mätningar eller diffar om det inte stängs av. Färst bevarade länkar (545 mot 598–611). Tabeller använder stil utan yttre pipes, vilket bryter enkel regex-baserad efterbehandling. Nittiofem öppna ärenden och lugnare releasetakt än markdownify.
Vem bör använda det, och vem bör låta bli
Använd html2text när beroendebudgeten verkligen är tajt och den tänkta integrations- och distributionsmodellen har passerat licensgranskning. Ett paket med noll beroenden är en verklig operativ fördel: mindre beroendeyta att granska och driftsätta.
Sätt body_width = 0 på första raden om du inte specifikt vill ha radbruten ren text.
Hoppa över det om du distribuerar mjukvara och copyleft är ett problem — markdownify är MIT, matchar det på token och matchar markitdown på tabeller för 1,6 MiB mer. Hoppa också över det om länkbevaring är viktig för dig, eftersom det behöll minst antal. Och hoppa över det om dina downstream-verktyg förutsätter yttre pipes i tabellrader.
Var en hanterad API-tjänst passar in
html2text konverterar HTML du redan har. Den hämtar inte sidor, renderar inte JavaScript och hanterar inte något anti-bot-lager — det gör ingen av de fyra konverterarna, och på många riktiga mål är det den svårare halvan av jobbet.
För samma fixture-filer över alla fem konverterare, se jämförelsen av HTML till Markdown i fem varianter.
En hostad tjänst för hämtning/rendering/extraktion, inklusive vår egen Thunderbit, verkar i ett annat lager. Thunderbit benchmarkades inte här. Gränsen som spelar roll är konvertering av redan levererad HTML kontra en tjänst som hämtar och behandlar en URL; den här artikeln ger ingen jämförelse på samma mått för kvalitet, latens eller kostnad.
Rättvis formulering: om du har HTML:en, vill ha Markdown och GPL inte är ett problem för hur du levererar, är html2text gratis och imponerande litet. Om du hämtar sidor, eller vill ha rader snarare än prosa, är det ett annat köp.
För det bredare fältet täcker vår översikt över web scraping-API:er hostade alternativ och översikten över open source-scrapers de självhävdade alternativen. Konvertera HTML till Markdown i Python är den praktiska genomgången.
Testa Thunderbit för webbdataextraktion
Bör du använda html2text?
Det är en stark kandidat när fotavtrycket spelar roll, radbrytning är avsiktligt avstängd och distributionsmodellen klarar licensgranskning.
Tokenantalet låg inom 1,3 % från markdownify och markitdown i fyrasidessviten. Det betyder inte att total kvalitet är likvärdig: html2text behöll färre länkar och färre rader på den oregelbundna Wikipedia-fixturen. Två driftdetaljer är omedelbart viktiga: body_width = 0 och tabellstilen utan yttre pipes.
Om GPL-granskningen stoppar det, är markdownify MIT, hade liknande utdatasstorlek och tokenantal här, behöll fler länkar och fler oregelbundna tabellrader och använde 1,6 MiB mer disk i den här miljön.
Testa Thunderbit för webbdataextraktion Get Started Free
Vanliga frågor
Kan html2text konvertera tabeller?
Ja. Min första räknare sa att den producerade en tabellrad över fem filer, och den räknaren var fel — den krävde inledande och avslutande pipes, medan html2text skriver Team Name | Year | Wins utan dem. Det är vanlig pipe-table-Markdown, även om testharnessen inte körde ett kompatibilitetstest mellan renderare. Med den korrigerade räknaren producerade html2text 32 rader mot markdownify:s 36 i fyrasidessviten och 91 mot 98 när den separata fixturen med komplex tabell räknas med.
Vad gör body_width, och varför ändra det?
Den radbryter utdata vid 78 tecken som standard, ett vettigt val för terminalläsbar ren text och ett dåligt för nästan allt annat. Radbrytningen lägger in nya rader mitt i meningar, delar långa URL:er över flera rader och ändrar tokeniseringen. Alla siffror i den här genomgången använde body_width = 0; med standardvärdet skulle de alla vara annorlunda.
Är GPL-licensen en verklig begränsning?
Det beror på den exakta integrations- och distributionsmodellen. Intern användning eller nätverksanvändning och att distribuera mjukvara är olika granskningsscenarier, men den här artikeln avgör inte det juridiska utfallet. Team som levererar mjukvara bör låta jurist granska villkoren för GPL-3.0-or-later; markdownify och turndown är MIT-licensierade. html2text:s license expression bekräftas i PyPI-metadata, på GitHub och i det installerade paketets METADATA-fil.
Är en release från april 2025 ett problem? Troligen inte i sig. HTML-till-text-konvertering är ett stabilt problem, biblioteket installerades och kördes rent på Python 3.14.2, och 41 releaser ligger bakom det. Nittiofem öppna ärenden är siffran jag faktiskt skulle kontrollera — skumma igenom dem efter något som liknar din input innan du bestämmer dig, eftersom ett tyst repo kan innebära att det är du som får fixa det.
Vad testades inte här?
Fyra konverterings-fixtures och en separat fixture med komplex tabell är fortfarande en liten svit. Testet täckte dock tolv syntetiska felaktiga dokument plus två kontroller: html2text kastade fel på 0/14, returnerade tomt på 0/14 och återställde alla 33 poängsatta markörer. Det täckte inte verkligt skadade sidor, bredare felmönster, nästlade listor, definitionslistor, fotnoter eller matematik. Hela inställningsytan — ignore_links, ignore_images, unicode_snob, single_line_break och resten — lämnades på standardvärden förutom body_width. Länkgapet observerades men analyserades inte, och Markdown round-tripping testades inte.




