
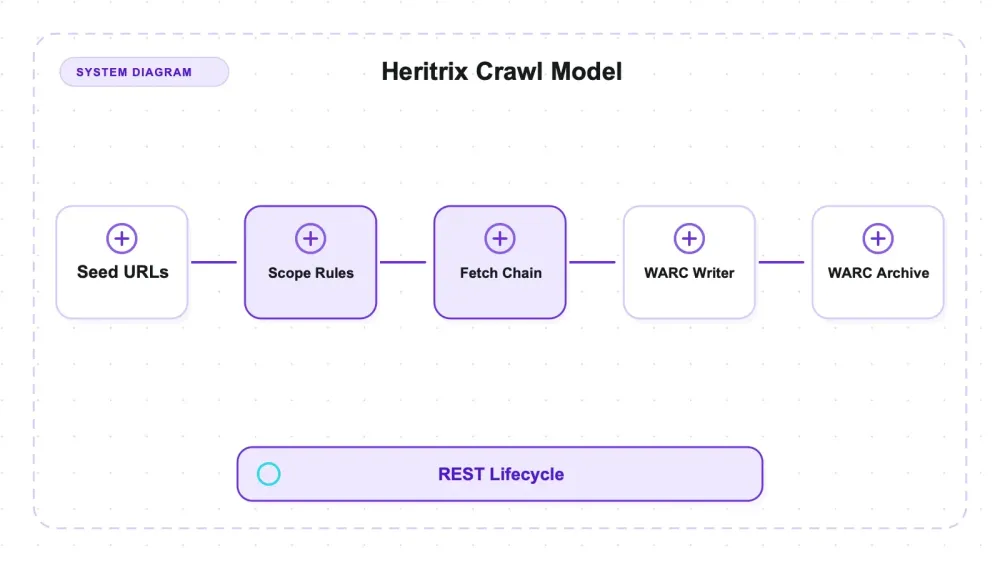
Heritrix är Internet Archives åpne kildkode-crawler för arkivering — mjukvarulinjen som ligger bakom Wayback Machine och som har körts i produktion i två decennier. Dess jobb är att fånga exakt det en webbplats levererade, och spara det i WARC-filer som kan spelas upp igen många år senare. Under huven är det en Java-motor där varje crawl består av en Spring bean-graf skriven i XML, och hela jobbets livscykel styrs via ett REST API. Det är inte en scraper: ingen selectorsyntax, ingen fältmappning, inga rader i slutet.
Jag testade 3.16.0 mot ett kontrollerat lokalt testupplägg och räknade vad den faktiskt skrev, post för post. Det som sticker ut är fullständigheten: tjugo hämtade URI:er gav sextioen WARC-poster, med payload-digest och capture IP på varje svar samt varje begäran länkad tillbaka till det svar den hör till, utan att jag behövde ändra någon konfigurationsinställning. Att drifta den är raka motsatsen till den upplevelsen — 41 MB, 114 jars (lib/ innehåller 142 filer; de övriga 28 är paketerade LICENSE- och NOTICE-texter), och en jobbkonfiguration på runt 750 rader innan första hämtningen — även om varje crawl här kördes helt headless via curl, utan ett enda klick i något webbgränssnitt.
Lagringsresultatet avslöjade en mindre uppenbar standardinställning. Två test-URL:er returnerade identiskt innehåll byte för byte, och standardprofilen hämtade och arkiverade båda i sin helhet: två response-poster och noll revisit-poster, trots att båda svaren fick samma payload-digest. Deduplikering med content digest fungerar när dess historikprocessorer har lagts till; det är inte aktiverat i standardprofilen, och det sparar lagring snarare än bandbredd.
Vad Heritrix faktiskt är
Arkivering är inte scraping, och det är en kategoriförväxling som är värd att reda ut. Heritrix ger dig inte rader. Det finns ingen CSV i slutet. Dess output är själva HTTP-konversationen — headers, bodies och capture-metadata — lagrad i ett format som är byggt för bevarande, och det är referensimplementationen för hela den här typen av arbete. Att be den om en produktprislista är som att be en rättsstenograf om en sammanfattning.
Aktuella siffror per 27 juli 2026: repot ligger på 3 285 stjärnor med 36 öppna issues, och 3.16.0 är senaste release, publicerad 2026-07-03. Det är exakt den build jag testade, så inget här är ett klagomål på en gammal version. Licensen har en liten twist: LICENSE-filen är ren Apache-2.0, men GitHubs egen detektor rapporterar "Other" eftersom vissa medföljande tredjepartsfiler har egna villkor. Om Heritrix ska in i en kommersiell produkt är det något som förtjänar fem minuters juridisk uppmärksamhet, inte bara en snabb blick på badge i sidpanelen.
En strukturell egenskap styr resten: Heritrix kör inte en webbläsare. Den hämtar via HTTP och extraherar länkar från de bytes som kom tillbaka. Dess syskon inom modern arkivering, Browsertrix Crawler, gör tvärtom — riktig Chromium och registrerar vad webbläsaren faktiskt gjorde. Båda skriver WARC, men den här recensionen mätte bara Heritrixs icke-webbläsarväg; jag benchmarkade inte något av systemen för skala eller genomströmning.
Kedjor, beans och SURT: så byggs en crawl i praktiken
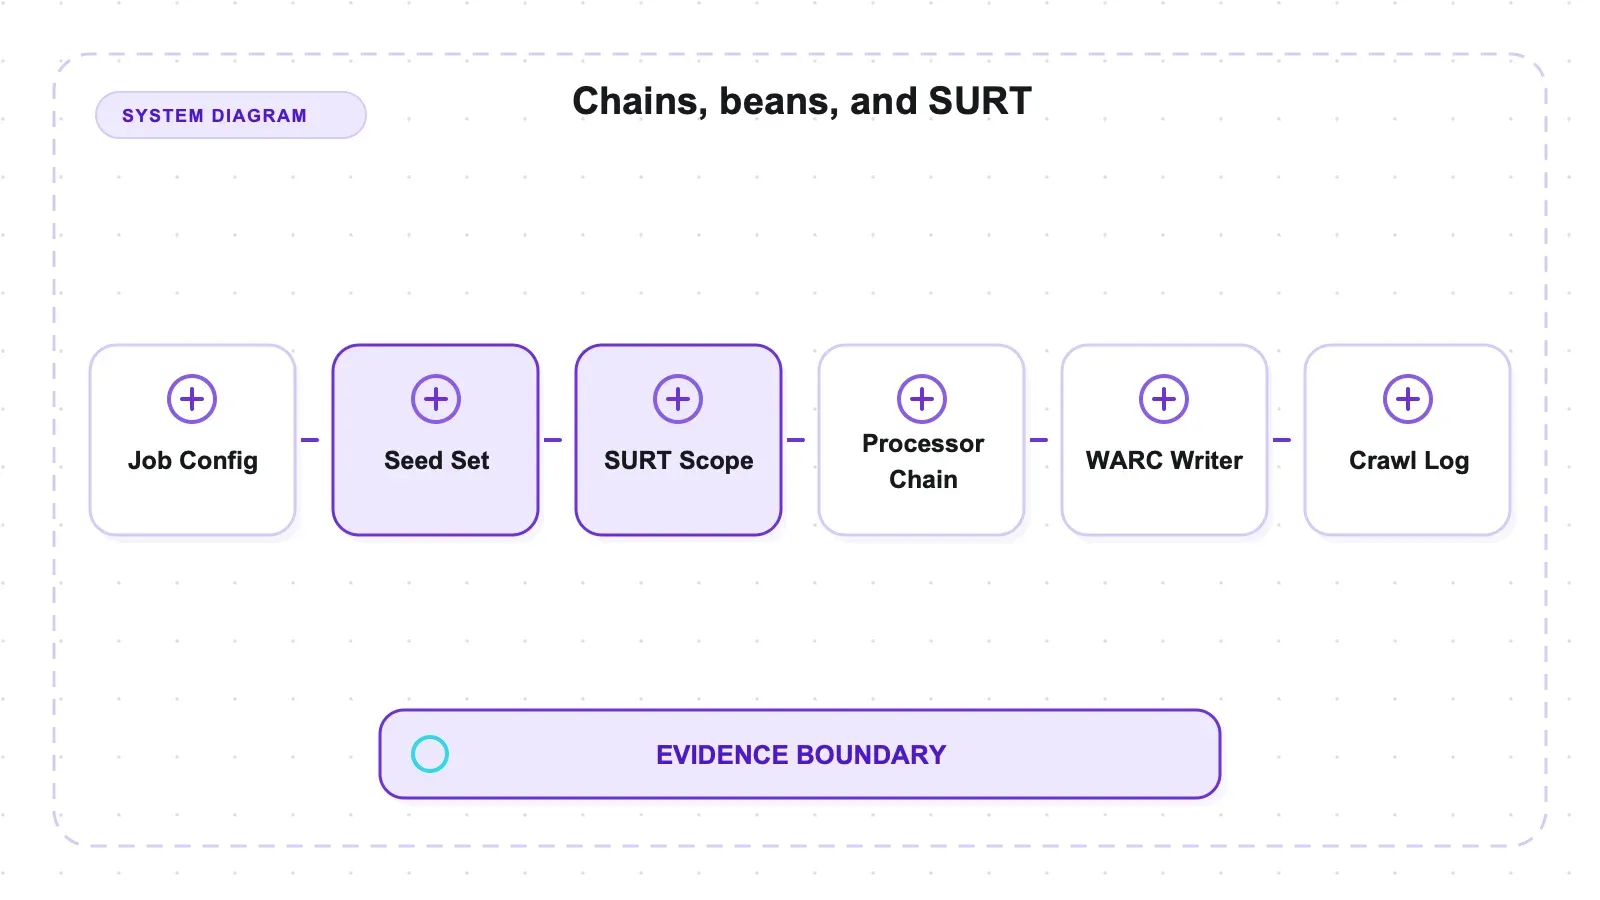
Under huven är ett Heritrix-jobb en Spring-applikationskontext. Inte "konfigurerad med Spring" — det är en Spring bean-graf, skriven i XML, och varje del av crawlen är en bean du kan byta ut.
Frontiern håller URI-kön, uppdelad per host. Den uppdelningen är anledningen till att politeness fungerar som den gör, och det spelar roll längre fram.
Processor-kedjor gör jobbet i tre steg: en candidate chain (ska den här upptäckta URI:n schemaläggas?), en fetch chain (DNS, robots, HTTP-hämtning, länkextraktion) och en disposition chain (skriv till WARC, uppdatera state). Att lägga till en kapacitet i Heritrix betyder oftast att man stoppar in en processor-bean på rätt plats i rätt kedja, och det är exakt så jag slog på deduplicering.
Scope är en stack av DecideRules som arbetar på SURT — Sort-friendly URI Reordering Transform, som skriver om http://www.example.com/a till http://(com,example,www,)/a så att hostprefix sorteras i hierarkier. Standard-scope genereras från dina seeds SURT-prefix. Regler accepterar och avvisar i ordning, och den sista träffen vinner.
WARC-skrivaren ligger i disposition-kedjan, och politeness bor i frontiern som tre värden: delayFactor, minDelayMs, maxDelayMs. Robots-lydnad är en policyssträng på fetchern.
Och allt detta kan styras via ett REST API, vilket visade sig vara viktigare än jag hade väntat mig.
Setup är den tyngsta delen av hela upplevelsen
Det du deployar innan första hämtningen:
| Setup-dimension | Heritrix 3.16.0 |
|---|---|
| Distributionsarkiv | ungefär 41 MB |
Filer i lib/ efter uppackning | 142 totalt: 114 .jar-filer och 28 LICENSE/NOTICE-texter |
| Vad som startar vid uppdragning | en Java-motor plus ett inbäddat Jetty-webbgränssnitt på https://localhost:8443 bakom ett självsignerat certifikat |
| Tid till REST-klart, på min maskin | cirka tio sekunder |
Standard-jobbkonfig (crawler-beans.cxml) | ungefär 750 rader Spring bean-XML |
Det mesta av den där jobbkonfigurationen kommer du aldrig röra. Men du kan inte hoppa över den, och två fält är obligatoriska innan crawlern hämtar något alls: din seed och metadata.operatorContactUrl. Standardvärdet är en platshållare, och den kommer inte att crawla förrän du ersätter den med en riktig URL som identifierar vem som kör crawlen.
Det kravet skapar en ansvarskoppling: en operatör måste ange en kontakt-URL innan crawlern kör. Det bevisar inte att identiteten är korrekt, att en crawl är auktoriserad eller att den följer tillämpliga regler, men det gör kontaktinformationen till en del av jobbet i stället för en valfri konvention.
Två saker i setupen överraskade mig faktiskt.
Den körde på en nyare JDK än miniminivån i dokumentationen. Getting Started-dokumentationen ber om Java 17 eller senare. Heritrix 3.16.0 startade, exponerade sitt REST API och genomförde varje crawl i detta testupplägg på OpenJDK 26.0.1, utan --add-opens, --enable-preview eller workaround kring Security Manager. Det är ett resultat för en macOS arm64-maskin, inte en full kompatibilitetsmatris, men det bekräftar att den testade builden inte var begränsad till JDK 17 på just den här hosten.
Du behöver aldrig röra webbgränssnittet. Hela jobbets livscykel sker via REST, och jag automatiserade allt med curl: skapa jobbet, PUT-a beans-filen, bygg, starta, pausa upp, polla tills controller-state visar FINISHED, terminera, rensa. Det är det verkliga svaret på frågan "går Heritrix att köra i en pipeline" — ja, headless, utan ett enda webbläsarklick. Många genomgångar visar Jetty-gränssnittet i skärmdumpar och låter som om det vore själva gränssnittet. Det är en bekvämlighet, inte ett krav.
En plattformspecifik deploynotis: den här Macen kör en systemomfattande HTTP-proxy via Surge. Heritrixs Java-klient ärvde proxyn och skickade även fixture-trafik till 127.0.0.1 genom den, vilket gav 503-svar trots OS:ets undantagslista och NO_PROXY. Att starta JVM:en med -Djava.net.useSystemProxies=false ändrade körningen från 2×503 till 18×200. Det här var en miljöinteraktion, inte en Heritrix-bugg; flaggan är bara relevant när man inte vill ärva systemets proxyinställningar.
Vad som faktiskt landar i arkivet
Jag körde standardprofilen mot ett kontrollerat testupplägg — en lokal server med en känd uppsättning endpoints, inklusive HTML-sidor, en kedja på tre nivåer, robots.txt och sitemap, samt avsiktliga 404- och 500-rutter — och parsade sedan den resulterande WARC:en post för post i stället för att lita på en sammanfattningsrad.
Tjugo hämtade URI:er gav sextioen poster:
| WARC-posttyp | Antal | Vad den innehåller |
|---|---|---|
warcinfo | 1 | provenance på crawl-nivå, skrivs en gång per fil |
response | 20 | fullständigt HTTP-svar, headers och body |
request | 20 | den exakta begäran Heritrix skickade |
metadata | 20 | Heritrix egna capture-anteckningar |
En ren 1:1:1-kvot mellan response, request och metadata per URI, direkt ur lådan, utan någon konfiguration från min sida. Och fullständigheten per post höll i granskningen:
| Kontroll per post | Antal | Varför det spelar roll |
|---|---|---|
Payload-digest med prefixet sha1: på responses | 20/20 | — |
WARC-IP-Address på responses | 20/20 | IP-adressen som innehållet faktiskt kom från, vilket är precis den sortens uppgift man desperat vill ha flera år senare när ett domännamn har bytt ägare |
Request-poster länkade till sitt svar via WARC-Concurrent-To | 20/20 | Inte "mest länkade". Alla. |
Och HTTP-status bevarades ordagrant, även de fula: 200 OK, 404 Not Found och 500 Internal Server Error finns kvar som riktiga statusrader i sparade responses i stället för att rensas bort som fel.
Den sista punkten skiljer arkivering från scraping tydligare än något annat. En scraper behandlar en 500 som ett fel att försöka igen eller hoppa över. En arkivmotor behandlar den som vad servern sa i just det ögonblicket, vilket är ett faktum värt att bevara. Heritrix Output-wikin beskriver den här poststrukturen; det jag inte sett någonstans var den uppmätta multipliciteten och 20/20-länkningen på en känd uppsättning endpoints. Den håller.
Deduplikeringen, mätt från båda håll
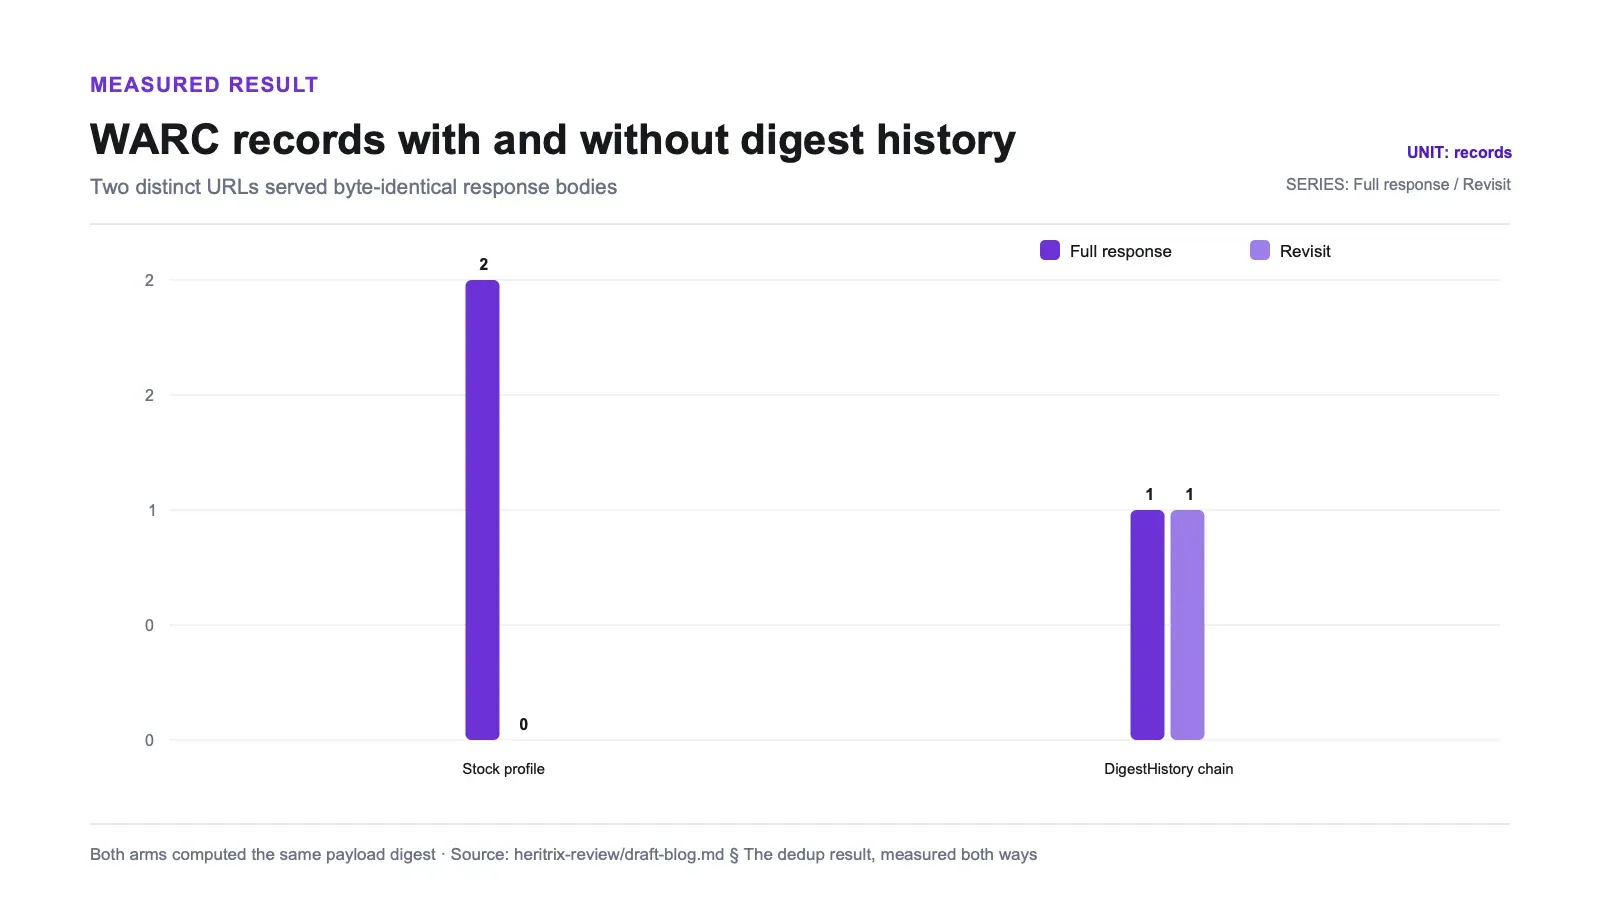
Mitt testupplägg serverade /dup/one och /dup/two med identiskt innehåll byte för byte. Olika URL:er, samma content — exakt det fall content-digest-deduplikering finns för att slå ihop. Jag körde det två gånger: en gång med standardprofilen, och en gång efter att ha lagt till digest-history-kedjan (BdbContentDigestHistory, plus en ContentDigestHistoryLoader i fetch-kedjan och en ContentDigestHistoryStorer efter WARC-skrivaren).
| Standardprofil | Med ContentDigestHistory-kedjan | |
|---|---|---|
Fullständiga response-poster skrivna | 2 | 1 |
revisit-poster skrivna | 0 | 1 |
| Delad payload-digest | ja (båda) | ja |
| Revisit-profil | — | identical-payload-digest |
Ur lådan fick båda svaren samma digest, men inga historikprocessorer agerade på den och båda payloads skrevs ut i full längd. När kedjan lades till omvandlades den andra hämtningen till en WARC revisit-post som pekar på den identiska payload-digesten, vilket är det beteende som WARC 1.1-specifikationen definierar revisits för.
Inget av detta är någon hemlighet. Duplication Reduction Processors-wikin säger att skipIdenticalDigests har standardvärdet false och att URL-agnostisk dedup kräver just de där loader- och storer-beans. Det här är inte dold funktionalitet som avslöjats; som nästan allt jag mätte här är det dokumenterat Heritrix-beteende med ett förstahandstal bredvid. Glappet ligger mellan dokumentationen och vad folk tror, och i min erfarenhet är tron ofta att "Heritrix dedup:ar", punkt slut, utan asterisk om konfiguration.
Två följdsatser är värda att verkligen ta in:
Deduplikering sker vid skrivning, inte vid bandbredd. Det här är mer mekanism än något jag mätte separat, men det följer direkt av hur content digests fungerar: du kan bara jämföra en digest efter att bytes har kommit fram, så den andra URL:en hämtas från origin ändå. Att aktivera kedjan minskar det du lagrar, inte det du överför eller det som målsajten måste leverera. Den som budgeterar dedup som en artighets- eller bandbreddsvinst tänker baklänges.
Lagringskalkyler som bygger på "det dedup:as ju" kan bli rejält fel. Om du arkiverar en sajt med mycket mallupprepning — speglade PDF:er, standardsidor, print-vyer av samma artiklar — och dimensionerar diskarna som om identiska bodies kollapsar, kan standardprofilen använda avsevärt mer lagring än den uppskattningen. Två-URL-testet visar standardbeteendet, inte effekten i miljon-URI-skala; den effekten beror på dubblettfrekvens, payloadstorlek och hur återcrawlning är designad.
Scope och robots gjorde exakt det de lovar
En crawlers egen beskrivning av vad den inte hämtade är värd väldigt lite, så båda dessa saker mättes med en server-side hit counter — målsajten räknade själv sina förfrågningar, oberoende av vad Heritrix loggade.
| Kontroll | Villkor | Server-side träffar på målet | Vad crawl-loggen visade |
|---|---|---|---|
| Scope | Standard-scope; jag seedade en sida som länkar till en andra host med en separat SURT-authority | 0 | hosten utanför scope dök inte upp alls — vilket betyder att den avvisades vid upptäckt, inte köades och misslyckades |
| Robots | Standardpolicy för obey; startsidan länkade till /robots-denied/secret, som min fixtures robots.txt förbjöd | 0 | registrerad som blockerad (robots.txt hämtades också) |
| Robots | Kontroll: robotsPolicyName växlad till ignore, kör om | 1 | — |
Scope. Samtidigt crawlas hosten inom scope normalt, så scope var disciplinerad snarare än att crawlen var trasig. En viktig brasklapp: jag körde bara standard-scope-varianten här, inte ett positivt kontrollfall med utökat scope, så läs detta som bekräftelse av dokumenterad design snarare än ett tvåsidigt bevis.
Robots. Länken var alltid nåbar; det var bara robots-policyn som stoppade den. Lydnaden är verklig och nödbromsen är verklig, vilket är rätt upplägg — vissa arkiveringsmandat ska faktiskt kunna övertrumfa robots, och det ska kräva att man medvetet skriver ignore i en konfigurationsfil.
Politeness: 57,7 sekunder för att crawla tjugo lokala sidor
Ett enda tal avgör om Heritrix passar ditt projekt.
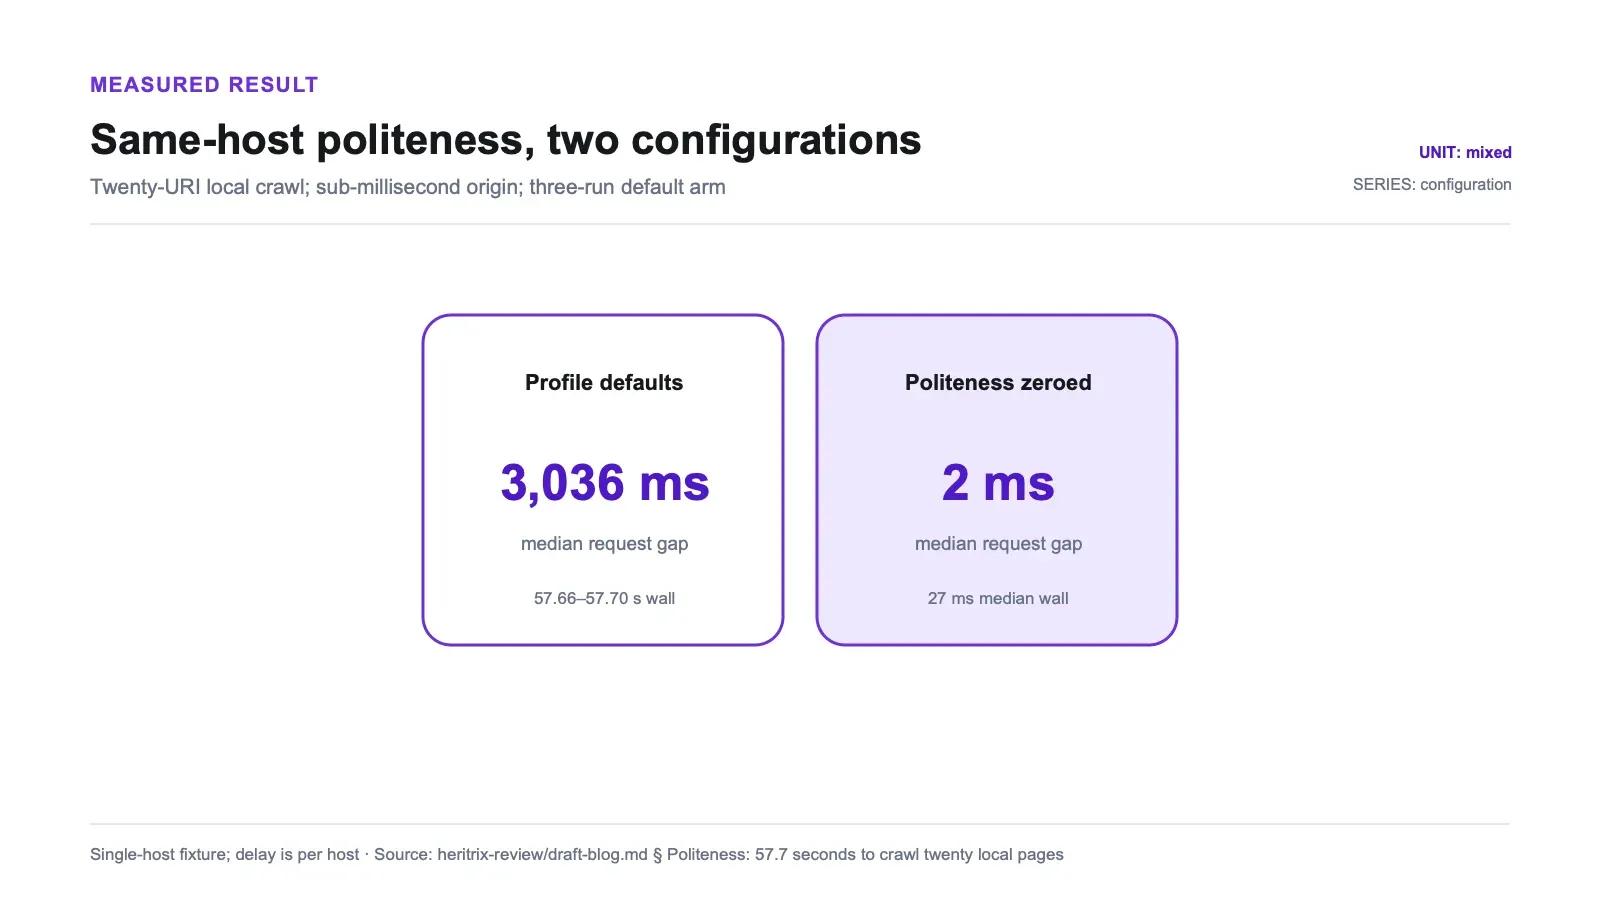
Samma testupplägg, samma tre körningar, på en enda lokal host med latens under millisekunden:
| Politeness-inställning | Medianintervall mellan begäranden till samma host | Väggklockstid, komplett crawl på 20 URI:er |
|---|---|---|
Profilens standardvärden (delayFactor 5.0, minDelayMs 3000, maxDelayMs 30000) | 3 036 ms (min 3 021, max 9 107, över 48 uppmätta intervall) | 57.66 s / 57.66 s / 57.70 s (de tre körningarna) |
| Politeness nollad | 2 ms | 27 ms (median) |
Den faktiska fördröjningen ligger rakt på minDelayMs-golvet: mot en origin under millisekunden blir delayFactor × fetch-time försumbar och minimumet dominerar per konstruktion. Förhållandet mellan raderna är inte så användbart eftersom nämnaren med noll politeness bara är tiotals millisekunder och skakar mellan körningar. Det stabila resultatet är det absoluta golvet: standard-Heritrix väntade ungefär tre sekunder mellan begäranden till samma host i detta testupplägg, vilket gjorde en crawl på tjugo sidor till ungefär en minuts väggtid.
Ett konkret sätt att känna det. Säg att ett universitetsbibliotek behöver arkivera en statlig webbplats på 50 000 sidor innan den avvecklas, och att allt ligger på en och samma host. Med ett golv på 3 sekunder per host blir det 150 000 sekunder tvingad väntan — ungefär 42 timmar, alltså ungefär ett dygn och tre fjärdedelar, innan man ens räknar in hämtningstid. Det är ren aritmetik från mitt uppmätta golv på 3 036 ms — 50 000 × 3,036 s = 151 800 s = 42,2 h; även med den konfigurerade miniminivån på 3 000 ms blir det 41,7 h, vilket avrundas till 42, inte 41. Inte en uppmätt crawl, men den aritmetik projektplanen behöver.
Fair nog är Heritrixs politeness per host, eftersom frontiern köar per host. En bred crawl över tusentals domäner parallelliseras över de köerna och får inte detta tak globalt. Mitt testupplägg var en enda host, vilket är worst case för just den här siffran. Om ditt arkivmål är en stor enda sajt är det worst case också ditt case.
Och det är en funktion. Fördröjningen är det som gör en arkiveringscrawler till något en sajtägare tolererar i stället för blockerar. Att justera den nedåt är ett beslut om någon annans server, och verktyget gör det beslutet explicit i stället för aggressivt som standard.
Vad jag inte testade
De här mätningarna täcker crawl-disciplin i ett kontrollerat testupplägg, och inget bredare. Utanför den ramen:
- Dedup mellan crawls och återcrawlning. Jag mätte bara content-digest-dedup inom en crawl. Att bära med sig en URI-historikdatabas mellan separata crawls (
FetchHistoryProcessor+PersistLog) är en annan mekanism och den körde jag inte. - Skala och långsiktig stabilitet. Ingen frontier med miljon URI:er, ingen checkpoint-and-restore, ingen flerdygnskörning. Mitt testupplägg mäter disciplin, inte uthållighet.
- JavaScript-renderad capture. Heritrixs standardcapture är icke-webbläsarbaserad och det är det jag mätte. De valfria webbläsarbaserade beteendena testades inte här.
- Politeness mot en origin med hög latens. Lokal latens är under millisekunden, så
minDelayMsdominerade av konstruktion. HurdelayFactorskalar mot en långsam verklig server är inte isolerat i mina data. - Sitemap-rekall. robots.txt hämtades och sitemap-direktivet följdes, men jag verifierade inte separat varje
<loc>-post.
Vad du bör tydliggöra före första produktionsjobbet
Standardprofilen är lång, men besluten som ändrar vad ett arkiv faktiskt betyder är ganska få. Börja med scope. Seeds genererar standard-SURT-prefix, och DecideRules kan bredda eller snäva in dem i ordning. Granska den slutliga regelordningen mot representativa URL:er inom och utanför scope, och verifiera sedan mot server-side-trafik eller annan oberoende request-logg. En crawlrapport kan inte bevisa att en exkluderad host aldrig kontaktades.
Bestäm sedan vad robots-policyn och operatörsidentiteten betyder för insamlingen. Den testade standarden följde fixturets disallow-regel, medan ändring av robotsPolicyName till ignore gjorde att den blockerade sökvägen hämtades. Den växlingen är mekaniskt enkel och institutionellt viktig. Dokumentera vem som godkände den och varför, tillsammans med en fungerande operatorContactUrl; den obligatoriska URL:en ger en sajtägare en väg tillbaka till operatören men inte auktorisationsmotivet.
Lagringsplaneringen behöver ett eget tydligt beslut. Om identiska bodies ska bli revisit-poster, lägg till och granska content-digest-historikprocessorerna innan du dimensionerar arkivet. Den testade kedjan påverkade representationen efter hämtning, så origin-trafik bör fortfarande budgeteras för båda URL:erna. Deduplikering mellan crawls är en separat mekanism och ska inte antas utifrån detta två-URL, enstaka crawl-resultat. En liten valideringscrawl med kända duplicerade bodies är ett billigt sätt att bekräfta att den deployade bean-grafen ger de tänkta posttyperna.
Till sist: behandla politeness som en schemaläggningsinput snarare än en sista-minuten-justering. I det lokala enhost-testet dominerade minDelayMs total tiden. Ett riktigt projekt bör räkna ut det konfigurerade golvet per host mot antalet målhostar och insamlingsdeadline, och sedan testa med representativ latens. Breda crawls och crawls för en enskild sajt belastar frontiern med hostuppdelning olika; den här recensionen mätte bara det senare. Behåll också REST-livscykeln i körboken: build, launch, unpause, poll, terminate och teardown är separata tillstånd som är värda att övervaka i automation.
För- och nackdelar
Fördelar
- Arkivkompletthet är utmärkt som standard: 20/20 responses med payload-digest, capture-IP och fullständig request↔response-länkning, utan konfiguration.
- Bevarar felresponses som fakta — statusraderna 200, 404 och 500 lagras ordagrant.
- Scope-disciplin verifierades mot en server-side-räknare: noll hämtningar utanför scope medan hosten inom scope crawlas normalt.
- Robots-lydnad stoppar verkligen hämtningen, med en avsiktlig
ignore-nödbroms för obligatorisk arkivering. - Fullt headless via REST — skapa, bygg, starta, polla, rensa, allt via
curl, inga UI-klick. - Kör rent på OpenJDK 26.0.1 utan JVM-flaggor, vilket är bättre modern-Java-hygien än vad de flesta tjugo år gamla kodbaser lyckas med.
- Obligatorisk operator contact URL gör att crawlern inte kan köras anonymt.
- Varje del av crawlen är en utbytbar bean, vilket är anledningen till att dedup kunde slås på med tre bean-insertioner i stället för en fork.
Nackdelar
- Content-digest-dedup är avstängt som standard och skriver identiska payloads i full längd — en verklig fälla för lagringsplanering.
- Deployen är tung: 41 MB distribution, 114 jars, en Java-motor plus Jetty och en jobbkonfiguration på cirka 750 rader Spring-XML.
- Standardpoliteness lägger ett golv på ungefär 3 sekunder per host; en crawl med 20 URI:er på en host tog 57,7 sekunder.
- Ingen JavaScript-rendering i standardvägen, så innehåll som bara skapas på klientsidan fångas inte.
- Konfigurationsytan belönar erfarenhet och straffar casual användning; det finns ingen femminutersväg till första crawlen.
- Inget i outputen är strukturerad data. Att få ut fält ur en WARC är ett separat projekt.
Vem som bör använda den, och vem som bör välja bort den
Heritrix är till för institutioner och team där leveransen är själva arkivet. Bibliotek, nationalarkiv, juridisk och regulatorisk bevarande, forskningsgrupper som fångar webben som primärkälla, alla som om fem år behöver kunna bevisa vad en URL visade en viss dag. Om orden "WARC", "replay" och "provenance" redan finns i ditt vokabulär är det här verktyget som resten av ditt ekosystem byggdes runt, och dess tyngd är priset för den interoperabiliteten.
Dess hostuppdelade frontier och långa användning inom webarkivering gör den till en plausibel kandidat för breda crawls över många domäner. Det är en arkitektur- och projekthistorisk bedömning, inte ett skalresultat från detta testupplägg; långsiktig genomströmning, checkpoint-återhämtning och beteende vid miljon-URI:er är fortfarande otestade här.
Välj bort den om du vill ha data snarare än ett arkiv. Om ditt mål är ett kalkylblad med produkter, listningar eller kontakter kommer Heritrix att göra ett perfekt jobb med att bevara sidor som du sedan måste bygga en separat pipeline för att tolka — och du har betalat för en Java-motor, en Spring-konfig och ett 3-sekunders politeness-golv för besväret. Välj också bort den om dina mål är client-renderade single-page-appar, där en icke-webbläsarbaserad hämtare bara fångar skalet och inte innehållet; då är en webbläsarbaserad arkivmotor rätt instrument. Och välj bort den om du behöver ett första resultat i dag, för setupkurvan är verklig.
Alternativ och var ett hanterat API passar in
Inom arkivering är den direkta moderna motsvarigheten Browsertrix Crawler — en webbläsarbaserad arkivmotor som kör Chromium och registrerar vad webbläsaren gjorde. Den kan fånga JavaScript-genererat innehåll som saknas i Heritrixs standard-HTTP-svar, men lägger till overhead för webbläsardrift och runtime. Den här recensionen körde ingen head-to-head-benchmark, så beslutet börjar med fångstkraven: webbläsargenererat tillstånd pekar mot en webbläsararkivare; vanliga HTTP-resurser ligger fortfarande i Heritrixs naturliga väg.
Relaterad recension: Browsertrix Crawler-recension.
För en helt annan typ av problem — du vill inte ha ett arkiv, du vill ha strukturerad data från sidor — jämför Heritrix med extraktionssystem utifrån output i stället för att behandla dem som likvärdiga crawlers. Heritrix är gratis och self-hosted: du kör JVM:en, äger beans-filen, dimensionerar diskarna och finjusterar politeness. Den modellen passar när bevarande är leveransen.
Upplysning: Thunderbit är utgivarens produkt och testades inte i detta Heritrix-upplägg. Den tillhör kategorin managed extraction: dess output är sidinnehåll eller strukturerade poster snarare än bevarandegrada WARC-filer. Välj en arkivmotor när återspelbar capture och provenance krävs; överväg en extraktionstjänst när leveransen är rader eller dokumenttext och hanterad drift är acceptabel.
Arkivering har sin egen tillståndsfråga, och den är inte densamma som scrapingens. Heritrix följer robots.txt som standard och kräver att du identifierar dig innan den hämtar en byte, vilket är en bra grund — men en robots-kompatibel crawl är inte automatiskt auktoriserad. Upphovsrätt, användarvillkor, personuppgifter och din egen institutions mandat ligger ovanpå det, och ignore-policyn finns för organisationer med juridisk grund att använda den, inte som en bekvämlighetsknapp. Om du sätter upp ett arkivprogram, reda ut auktorisationsomfånget innan diskarna fylls, och läs gärna om den juridiska sidan av web scraping och arkivering om det här är nytt territorium.
Testa Thunderbit för webbdatastraktion
Slutomdöme
Ska du använda Heritrix? Ja — om din output är ett arkiv och du har någon som är beredd att lära sig Spring beans.
Testupplägget ger ett tydligt beslut: standardprofilen bevarade response-, request- och capture-metadata konsekvent; scope- och robots-kontroller påverkade server-side-hämtningar enligt konfiguration; och hela jobbets livscykel kördes via REST. Det är användbara egenskaper för en arkiveringspipeline, inom den lilla enhost-gräns som testades här.
De operativa kostnaderna är lika tydliga: en Java-distribution och en stor Spring-konfiguration, ett konfigurerat per-host-delay som dominerade denna lokala crawl, samt content-digest-deduplikering som kräver extra historikprocessorer. Team som behöver WARC-trogenhet kan acceptera de kostnaderna; team som behöver extraherade fält bör börja i en annan kategori.
Innan en produktionscrawl bör du verifiera dedup-kedjan, politeness-inställningarna, scope, robots-policy, operatörsidentitet och lagringsantaganden mot den faktiska jobbkonfigurationen. Standardprofilen är en utgångspunkt, inte ett implicit ställningstagande till de operativa valen.
Testa Thunderbit för webbdatastraktion Get Started Free
Vanliga frågor
Gör operatorContactUrl en crawl auktoriserad?
Nej. Den tvingar jobbet att innehålla en kontakt-URL, vilket ger sajtoperatörer en ansvarsväg, men den etablerar inte tillåtelse, identitetsriktighet, upphovsrättsläge eller regelefterlevnad. Det är fortfarande distributionsbeslut utanför crawlern.
Minskar content-digest-deduplikering antalet begäranden till origin? Inte i den konfiguration som testades här. Båda URL:erna hämtades innan deras payload-digests kunde jämföras. Historikkedjan ändrade hur den andra payloaden representerades i WARC-lagringen; den gjorde inte att den andra URL:en hoppades över som nätverksbegäran.
Kan Heritrix köras utan sitt webbgränssnitt?
Ja. Den testade livscykeln — skapa, ladda upp konfiguration, bygg, starta, pausa upp, polla, terminera och rensa — kördes via REST API med curl. Det inbäddade Jetty-gränssnittet behövdes inte.
Deduplikerar standardprofilen i Heritrix identiska payloads? Inte i det här testupplägget som det var konfigurerat. Standardprofilen lagrade båda identiska svaren som fullständiga response-poster. När content-digest-historikkedjan lades till ändrades den andra hämtningen till en revisit-post, så deduplicering är ett pipeline-val du måste konfigurera och verifiera, inte ett automatiskt standardbeteende.
Hur ska jag välja politeness-delay? Se tiderna här som en mekanik-kontroll, inte en produktionsrekommendation. Sätt delay utifrån målsajtens regler, överenskommelse med operatören, serverkapacitet, crawlens syfte och din egen retry-/concurrency-policy, och bekräfta sedan de faktiska intervallen mellan samma host i loggarna.




