
Kort svar: GDPR förbjuder inte webbskrapning. Men när en scraper samlar in, lagrar, strukturerar eller återanvänder information om identifierbara personer handlar det om behandling av personuppgifter. ”Det var offentligt” är ingen strategi för GDPR-efterlevnad.
Den gränsen är nu extra svår att ignorera. I juli 2026 slog Europeiska dataskyddsstyrelsen (EDPB) fast att GDPR gäller för skrapning när den omfattar behandling av personuppgifter, och pekade ut ändamålsbegränsning och transparens som centrala frågor. De nya riktlinjerna för webbskrapning är fortfarande ute på remiss, men riktningen är tydlig: den tekniska handlingen att hämta en sida är bara början på efterlevnadsbedömningen. EDPB-uppdatering
Den här guiden är en praktisk arbetsmodell, inte juridisk rådgivning. Använd den för att fatta bättre produkt- och teknikbeslut, och ta sedan in privacy counsel eller ert dataskyddsombud (DPO) i de fall som innebär verklig risk.
Först: skilj på ”kan skrapas” och ”kan användas”
Tre olika frågor blandas ofta ihop:
| Fråga | Vad den försöker besvara |
|---|---|
| Åtkomst | Har du behörighet att komma åt webbplatsen och samla in materialet? |
| Dataskydd | Om personer kan identifieras, får du behandla uppgifterna enligt GDPR? |
| Återanvändning | Får du spara, berika, sälja, träna på, publicera eller kontakta personer med hjälp av dem? |
Att klara ett av dessa test betyder inte att du klarar de andra. En sida kan vara offentligt tillgänglig samtidigt som informationen ändå är personuppgifter. En tekniskt lyckad crawl kan fortfarande skapa problem enligt GDPR, avtalsrätt, immaterialrätt, databasskydd, konsumentskydd eller marknadsföringslagstiftning.
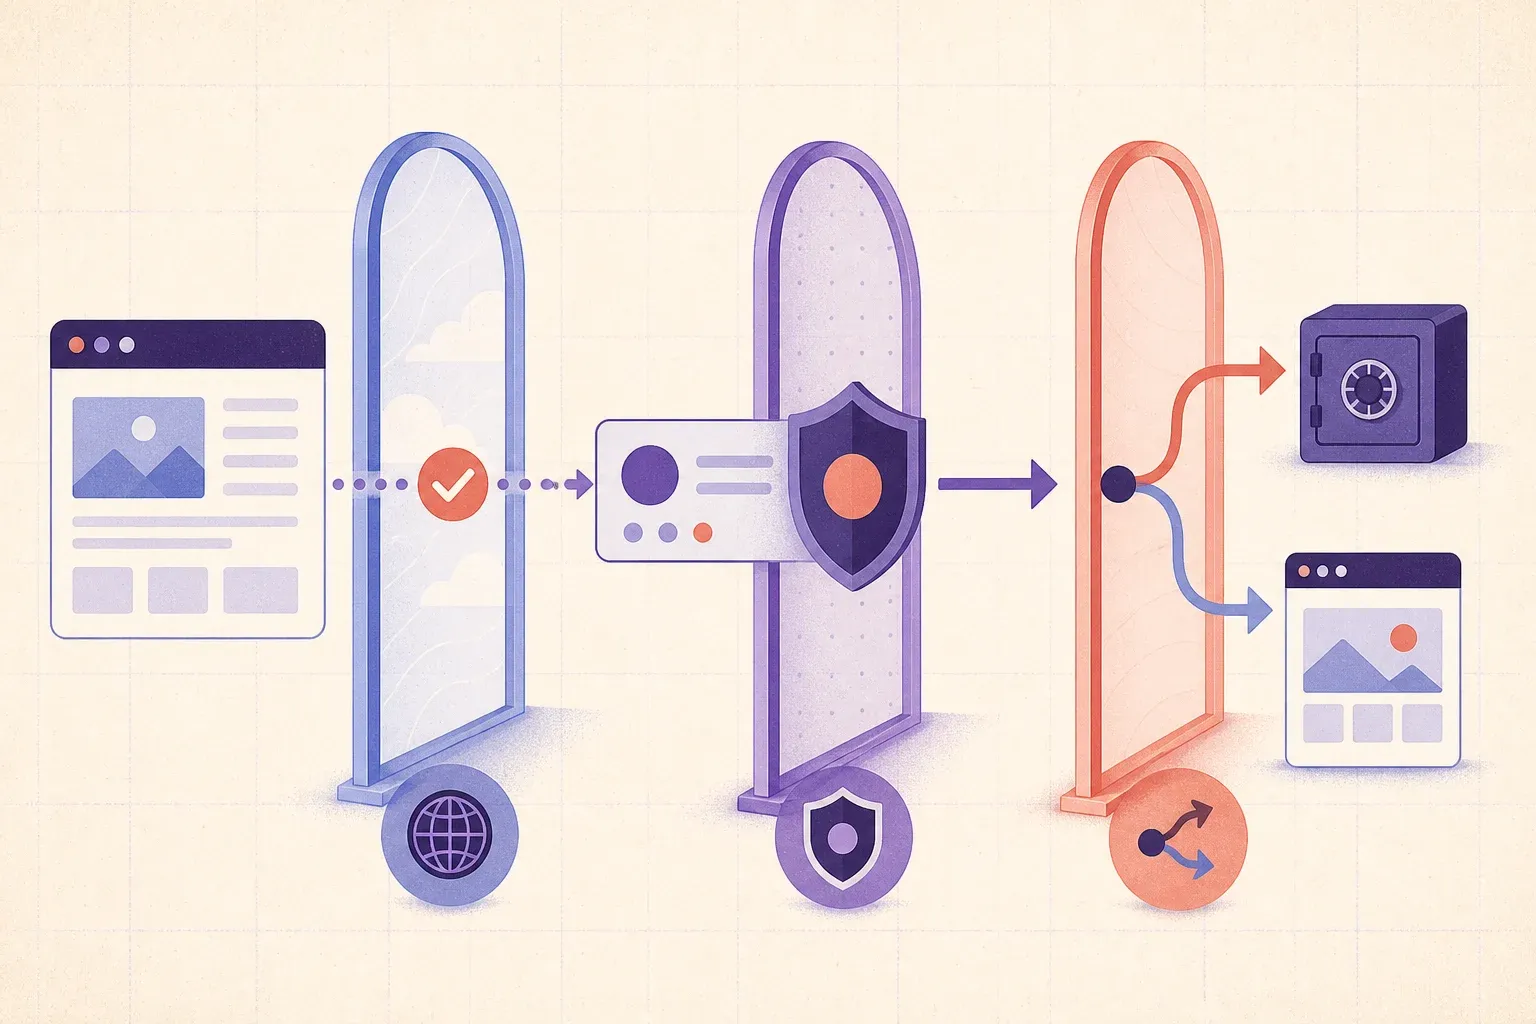
Se därför efterlevnad som ett arbetsflöde innan du kör igång — inte som en paragraf i en integritetspolicy som läggs till i efterhand.
1. Avgör om GDPR alls är tillämplig
Börja med två frågor.
Innehåller datasetet personuppgifter?
Personuppgifter är bredare än namn och e-postadress. Det omfattar all information som rör en identifierad eller identifierbar person, till exempel profilbild, användarnamn som går att koppla till en individ, platsdata, IP-adress, yrkesbakgrund, recensioner eller en kombination av annars harmlösa fält. EDPB-definition
Uppgifter på företagsnivå kan i vissa fall vara ofarliga. Men ett ”affärskontakt”-register kan snabbt bli personuppgifter när det innehåller en namngiven enskild näringsidkare, en direktadress till en anställd, ett mobilnummer eller en länkad profil. Utgå från det faktiska datasetet, inte det idealiserade.
Gäller GDPR för er organisation och ert ändamål?
GDPR kan gälla när behandlingen är kopplad till en etablering i EU. Den kan också gälla en organisation utanför EU om den erbjuder varor eller tjänster till personer i EU eller övervakar deras beteende. Översikt från Europeiska kommissionen
Om svaret är ja på båda frågorna bör du utgå från att skrapningen kräver en dokumenterad GDPR-process. Om svaret är oklart, använd inte osäkerhet som grönt ljus — eskalera frågan.
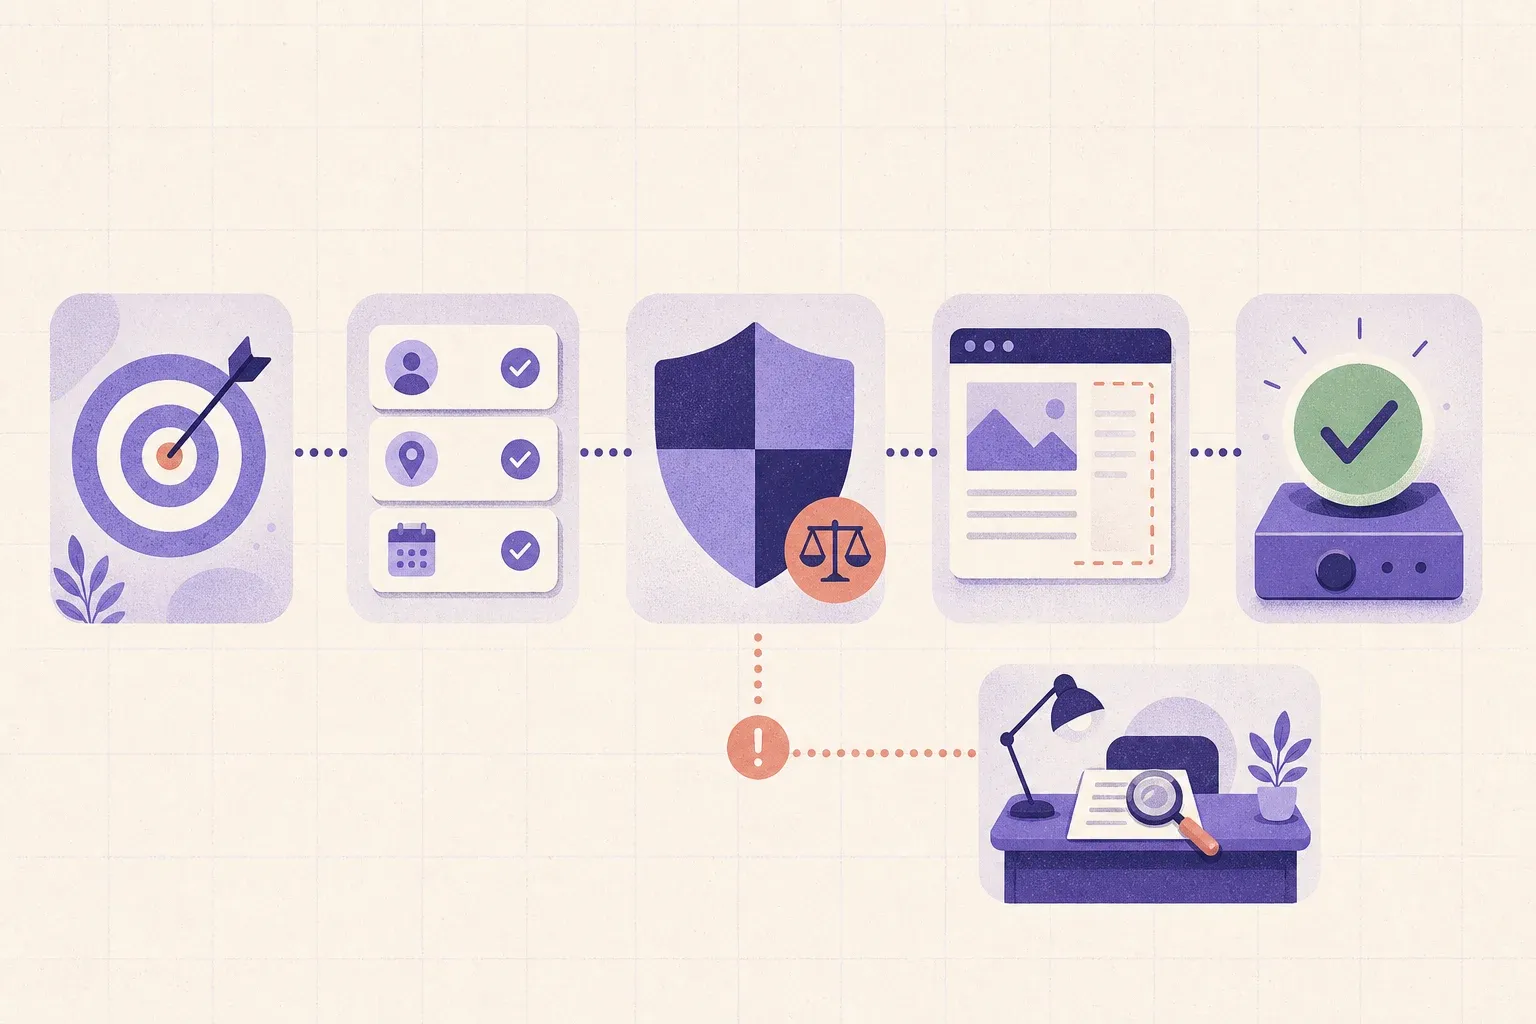
2. Skriv en insamlingsbrief på en sida innan crawlern körs
Den enklaste kontrollen är också den mest värdefulla: specificera vad du behöver innan insamlingen börjar.
Din brief bör svara på:
- Syfte: Vilket konkret beslut, vilken tjänst eller analys kräver den här datan?
- Personer och fält: Vilka kategorier av personer kan förekomma, och exakt vilka fält behövs?
- Källa och åtkomst: Är innehållet fritt tillgängligt? Invänder källan genom villkor, robots-styrning, inloggningsväggar eller andra tekniska hinder?
- Användning och mottagare: Vem ska se resultatet? Kommer datan att berikas, exporteras, delas, användas för direktmarknadsföring eller modellträning?
- Lagringstid: När ska rådata, arbetsfiler och härledda poster raderas eller granskas?
- Ansvar: Vem är personuppgiftsansvarig, vem är personuppgiftsbiträde och vem hanterar rättighetsförfrågningar?
Det här är inte byråkrati för byråkratins skull. GDPR-principerna kräver ett tydligt syfte och att bara uppgifter som är adekvata, relevanta och begränsade till vad som är nödvändigt behandlas. Europeiska kommissionens principer
3. Välj och dokumentera en rättslig grund — anta inte att den finns
Varje behandling av personuppgifter behöver en rättslig grund. Samtycke kan passa vissa produkter, men är inte standardlösningen för offentliga webbkällor. För vissa privata organisationer kan berättigat intresse vara en möjlig grund för snävt avgränsad skrapning med verkliga skyddsåtgärder. Men det är inte automatiskt.
En hållbar bedömning av berättigat intresse besvarar tre frågor:
- Är intresset lagligt, specifikt, verkligt och aktuellt?
- Är insamlingen nödvändig för det syftet, eller finns det ett mindre ingripande sätt att nå samma mål?
- Väger personens intressen, rättigheter eller rimliga förväntningar tyngre än ert intresse?
CNIL menar att offentligt tillgängliga uppgifter som samlas in via skrapning i regel bedöms genom linsen berättigat intresse, men att ytterligare åtgärder krävs för att minska påverkan på individer. Myndigheten betonar också att bedömningen ska göras från fall till fall, inte som ett generellt undantag. CNIL-vägledning
Dokumentera analysen, antagandena och vilka åtgärder ni valde. ”Profilen var offentlig” är kontext för avvägningen — inte avvägningen i sig.
4. Gör dataminimering till ett tekniskt krav
Det mest GDPR-säkra registret är ofta det som din scraper aldrig samlade in.
Bygg in följande skydd i insamlingsjobbet:
- Fältlista med tillåtelse. Definiera vilka fält du behöver; skrapa inte allt som syns bara för att det är enkelt.
- Blockera känsliga kategorier. Uteslut hälsoinformation, politiska åsikter, religion, facklig tillhörighet, sexliv, biometriska uppgifter och andra särskilda kategorier om inte jurist har tagit fram en specifik laglig väg. Vanlig text kan oväntat avslöja sådana kategorier.
- Uteslut högriskkällor. Ha en standardlista över källor som ska undantas, till exempel stödgrupper, hälsoforum, barnmiljöer och andra sammanhang där återanvändning kan vara överraskande eller skadlig.
- Radera spill snabbt. Om irrelevanta personuppgifter fångas in, isolera och radera dem i stället för att diskret behålla dem ”ifall att”.
- Spara härkomst. Lagra käll-URL, insamlingsdatum och relevant konfiguration tillsammans med varje dataset. Det stödjer riktighet, radering och hantering av rättigheter.
CNIL rekommenderar uttryckligen att man i förväg bestämmer relevanta kategorier, filtrerar bort onödiga eller känsliga uppgifter, raderar irrelevanta uppgifter och respekterar tekniska eller rättsliga invändningar mot insamling. CNIL-skyddsåtgärder
5. Se transparens som en del av produkten
Uppgifter som samlas in från en webbplats samlas vanligtvis in indirekt. Det innebär att transparenskraven i artikel 14 kan vara relevanta: förklara vem ni är, syftet, kategorierna och källan till uppgifterna, rättslig grund, lagringstid, mottagare, överföringar och personernas rättigheter.
Europeiska kommissionens sammanfattning säger att när uppgifter har hämtats från annan källa ska information normalt lämnas inom en månad, vid första kommunikation eller vid första utlämnande — beroende på vad som är tillämpligt. Det finns undantag, bland annat när underrättelse är omöjlig eller skulle innebära oproportionerlig ansträngning, men de är villkorade och bör bedömas och dokumenteras, inte antas. Europeiska kommissionens skyldigheter
För breda insamlingar kan ett tydligt offentligt meddelande, en datasetsida, en särskild kontaktväg och lättillgängliga instruktioner för invändning, tillgång, rättelse och radering vara mer värdefullt än en dold juridiksida. Rätt format beror på behandlingen och risken.
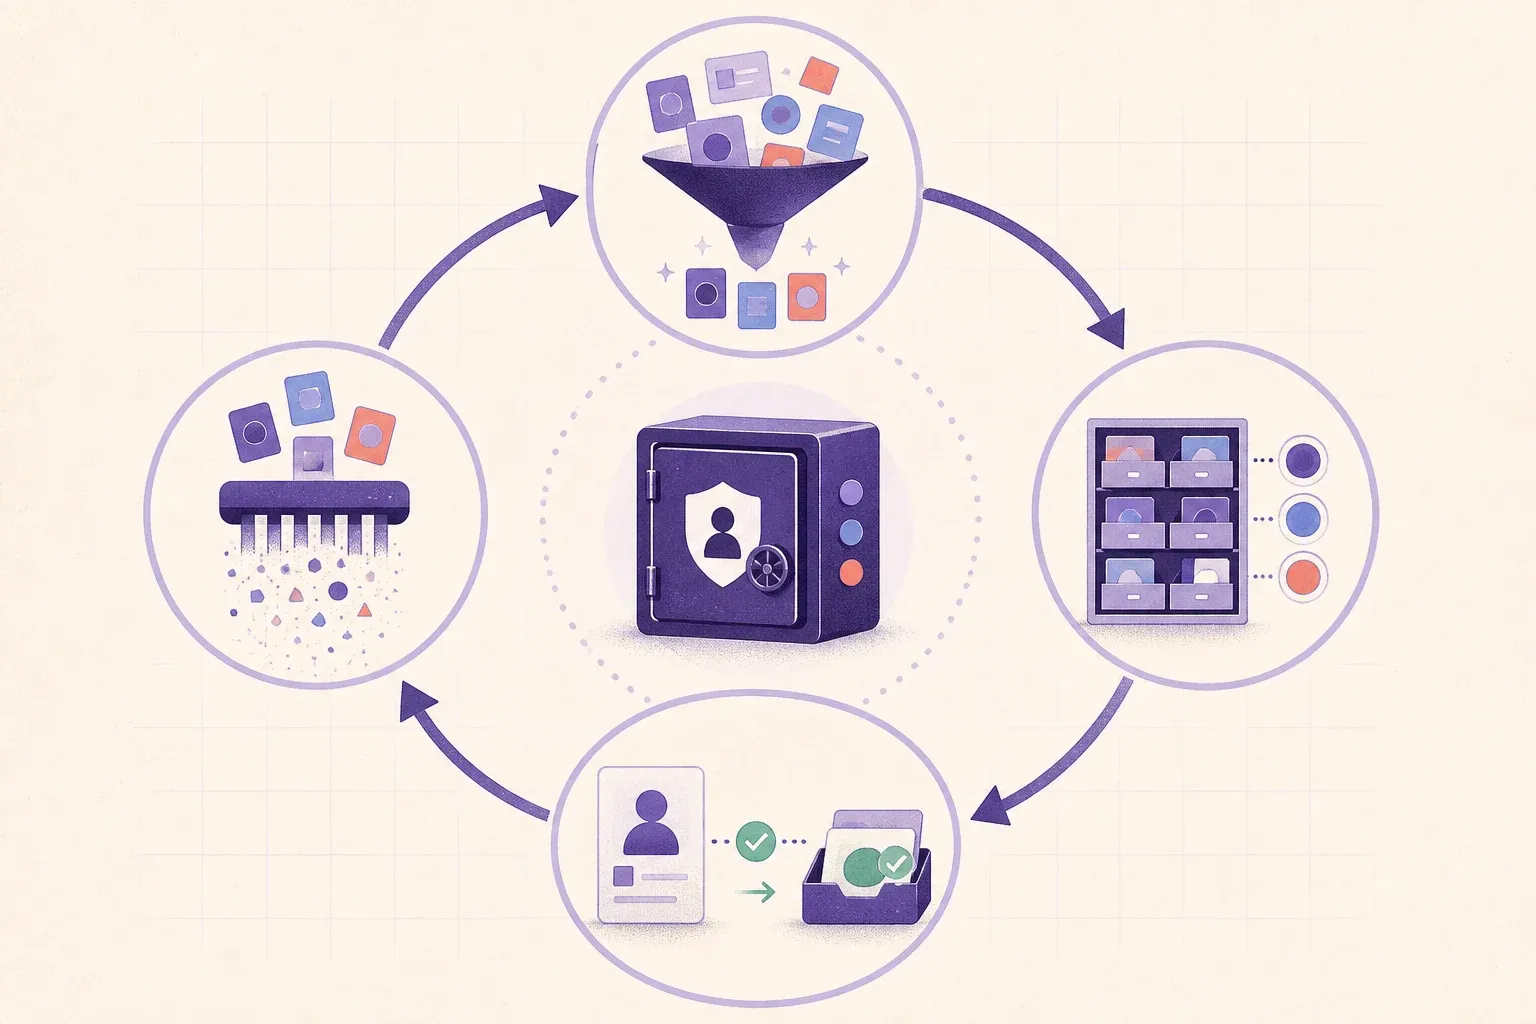
6. Bygg ett arbetsflöde för radering och rättigheter innan lansering
Skrapning i stor skala gör efterföljande städning dyr. Ge datan ett ID, behåll en kontrollerad koppling mellan källa och post, och se till att du kan hitta och ta bort eller maskera en persons uppgifter i råfångst, databaser, exportfiler, index och nedströms system.
Bestäm åtminstone:
- vem som tar emot och verifierar en rättighetsförfrågan;
- hur en post lokaliseras utan att be om onödigt extra information;
- hur radering eller invändning sprids till nedströms system;
- hur spärrning förhindrar oavsiktlig återinsamling;
- hur länge loggar och backupkopior behåller posten, och vilken undantagsprocess som gäller.
Om datasetet ska användas för en modell, ett berikningsnät, profilering eller direktmarknadsföring behöver planen vara ännu striktare. Ju längre datan färdas, desto svårare blir det att faktiskt respektera rättigheter.
7. Säkra datasetet och bedöm högriskfall tidigt
GDPR kräver åtgärder som står i proportion till risken, inklusive skydd mot obehörig åtkomst, förlust, förstörelse och otillåten behandling. Inbyggt dataskydd och dataskydd som standard innebär att dessa kontroller väljs från början, inte efter ett intrång. Europeiska kommissionens skyldigheter
Bra grundskydd omfattar rollbaserad åtkomst, kryptering under överföring och i vila, hantering av hemligheter, revisionsloggar, leverantörsgranskning, kontroll av dataexport och en testad incidentprocess. Pseudonymisering kan minska risk, men är inte samma sak som anonymisering och tar vanligtvis inte bort GDPR-skyldigheter i sig.
En DPIA bör övervägas innan behandling som sannolikt innebär hög risk, särskilt när du kombinerar flera av följande faktorer:
- storskalig insamling eller övervakning;
- profilering eller beslut som påverkar människor;
- särskilda kategorier eller mycket personliga uppgifter;
- barn eller andra utsatta personer;
- kombination av dataset för att dra nya slutsatser;
- ihållande identifiering, platsdata eller återanvändning i stil med data brokers;
- AI-träning eller en modell som kan memorera eller exponera personuppgifter.
Kommissionen anger systematisk och omfattande automatiserad utvärdering, storskalig behandling av känsliga uppgifter och storskalig systematisk övervakning bland de fall som kräver en DPIA. DPIA-vägledning
Checklista inför lansering för team som skrapar webbdata
Innan du kör ett produktionsjobb, säkerställ allt nedan:
- Vi vet om insamlingen innehåller personuppgifter och varför GDPR gäller eller inte gäller.
- Vi har ett exakt skriftligt syfte och en fältlista med endast nödvändiga uppgifter.
- Vi har dokumenterat rättslig grund och, om relevant, en bedömning av berättigat intresse.
- Vi har som standard uteslutit känsliga och högriskkällor eller kategorier.
- Vi har bedömt källans begränsningar och kringgår inte åtkomstkontroller.
- Vi har en tydlig offentlig förklaring och en fungerande väg för rättighetsförfrågningar och invändningar.
- Vi känner till rollerna som personuppgiftsansvarig/personuppgiftsbiträde och har lämpliga leverantörsvillkor.
- Vi har processer för lagringstid, radering, spärrning och vidare spridning nedströms.
- Vi har proportionerliga säkerhetskontroller och tydligt incidentansvar.
- Vi har genomfört, eller medvetet dokumenterat varför vi inte behöver, en DPIA och en bedömning av gränsöverskridande överföringar.
Det praktiska slutsatsen
GDPR-efterlevnad för webbskrapare handlar inte om att hitta en magisk rad i en robots-fil eller klistra in en friskrivning i produkten. Det handlar om att göra insamlingen proportionerlig i förhållande till ett tydligt angivet syfte, ge människor verklig insyn och kontroll, och kunna bevisa era val i efterhand.
Börja smalt. Samla in mindre. Spara källor och tidsstämplar. Bygg in radering i datamodellen. Eskalera känslig användning, storskalig användning, profilering och AI-träning innan datan går vidare nedströms. De vanorna gör en scraper mer pålitlig — och betydligt enklare att driva när den första integritetsfrågan dyker upp.
Den här artikeln ger allmän information, inte juridisk rådgivning. Sök kvalificerad rådgivning för er organisations faktiska förhållanden, jurisdiktioner, datakategorier och avsedda användning.
Läs mer




